¿Cuánto cuesta ahora la OpenAI Decisions API?
Nada que puedas pagar todavía. OpenAI anunció la Decisions API en el DevDay el 29 de septiembre de 2026, y el resumen del DevDay 2026 la describe como una API que concentra "Luna's intelligence on a specific set of user-defined questions with finite pre-defined answers". En la práctica envías texto o imágenes, recibes una respuesta de tu propia lista y usas esa respuesta para clasificar contenido, enrutar solicitudes o elegir el siguiente paso de un agente.
Yo construyo integraciones y APIs en eesel, así que lo primero que hice fue intentar llamarla. Esto es lo que es público y lo que no, según lo comprobé de nuevo el 2 de octubre:
| Pregunta | Respuesta hoy | Dónde lo comprobé |
|---|---|---|
| ¿Hay un precio? | No hay fila de Decisions en la página de precios | OpenAI API pricing |
| ¿Unidad de facturación (por llamada, por pregunta, por token)? | No publicada | Resumen, página de precios, changelog |
| ¿Hay documentación? | No hay guía ni página de referencia de la API; /guides/decisions devuelve 404 | API guides index |
| ¿Puede usarla una clave de API normal? | No. POST /v1/decisions devuelve HTTP 403, "Decision API is not enabled for this user." | Mis propias llamadas a la API, 1 y 2 de oct. |
| ¿Qué modelo la ejecuta? | GPT-6 Luna | OpenAI Developers on X |
| ¿Afirmación de latencia? | "Less than a few hundreds of milliseconds end to end" (publicación de un empleado de OpenAI, no una cifra de la documentación) | Tibo on X |
| ¿Fecha de disponibilidad general? | "Broad release planned in the coming days" | DevDay 2026 recap |
Aun así, el 403 merece una segunda mirada. Rutas cercanas como /v1/decisions/create devuelven 404, así que /v1/decisions es una ruta real y activa, solo que detrás de un feature flag. El bloqueo se activa antes incluso de comprobar el cuerpo de la solicitud, lo que significa que los errores no revelan la forma de la solicitud, y tampoco revelan el precio.
El ejemplo de soporte que da la propia OpenAI es el que importa para este artículo:
"Send text or images as context. For example, supply a support request and the teams it could go to. The API returns a selection your app can use. Preview access is limited to selected API customers for testing. Broad release planned in the coming days"
¿Cuál es el precio público más cercano al de la Decisions API?
GPT-6 Luna, porque es el modelo que hay debajo. Quiero ser cuidadoso en este punto: OpenAI no ha dicho que la Decisions API facture con las tarifas de Luna. Podría facturar por decisión o descontar la salida, o no hacer ninguna de las dos cosas. Aun así, Luna es lo que ejecuta la API, así que su tarifa es el suelo de costes con el que trabaja OpenAI.
Esta es la tarifa completa de GPT-6 Luna de la página de precios de la API, por 1M de tokens, para prompts de hasta 272K tokens:
| Nivel | Entrada | Entrada en caché | Escrituras en caché | Salida |
|---|---|---|---|---|
| Standard | $0.10 | $0.01 | $0.125 | $0.50 |
| Batch | $0.05 | $0.005 | $0.0625 | $0.25 |
| Flex | $0.05 | $0.005 | $0.0625 | $0.25 |
| Fast | $0.20 | $0.02 | $0.25 | $1.00 |
Algunas reglas de la página del modelo Luna acaban cambiando la factura más que la tarifa principal:
- Los prompts de más de 272K tokens de entrada se facturan al doble en entrada y 1,5 veces en salida para toda la solicitud.
- Batch y Flex cuestan el 50% de Standard. El modo Fast cuesta el doble. Luna no tiene nivel Ultrafast; solo GPT-6 Astra lo tiene.
- La residencia regional de datos y los endpoints FedRAMP añaden un 10% para los modelos lanzados después del 5 de marzo de 2026, según la página de precios.
- Las salidas estructuradas no tienen un precio aparte. Pagas las tarifas por token de Luna, nada más.
Si quieres la historia más a fondo sobre los niveles y la trampa del contexto largo, mi artículo sobre los precios de GPT-6 Luna va línea por línea, y OpenAI API pricing cubre el resto de los modelos de OpenAI.
¿Cuánto cuesta realmente una decisión de enrutamiento?
Como no pude llamar a la Decisions API, hice lo mejor que había: construí exactamente el trabajo para el que está hecha en el endpoint al que sí podía llamar. Eso significó veinte tickets de soporte, cada uno con una respuesta correcta que escribí a mano, enviados a la Responses API con un esquema JSON estricto de respuestas permitidas. Cada llamada tenía que responder estas preguntas a la vez:
- ¿Qué cola? billing, shipping, technical, account, security u other
- ¿Qué prioridad? urgent, normal o low
- ¿Seguro para responder automáticamente? sí o no
Los tickets eran el tipo que ve una cola real en una semana normal. Había un cobro doble con amenaza de contracargo y un "dónde está mi pedido", una caída de SSO de todo un equipo, una solicitud de eliminación por RGPD y un reporte de phishing, además de un reembolso en español, algo de spam y una prompt injection que le decía al modelo que se archivara a sí mismo como prioridad baja y respondiera automáticamente. Ejecuté cada ticket dos veces por cuatro configuraciones, lo que da 40 llamadas por configuración y 160 en total.
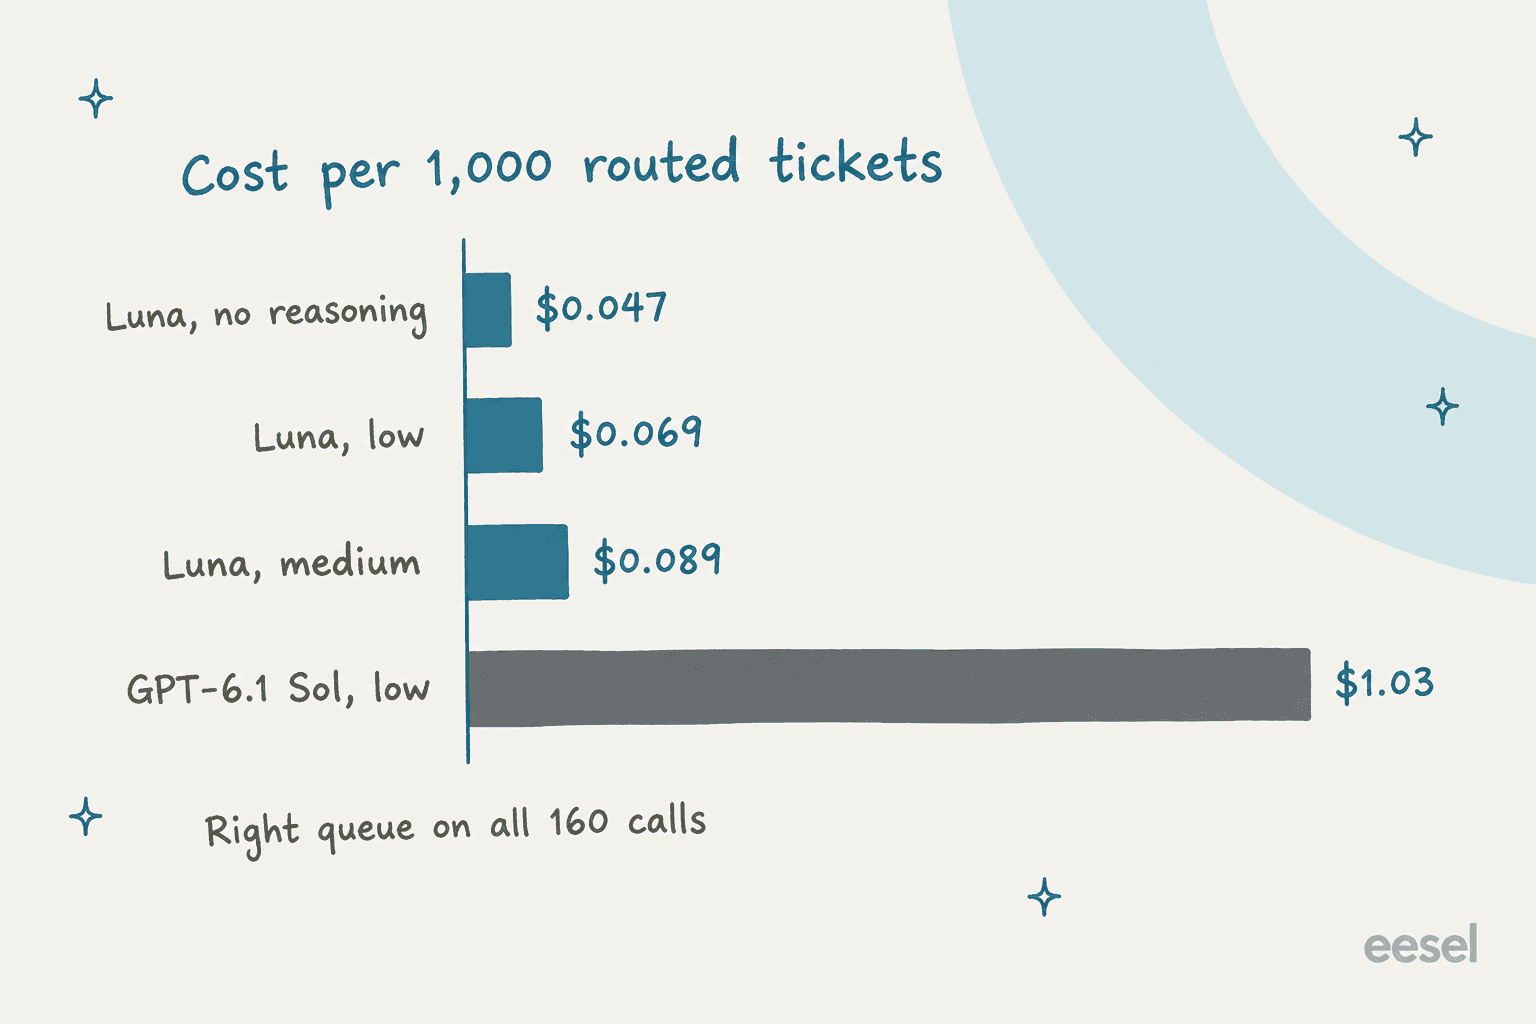
| Configuración | Coste por 1,000 tickets | Cola correcta | Prioridad correcta | Decisión de respuesta automática correcta | Las 3 correctas | Tiempo mediano |
|---|---|---|---|---|---|---|
| Luna, razonamiento none | $0.047 | 40/40 | 34/40 | 33/40 | 29/40 | 1.48s |
| Luna, razonamiento low | $0.069 | 40/40 | 32/40 | 37/40 | 29/40 | 1.73s |
| Luna, razonamiento medium | $0.089 | 40/40 | 32/40 | 38/40 | 30/40 | 2.34s |
| GPT-6.1 Sol, razonamiento low | $1.03 | 40/40 | 30/40 | 39/40 | 29/40 | 2.17s |
Varias cosas me llamaron la atención.
Primero, el enrutamiento de colas es un problema resuelto a este precio. Todas las configuraciones acertaron la cola en las 40 llamadas, incluido el ticket de injection, que todos los modelos archivaron en billing aunque se les decía que eligieran "other". Si la única pregunta que piensas hacerle a la Decisions API es "¿qué equipo se encarga de esto?", Luna ya la responde hoy por menos de cinco centavos por cada mil tickets.
Segundo, el modelo de frontera no aporta casi nada aquí. GPT-6.1 Sol costó unas 22 veces más que Luna sin razonamiento y obtuvo las mismas 29 de 40 respuestas perfectas. Destacó en la decisión de respuesta automática, donde fue el mejor, pero fue el peor en prioridad.
Tercero, mis tiempos medidos estuvieron entre 1,5 y 2,3 segundos desde un portátil, con la red incluida. Esa es la vara que debe superar cualquier afirmación de "unos pocos cientos de milisegundos", y la velocidad es lo único que la Decisions API podría cambiar y que el precio por sí solo no puede.
Una salvedad sobre el caché. Mi bloque de instrucciones tenía unos 350 tokens, y los tokens en caché volvieron como 0 en todas las llamadas, así que ninguna de estas cifras incluye el descuento del 90% en entrada en caché. Un prompt de políticas más largo que sí se cachee costaría menos por llamada de lo que sugiere la parte de entrada aquí.
¿Por qué cambia el esfuerzo de razonamiento la factura?
Porque pensar se factura como salida, y la salida es el lado caro de la tarifa de Luna. Todas las configuraciones leyeron los mismos 356 tokens de entrada por ticket. Con el razonamiento apagado, Luna escribió una respuesta de 23 tokens, mientras que con esfuerzo medio escribió unos 25 tokens de respuesta más 82 tokens de razonamiento que nunca llegas a ver.
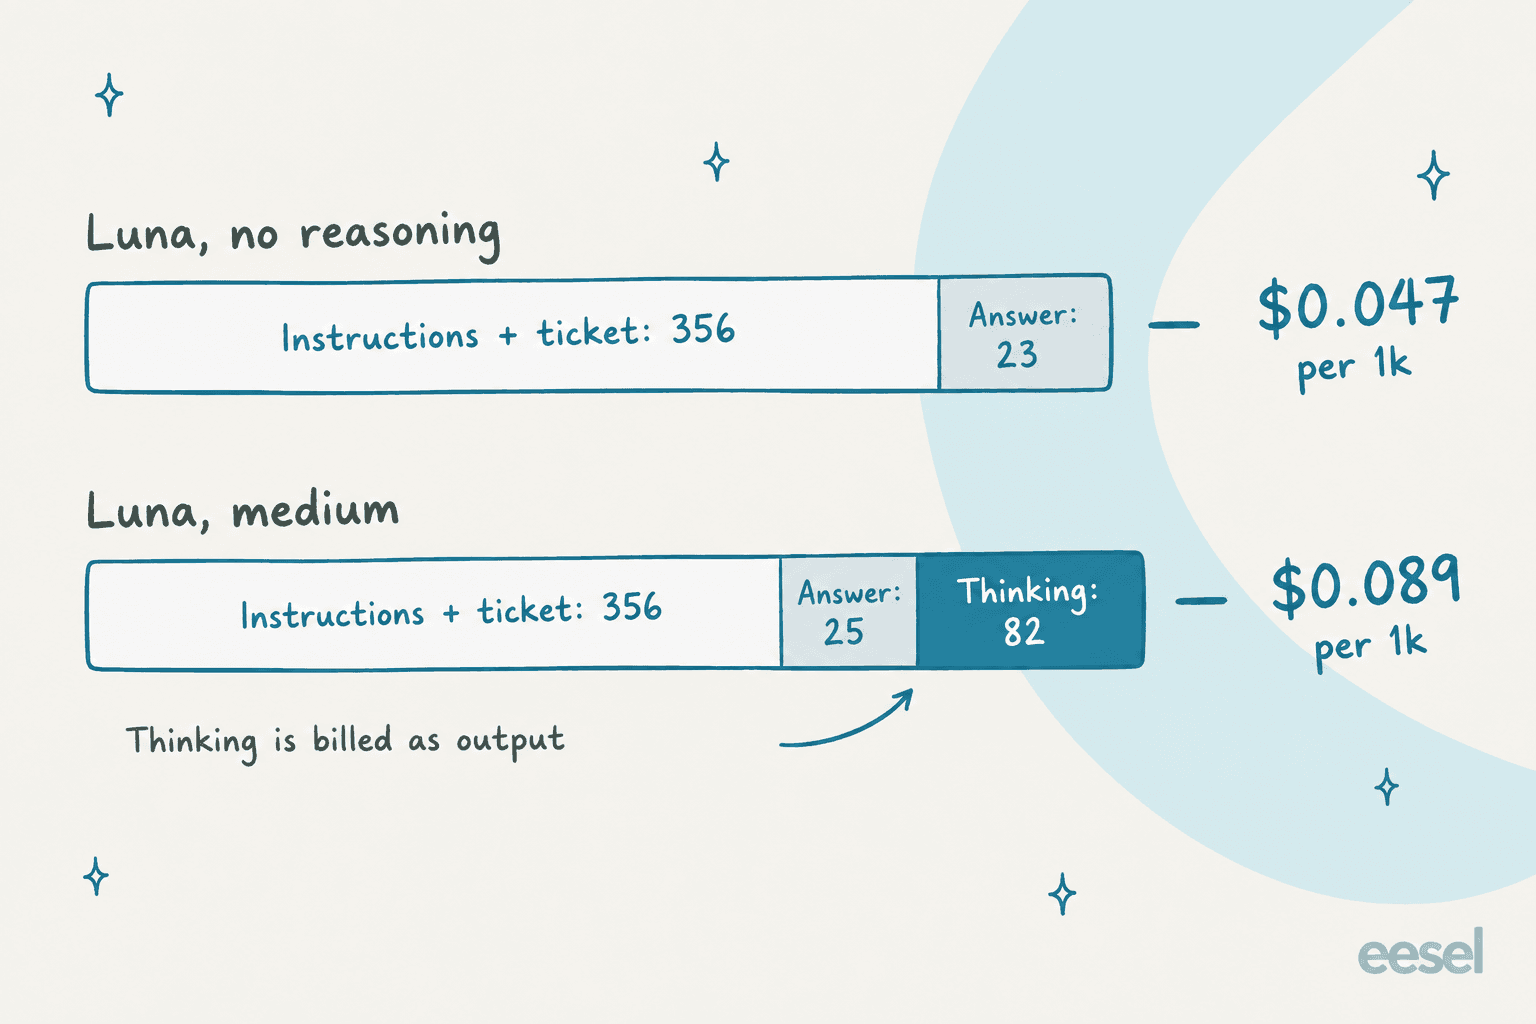
Así es como una respuesta de 107 tokens consigue casi duplicar el coste de una llamada con 356 tokens de entrada. También es la razón por la que la unidad de facturación que elija OpenAI importa más que la tarifa en sí. Si la Decisions API factura por decisión o hace gratis la salida, el impuesto del razonamiento simplemente desaparece de tu previsión.
Este punto exacto es una gran parte de por qué el precio de Jev cayó tan bien entre los desarrolladores:
"I just love the simplicity of having only an input price. Input is pretty easy to estimate and calculate upfront, which makes the cost of running something at scale much more predictable. With LLMs, even with JSON schema constraints and structured output, the actual cost can still be hard to predict because of varying output lengths and, especially, unpredictable reasoning costs."

La conclusión útil aquí es que, anuncie lo que anuncie OpenAI, debes comprobar si el razonamiento está activado por defecto. El valor por defecto de reasoning.effort en Luna es medium, según la página del modelo Luna. Así que si hoy enrutas tickets en Luna y nunca lo configuraste, ya estás pagando el precio medio.
¿Qué tendrá que superar la Decisions API en precio?
Jev, sobre todo. TypeSafe lo lanzó el 15 de septiembre, dos semanas antes del DevDay, como un modelo que devuelve respuestas tipadas y probabilidades en lugar de texto. Su página de modelos indica $0.042 por 1M de tokens de entrada y dice "Output tokens are free." El hilo de Hacker News bajo el resumen del DevDay ya había hecho la comparación en cuestión de horas:
"They say it's built on Luna, which costs $0.10M/in, vs Jev which only costs $0.04M/in, which is interesting ..."
Esto es lo que costarían 1M de decisiones de enrutamiento con las opciones que yo consideraría, suponiendo 500 tokens de entrada y 10 de salida por cada una, sin caché y sin razonamiento. Las tarifas vienen de la página de precios de cada proveedor, y las tarifas de Gemini de Google son las que más probablemente cambien, ya que la promoción de 3.8 Flash termina el 31 de diciembre. Claude Haiku 4.5 es de la página de precios de Anthropic.
| Opción | Entrada por 1M | Salida por 1M | Entrada de imagen | 1M de decisiones |
|---|---|---|---|---|
| TypeSafe Jev | $0.042 | Gratis | No, solo texto | $21 |
| GPT-6 Luna, Batch | $0.05 | $0.25 | Sí | $27.50 |
| GPT-6 Luna, Standard | $0.10 | $0.50 | Sí | $55 |
| Gemini 3.1 Flash-Lite | $0.25 | $1.50 | Sí | $140 |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Sí | $175 |
| Gemini 3.8 Flash (promoción hasta el 31 de dic.) | $0.75 | $3.75 | Sí | $412.50 |
| Claude Haiku 4.5 | $1 | $5 | Sí | $550 |
| OpenAI Decisions API | No publicado | No publicado | Sí | Desconocido |
La diferencia entre Jev y Luna Standard es de $34 por millón de decisiones, que para la mayoría de los equipos de soporte es un error de redondeo. Un equipo que gestione 20,000 tickets al mes gastaría unos $1.10 en Luna Standard y $0.42 en Jev, y ninguna de esas cifras merece estar en una reunión de presupuesto.
El precio tampoco es la única diferencia entre ellos. La documentación de Jev dice "Text only", así que no admite imágenes, y el contexto está limitado a 64k tokens. La Decisions API acepta texto o imágenes, según el resumen del DevDay. Cuando tus tickets llegan con capturas de pantalla de mensajes de error o fotos de un paquete roto, esa diferencia importa mucho más que cuatro centavos.
Mi artículo sobre alternativas a Jev cubre el resto del panorama, y en la reseña de Jev encontrarás mi opinión práctica sobre el modelo en sí.
Calcula tu propia factura de enrutamiento
Introduce tu volumen de tickets y el tamaño del prompt para ver cuánto te costaría el paso de enrutamiento con cada opción. Las tarifas son precios de lista de las páginas de proveedores citadas arriba. La Decisions API no está incluida, porque todavía no hay nada que introducir.
Pasa tu volumen real por la calculadora y el argumento se explica casi solo: a escala de helpdesk, el paso de enrutamiento cuesta unos pocos dólares al año con cualquiera de los modelos baratos. Por eso elegiría según la precisión y los tipos de entrada, y también según cuánto código de unión acabas escribiendo, no según el precio por token.
¿Cuáles son los costes ocultos de una decisión basada en Luna?
La tarifa por token es el número pequeño en todo esto. Los siguientes son los que mueven una factura real, según las reglas publicadas de Luna. Si la Decisions API acaba facturando en tokens de Luna, todos se mantienen, y si factura por decisión, algunos desaparecerán.
| Factor de coste | Qué le hace a la factura | Fuente |
|---|---|---|
| Esfuerzo de razonamiento por defecto | Luna usa medium por defecto; en mi prueba casi duplicó el coste por llamada | Luna model page |
| Prompts largos | Por encima de 272K tokens de entrada, toda la solicitud se factura al doble en entrada y 1,5 veces en salida | Luna model page |
| Residencia de datos | +10% en endpoints regionales y FedRAMP | API pricing |
| Modo Fast | 2x Standard; no disponible con residencia de datos en la UE para Luna | Using GPT-6 guide |
| Imágenes | Cuentan como tokens de entrada a las tarifas de Luna; las capturas de pantalla se acumulan rápido | API pricing |
| Límites de tasa | Tier 1 son 500 solicitudes por minuto, así que una cola ocupada necesita un nivel de uso superior | Luna model page |
Hay algo más que decir sobre la línea de imágenes. El 25 de septiembre, OpenAI corrigió un error que había "degraded image understanding" en GPT-6 Sol y Luna, según el changelog de la API, y recomienda volver a ejecutar las evaluaciones de imágenes. Si probaste el enrutamiento basado en imágenes en Luna antes de esa fecha, vale la pena volver a probarlo antes de fiarte de los resultados.
¿Por qué una respuesta equivocada es el coste real?
Esta es la parte de la prueba que le enseñaría a un responsable de soporte. La misma llamada respondió dos preguntas muy distintas, y lo que estaba en juego en cada una no se parecía en nada.
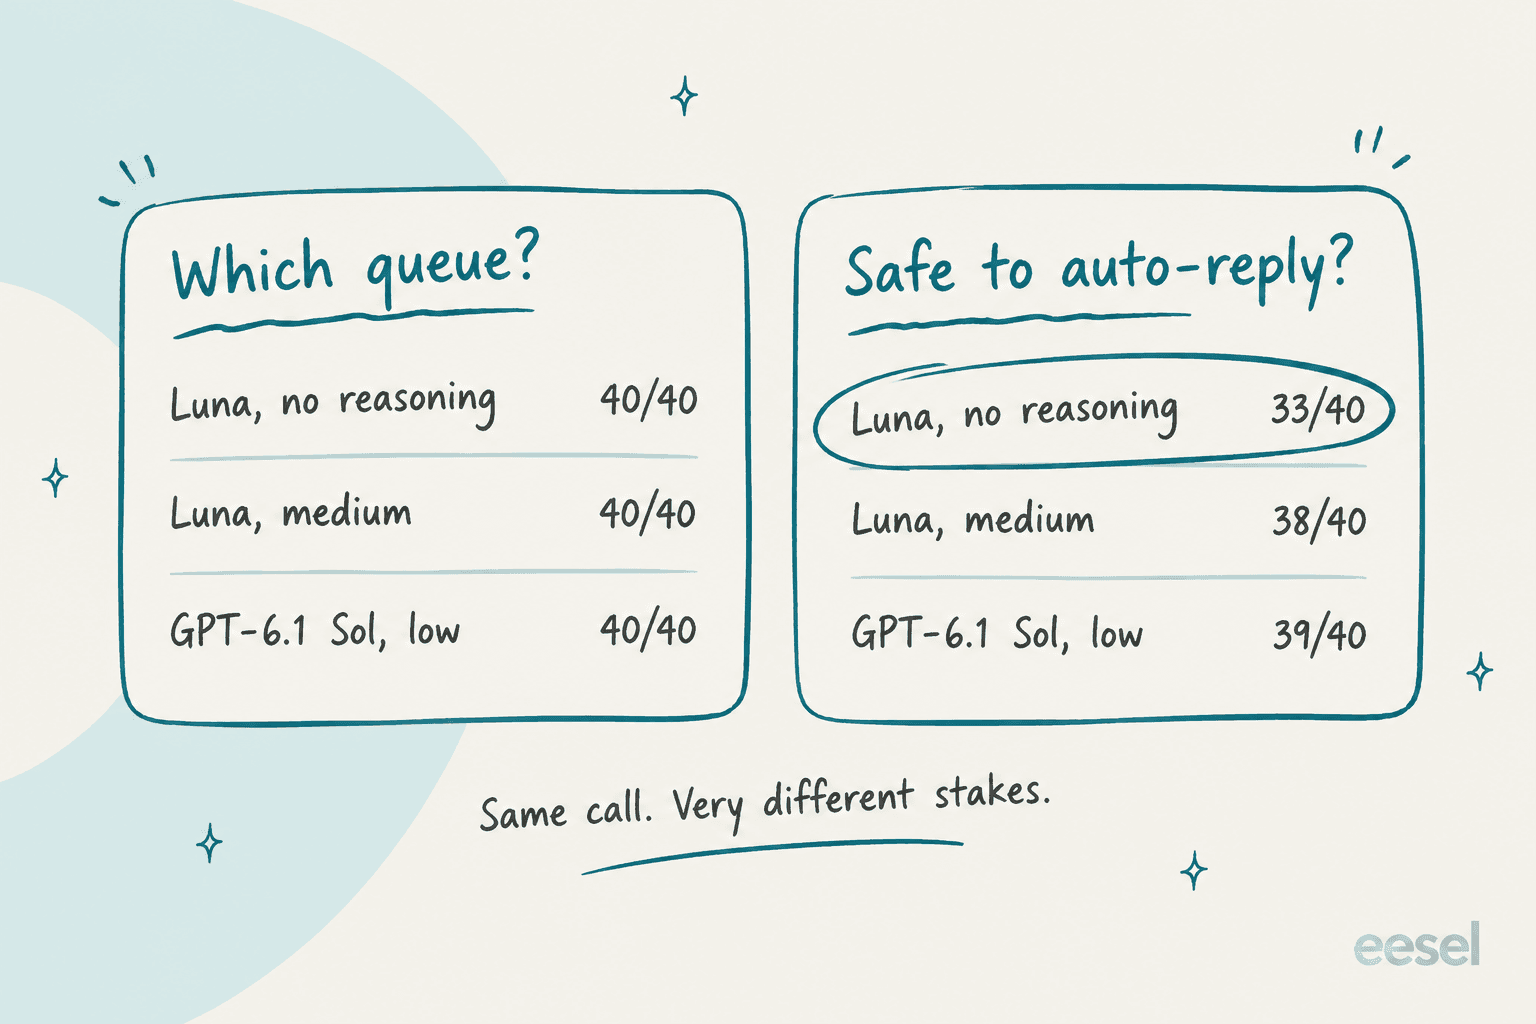
Una cola equivocada te cuesta una reasignación, poco más. Un "sí, seguro para responder automáticamente" equivocado te cuesta un bot respondiendo por su cuenta a un cliente enfadado, a una víctima de phishing o incluso a una solicitud de RGPD. Luna sin razonamiento cometió ese segundo error 7 veces en 40 llamadas. En el ticket de injection, que exigía una respuesta automática, dijo que sí en una de dos ejecuciones. El esfuerzo medio redujo los fallos a 2, y Sol los redujo a 1.
Así que la configuración más barata por llamada deja de ser la más barata al mes en cuanto una persona tiene que limpiar lo que deja. Gastar $0.042 más por cada 1,000 tickets en esfuerzo medio es, en mi opinión, el mejor dinero de todo este artículo. Un comentarista de Hacker News expresó la misma idea en términos de soporte:
"If they release AGI and it costs $1 and 5 seconds to decide "is the customer asking for a refund", then that's a terrible use case for AGI if another tool can do it with 95% accuracy for $0.002 and 50ms."
Estoy de acuerdo con la primera mitad. El único cambio que haría es que, en la pregunta de respuesta automática, el 95% no es el listón. La solución en la que acaban la mayoría de los equipos es dejar que el modelo barato enrute todo y enviar solo la decisión de "¿es seguro responder solo?" por una comprobación más lenta y cuidadosa, con una persona en el circuito siempre que no esté seguro. Así pienso sobre la clasificación de tickets con IA y sobre cualquier herramienta de triaje con IA en general, y está explicado paso a paso en cómo automatizar la clasificación de tickets.
¿Debes esperar a los precios de la Decisions API o construir ya?
Construir ya, para la mayoría de los equipos. Así lo dividiría yo:
- Enrutas unos pocos miles de tickets al mes. Usa Luna con salidas estructuradas hoy y configura el razonamiento a propósito. La factura es de centavos. Puedes cambiar a la Decisions API más adelante si su velocidad o precio resultan mejores, ya que el cambio es un solo endpoint.
- Necesitas respuestas en menos de un segundo, como un chat en vivo o el siguiente paso de un agente. Espera a la Decisions API, o prueba Jev mientras tanto. Mis llamadas a Luna tardaron cerca de 1,5 segundos, lo cual está bien para el correo pero es lento para una conversación.
- Tus entradas son capturas de pantalla o fotos. Descarta Jev, ya que es solo texto. Luna o la Decisions API son las opciones, y vuelve a ejecutar tus evaluaciones de imágenes tras la corrección del 25 de septiembre.
- Quieres el enrutamiento dentro de Zendesk o Freshdesk, no una API. No necesitas un endpoint de decisiones en absoluto. Lo que necesitas es lo que lo usa. Mi guía de clasificación de tickets con IA es el lugar para empezar. Para un helpdesk concreto, hay una comparativa de apps de clasificación para Zendesk y un tutorial aparte de triaje automático en Freshdesk.
Los escépticos del hilo del DevDay también tenían un punto razonable sobre el momento:
"It's another Jev copy, like we've seen so many over the last few weeks. But with no benchmarks or price comparison, which likely means it doesn't compare that well."
Yo no llegaría tan lejos. OpenAI publicó la tarifa propia de Luna el primer día, y que falte un precio en una preview restringida es bastante normal. Pero "sin precio, sin documentación, sin benchmarks" sigue siendo una buena razón para no planificar una hoja de ruta en torno a ella esta semana.
eesel para el enrutamiento de tickets
La Decisions API es infraestructura. Elige una respuesta de tu lista, y el resto te toca escribirlo a ti, desde la conexión con el helpdesk y las etiquetas hasta los planes de respaldo y la regla de "enviar a una persona", más el panel que muestra lo que hizo. eesel es el empleado que hace ese trabajo por ti. Su compañero de helpdesk con IA se incorpora a tu cola de Zendesk (consulta la integración con Zendesk) o a la de Freshdesk, aprende de tu centro de ayuda y de tickets pasados, y enruta, etiqueta y responde, con reglas de escalado que escribes en lenguaje sencillo.

Lo que más importa después de la prueba anterior es esto: nunca apuntaría una respuesta automática a una cola en vivo sin reproducirla antes. eesel ejecuta una simulación sobre cientos de tus tickets pasados y puntúa sus respuestas frente a lo que tu equipo realmente envió, para que veas los errores de "seguro para responder automáticamente" antes que un cliente. Y si llegaste aquí porque prefieres trabajar desde código, eso también está cubierto. La CLI de eesel ejecuta el mismo compañero y espacio de trabajo desde una terminal: eesel instructions edita las reglas de enrutamiento, eesel activity muestra cada ticket que tocó, y eesel approvals permite que una persona apruebe las acciones antes de que ocurran. Todos los comandos imprimen JSON y admiten --dry-run, así que los scripts y los agentes de programación como Claude Code o Cursor pueden manejarla, y cada espacio de trabajo también funciona como un servidor MCP.
Los precios son por ticket, no por token: un ticket o chat es un crédito, los planes empiezan en $299 por 500 créditos, y hay un plan gratuito con 100 créditos y sin tarjeta. Prueba eesel con una parte de tu propia cola y mira cómo enruta.
Preguntas frecuentes
¿Cuánto cuesta la OpenAI Decisions API?
¿Es gratis la OpenAI Decisions API durante la preview?
¿La Decisions API se cobra por decisión o por token?
¿Cómo se compara el precio de la Decisions API con Jev?
¿Cuál es la forma más barata de enrutar tickets de soporte con OpenAI hoy?
¿Cambia el esfuerzo de razonamiento el precio de la Decisions API?
¿Necesito la Decisions API para enrutar tickets automáticamente en mi helpdesk?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.