Por qué la gente busca una alternativa a GPT-6 Luna
Empecemos siendo justos con Luna, porque se lo ha ganado. Cuando OpenAI lanzó Sol y Luna el 23 de septiembre de 2026, el titular fue un recorte plano del 50% en el precio frente a la generación GPT-5.6. Simon Willison resumió el ambiente en el hilo de lanzamiento:
"GPT-6 Luna being half the price of GPT-5.6 Luna is a really big deal."

Con $0.10/$0.50 por 1M de tokens, una ventana de contexto de 1,05M de tokens y entradas de imagen, Luna es mucho modelo por el precio. También es el modelo barato por defecto para millones de personas, ya que es el único modelo GPT-6 en ChatGPT Free y Go. Otro comentarista lo resumió con claridad:
"6-luna is at the pareto for most of the tasks! I dont know how they make money here but its insane value from a closed source model."
Entonces, ¿por qué comparar? Aparecen una y otra vez tres razones reales:
- Precio a volumen. Si estás pasando millones de tokens al día por un clasificador, un resumidor o un pipeline por lotes, incluso la pequeña tarifa de salida de Luna se acumula, y un par de modelos cotizan más bajo.
- Pesos abiertos. Luna es cerrado y solo accesible por API. Si necesitas alojarlo tú mismo por privacidad, soberanía o control de costes, tienes que dejar OpenAI por completo.
- Una fortaleza concreta. Entradas multimodales más ricas (audio, vídeo, PDF), tiempos de respuesta más rápidos para un widget de chat en vivo, o una política de datos que mantiene todo en infraestructura occidental. Luna es un generalista fuerte, no el líder en ninguna de estas.
Aquí ves dónde se sitúan realmente las ocho alternativas en el número por el que empieza la mayoría de la gente: el precio de salida por 1M de tokens.
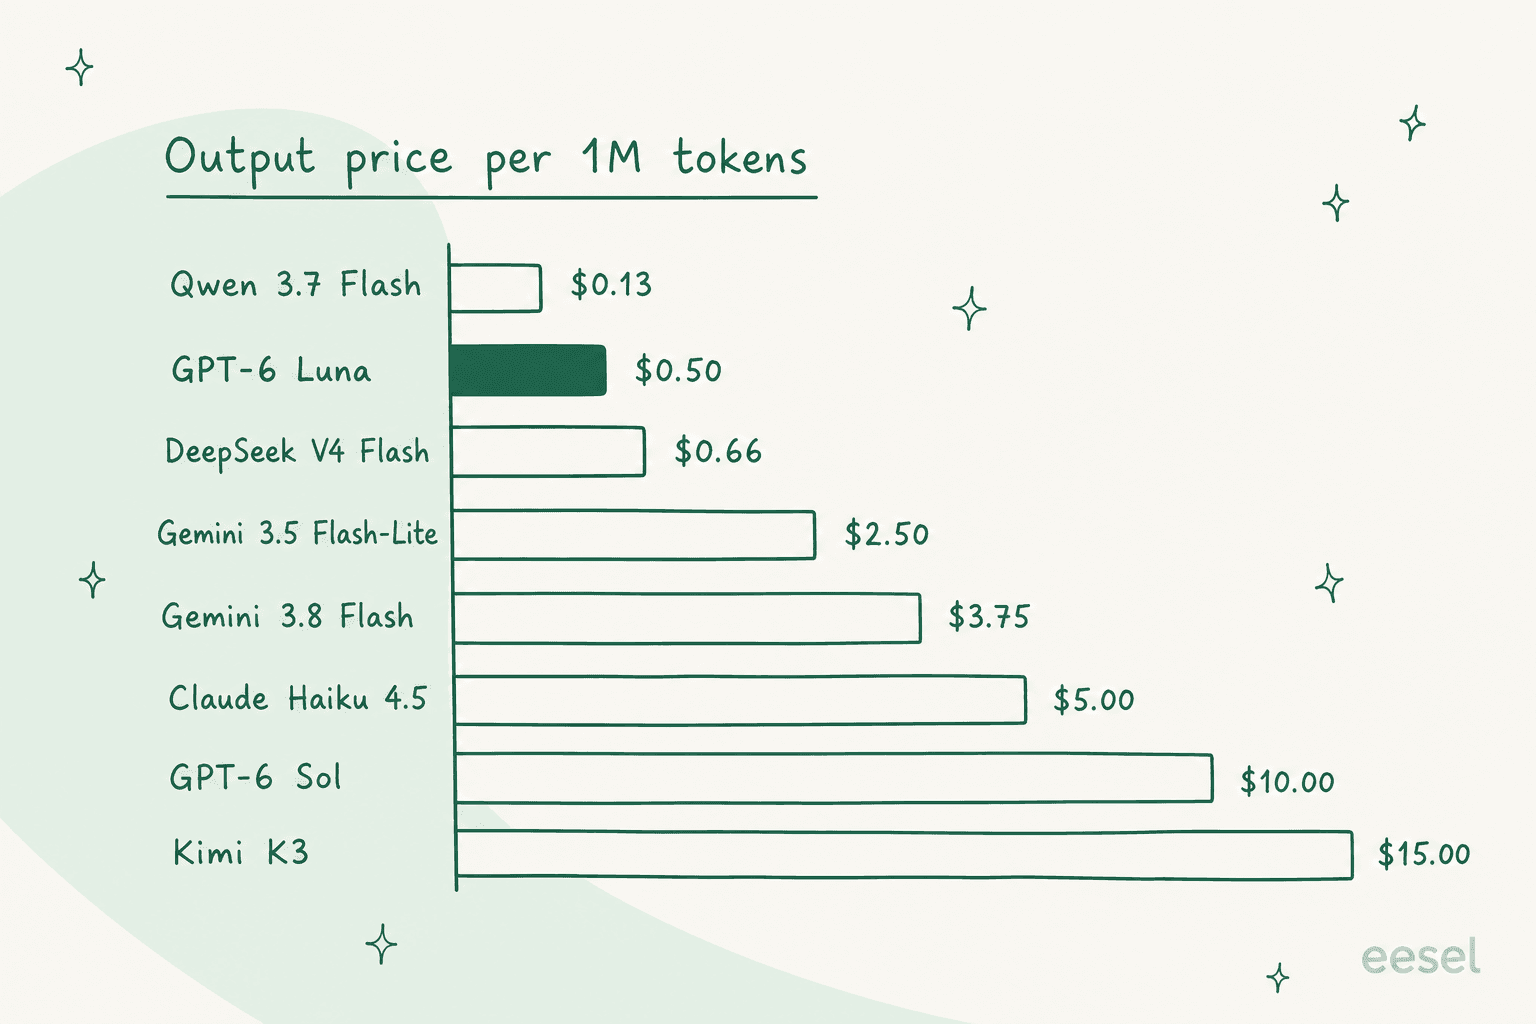
Cómo elegí estas alternativas
Mantuve la lista limitada a modelos que están genuinamente en la categoría de peso de Luna: baratos, rápidos y construidos para trabajo de alto volumen o ligero, no los buques insignia de vanguardia de la lista de modelos de OpenAI a los que recurrirías para escribir código todo el día. No incluí GPT-6 Astra ni Claude Opus aquí, porque un modelo de 20 a 100 veces el precio de salida de Luna no es una "alternativa", es un presupuesto distinto. (Si lo que realmente buscas es un motor de vanguardia, mi repaso de alternativas a GPT-6 Astra es mejor lectura.)
Para cada modelo revisé el precio real por token según la propia tabla de tarifas del proveedor, la ventana de contexto, si los pesos son abiertos, qué puede tomar como entrada, y dónde realmente brilla o falla. Todo lo de abajo tiene precios de fuentes primarias, y donde el precio de un modelo es inusual (tramos, recargos de hora punta/valle, un aumento programado) lo he señalado, porque esas peculiaridades son exactamente lo que convierte a un modelo "más barato" en una factura sorpresa.
Aquí está todo el panorama de un vistazo.
| Modelo | Mejor para | Entrada $/1M | Salida $/1M | Contexto | Pesos abiertos | Entrada de imagen |
|---|---|---|---|---|---|---|
| GPT-6 Luna (titular actual) | La opción equilibrada por defecto | $0.10 | $0.50 | 1.05M | No | Sí |
| Gemini 3.8 Flash | Trabajo multimodal por lotes | $0.75 | $3.75 | 1M | No | Sí |
| Gemini 3.5 Flash-Lite | La multimodal más barata | $0.30 | $2.50 | 1M | No | Sí |
| Claude Haiku 4.5 | Fiabilidad por dólar | $1.00 | $5.00 | 200K | No | Sí |
| DeepSeek V4 Flash | Los pesos abiertos más baratos | $0.22 (off-peak) | $0.66 (off-peak) | 1M | Sí (MIT) | No |
| Qwen 3.7 Flash | La tarifa más baja en prompts pequeños | $0.03-$0.20 | $0.13-$0.80 | 1M | No | Sí |
| Kimi K3 | Peso pesado de pesos abiertos | $3.00 | $15.00 | 1M | Sí | Sí |
| GPT-6 Sol | Quedarse en OpenAI, más margen | $2.00 | $10.00 | 1.05M | No | Sí |
| Grok 4.7 | Bucles de agentes y tiempo real | $2.00 | $6.00 | 500K | No | Sí |
Ahora, los modelos en sí.
1. Gemini 3.8 Flash
Ideal para: equipos que quieren entradas multimodales y un rendimiento enorme para trabajo nocturno no interactivo.
Gemini 3.8 Flash es el modelo Flash más nuevo de Google, y el planteamiento honesto es el que da el propio Google: se construye directamente sobre Gemini 3.7 Flash, no sobre una base nueva. La ficha del modelo lo dice así, con todas las letras, en cuatro secciones distintas. Lo que obtienes por el mismo precio que 3.7 es un modelo que "trabaja más duro", ejecutando pasos de razonamiento adicionales y llamando a herramientas con más frecuencia, lo cual es genial para tareas difíciles y un desperdicio para las fáciles.
Donde claramente supera a Luna es en las entradas: texto, imagen, audio, vídeo y PDF entran todos, frente al texto-e-imagen de Luna. También obtiene un sólido índice de inteligencia de Artificial Analysis de 59, muy por encima de la mediana de su clase.
Ventajas:
- Entradas totalmente multimodales (audio, vídeo, PDF), que Luna no admite.
- Rendimiento bruto genuinamente rápido: 302 tokens/seg., cerca de lo más alto de la tabla de velocidad de Artificial Analysis.
- Un nivel gratuito y una ventana de contexto de 1M de tokens.
Desventajas:
- El dato poco comentado es el tiempo hasta el primer token: Artificial Analysis midió
13.3sfrente a una mediana de clase de unos3s. Eso descalifica a cualquier cosa que un humano esté esperando, como una respuesta de chat, y es irrelevante para un trabajo por lotes nocturno. - El precio se duplica el 1 de enero de 2027, a
$1.50/$7.50. El propio Google dice a los desarrolladores centrados en la eficiencia que se queden con 3.7 Flash.
Precio: $0.75 de entrada / $3.75 de salida por 1M hasta el 31 de diciembre de 2026, y luego exactamente 2x a partir de enero de 2027. Batch y Flex tienen un 50% de descuento. Consulta el desglose completo de precios de Gemini para ver los niveles.
Mi opinión: elige Gemini 3.8 Flash en lugar de Luna cuando necesites darle audio o vídeo y el trabajo no sea interactivo. Para un widget de chat en vivo, esa cifra de tiempo hasta el primer token lo descarta, y yo miraría Flash-Lite o Luna en su lugar.
2. Gemini 3.5 Flash-Lite
Ideal para: la forma más barata de conseguir las entradas multimodales de Google a gran volumen.
Si Gemini 3.8 Flash es el modelo que "trabaja más duro", Flash-Lite es el que quiere "simplemente ser barato y rápido". Es el miembro económico y de alto rendimiento de la línea Gemini 3.5, y es la respuesta más directa de Google a Luna. Toma el mismo conjunto rico de entradas (texto, imagen, vídeo, audio, PDF) y devuelve texto, con una ventana de contexto de aproximadamente 1M de tokens. Vale la pena echar un vistazo al campo más amplio de alternativas a Gemini si quieres más opciones de Google.
La especificación que destaca es la velocidad: Artificial Analysis lo sitúa cerca de la cima del campo en velocidad de salida, alrededor de 490 tokens/seg., un mundo distinto del problema de latencia de 3.8 Flash. El compromiso es la inteligencia: su índice de inteligencia está en 36, así que es un caballo de batalla para clasificación, extracción y enrutamiento, no para tareas que exigen mucho razonamiento.
Ventajas:
- Entradas multimodales a un precio genuinamente bajo.
- Salida muy rápida, lo que lo hace viable para uso interactivo donde 3.8 Flash no lo es.
- Más barato que Claude Haiku 4.5 en ambos medidores, según la propia comparación de Google.
Desventajas:
- Una brecha funcional real que conviene conocer: la página del modelo indica que el uso del ordenador no es compatible, así que no es el modelo con el que construir un agente que maneje el navegador.
- Menor inteligencia bruta que Luna, así que es una herramienta más limitada.
Precio: $0.30 de entrada / $2.50 de salida por 1M (Estándar). Batch y Flex reducen eso a la mitad, a $0.15/$1.25. El nivel gratuito entrena con tu contenido, así que no es apto para datos sensibles.
Mi opinión: este es el Gemini que realmente pondría cara a cara con Luna para trabajo de texto e imagen barato y de alto volumen. Su precio de salida es más alto que el de Luna, pero para cualquier cosa que incluya una imagen, el soporte multimodal y la velocidad pueden justificar la diferencia.
3. Claude Haiku 4.5
Ideal para: equipos que quieren la fiabilidad y la capacidad de seguir instrucciones de la familia Claude a un precio de nivel rápido.
Claude Haiku 4.5 es el modelo pequeño y rápido de Anthropic, y es el más caro del verdadero nivel "económico" aquí, con $1.00/$5.00. Lo que pagas es la reputación de Anthropic por seguir instrucciones con cuidado y una menor tendencia a salirse del carril, lo cual importa mucho cuando la salida del modelo alimenta algo automatizado.
Tiene una ventana de contexto más pequeña que el resto (200K en lugar de 1M), lo cual está bien para la mayoría de las tareas y es una limitación real para quien meta toda una base de código o base de conocimiento en un solo prompt.
Ventajas:
- Capacidad de seguir instrucciones sólida y predecible al estilo Claude.
- Respuestas rápidas, así que funciona para usos interactivos.
- El ecosistema, las herramientas y la documentación de Claude son excelentes.
Desventajas:
- Diez veces la tarifa de salida de Luna, así que en puro volumen es la opción cara de este grupo.
- 200K de contexto es lo más pequeño aquí.
- No tiene pesos abiertos, ni una opción de contexto gigante como los modelos de 1M de tokens.
Precio: $1.00 de entrada / $5.00 de salida por 1M de tokens. Se aplican descuentos de caché de prompts y por lotes, que reducen la tarifa efectiva en cargas de trabajo repetitivas.
Mi opinión: si la fiabilidad es lo que te quita el sueño, y tus prompts caben en 200K, Haiku merece la prima sobre Luna. Si buscas la factura más baja, no es el indicado, y uno de los modelos abiertos chinos de abajo hará el mismo trabajo rutinario por una fracción del coste.
4. DeepSeek V4 Flash
Ideal para: la opción más barata con pesos abiertos que realmente puedes descargar y alojar tú mismo.
DeepSeek V4 Flash es la elección campeona del presupuesto, y en la que más importan las notas al pie sobre precios. Es un modelo de mezcla de expertos con 284B de parámetros totales / 13B activos, publicado bajo una licencia MIT con pesos descargables, así que puedes ejecutarlo en tu propio hardware.
Dos cosas que conviene saber antes de emocionarte con el precio de lista. Primero, es solo de texto, así que no hay entrada de imagen documentada. Segundo, la API de origen usa precios de hora punta y valle: $0.22/$0.66 por 1M fuera de hora punta, subiendo a $0.44/$1.32 en hora punta. Las horas punta son de 01:00 a 10:00 UTC (horario laboral chino), así que una cola de EE. UU. o Europa se factura mayoritariamente a la tarifa valle más barata, lo cual es una peculiaridad simpática y frágil a la vez.
También hay una trampa de coste más sutil que salió directamente en el hilo de lanzamiento de Luna. Un comentarista comparó sus propias facturas de DeepSeek y Luna, y alguien le respondió:
"This isn't right. You're comparing cost per token, but DeepSeek V4 Flash uses more tokens. Artificial Analysis found GPT 6 Luna to be significantly cheaper than DeepSeek."
Esa es toda la categoría en un solo intercambio: DeepSeek es verboso, y un modelo hablador gasta más tokens en terminar el mismo trabajo, así que la tarifa más baja por token no siempre significa una factura más baja.
Ventajas:
- Pesos abiertos MIT, así que puedes alojarlo tú mismo y mantener los datos internos.
- La tarifa por token más baja publicada de cualquier modelo capaz aquí (fuera de hora punta).
- Contexto enorme de 1M de tokens y razonamiento incorporado.
Desventajas:
- Solo texto, sin entrada de imagen documentada.
- La salida verbosa puede borrar el ahorro por token en tareas reales.
- Los términos de la API de pago guardan silencio, sin permitir explícitamente, sobre el uso para entrenamiento, y los datos están sujetos a la ley de la RPC, así que no es apto tal cual para datos de clientes.
Precio: fuera de hora punta $0.22 de entrada / $0.66 de salida, en hora punta $0.44/$1.32, todo por 1M. Los tokens de razonamiento se facturan a la tarifa de salida, y el "thinking" está activado por defecto, así que hay que presupuestarlo.
Mi opinión: si quieres pesos abiertos y el suelo absoluto del coste, DeepSeek V4 Flash es el que hay que probar, pero pruébalo con tus prompts reales y mide el número de tokens, no solo la tarifa. Para datos de clientes, trata la política de entrenamiento "silenciosa" como un motivo para alojarlo tú mismo en lugar de usar la API de origen.
5. Qwen 3.7 Flash
Ideal para: la tarifa de titular más baja en prompts pequeños, si puedes vivir con documentación escasa.
El Qwen 3.7 Flash de Alibaba tiene el número más bajo de toda la tabla, $0.03/$0.13 por 1M, pero hay un asterisco que no puedes pasar por alto: el precio está escalonado según el tamaño del prompt. Esa tarifa barata solo se mantiene por debajo de 32K tokens. Sube a $0.10/$0.40 de 32K a 256K, y a $0.20/$0.80 de 256K a 1M. Así que la tarifa de "modelo de visión más barato" y el "contexto de 1M" no pueden ser ciertos ambos en la misma llamada.
La otra nota honesta es que casi nada de este modelo está verificado de forma independiente. Alibaba no publicó benchmarks, ni arquitectura, ni número de parámetros, y los pesos son cerrados. La única evaluación de terceros, el test de visión de Roboflow, lo clasifica en el puesto 22 de 23 en general, pero en el puesto 1 de 23 en coste. Y "Flash" aquí significa barato, no rápido: corre a unos 59 tokens/seg., mucho más lento que el Flash-Lite de Gemini.
Ventajas:
- La tarifa de entrada por token más baja aquí, en prompts pequeños.
- Acepta entrada de imagen, a diferencia de DeepSeek.
- Contexto de 1M de tokens disponible (en el tramo de precio más alto).
Desventajas:
- El precio escalonado significa que la tarifa barata se evapora en prompts grandes (6,7 veces más en la entrada en el tramo más alto).
- Salida lenta y documentación escasa y no verificada.
- Pesos cerrados, un único proveedor, así que no hay autoalojamiento ni enrutamiento de respaldo.
Precio: tres tramos según el tamaño del prompt, desde $0.03/$0.13 por debajo de 32K hasta $0.20/$0.80 en 256K-1M. Compara con el panorama completo de precios de Qwen antes de decidirte.
Mi opinión: Qwen 3.7 Flash encaja de maravilla en tareas de visión de alto volumen y prompt corto donde el coste lo es todo y puedes validar la calidad tú mismo. Para cualquier cosa que necesite un contexto grande o benchmarks documentados, yo pasaría. Mi artículo sobre alternativas a Qwen tiene la familia Qwen más amplia si quieres más margen.
6. Kimi K3
Ideal para: equipos que quieren un peso pesado genuinamente de pesos abiertos y están dispuestos a pagarlo.
Kimi K3 es la excepción en esta lista, y lo he incluido a propósito. Con $3/$15 por 1M no es barato; está en la misma banda que Claude Sonnet, y es unas 30 veces la tarifa de salida de Luna. Entonces, ¿por qué está aquí? Porque es el modelo de pesos abiertos al que la gente recurre cuando quiere poseer un modelo capaz por completo, y sus pesos realmente salieron en Hugging Face a tiempo.
Es un modelo de mezcla de expertos con 2,8T de parámetros totales / 104B activos, visión nativa, un contexto de 1M de tokens, y un índice de inteligencia de Artificial Analysis de 57, que lo sitúa cerca de la cima de todo el campo, no solo del extremo barato.
Ventajas:
- Pesos abiertos que salieron según lo prometido, verificables en Hugging Face.
- Alta inteligencia, muy por encima del resto de esta lista.
- Visión nativa y un contexto de 1M de tokens.
Desventajas:
- No es un modelo económico. Solo es una alternativa a Luna en el sentido de "abierto y capaz", no en el sentido de "barato".
- El razonamiento no se puede desactivar, y por defecto va al máximo esfuerzo, así que la latencia y el gasto de tokens son altos.
Precio: $3 de entrada / $0.30 de acierto de caché / $15 de salida por 1M. Los niveles de la app de consumo van desde un plan gratuito hasta $199/mes. Mi repaso de alternativas a Kimi K2.5 cubre el campo más amplio de modelos abiertos.
Mi opinión: si lo que realmente querías de "una alternativa a Luna" era un modelo abierto y capaz para autoalojar, Kimi K3 es la elección, y DeepSeek V4 Flash es el primo más barato. Si querías la factura más baja, Kimi es directamente el árbol equivocado.
7. GPT-6 Sol
Ideal para: quedarte dentro de OpenAI cuando a Luna se le acaba el margen.
A veces la mejor alternativa a Luna es el modelo un escalón por encima en la misma familia. GPT-6 Sol es el modelo GPT-6 de nivel medio de OpenAI, a $2/$10, y existe justo para el momento en que las respuestas de Luna dejan de ser suficientemente buenas pero no quieres cambiar de proveedor, SDK ni acuerdos de datos.
El propio planteamiento de OpenAI es "construye con Sol, escala con Luna", y la historia de los benchmarks es honesta: los índices de Inteligencia y Codificación de Sol están más o menos al nivel de GPT-5.6, así que esto es más un recorte de precio que un salto de capacidad, con una victoria real en veracidad (OpenAI informa de aproximadamente la mitad de los errores del Sol anterior).
Ventajas:
- Misma API, herramientas y términos de datos que Luna, así que cambiar es un cambio de una línea.
- Conjunto completo de herramientas de la Responses API: búsqueda web, intérprete de código, shell alojada, uso del ordenador, MCP.
- Considerablemente más capaz que Luna en tareas difíciles, con una gran mejora en veracidad.
Desventajas:
- 20 veces el precio de salida de Luna, así que es un paso hacia arriba en coste, no un ahorro.
- No está en los planes Free ni Go; necesitas Plus, Pro, Business o la API.
Precio: $2 de entrada / $10 de salida por 1M en estándar, con Batch y Flex al 50% de descuento. La página completa de precios de GPT-6 Sol tiene las tarifas de contexto largo y modo rápido.
Mi opinión: Sol no es una alternativa para quien compara por precio, es el camino natural de mejora cuando la calidad de Luna es el cuello de botella. Recurre a él cuando el fallo que intentas resolver es la precisión, no el coste.
8. Grok 4.7
Ideal para: ejecutar bucles de agentes a gran volumen y tareas que quieren datos en tiempo real o de X.
Grok 4.7 de xAI es la más cara de las opciones de nivel medio, con $2/$6, pero está construida para un trabajo específico: tareas agénticas largas de varias horas. Corre sobre un modelo base nuevo y más grande que el 4.6, con una ejecución de aprendizaje por refuerzo más larga y ponderada hacia el trabajo multipaso, y entiende de forma nativa el propio arnés de agentes de xAI.
El argumento de venta es "casi de vanguardia a un precio amigable con el volumen". En las propias tablas de xAI obtiene puntuaciones agénticas y de terminal sólidas, aunque las coronas de mejor codificación y terminal siguen perteneciendo a modelos como Fable 5.1. Es justo señalar que también pierde en algunos benchmarks, como HealthBench, donde tanto GPT-6 Sol como Fable lo superan.
Ventajas:
- Fuerte en tareas agénticas de largo alcance, con una API de compactación de contexto para ejecuciones muy largas.
- Acceso a datos en tiempo real y de X a través de las herramientas de xAI.
- Un modelo capaz al precio de Grok 4.6.
Desventajas:
- La opción de nivel medio más cara aquí, y la tarifa de contexto largo (
$4/$12por encima de 200K tokens de prompt) se aplica a cada token de la solicitud, no solo al excedente. - Contexto de 500K, más pequeño que los modelos de 1M de tokens.
- Los medidores no basados en tokens (búsqueda, ejecución de código) se acumulan en los bucles de agentes.
Precio: $2 de entrada / $6 de salida por debajo de 200K tokens de prompt, $4/$12 por encima, todo por 1M. Las llamadas a herramientas se facturan por separado, por ejemplo, búsqueda web y de X a $5/1.000 llamadas.
Mi opinión: Grok 4.7 no es realmente un competidor de Luna para tareas de texto baratas. Es la elección cuando el trabajo es una ejecución agéntica larga, especialmente una que necesite datos en vivo. Para resumir o clasificar de forma simple y de alto volumen, es excesivo y sobreprecio frente a Luna.
Las dos preguntas que realmente lo deciden
Si quitas los nombres de los modelos, toda esta comparación se reduce a dos preguntas.
La primera es abierto o cerrado. La mayoría de estos son modelos cerrados, solo accesibles por API. Si el autoalojamiento es un requisito estricto, tu lista corta se reduce rápido.
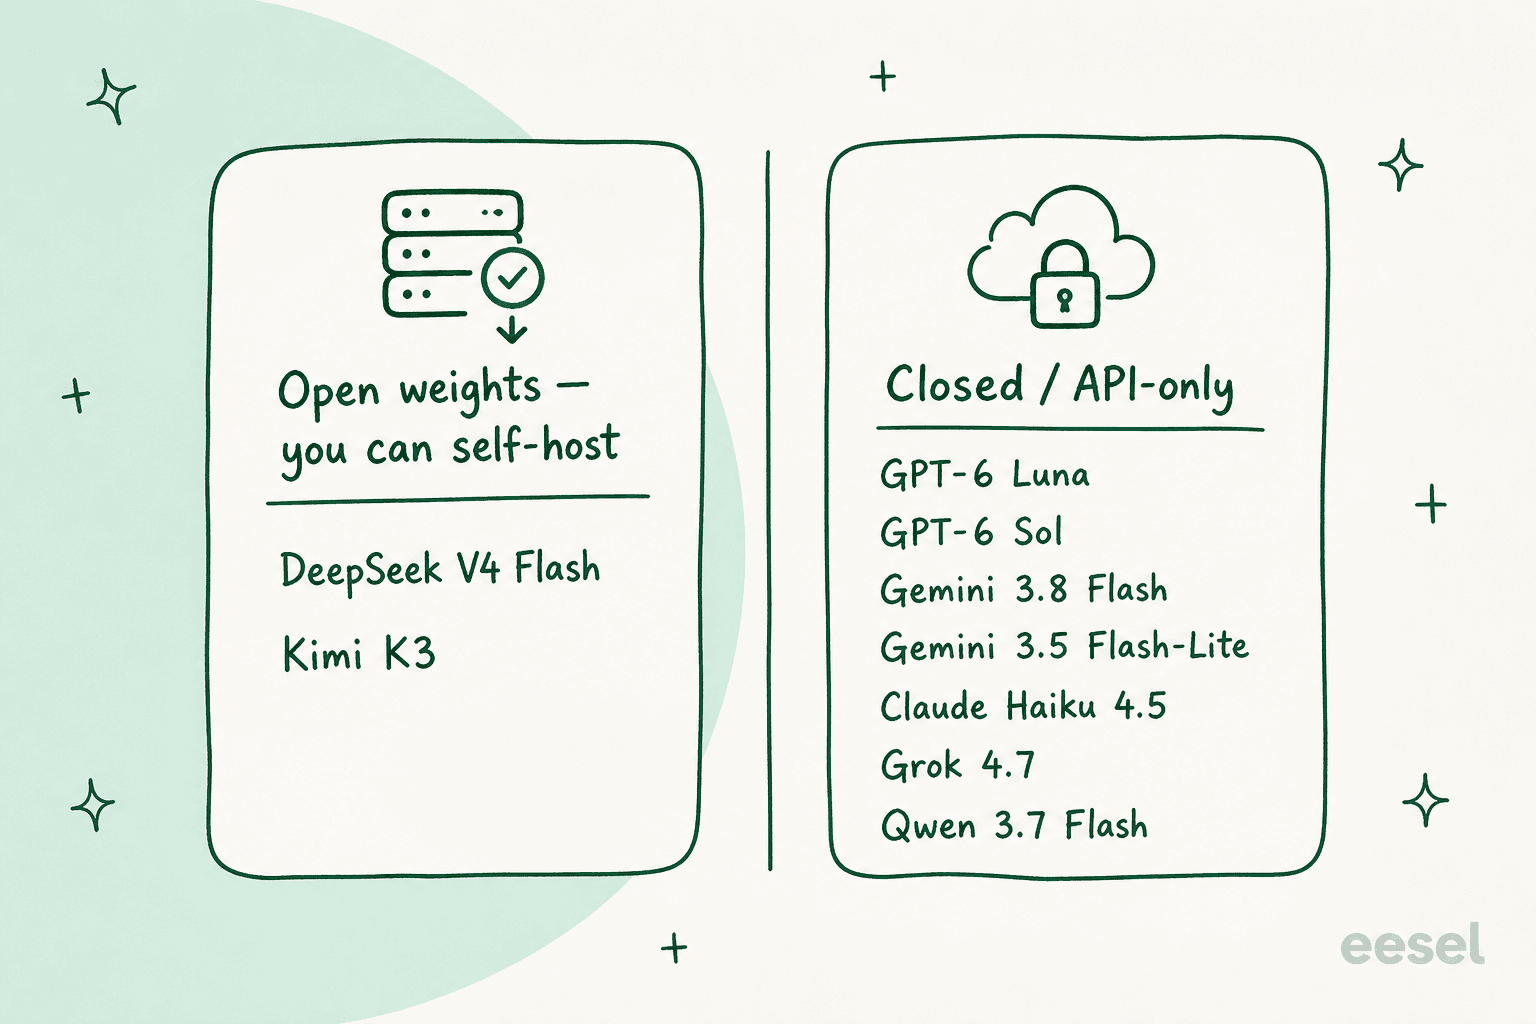
Este mismo compromiso aparece siempre que comparas los mejores agentes de IA: la licencia decide tu arquitectura antes que los benchmarks. La segunda pregunta es la que hace tropezar a toda hoja de cálculo: lo más barato por token no es lo más barato por tarea. Un modelo que cotiza a un tercio del precio de Luna pero escribe el doble de tokens para terminar el mismo trabajo no te está ahorrando nada. La única forma de saberlo es pasar tus prompts reales por dos o tres candidatos y comparar la factura real, no la tabla de tarifas. Por eso también la suscripción de ChatGPT puede superar silenciosamente todas estas tarifas de API para uso individual, ya que una cuota mensual plana evita por completo el precio por token.
La parte que el modelo no resuelve
Esto es lo que me gustaría escuchar si fuera yo quien leyera esto. Si estás eligiendo un modelo barato para impulsar un trabajo real y recurrente, y para la mayoría de los equipos que leen un artículo como este ese trabajo es la atención al cliente, entonces elegir el modelo es el 10% fácil del trabajo.
He pasado los últimos años viendo a equipos poner IA en colas de soporte en vivo, y el patrón es siempre el mismo. El modelo en bruto es tokens que entran, texto que sale. Antes de que pueda responder con seguridad a un cliente, alguien todavía tiene que construir la recuperación de información para que conozca tu centro de ayuda, las barreras de seguridad para que no invente con confianza una política de reembolsos, las integraciones para que pueda buscar un pedido, las pruebas para que descubras cómo se comporta antes de que lo haga un cliente, y la ruta de escalado para cuando deba pasar la conversación a un humano. Un copiloto de IA para atención al cliente tiene que resolver cada uno de estos puntos. Eso es el 90%.
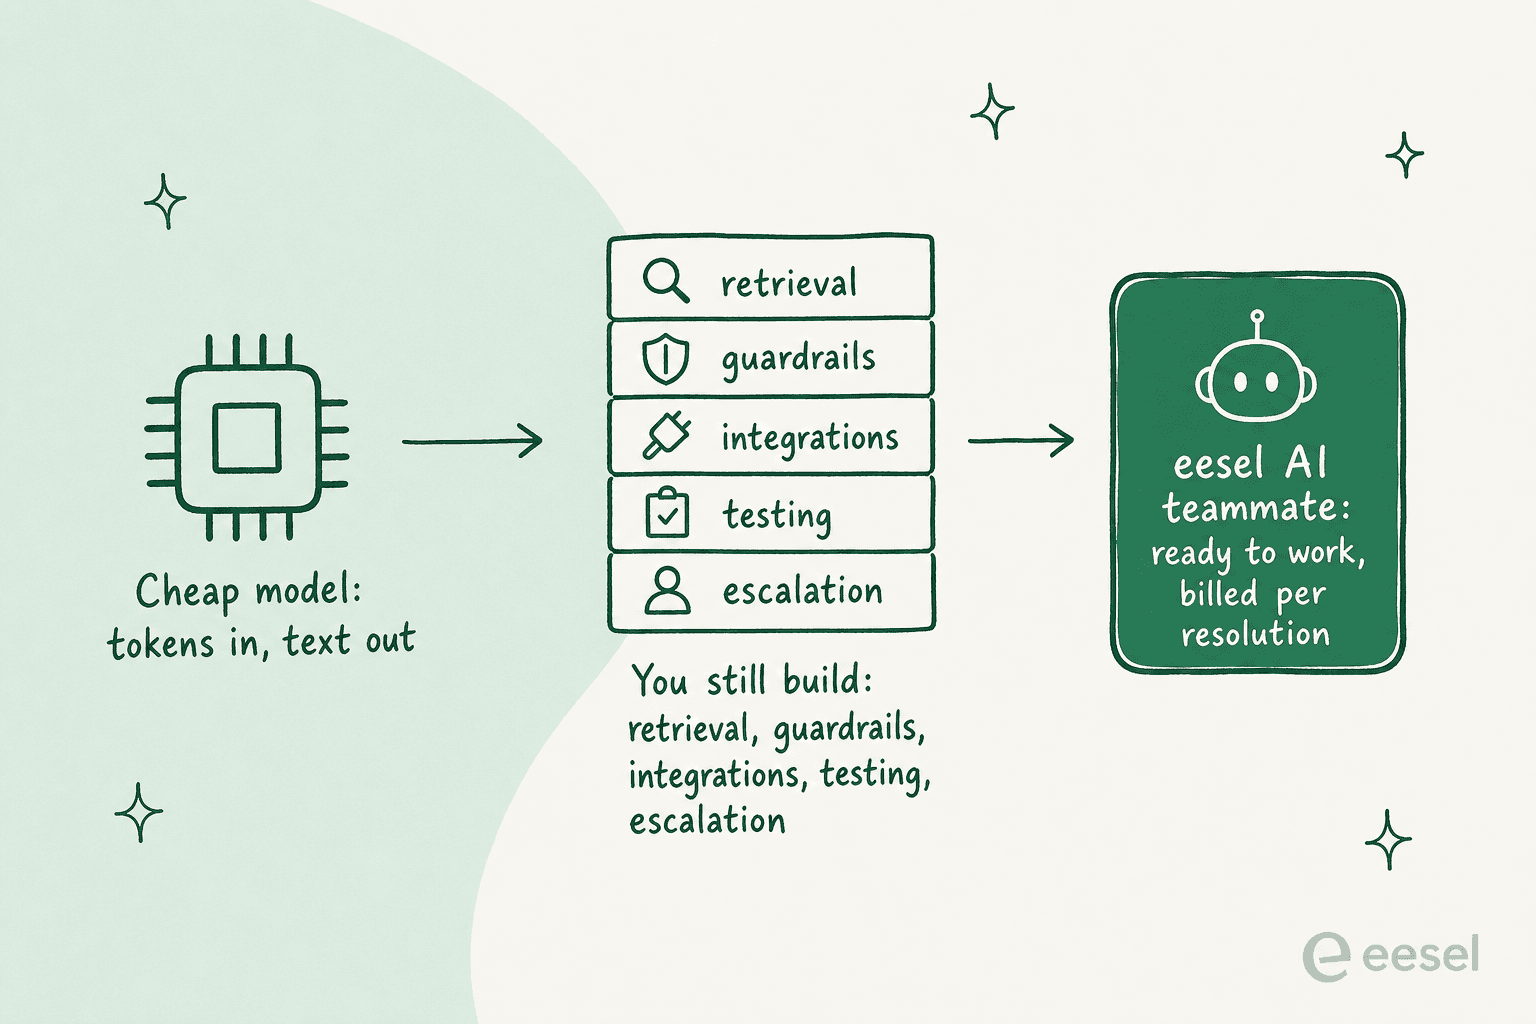
El error más caro que veo es un equipo que lanza un modelo barato directamente a la cola, lo ve dar una respuesta equivocada con confianza a un cliente real, y solo entonces sale a buscar el 90% que falta. Por eso, todo despliegue en el que confiaría se simula primero contra tickets históricos, para que veas las respuestas equivocadas antes de que lleguen jamás a una persona.
Prueba eesel AI
Aquí es donde puedo ser directo sobre lo que construyo. Los modelos de arriba son infraestructura. eesel AI es el empleado que corre encima de ellos. En lugar de venderte un modelo y un montón de piezas, entregamos compañeros de equipo de IA listos para trabajar para tareas específicas, y el que la mayoría de quienes leen esto quiere es el compañero de equipo de IA para el helpdesk.

Se une a tu cola existente, aprende de tus tickets pasados y tu centro de ayuda, y se factura por resolución, así que pagas por trabajos hechos en lugar de por tokens quemados. Y como puedes simularlo contra tus propios tickets históricos antes de que toque una cola en vivo, puedes ver exactamente cómo habría manejado a clientes reales primero.
Si prefieres manejar todo esto desde una terminal o un script, también está la CLI de eesel. Es una forma amigable para agentes de operar el mismo compañero de equipo y espacio de trabajo: una persona puede ejecutarla a mano, los scripts pueden automatizarla, y agentes de codificación como Claude Code, Codex y Cursor pueden manejarla directamente. Puedes conectar una fuente, enviar instrucciones, iniciar una simulación, disparar una ejecución y leer la actividad, todo sin abrir el panel. Si el motivo por el que comparas APIs de modelos en bruto es que quieres control programático y sin interfaz, esa es la superficie construida para ello, apoyada sobre un compañero de equipo que ya se encarga del 90% que el modelo no resuelve.
Puedes probar eesel AI gratis, y si el soporte es el trabajo, ese es un camino mucho más corto que conectar tú mismo un modelo barato.
Preguntas frecuentes
¿Cuáles son las mejores alternativas a GPT-6 Luna en 2026?
¿Hay alguna alternativa más barata a GPT-6 Luna?
¿Cuál es el modelo GPT-6 más barato?
¿Qué alternativa a GPT-6 Luna es mejor para atención al cliente?
¿Tienen pesos abiertos las alternativas a GPT-6 Luna?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.