Por qué mirar más allá de GPT-6 Sol
Déjame ser justo con Sol primero, porque se lo ha ganado. Se lanzó el 23 de septiembre de 2026 como el nivel medio de la familia GPT-6, entre GPT-6 Luna y el buque insignia GPT-6 Astra. El mensaje de OpenAI es simple y honesto: la misma inteligencia general que GPT-5.6 Sol, más o menos la mitad de errores factuales, a la mitad del precio de la API. Tiene una ventana de contexto de 1.050.000 tokens, búsqueda web, intérprete de código, una shell alojada, uso del ordenador y soporte de MCP integrado. Para la mayoría del chat cotidiano, la extracción y la redacción, te da una respuesta muy buena a un precio razonable.
Entonces, ¿por qué alguien busca alternativas? Aparecen unas cuantas razones concretas una y otra vez.
Primero, el precio a gran volumen. Los 2 $ de entrada y 10 $ de salida por millón de tokens de Sol están en la media, no son baratos. Cuando ejecutas un modelo dentro de un bucle de agente que lo llama miles de veces al día, el precio de salida es el número que decide tu factura, y varios modelos de más abajo cobran una fracción de los 10 $ de Sol.
Segundo, está atado a OpenAI. Sol tiene pesos cerrados y, en la API, no está en ningún nivel gratuito, así que el Tier 1 es tu mínimo. Si tu historia de cumplimiento normativo requiere autoalojamiento, o simplemente quieres evitar el riesgo de depender de un solo proveedor, Sol no te ayuda ahí.
Tercero, es un lanzamiento de valor, no un salto de capacidad. En inteligencia general está más o menos al nivel del modelo que reemplaza. Si de verdad necesitas un modelo más inteligente para programación difícil o trabajo de agentes de largo alcance, tienes que mirar más arriba en la gama, no hacia los lados.
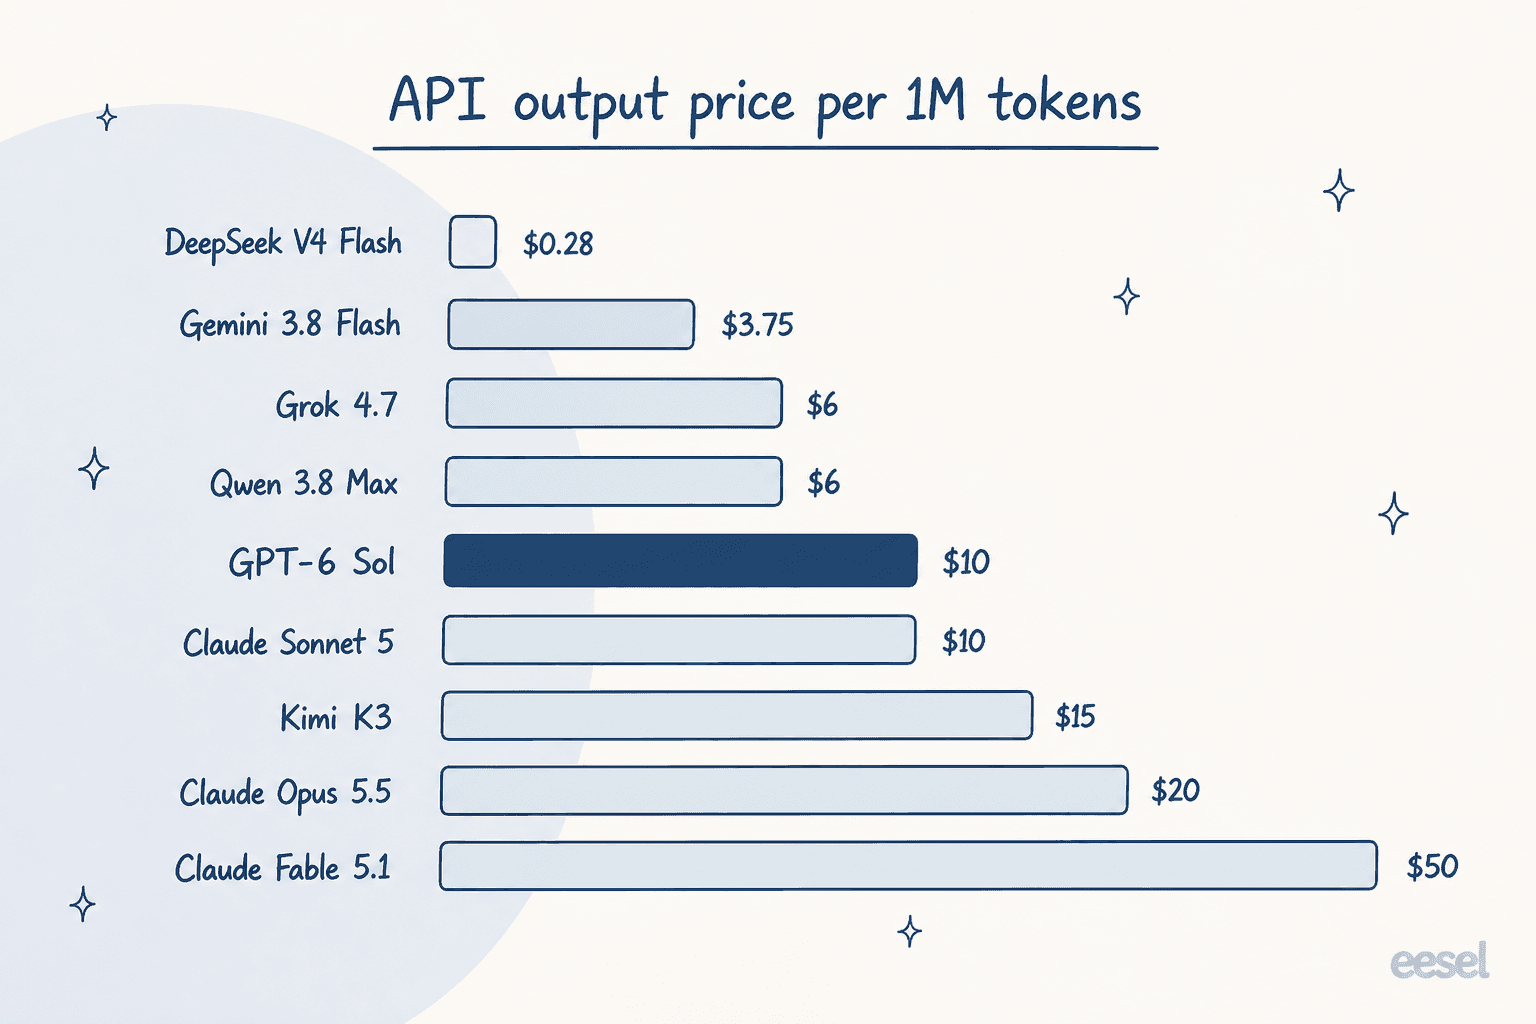
Esa diferencia en el precio de salida es toda la historia en una sola imagen. Los 10 $ de Sol están justo en el medio, con modelos económicos un orden de magnitud más baratos por un lado y modelos de frontera cinco veces más caros por el otro. Hacia qué lado te muevas depende por completo del trabajo.
Cómo elegí estas alternativas
Limité la lista a modelos que son reales, están disponibles de forma general y que un equipo podría realmente poner en producción hoy. Sopesé cuatro cosas:
- Precio, con honestidad. Tarifas reales de entrada y salida por millón de tokens, más las trampas (recargos por contexto largo, precios de caché, tarifas promocionales que caducan).
- Capacidad por el dinero. Dónde se sitúa el modelo en benchmarks públicos y mediciones independientes como Artificial Analysis, no solo en el gráfico propio del proveedor.
- Apertura. Solo API cerrada, o pesos abiertos que puedas descargar y alojar.
- Ajuste al trabajo. Caballo de batalla equilibrado, techo de frontera, presupuesto y velocidad, o autoalojamiento. Nadie necesita ocho modelos; necesita el adecuado para su situación.
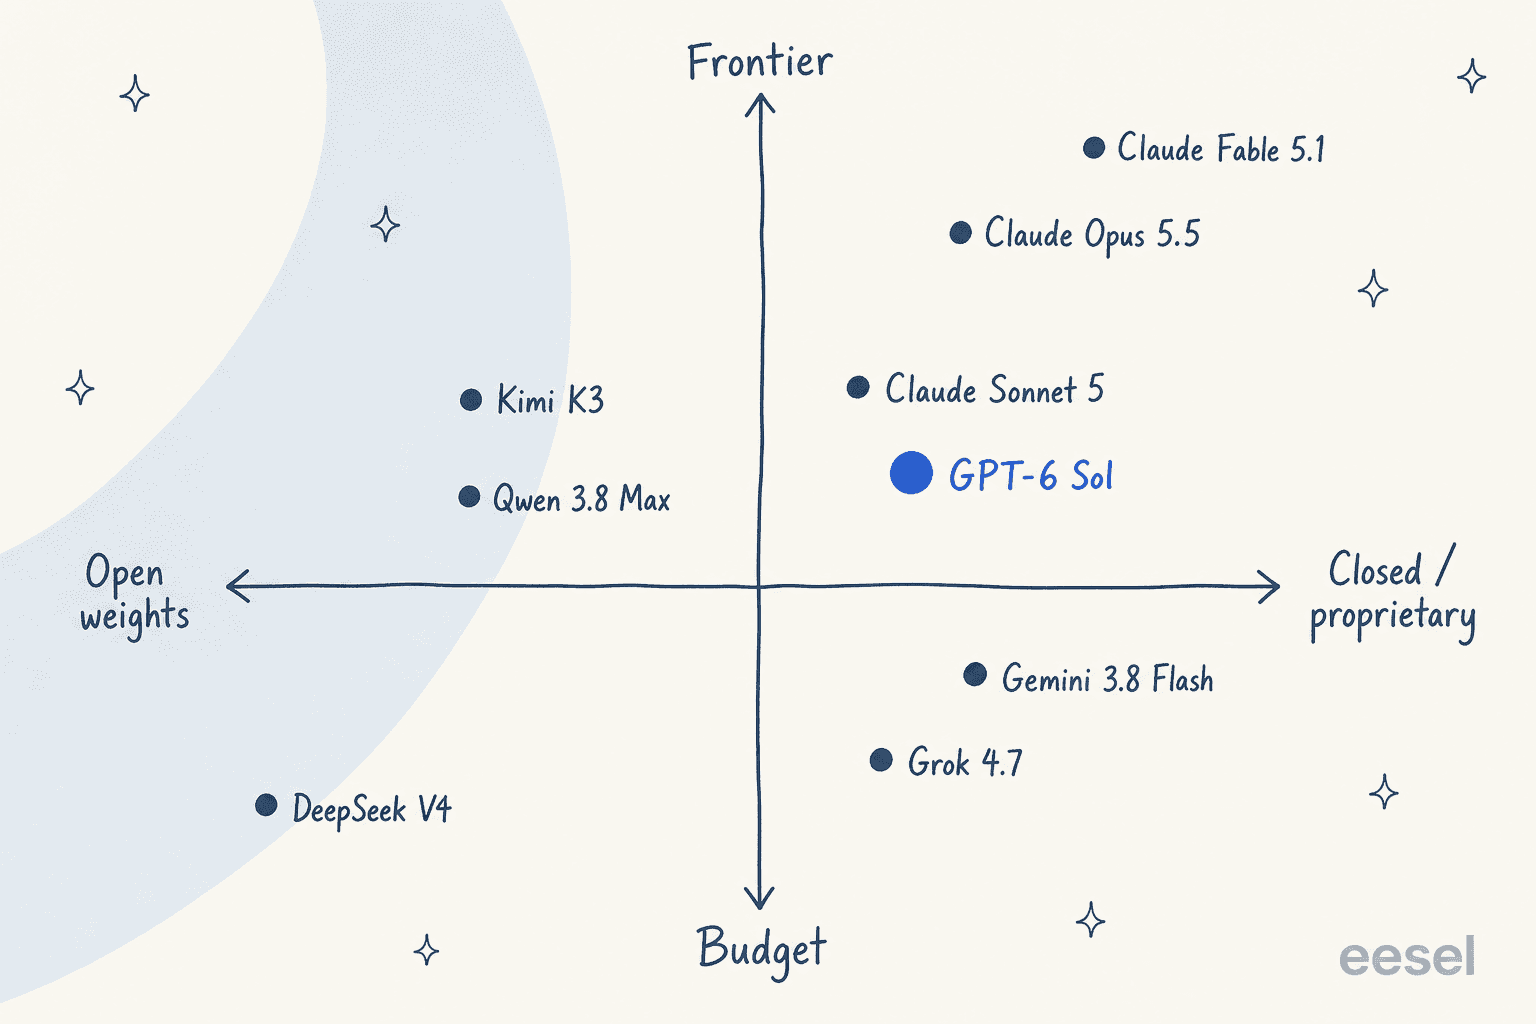
Aquí está todo el panorama de un vistazo antes de revisarlos uno por uno.
| Modelo | Mejor para | Precio de API (entrada / salida por 1M) | Contexto | Pesos |
|---|---|---|---|---|
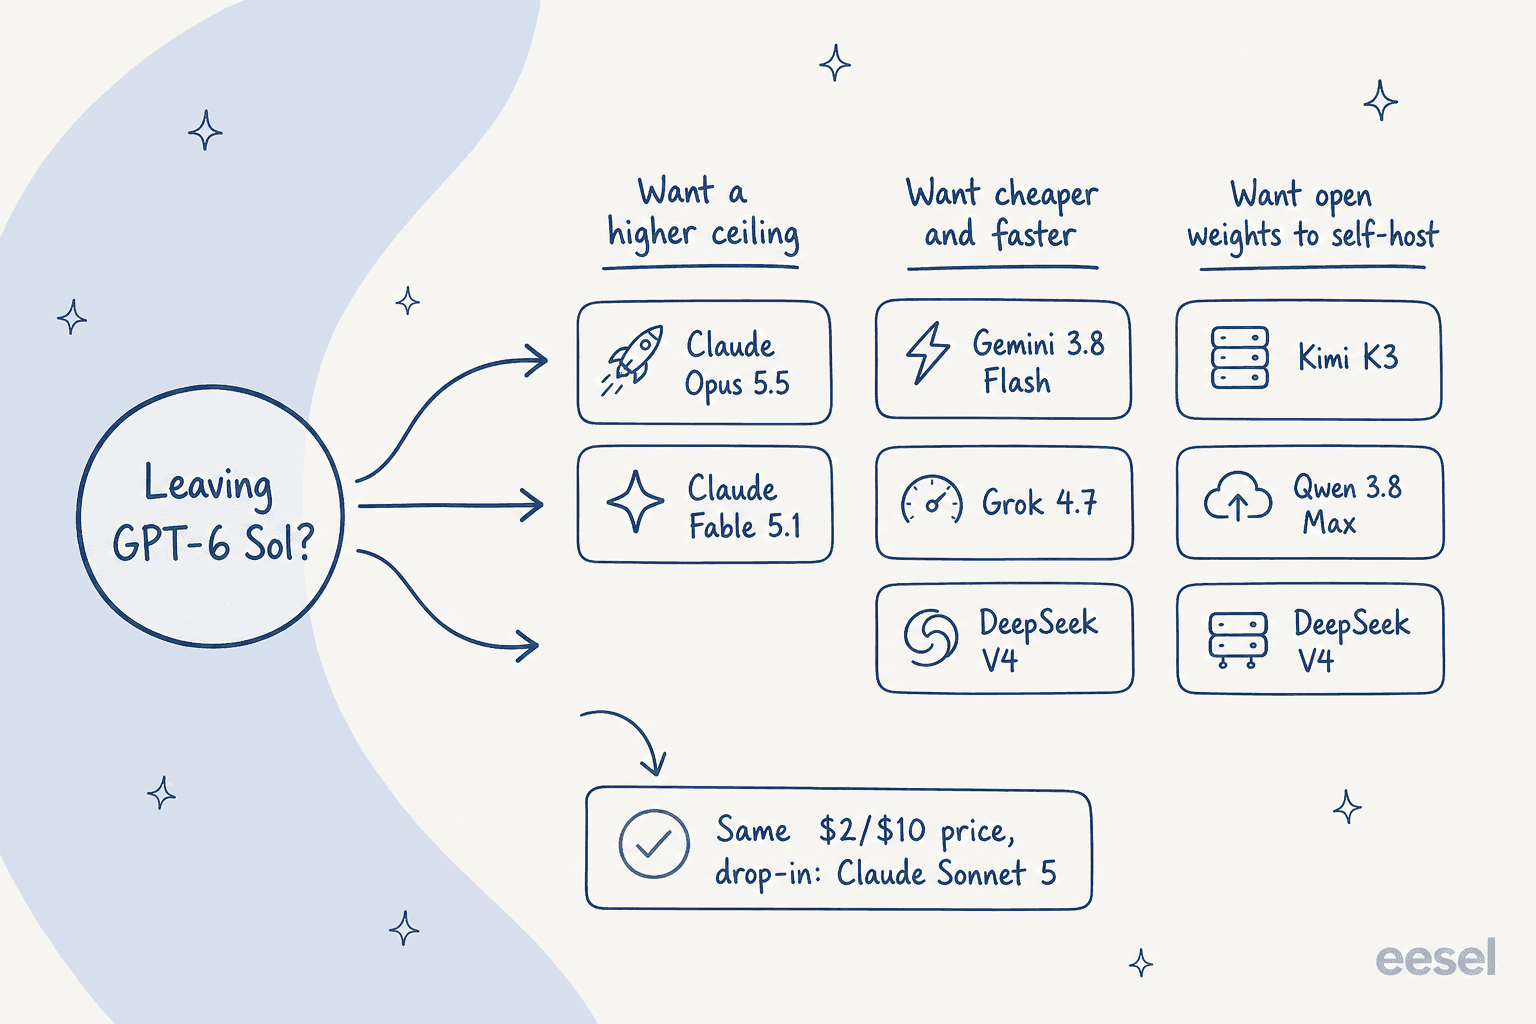
| Claude Sonnet 5 | Cambio directo al mismo precio | $2 / $10 | 1M | Cerrado |
| Claude Opus 5.5 | Un techo más alto, ajustable por esfuerzo | $4 / $20 | 1M | Cerrado |
| Google Gemini 3.8 Flash | La opción rápida más barata a gran escala | $0.75 / $3.75 | 1M | Cerrado |
| Grok 4.7 | Salida más barata en bucles de agentes | $2 / $6 | 500K | Cerrado |
| Kimi K3 | Buque insignia de pesos abiertos | $3 / $15 | 1M | Abierto |
| DeepSeek V4 | Presupuesto mínimo + autoalojamiento | $0.14 / $0.28 (Flash) | ~1M | Abierto |
| Qwen 3.8 Max | Ecosistema abierto, multilingüe | $2 / $6 | 1M | Abierto (base) |
| Claude Fable 5.1 | Techo de frontera para trabajo difícil | $10 / $50 | 1M | Cerrado |
Una nota rápida sobre esa pregunta de «el más inteligente», porque surge de inmediato. En la instantánea del Artificial Analysis Intelligence Index tomada el día en que se lanzaron tanto Sol como Opus 5.5, Opus 5.5 se situó en 58 (primer puesto de 212 modelos) frente al 48 de Sol. Esa es una diferencia real. Pero AA reescala su índice periódicamente, así que he evitado pegar un único número de índice junto a cada modelo aquí; comparar una puntuación de la instantánea de una semana con la de otra es exactamente cómo la gente acaba publicando disparates sin querer. Donde cito un benchmark más abajo, es sobre una base en la que confío.
1. Claude Sonnet 5: el reemplazo al mismo precio
Ideal para: equipos que quieren un caballo de batalla equilibrado al precio exacto de Sol, sin quedar atados a OpenAI.
Si Sol es el modelo equilibrado del día a día, Claude Sonnet 5 es el mismo puesto desde el otro gran laboratorio. Y el precio no solo es parecido, es idéntico: 2 $ de entrada y 10 $ de salida por millón de tokens, con lecturas de caché a 0,20 $. Ese 2 $/10 $ fue brevemente una tarifa de lanzamiento que estaba programada para subir a 3 $/15 $, pero Anthropic canceló el aumento en agosto de 2026, así que ahora es el precio estándar permanente, no una promoción que va a caducar.
Lo que obtienes por el mismo dinero es un conjunto distinto de puntos fuertes. Sonnet 5 tiene una ventana de contexto de 1M de tokens y fama de prosa larga más limpia y sesiones de programación largas más estables. Donde se queda atrás es en la actualidad del conocimiento: su fecha límite de entrenamiento es enero de 2026, más antigua que la de Sol, y Anthropic ha publicado menos cifras de benchmarks cara a cara en texto plano que OpenAI.
A favor: precio idéntico de 2 $/10 $; escritura y programación sólidas; contexto de 1M; una cobertura de segundo proveedor frente al riesgo de depender solo de OpenAI.
En contra: fecha límite de conocimiento más antigua; menos benchmarks publicados para verificar; sin nivel gratuito integrado en la API.
Mi opinión: si la única razón por la que sigues con Sol es «era la opción por defecto sensata», Sonnet 5 es la primera alternativa que probar, porque cambiar no te cuesta nada en precio y te compra opcionalidad. Elígelo si valoras la calidad de la prosa o quieres evitar depender de un solo proveedor; quédate con Sol si dependes mucho del ecosistema de herramientas de OpenAI.
2. Claude Opus 5.5: un salto real en el techo
Ideal para: equipos que necesitan más capacidad en bruto que Sol y están dispuestos a ajustar el esfuerzo para controlar el costo.
Opus 5.5 es el interesante, porque la lectura ingenua se equivoca. Sobre el papel cuesta más que Sol: 4 $ de entrada, 20 $ de salida por millón, el doble de la tarifa por token de Sol. También encabezó ese índice de Artificial Analysis del día del lanzamiento con 58 frente al 48 de Sol. Así que es más inteligente y más caro, y uno asumiría que las cuentas por tarea siguen la etiqueta de precio.
No es así, y esta es la parte no obvia que vale la pena interiorizar. Como ajustas Opus 5.5 según el esfuerzo de razonamiento, el costo ajustado por esfuerzo puede invertir la comparación. En el enfrentamiento directo, Opus 5.5 con esfuerzo medio obtuvo 51 puntos por unos 1,34 $ por tarea, superando a Sol con esfuerzo máximo, que obtuvo 48 por 1,06 $, con un margen de calidad amplio por una pequeña prima de costo. En la cima absoluta, Sol es mucho más barato por tarea (1,06 $ frente a los 5,98 $ de Opus al máximo), porque Opus consume muchos más tokens de salida. La duración de la tarea y el esfuerzo son la bisagra, no el nombre del modelo.
Opus 5.5 es además el primer Opus de Anthropic que se vuelve más barato que su predecesor, un recorte del 20 %, y Anthropic ahora recomienda empezar con él para la mayoría del trabajo. La lectura de la comunidad es más mixta en cuanto a la verbosidad:
writes like gemini, a drastic improvement over the opus 5.1 claudeisms

A favor: salto de capacidad claro sobre Sol; el regulador de esfuerzo te permite comprar calidad barata en tareas más cortas; recorte de precio del 20 % sobre Opus 5; fecha límite de junio de 2026.
En contra: caro por tarea con esfuerzo máximo; todavía puede ser verboso; excesivo para extracción simple o chat.
Mi opinión: elige Opus 5.5 cuando las respuestas de Sol no sean del todo suficientes y realmente vayas a ajustar el nivel de esfuerzo. Si de todos modos vas a ejecutarlo todo al máximo y nunca tocas el regulador, pagarás por una capacidad que no usas.
3. Google Gemini 3.8 Flash: el barato y rápido
Ideal para: cargas de trabajo de alto volumen donde el costo y el rendimiento superan a todo lo demás.
Si tu cuello de botella es el presupuesto, Gemini 3.8 Flash es el movimiento obvio. Cuesta 0,75 $ de entrada y 3,75 $ de salida por millón hasta el 31 de diciembre de 2026, y luego exactamente el doble a partir del 1 de enero de 2027 (1,50 $/7,50 $). Incluso a la tarifa de 2027 sigue por debajo del precio de salida de Sol. Tiene una ventana de entrada de 1M de tokens, un nivel gratuito, y en Artificial Analysis ocupa el tercer puesto de 196 modelos en velocidad de salida en bruto.
Dos advertencias honestas. Primero, no es un modelo base nuevo; la propia ficha del modelo de Google dice hasta cuatro veces que «está basado en Gemini 3.7 Flash», y Google literalmente le dice a los desarrolladores enfocados en eficiencia que se queden en 3.7. Segundo, el rendimiento no es lo mismo que la capacidad de respuesta: AA midió su tiempo hasta el primer token en 13,3 segundos frente a una mediana de la clase de 3 segundos. Eso está bien para un trabajo por lotes nocturno y es un problema real para cualquier cosa que un humano esté esperando, como una respuesta de chat en vivo.
A favor: la opción rápida más barata aquí; contexto enorme; nivel gratuito; rendimiento excelente.
En contra: latencia lenta del primer token; no es un modelo genuinamente nuevo; puede ser verboso y gastar tokens extra.
Mi opinión: recurre a Gemini 3.8 Flash para trabajos grandes por lotes y en segundo plano donde domina el costo por token. Para cualquier cosa sensible a la latencia, su primer token lento lo descalifica, y yo miraría a Grok o Sonnet en su lugar.
4. Grok 4.7: salida más barata para bucles de agentes
Ideal para: cargas de trabajo agénticas que llaman al modelo constantemente y les importa el precio de salida.
Grok 4.7 de xAI llegó el 21 de septiembre de 2026 e iguala a Sol en entrada (2 $) mientras lo supera en salida: 6 $ por millón frente a los 10 $ de Sol, por debajo de un prompt de 200K tokens. Está construido sobre un modelo base nuevo y más grande que Grok 4.6, con una ejecución de aprendizaje por refuerzo más larga y orientada a tareas agénticas de varias horas, y muestra un salto real en benchmarks de agentes, casi duplicando su puntuación en Terminal-Bench 4.0 frente a 4.6.
Vigila dos cosas. El precio por contexto largo es una trampa que merece leerse dos veces: por encima de 200K tokens de prompt, la tarifa salta a 4 $/12 $ y se aplica a todos los tokens de la solicitud, no solo al excedente. Y en algunas evaluaciones Grok 4.7 realmente pierde frente a Sol; en HealthBench Professional obtiene 56,7 frente al 60,5 de Sol, así que no es una victoria limpia en todas partes.
A favor: salida más barata que Sol; gran mejora agéntica sobre 4.6; pila de seguridad sólida; contexto de 500K.
En contra: un precipicio de precios por contexto largo que castiga; pierde frente a Sol en algunos dominios; la variante «Fast» es solo para Cursor y Grok Build, no para la API pública.
Mi opinión: Grok 4.7 tiene un precio pensado para ejecutarse a gran volumen en bucles de agentes, y ahí es exactamente donde lo usaría. Solo mantén las solicitudes por debajo del límite de 200K tokens, o la tarifa de contexto largo borrará el ahorro.
5. Kimi K3: el buque insignia de pesos abiertos
Ideal para: equipos que quieren un modelo de clase frontera que realmente puedan descargar.
Kimi K3 de Moonshot AI destaca si la apertura importa. Es un modelo de mezcla de expertos de 2,8 billones de parámetros (104 mil millones activos), con contexto de 1M de tokens, y, fundamentalmente, los pesos se publicaron a tiempo en Hugging Face, donde el índice de safetensors confirma el recuento completo de 2,8 billones desde fuera del comunicado de prensa. Puedes ejecutarlo tú mismo.
En la API alojada cuesta 3 $ de entrada y 15 $ de salida por millón, la misma franja que Claude Sonnet, así que esto no es la ganga que fue K2; el valor está en los pesos abiertos, no en la tarifa de la API. En benchmarks supera a la generación anterior de modelos de frontera y queda por detrás de la clase alta actual, como Fable 5.1 y GPT-5.6 Sol. Una peculiaridad que hay que conocer: el razonamiento no se puede desactivar en ningún nivel, así que su configuración más barata es un control de latencia, no un verdadero nivel de costo.
A favor: pesos genuinamente abiertos, verificados en Hugging Face; calidad cercana a la frontera; contexto de 1M; visión nativa.
En contra: el precio de la API es de nivel medio, no barato; el razonamiento siempre está activo; no se aceptan URLs de imágenes públicas (solo base64).
Mi opinión: si tu razón para dejar Sol es que es cerrado, Kimi K3 es el buque insignia de pesos abiertos más fuerte para autoalojar. Si solo quieres una API alojada más barata, sus 3 $/15 $ no son la respuesta, y yo miraría a DeepSeek en su lugar.
6. DeepSeek V4: el rey del presupuesto que puedes alojar
Ideal para: la opción por token absolutamente más barata, con el bono de pesos abiertos.
DeepSeek V4 es donde el gráfico de precios se desploma. El nivel Flash cuesta 0,14 $ de entrada y 0,28 $ de salida por millón, aproximadamente una treintaicincoava parte del precio de salida de Sol, con pesos abiertos incluidos. Hay un giro genuinamente extraño que vale la pena conocer: tras un reentrenamiento a finales de julio, el económico nivel Flash actualmente supera al más caro nivel Pro en los nueve benchmarks agénticos que publica DeepSeek, y Artificial Analysis tiene a Flash por delante de Pro en su propio índice. El nivel caro es simplemente la versión más antigua en este momento.
Donde Pro todavía se gana el sueldo es en la recuperación y la búsqueda de agujas en contexto largo, en cosas como SimpleQA-Verified y recuperación de 1M de tokens. Y una advertencia justa: en la clasificación de preferencia humana de LMArena, Pro sigue por delante de Flash, así que el índice automatizado y los votantes humanos no están de acuerdo. Lee ambos antes de comprometerte.
A favor: con diferencia lo más barato aquí; pesos abiertos; Flash pega muy por encima de su precio.
En contra: la nomenclatura de los niveles es genuinamente confusa ahora mismo; el razonamiento de Pro no se puede bajar de forma barata; ecosistema más pequeño que el de los grandes laboratorios.
Mi opinión: para trabajo de alto volumen y sensible al costo, DeepSeek V4 Flash es imbatible en precio y sorprendentemente capaz. Empieza con Flash, no con Pro, a pesar de los nombres, y haz benchmarks con tu propia tarea antes de asumir que el nivel barato es peor.
7. Qwen 3.8 Max: la apuesta por el ecosistema abierto
Ideal para: equipos que quieren una base abierta, un rendimiento multilingüe sólido y una gran nube detrás.
Qwen 3.8 Max de Alibaba se hizo disponible de forma general el 2 de agosto de 2026. Es un modelo de mezcla de expertos de 2,4 billones de parámetros (95 mil millones activos) con contexto de 1M, con un precio de 2 $ de entrada y 6 $ de salida por millón, igualando a Sol en entrada y superándolo en salida. En LMArena es fuerte: quinto en el tablero de Texto y segundo en Visión en el momento de la comprobación.
La historia de la apertura tiene un asterisco. Los pesos base sí se publicaron como Qwen3.8-2.4T-A95B, pero bajo una licencia personalizada qwen3.8-max, no Apache 2.0, y la base abierta no es equivalente en funciones al Max alojado (que añade visión, modo sin razonamiento y herramientas integradas). Si quieres un Qwen con licencia permisiva, el más pequeño Qwen3.8-27B es el de Apache 2.0. Así que lee la licencia antes de construir sobre él.
A favor: salida más barata que Sol; fuerte en LMArena, especialmente en visión y multilingüe; pesos base abiertos disponibles.
En contra: la licencia de Max es personalizada, no Apache; a la base abierta le faltan las funciones alojadas; las clasificaciones automatizadas y humanas apuntan en direcciones distintas.
Mi opinión: Qwen 3.8 Max es una buena elección si quieres vivir en un ecosistema abierto y valoras el trabajo multilingüe y de visión. Solo no asumas que «abierto» significa «reemplazo con licencia Apache para el Max alojado», porque no lo es.
8. Claude Fable 5.1: el techo de frontera
Ideal para: el trabajo de programación más difícil y el trabajo de agentes de largo alcance, donde la calidad supera al costo sin rodeos.
Cuando Sol no es lo bastante inteligente y el regulador de esfuerzo de Opus 5.5 todavía no basta, Fable 5.1 es la cima de la familia Claude 5 de Anthropic. Es caro, 10 $ de entrada y 50 $ de salida por millón, cinco veces el precio de salida de Sol, y no finge lo contrario. Lo que compras es el techo: lidera el grupo en Terminal-Bench-Science (52,6 %), CursorBench (73,4 %) y HLE-with-tools (65 %), y encabezó la propia tabla Elo de GDPval del equipo de Grok por delante de todos los rivales que listaron.
Las ejecuciones del mundo real son la parte que se queda grabada: Anthropic cita una sesión de agente sin supervisión de 38 horas en Ramp, y un equipo de investigación que resolvió un problema de años. El único cambio que suaviza el precio es el recorte de las lecturas de caché a 0,25 $ por millón, más barato por token en caché que Opus 5.5. Vale la pena saber antes de construir con él: Fable 5.1 eliminó el uso forzado de herramientas (tool_choice any/tool ahora da error 400) y añade una marca de agua estadística de texto a toda la salida para cumplir con la Ley de IA de la UE.
A favor: calidad genuinamente de frontera; grandes ejecuciones agénticas del mundo real; lecturas de caché baratas; contexto de 1M.
En contra: el modelo más caro aquí, con diferencia; la marca de agua y los falsos positivos de rechazo frustran a algunos desarrolladores; excesivo para tareas cotidianas.
Mi opinión: Fable 5.1 no es un reemplazo de Sol para la mayoría de las cargas de trabajo, es el modelo al que escalas para el 5 % de trabajos que son genuinamente difíciles. Dirige tu tráfico fácil hacia algo barato y reserva Fable para el trabajo que realmente lo necesita.
Lo que nadie que cambia de modelo realmente se pregunta
Esto es con lo que me sigo topando, y es la razón por la que escribí el final antes que la lista. La mayoría de las personas que comparan alternativas a GPT-6 Sol para un producto real, especialmente para atención al cliente, se están haciendo la pregunta equivocada. Están optimizando el motor cuando lo que decide si funciona es todo lo que envuelve al motor.
He pasado los últimos años poniendo agentes de IA en colas de soporte en vivo en miles de empresas, y el patrón nunca cambia. El modelo rara vez es el cuello de botella. El cuello de botella es: ¿tiene el contexto real de tu empresa, puede realizar acciones reales en tu helpdesk, y puedes confiar en él antes de que toque a un cliente real? Aprendimos eso por las malas, por lo que cada implementación de eesel ahora simula contra tus tickets históricos primero, para que veas la tasa de resolución y las respuestas exactas en tickets reales del pasado antes de que nada salga en vivo. Una API de modelo en bruto no te da nada de eso. Te da un endpoint de completado de texto muy inteligente y una factura.
Cambiar Sol por Sonnet 5 o Gemini Flash cambia tu costo por token. Por sí solo, no te consigue un agente de soporte. Esa es una capa distinta, y es en la que realmente enfocaría la decisión.
Prueba eesel

Así es como lo pienso: un modelo es infraestructura, y eesel es el empleado que contratas para ejecutarse sobre él. No eliges eesel en lugar de GPT-6 Sol o Claude o Gemini; eliges al compañero de equipo, y este usa el modelo que sea adecuado para el trabajo por debajo. Hoy esa plantilla es un compañero de equipo de IA para helpdesk listo para trabajar que se une a tu cola de soporte existente ya conociendo tu centro de ayuda y tickets pasados, y un redactor de blog de IA para contenido. Cada uno llega con las habilidades, integraciones y contexto de la empresa para su rol, y se factura por resolución, no por token, así que un modelo hablador no dispara tu factura.
Si eres del tipo de persona que compara APIs de modelos, la CLI de eesel es probablemente la forma más rápida de verlo. Es una superficie amigable para agentes sobre el mismo compañero de equipo y espacio de trabajo: puedes manejarla desde una terminal, automatizarla en scripts, y dejar que agentes de programación como Claude Code, Codex y Cursor la operen directamente, junto con el servidor MCP, webhooks y controles de acceso de red. El mismo agente que el panel, solo que sin interfaz. Puedes probar eesel gratis y simularlo con tus propios tickets antes de comprometerte a nada.
Preguntas frecuentes
¿Cuál es la mejor alternativa a GPT-6 Sol en 2026?
¿Hay una alternativa más barata a GPT-6 Sol?
¿Cuál es una buena alternativa de pesos abiertos a GPT-6 Sol?
¿Es GPT-6 Sol mejor que Claude Sonnet 5?
¿Las alternativas a GPT-6 Sol funcionan para la automatización de atención al cliente?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.