Resumen rápido
GPT-6 Sol de OpenAI se lanzó el 23 de septiembre de 2026 como el nivel intermedio de la familia GPT-6, y el titular es un recorte de precio, no una mejora de especificaciones: 2 $ por millón de tokens de entrada y 10 $ por millón de tokens de salida en la API estándar. Eso es exactamente la mitad de los 4 $/20 $ de GPT-5.6 Sol, y una quinta parte del precio del buque insignia GPT-6 Astra.
Lo interesante es lo que obtienes a cambio del recorte. Los detalles que realmente mueven tu factura:
- Misma inteligencia, mitad de precio. Artificial Analysis encontró que el Intelligence Index se mantiene aproximadamente al nivel de GPT-5.6 Sol, mientras mejora la factualidad. Estás comprando la misma clase de modelo más barata, no un salto.
- Los niveles de servicio hacen que el coste varíe 4 veces. Batch y Flex ejecutan Sol a 1 $/5 $, el modo Fast a 4 $/20 $. Mismo modelo, matemática radicalmente distinta.
- No es gratis. No hay nivel gratuito en la API, y en ChatGPT empieza en el plan Plus de 20 $/mes. Solo GPT-6 Luna llega a Free y Go.
Si eres desarrollador, la sección de abajo tiene la tabla completa por niveles más una calculadora para tu propio volumen. Si diriges un equipo de soporte u operaciones y en realidad te preguntas "¿cuánto me costará una IA por ticket?", el precio por token es la unidad equivocada. Por eso un agente de IA para el centro de ayuda como eesel factura por ticket resuelto, algo en lo que entraré al final.
Precios de la API de GPT-6 Sol: el nivel estándar
Aquí está el número por el que vino la mayoría. En la página de precios de la API, el precio estándar de GPT-6 Sol es de 2,00 $ por millón de tokens de entrada y 10,00 $ por millón de tokens de salida. La entrada en caché baja a 0,20 $, y las escrituras de caché cuestan 2,50 $ por millón.
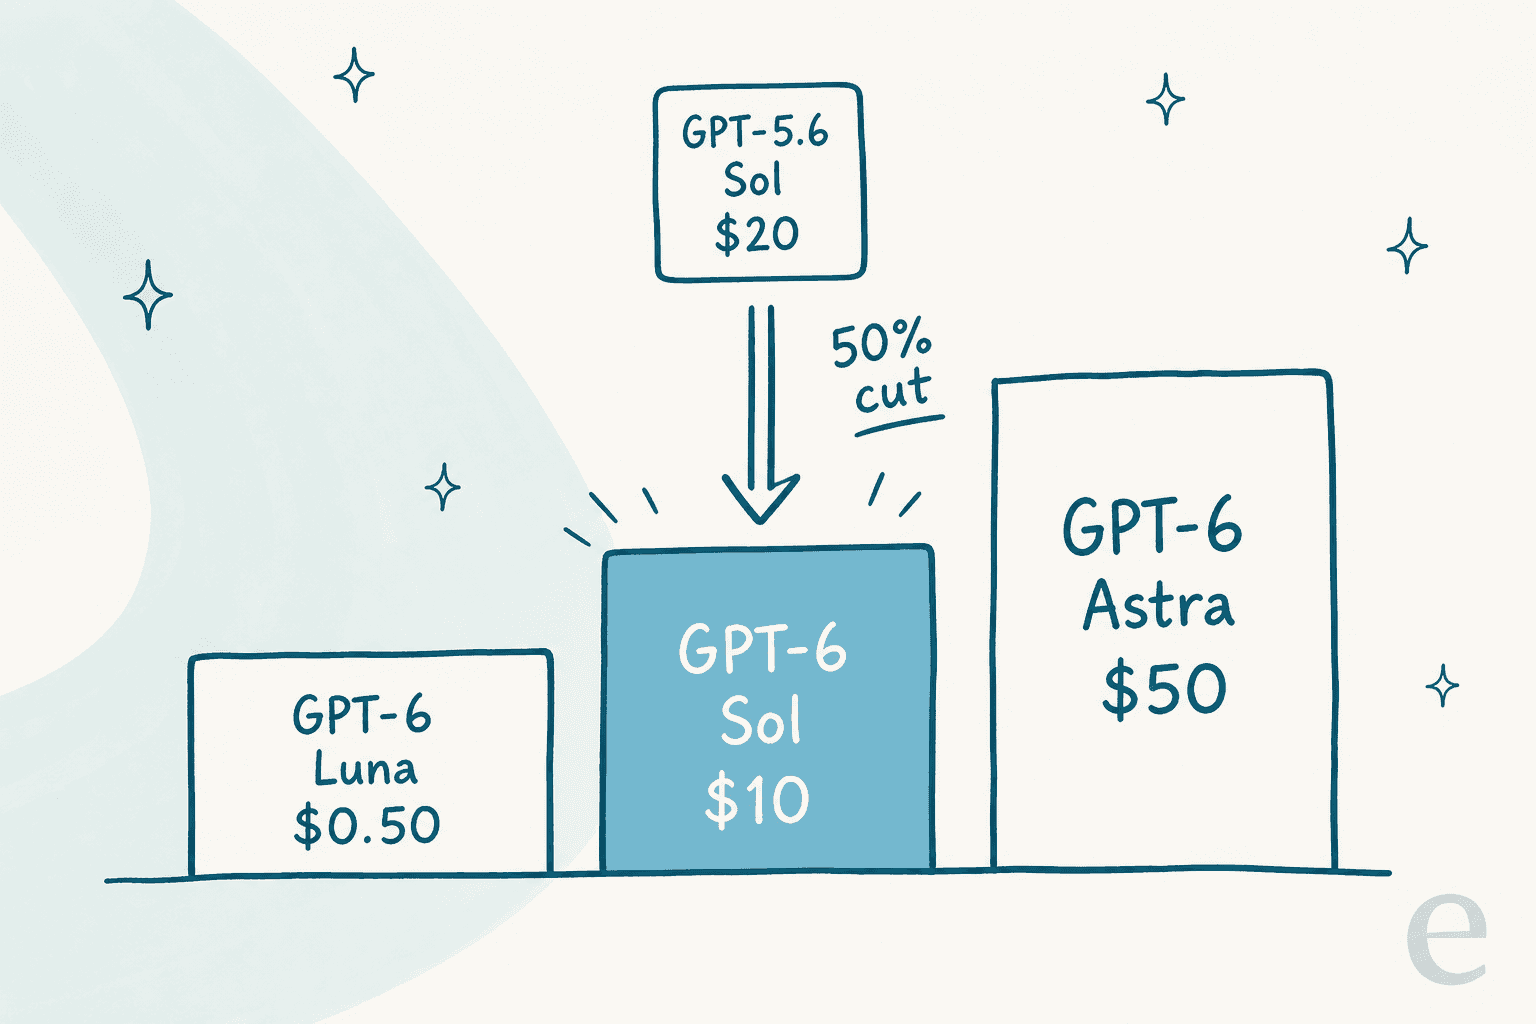
Eso sitúa a Sol justo en el medio de la gama de modelos de OpenAI: muy por encima del ligero Luna, y muy por debajo del buque insignia Astra. Así se sitúa la familia GPT-6 en el nivel estándar de contexto corto, con el saliente GPT-5.6 Sol como referencia:
| Modelo | Entrada (por 1M) | Entrada en caché | Salida (por 1M) | Posición |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Buque insignia |
| gpt-6-sol | $2.00 | $0.20 | $10.00 | Nivel medio (nuevo) |
| gpt-6-luna | $0.10 | $0.01 | $0.50 | El más barato |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Nivel medio anterior |
Fuente: Precios de la API de OpenAI. La historia que cuenta la tabla es simple: GPT-6 Sol es el antiguo GPT-5.6 Sol a mitad de precio. OpenRouter confirmó las mismas tarifas el día del lanzamiento, con Sol a "2 $/M de entrada y 10 $/M de salida". El propio planteamiento de OpenAI en la publicación de lanzamiento es "Build with Sol. Scale with Luna", lo que indica dónde debe situarse cada modelo.
El recorte del 50%: qué cambió y qué no
Un recorte de precio de este tamaño suele venir con una historia de capacidades. Esta, en su mayor parte, no la tiene, y vale la pena ser honesto al respecto.
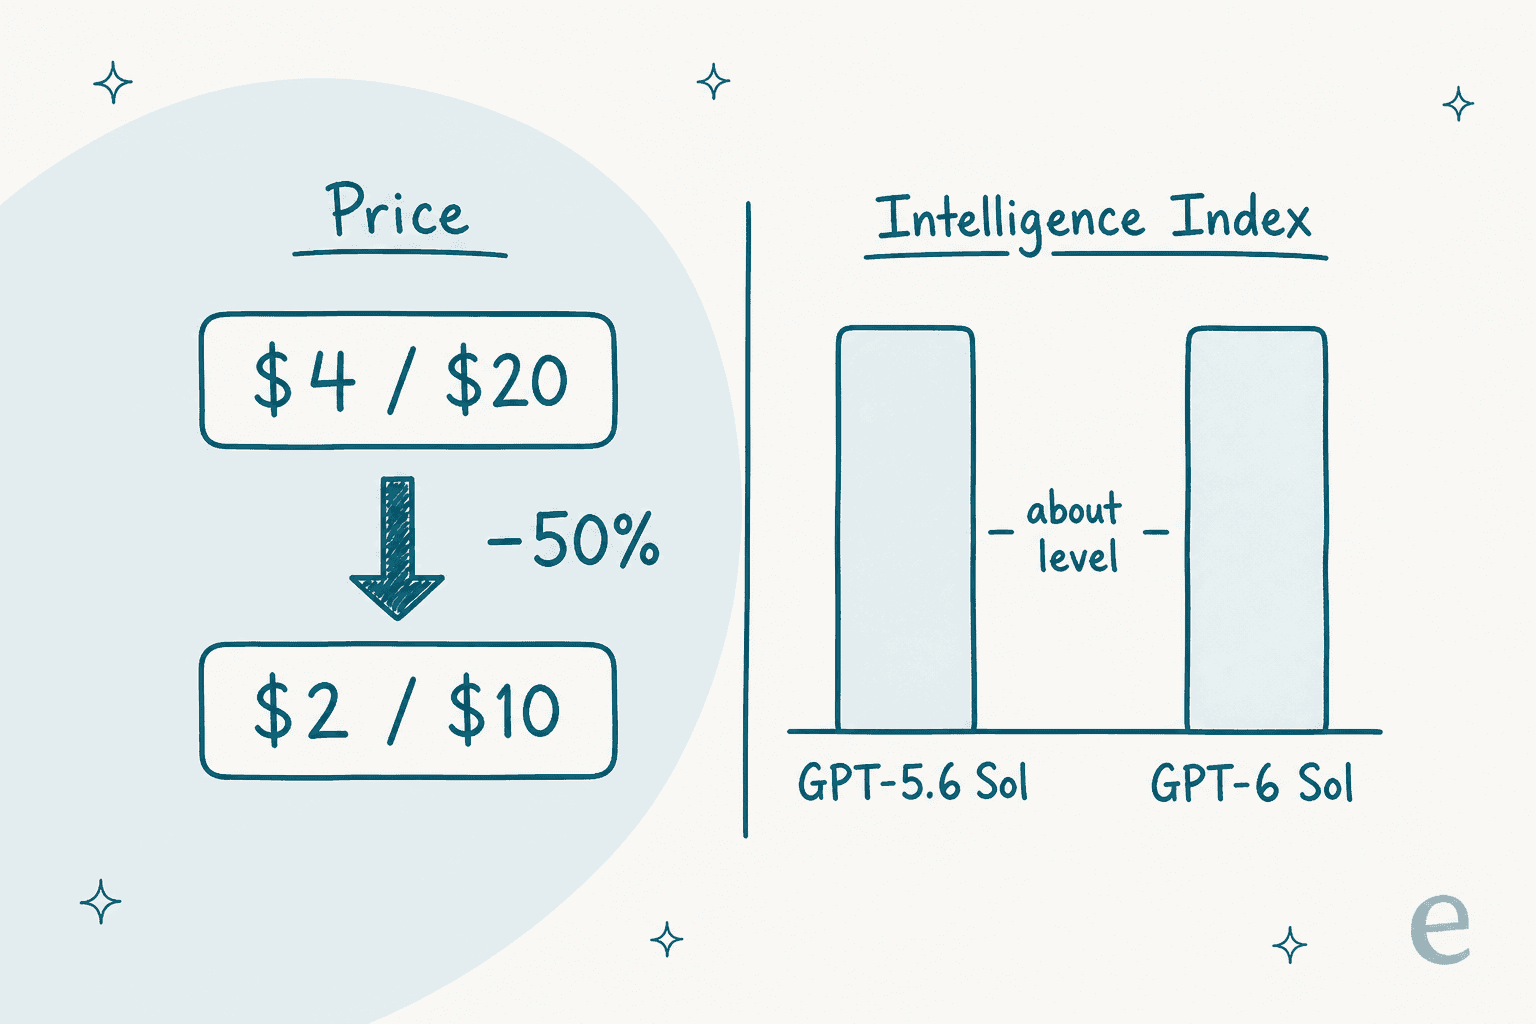
En la medida bruta de inteligencia, Artificial Analysis informó que GPT-6 Sol y Luna "empujan la frontera de la eficiencia de coste al reducir el coste a la mitad", mientras que el Intelligence Index y el Coding Agent Index "se mantienen al nivel de GPT-5.6, con avances en algunas evaluaciones y retrocesos en otras". Así que el panorama es: el precio se movió mucho, la inteligencia apenas se movió.
Donde Sol sí mejoró fue en fiabilidad y rendimiento de programación, y OpenAI se apoyó en ambos:
- Factualidad. OpenAI informa de que GPT-6 Sol comete aproximadamente la mitad de errores factuales que GPT-5.6 Sol, acercándose a la fiabilidad de nivel Astra a una fracción del coste. Artificial Analysis registró que la tasa de alucinación con máximo esfuerzo cayó del 92% al 60%.
- Programación. OpenAI informa de un 68,8% en DeepSWE v1.1, a un punto de la mejor puntuación de Claude Fable 5 con aproximadamente un 80% menos de coste por tarea.
- Evaluaciones agénticas. Artificial Analysis anotó pequeñas mejoras en AutomationBench (62% frente a 60%) y Terminal-Bench 4.0 (44% frente a 40%), y un salto en el AA-Omniscience Index de 22 a 27.
La comunidad lo interpretó de la misma manera. En la discusión de lanzamiento, un desarrollador lo expuso con claridad:
"I'd have loved improved performance for 2x the price than ~equal performance for 0.5x the price."

Ese es el marco honesto para los precios de GPT-6 Sol. Si ya usabas GPT-5.6 Sol, esto es un recorte de factura que obtienes gratis. Si esperabas que el "6" significara un cambio radical en la inteligencia bruta, las puntuaciones de los benchmarks sugieren moderar esa expectativa.
Niveles de servicio: la variación de 4 veces que casi todos pasan por alto
La tarifa estándar es un punto de partida, no toda la historia. GPT-6 Sol funciona con los mismos niveles de servicio que el resto de la familia, y la diferencia entre el más barato y el más caro es de 4 veces para exactamente el mismo modelo. Esta es la palanca más grande que tienes sobre el coste.
| Nivel | Entrada (por 1M) | Entrada en caché | Salida (por 1M) | Compensación |
|---|---|---|---|---|
| Batch | $1.00 | $0.10 | $5.00 | 50% de descuento, asíncrono, hasta 24 h |
| Flex | $1.00 | $0.10 | $5.00 | 50% de descuento, más lento, puede hacer cola |
| Standard | $2.00 | $0.20 | $10.00 | Latencia predeterminada |
| Fast mode | $4.00 | $0.40 | $20.00 | 2x, la latencia más baja |
Fuente: Precios de la API de OpenAI. Algunas cosas que conviene saber antes de elegir uno:
- Batch y Flex tienen el mismo precio, pero son para trabajos distintos. Batch es para trabajo asíncrono que envías y recoges después; Flex es para solicitudes interactivas que estás dispuesto a dejar correr más lento o en cola. Ambos reducen tu factura a la mitad.
- El modo Fast duplica la tarifa para la latencia más baja, y acepta
service_tier: "priority"oservice_tier: "fast". - El modo Fast tiene una trampa regional. Para la residencia de datos en la UE puede caer al nivel estándar, así que no lo des por sentado en todas partes.
Si una carga de trabajo tolera la latencia, configurarla por defecto en Batch o Flex reduce tu gasto en Sol a la mitad otra vez, encima del 50% que ya ahorraste al dejar GPT-5.6. Eso se acumula: una tarea apta para lotes en GPT-6 Sol cuesta 1 $/5 $, un cuarto de la factura estándar del mes pasado en GPT-5.6 Sol.
Las trampas: contexto largo y las especificaciones
Dos detalles se esconden en la letra pequeña de la página del modelo, y ambos pueden reformar tu presupuesto sin que te des cuenta.
Primero, el contexto largo se factura a una tarifa más alta para toda la solicitud. La ventana de contexto de Sol es grande, de 1.050.000 tokens, pero cualquier prompt de más de 272K tokens de entrada hace que toda la solicitud pase a la tarifa de contexto largo: 4 $ por millón de entrada y 15 $ por millón de salida en el nivel estándar. Eso es 2x en la entrada y 1,5x en la salida, aplicado a cada token de la solicitud, no solo a los que superan el umbral.
| Nivel estándar | Contexto corto (≤272K) | Contexto largo (>272K) |
|---|---|---|
| Entrada (por 1M) | $2.00 | $4.00 |
| Entrada en caché | $0.20 | $0.40 |
| Salida (por 1M) | $10.00 | $15.00 |
Segundo, vale la pena conocer las especificaciones antes de comprometerte. GPT-6 Sol admite hasta 922.000 tokens de entrada y devuelve hasta 128.000, con una fecha de corte de conocimiento del 20 de abril de 2026. Acepta texto e imagen como entrada, texto como salida, y expone un esfuerzo de razonamiento desde none hasta max, con medium como opción predeterminada. También incluye el conjunto completo de herramientas de la Responses API: búsqueda web, intérprete de código, shell alojado, uso del ordenador y MCP. Y un suelo que conviene recordar: Sol no está en el nivel gratuito, así que Tier 1 es el punto de entrada para desarrolladores.
Calcula tu factura de la API de GPT-6 Sol
Los precios de catálogo son abstractos hasta que introduces tus propios números. Indica los millones de tokens de entrada y salida que esperas al mes, elige un nivel de servicio, y esto calcula el coste mensual. Tiene en cuenta el recargo por contexto largo automáticamente.
El patrón que encuentran la mayoría de los equipos es que los tokens de salida dominan la factura, ya que la salida cuesta 5 veces la tarifa de entrada. Si tu carga de trabajo genera respuestas largas, ahí es donde va el dinero, y donde pasar una tarea apta para lotes a Batch da sus frutos más rápido.
Precios de GPT-6 Sol en ChatGPT y Codex
Si no estás llamando a la API, GPT-6 Sol te llega a través de ChatGPT Work y Codex, y el plan en el que estás traza una línea clara sobre quién lo obtiene.
| Plan | Precio | Acceso a GPT-6 Sol |
|---|---|---|
| Free | $0 | No (solo Luna) |
| Go | $8/mo | No (solo Luna) |
| Plus | $20/mo | Sí |
| Pro | From $100/mo | Ampliado |
| Business / Enterprise / Edu | Per seat | Sí |
Fuente: Anuncio de lanzamiento de OpenAI. Algunas cosas destacan:
- Sol empieza en Plus. El plan Plus de 20 $/mes es el punto de entrada para los usuarios de ChatGPT que quieren Sol. Ni Free ni el plan Go de 8 $ lo incluyen; obtienen GPT-6 Luna en la app de escritorio.
- Codex también obtiene Sol. OpenAI lanzó ambos modelos en Codex en los mismos niveles, así que los usuarios de agentes de programación de Plus en adelante pueden seleccionar Sol directamente.
- Enterprise es por asiento. En Business y Enterprise, Sol está disponible por asiento junto con el acceso Edu, que sigue el mismo patrón que el resto de la gama de OpenAI.
No todos quedaron convencidos de que el ahorro en la suscripción coincida con el recorte de la API. Un desarrollador señaló que los cambios en los límites de mensajes sugerían que el recorte del 50% en la API se traducía en algo más cercano a un recorte de un tercio dentro de los planes de ChatGPT, así que conviene comprobar tu propia asignación en lugar de asumir que el descuento del catálogo se traslada directamente.
Cómo se comparan los precios de GPT-6 Sol
Ampliando la mirada, ¿dónde se sitúa Sol frente al resto de la frontera? La versión corta es que OpenAI usó Sol para competir con fuerza en precio en la parte media del mercado.
- Frente a su propia gama: a 2 $/10 $, Sol cuesta una quinta parte de GPT-6 Astra (10 $/50 $) y 20 veces el precio de Luna (0,10 $/0,50 $). Para la mayoría de las tareas cotidianas, Sol es el punto óptimo; para trabajo agéntico de largo plazo o de seguridad, la prima de Astra puede seguir valiendo la pena.
- Frente a Anthropic: Sol está muy por debajo de Fable 5.1, a 10 $/50 $, mientras OpenAI afirma que las puntuaciones de programación están a un punto en la parte alta.
- Frente a Google: se sitúa por encima de las opciones más ligeras de Gemini como Gemini 3 Flash, pero compite directamente con los niveles medios en una base de precio por inteligencia.
El panorama más amplio en el hilo de lanzamiento fue que los modelos cerrados siguen abaratándose sin volverse mucho más inteligentes, algo que varios desarrolladores calificaron como una carrera hacia el fondo en el precio. Esa es una buena noticia si compras tokens. Pero también es un recordatorio de que un modelo más barato no cambia la parte más difícil de llevar la IA a un flujo de trabajo real, que es todo lo que rodea al modelo.
Qué significan los precios de GPT-6 Sol si diriges un equipo de soporte
Aquí es donde quiero ser útil en lugar de solo enumerar tarifas, porque dedico mi tiempo a cómo se usan realmente estos modelos, y la respuesta honesta es un poco contraintuitiva.
Si diriges soporte al cliente u operaciones internas, un modelo de frontera más barato cambia menos de lo que sugiere el titular. Un modelo en bruto como Sol es infraestructura. Es un motor capaz, pero, de fábrica, no conoce tu política de reembolsos, no puede ver tus últimos 50.000 tickets, no tiene acceso a tu sistema de pedidos, y no tiene ninguna forma segura de ser probado contra tu cola real antes de empezar a responder a los clientes. Se factura por token por pensar, no por problema resuelto. Un recorte del 50% en tokens es real, pero es un descuento sobre la parte más barata del proyecto.
La unidad que realmente importa para un equipo de soporte es el coste por resolución, no el coste por token. Una factura de tokens es impredecible: varía con la longitud del prompt, los reintentos y lo hablador que esté el modelo un día cualquiera. He visto bots que suenan seguros dar tranquilamente respuestas equivocadas en colas en vivo, que es exactamente por lo que todo despliegue debería simularse contra tus propios tickets históricos antes de acercarse a un cliente. Esa es la brecha entre un modelo y un sistema construido a su alrededor: tu conocimiento, tus integraciones, acciones seguras, y una forma de probarlo primero con tu historial.
Por esto tampoco cambiaría de plataforma tu automatización de soporte la semana en que sale un modelo nuevo. Los mejores agentes de IA para el centro de ayuda y herramientas de atención al cliente están diseñados para ser flexibles con el modelo, así que cuando llega uno más barato o más inteligente, heredas la mejora sin reconstruir nada, y sin renegociar tu presupuesto en torno a una nueva tarifa de tokens.
Prueba eesel
Si tu interés en el precio de Sol en realidad es "¿cuánto me costará que una IA resuelva tickets de verdad?", ese es el trabajo para el que está construido un compañero de equipo de IA, y ahí es donde se sitúa eesel. GPT-6 Sol es el motor; eesel es el empleado que contratas para conducirlo. El agente de IA para el centro de ayuda se entrena con tus tickets pasados y tu centro de ayuda, se conecta al helpdesk que ya usas en lugar de sustituirlo, y te permite simularlo contra miles de tus tickets históricos reales para que veas cómo va a rendir, y cuánto va a costar, antes de que toque una conversación en vivo.
La facturación cuenta una historia que una tarifa de tokens no puede contar. En lugar de pagar por token para pensar, pagas 40 céntimos por ticket que realmente gestiona, sin cuotas por asiento y sin mínimo de plataforma, así que el coste sigue a los resultados en lugar de a la cháchara del modelo. Puedes empezar gratis con 50 $ de uso y sin tarjeta de crédito.

Y como esta es una pregunta de precios orientada a desarrolladores, vale la pena saber que todo el espacio de trabajo de eesel se puede manejar desde la terminal, no solo desde un panel. La CLI de eesel (npx @eesel/cli) permite que una persona, un script o un agente de programación como Claude Code, Codex o Cursor operen al mismo compañero de equipo: conectar un helpdesk, leer y editar las instrucciones permanentes, ejecutar eesel activity para inspeccionar ejecuciones pasadas, y controlar los cambios con eesel approvals. Cada comando imprime JSON, y --dry-run muestra la llamada exacta al servidor que haría una escritura antes de enviarla. Así que la misma facturación por resolución que modelarías en esta calculadora es algo que puedes integrar en tus propias herramientas, no solo recorrer en una interfaz.
Los precios de GPT-6 Sol son un buen trato en tokens, y para programación y trabajo cotidiano vale la pena aprovechar el recorte del 50%. Pero para la mayoría de los equipos de soporte, la tarifa de tokens nunca fue el número que importaba. Conseguir un compañero de equipo probado, conectado y responsable dentro de tu flujo de trabajo existente, facturado por resultado, es la parte en la que vale la pena invertir tu presupuesto.
Preguntas frecuentes
¿Cuánto cuesta GPT-6 Sol en la API?
¿Es GPT-6 Sol más barato que GPT-5.6 Sol?
¿Qué es el recargo por contexto largo de GPT-6 Sol?
¿Cuánto cuesta GPT-6 Sol en ChatGPT y Codex?
¿Qué cambian Batch y el modo Fast en los precios de GPT-6 Sol?
GPT-6 Sol frente a los precios de GPT-6 Astra: ¿cuál debería usar?


Article by
Kurnia Kharisma Agung Samiadjie
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.