
Resumen
GPT-6.1 Sol se lanzó en el DevDay de OpenAI el 29 de septiembre de 2026, exactamente una semana después de GPT-6 Sol. El Sol de la semana pasada fue una rebaja de precio con un número de versión nuevo. Este es lo contrario: mismo precio de $2/$10, un salto real de capacidad.
- Se acerca a Astra. OpenAI reporta que iguala a GPT-6 Astra en programación DeepSWE a aproximadamente una quinta parte del coste, y queda a 2.1 puntos de Astra en OSWorld 2.0 (uso del ordenador) con cerca de una séptima parte del coste por tarea.
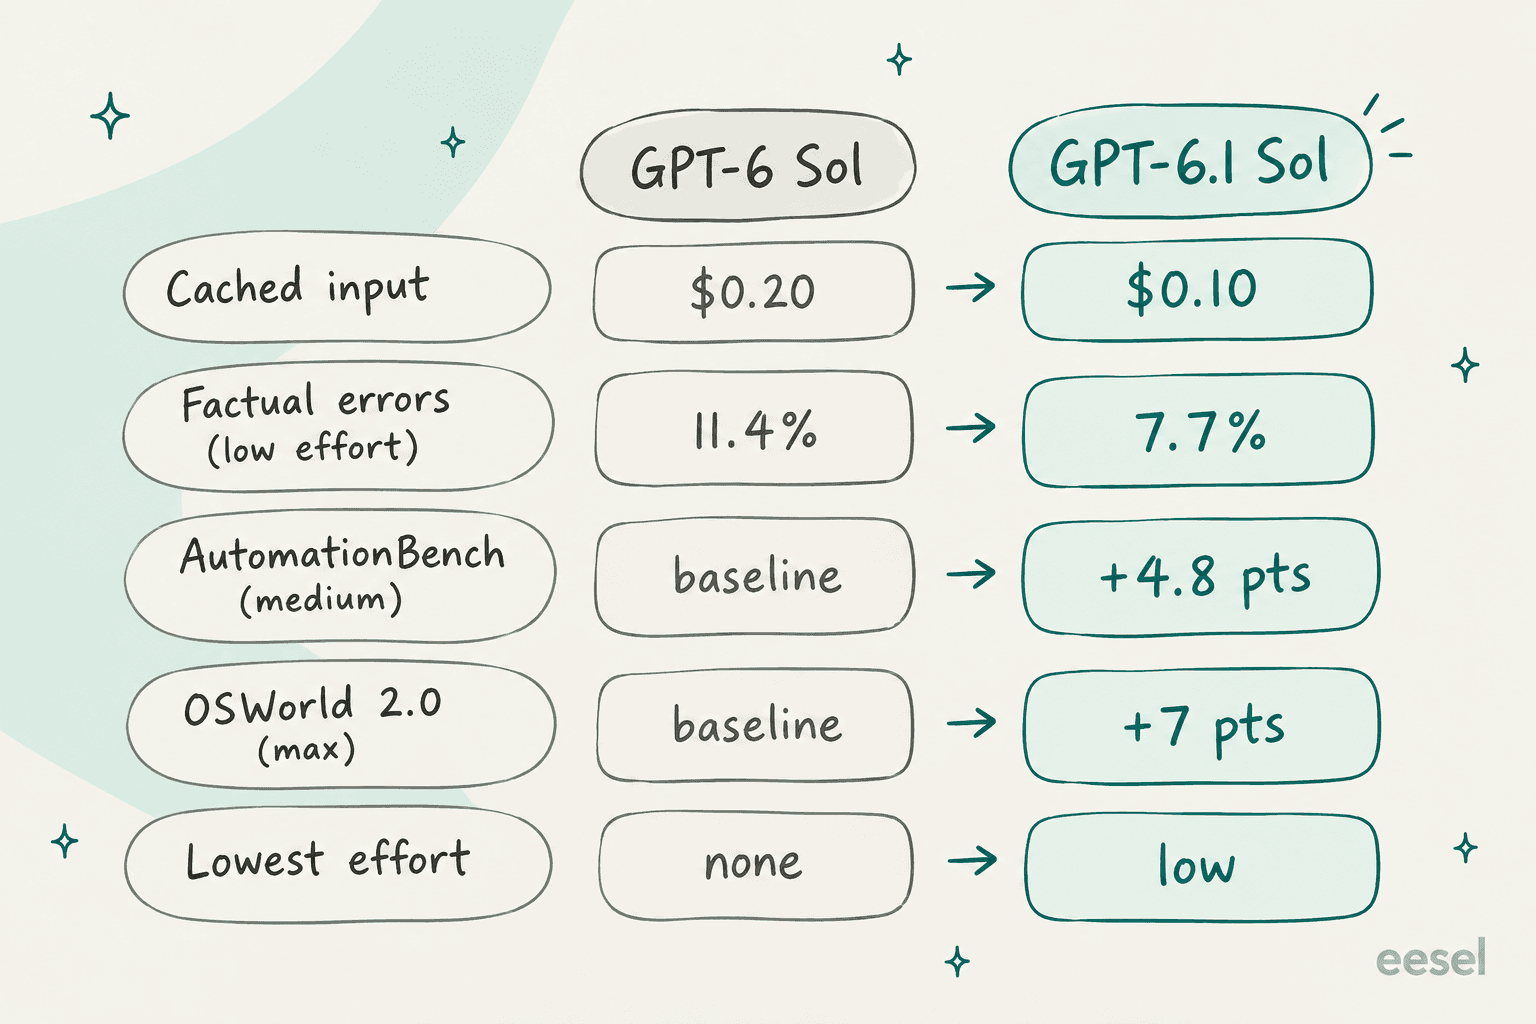
- El precio apenas se movió, y una parte se abarató. El precio estándar de la API sigue en $2 de entrada y $10 de salida por millón de tokens, pero la entrada en caché se reduce a la mitad, a $0.10 por millón.
- Las trampas son pequeñas pero reales. El esfuerzo de razonamiento
nonedesaparece, Chat Completions funciona sin llamadas a herramientas, todavía no está en el Chat normal de ChatGPT y el nivel Ultrafast llegará "pronto".
Mi opinión: para la mayoría de los equipos, GPT-6.1 Sol convierte a Astra en una herramienta de especialista, no en la opción por defecto. Si gestionas una cola de soporte, un modelo más listo seguirá sin conocer tu política de reembolsos. Lo que mueve la tasa de resolución es el agente de IA para helpdesk que lo rodea, que es el trabajo de eesel, probado primero con tus propios tickets pasados.
Qué es realmente GPT-6.1 Sol
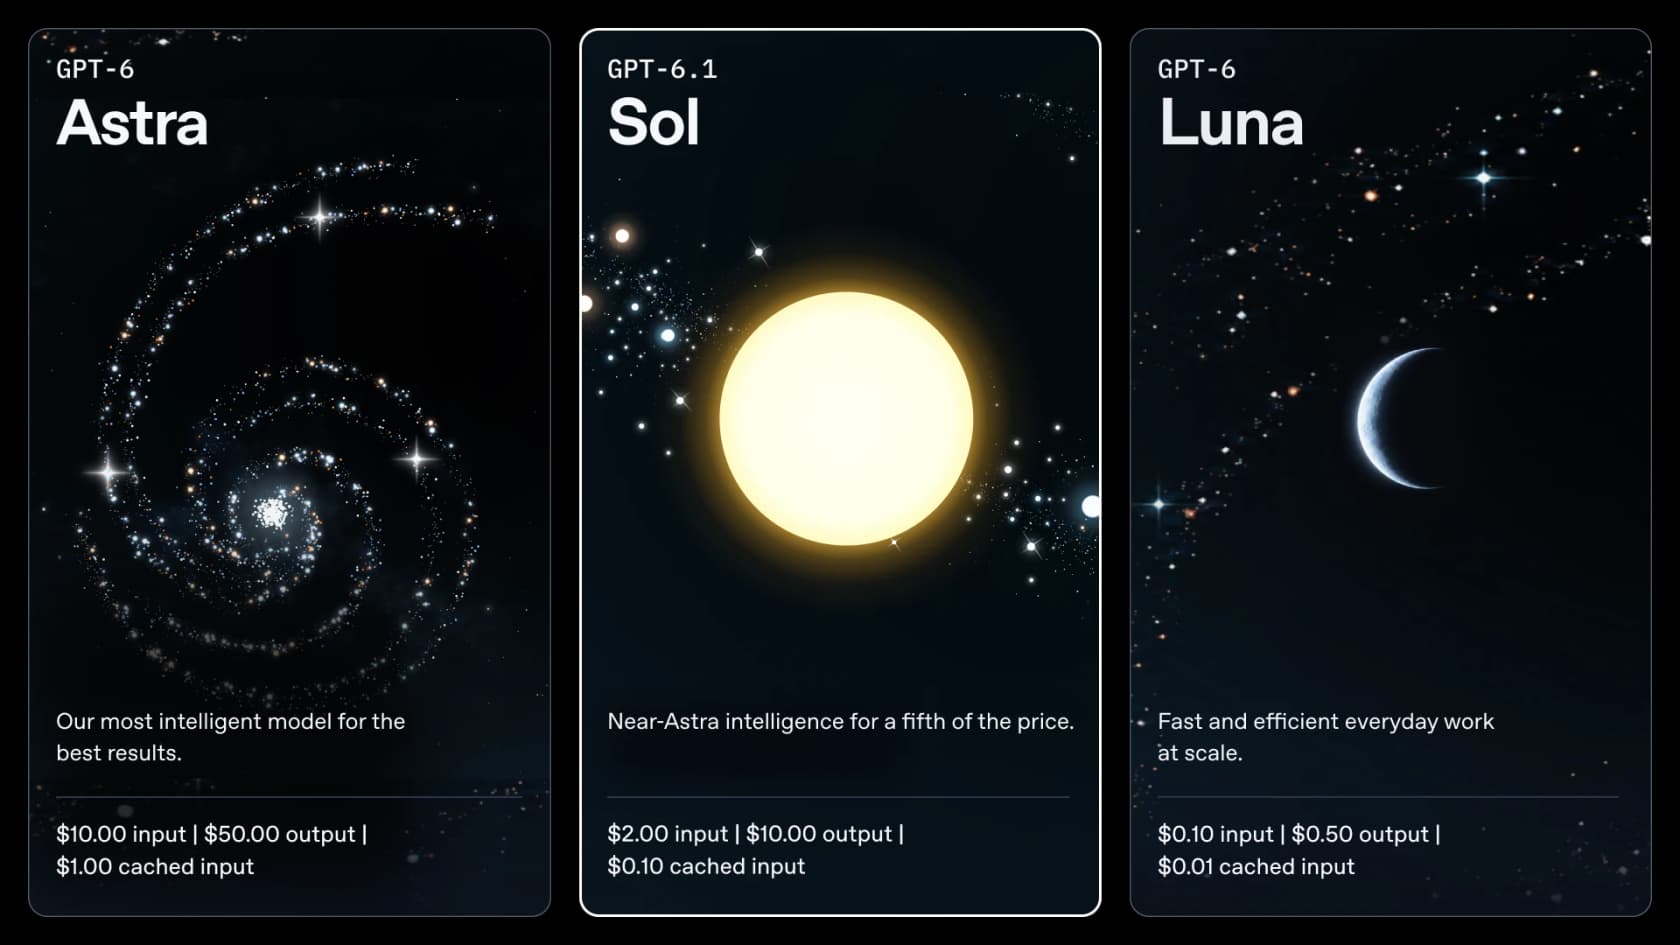
GPT-6.1 Sol es una mejora del modelo de gama media de la familia GPT-6 de OpenAI. Así queda ahora la familia: Astra arriba, 6.1 Sol en el medio y GPT-6 Luna abajo. El lema que OpenAI eligió es "Inteligencia casi de Astra por una quinta parte del precio", y esa frase aparece impresa también en las tarjetas de precios del lanzamiento.
Gran parte de lo que escribo sobre modelos de IA viene del lado de las búsquedas, y la intención de búsqueda aquí es fácil de leer. Quien busca "GPT-6.1 Sol" un día después del lanzamiento no pregunta qué es un modelo de lenguaje, pregunta una sola cosa: ¿sigo necesitando pagar por Astra? Por eso construí este artículo alrededor de esa pregunta.
En la página del modelo, la ficha técnica es casi idéntica a la de su predecesor. El id del modelo es gpt-6.1-sol, con una ventana de contexto de 1,050,000 tokens, 128,000 tokens de salida máxima y un límite de conocimiento del 30 de abril de 2026 (diez días más tarde que el 20 de abril de GPT-6 Sol). La entrada puede ser texto o imágenes, y lo que devuelve es texto. En la Responses API admite búsqueda web, búsqueda de archivos, un intérprete de código, un shell alojado, apply patch, skills, uso del ordenador, búsqueda de herramientas y MCP. También hay residencia de datos en EE. UU. y la UE, aunque si eliges residencia en la UE el modo Fast no está disponible.
Qué cambió frente a GPT-6 Sol, una semana después
Cuando GPT-6 Sol salió el 22 de septiembre, el resumen honesto era "la misma inteligencia que GPT-5.6 Sol a la mitad de precio". Artificial Analysis lo puso solo un punto por encima de GPT-5.6 Sol en su Intelligence Index, y poco más. GPT-6.1 Sol es el lanzamiento en el que la capacidad empieza de verdad a moverse.
Según la publicación de lanzamiento de OpenAI, estas son las diferencias frente a GPT-6 Sol:
- Programación: en DeepSWE v1.1, supera la mejor puntuación de GPT-6 Sol en 6.4 puntos porcentuales, con menor esfuerzo de razonamiento y menor coste.
- Flujos de trabajo empresariales: en AutomationBench, sube 4.8 puntos respecto a GPT-6 Sol con esfuerzo medio.
- Uso del ordenador: en el conjunto offline de OSWorld 2.0, supera a GPT-6 Sol por 7 puntos con esfuerzo máximo, a menos de la mitad del coste.
- Ciencia: en Terminal-Bench Science 0.1, más que duplica la puntuación de GPT-6 Sol con esfuerzo máximo.
- Factualidad: con esfuerzo bajo, la proporción de respuestas con un error factual baja del 11.4% al 7.7%, una reducción de cerca del 32%.
También algo se movió en seguridad. El anexo de la tarjeta del sistema reporta que, cuando una herramienta de búsqueda está rota, GPT-6.1 Sol no se lo dice al usuario en el 2.08% de los casos, frente al 4.92% de GPT-6 Sol. Si lo que construyes es de cara al cliente, un modelo que "admite cuando no puede consultar algo" vale más que un par de puntos de benchmark.
Una cosa pequeña sí empeoró, y volveré sobre ella en la sección de las trampas: el ajuste de razonamiento más bajo ahora es low, no none.
¿Cuánto se acerca a Astra?
Esta es la parte que decide si sigues pagando por el modelo estrella o no. OpenAI lo plantea como "casi iguala", y en su mayor parte los números lo respaldan.
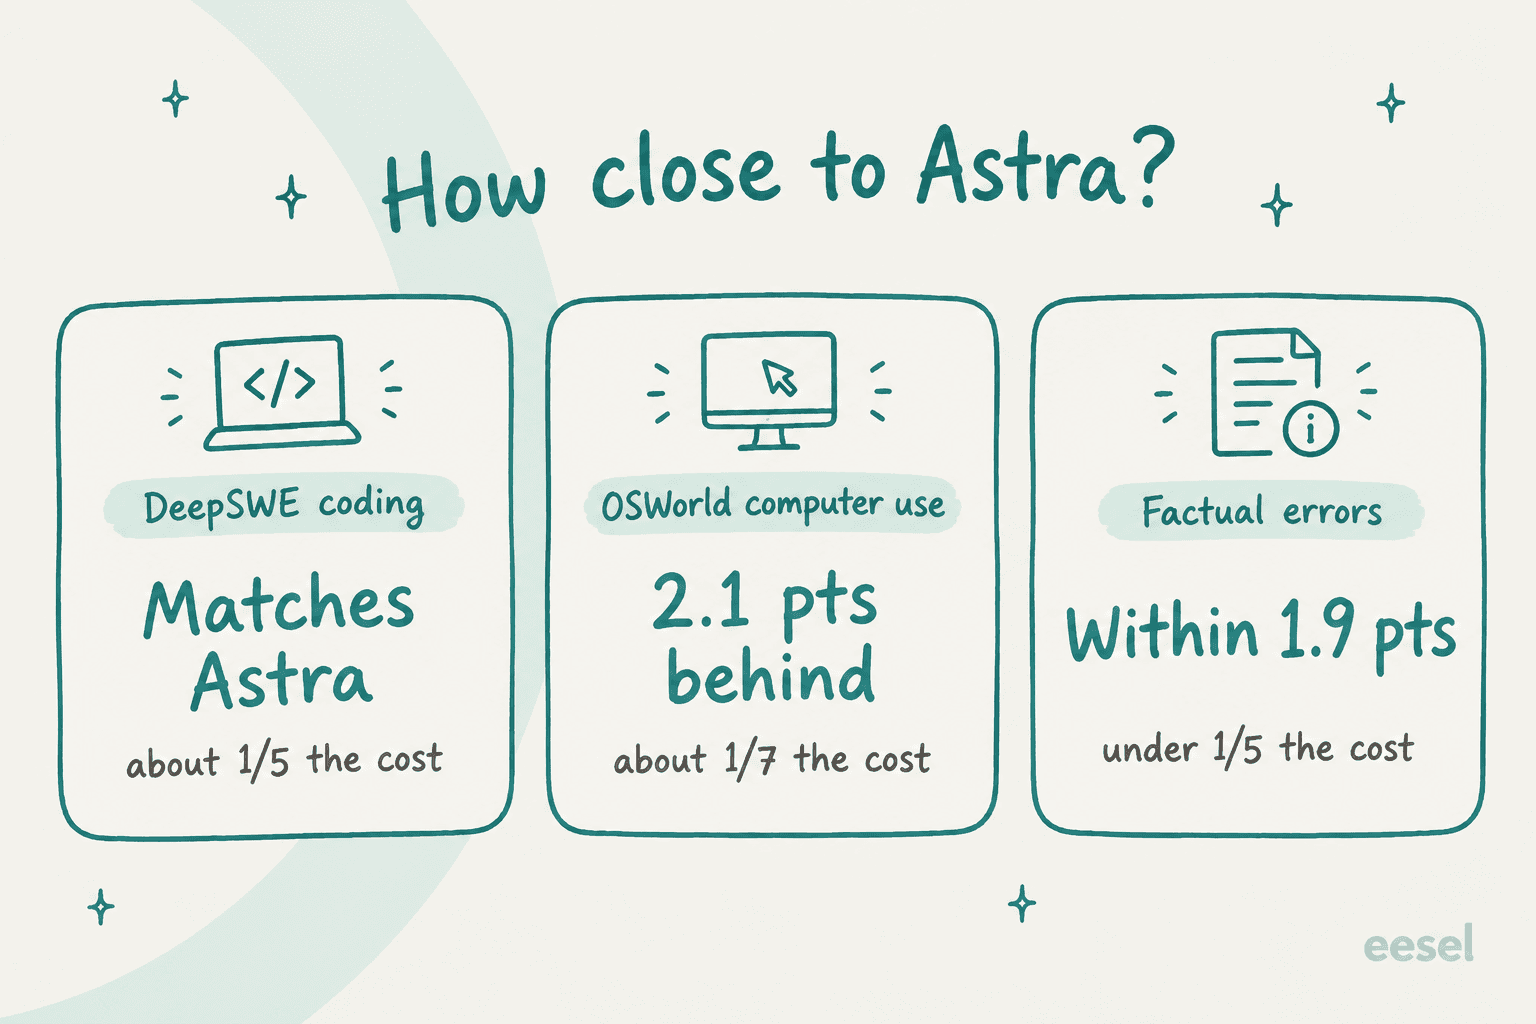
En DeepSWE v1.1, OpenAI dice que 6.1 Sol iguala a GPT-6 Astra a aproximadamente una quinta parte del coste. En OSWorld 2.0, queda a 2.1 puntos de Astra con esfuerzo máximo por cerca de una séptima parte del coste por tarea. Y en todos los ajustes de razonamiento que probaron, la tasa de error factual se mantiene a menos de 1.9 puntos de la de Astra, a menos de una quinta parte del coste por tarea.
Frente a Anthropic también sale bien parado. En GDP.pdf, una prueba de responder preguntas profesionales a partir de PDF complejos, OpenAI reporta que 6.1 Sol puntúa más que Claude Opus 5.5 con respaldos, a menos de la mitad del coste por tarea. Y en AutomationBench queda 2.2 puntos por encima de Opus 5.5 con esfuerzo medio, por aproximadamente un tercio del coste.
Donde más se ensancha la brecha de coste es en el trabajo científico. Con esfuerzo máximo en Terminal-Bench Science, OpenAI sitúa a 6.1 Sol en $5.47 por tarea de media, frente a $23.21 de Opus 5.5 y $23.80 de Astra.
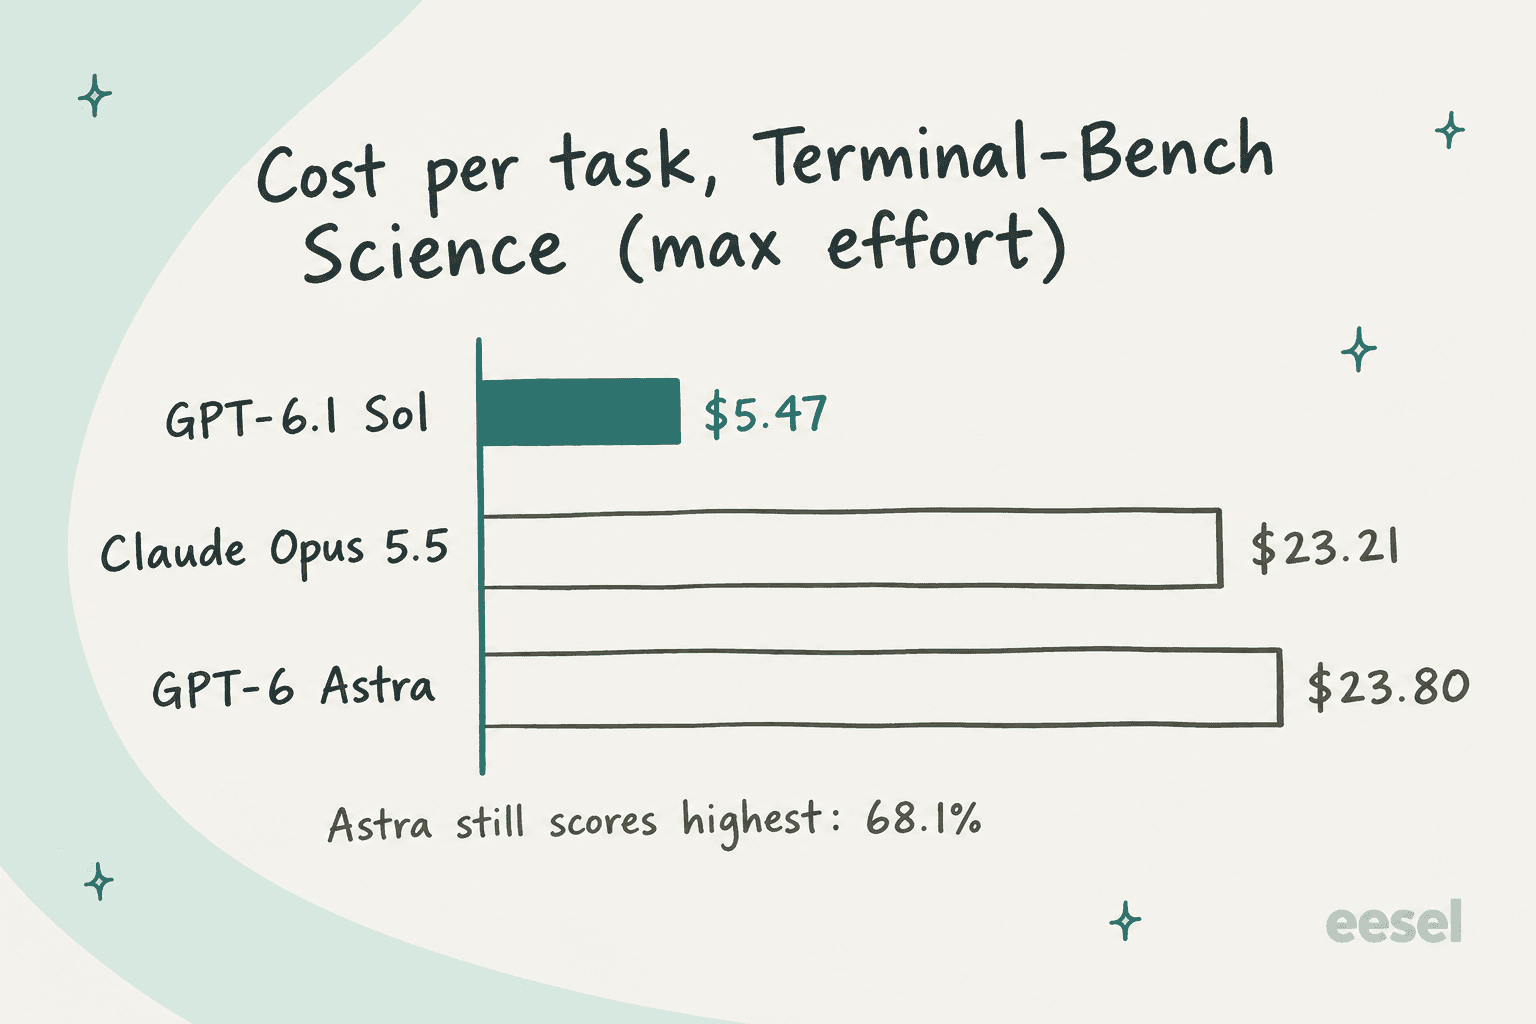
Hay una salvedad justa que poner a todo esto. Cada número de arriba es una evaluación propia de OpenAI, y las cifras de la competencia salen de "informes públicos", según la nota al pie de la publicación de lanzamiento. OpenAI también dice que Astra sigue registrando la puntuación científica más alta, 68.1%, y "debería usarse para las tareas de investigación científica más difíciles". Así que la brecha es pequeña, pero no es cero. La buena noticia es que los números independientes de abajo cuentan más o menos la misma historia.
Qué dicen las pruebas independientes y los primeros usuarios
Artificial Analysis tuvo números el día del lanzamiento y, con sinceridad, respaldan el titular de OpenAI más de lo que esperaba. Con esfuerzo máximo, GPT-6.1 Sol puntúa 51.8 en el Intelligence Index, frente a 47.5 de GPT-6 Sol y 52.7 de GPT-6 Astra. Lo logra a $0.72 por tarea frente a $3.26 de Astra, es decir, cerca del 22% del coste del modelo estrella por aproximadamente un punto menos.
"GPT-6.1 Sol replaces GPT-6 Sol after just 7 days. It scores 1 point below GPT-6 Astra in the Intelligence Index at less than one quarter of the Cost per Task"
Para mí lo más útil de sus datos es la tabla por nivel de esfuerzo, porque la curva se aplana con fuerza al llegar arriba:
| Esfuerzo | Intelligence Index | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
| low | 42.1 | $0.13 | 56s |
| medium | 47.8 | $0.21 | 131s |
| high | 50.2 | $0.32 | 205s |
| xhigh | 51.0 | $0.39 | 271s |
| max | 51.8 | $0.72 | 569s |
Fuente: Artificial Analysis. Con xhigh te quedas a un punto de max por cerca de la mitad del coste, y la mitad de la espera también. Artificial Analysis encontró además que xhigh superó a max por 3 puntos en su Coding Agent Index, quedando 1 punto por encima de Astra "for less than 15% of the Cost per Task". Así que si lo tuyo son los agentes de programación, xhigh parece el punto ideal.
Los mismos datos traen también dos salvedades honestas. Primero, es más lento que GPT-6 Sol: 67 frente a 76 tokens por segundo, y 569 frente a 408 segundos por tarea con esfuerzo máximo, porque escribe más tokens de salida. Segundo, su tasa de alucinación mejoró del 60% al 54%, que es mejor, aunque todavía no llega al 51% del modelo estrella.
En el hilo de lanzamiento de Hacker News la gente fue mayormente positiva sobre el coste y más dividida sobre el acabado, y el precio de la caché fue lo que más reacciones generó:
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

Un desarrollador ejecutó el mismo trabajo de imagen a HTML en 6.1 Sol y en Claude Opus 5.5, y volvió con un veredicto justo y dividido:
"Overall, opus executes a bit better than 6.1 sol, which surprises me. [...] It's not bad by any means, but I think where Opus really wins is the motion animation of the svgs / final polish [...] Still, it executed quick and was quite cheap to run."
En X, la opinión que más vi repetida fue una más directa:
"OpenAI just launched GPT-6.1 Sol, and for coding it can replace Astra outright at 1/5 the price."
La nota agria tuvo más que ver con las suscripciones que con el modelo en sí. Un comentarista en Hacker News dijo que las cuotas de los planes de ChatGPT se recortaron al mismo tiempo, así que "even in the best case scenario it's about 2.5 times cheaper for Codex users." Es una afirmación de un usuario y no una cifra de OpenAI, pero si usas Sol mediante un plan y no la API, conviene revisar tu propio medidor de uso antes de asumir un ahorro de 5x.
Precios de GPT-6.1 Sol
El titular aquí es simple: nada subió. En la página de precios de la API, GPT-6.1 Sol reemplaza a GPT-6 Sol en la tabla principal con la misma tarifa estándar de $2/$10. Solo cambió una línea, la entrada en caché, que baja de $0.20 a $0.10 por millón, el 5% de la tarifa sin caché.
| Nivel | Entrada | Entrada en caché | Escrituras en caché | Salida |
|---|---|---|---|---|
| Standard (hasta 272K de entrada) | $2.00 | $0.10 | $2.50 | $10.00 |
| Standard (más de 272K de entrada) | $4.00 | $0.20 | $5.00 | $15.00 |
| Batch / Flex | $1.00 | $0.05 | $1.25 | $5.00 |
| Fast | $4.00 | $0.20 | $5.00 | $20.00 |
| Ultrafast | Próximamente |
Todos los precios por 1M de tokens. Fuente: precios de la API de OpenAI. El procesamiento regional (residencia de datos) añade un 10% de recargo.
Ese recorte de la entrada en caché importa más de lo que parece a primera vista. Un agente reutiliza el mismo prompt de sistema largo y las mismas definiciones de herramientas en cada llamada, más el historial de la conversación encima, así que la parte en caché de la entrada tiende a ser grande. OpenAI lo señala directamente en la publicación: el recorte da a los desarrolladores "more room to build and run capable agents that reuse context across requests."
Mirando toda la familia, la salida sube 20x de Luna a Sol y 5x de Sol a Astra:
| Modelo | Entrada / Salida (por 1M) | Entrada en caché | Ideal para |
|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | Tareas de alto volumen y bajo riesgo |
| GPT-6.1 Sol | $2.00 / $10.00 | $0.10 | La nueva opción por defecto para trabajo real |
| GPT-6 Astra | $10.00 / $50.00 | $1.00 | La investigación más difícil y las tareas de largo recorrido |
Fuente: precios de la API de OpenAI. Para el catálogo completo, incluidos los modelos de imagen y audio, la guía de precios de la API de OpenAI lo tiene todo.
Sol o Astra: ¿cuál deberías usar?
Cuando eliges entre los dos para un proyecto real, la respuesta depende de lo difícil que sea el trabajo y de cuánto dure, no de cuál sea el modelo más nuevo. Elige la opción que más se parezca.
¿Cuál es el trabajo?
Las trampas que nadie pone en el titular
El lanzamiento es sólido, pero hay cuatro detalles que harán tropezar a cualquiera que migre una integración existente.
- No existe el esfuerzo de razonamiento
none. La página del modelo dice que el esfuerzo admitelow,medium(el predeterminado),high,xhighymax, y quenoneyminimalno se admiten. GPT-6 Sol sí admitíanone. Así que si construiste una ruta crítica en latencia sobre cero razonamiento, pruébala antes de cambiar. - Chat Completions no tiene llamadas a herramientas. OpenAI dice que uses la Responses API para las llamadas a herramientas; Chat Completions se admite sin ellas. Cualquier código de agente antiguo que viva en Chat Completions tendrá que migrarse.
- Todavía no está en el Chat normal de ChatGPT. Está en ChatGPT Work y Codex para Plus, Pro, Business, Enterprise y Edu, pero OpenAI dice que "not yet available in Chat." Los usuarios de Free y Go no lo tienen.
- Ultrafast es una promesa, no un producto. El resumen del DevDay dice que Ultrafast funciona hasta 8x más rápido (300 tokens por segundo) en Codex y hasta 6x en la API, y que "GPT-6.1 Sol Ultrafast is coming soon." Hoy, solo Astra tiene precio Ultrafast.
Ninguno de estos puntos es un impedimento por sí solo. Son el tipo de cambio pequeño que convierte una migración de "solo cambia el id del modelo" en medio día de depuración, si nadie te avisó antes.
Cómo conseguir acceso
- API: usa el id de modelo
gpt-6.1-solen la Responses API. No hay nivel gratuito, así que el Tier 1 es el mínimo, con 500 solicitudes y 500,000 tokens por minuto, escalando hasta 15,000 solicitudes y 40 millones de tokens por minuto en el Tier 5. La guía de límites de uso explica cómo suben los niveles. - ChatGPT Work y Codex: disponible para usuarios de Plus, Pro, Business, Enterprise y Edu desde el día del lanzamiento. Si vives en Codex para programación con agentes, este es el modelo al que cambiar, y el desglose de precios de Codex cubre las cuotas de los planes.
- Business y Enterprise: los espacios de trabajo de ChatGPT Enterprise y Business lo tienen en ChatGPT Work y Codex desde el primer día, igual que Plus y Pro.
Qué significa para quien construye
Si ya usas GPT-6 Sol, esta es la mejora más fácil del año: el precio se mantiene y obtienes más capacidad, además de contexto en caché más barato. Revisa primero las cuatro trampas de arriba y luego apunta tu integración a gpt-6.1-sol.
La decisión más importante es la de Astra. Hace una semana, recurrir a Astra para agentes de programación todavía era fácil de defender. Hoy, con Sol igualándolo en DeepSWE, la mayoría de los equipos que pagan 5x por Astra deberían ejecutar su propio conjunto de pruebas en ambos y ver dónde se queda corto realmente Sol. En tareas largas, el coste de un agente de IA son sobre todo tokens de salida, y la salida es justo donde vive la brecha de 5x.
Si prefieres manejar ese tipo de flujo de trabajo desde una terminal, merece la pena conocer la CLI de eesel. Opera el mismo compañero de eesel y el mismo espacio de trabajo que el panel: puedes ejecutar eesel chat a mano, automatizar eesel activity para leer lo que hizo el agente en cada ejecución, usar --dry-run para ver exactamente qué enviaría una escritura antes de enviarla, y dejar que agentes de programación como Claude Code, Codex y Cursor la llamen directamente. Además, cada espacio de trabajo expone un servidor MCP, lo que significa que una sesión de Codex con GPT-6.1 Sol puede manejar tu compañero de soporte como una herramienta, en lugar de que tú hagas clic por una interfaz.
Qué significa si diriges un equipo de soporte
Ahora viene lo contraintuitivo. Que un modelo esté casi a la altura de Astra en benchmarks de programación cambia menos en una cola de soporte de lo que sugiere el lanzamiento.
La mejor factualidad es real y bienvenida, ya que menos respuestas erróneas dichas con seguridad es justo lo que necesita el soporte. Pero en soporte, la mayoría de las respuestas erróneas no vienen de que el modelo se invente cosas, sino del conocimiento que se le dio en primer lugar. Un equipo de soporte B2B de telemática de vehículos que configuró eesel en Zendesk lo notó pronto: su bot respondía que sí a "¿soportan el modelo de mi coche?" para marcas que no estaban en su base de datos, porque el centro de ayuda decía "soportamos todos los modelos". El modelo leyó la fuente con fidelidad, lo que estaba mal era la fuente. Ninguna mejora de modelo arregla eso, y el equipo describió la configuración inicial como prueba y error.
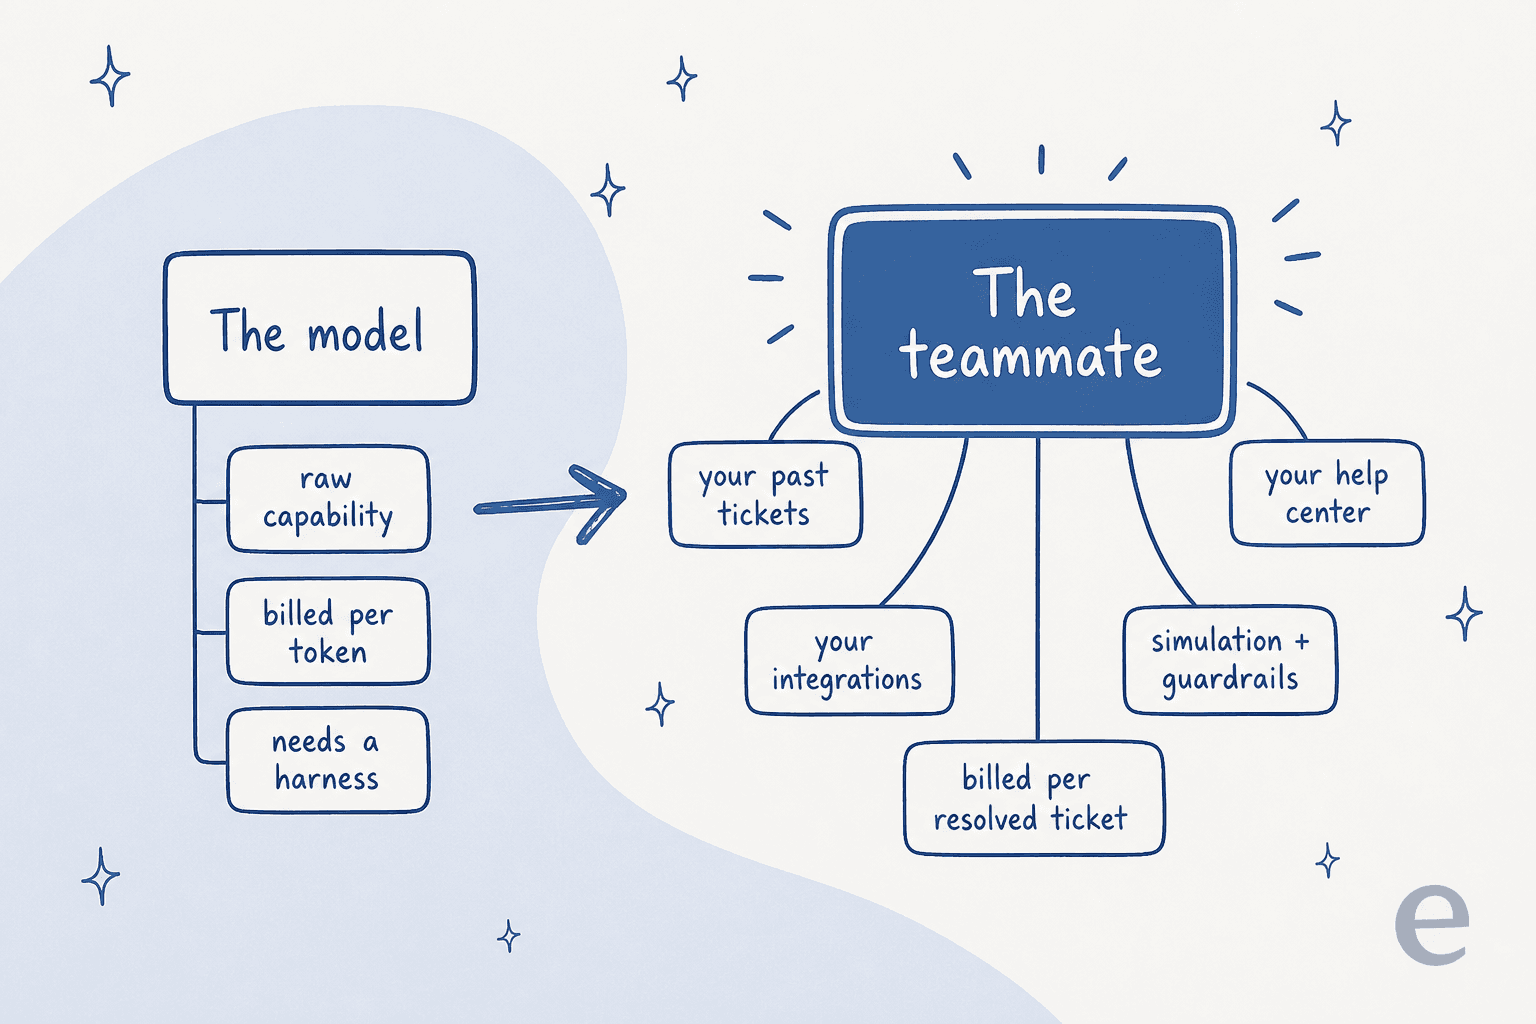
Por eso pondría un modelo nuevo al final de la lista de prioridades de un equipo de soporte. Lo que mueve la tasa de resolución es la capa que rodea al modelo, es decir, entrenar con tus tickets pasados, conectar el helpdesk que ya usas y además probar las respuestas contra tu propio historial antes de salir en vivo. Si te preocupan las alucinaciones, la solución también está sobre todo en esa capa. Los mejores agentes de IA son flexibles con el modelo, así que cuando sale un modelo mejor como GPT-6.1 Sol, lo heredas en vez de cambiar de plataforma.
Prueba eesel
Si lo que realmente quieres de GPT-6.1 Sol son menos tickets en la cola, no hace falta que construyas tú la estructura. GPT-6.1 Sol es infraestructura; eesel es el empleado. El compañero de IA para helpdesk de eesel aprende de tus tickets pasados y tu centro de ayuda, se conecta a Zendesk, Freshdesk, Gorgias y los demás helpdesks que ya usas, y ejecuta una simulación con tus tickets pasados reales para que puedas comparar sus respuestas con lo que tu equipo envió de verdad antes de que responda a un solo cliente.
El precio es un plan de créditos mensual fijo donde un ticket o chat es un crédito, con todas las funciones y usuarios ilimitados incluidos, y un plan gratuito con 100 créditos y sin tarjeta. No hay cargo por token, así que el modelo de debajo sea GPT-6.1 Sol o el siguiente lanzamiento, la factura sigue siendo predecible. Prueba eesel con una parte de tu cola y mira las respuestas sobre tus propios tickets.
Preguntas frecuentes
¿Qué es GPT-6.1 Sol?
¿Cuánto cuesta GPT-6.1 Sol?
¿Cuál es la diferencia entre GPT-6 Sol y GPT-6.1 Sol?
none desaparece, así que low es ahora el mínimo. El artículo original sobre GPT-6 Sol cubre el modelo anterior.¿GPT-6.1 Sol es tan bueno como GPT-6 Astra?
¿Está GPT-6.1 Sol disponible en ChatGPT?
gpt-6.1-sol, sin acceso en el nivel gratuito.¿GPT-6.1 Sol tiene un modo Ultrafast?
¿Cuáles son los límites de uso de GPT-6.1 Sol?
¿Debo usar GPT-6.1 Sol para automatizar el soporte al cliente?

Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.