
Precios de GPT-6.1 Sol de un vistazo
GPT-6.1 Sol se lanzó en el DevDay de OpenAI el 29 de septiembre de 2026, y en la página de precios de la API simplemente heredó la fila de GPT-6 Sol. Yo construyo integraciones en eesel. Cada vez que sale un modelo, acabo rehaciendo la misma hoja de cálculo de costes para algún cliente, así que esta vez escribí la hoja como un artículo.
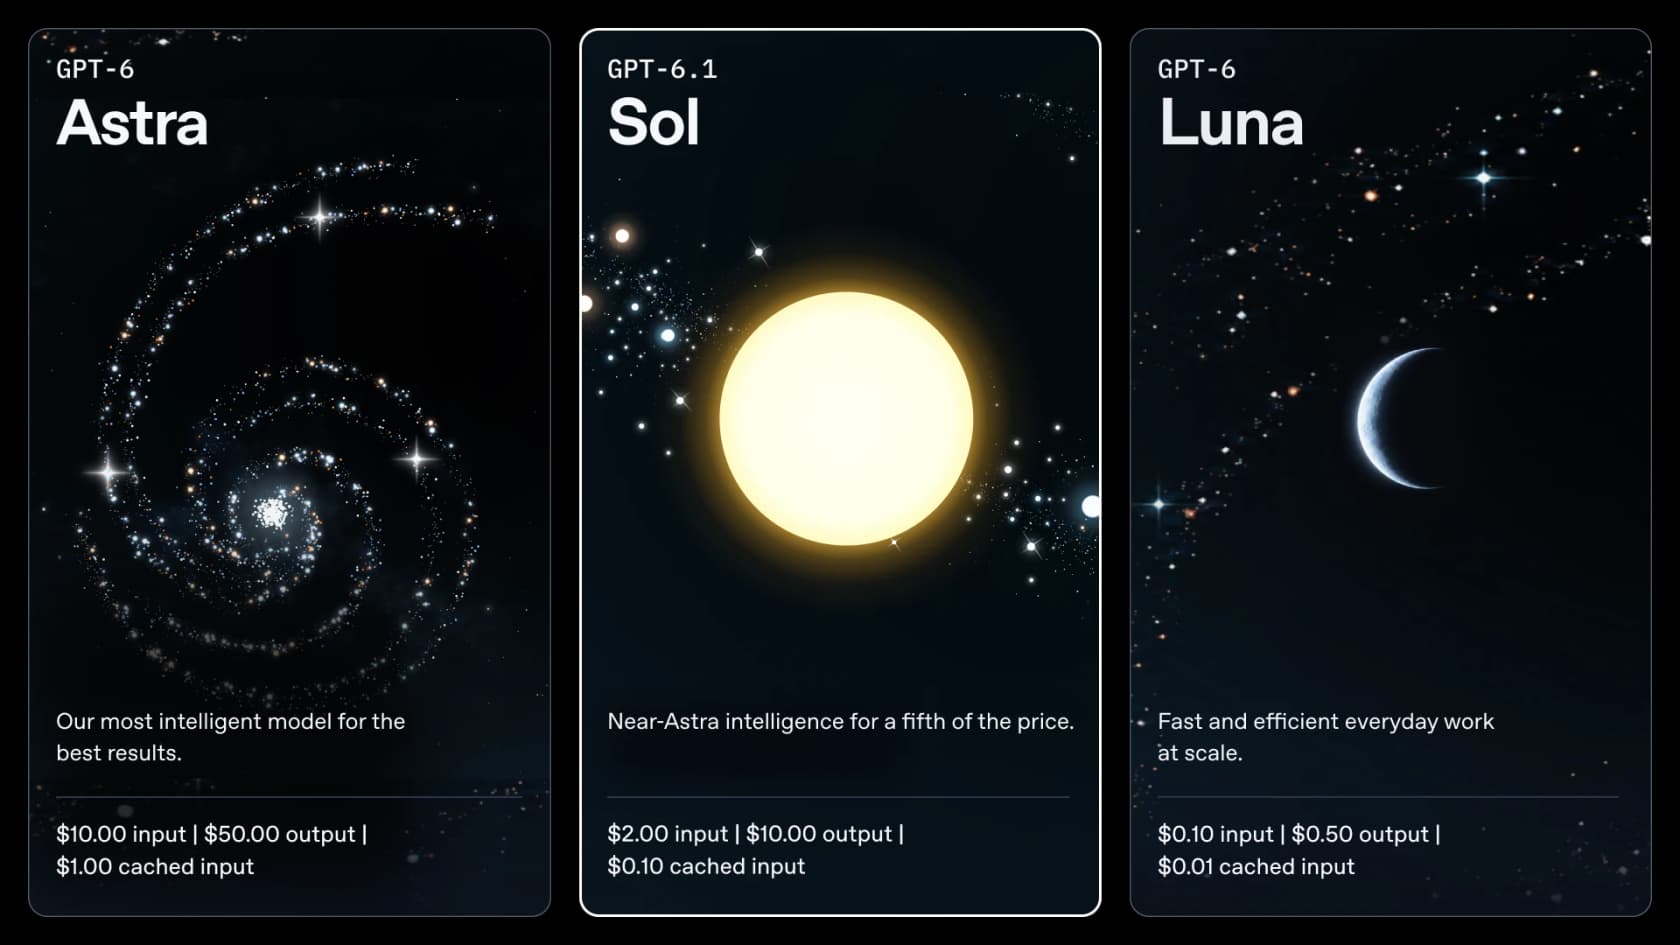
Esta es la tarifa completa del nivel estándar, con ambas bandas de contexto:
| Nivel estándar (por 1M de tokens) | Contexto corto (hasta 272K de entrada) | Contexto largo (más de 272K de entrada) |
|---|---|---|
| Entrada | $2.00 | $4.00 |
| Entrada en caché | $0.10 | $0.20 |
| Escrituras en caché | $2.50 | $5.00 |
| Salida (incluye razonamiento) | $10.00 | $15.00 |
Fuente: precios de la API de OpenAI, revisado de nuevo el 1 de octubre de 2026. La página del modelo detalla las proporciones detrás de esas cifras: la entrada en caché es el 5 % de la tarifa sin caché, las escrituras en caché son 1.25x, y los prompts largos cuestan "2x input and cache rates and 1.5x output for the full request."
Es el modelo intermedio de la gama de modelos de OpenAI, y unos cuantos detalles técnicos importan cuando empiezas a presupuestar. El id del modelo es gpt-6.1-sol, con una ventana de contexto de 1,050,000 tokens y 128,000 tokens de salida máxima. La API no tiene nivel gratuito, así que el Tier 1 (500 solicitudes y 500,000 tokens por minuto) es el mínimo.
Qué cambió respecto a los precios de GPT-6 Sol
Sobre el papel, casi nada. Esta es toda la diferencia:
| Concepto | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| Entrada (por 1M) | $2.00 | $2.00 |
| Entrada en caché | $0.20 | $0.10 |
| Salida | $10.00 | $10.00 |
| Esfuerzo de razonamiento mínimo | none | low |
| Tokens de salida por tarea (AA, max) | 31.1K | 38.1K |
| Coste por tarea (AA, max) | $1.05 | $0.72 |
Fuentes: precios de la API de OpenAI, Artificial Analysis. El artículo de precios de GPT-6 Sol cubre el panorama completo de la semana pasada.
Dos de estas cifras tiran en direcciones opuestas. GPT-6.1 Sol escribe más salida. Artificial Analysis midió "~10-30% more output tokens than GPT-6 Sol" en todos los niveles de esfuerzo. Aun así, resultó un 31 % más barato por tarea con esfuerzo máximo, porque termina el trabajo con menos ejecuciones fallidas y su entrada en caché cuesta la mitad. Paridad por token no es paridad por tarea. Aquí, al menos, la cifra por tarea se movió a tu favor.
El cambio que sí puede subir una factura es el suelo de razonamiento. GPT-6 Sol permitía trabajar con esfuerzo none, lo que significaba cero tokens de razonamiento. En 6.1 Sol, la página del modelo dice que none y minimal "are not supported", así que low es el ajuste más barato. Si tenías un clasificador de gran volumen en none, ahora facturará algo de salida de razonamiento en cada llamada, así que lo probaría antes de cambiar el id del modelo.
El recorte de la entrada en caché es el verdadero cambio de precio
Esta es la parte de los precios de GPT-6.1 Sol que debería haber sido el titular, y la gente del hilo del día del lanzamiento lo vio enseguida:
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

El motivo es sencillo. Los agentes reenvían el mismo material en cada llamada: el prompt de sistema, las definiciones de herramientas y un historial de conversación que no deja de crecer. Ese prefijo repetido se almacena en caché. En un agente de larga duración, casi toda la entrada se factura entonces a la tarifa de caché y no a los $2 de lista. Así que tu precio real de entrada es una mezcla, y lo que fija la mezcla es sobre todo tu porcentaje de aciertos de caché.
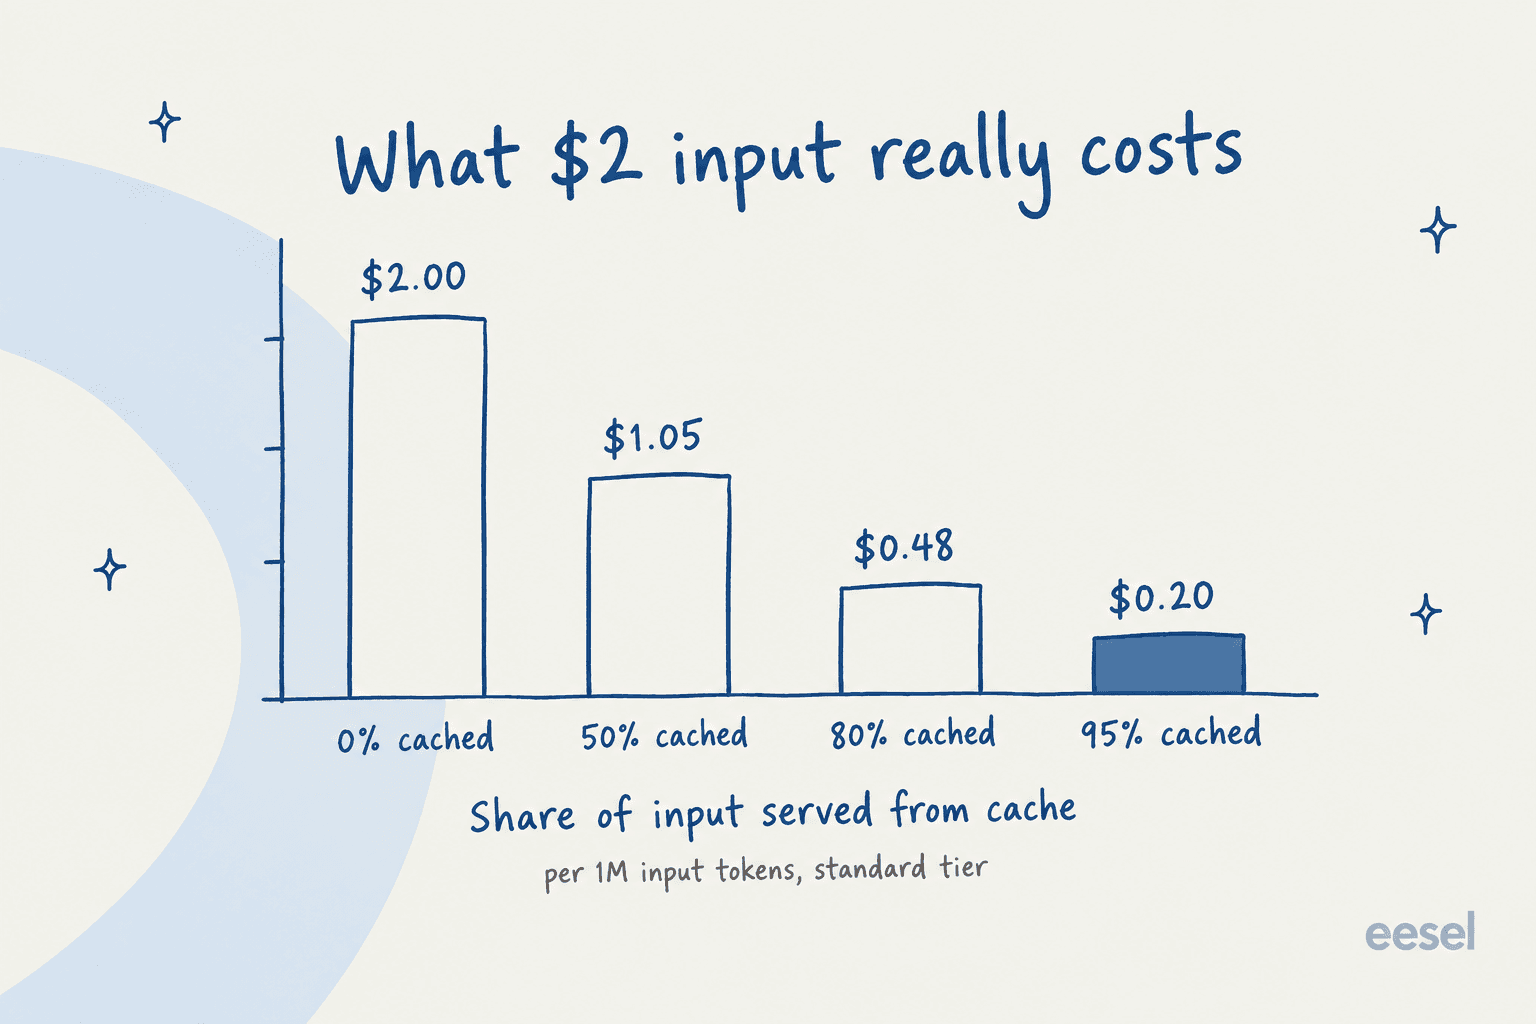
Haz la misma cuenta con toda la familia y verás cuánto amplió el recorte de caché la distancia con el modelo estrella:
| Porcentaje de entrada en caché | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 0% | $2.00 | $2.00 | $10.00 |
| 50% | $1.05 | $1.10 | $5.50 |
| 80% | $0.48 | $0.56 | $2.80 |
| 95% | $0.20 | $0.29 | $1.45 |
Precio efectivo de entrada por 1M de tokens, nivel estándar, calculado a partir de la tarifa de OpenAI. Con un 80 % de aciertos de caché, la entrada de GPT-6.1 Sol cuesta alrededor de una sexta parte que la de Astra, y el artículo de precios de GPT-6 Astra tiene la tarjeta completa del modelo estrella. Hay dos salvedades. Las escrituras en caché cuestan $2.50 por millón, 1.25x la tarifa normal de entrada, lo que significa que la primera llamada que almacena un prefijo cuesta algo más que una sin caché. Además, la caché solo ayuda mientras el prefijo sea idéntico byte a byte. Pon una marca de tiempo al principio de tu prompt de sistema y el descuento cae a cero sin avisar.
Niveles de servicio: Batch, Flex, Fast y el Ultrafast que falta
Es un solo modelo con cuatro precios, y el nivel que elijas mueve la factura más que cualquier ajuste del prompt:
| Nivel (por 1M, contexto corto) | Entrada | Entrada en caché | Escrituras en caché | Salida | Entrada / salida en contexto largo |
|---|---|---|---|---|---|
| Batch | $1.00 | $0.05 | $1.25 | $5.00 | $2.00 / $7.50 |
| Flex | $1.00 | $0.05 | $1.25 | $5.00 | $2.00 / $7.50 |
| Standard | $2.00 | $0.10 | $2.50 | $10.00 | $4.00 / $15.00 |
| Fast | $4.00 | $0.20 | $5.00 | $20.00 | $8.00 / $30.00 |
| Ultrafast | Próximamente |
Fuente: precios de la API de OpenAI. Qué significa cada uno en la práctica:
- Batch y Flex cuestan la mitad que el estándar. Batch es para trabajos que envías y recoges más tarde; Flex es para solicitudes que no te importa que vayan más lentas. Si un trabajo no necesita respuesta en segundos, va aquí.
- Fast duplica el precio a cambio de menor latencia. La página de precios señala que el procesamiento prioritario "was renamed Fast mode on July 30, 2026."
- Ultrafast no está disponible para Sol. El resumen del DevDay dice "GPT-6.1 Sol Ultrafast is coming soon." Hoy solo GPT-6 Astra tiene precio Ultrafast, a $60/$300 por millón.
- La residencia de datos añade un 10 %. Los endpoints de procesamiento regional llevan un recargo del 10 % para los modelos lanzados después del 5 de marzo de 2026, y la página del modelo añade que Fast no está disponible con residencia de datos en la UE.
Al combinarlos es donde el ahorro se nota de verdad. Un trabajo apto para batch con un prefijo grande en caché funciona a $1 de entrada, $0.05 en caché y $5 de salida. Frente a la tarifa estándar de Astra, eso es un 90 % menos solo en salida.
El precipicio de los 272K
La regla del contexto largo es la línea más fácil de pasar por alto de la tarifa. También es la más cara si tropiezas con ella. Cuando un prompt pasa de 272K tokens de entrada, toda la solicitud se factura a la tarifa larga, no solo los tokens que superan el límite.
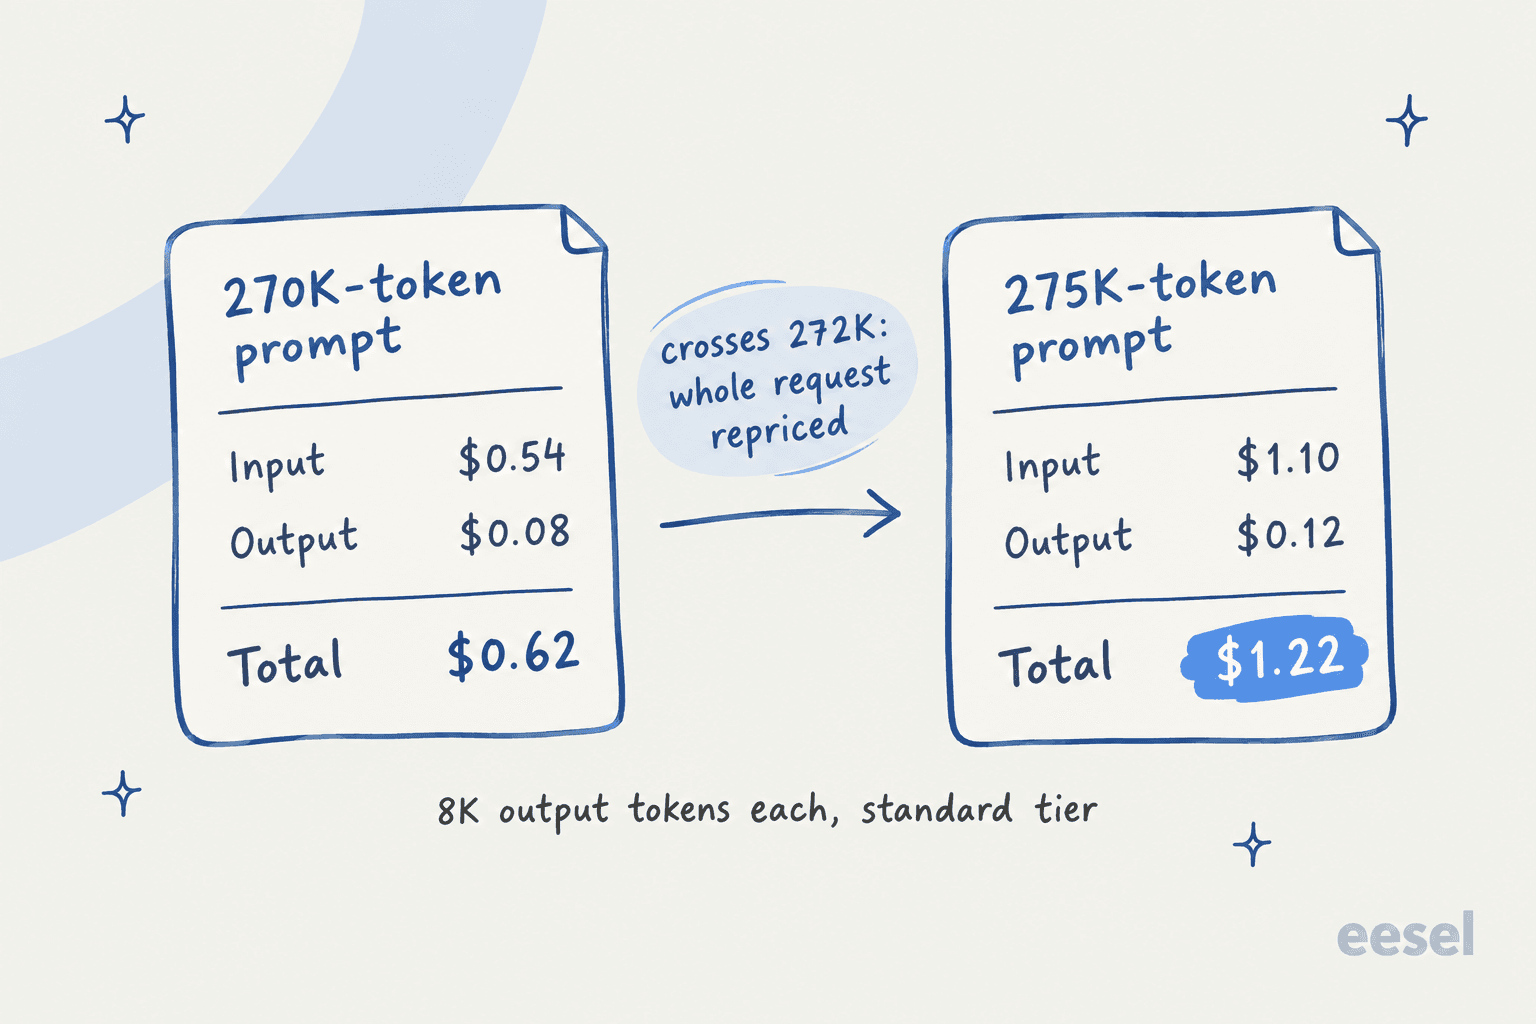
Esa imagen es toda la trampa: 5,000 tokens de entrada extra casi duplican la solicitud, de $0.62 a $1.22. La ventana de 1,050,000 tokens es real. Solo que tiene un escalón de precio a un cuarto del camino. Quien haga análisis de documentos o tareas de programación sobre repositorios enteros debería comprobar dónde caen sus prompts. Dividir un trabajo de 400K en dos llamadas de 200K suele salir mejor que enviarlo entero. Un sistema de recuperación que solo envíe los fragmentos relevantes gana a ambas.
Coste por tarea: el número que de verdad importa
Una tarifa por token te da el precio del combustible. No te dice cuánto combustible necesita el viaje. Con modelos de razonamiento, ese segundo número puede variar más de 5x según el esfuerzo, y por eso presupuesto a partir de él.
Artificial Analysis ejecutó su Intelligence Index completo una vez por cada nivel de esfuerzo:
| Esfuerzo | Intelligence Index | Coste por tarea | Tokens de salida por tarea | Tiempo por tarea |
|---|---|---|---|---|
| low | 42.1 | $0.13 | 4.0K | 56s |
| medium | 47.8 | $0.21 | 8.1K | 131s |
| high | 50.2 | $0.32 | 13.2K | 205s |
| xhigh | 51.0 | $0.39 | 17.6K | 271s |
| max | 51.8 | $0.72 | 38.1K | 569s |
Fuente: Artificial Analysis. Cerca de la cima, la curva se queda casi plana. Pasar de xhigh a max casi duplica el coste, y a cambio recibes 0.8 puntos.
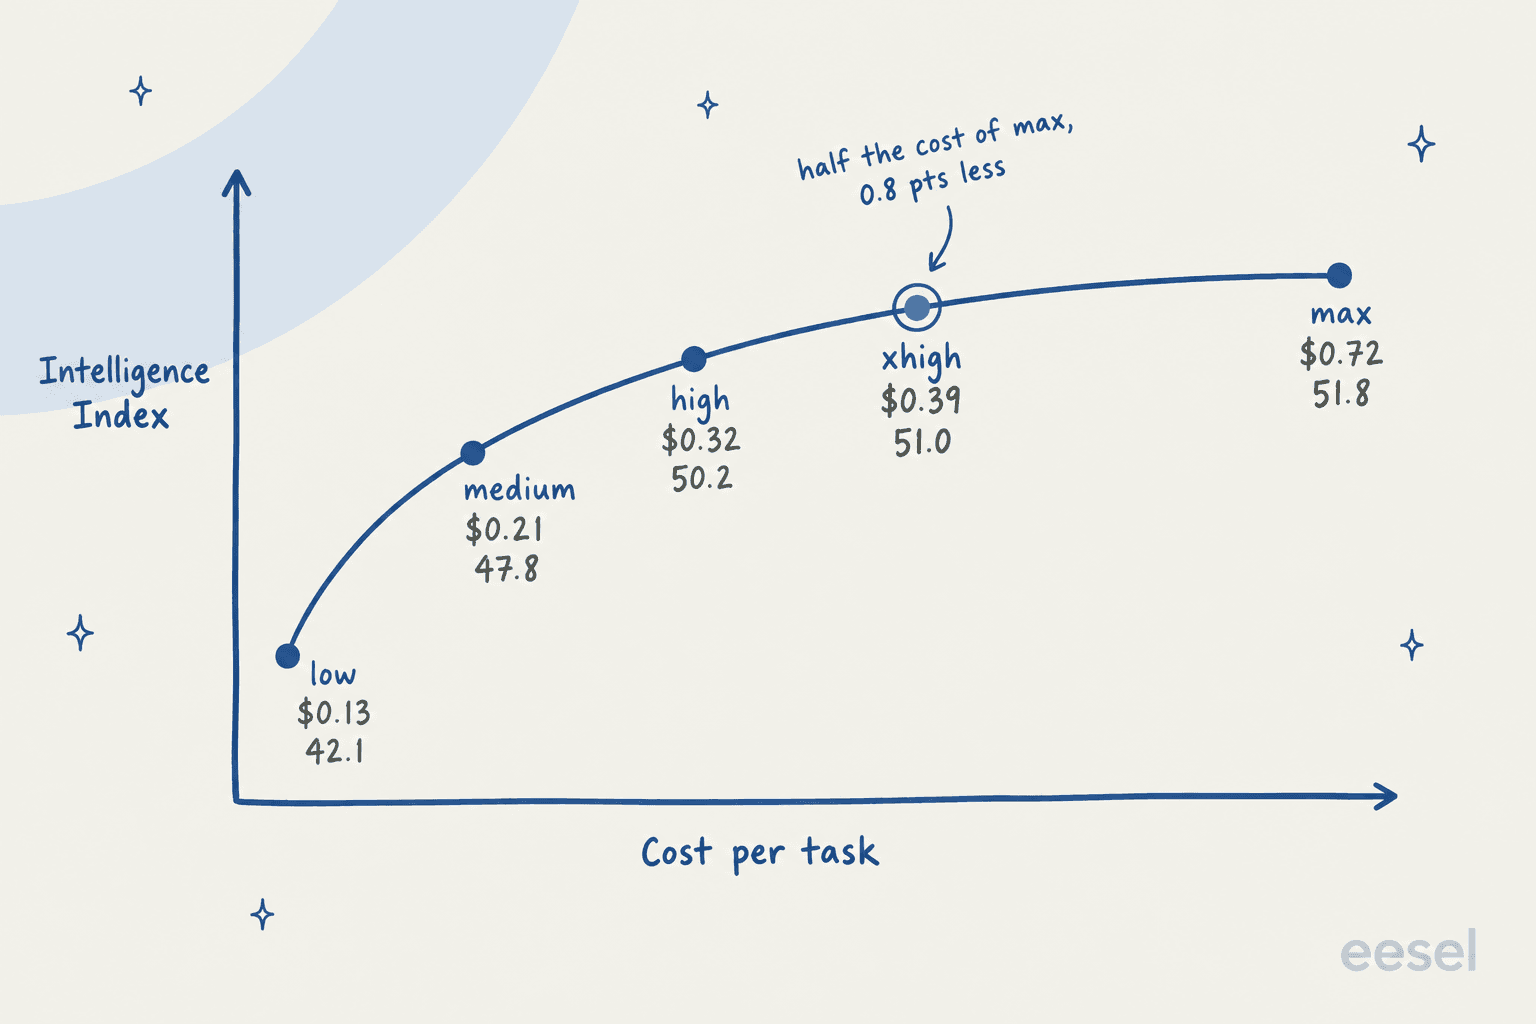
Para programación, xhigh queda aún mejor. Artificial Analysis informó de que xhigh superó a max por 3 puntos en su Coding Agent Index, quedando 1 punto por encima de GPT-6 Astra "for less than 15% of the Cost per Task." Mi punto de partida es medium para el trabajo diario y xhigh para agentes de programación. Solo recurriría a max cuando una prueba demuestre que compensa el coste extra.
Mirar por tarea también reordena cómo se comparan los modelos de aspecto barato. Un desarrollador del hilo del lanzamiento lo señaló con cifras de Artificial Analysis:
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens, making the Chinese models come out costlier and slower per actual task performed end-to-end."
Comprobé las cifras de ese comentario con Artificial Analysis y se sostienen: 6.1 Sol en medium sale a $0.21 por tarea con 8.1K tokens de salida, mientras que el comentarista cita a DeepSeek V4.1 Flash en max con $0.27 y 89K tokens generados.
Las partidas que no aparecen en la tarifa
Algunos costes viven fuera de la tabla por token, y todos aparecen en facturas reales:
- Los tokens de razonamiento son salida. Cada token de razonamiento se factura a la tarifa de salida de $10. En
max, Artificial Analysis midió 38.1K tokens de salida por tarea, y casi todo es pensamiento, no respuesta. - Las herramientas integradas tienen sus propios precios. En la página de precios, la búsqueda web cuesta $10 por 1,000 llamadas más los tokens de contenido de búsqueda a tarifas del modelo, las llamadas a la herramienta de búsqueda de archivos cuestan $2.50 por 1,000, y los contenedores de shell alojado o intérprete de código van desde $0.03 por sesión de 20 minutos (1 GB) hasta $1.92 (64 GB).
- Llamar a herramientas requiere la Responses API. La página del modelo dice que Chat Completions funciona "without tool calling." No es una línea de la factura, pero migrar código de agentes antiguo sigue costando tiempo de ingeniería.
- Los marketplaces en la nube facturan por separado. Si ejecutas modelos de OpenAI a través de Amazon Bedrock o Microsoft Azure, esos servicios fijan y facturan la tarifa, según la página de precios de OpenAI.
Estima tu factura de GPT-6.1 Sol
Introduce aquí la forma de tu propio tráfico, desde solicitudes al mes y tokens por solicitud hasta tu porcentaje de caché y el nivel. Si una solicitud supera los 272K, el estimador cambia solo a la tarifa de contexto largo. También muestra cuánto costaría el mismo tráfico en GPT-6 Astra y GPT-6 Luna.
De entrada, los valores por defecto modelan un agente de programación con un prefijo grande en caché. Baja el deslizador de caché a cero y la línea de entrada se dispara. Después, pon los tokens de salida en 20,000 y verás lo que cuesta el hábito de usar esfuerzo max. La mayoría de las veces, el dinero se va en la salida. Para imagen, audio y modelos antiguos, la guía de precios de la API de OpenAI tiene el resto del catálogo.
Ejemplos de cálculo en tres tamaños
Las tarifas de lista cobran sentido cuando les pones una forma de tráfico real. Estos son tres casos que me encuentro a menudo, todos calculados a partir de la tarifa. Los conteos de tokens son suposiciones mías a modo de ilustración, no mediciones, así que mete tus propios números en el estimador de arriba.
| Carga de trabajo | Forma del tráfico | GPT-6.1 Sol | Comparación |
|---|---|---|---|
| Bucle de agente de programación | 30,000 llamadas/mes, 60K de entrada (50K en caché), 3K de salida, estándar | $1,650/mes | Astra: $9,000. GPT-6 Sol: $1,800 |
| Extracción nocturna de documentos | 20,000 documentos/mes, 40K de entrada (sin caché), 2K de salida, Batch | $1,000/mes | El mismo trabajo en estándar: $2,000 |
| Triaje de tickets de soporte | 100,000 tickets/mes, 2.5K de entrada (2K en caché), 600 de salida, estándar | $720/mes | Luna: $37. Astra: $3,700 |
Varias cosas destacan en esta tabla:
- El agente de programación es sobre todo una factura de salida. De los $1,650, $900 son salida y solo $150 son los 1.5 mil millones de tokens de entrada en caché. Frente a GPT-6 Sol, el recorte de caché ahorró $150 al mes. El resto depende del ajuste de esfuerzo.
- Batch es la línea más barata que jamás cambiarás. Cambias un parámetro y el trabajo de extracción cuesta la mitad, sin cambio de calidad.
- El triaje es trabajo para Luna. Para etiquetas cortas y de poco riesgo a gran volumen, GPT-6 Luna hace lo mismo por cerca del 5 % del precio. Reservaría Sol para las respuestas que tienen que ser correctas. El artículo de precios de GPT-6 Luna tiene su tarifa completa.
Precios de GPT-6.1 Sol en ChatGPT y Codex
Usar GPT-6.1 Sol mediante una suscripción en lugar de la API funciona distinto: pagas un precio mensual fijo y vas consumiendo una asignación. OpenAI dice que está disponible "to all Plus, Pro, Business, Enterprise, and Edu users in ChatGPT Work and Codex," y "not yet available in Chat."
| Plan | Precio mensual | GPT-6.1 Sol | Notas |
|---|---|---|---|
| Free | $0 | No | GPT-5.6 Luna para el chat diario |
| Go | $8 | No | Puede incluir anuncios |
| Plus | $20 | Sí | Uso ampliado de Codex |
| Pro 100 | $100 | Ampliado | Sin Ultrafast |
| Pro 200 | $200 | Ampliado | Más uso que Pro 100 |
| Pro 500 | $500 | Ampliado | Mayor asignación, incluye Ultrafast |
| Business / Enterprise / Edu | Por usuario | Sí | En ChatGPT Work y Codex |
Fuentes: precios de ChatGPT, About ChatGPT Pro tiers y la publicación del lanzamiento. La guía de precios de ChatGPT cubre todos los planes, precios de ChatGPT Work profundiza en Work, y ChatGPT Enterprise trata los acuerdos por usuario.
Las suscripciones traen una pega que la API no tiene. La página de ayuda de Pro de OpenAI dice que las nuevas suscripciones Pro 200 "include a lower usage allowance than previously offered", y que los suscriptores actuales conservan la asignación anterior solo hasta el 29 de octubre de 2026. El resumen del DevDay sitúa a Pro 500 en "25 times the ChatGPT Plus allowance." Al llegar al límite, la misma página de ayuda dice que el uso elegible de Codex y ChatGPT Work puede consumir créditos comprados.
Algunos primeros usuarios calcularon qué significa eso para Codex:
"They have also cut allowances for subscriptions in half. So even in the best case scenario it's about 2.5 times cheaper for Codex users."
Es la estimación de un usuario, no una cifra de OpenAI. Aun así, es una advertencia razonable. Un modelo 5x más barato que Astra en la API no se convierte en 5x más trabajo dentro de un plan. Si vives en Codex, vigilaría tu propio medidor de uso durante una semana antes de contar con el ahorro.
Cómo se comparan los precios de GPT-6.1 Sol
En precio de lista, GPT-6.1 Sol iguala exactamente a Claude Sonnet 5.5 y queda muy por debajo de todo lo que está por encima:
| Modelo | Entrada / salida (por 1M) | Acierto de caché | Coste por tarea (AA) | Intelligence Index (AA) |
|---|---|---|---|---|
| GPT-6 Luna | $0.10 / $0.50 | $0.01 | n/d | n/d |
| GPT-6.1 Sol (medium) | $2 / $10 | $0.10 | $0.21 | 47.8 |
| GPT-6.1 Sol (max) | $2 / $10 | $0.10 | $0.72 | 51.8 |
| Claude Sonnet 5.5 (high) | $2 / $10 | $0.20 | $1.08 | 47 |
| Claude Opus 5.5 (medium) | $4 / $20 | $0.20 | $1.34 | 51 |
| GPT-6 Astra (max) | $10 / $50 | $1.00 | $3.26 | 52.7 |
| Claude Opus 5.5 (max) | $4 / $20 | $0.20 | $5.98 | 58 |
Fuentes: precios de OpenAI, precios de Anthropic y Artificial Analysis para el coste por tarea y las puntuaciones.
Mi lectura tiene dos partes. Con la misma puntuación, GPT-6.1 Sol es mucho más barato por tarea: 47.8 por $0.21 frente a 47 por $1.08 de Sonnet 5.5, y 51.8 en max por cerca de la mitad de lo que cobra Opus 5.5 en medium por 51. Artificial Analysis lo dijo claro: "for a given level of intelligence, there is no cheaper model."
Lo que no hace es llegar a lo más alto. Opus 5.5 y Sonnet 5.5 en max puntúan más, y en una comparación práctica del hilo del lanzamiento, un desarrollador encontró que Opus 5.5 "executes a bit better" en el pulido final. Eso hace que la elección dependa de la puntuación que necesites, no del precio de lista. Si con 48 a 52 en este índice te basta para tu trabajo, GPT-6.1 Sol es la forma más barata de llegar. ¿Necesitas lo más alto de la tabla? Lo pagarás en otro sitio. La comparación de la API de OpenAI frente a la de Anthropic profundiza en ese equilibrio.
Qué significan los precios de GPT-6.1 Sol para un equipo de soporte
Esta parte va contra la intuición. En una cola de soporte, un modelo más barato es la partida más pequeña del proyecto, mientras que la factura de tokens es la más difícil de predecir.
Piensa en lo que mueve las cifras anteriores: longitud del prompt, porcentaje de aciertos de caché, esfuerzo de razonamiento, reintentos, llamadas a herramientas y si un prompt cruzó los 272K. Ninguno de ellos se traduce en "tickets gestionados". Un responsable de soporte no puede darle a finanzas un presupuesto que diga "entre $400 y $2,000 según lo charlatán que sea el modelo". Sale en evaluaciones reales de eesel. Un comprador en Freshdesk llegó a 200 interacciones en un solo día de prueba y enseguida empezó a proyectar el coste en 9,000 al mes. Lo que le preocupaba no era la tarifa. Era no saber el total.
Luego está la tentación de construirlo uno mismo, que se hace más fuerte cada vez que un modelo se abarata. Un cliente de gama media que se fue, tras una integración rota, a una herramienta más barata lo expresó así en una respuesta al fundador de eesel:
"We switched to a system [...] that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Es un plan razonable, y GPT-6.1 Sol a $2/$10 abarata de verdad la parte del modelo. Pero el modelo nunca fue la parte cara. El trabajo está en la capa que lo rodea: entrenar con tus tickets pasados, conectar el helpdesk que ya usas, acciones seguras y probar las respuestas con el historial real antes de salir en producción. Si te preocupan las alucinaciones, el remedio también está en esa capa, no en la tarifa. Por eso los mejores agentes de IA para soporte son flexibles con el modelo: cuando sale uno más barato, lo heredas en lugar de reconstruir. El desglose del coste de los agentes de IA muestra a dónde va realmente ese dinero.
Prueba eesel
Si lo que de verdad quieres de GPT-6.1 Sol son menos tickets en la cola, no necesitas ponerle precio a los tokens. eesel es una plataforma de compañeros de IA, y el compañero de IA para helpdesk es el que sirve para este trabajo. GPT-6.1 Sol es infraestructura; eesel es el empleado. Aprende de tus tickets pasados y tu centro de ayuda, se conecta a Zendesk, Freshdesk, Gorgias y los demás helpdesks que ya usas, y ejecuta una simulación con tus tickets pasados reales para que compares sus respuestas con lo que tu equipo envió de verdad.
La facturación funciona al revés que un contador de tokens. Los precios de eesel son un plan mensual fijo de créditos, desde $299 por 500 créditos, donde un ticket o chat gestionado es un crédito. Incluye todas las funciones y usuarios ilimitados, y un plan gratuito te da 100 créditos sin tarjeta. Sea cual sea el modelo que funcione por debajo, tu factura de automatización de soporte es el mismo número cada mes.
Como este es un artículo de precios para desarrolladores, queda una cosa más que señalar. La CLI de eesel opera desde una terminal el mismo compañero y el mismo espacio de trabajo que el panel. Puedes conectar un helpdesk con eesel integrations connect, leer cada ejecución con eesel activity y poner las acciones de riesgo tras eesel approvals. Todos los comandos imprimen JSON, y --dry-run muestra la llamada exacta que haría una escritura antes de enviarla. Además, cada espacio de trabajo es un servidor MCP, así que una sesión de Codex con GPT-6.1 Sol puede manejar a tu compañero de soporte como herramienta, con el mismo patrón que cualquier configuración de MCP para soporte. Tienes el control por scripts que querrías de un agente que construyas tú mismo, con una facturación por ticket que sí puedes meter en un presupuesto.
Preguntas frecuentes
¿Cuánto cuesta GPT-6.1 Sol en la API?
¿Es GPT-6.1 Sol más caro que GPT-6 Sol?
¿Cuál es el precio de contexto largo de GPT-6.1 Sol?
¿Es GPT-6.1 Sol gratis en ChatGPT?
¿Cuánto cuesta GPT-6.1 Sol en Codex?
¿Cuánto cuesta GPT-6.1 Sol por tarea?
¿Es GPT-6.1 Sol más barato que Claude Sonnet 5.5?
¿Qué significan los precios de GPT-6.1 Sol para un equipo de soporte?

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.