Precios de la API de GPT-6 Astra: el nivel estándar
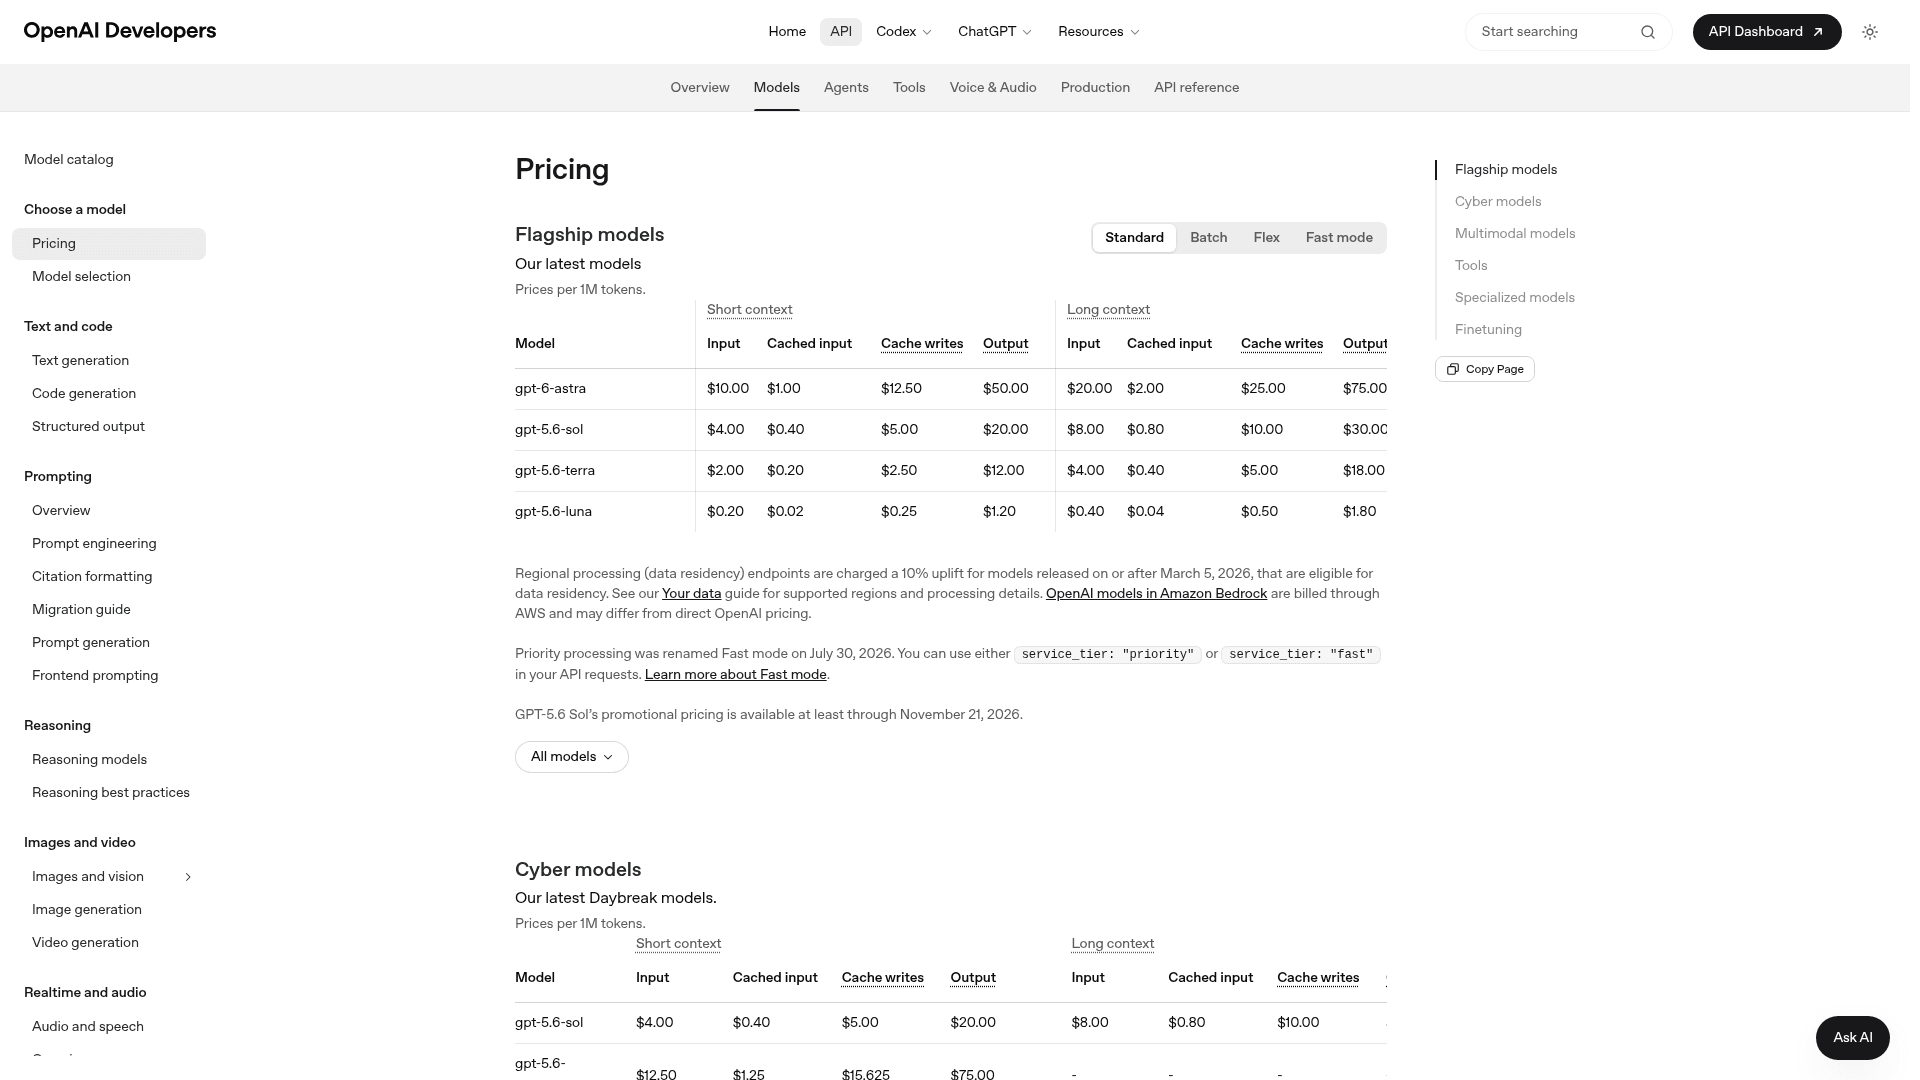
Aquí está el número por el que vino la mayoría. En la página de precios de la API, el precio estándar de GPT-6 Astra es $10,00 por millón de tokens de entrada y $50,00 por millón de tokens de salida. La entrada en caché baja a $1,00, y las escrituras en caché son $12,50 por millón.
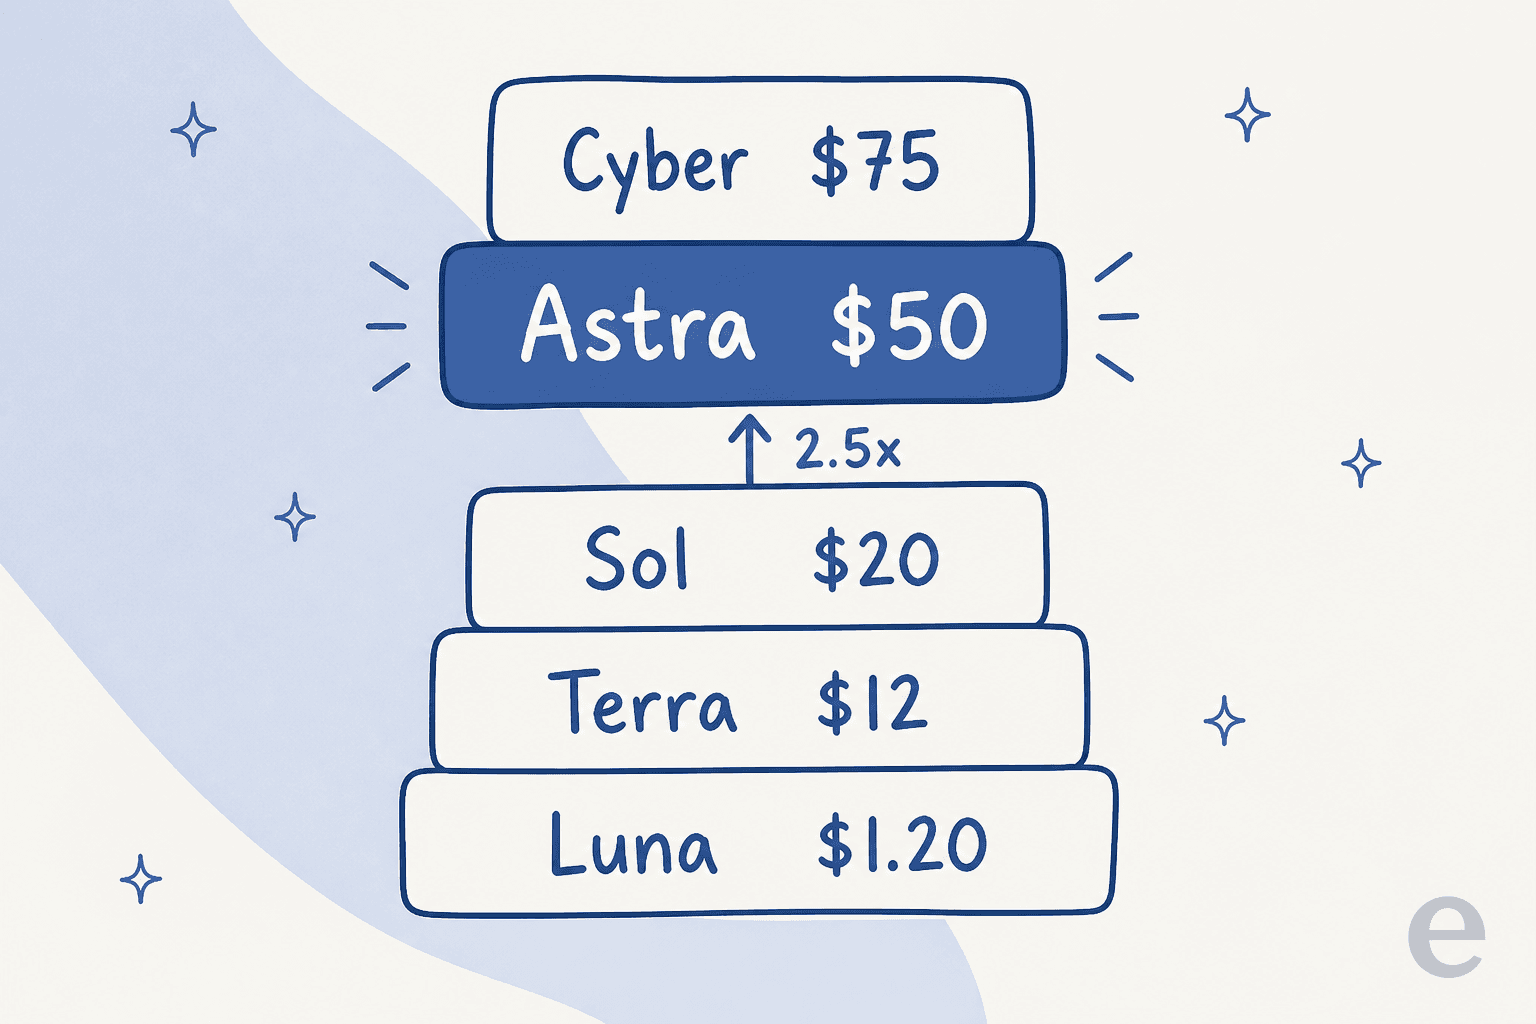
Para ponerlo en contexto, es un salto real respecto al resto de la gama de modelos de OpenAI. Astra es ahora el segundo modelo más caro que vende OpenAI, solo por detrás del especialista gpt-5.6-cyber. Así se posiciona cada modelo insignia en el nivel estándar de contexto corto:
| Modelo | Entrada (por 1M) | Entrada en caché | Salida (por 1M) | Posición |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Nuevo insignia |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Insignia anterior (promo) |
| gpt-5.6-terra | $2.00 | $0.20 | $12.00 | Gama media |
| gpt-5.6-luna | $0.20 | $0.02 | $1.20 | Más barato |
| gpt-5.6-cyber | $12.50 | $1.25 | $75.00 | Especialista (Daybreak) |
Fuente: Precios de la API de OpenAI. Un detalle con fecha que vale la pena precisar: el $4/$20 de GPT-5.6 Sol es precio promocional garantizado al menos hasta el 21 de noviembre de 2026, así que la brecha del "2,5x" se mide frente a un descuento que puede no durar.
Esa paridad de precio con Fable 5.1 de Anthropic no pasó desapercibida para los profesionales. Como dijo un comentarista de Hacker News, OpenAI "finalmente encontró la manera de dejar de vender barato y ganar dinero con clientes de alta demanda, como hace Anthropic". La consecuencia más silenciosa que algunos notaron: con ambos laboratorios punteros ahora en $10/$50, la opción de comparar precios entre ellos simplemente desapareció.
Niveles de servicio: la variación de 4x que casi todos pasan por alto
La tarifa estándar es un punto de partida, no toda la historia. GPT-6 Astra funciona en cuatro niveles de servicio, y la diferencia entre el más barato y el más caro es de 4 veces para exactamente el mismo modelo. Esta es la palanca más grande que tienes sobre el coste, más importante que cualquier optimización de prompt.
| Nivel | Entrada (por 1M) | Entrada en caché | Salida (por 1M) | Compensación |
|---|---|---|---|---|
| Batch | $5.00 | $0.50 | $25.00 | 50% menos, asíncrono, hasta 24h |
| Flex | $5.00 | $0.50 | $25.00 | 50% menos, más lento, puede encolarse |
| Standard | $10.00 | $1.00 | $50.00 | Latencia por defecto |
| Fast mode | $20.00 | $2.00 | $100.00 | 2x, latencia mínima |
Fuente: Precios de la API de OpenAI. Algunas cosas a saber antes de elegir uno:
- Batch y Flex cuestan lo mismo, pero sirven para tareas distintas. Batch es para cargas de trabajo asíncronas que envías y recoges después; Flex es para solicitudes interactivas que aceptas que corran más lento o se encolen. Ambos reducen tu factura a la mitad.
- El modo Fast fue renombrado desde Priority el 30 de julio de 2026. Aún puedes pasar
service_tier: "priority"oservice_tier: "fast". Duplica la tarifa para conseguir la menor latencia. - El modo Fast tiene una trampa regional. No está disponible para GPT-6 Astra con residencia de datos en la UE; esas solicitudes vuelven al nivel estándar.
Si una carga de trabajo puede tolerar latencia, cambiarla por defecto a Batch o Flex reduce efectivamente tu gasto en Astra a la mitad sin cambiar la calidad de la salida. Eso es lo primero que revisaría en cualquier pipeline de alto volumen.
Las trampas: contexto largo y recargo regional
Dos recargos se esconden en la letra pequeña de la página del modelo, y ambos pueden reconfigurar un presupuesto sin que te des cuenta.
Primero, el contexto largo se factura a una tarifa más alta para toda la solicitud. La ventana de contexto de Astra es enorme, 1.050.000 tokens, pero cualquier prompt de más de 272K tokens de entrada convierte toda la solicitud a la tarifa de contexto largo: $20 por millón de entrada y $75 por millón de salida en el nivel estándar. Eso es 2 veces la entrada y 1,5 veces la salida, y se aplica a cada token de la solicitud, no solo a los que superan el umbral.
| Nivel estándar | Contexto corto (≤272K) | Contexto largo (>272K) |
|---|---|---|
| Entrada (por 1M) | $10.00 | $20.00 |
| Entrada en caché | $1.00 | $2.00 |
| Salida (por 1M) | $50.00 | $75.00 |
Segundo, el procesamiento regional conlleva un recargo del 10%. Los endpoints de residencia de datos para modelos lanzados a partir del 5 de marzo de 2026 se cobran un 10% más. Si estás obligado a una región específica por cumplimiento normativo, ten esto en cuenta además de todo lo demás.
Y un mínimo que conviene recordar: Astra no está en el nivel gratuito en absoluto, así que el uso de Tier 1 es el punto de entrada para desarrolladores.
Calcula tu factura de la API de GPT-6 Astra
Los precios de etiqueta son abstractos hasta que introduces tus propias cifras. Introduce los millones de tokens de entrada y salida que esperas al mes, elige un nivel de servicio, y esto calcula el coste mensual. Tiene en cuenta el recargo por contexto largo automáticamente.
El patrón que la mayoría de los equipos encuentra es que los tokens de salida dominan la factura, ya que la salida cuesta 5 veces la tarifa de entrada. Si tu carga de trabajo genera respuestas largas, ahí es donde va el dinero, y ahí es donde cambiar un trabajo compatible con lotes al nivel Batch se rentabiliza más rápido.
Precios de GPT-6 Astra en ChatGPT
Si no llamas a la API, GPT-6 Astra te llega a través de los planes de ChatGPT en su lugar, y la página de precios traza una línea clara sobre quién lo obtiene.
| Plan | Precio | Acceso a GPT-6 Astra |
|---|---|---|
| Free | $0 | No (solo Luna) |
| Go | $8/mes | No |
| Plus | $20/mes | Sí |
| Pro | Desde $100/mes | Ampliado, más una variante Pro |
| Business / Enterprise | Por asiento | Sí (Enterprise desactivado por defecto) |
Fuente: Precios de ChatGPT. Algunas cosas destacan:
- Astra empieza en Plus. El plan Plus de $20/mes es el punto de entrada para los usuarios de ChatGPT. Ni Free ni el plan Go de $8 lo incluyen, y los usuarios de Free están limitados a GPT-5.6 Luna.
- Pro añade margen. Pro, desde $100/mes, da 5 o 20 veces más uso y un modo de razonamiento Pro de mayor esfuerzo impulsado por Astra.
- Enterprise tiene un interruptor. En Business y Enterprise, Astra está disponible por asiento, pero al lanzamiento viene desactivado por defecto por espacio de trabajo, así que un administrador tiene que habilitarlo. Las organizaciones sin ánimo de lucro pueden obtener hasta un 75% de descuento en Business o Enterprise.
Cómo se compara el precio de GPT-6 Astra
Ampliando la vista, ¿dónde se sitúa Astra frente al resto de la frontera? En resumen, OpenAI dejó de competir por precio en la cima.
- Frente a su propia gama: a $10/$50, Astra cuesta 2,5 veces más que GPT-5.6 Sol y aproximadamente 4 veces más que GPT-5.6 Terra. Para la mayoría de las tareas cotidianas, Terra o Luna te dan la mayor parte del valor por una fracción del coste.
- Frente a Anthropic: Astra coincide exactamente con Fable 5.1 a $10/$50, así que ambos modelos insignia tienen ahora el mismo precio.
- Frente a Google: se sitúa muy por encima de los precios de Gemini en niveles comparables, y muy por encima de opciones más ligeras como Gemini 3 Flash.
La ansiedad de la comunidad por el precio tenía menos que ver con la etiqueta y más con el consumo. Un usuario con suscripción a Codex advirtió que Sol ya es "un modelo hambriento de tokens" y le preocupaba que Astra, a 2,5 veces la tarifa, agotara las cuotas más rápido. El matiz: Astra usa menos tokens por tarea agéntica, así que ambos efectos se cancelan parcialmente. Por eso el coste de un agente de IA nunca es solo la tarifa por token. El consumo es la otra mitad de la ecuación, y solo puedes verlo con tu propio tráfico.
Qué significa el precio de GPT-6 Astra si diriges un equipo de soporte
Aquí quiero ser útil en lugar de solo enumerar tarifas, porque construyo productos en este espacio y la respuesta honesta es un poco contraintuitiva.
Si diriges soporte al cliente u operaciones internas, la llegada de un modelo de frontera más potente y caro cambia menos de lo que sugieren los titulares. Un modelo en bruto como Astra es infraestructura. Es un motor espectacular, pero de fábrica no conoce tu política de reembolsos, no puede ver tus últimos 50.000 tickets, no tiene acceso a tu sistema de pedidos y no tiene una forma segura de ser probado contra tu cola real antes de empezar a responder a clientes. Se factura por token por pensar, no por problema resuelto. La mayoría confunde "el modelo se volvió más inteligente y más caro" con "mis cuentas de soporte cambiaron", y son dos proyectos distintos.
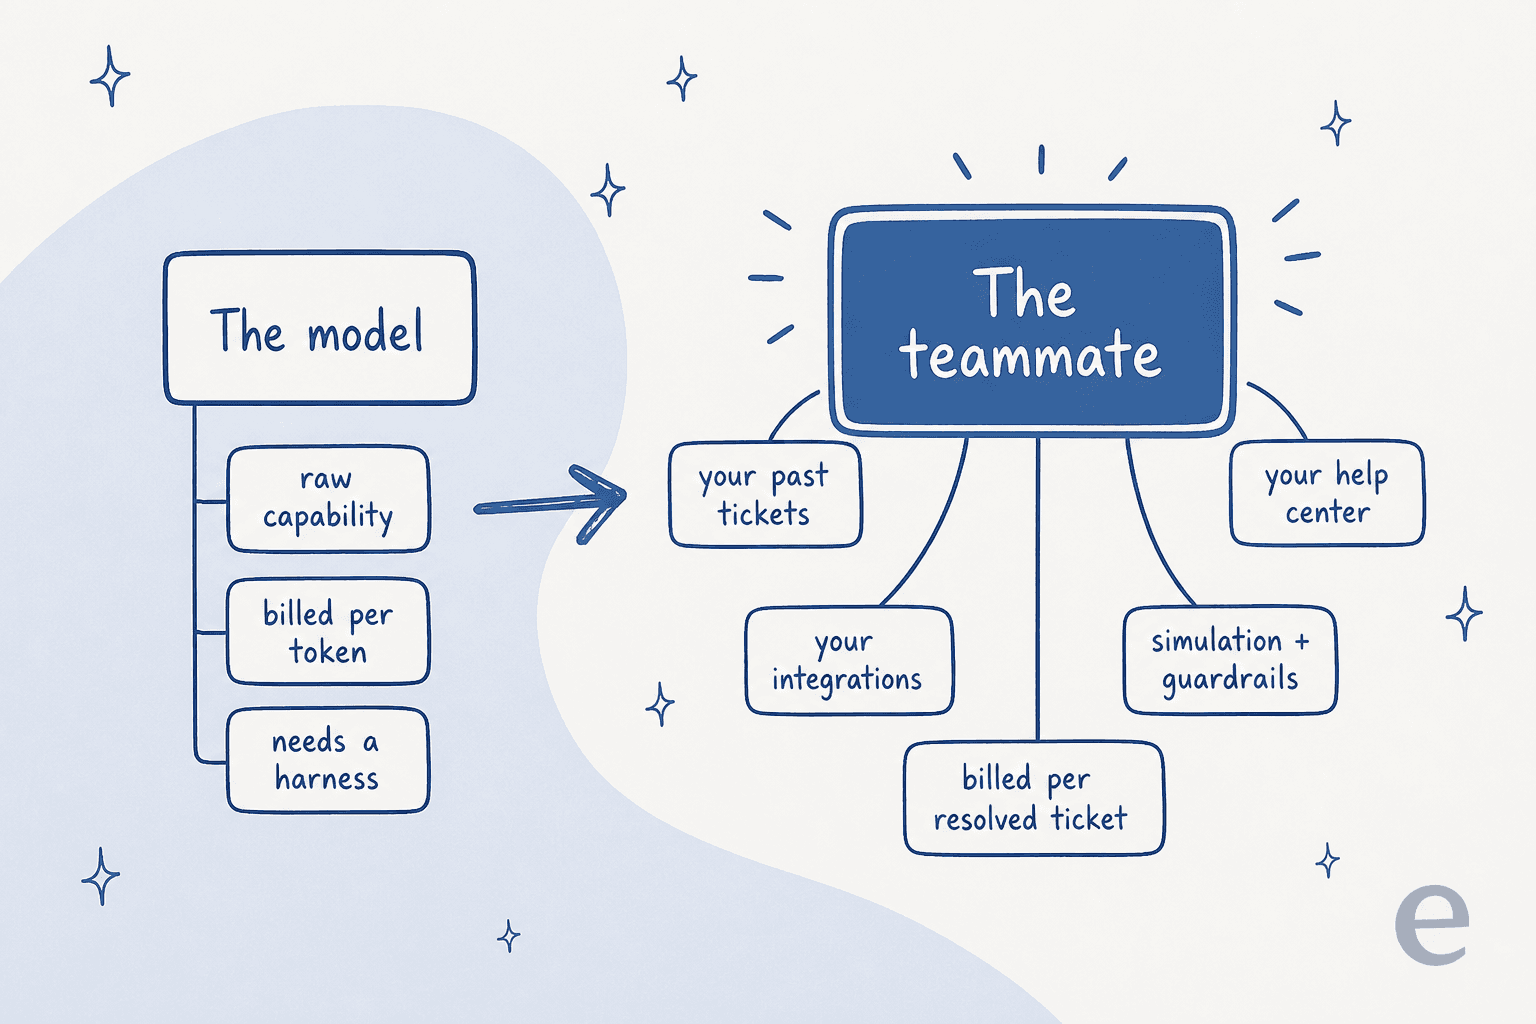
La unidad que realmente importa para un equipo de soporte es el coste por resolución, no el coste por token. Una factura de tokens es impredecible: varía con la longitud del prompt, los reintentos y lo hablador que sea el modelo un día dado. Hemos pasado años poniendo agentes de IA en colas de soporte en vivo, y la lección que se repite es que los equipos quieren saber cuánto cuesta atender un ticket, punto, no cuánto cuesta un millón de tokens de salida antes de haber averiguado cuántos tokens necesita siquiera un ticket. Esa es la brecha entre un modelo y un sistema construido a su alrededor: tu conocimiento, tus integraciones, acciones seguras y una forma de simularlo sobre tu historial antes de ponerlo en marcha.
Esta es también la razón por la que no reconstruiría tu automatización de soporte la semana en que se lanza un nuevo modelo. Los mejores agentes de helpdesk con IA y herramientas de servicio al cliente están diseñados para ser flexibles con el modelo, así que cuando llega un modelo genuinamente mejor, heredas la mejora sin reconstruir nada y sin renegociar tu presupuesto en torno a una nueva tarifa por token.
Prueba eesel
Si tu interés en el precio de Astra en realidad es "cuánto me va a costar una IA para resolver tickets de verdad", ese es el trabajo para el que está construido un compañero de equipo con IA, y ahí es donde entra eesel. GPT-6 Astra es el motor; eesel es el empleado que contratas para conducirlo. El agente de helpdesk con IA se entrena con tus tickets pasados y tu centro de ayuda, se conecta al helpdesk que ya usas en lugar de reemplazarlo, y te permite simularlo contra miles de tus tickets históricos reales para que veas exactamente cómo va a rendir, y cuánto va a costar, antes de que toque una conversación en vivo.
La facturación cuenta la historia que el precio por token de Astra no puede contar. En lugar de pagar por token por pensar, pagas 40 céntimos por ticket que realmente resuelve, sin cuotas por asiento y sin mínimo de plataforma, así que el coste sigue a los resultados en lugar de a la cháchara del modelo. Puedes empezar gratis con $50 de uso y sin tarjeta de crédito, apuntarlo a una parte de tu cola y ver las cifras de resolución en tus propios tickets, algo mucho más útil para decidir que cualquier gráfico de precio por millón de tokens.

El precio de GPT-6 Astra es un salto real, y para el uso autónomo de ordenador y trabajo de seguridad la prima puede valer la pena. Pero para la mayoría de los equipos de soporte, la tarifa por token nunca fue el número que importaba. Conseguir un compañero de equipo probado, conectado y responsable dentro de tu flujo de trabajo existente, facturado por resultado, es en lo que vale la pena gastar tu presupuesto.
Preguntas frecuentes
¿Cuánto cuesta GPT-6 Astra en la API?
¿Por qué el precio de GPT-6 Astra es más alto que el de GPT-5.6 Sol?
¿Está disponible GPT-6 Astra en el nivel gratuito?
¿Qué es el recargo por contexto largo de GPT-6 Astra?
¿Cuánto cuesta GPT-6 Astra en ChatGPT?
¿Qué cambian Batch, Flex y el modo Fast en el precio de GPT-6 Astra?
GPT-6 Astra vs GPT-5.6 Sol en precio: ¿cuál debería usar?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.