

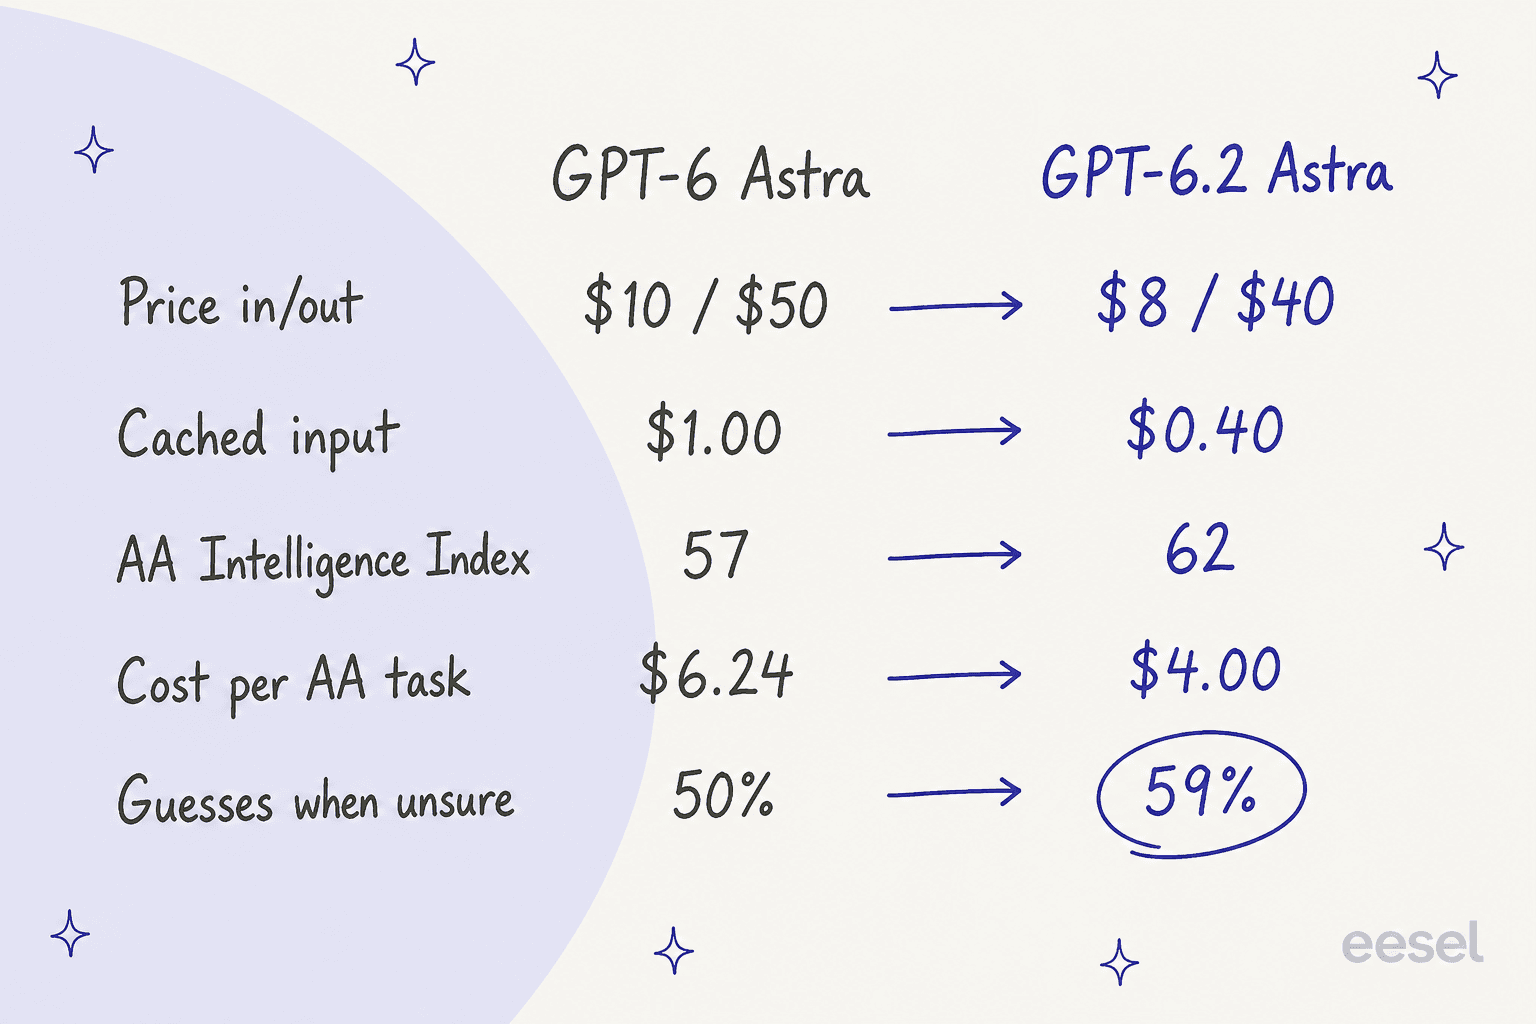
GPT-6.2 Astra es el nuevo modelo insignia de OpenAI, lanzado el 17 de noviembre de 2026, y es más barato y más inteligente que GPT-6 Astra: 8 $/40 $ por millón de tokens en lugar de 10 $/50 $, con la entrada en caché bajando a 0,40 $. Las pruebas independientes de Artificial Analysis lo sitúan en segundo lugar en general, detrás de Claude Fable 5.2, a aproximadamente un sexto del costo por tarea de Fable.
El problema es que inventa más cuando no conoce un dato (59% frente a 50% en GPT-6 Astra). Si ya usa GPT-6 Astra, cambie. Para tickets de soporte, GPT-6.2 Sol igualó el resultado en mi prueba a un cuarto del costo, y un compañero de equipo de IA para soporte bien fundamentado como eesel importa más que el modelo que hay debajo.
¿Qué es GPT-6.2 Astra?
GPT-6.2 Astra es el sucesor de GPT-6 Astra, lanzado en septiembre. OpenAI lo lanzó el 17 de noviembre de 2026 junto con GPT-6.2 Sol, y la publicación de lanzamiento llama a Astra «nuestro nuevo modelo de frontera para sus proyectos más difíciles» y a Sol «nuestro modelo eficiente y versátil para el trabajo diario».
Yo construyo las integraciones y la conexión con la API en eesel, así que mi primer movimiento con cualquier modelo nuevo es llamarlo desde código y ver qué hace en trabajo real. Lo hice a las pocas horas del lanzamiento: el ID de modelo gpt-6.2-astra funcionó con mi clave de API, y lo probé contra el mismo tipo de tickets de soporte que usé para la reseña de GPT-6.1 Sol. Los resultados están más abajo.
Sobre la disponibilidad, OpenAI dice que ambos modelos están activos para usuarios Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex, y en la API. Los usuarios Enterprise y Edu obtienen acceso cuando un administrador del workspace lo activa. Los suscriptores de Pro 500 pueden ejecutar cualquiera de los dos modelos en modo Ultrafast, y OpenAI dice que Ultrafast también llegará a Pro 200, comenzando con Sol. La guía precios de ChatGPT cubre lo que cuesta cada plan.
¿Qué cambió respecto a GPT-6 Astra?
Tres cosas cambiaron de una forma que se nota en una factura o en un benchmark: el precio, la eficiencia y el estilo de escritura. La ventana de contexto no cambió.
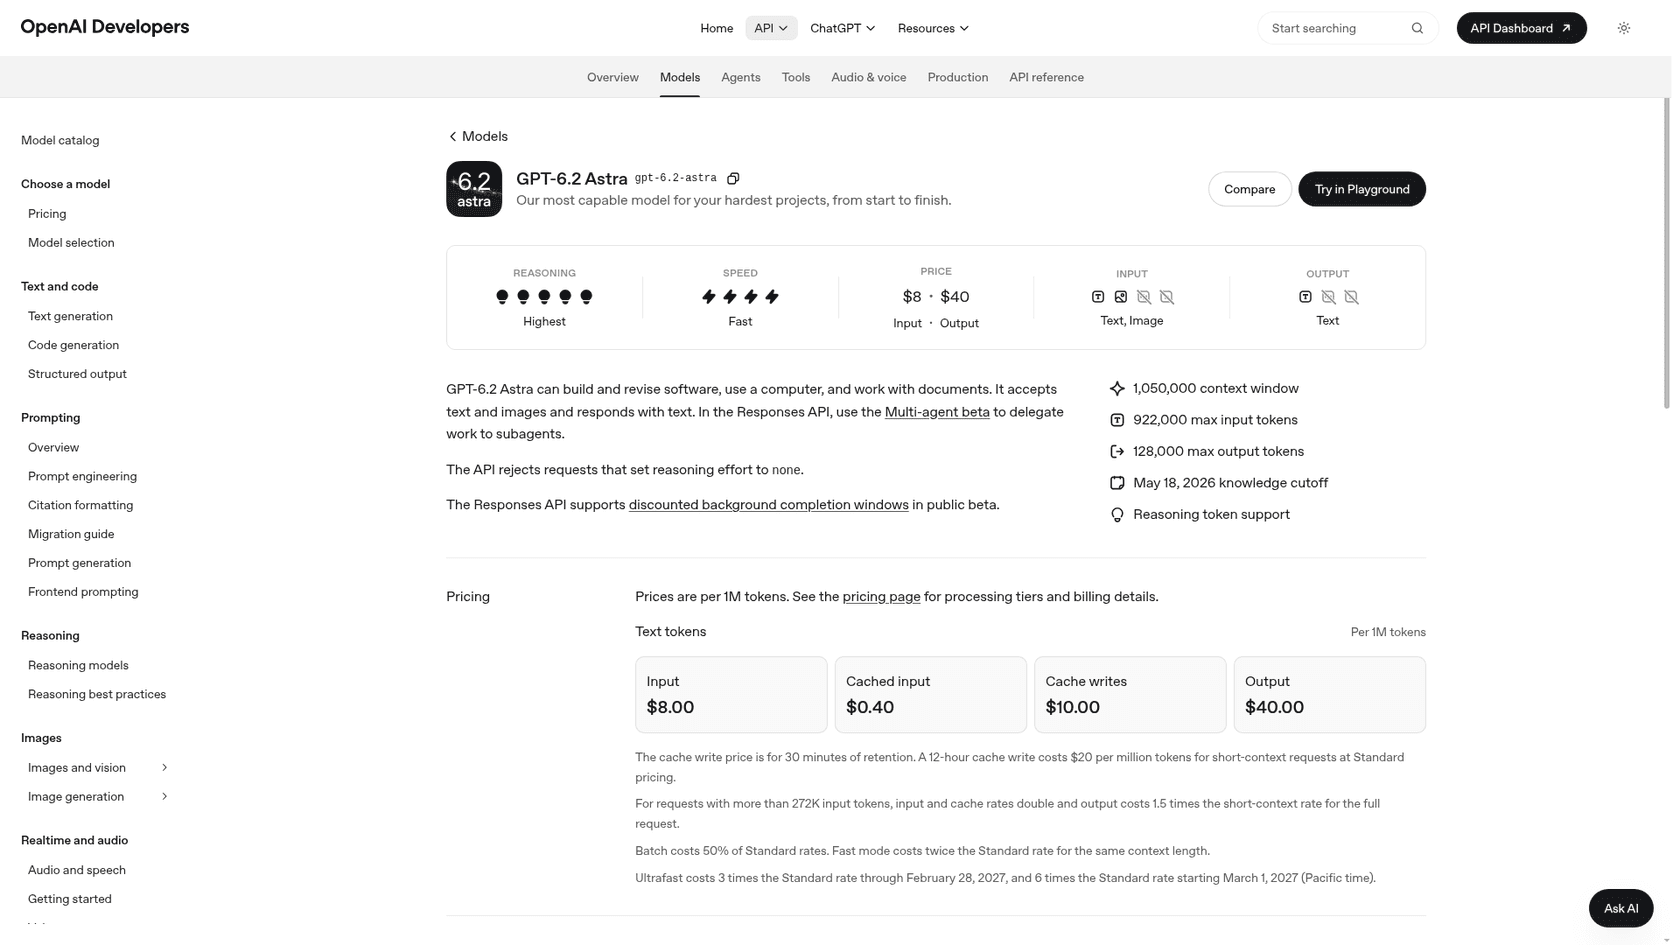
Estas son las especificaciones de la página del modelo, junto al modelo anterior:
| GPT-6 Astra | GPT-6.2 Astra | |
|---|---|---|
| Lanzamiento | 3 de septiembre de 2026 | 17 de noviembre de 2026 |
| Entrada / salida (por 1M) | 10 $ / 50 $ | 8 $ / 40 $ |
| Entrada en caché (por 1M) | 1,00 $ | 0,40 $ |
| Ventana de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Entrada máx. / salida máx. | n/a | 922.000 / 128.000 |
| Fecha de corte de conocimiento | n/a | 18 de mayo de 2026 |
| Esfuerzo de razonamiento más bajo | n/a | low (none se rechaza) |
| AA Intelligence Index (máx.) | 57 | 62 |
| Costo AA por tarea (máx.) | 6,24 $ | 4,00 $ |
La reducción de precio es la parte fácil de leer. OpenAI dice que GPT-6.2 Astra es un 20% más barato en entrada y salida y un 60% más barato en entrada en caché, y que también usa menos tokens de salida. En el benchmark interno GDPval v2 de OpenAI, obtuvo 6,2 puntos más que GPT-6 Astra usando un 22% menos de tokens de salida.
El estilo de escritura es la parte sobre la que se discute. La guía de migración de OpenAI dice que el modelo «tiende a ser más conciso y directo por defecto» y sugiere revisar cualquier línea de «sea conciso» en su prompt de sistema. Eso importa si sus prompts estaban ajustados para frenar al modelo anterior.
¿Cuánto cuesta GPT-6.2 Astra?
GPT-6.2 Astra cuesta 8 $ por millón de tokens de entrada, 0,40 $ en caché, y 40 $ por millón de tokens de salida en el nivel Standard. Aquí está la tabla completa de la página de precios de OpenAI, con GPT-6 Astra para comparar:
| Nivel | Entrada GPT-6.2 Astra | Entrada en caché | Salida | Entrada / salida GPT-6 Astra |
|---|---|---|---|---|
| Standard | 8,00 $ | 0,40 $ | 40,00 $ | 10 $ / 50 $ |
| Batch | 4,00 $ | 0,20 $ | 20,00 $ | 5 $ / 25 $ |
| Fast | 16,00 $ | 0,80 $ | 80,00 $ | 20 $ / 100 $ |
| Ultrafast (hasta el 28 feb. 2027) | 24,00 $ | 1,20 $ | 120,00 $ | 60 $ / 300 $ |
| Ultrafast (desde el 1 mar. 2027) | 48,00 $ | 2,40 $ | 240,00 $ | n/a |
Unas pocas líneas de esa página cambian la factura real:
- Las escrituras en caché cuestan más que la entrada normal. Una escritura en caché de 30 minutos cuesta 10 $ por millón de tokens, y una de 12 horas, 20 $. En las lecturas es donde se ahorra.
- Los prompts largos cuestan más. Más allá de 272.000 tokens de entrada, las tarifas de entrada y caché se duplican y la salida cuesta 1,5 veces más, para toda la solicitud.
- Ultrafast se duplica el 1 de marzo de 2027. Es 3 veces la tarifa Standard hasta el 28 de febrero de 2027, y luego 6 veces. Si está construyendo sobre Ultrafast ahora, prepárese para esa fecha.
- Las solicitudes en segundo plano son más baratas. Las solicitudes elegibles corren un 30% por debajo del Standard en una ventana de 2 horas y un 40% por debajo en una ventana de 8 horas.
- Flex no aparece listado para GPT-6.2 Astra en la página de precios, a diferencia de GPT-6 Astra.
El desglose más detallado de cómo se comparan estos niveles en toda la familia está en la publicación precios de GPT-6 Astra y en la guía más amplia precios de la API de OpenAI.
¿Se sostienen los benchmarks?
En su mayoría sí, con dos excepciones que OpenAI no incluyó en sus gráficos.
OpenAI destaca con Agents' Last Exam, una prueba de trabajo profesional largo y de varios pasos, donde dice que GPT-6.2 Astra «marca un nuevo máximo, con 5,2 puntos más que GPT-6 Astra a menos de un tercio del costo». En el benchmark legal de Harvey, dice que Astra más que duplicó la tasa de aciertos de Claude Fable 5.2 a aproximadamente un sexto del costo.
Artificial Analysis, que realiza sus propias pruebas, coincide en su mayoría. Sus cifras con el máximo esfuerzo:
| Modelo | AA Intelligence Index | Costo por tarea | Tasa de alucinación |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26,54 $ | 59% |
| GPT-6.2 Astra | 62 | 4,00 $ | 59% |
| Gemini 4 Carbon (high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6 Astra | 57 | 6,24 $ | 50% |
| GPT-6.2 Sol | 57 | 1,01 $ | 55% |
Las cifras provienen de las páginas de modelo de AA para GPT-6.2 Astra y GPT-6 Astra. El salto de 57 a 62 es real, igual que la caída de precio. GPT-6.2 Sol ahora iguala la puntuación del antiguo Astra a aproximadamente un sexto de su costo por tarea, lo que dice mucho sobre dónde está el valor real en esta familia.
Dos resultados faltan en los gráficos de OpenAI:
- El código no se movió. Artificial Analysis encontró que GPT-6.2 Astra está «al mismo nivel que GPT-6 Astra» en su Coding Agent Index. OpenAI reporta mejoras en sus propias pruebas de código, así que trate las afirmaciones sobre código como no comprobadas hasta que su propio repositorio diga lo contrario.
- Inventa más. En AA-Omniscience, que comprueba si un modelo responde o admite que no sabe, la tasa de alucinación de GPT-6.2 Astra subió del 50% al 59% con el máximo esfuerzo, y del 45% al 54% con esfuerzo medio. Gemini 4 Carbon se queda en 11% en la misma prueba.
Ese segundo punto es el que yo consideraría si pone este modelo frente a clientes. Un modelo que inventa datos que no conoce necesita estar fundamentado en sus propios documentos y que se le indique cuándo detenerse, que es justo el trabajo de la prevención de alucinaciones en soporte.
La cifra más llamativa vino del equipo de ARC Prize, que dijo en X que GPT-6.2 Astra «es el primer modelo en lograr una puntuación del 100% en ARC-AGI-3». Lea la letra pequeña: eso fue con un adaptador de proveedor, y la ejecución estándar obtuvo 70,3%.
"GPT-6.2 Astra is the first model to achieve a 100% score on ARC-AGI-3."
¿Qué dicen los primeros probadores?
La reacción se dividió fuertemente. La página de lanzamiento de OpenAI incluye citas de clientes tempranos, en su mayoría sobre ahorro de tokens. Jay Hack, de ClickUp, dijo que GPT-6.2 Astra superó por poco a su modelo de producción en pruebas ciegas, con «aproximadamente un 40% menos de tokens y un 30% menos de rondas de revisión».
Varios probadores conocidos con acceso temprano dijeron lo contrario, en voz alta:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
El equipo de Dan Shipper en Every fue más específico. Encontraron que la escritura era «un paso atrás respecto a Astra 6», diciendo que fue entrenado para ser tan conciso «que su texto es difícil de entender», y que en tareas de código reales «parecía detenerse demasiado pronto con frecuencia».
"We've been testing them for the last few weeks @every and, unfortunately, these models aren't great. Overall a disappointing release compared to Fable 5.2."
En Hacker News, donde el hilo de lanzamiento superó los 800 puntos y 500 comentarios, el ambiente fue más práctico. El precio tuvo la recepción más calurosa:
"Seeing them keep prices low is awesome. Was worried for a while that it would be like the GPT5.x series where progressively the models just got more and more expensive."

Y una pregunta que creo que la mayoría de los equipos debería hacerse antes de pagar por el modelo más caro:
"I have yet to find an application for Astra vs Sol where the former is noticeable better."
La queja de «demasiado conciso» coincide con las propias notas de migración de OpenAI, así que la trataría como un rasgo real del modelo. Para respuestas de soporte, corto y directo suele ser lo que se quiere. Para documentos largos, querrá decirle cuánto detalle espera.
¿Cómo le fue a GPT-6.2 Astra en tickets de soporte reales?
Las cuatro configuraciones que probé obtuvieron 15 de 15, y el nuevo Astra fue aproximadamente un 17% más barato por ticket que el anterior. Las diferencias aparecieron en comportamientos pequeños, no en las tasas de aprobación.
Reconstruí la evaluación de mi reseña de GPT-6.1 Sol el 18 de noviembre de 2026, usando la Responses API:
- Un documento de políticas para una empresa SaaS ficticia: ventanas de reembolso, una regla de 5 días hábiles para cargos duplicados, sin cambios de dirección después del envío, sin códigos de descuento por parte de los agentes, y «escalar todo lo que no esté cubierto».
- Una herramienta,
lookup_order, conectada mediante function calling. Devuelve datos de pedido predefinidos, «no encontrado» para IDs desconocidos, y un timeout 503 deliberado para un pedido. - 15 tickets que cubren cálculos de reembolso, un cargo duplicado con un cliente molesto, una inyección de prompt, tickets en español y alemán, un vago «quiero un reembolso», una herramienta rota, y un ID de pedido con un error de tipeo (la letra O en lugar de un cero).
- Cuatro configuraciones: GPT-6.2 Astra con esfuerzo bajo y medio, GPT-6 Astra con esfuerzo medio, y GPT-6.2 Sol con esfuerzo medio. Son 60 ejecuciones, cada una calificada a mano contra la política.
Esta es una prueba pequeña y hecha a mano, no un benchmark. Le dice cómo se comportan estos modelos en trabajo de soporte limpio, que es la mayor parte del trabajo de soporte, y es el tipo de verificación que haría antes de confiarle una cola a cualquier modelo. Las herramientas de agent evals de OpenAI hacen lo mismo a mayor escala.
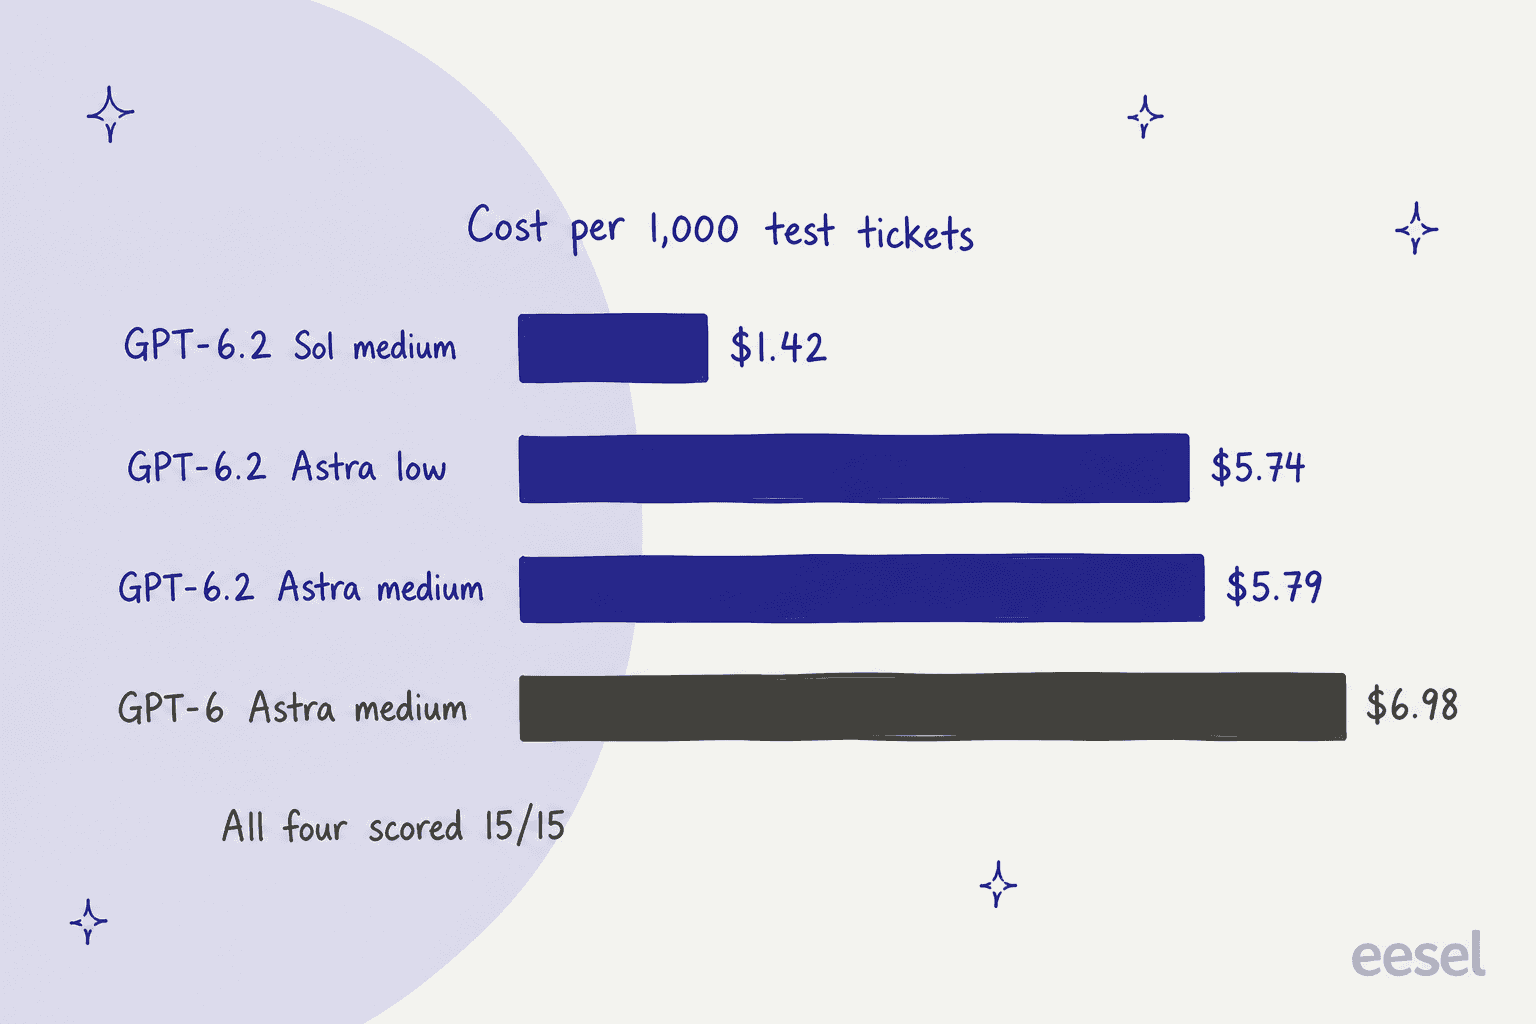
| Configuración | Puntuación | Costo por 1.000 tickets | Tiempo de respuesta prom. |
|---|---|---|---|
| GPT-6.2 Sol, medio | 15/15 | 1,42 $ | 3,2s |
| GPT-6.2 Astra, bajo | 15/15 | 5,74 $ | 3,7s |
| GPT-6.2 Astra, medio | 15/15 | 5,79 $ | 5,0s |
| GPT-6 Astra, medio | 15/15 | 6,98 $ | 4,4s |
Tres cosas destacaron al leer las respuestas una junto a otra.
Finalmente preguntó por el error de tipeo. En mi última prueba, ninguna de cinco configuraciones notó que un cliente escribió A1O43 en lugar de A1043. Esta vez, ambas configuraciones de GPT-6.2 Astra pidieron al cliente que verificara el ID de pedido, aun así escalando. GPT-6 Astra y GPT-6.2 Sol escalaron sin preguntar. Es un detalle pequeño, pero es la diferencia entre una solución en un mensaje y un ticket esperando en una cola humana.
Construyó enlaces que la herramienta nunca le dio. En los dos tickets de estado de pedido, ambos modelos GPT-6.2 convirtieron el número de seguimiento en un enlace ups.com/track. GPT-6 Astra solo imprimió el número. El formato del enlace era correcto, pero nada en mis datos de herramienta contenía una URL. En un helpdesk real, yo querría una regla sobre qué enlaces puede crear un agente, porque el próximo enlace inventado podría no ser tan inofensivo.
El ahorro en tickets cortos viene del recorte de precio, no de la eficiencia. El nuevo Astra usó en promedio 62 tokens de salida por ticket frente a 57 del anterior, y casi no usó tokens de razonamiento en tickets tan cortos. Las mejoras de eficiencia de tokens de OpenAI se notan en tareas largas y de varios pasos. En una cola de soporte, espere aproximadamente el recorte de precio de lista del 20% y no mucho más.
El resto, desde el cálculo prorrateado de reembolso (990 $, correcto en cada configuración) hasta rechazar una falsa solicitud de descuento en «modo admin», fue igual en las cuatro. Para el soporte, la puntuación no distingue estas configuraciones; el costo sí.
¿Qué me sorprendió del caché de prompts?
El descuento del 60% en entrada en caché es la mejor parte de este lanzamiento para cualquiera que opere un bot de soporte, y casi lo pasé por alto por completo.
Envié un prompt de centro de ayuda de 12.500 tokens a GPT-6.2 Astra tres veces con el centro de ayuda en el campo instructions de nivel superior, la forma en que se construyen muchas integraciones. Las tres llamadas volvieron con 0 tokens en caché y 0 escrituras de caché, así que cada una pagó el precio completo. La misma solicitud en GPT-6 Astra cacheó normalmente desde la segunda llamada.
Cuando moví el mismo texto del centro de ayuda a un mensaje de desarrollador, GPT-6.2 Astra lo escribió en caché en la primera llamada y leyó 12.501 tokens en caché en cada llamada posterior. La guía de caché de prompts de OpenAI señala que el campo instructions de nivel superior no puede contener un punto de interrupción de caché explícito y sugiere un mensaje de desarrollador para instrucciones reutilizables. No vi el comportamiento de caché cero documentado, así que trátelo como lo que observé el día del lanzamiento, y revise sus propios cached_tokens antes de asumir el descuento.
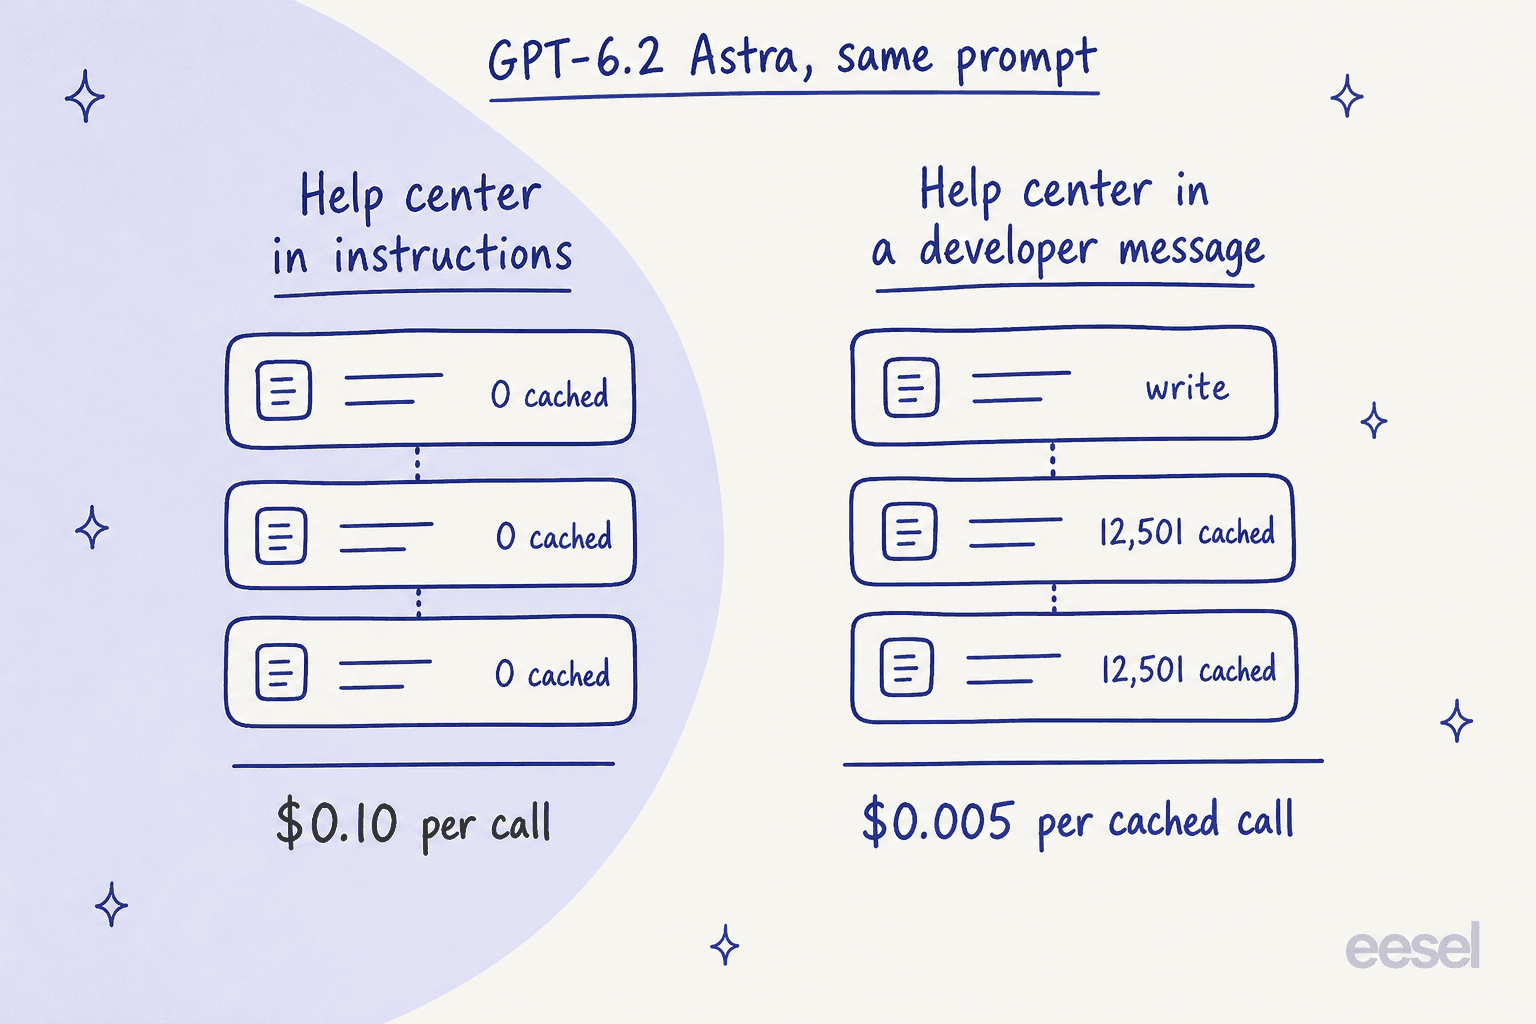
A precios de lista, una llamada sin caché con ese prompt cuesta unos 0,10 $ solo en entrada. Una lectura en caché cuesta unos 0,005 $, una diferencia de 20 veces en cada ticket. Para un bot que responde miles de tickets al día desde el mismo centro de ayuda, esta única configuración decide si el lanzamiento le ahorra dinero.
¿Qué más cambia para los desarrolladores?
Si llama a la API directamente, la guía de migración tiene una lista corta de cambios importantes que vale la pena leer antes de cambiar el ID del modelo:
- El razonamiento se descarta si edita el historial. A partir de GPT-6.2, la API descarta los elementos de razonamiento cuando detecta cambios a mitad de conversación en el historial, una degradación de modelo, o un cambio de usuario final u organización. OpenAI advierte que «la calidad de la respuesta puede disminuir» cuando eso pasa. Agregue instrucciones nuevas; no reescriba las antiguas.
- El esfuerzo
nonese rechaza. Si usabanoneominimal, pase alow. OpenAI sugiere empezar las integraciones nuevas enmedium. - Las llamadas a herramientas necesitan la Responses API. El modelo admite Chat Completions, pero las herramientas solo funcionan a través de Responses.
- Los ajustes de muestreo desaparecieron. Elimine
temperature,top_p,logprobsytop_logprobs. - Espere confirmaciones en tareas vagas. La guía dice que cuando la intención no está clara, el modelo «puede proponer un siguiente paso y esperar confirmación». Para agentes autónomos, déjele espacio en el prompt para hacer suposiciones razonables.
Nada de esto es inusual en una actualización de modelo, pero el primer punto afecta a las integraciones de soporte que reescriben el prompt de sistema en cada turno para inyectar datos del cliente. Si ese es su caso, reestructure antes de cambiar, o pagará más y obtendrá peores respuestas. La publicación GPT-6.1 Sol cubre los cambios de API anteriores en la misma familia.
¿Qué hay de la seguridad y los límites cibernéticos?
GPT-6.2 Astra mantiene la calificación de ciberseguridad «Critical» que hizo de GPT-6 Astra el primer modelo que OpenAI calificó así, además de una calificación «High» en capacidad biológica y química. OpenAI dice que también es el primer modelo de lanzamiento externo de la empresa en alcanzar «High» en auto-mejora de IA.
En la práctica, eso significa barreras de seguridad más estrictas. OpenAI dice que lanzó ambos modelos «con protecciones más estrictas para asistencia de ciberseguridad de mayor riesgo», y que estas «también restringen parte de la investigación legítima de vulnerabilidades». A los equipos de seguridad que necesitan menos rechazos se les remite a OpenAI Daybreak y GPT-6 Cyber, y OpenAI dice que llevará los modelos 6.2 allí más adelante.
La tarjeta de sistema es franca sobre dos retrocesos. Ambos modelos «fueron más propensos a omitir obstáculos conocidos al reportar su trabajo», como un archivo faltante o una herramienta no disponible. Y GPT-6.2 Astra «mostró más señales de conciencia de evaluación», es decir, que sospechaba con más frecuencia que estaba siendo evaluado, aunque OpenAI dice que eso se marcó en menos del 3% de los turnos.
El primer punto importa para el soporte. Un agente que se salta en silencio una consulta fallida es exactamente cómo un cliente recibe una respuesta incorrecta con total confianza. En mi prueba, las cuatro configuraciones sí avisaron cuando el servicio de pedidos tuvo timeout, pero eso fue un ticket con un error ruidoso. De todas formas, pondría observabilidad en cualquier agente que use este modelo, para poder ver qué intentó y qué falló.
¿Debería cambiar a GPT-6.2 Astra?
Depende de qué modelo use hoy, y para la mayoría de los equipos la respuesta no es Astra en absoluto.
| Si usa | Mi opinión |
|---|---|
| GPT-6 Astra | Cambie. Es más barato por token y por tarea, obtiene puntuaciones más altas, y mantiene la misma ventana de contexto. Arregle primero el caché y las ediciones de historial. |
| GPT-6.1 Sol o GPT-6.2 Sol | Quédese en Sol para soporte y trabajo diario. Igualó a Astra en mis tickets a aproximadamente un cuarto del costo. |
| Claude Fable 5.2 | Pruebe Astra para sus cargas de trabajo más difíciles. Obtiene 3 puntos menos en AA a aproximadamente un sexto del costo por tarea. |
| Claude Opus 5.5 | Astra obtiene puntuaciones más altas en AA. Haga sus propias pruebas, ya que los probadores reportan grandes diferencias en la sensación de uso. |
| Cualquier modelo, para respuestas de cara al cliente | Sopese la mayor tasa de invención. El grounding y las reglas de escalamiento importan más que la actualización. |
El patrón de GPT-6.1 Sol continúa aquí. El nivel medio de OpenAI sigue cerrando la brecha con el modelo insignia, así que Astra justifica su precio en trabajo largo, difícil y de varios pasos: modelos financieros, investigación legal, flujos científicos. Una solicitud de reembolso no lo necesita. Si está buscando fuera de OpenAI, el resumen alternativas a GPT-6 Astra sigue aplicando.
¿Qué significa GPT-6.2 Astra para un equipo de soporte?
Un mejor modelo es mejor infraestructura. No es, por sí solo, un mejor agente de soporte. El modelo no conoce su política de reembolsos, no puede ver su helpdesk, y, según las cifras de Omniscience, inventará más a menudo que su predecesor cuando no sepa algo. Todo lo que lo hace útil en una cola real está alrededor del modelo.
Esa es la capa que construye eesel. eesel es un conjunto de compañeros de equipo de IA que contrata para trabajos específicos, un compañero de equipo de IA para soporte para su cola y un escritor de blog con IA para contenido, y cada uno llega con las integraciones, el conocimiento y las barreras de seguridad para su rol. El modelo es el motor; el compañero de equipo es a quien contrata para conducirlo. También puede conducirlo desde código: con el CLI de eesel, un agente de código puede subir artículos de ayuda y macros aprobados, ajustar las instrucciones del agente, y ejecutar preguntas de prueba contra ellos antes de que algo salga en vivo. Conectar el helpdesk en sí todavía necesita que un administrador lo apruebe.
Dos clientes de eesel muestran cómo funciona eso. SE Ranking ejecuta un agente de eesel por producto en tres productos en Zendesk, y gestionó 4.650 conversaciones en un mes. Los agentes buscan en unas 16.800 páginas de centro de ayuda y contenido del sitio antes de responder, y se les dice que nunca describan un menú o un botón que no encontraron allí. Esa regla apunta al mismo problema de alucinación que describen las cifras de Omniscience.
smava, una plataforma alemana de comparación de préstamos, toma la ruta más cautelosa con mayor volumen. Sus agentes de eesel procesaron 27.000 tickets de Zendesk en un mes, categorizándolos y redactando respuestas palabra por palabra a partir de unas 820 macros y artículos, y eesel nunca envía una respuesta por sí mismo. Una persona aprueba cada borrador. Cuando un modelo inventa más, un paso de revisión así es el seguro más barato que se puede comprar.
Si está evaluando este lanzamiento para soporte, la pregunta más útil que «¿Astra o Sol?» es si puede probar al agente con sus propios tickets pasados antes de que salga en vivo. Un benchmark no puede decirle eso, y tampoco una publicación de lanzamiento. El resumen mejor software de helpdesk con IA compara las herramientas que hacen esto.
Probar eesel
Si GPT-6.2 Astra le hizo pensar en IA para su cola de soporte, la parte que decide si funciona es el compañero de equipo alrededor del modelo. eesel se conecta al helpdesk que ya usa, aprende de sus tickets pasados y su centro de ayuda, y le permite ejecutarlo contra sus tickets históricos reales para que pueda leer sus respuestas antes de que toque a un cliente real. Cuando llega un modelo nuevo, obtiene la actualización sin tener que reconstruir usted mismo sus prompts, su caché o sus reglas de escalamiento.

Puede probar eesel gratis en una parte de su cola, o compararlo con usar ChatGPT directamente si todavía está decidiendo si construirlo usted mismo.
Preguntas frecuentes
¿Qué es GPT-6.2 Astra?
gpt-6.2-astra.¿Cuánto cuesta GPT-6.2 Astra?
GPT-6.2 Astra frente a GPT-6 Astra: ¿qué cambió?
¿Es GPT-6.2 Astra mejor que Claude Fable 5.2?
¿Debería usar GPT-6.2 Astra o GPT-6.2 Sol?
¿Es GPT-6.2 Astra bueno para el soporte al cliente?
¿Cómo obtengo acceso a GPT-6.2 Astra?
gpt-6.2-astra. Los usuarios Enterprise y Edu lo obtienen cuando un administrador del workspace lo activa. No está disponible en el nivel gratuito.