Qué es realmente GPT-6 Sol
Dejemos el contexto claro antes de los benchmarks. OpenAI lanzó GPT-6 Sol y GPT-6 Luna juntos el 22 de septiembre, situándolos bajo el buque insignia Astra que llegó el 3 de septiembre. La frase que usó OpenAI es "construye con Sol, escala con Luna": Sol es el modelo capaz de gama media contra el que desarrollas, Luna es el nivel ultraeconómico al que recurres cuando el volumen crece.
Si solo quieres el resumen de especificaciones y precios sin veredicto, mis publicaciones resumen de GPT-6 Sol y precios de GPT-6 Sol lo cubren. Este análisis trata de si realmente es bueno.
Sobre el papel, Sol es un modelo serio. Tiene una ventana de contexto de 1.050.000 tokens, salida máxima de 128K, una fecha de corte de conocimiento de abril de 2026, y el conjunto completo de herramientas de la Responses API: búsqueda web y de archivos, intérprete de código, una shell alojada, uso del ordenador y MCP. El esfuerzo de razonamiento se mueve en seis niveles, de none a max, con medium como opción predeterminada. Recibe texto e imagen, y produce texto.
Me dedico a construir agentes de IA, así que lo que más me importa no es la cifra de contexto que aparece en los titulares, sino cómo se comporta el modelo dentro de un bucle de agente. Y ahí está la parte interesante de este análisis, porque la historia de los benchmarks y la historia del comportamiento apuntan en direcciones ligeramente distintas.
He pasado los últimos tres años y pico poniendo IA en colas de soporte reales, viendo cómo un modelo tras otro llega a producción. El patrón casi nunca cambia: el gráfico de lanzamiento dice una cosa y la experiencia real dice otra. Así que, en lugar de tomar al pie de la letra el discurso de "la siguiente generación", leo GPT-6 Sol como dos cosas separadas empaquetadas en un solo lanzamiento: una pequeña actualización de inteligencia y una gran actualización de precios.
Las dos historias dentro de un solo lanzamiento
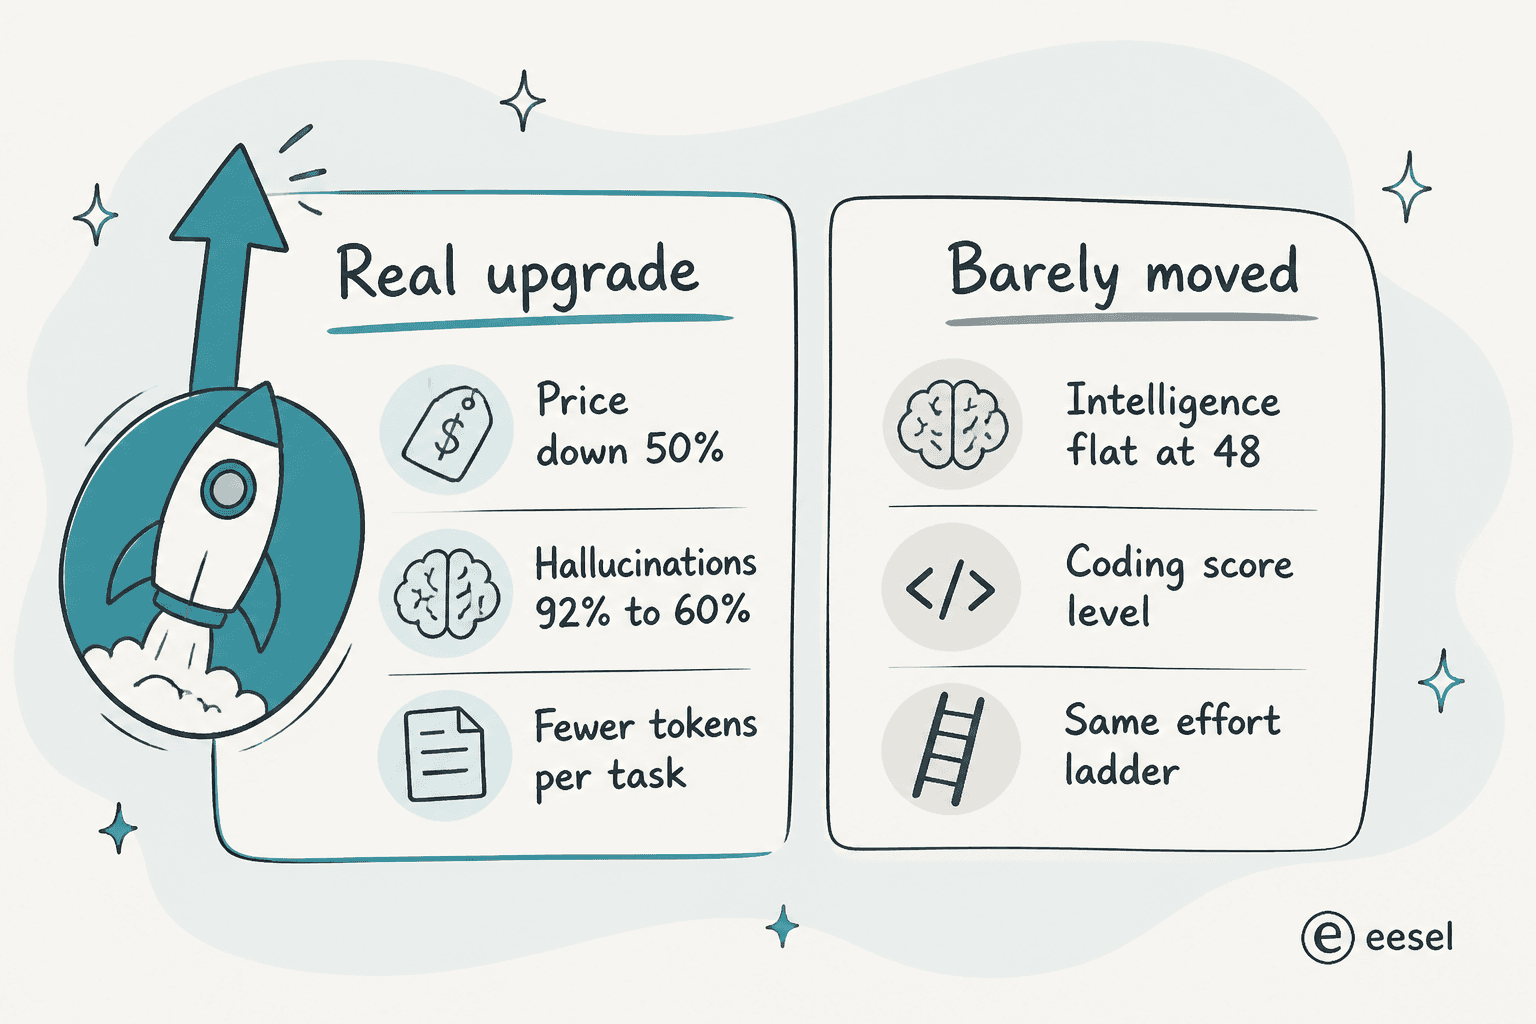
La primera historia es con la que abre OpenAI: Sol se volvió mucho más barato. A 2 $/10 $ es la mitad de precio que GPT-5.6 Sol, y Artificial Analysis midió el coste de ejecutar todo su Intelligence Index en 1,06 $ por tarea, alrededor de un 50% menos que los 1,99 $ de GPT-5.6 Sol. La entrada en caché baja a 0,20 $, un descuento del 90%. Para cualquiera con volumen real, ese es todo el argumento de venta, y es fuerte.
La segunda historia está enterrada en esa misma tabla de benchmarks: la inteligencia no se movió realmente. En el AA Intelligence Index, GPT-6 Sol a máximo esfuerzo puntúa 48, algo que AA describe como al nivel de GPT-5.6, "avances en algunas evaluaciones, retrocesos en otras". El Coding Agent Index cuenta la misma historia: prácticamente plano, a un precio menor.
Hay una mejora de capacidad real, y merece la pena nombrarla con claridad porque es fácil pasarla por alto: la precisión factual. OpenAI dice que Sol comete aproximadamente la mitad de errores que GPT-5.6 Sol, y la tasa de alucinaciones a máximo esfuerzo de AA lo respalda, cayendo de alrededor del 92% al 60%. Para quien usa el modelo para responder preguntas reales en lugar de escribir código desechable, tener menos respuestas equivocadas con aire de seguridad vale, posiblemente, más que un punto extra de razonamiento puro.
"En general, creo que para la mayoría el ganador de hoy fue Anthropic. Yo personalmente prefiero Opus 5.5 en medium frente a GPT-6 Sol Max, en pruebas muy, muy tempranas. Rango de precio similar, más capacidad."

Ese comentario es justo, y es la contraparte honesta a Sol: si tienes el presupuesto, existe un modelo más inteligente. Pero también compara a Sol a máximo esfuerzo con Opus en medium, y como señaló otro lector en respuesta, esos no son ajustes equivalentes. Lo que me lleva a la parte de este análisis que creo más importante.
Cómo se comporta realmente en un agente
Las puntuaciones brutas no capturan cómo es trabajar con un modelo. Dos comportamientos aparecieron una y otra vez en las reacciones de los desarrolladores, y ambos coinciden con lo que he visto al conectar modelos de OpenAI en bucles de agente.
El primero es la eficiencia de tokens. GPT-6 Sol usa alrededor de 31 000 tokens de salida por tarea en el índice de AA, frente a unos 119 000 de Opus 5.5. Eso es cerca de 4 veces menos tokens para llegar a una respuesta de calidad parecida, que es gran parte del motivo por el que se siente rápido y por el que la factura se mantiene baja. También es la razón silenciosa por la que un modelo "más barato por token" puede resultar todavía más barato por tarea terminada de lo que sugiere el precio de etiqueta.
El segundo es el exceso de celo, y aquí Sol tiene una desventaja genuina:
"Los modelos de OpenAI también son mucho más entusiastas que los de Anthropic, que están más del lado perezoso. Sin supervisión, Sol/Astra intentará construir un cohete verificado con sha256 si le pides que arregle una condición de carrera en tu app de lista de tareas."
Me reí con eso porque es exacto. Apunta a Sol con una tarea pequeña sin acotarla bien y sobreconstruirá con gusto. En un agente, eso significa apoyarte más en tus instrucciones y barreras de seguridad de lo que harías con un modelo más perezoso. No es exactamente un defecto, es una personalidad, pero es una con la que hay que diseñar en torno a ella.
La otra cara de esa personalidad es la prosa. Dan Shipper de Every resumió la diferencia de escritura con claridad:
"Sol mejora sobre GPT-5.6 —incluyendo mejor código Ruby en pruebas de @kieranklaassen—, pero Opus 5.5 tiene el techo más alto para construcciones largas y autónomas."
Su valoración completa es el resumen más claro de todo este enfrentamiento que he leído: Sol escribe una prosa limpia y mínima y pone la idea importante primero, mientras que es Opus quien tiene el techo más alto para el trabajo autónomo largo. Ese es el trade-off en una frase.
La escala de esfuerzo es la verdadera decisión
Esto es lo que la mayoría de los análisis de Sol pasan por alto: con seis niveles de razonamiento, "qué tan bueno es GPT-6 Sol" es la pregunta equivocada. La correcta es "qué tan bueno con qué esfuerzo, a qué coste".
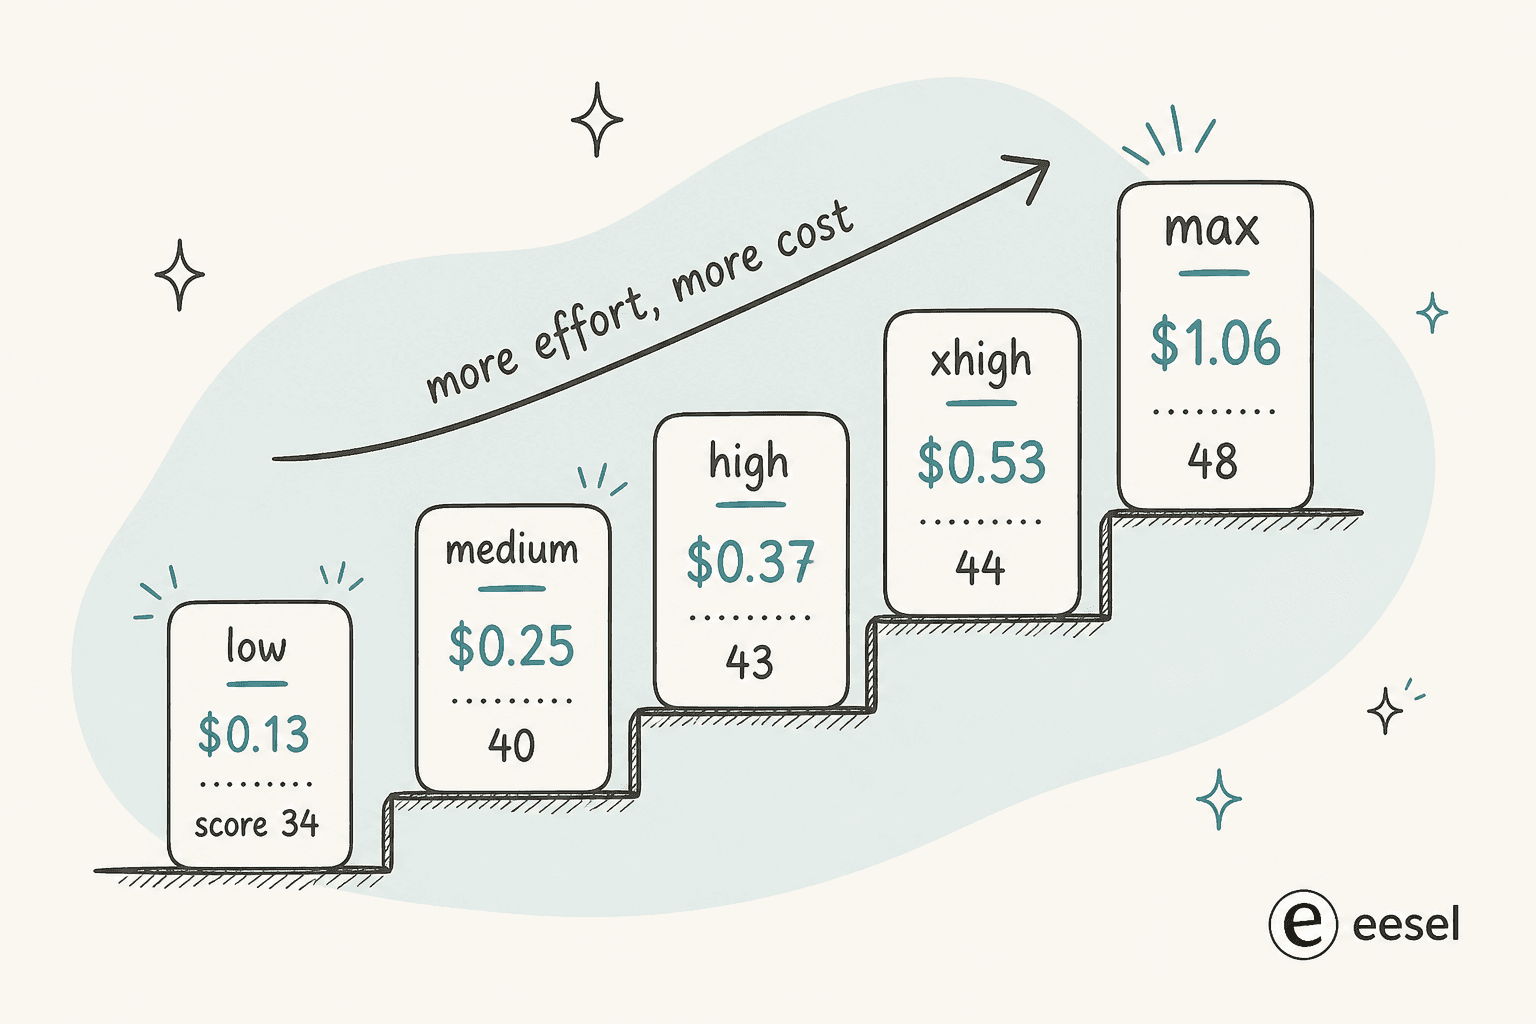
AA publicó la curva de esfuerzo completa, y el rango es amplio. El esfuerzo bajo puntúa 34 a 0,13 $ por tarea; el esfuerzo máximo puntúa 48 a 1,06 $. Eso es una oscilación de coste de 8 veces por 14 puntos de índice. Para gran parte del trabajo real, el punto óptimo está en el medio de esa escala, no en la cima. El selector de abajo es el modelo mental que uso para decidir qué nivel elegir.
¿Qué nivel de esfuerzo de GPT-6 Sol?
Elige la tarea. Las puntuaciones y el coste por tarea vienen del Artificial Analysis Intelligence Index.
Aquí también está la advertencia honesta sobre el techo. Incluso a máximo esfuerzo, el 48 de Sol queda por debajo del 58 de Opus 5.5 y por debajo del propio Astra de OpenAI. Si tu trabajo necesita de verdad lo más alto del mercado, Sol no es la opción. Pero la mayor parte del trabajo no lo necesita, y esa brecha es exactamente lo que te ahorras a mitad de precio.
Precios: la razón real para prestarle atención
Seré directo: el precio es el verdadero análisis. Así se sitúa Sol frente a sus hermanos y su rival más cercano.
| Modelo | Entrada/salida (por 1M) | Entrada en caché | AA Intelligence | Coste por tarea AA |
|---|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,01 $ | no listado | n/a |
| GPT-6 Sol | 2 $ / 10 $ | 0,20 $ | 48 | 1,06 $ |
| GPT-6 Astra | 10 $ / 50 $ | 1,00 $ | ~61 | mayor |
| Claude Opus 5.5 | 4 $ / 20 $ | 0,20 $ | 58 | 5,98 $ |
Dos cosas destacan. Primero, Sol cuesta la mitad que Opus 5.5 en tokens, algo que un lector usó para argumentar que ni siquiera están en la misma categoría. Segundo, y esto es lo que me sorprendió: como Sol consume muchos menos tokens de salida, su coste por tarea terminada (1,06 $) está más cerca de una quinta parte de Opus 5.5 (5,98 $), no de la mitad. La brecha por token subestima la brecha real.
Dos advertencias mantienen esto honesto. El modo Fast duplica la tarifa a 4 $/20 $, y las entradas superiores a 272K tokens reciben un recargo por contexto largo, que, como señaló un lector, reduce la ventaja de precio de Sol en cuanto le das contextos enormes. Si tu flujo de trabajo es realmente pesado en contexto largo, vuelve a hacer los números. Mi publicación sobre precios de GPT-6 Sol tiene la tabla completa por niveles, y la guía de precios de Codex explica cómo se traduce eso dentro de la suscripción en lugar de la API.
Quién debería usarlo realmente
Después de todo esto, aquí va mi recomendación clara.
Usa GPT-6 Sol si pasas el día en Codex o en la API haciendo programación cotidiana, redacción y preguntas y respuestas, y quieres un modelo rápido, barato y predecible que no derroche tokens. Si estabas en GPT-5.6 Sol, esto es una mejora directa: misma inteligencia, mitad de coste, menos alucinaciones. Es mi elección como opción predeterminada para alto volumen.
Busca en otro sitio si necesitas el techo más alto para construcciones largas, autónomas y de varias horas, en cuyo caso Opus 5.5 o Astra se ganan su prima, o si tu trabajo tiene mucho contexto largo, donde el recargo se come el ahorro. Y si construyes agentes de IA, recuerda que el exceso de celo de Sol exige más acotación y barreras de seguridad, no menos.
Para un enfrentamiento completo sobre la cuestión de frontera, mi comparativa GPT-6 Sol frente a Opus 5.5 y el crítico análisis de GPT-6 Astra profundizan más de lo que puedo aquí, y el listado de modelos de OpenAI mapea toda la gama.
La brecha entre un modelo y una contratación
Esta es la trampa en la que veo caer a los equipos cada semana de lanzamiento, y merece la pena terminar con ella. Un modelo que lidera los benchmarks no es un compañero de equipo que funcione. GPT-6 Sol es un motor rápido, barato y capaz, pero sigue siendo solo un motor: apunta la API en bruto a tu cola de soporte y serás tú quien se quede con la recuperación de información, las barreras de seguridad, la integración con el helpdesk, las pruebas y cada respuesta equivocada que dé con seguridad el primer día.
Esa última parte es donde me he ganado las cicatrices. Hemos visto a un bot que sonaba seguro dar respuestas equivocadas en silencio en una cola en producción, que es exactamente por qué ahora cada despliegue se simula contra miles de tickets históricos antes de tocar a un cliente real. Un modelo en bruto no te da nada de eso.
Esta es la distinción sobre la que está construido eesel: un modelo es infraestructura, eesel es la persona empleada. eesel es una plataforma de compañeros de equipo de IA, y contratas compañeros listos para trabajar en tareas concretas. La plantilla actual es un compañero de IA para helpdesk y un redactor de blog con IA, cada uno con las habilidades, integraciones y contexto de la empresa para su rol. El compañero de helpdesk se une a tu cola existente, aprende de tus tickets pasados y factura por resolución, así que puedes medirlo frente al coste de un agente humano en lugar de adivinar. Esa es la diferencia entre un experimento de IA conversacional en bruto y un ahorro real en costes de soporte que puedes poner en números.

Y si eres del tipo de desarrollador al que le gustó Sol precisamente porque vive en una terminal, eesel también te recibe ahí. La CLI de eesel maneja el mismo compañero y el mismo workspace desde la línea de comandos: una persona puede usarla de forma interactiva, los scripts pueden automatizarla, y agentes de código como Claude Code, Codex o Cursor pueden operarla sin interfaz. Puedes conectar fuentes, enviar instrucciones, ejecutar una simulación sobre tickets históricos y revisar la actividad, todo sin abrir el panel. Es la misma superficie amigable con agentes y lista para MCP que querrías si estuvieras construyendo sobre Sol tú mismo, solo que la recuperación de información y las barreras de seguridad ya están hechas. Puedes probar eesel gratis.
Preguntas frecuentes
El bloque de preguntas frecuentes de arriba responde las dudas más comunes sobre el análisis de GPT-6 Sol, desde el precio hasta cómo se compara con Astra y Opus 5.5. Si estás decidiendo entre modelos, empieza con la comparativa GPT-6 Sol frente a Opus 5.5 y después con el ranking de mejores agentes de IA si estás construyendo algo que de verdad resuelva tickets en lugar de solo responder prompts.
Preguntas frecuentes
¿Merece la pena GPT-6 Sol frente a GPT-5.6 Sol?
¿Cuánto cuesta GPT-6 Sol?
¿Es GPT-6 Sol mejor que Claude Opus 5.5?
¿En qué destaca más GPT-6 Sol?
¿En qué se diferencia GPT-6 Sol de GPT-6 Astra?
¿Puedo usar GPT-6 Sol para atención al cliente?
¿Está disponible GPT-6 Sol en el plan gratuito?


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.