Precios de la API de GPT-6 Luna: el nivel estándar
Aquí está el número por el que vino la mayoría de la gente. En la página de precios de la API, los precios estándar de GPT-6 Luna son $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. La entrada en caché baja a $0.01, y las escrituras de caché son de $0.125 por millón.
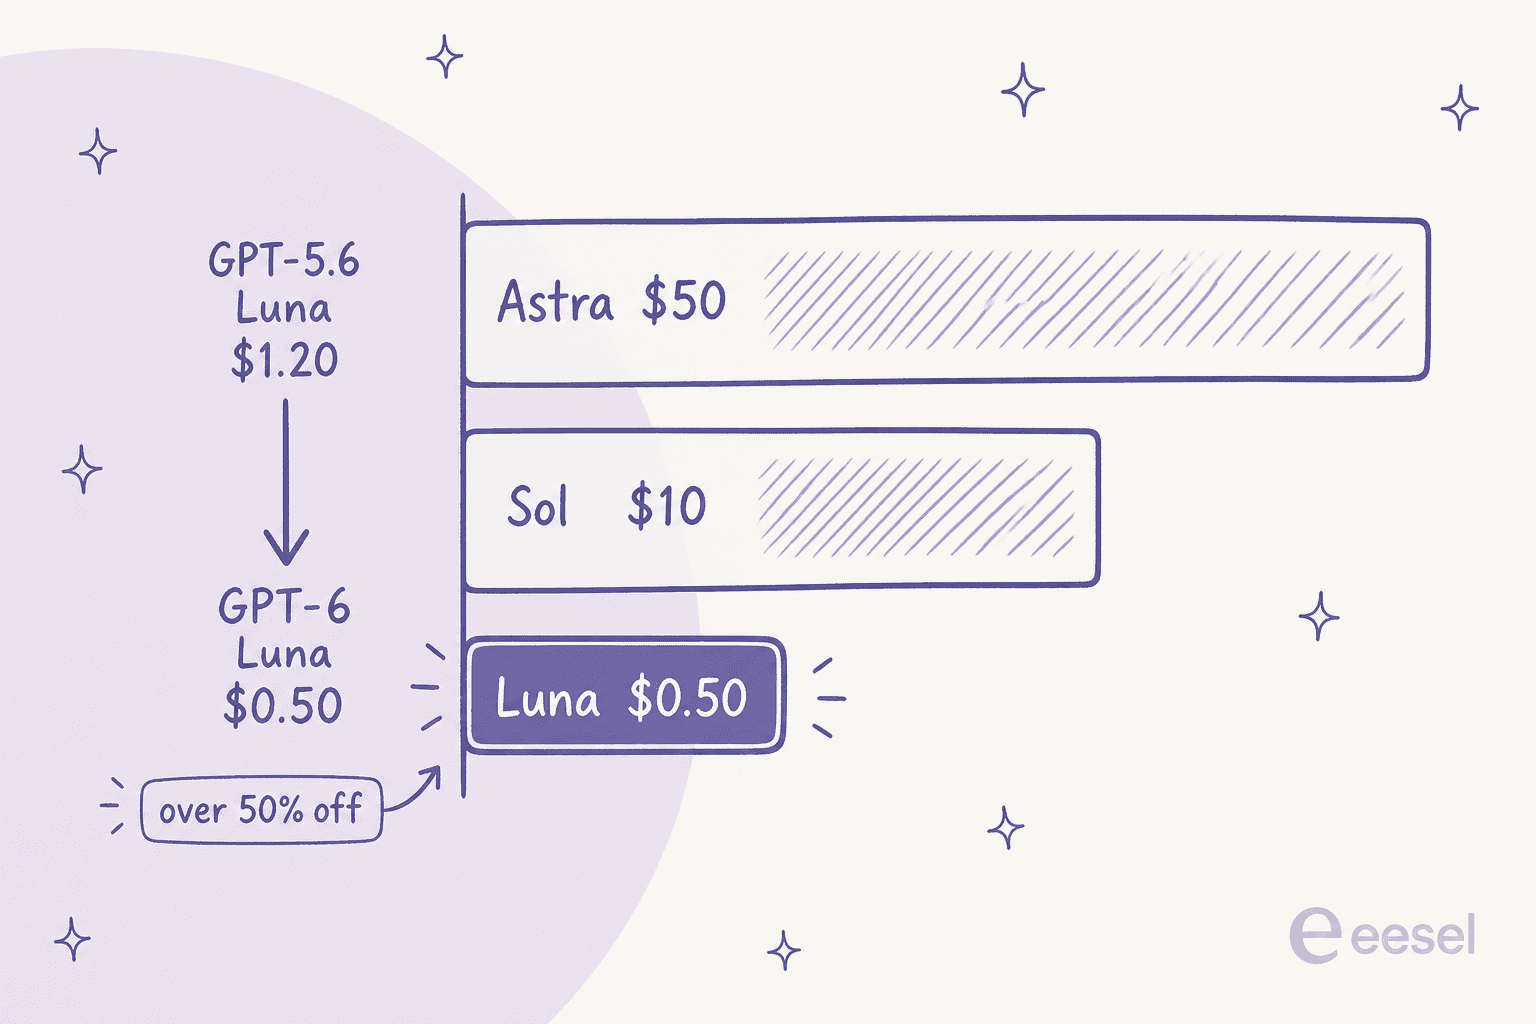
Eso coloca a Luna en la parte inferior de la lista de modelos de OpenAI: muy por debajo del nivel medio Sol, y un error de redondeo junto al buque insignia Astra. Así se ubica la familia GPT-6 en el nivel estándar de contexto corto, con el saliente GPT-5.6 Luna como referencia:
| Modelo | Entrada (por 1M) | Entrada en caché | Salida (por 1M) | Posición |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Buque insignia |
| gpt-6-sol | $2.00 | $0.20 | $10.00 | Nivel medio |
| gpt-6-luna | $0.10 | $0.01 | $0.50 | Más barato (nuevo) |
| gpt-5.6-luna | $0.20 | $0.02 | $1.20 | Nivel ligero anterior |
Fuente: precios de la API de OpenAI. La historia que cuenta la tabla es simple: GPT-6 Luna es el antiguo GPT-5.6 Luna, con la entrada reducida a la mitad y la salida recortada bastante más de la mitad. OpenRouter confirmó las tarifas de la familia el día del lanzamiento. El propio planteamiento de OpenAI en la publicación de lanzamiento es «Build with Sol. Scale with Luna», que indica exactamente dónde debe situarse Luna: el modelo al que se recurre para trabajo simple y de alto volumen.
El recorte de precio: qué cambió y qué no
Un recorte de precio de este tamaño suele venir acompañado de una historia de capacidad. En este caso, mayormente no es así, y vale la pena ser honesto al respecto.
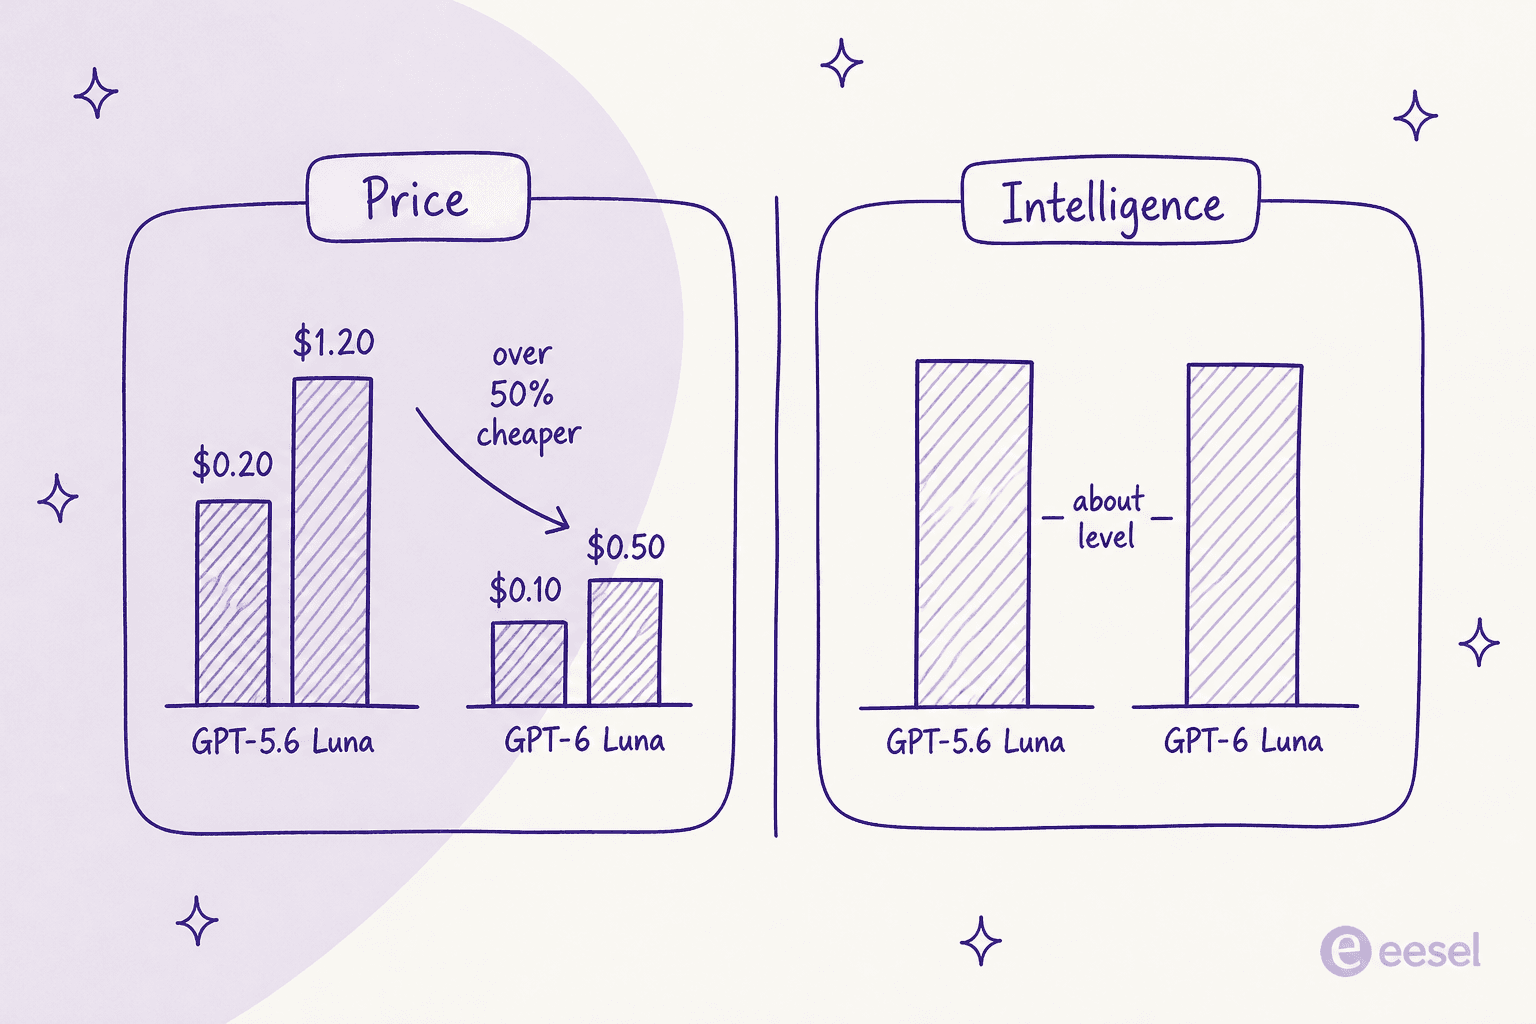
En la medida bruta de inteligencia, Artificial Analysis informó que GPT-6 Sol y Luna «empujan la frontera de eficiencia de costos al reducir el costo a la mitad», mientras que el Intelligence Index y el Coding Agent Index «se mantienen al nivel de GPT-5.6, con progreso en algunas evaluaciones y retrocesos en otras». Así que el resumen es: el precio se movió mucho, la inteligencia apenas se movió.
Donde Luna sí mejoró fue en fiabilidad, y OpenAI se apoyó en ello:
- Factualidad. OpenAI informa que la familia GPT-6 comete menos errores factuales que sus predecesores GPT-5.6. Artificial Analysis registró que la tasa de alucinación de Luna con máximo esfuerzo bajó del 93% al 77%, una mejora real, aunque todavía superior a la de Sol en la misma prueba.
- Frontera de eficiencia de costos. El objetivo de Luna es el rendimiento por dólar, y ahí es donde se mueve: la misma inteligencia ligera a aproximadamente la mitad del costo por token.
- Evaluaciones agénticas. La familia registró pequeñas mejoras en AutomationBench y Terminal-Bench, pero Luna no es el modelo al que se recurre para trabajo agéntico difícil. Ese es Sol y Astra.
La comunidad lo interpretó de la misma manera. En la discusión del lanzamiento, un desarrollador lo expresó claramente:
«Me habría encantado un mejor rendimiento por el doble de precio, más que un rendimiento ~igual por la mitad del precio».

Ese es el marco honesto para los precios de GPT-6 Luna. Si ya usaba GPT-5.6 Luna, esto es un recorte de factura gratis. Si esperaba que el «6» significara un salto en la inteligencia bruta, las puntuaciones de los benchmarks invitan a moderar esa expectativa.
Niveles de servicio: la variación de 4x que casi nadie nota
La tarifa estándar es un punto de partida, no toda la historia. GPT-6 Luna funciona en los mismos niveles de servicio que el resto de la familia, y la brecha entre el más barato y el más caro es de 4 veces para exactamente el mismo modelo. Para un modelo de alto volumen como Luna, esa es la palanca individual más grande sobre el costo.
| Nivel | Entrada (por 1M) | Entrada en caché | Salida (por 1M) | Compensación |
|---|---|---|---|---|
| Batch | $0.05 | $0.005 | $0.25 | 50% de descuento, asíncrono, hasta 24h |
| Flex | $0.05 | $0.005 | $0.25 | 50% de descuento, más lento, puede quedar en cola |
| Estándar | $0.10 | $0.01 | $0.50 | Latencia predeterminada |
| Modo Fast | $0.20 | $0.02 | $1.00 | 2x, latencia más baja |
Fuente: precios de la API de OpenAI. Algunas cosas que conviene saber antes de elegir:
- Batch y Flex cuestan lo mismo, pero son para trabajos distintos. Batch es para trabajo asíncrono que se envía y se recoge más tarde; Flex es para solicitudes interactivas que está dispuesto a dejar correr más lento o en cola. Ambos reducen su factura a la mitad.
- El modo Fast duplica la tarifa para la latencia más baja, y acepta
service_tier: "priority"oservice_tier: "fast". - El modo Fast tiene una trampa regional. Para la residencia de datos en la UE puede caer de vuelta al estándar, así que no lo dé por sentado en todas partes.
Si una carga de trabajo tolera la latencia, pasarla por defecto a Batch o Flex vuelve a reducir su gasto en Luna a la mitad. Eso se suma a la bajada de precio respecto a GPT-5.6: un trabajo apto para lotes en GPT-6 Luna se ejecuta a $0.05/$0.25, que es donde viven los trabajos de clasificación y extracción realmente baratos y de alto volumen.
Las trampas: contexto largo y la ficha técnica
Dos detalles se esconden en la letra pequeña de la página del modelo, y ambos pueden alterar un presupuesto en silencio.
Primero, el contexto largo se factura a una tarifa más alta para toda la solicitud. La ventana de contexto de Luna es amplia, 1.050.000 tokens, pero cualquier prompt de más de 272K tokens de entrada hace que toda la solicitud pase a la tarifa de contexto largo: $0.20 por millón de entrada y $0.75 por millón de salida en el nivel estándar. Eso es 2x en entrada y 1,5x en salida, aplicado a cada token de la solicitud, no solo a los que superan el umbral.
| Nivel estándar | Contexto corto (≤272K) | Contexto largo (>272K) |
|---|---|---|
| Entrada (por 1M) | $0.10 | $0.20 |
| Entrada en caché | $0.01 | $0.02 |
| Salida (por 1M) | $0.50 | $0.75 |
Segundo, vale la pena conocer la ficha técnica antes de comprometerse. GPT-6 Luna admite hasta 922.000 tokens de entrada y devuelve hasta 128.000, con una fecha de corte de conocimiento del 18 de mayo de 2026, un mes después que Sol. Acepta texto e imagen como entrada, texto como salida, y expone un esfuerzo de razonamiento desde none hasta max, con medium como predeterminado. También incluye el conjunto completo de herramientas de la Responses API: búsqueda web, intérprete de código, shell alojado, uso de computadora y MCP. El límite mínimo de tasa es Tier 1 con 500 solicitudes y 500K tokens por minuto, escalando a 30.000 solicitudes y 180M tokens por minuto en Tier 5.
Estime su factura de la API de GPT-6 Luna
Los precios de lista son abstractos hasta que pone sus propios números. Introduzca los millones de tokens de entrada y salida que espera al mes, elija un nivel de servicio, y esto calcula el costo mensual. Tiene en cuenta el recargo por contexto largo automáticamente.
El patrón que la mayoría de los equipos encuentra es que los tokens de salida dominan la factura, ya que la salida cuesta 5 veces la tarifa de entrada. Para las cargas de trabajo de alto volumen de Luna, esa cuenta escala rápido, y mover un trabajo apto para lotes a Batch es donde el ahorro se paga más rápido.
Precios de GPT-6 Luna en ChatGPT y Codex
Si no está llamando a la API, GPT-6 Luna le llega a través de ChatGPT y Codex, y aquí es donde la historia de Luna se diferencia del resto de la familia: es el modelo que todos obtienen.
| Plan | Precio | Acceso a GPT-6 Luna |
|---|---|---|
| Free | $0 | Sí (app de escritorio) |
| Go | $8/mes | Sí (app de escritorio) |
| Plus | $20/mes | Sí |
| Pro | Desde $100/mes | Sí |
| Business / Enterprise / Edu | Por puesto | Sí |
Fuente: anuncio de lanzamiento de OpenAI. Algunas cosas destacan:
- Luna llega a Free. Este es el titular para los no desarrolladores: el plan Free y el plan Go de $8 obtienen GPT-6 Luna en la app de escritorio. Ninguno de los dos incluye Sol, que empieza en el plan Plus de $20/mes. Si ha usado un modelo GPT-6 sin pagar por ChatGPT, era Luna.
- Los planes de pago suman Sol encima. Plus y superiores mantienen Luna y añaden GPT-6 Sol, así que pagar más no le quita Luna; amplía su menú de modelos.
- Codex también obtiene Luna. OpenAI lanzó ambos modelos en Codex en los mismos niveles, así que los usuarios de agentes de codificación pueden elegir Luna para ejecuciones más baratas y ligeras.
No todo el mundo quedó convencido de que el ahorro en la suscripción coincida con el recorte de la API. Un desarrollador señaló que los cambios en el límite de mensajes sugerían que el recorte del 50% en la API se tradujo en algo más cercano a un recorte de un tercio dentro de los planes de ChatGPT, así que conviene revisar su propia asignación en lugar de asumir que el descuento de lista se traslada directamente.
Cómo se comparan los precios de GPT-6 Luna
Ampliando la vista, ¿dónde se sitúa Luna frente al resto de la frontera? La versión corta es que OpenAI usó a Luna para fijar el piso de precio de un modelo realmente útil.
- Frente a su propia gama: a $0.10/$0.50, Luna es una quinta parte del precio de GPT-6 Sol ($2/$10) y una centésima parte de GPT-6 Astra en salida ($50). Para trabajo simple y de alto volumen, Luna es la elección obvia; para razonamiento difícil o trabajo agéntico de largo alcance, se sube a Sol o Astra.
- Frente a Anthropic: Luna se sitúa muy por debajo del extremo ligero de la gama de Anthropic en precio bruto por token, que es exactamente el posicionamiento que OpenAI quería en la parte baja del mercado.
- Frente a Google: compite cara a cara con las opciones más ligeras de Gemini como Gemini 3 Flash en una base de precio por inteligencia, que es la verdadera batalla en este nivel.
La imagen más amplia en el hilo de lanzamiento fue que los modelos cerrados siguen abaratándose sin volverse mucho más inteligentes, algo que varios desarrolladores enmarcaron como una carrera hacia el fondo en precio. Eso es buena noticia si está comprando tokens. Es un recordatorio, sin embargo, de que un modelo más barato no cambia la parte más difícil de llevar la IA a un flujo de trabajo real, que es todo lo que rodea al modelo.
Qué significan los precios de GPT-6 Luna si dirige un equipo de soporte
Aquí es donde quiero ser útil en lugar de solo enumerar tarifas. Yo construyo el producto de eesel, así que paso mi tiempo pensando en cómo estos modelos realmente se integran en un flujo de trabajo en vivo, y la respuesta honesta es algo contraintuitiva.
Si dirige soporte al cliente u operaciones internas, un modelo de frontera más barato cambia menos de lo que sugiere el titular. Un modelo en bruto como Luna es infraestructura. Es un motor capaz y barato, pero recién salido de la caja no conoce su política de reembolsos, no puede ver sus últimos 50.000 tickets, no tiene acceso a su sistema de pedidos y no tiene una manera segura de ser probado contra su cola real antes de empezar a responder a los clientes. Se factura por token por pensar, no por problema resuelto. Un precio por token mínimo es real, pero es un descuento en la parte más barata del proyecto.
La unidad que realmente importa para un equipo de soporte es el costo por resolución, no el costo por token. Una factura de tokens es impredecible: se mueve con la longitud del prompt, los reintentos y lo conversador que sea el modelo un día cualquiera. A lo largo de años poniendo IA en colas de soporte en vivo, hemos visto bots que suenan seguros de sí mismos dar respuestas equivocadas en silencio, que es exactamente por qué cada lanzamiento debería simularse contra sus propios tickets históricos antes de acercarse a un cliente. Esa es la brecha entre un modelo y un sistema construido a su alrededor: su conocimiento, sus integraciones, acciones seguras y una forma de probarlo primero con su historial.
Por eso tampoco volvería a cambiar de plataforma su automatización de soporte la semana en que se lanza un nuevo modelo. Los mejores agentes de IA para el helpdesk y herramientas de servicio al cliente son flexibles de modelo por diseño, así que cuando llega un modelo más barato o más inteligente, hereda la mejora sin reconstruir nada, y sin renegociar su presupuesto en torno a una nueva tarifa de tokens.
Pruebe eesel
Si su interés en el precio de Luna es en realidad «¿cuánto me va a costar una IA para resolver tickets de verdad?», ese es el trabajo para el que está construido un compañero de equipo de IA, y ahí es donde encaja eesel. GPT-6 Luna es el motor; eesel es el empleado que contrata para conducirlo. El agente de IA para el helpdesk entrena con sus tickets pasados y su centro de ayuda, se conecta al helpdesk que ya usa en lugar de reemplazarlo, y le permite simularlo contra miles de sus tickets históricos reales para que vea cómo va a rendir, y cuánto le va a costar, antes de que toque nunca una conversación en vivo.
La facturación cuenta la historia que una tarifa de tokens no puede contar. En lugar de pagar por token para pensar, paga 40¢ por ticket que realmente maneja, sin cuotas por puesto y sin mínimo de plataforma, así que el costo sigue a los resultados en lugar de la charla del modelo. Puede empezar gratis con $50 de uso y sin tarjeta de crédito.

Y como esta es una pregunta de precios orientada a desarrolladores, vale la pena saber que todo el espacio de trabajo de eesel se puede manejar desde la terminal, no solo desde un panel. El CLI de eesel (npx @eesel/cli) permite que una persona, un script o un agente de codificación como Claude Code, Codex o Cursor opere el mismo compañero de equipo: conectar un helpdesk, leer y editar las instrucciones vigentes, ejecutar eesel activity para inspeccionar ejecuciones pasadas, y bloquear cambios detrás de eesel approvals. Cada comando imprime JSON, y --dry-run muestra exactamente la llamada al servidor que haría una escritura antes de enviarla. Así que la misma facturación por resolución que modelaría en esta calculadora es algo que puede integrar en sus propias herramientas, no solo algo que recorre en una interfaz.
Los precios de GPT-6 Luna son ahora mismo la forma más barata de ejecutar un modelo capaz, y para trabajo simple de alto volumen el precio vale la pena. Pero para la mayoría de los equipos de soporte, la tarifa de tokens nunca fue el número que importaba. Conseguir un compañero de equipo probado, conectado y responsable dentro de su flujo de trabajo existente, facturado por resultado, es la parte en la que vale la pena gastar su presupuesto.
Preguntas frecuentes
¿Cuánto cuesta GPT-6 Luna en la API?
¿Es GPT-6 Luna más barato que GPT-5.6 Luna?
¿Está disponible GPT-6 Luna en el plan gratuito?
¿Qué es el recargo por contexto largo de GPT-6 Luna?
¿Cuánto cuesta GPT-6 Luna en ChatGPT y Codex?
¿Qué cambian Batch y el modo Fast en los precios de GPT-6 Luna?
Precios de GPT-6 Luna vs GPT-6 Sol: ¿cuál debería usar?


Article by
Rama Adi Nugraha
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.