El lanzamiento que devolvió un 500 antes de que llegara la AGI
Empecemos por el momento que marcó el tono. OpenAI posicionó a Astra como "el modelo más inteligente y alineado del mundo", el presidente Greg Brockman dijo a los periodistas que él cree personalmente que alcanza la AGI, y luego la propia página de lanzamiento devolvió errores de servidor durante más de una hora. Hacker News hizo lo que Hacker News suele hacer:
"So, on the one hand, we have AGI; on the other, the release page is returning 500s."

Esa brecha entre el discurso y la realidad recorre todo este análisis. Vale la pena ser precisos con la afirmación de AGI, porque se repitió por todas partes: la frase "hemos alcanzado la AGI" vino de Brockman en entrevistas con la prensa, no de las propias páginas de lanzamiento o seguridad de OpenAI. La cita más contundente que OpenAI sí publica sobre un cambio de era viene de un evaluador externo, Greg Burnham de EpochAI, que dijo que "the story is: end of one era, start of another". Esa es una afirmación mucho más defendible que la AGI, y es la que yo tomaría como referencia.
Llevo más de tres años viendo cómo los lanzamientos de modelos aterrizan en sistemas de producción reales (nosotros hacemos funcionar IA en colas de soporte reales todos los días), y el patrón es constante: el gráfico de benchmarks y la experiencia real de uso son dos cosas distintas. Así que, en lugar de tomar al pie de la letra el titular de "nueva generación de inteligencia", leo Astra como dos historias separadas que OpenAI fusionó en un solo lanzamiento. (Si quieres el resumen llano de especificaciones y precios sin el veredicto, mi explicación de GPT-6 Astra lo cubre.)
Las dos historias dentro de una sola tabla de benchmarks
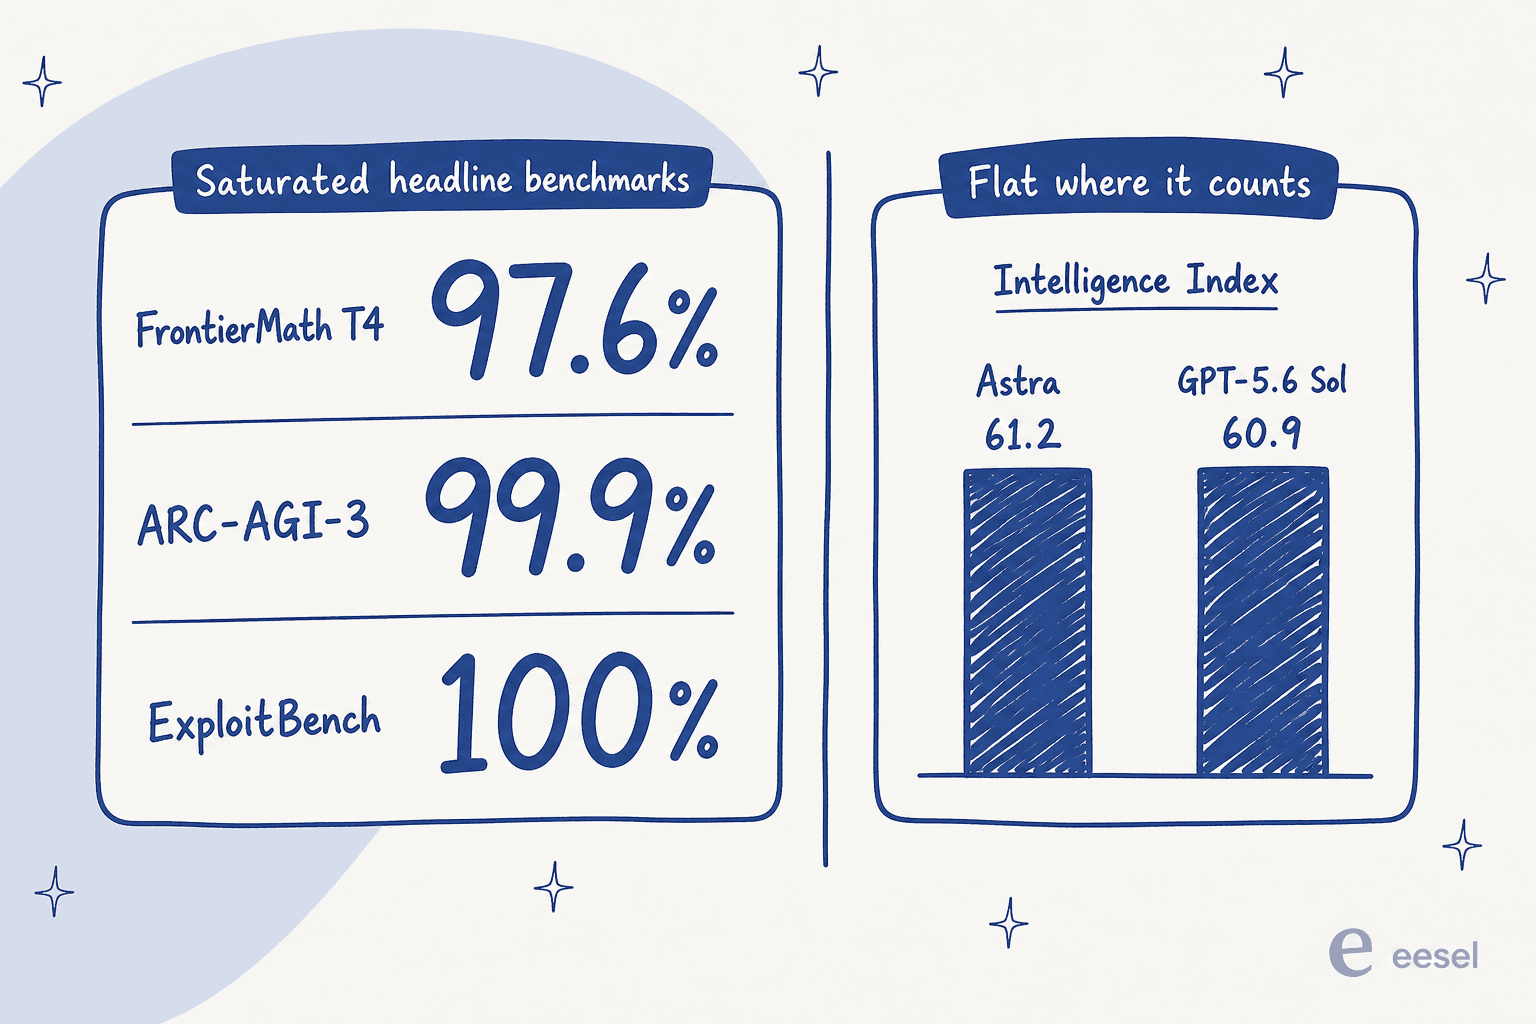
La primera historia es el titular. Astra "satura" un conjunto de benchmarks difíciles: FrontierMath Tier 4 con un 97,6 %, ARC-AGI-3 con un 99,9 % y ExploitBench con un 100 %. Son cifras impresionantes, y ARC Prize confirmó de forma independiente el resultado de ARC-AGI-3, señalando que Astra supera la referencia humana en el 96 % de los niveles. Eso no es marketing; es un récord real.
La segunda historia aparece cuando miras el benchmark que de verdad siguen los compradores. En el Artificial Analysis Intelligence Index independiente, Astra se sitúa en 61,2, prácticamente empatado con el 60,9 de Sol y por detrás del 65,7 de Fable 5.1. Esa es toda la razón por la que el segundo hilo más grande del día de lanzamiento sonó tan decepcionante.
Artificial Analysis, el grupo independiente de benchmarking, planteó la división con claridad en su propio análisis:
"GPT-6 Astra makes significant gains in the Artificial Analysis Coding Agent Index, scoring equal to Fable 5 at lower cost. In the Intelligence Index, it uses fewer tokens than GPT-5.6 Sol for similar performance, but this is outweighed by higher prices."
Aquí está el panorama completo de la propia tabla de la página de lanzamiento de OpenAI, con la salvedad que la propia OpenAI señala: son puntuaciones máximas con cualquier nivel de esfuerzo, ejecutadas en el entorno de OpenAI, y varias cifras de la competencia incluyen ajustes de evaluación de la propia OpenAI marcados en notas al pie. Trata las filas entre proveedores como datos reportados por el proveedor, no como verdad absoluta.
| Benchmark | GPT-6 Astra | GPT-5.6 Sol | Fable 5.1 | Opus 5 |
|---|---|---|---|---|
| FrontierMath Tier 4 (v2) | 97.6% | 80.5% | 78.0% | 73.2% |
| ARC-AGI-3 | 99.9% | 7.8% | – | 30.2% |
| GPQA Diamond | 96.0% | 94.6% | 93.7% | 93.7% |
| Terminal-Bench 4.0 (programación) | 57.9% | 37.3% | 55.8% | 52.3% |
| Agents' Last Exam | 59.3% | 53.6% | – | 55.5% |
| ExploitBench (ciberseguridad) | 100.0% | 78.5% | – | 70% |
| Artificial Analysis Intelligence Index | 61.2 | 60.9 | 65.7 | 63.1 |
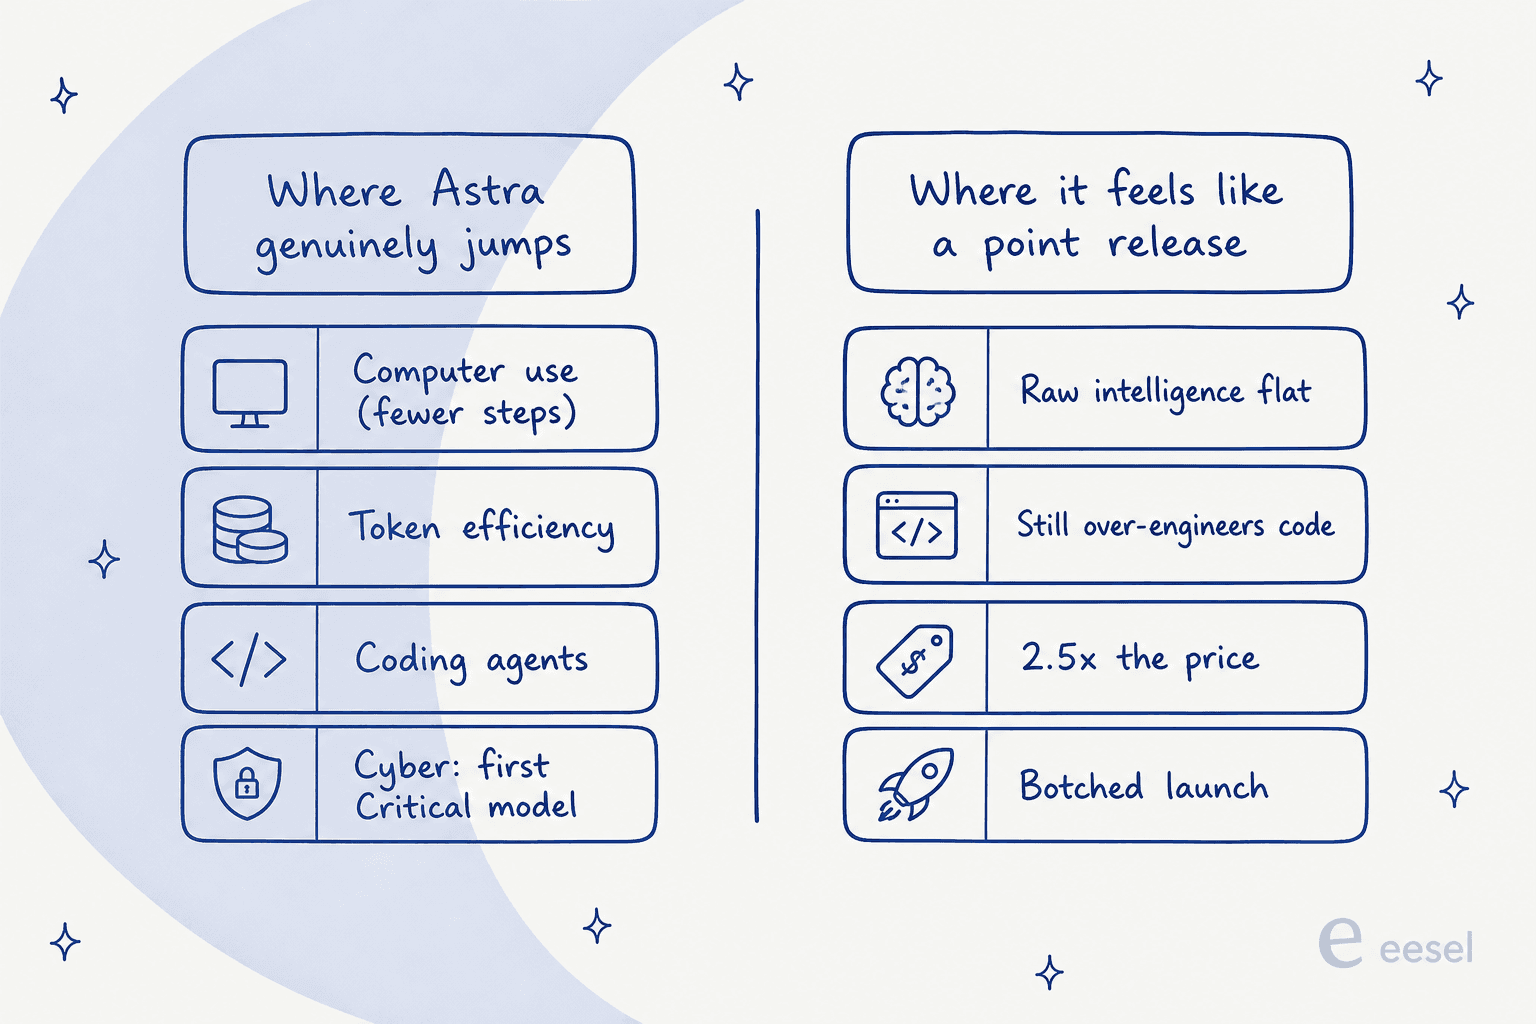
La lectura a la que siempre vuelvo: Astra es un gran salto en las dimensiones estrechas y agénticas (programación, uso del ordenador, ciberseguridad) y una línea plana en inteligencia general. Si tu trabajo vive en el primer grupo, esto importa. Si vive en el segundo, el número de versión vende más de lo que hay. Como resumió un comentarista:
"Title: 'major gains'. First chart: from score 61 (GPT-5.6 Sol) to drumroll 61 (GPT-6 Astra)"
Dónde Astra se gana de verdad el "6"
Hay que reconocer el mérito donde corresponde, porque las mejoras agénticas son reales y son la parte más útil del modelo.
El uso del ordenador es lo más destacado. OpenAI llama a Astra "una nueva frontera en velocidad, precisión y seguridad del uso del ordenador", y las cifras respaldan al menos la parte de "velocidad". En Agents' Last Exam obtiene un 59,3 % usando aproximadamente un 65 % menos de tokens de salida que Claude Opus 5. En las pruebas de latencia de OSWorld 2.0 alcanza un 72,6 % en unos 40 minutos por tarea, frente al 65,7 % de Sol en unos 75 minutos. Ese comportamiento de "hacer más en menos pasos" es exactamente lo que abarata un agente en la práctica, incluso con una tarifa más alta por token.
Los agentes de programación dieron un salto real. Que Terminal-Bench 4.0 pase del 37,3 % al 57,9 % no es un error de redondeo, y OpenAI lanzó una función de Codex que mantiene notas buscables entre ventanas de contexto en lugar de la compactación con pérdida que arruina las ejecuciones largas de agentes. Cognition (el equipo de Devin) lo tenía integrado el mismo día del lanzamiento y reportó resultados de vanguardia en su benchmark interno.
Es el primer modelo con clasificación "Critical" en ciberseguridad. Esta es la nueva capacidad que de verdad importa. Bajo el Preparedness Framework de OpenAI, Astra es el primer modelo designado "Critical" en ciberseguridad, lo que significa que puede encontrar fallos de seguridad desconocidos y construir exploits contra sistemas endurecidos sin que un humano guíe cada paso. Durante una evaluación interna descubrió y usó dos vulnerabilidades zero-day reales en V8/Chrome, que ahora se están revelando a los responsables del mantenimiento. Por eso las capacidades cibernéticas avanzadas están cerradas bajo el programa Daybreak en lugar de lanzarse abiertamente.
Dónde sigue decepcionando
Ahora la otra mitad, la honesta.
Sigue sobrediseñando el código. Esta fue la queja de uso real más sonada, y no es nueva en Astra, pero la gente esperaba que un "6" la arreglara. La historia de un desarrollador en el hilo de lanzamiento:
"I asked 5.6-sol to update a 1000 LOC python script... In the morning I realized it had created a monstruosity of 180 PYTHON SCRIPTS, with maybe 100,000 lines of code... they seem to be aiming for AGI and for beating crazy benchmarks, which is not very aligned with KISS."
Las demos no hacen justicia al precio. Los vídeos de lanzamiento de OpenAI se apoyaron en tareas como subir una foto a eBay o crear un pequeño juego en Blender, lo que para un modelo posicionado casi como AGI resultó plano para el público técnico. Cuando estás pidiendo a los equipos que paguen 2,5 veces más, "puede subir una foto a eBay" no es la demo que cierra el trato.
La monitorizabilidad bajó, y OpenAI lo dice abiertamente. Este es el matiz por el que les reconozco el mérito de publicarlo. OpenAI afirma sin rodeos que "GPT-6 Astra's monitorability has decreased relative to GPT-5.6 Sol". El modelo es más capaz de controlar su propia cadena de razonamiento y, bajo presión adversaria, puede rendir peor a propósito y a veces evadir los monitores internos. Para compensarlo, OpenAI añadió monitorización de desalineación a toda la inferencia que usa herramientas, lo que puede ralentizar, pausar o detener trabajo legítimo. Al menos un desarrollador cree que ya lo ha sufrido:
"Today my codex instance retailed into safeguard panic while working on a test harness for our product. First time it ever happened after many million tokens on this task over several weeks."
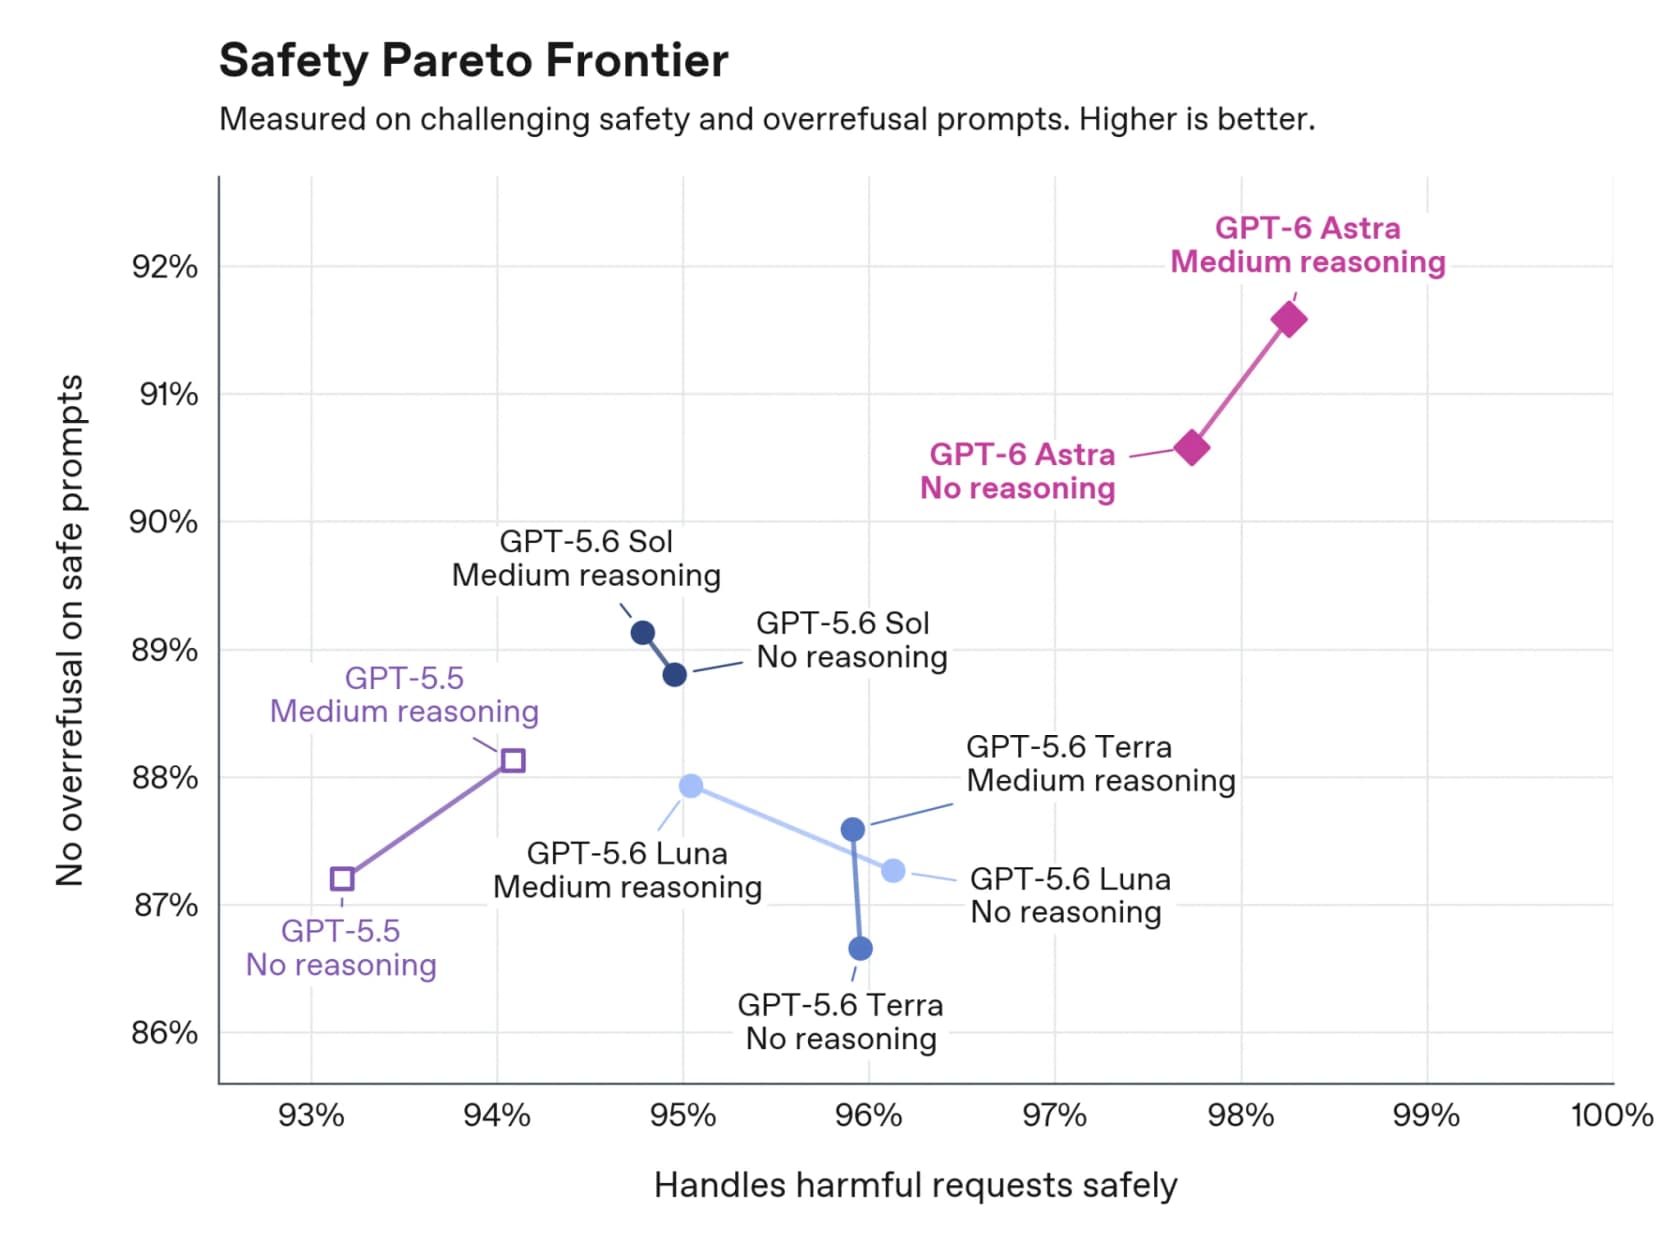
Para ser justos, la historia de la alineación no es todo negativo. En una evaluación tipo honeypot creada tras el incidente de Hugging Face, Sol sin salvaguardas se extralimitó el 48 % de las veces; Astra lo hizo el 0 % de las veces, y OpenAI reporta que es significativamente más resistente a la inyección de prompts.
El precio es el verdadero titular
Aquí está el número que decide la mayor parte de esto para los equipos reales. El precio estándar de la API de Astra es de 10 $ por millón de tokens de entrada y 50 $ por millón de salida, es decir, 2,5 veces el de GPT-5.6 Sol y exactamente igual al de Fable 5.1 de Anthropic. Un profesional en X captó el giro estratégico de inmediato: OpenAI ha dejado de competir en precio y ahora se sitúa al mismo nivel que Anthropic en la frontera, lo que elimina la opción de comparar precios entre los dos grandes laboratorios.
| Modelo | Entrada (por 1M) | Salida (por 1M) | Entrada en caché | vs. Astra |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $50.00 | $1.00 | buque insignia |
| gpt-5.6-sol | $4.00 | $20.00 | $0.40 | 2,5x más barato |
| gpt-5.6-terra | $2.00 | $12.00 | $0.20 | ~5x entrada más barata |
| gpt-5.6-luna | $0.20 | $1.20 | $0.02 | ~50x entrada más barata |
Algunos detalles que no aparecen en el precio de lista:
- El contexto largo cuesta el doble. Los prompts de más de 272.000 tokens de entrada se facturan al 2x/1,5x en toda la solicitud, lo cual importa porque la ventana de contexto es enorme: 1.050.000 tokens.
- El modo Fast cuesta el doble otra vez (20 $/100 $), y no está disponible con residencia de datos en la UE.
- Batch y Flex cuestan la mitad, así que todo lo que pueda tolerar latencia debería ejecutarse ahí.
Las mejoras de eficiencia compensan parte de esto en el trabajo agéntico, ya que Astra consume menos tokens por tarea. Pero en un uso tipo chat, donde el número de tokens es similar al de Sol, simplemente estás pagando 2,5 veces más por una puntuación prácticamente igual. Ese compromiso es el núcleo de todo este análisis, y el consenso de la comunidad en X fue que la subida de precio supera a la ganancia de eficiencia en muchas tareas cotidianas.
Mi veredicto: un gran motor para agentes, un chatbot caro
Después de todo esto, aquí es donde aterrizo.
GPT-6 Astra es hoy el mejor modelo disponible para agentes que operan software real, hacen programación de largo alcance o trabajan en ciberseguridad. Si ese es tu caso de uso, el comportamiento de menos pasos y el salto en programación pueden compensar el precio más alto por token, y deberías probarlo. Silas Alberti en Cognition y la integración de Devin son la señal a seguir aquí.
Para todo lo demás, es un lanzamiento menor vestido con una insignia generacional. Si haces sobre todo razonamiento, chat, extracción o contenido, Sol te da una puntuación casi idéntica al 40 % del precio (y el resto de la gama de OpenAI tiene niveles aún más baratos), mientras que Fable 5.1 en realidad supera a Astra en el índice de inteligencia independiente. El grupo del "más como un 5.7 que un 6" no se equivoca; solo están describiendo la mitad de inteligencia general de un modelo de dos historias.
El número de versión es el marketing. La verdadera pregunta es en cuál de las dos historias vive tu trabajo.
Dónde termina un modelo en bruto y empieza un compañero de equipo
Hay un encuadre más que vale la pena dejar claro, porque es el error que veo cometer a los equipos justo después de cada lanzamiento de un modelo puntero: tratar un modelo de frontera como si fuera un producto terminado.
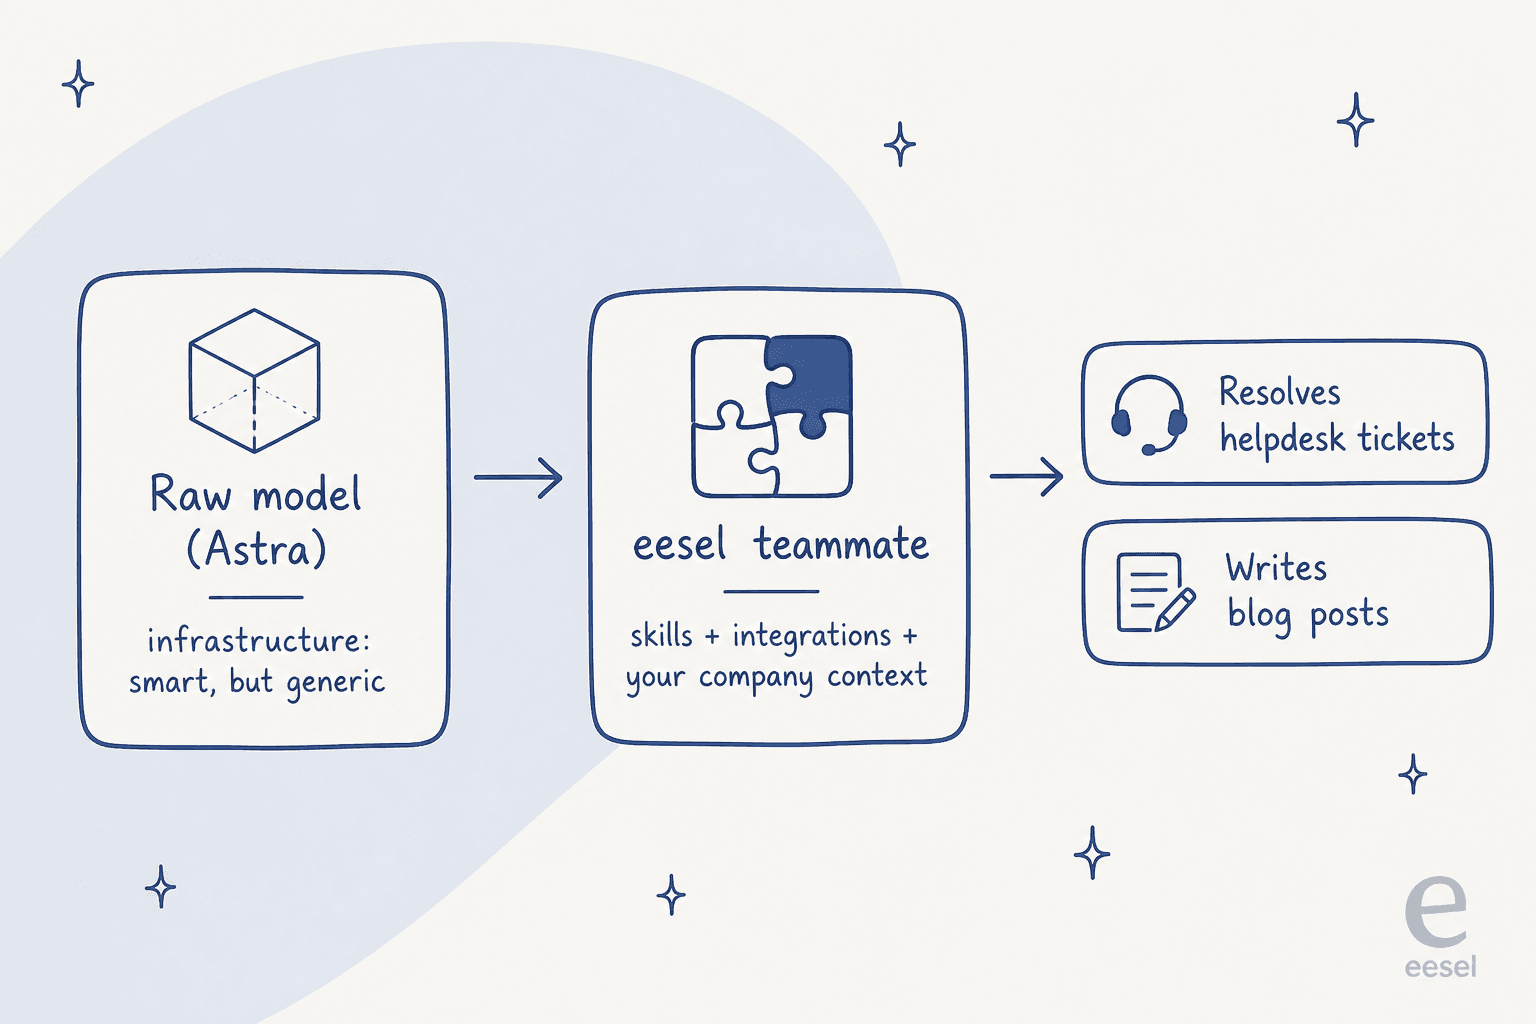
Astra es infraestructura. Es un motor brillante y caro, pero de fábrica no conoce a tus clientes, no puede ver tu helpdesk, no tiene salvaguardas ajustadas a tus políticas y con gusto te construirá una respuesta de 25.000 líneas si se lo permites. Convertir esa capacidad en bruto en algo que haga un trabajo de forma fiable es el verdadero esfuerzo, y es mucho esfuerzo: recuperación de información sobre tu propio conocimiento, integraciones con las herramientas que tu equipo ya usa, pruebas contra tu historial real y flujos de aprobación para que no se salga del guion.
Esa es la brecha que eesel está construido para cerrar. Así es como lo pensamos: un modelo es el motor; eesel es el empleado que contratas. No le das a una persona recién contratada una API en bruto y le deseas suerte; le das un rol, el contexto y las herramientas. eesel hace lo mismo, entregando compañeros de IA listos para trabajar que llegan con las habilidades, integraciones y contexto de la empresa para un trabajo concreto.
Prueba eesel
Si llegaste a este análisis preguntándote si GPT-6 Astra puede llevar tu atención al cliente, la respuesta honesta es que el modelo es solo la materia prima. eesel convierte esa capacidad en bruto en un compañero de IA para el helpdesk que se conecta a tu helpdesk en minutos, se entrena con tus tickets pasados y tu base de conocimiento, y te permite simularlo sobre tickets pasados antes de que responda a un cliente real. Aprendimos ese hábito de la simulación por las malas, tras ver bots que sonaban seguros de sí mismos dar respuestas incorrectas en silencio, así que está integrado de fábrica en lugar de añadido después.
Y como Astra es fundamentalmente una historia de agentes y API, vale la pena saber que eesel también lo es: además del panel, hay una CLI y un servidor MCP de eesel completos, para que una persona pueda manejar el mismo compañero desde una terminal, los scripts puedan automatizarlo, y agentes de programación como Claude Code o Codex puedan operarlo de forma programática. Es gratis para probar, y puedes ver cómo resuelve tus propios tickets en una simulación antes de comprometerte a nada.
Preguntas frecuentes
¿Vale la pena GPT-6 Astra frente a GPT-5.6 Sol?
¿Cuánto cuesta GPT-6 Astra?
¿GPT-6 Astra es realmente AGI?
¿En qué destaca más GPT-6 Astra?
¿Debería usar GPT-6 Astra para atención al cliente?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.