
Por qué mirar más allá de GPT-6.1 Sol
Quiero ser justo primero con 6.1 Sol. Se lo ha ganado. OpenAI lo lanzó en el DevDay el 29 de septiembre de 2026, solo siete días después de GPT-6 Sol, y reemplazó al modelo anterior en la tabla de precios principal de OpenAI. El precio de lista se mantuvo en $2/$10. Sin embargo, la entrada en caché bajó a $0.10 por millón, la mitad de lo que cobraba GPT-6 Sol. Artificial Analysis le da 51.8 con esfuerzo máximo por $0.72 la tarea, cerca de 1 punto por debajo de GPT-6 Astra al 22 % del coste de Astra.
Es una posición sólida, y Artificial Analysis lo dijo bastante claro el día del lanzamiento:
"All effort levels of GPT-6.1 Sol push out the cost efficiency Pareto frontier: for a given level of intelligence, there is no cheaper model."
Entonces, ¿por qué comparar? Al leer los hilos del lanzamiento y hacer mis propias pruebas, siguieron saliendo tres razones.
Cambió la API por debajo. 6.1 Sol solo acepta esfuerzo low, medium, high, xhigh y max. Probé a enviarle none el 1 de octubre y recibí "Unsupported value: 'none' is not supported with the 'gpt-6.1-sol' model." El function calling en Chat Completions solo funciona con esfuerzo none, lo que deja a cualquier bot construido sobre llamadas a herramientas de Chat Completions con dos opciones: pasarse a la Responses API o quedarse en un modelo anterior.
Es más lento. Artificial Analysis midió 67 tokens por segundo frente a 76 de GPT-6 Sol, y en mi propia prueba tardó 4.1s por ticket con esfuerzo medio frente a 3.5s del modelo anterior. Esa diferencia parece pequeña. Deja de parecerlo cuando hay un cliente esperando la respuesta.
Sigue siendo un solo proveedor, pesos cerrados, sin nivel gratuito. Si el cumplimiento normativo te obliga a alojarlo tú mismo, o simplemente quieres un segundo proveedor en los libros, 6.1 Sol no te ayuda ahí.
Alguien en Hacker News detectó el cambio de la API el primer día:
"That seems likely, in the API GPT-6.1 Sol requires reasoning, just like Astra, whereas GPT-6 Sol (and Luna) allow "none""

Cómo es realmente el coste por tarea
Antes de la lista, hay un gráfico que merece una mirada, porque cambia cómo deberías leer cada precio de lista de más abajo. Extraje las páginas de modelos de Artificial Analysis de cada alternativa el 1 de octubre de 2026, lo que significa que cada puntuación de aquí sale de un índice en un solo día. La gente mezcla constantemente instantáneas del índice de semanas distintas y acaba publicando disparates. Yo no quería hacer eso.
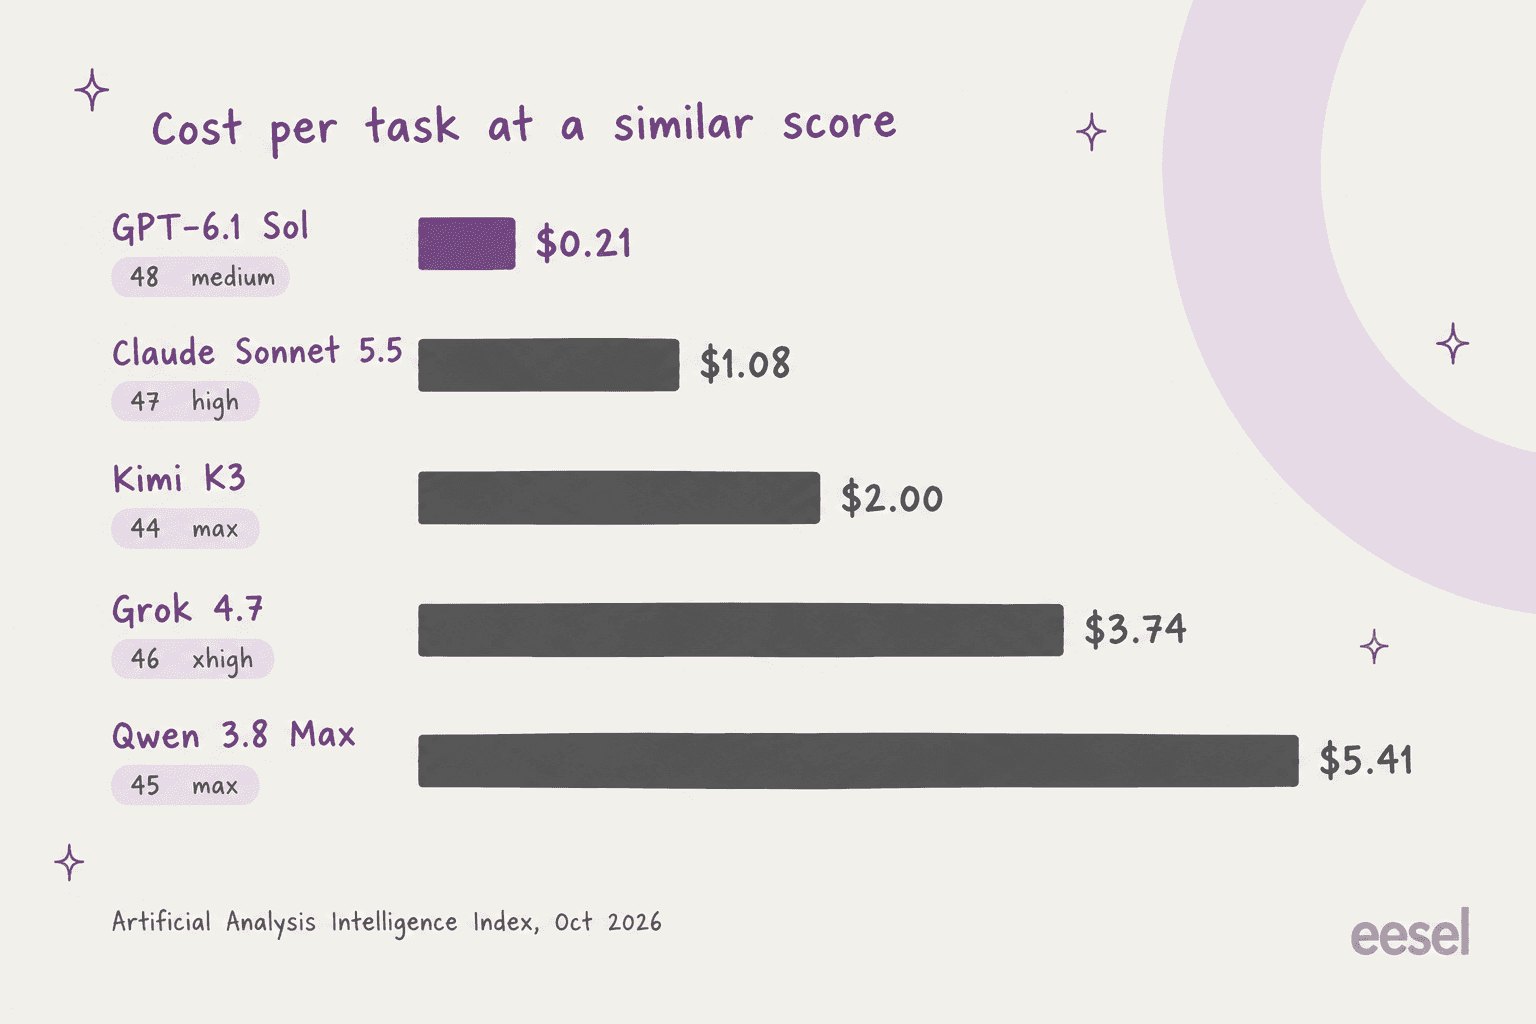
Todos los modelos del gráfico puntúan a menos de unos 4 puntos de 6.1 Sol con esfuerzo medio. Cada uno cuesta de 5 a 26 veces más por tarea. Toma Grok 4.7. Su precio de salida es menor que el de Sol ($6 frente a $10), y aun así cuesta $3.74 por tarea, porque escribe muchos más tokens para llegar. Un comentarista de Hacker News hizo la misma observación sobre los modelos chinos baratos, y lo dijo de forma más colorida de lo que yo lo haría:
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens"
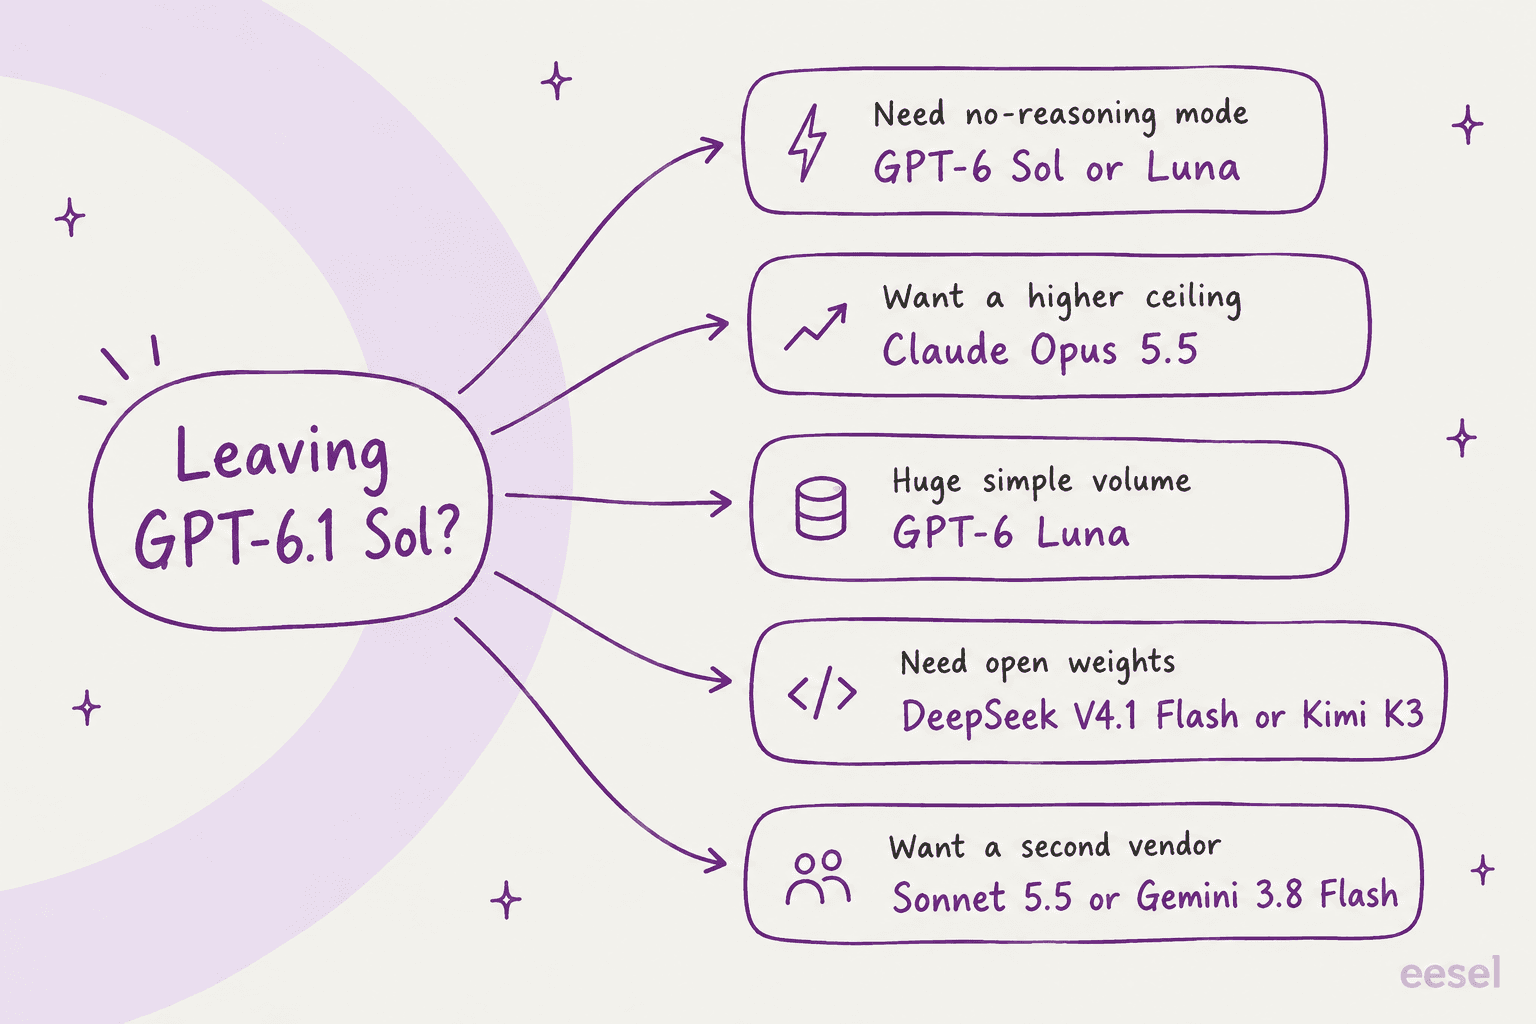
Así que la pregunta útil no es "qué modelo es más barato que Sol". Por tarea, casi ninguno. La mejor pregunta es "cuál de mis cinco razones se aplica a mí".
Cómo elegí y probé estas alternativas
Todos los modelos de aquí están disponibles de forma general hoy en una API pública. A partir de ahí valoré cuatro cosas: precios reales por token de la página de precios de cada proveedor, más coste por tarea y puntuación de la misma instantánea de Artificial Analysis. También miré si los pesos son abiertos y qué tan bien encaja cada modelo con una razón concreta para dejar 6.1 Sol.
Después, las cuatro opciones más baratas o más relevantes pasaron por mi prueba de soporte. Es el mismo banco de pruebas de mi reseña de GPT-6.1 Sol: 15 tickets contra una política breve de reembolsos y envíos de una empresa SaaS inventada, con una herramienta de consulta de pedidos que a veces falla a propósito. Los tickets son variados: plazos de reembolso y cálculos prorrateados, una inyección de prompt, un cobro duplicado con un cliente enfadado, solicitudes en español y alemán, una herramienta rota y un ID de pedido con un error tipográfico.
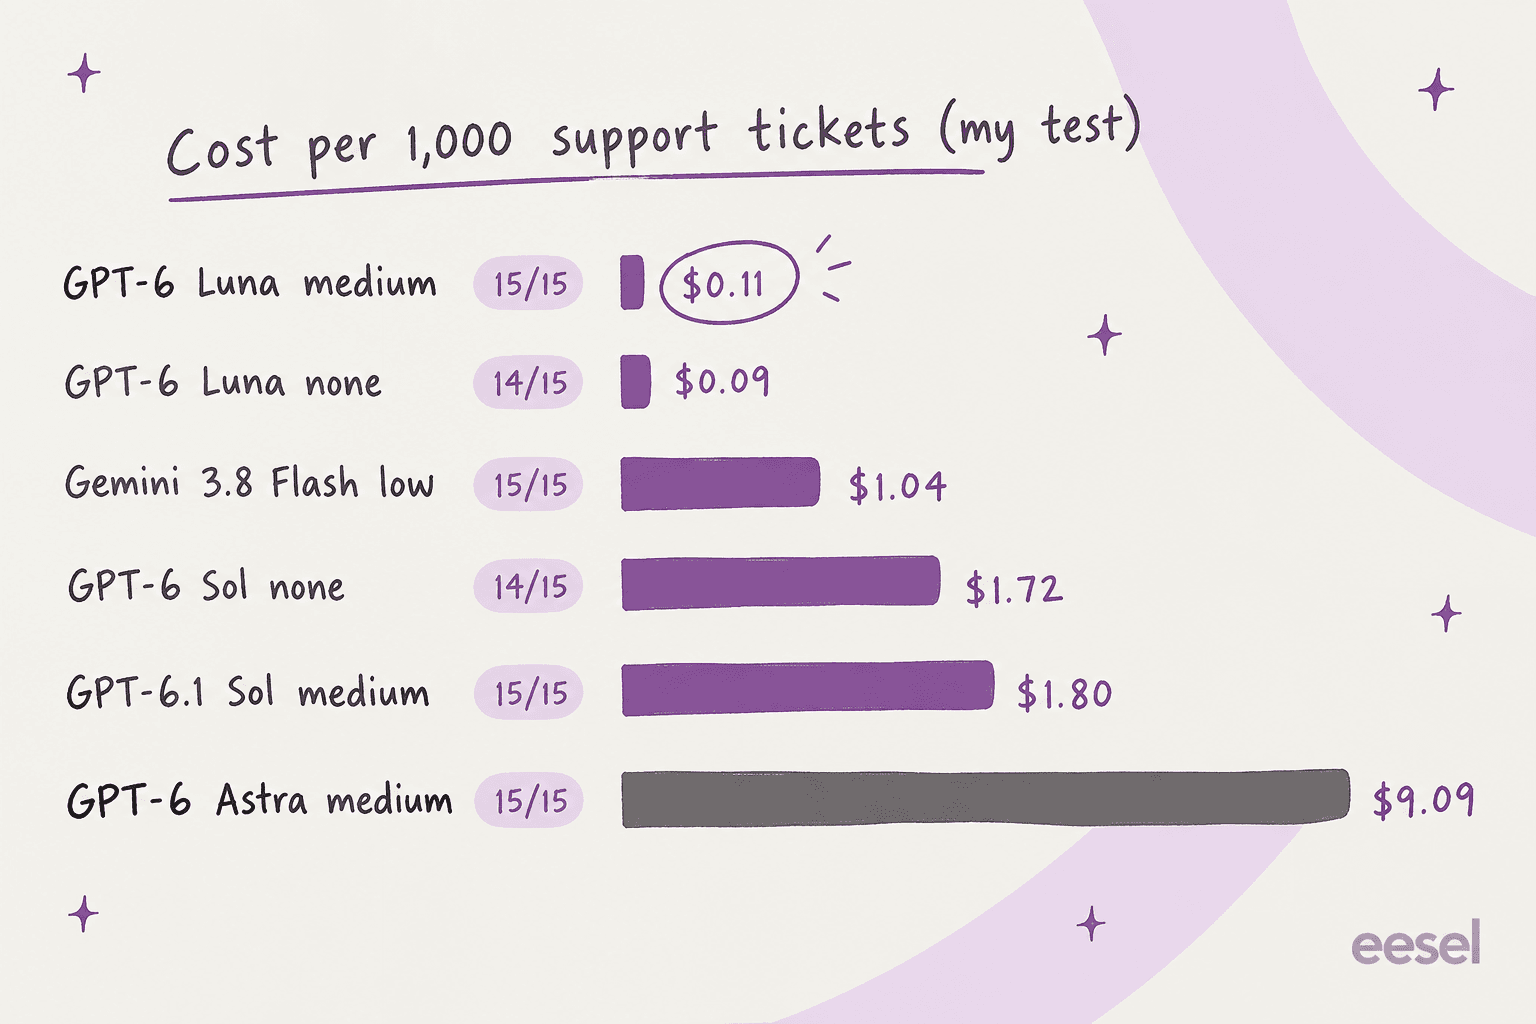
Un par de cosas me sorprendieron. Primero, el modelo más barato de la gama de OpenAI igualó el 15/15 de 6.1 Sol. Segundo, los únicos dos fallos vinieron de las ejecuciones con esfuerzo none, y ambos fueron el mismo ticket: el cálculo del reembolso prorrateado. Sin razonamiento, tanto GPT-6 Sol como GPT-6 Luna dijeron que no podían calcular la cantidad y lo pasaron a una persona. Sube Luna a esfuerzo medio, sin embargo, y llegó a $990, que es la respuesta correcta.
Una advertencia, porque la querría si fuera yo quien lee: 15 tickets con una política limpia son una prueba pequeña y bastante amable. Lo que demuestra es que estos modelos pueden seguir reglas y usar una herramienta. Lo que no puede demostrar es cómo manejan tus macros desordenadas, tu centro de ayuda de 400 artículos o un cliente que escribe primero tres párrafos sobre otra cosa.
Aquí está todo el panorama lado a lado.
| Modelo | Mejor razón para cambiar | Precio API (entrada / caché / salida por 1M) | Puntuación AA / coste por tarea | Contexto | Pesos | Mi prueba |
|---|---|---|---|---|---|---|
| GPT-6.1 Sol (referencia) | - | $2 / $0.10 / $10 | 47.8 / $0.21 (medium) | 1.05M | Cerrados | 15/15, $1.80 por 1k |
| GPT-6 Luna | Gran volumen simple | $0.10 / $0.01 / $0.50 | 29.5 / $0.018 (medium) | 1.05M | Cerrados | 15/15, $0.11 por 1k |
| GPT-6 Sol | Necesitas esfuerzo none | $2 / $0.20 / $10 | 39.8 / $0.25 (medium) | 1.05M | Cerrados | 14/15, $1.72 por 1k |
| Claude Opus 5.5 | Techo más alto | $4 / $0.20 / $20 | 57.6 / $5.98 (max) | 1M | Cerrados | - |
| Claude Sonnet 5.5 | Segundo proveedor, mismo precio | $2 / $0.20 / $10 | 46.7 / $1.08 (high) | 1M | Cerrados | - |
| GPT-6 Astra | Ultrafast hoy | $10 / $1 / $50 | 52.7 / $3.26 (max) | 1.05M | Cerrados | 15/15, $9.09 por 1k |
| Gemini 3.8 Flash | Nivel gratuito, stack de Google | $0.75 / $0.075 / $3.75 | 40.9 / $1.24 (high) | 1M | Cerrados | 15/15, $1.04 por 1k |
| Grok 4.7 | Tarifa de salida más barata | $2 / $0.50 / $6 | 46.4 / $3.74 (xhigh) | 500K | Cerrados | - |
| DeepSeek V4.1 Flash | Pesos abiertos, MIT | $0.15 / $0.003 / $0.60 (fuera de horas punta) | 39.5 / $0.27 (max) | 1M | Abiertos | - |
| Kimi K3 | Pesos abiertos de frontera | $3 / $0.30 / $15 | 43.6 / $2.00 (max) | 1M | Abiertos | - |
¿Por qué dejas GPT-6.1 Sol?
Elige la razón que mejor encaje contigo.
none y permiten function calling en Chat Completions. 6.1 Sol rechaza ambos. Planifica igualmente el paso a la Responses API, porque GPT-6 Sol ya ha sido reemplazado en la tabla de precios principal.1. GPT-6 Luna: el que probaría primero para volumen de soporte
Ideal para: trabajo de alto volumen basado en reglas, como respuestas a tickets, etiquetado y enrutamiento, donde importan más la velocidad y el coste que el razonamiento máximo.
Este cambió mi propio valor por defecto. GPT-6 Luna es el modelo GPT-6 más barato de OpenAI, $0.10 de entrada y $0.50 de salida por millón de tokens, y con esfuerzo medio acertó 15 de 15 de mis tickets de soporte. Consultó la herramienta de pedidos y rechazó la inyección de prompt. En el cobro duplicado citó la regla de 5 días hábiles en lugar de prometer "hoy". También respondió en español y alemán, y luego calculó el reembolso prorrateado de $990. La ejecución completa salió a $0.11 por cada 1,000 tickets, mientras que 6.1 Sol en medium costó $1.80.
Nada de lo que probé fue más rápido tampoco: 3.0s por ticket con esfuerzo medio y 2.3s con none. Su página de modelo indica la misma ventana de contexto de 1,050,000 tokens que Sol, un corte de conocimiento de mayo de 2026 y el rango completo de esfuerzo de none a max.
Donde Luna se queda corto es en el índice de Artificial Analysis, no en mi prueba. Luna puntúa 29.5 en medium y 37.3 en max, frente a 47.8 de 6.1 Sol en medium. Mis tickets eran cortos y la política estaba ordenada, así que esa brecha nunca tuvo oportunidad de aparecer. Pon a Luna sobre una base de conocimiento más desordenada o una tarea de agente de varios pasos y aparecerá.
Ventajas: unas 16 veces más barato que 6.1 Sol por ticket en mi prueba; respuestas más rápidas; conserva el esfuerzo none y las llamadas a herramientas de Chat Completions; misma ventana de contexto.
Inconvenientes: puntuación mucho más baja en razonamiento difícil; con esfuerzo none se saltó el cálculo prorrateado; pesos cerrados, un solo proveedor.
Precios: $0.10 de entrada, $0.01 en caché, $0.50 de salida por 1M de tokens; Batch y Flex con 50 % de descuento. Desglose completo en precios de GPT-6 Luna.
Mi opinión: para una cola de soporte, empieza con Luna en esfuerzo medio y manda lo que escale a 6.1 Sol. Así la mayor parte de tu volumen queda en un modelo que cuesta casi nada, y solo pagas tarifas de Sol por los tickets que realmente las necesitan.
2. GPT-6 Sol: el que todavía hace none
Ideal para: equipos cuyo código de producción depende del esfuerzo none o del function calling en Chat Completions, y que necesitan un modelo equivalente mientras migran.
Para algunos equipos, la mejor alternativa a 6.1 Sol es simplemente el modelo al que reemplazó. GPT-6 Sol ya no está en la tabla de precios principal, pero su página de modelo sigue activa, sigue en $2/$10 y sigue diciendo "reasoning.effort supports none." También dice "Chat Completions supports function calling only with reasoning_effort set to none", y esa es exactamente la combinación que 6.1 Sol eliminó. Cuando miré la página de deprecaciones de OpenAI el 1 de octubre, no figuraba fecha de cierre para GPT-6 Sol.
En mi prueba con esfuerzo none sacó 14/15 a $1.72 por cada 1,000 tickets y 3.6s por ticket, algo más rápido que 6.1 Sol. El único fallo fue el cálculo prorrateado: dijo "the policy doesn't specify how to count unused full months" y escaló. Es un fallo seguro en lugar de una respuesta errónea. Aun así, es un ticket más que una persona tiene que tocar.
En calidad, gana 6.1 Sol. Artificial Analysis da a GPT-6 Sol 39.8 por $0.25 la tarea en medium, frente a 47.8 por $0.21 de 6.1 Sol. La entrada en caché también cuesta el doble, $0.20. Si quieres profundizar, la reseña de GPT-6 Sol de mi compañero lo cubre.
Ventajas: conserva el esfuerzo none; el único modelo GPT-6 de $2/$10 con llamadas a herramientas en Chat Completions; no requiere cambios de código.
Inconvenientes: puntuaciones más bajas que 6.1 Sol en todos los niveles de esfuerzo; la entrada en caché cuesta el doble; ya reemplazado en la tabla de precios, así que tómalo como puente.
Precios: $2 de entrada, $0.20 en caché, $10 de salida por 1M de tokens; los prompts de más de 272K tokens de entrada facturan toda la petición a 2x de entrada y 1.5x de salida. Más en precios de GPT-6 Sol.
Mi opinión: quédate en GPT-6 Sol solo el tiempo que te lleve mover tus llamadas a herramientas a la Responses API. Para none a largo plazo, Luna es la apuesta más segura. Es el modelo barato actual, no el que fue reemplazado.
3. Claude Opus 5.5: un salto real de techo
Ideal para: programación difícil y tareas largas de agente donde las respuestas de 6.1 Sol son buenas pero no del todo suficientes.
¿Dejas 6.1 Sol porque quieres un modelo más inteligente? Entonces miraría Claude Opus 5.5. Puntúa 57.6 con esfuerzo máximo en Artificial Analysis, unos 6 puntos por encima del mejor resultado de 6.1 Sol, y logra 66.4 % en Terminal-Bench 4.0 según la publicación de lanzamiento de Anthropic. También es el primer Opus que resultó más barato que el anterior, a $4/$20 por millón.
El problema, como siempre, es el coste por tarea. Con esfuerzo máximo sale a $5.98 la tarea, ocho veces los $0.72 de 6.1 Sol en max. El esfuerzo medio es mejor trato: 51.2 por $1.34, que es la puntuación máxima de 6.1 Sol por aproximadamente el doble de dinero. La comparación GPT-6 Sol vs Opus 5.5 explica esa aritmética del esfuerzo en detalle.
La mayoría de los informes prácticos que encontré en HN se inclinan por Opus cuando el código se complica:
"I've implemented multiple features side by side with Opus 5.5 and 6 Sol, and the Opus 5.5 results always have fewer high severity bugs and require fewer rounds of fixes to get it over the finish line."
Ese comentario compara Opus con GPT-6 Sol, no con 6.1, y el mismo hilo dice que 6.1 cierra parte de la brecha. Aun así, coincide con lo que oigo de los ingenieros de aquí.
Ventajas: la puntuación más alta de esta lista; fuerte en benchmarks de terminal y programación; $0.20 por lecturas de caché; 1M de contexto sin recargo de contexto largo.
Inconvenientes: el más caro por tarea en max; excesivo para chat simple o extracción; un proveedor más que gestionar.
Precios: $4 de entrada, $0.20 de lectura de caché, $20 de salida por 1M de tokens; Batch con 50 % de descuento, según la documentación de precios de Anthropic. Consulta precios de Claude Opus 5.5.
Mi opinión: elige Opus 5.5 en esfuerzo medio cuando 6.1 Sol falle una y otra vez en tus tareas más difíciles. Solo no lo dejes en max por defecto. Acabarás pagando tokens que nunca necesitaste.
4. Claude Sonnet 5.5: mismo precio de lista, otro proveedor
Ideal para: equipos que quieren un modelo de $2/$10 de un segundo laboratorio, sobre todo para programación y trabajo de agente.
Claude Sonnet 5.5 se lanzó el 28 de septiembre de 2026, un día antes que 6.1 Sol, con los mismos $2 de entrada y $10 de salida. Según las propias cifras de Anthropic, incluso supera a Opus 5.5 en Terminal-Bench 4.0 (70.6 % frente a 66.4 %). En Artificial Analysis alcanza 56.0 con esfuerzo máximo, muy por encima de los 51.8 de 6.1 Sol.
El coste por tarea es donde conviene prestar atención. Con esfuerzo máximo, Sonnet 5.5 cuesta $7.60 la tarea, más que Opus 5.5. Con esfuerzo alto puntúa 46.7 por $1.08, que es más o menos la puntuación de 6.1 Sol en medium por cinco veces el coste. La propia Anthropic dice que el ahorro está en el esfuerzo bajo. La reseña de Sonnet 5.5 de mi compañero llegó a la misma conclusión.
Los bots de soporte tienen una trampa adicional. Sonnet 5.5 devuelve un 400 con tool_choice forzado (any o una herramienta con nombre), así que un bot que fuerza una consulta de pedido en cada ticket necesita reescribirse. Es el mismo tipo de cambio incompatible que está alejando a la gente de 6.1 Sol, solo que en otro lugar.
En el hilo de 6.1 Sol, algunos desarrolladores creen que Anthropic va por delante en esta ronda:
"I suspect they didn't show the benchmarks and test results because it would have been embarrassing to reveal that their flagship model can't compete with the capabilities of Sonnet 5.5."
Ventajas: mismo precio de $2/$10 de un segundo proveedor; puntuación máxima más alta que 6.1 Sol; muy fuerte en programación de terminal; 1M de contexto.
Inconvenientes: mucho más caro por tarea con puntuaciones iguales; la elección forzada de herramienta ahora devuelve un error; el esfuerzo máximo puede quemar cantidades enormes de tokens.
Precios: $2 de entrada, $0.20 de lectura de caché, $10 de salida por 1M de tokens; Batch $1/$5. Consulta precios de Claude Sonnet 5.5.
Mi opinión: Sonnet 5.5 es la jugada correcta si quieres un segundo proveedor para programación y mantendrás el esfuerzo en low o medium. Si lo tuyo son respuestas de soporte a volumen, 6.1 Sol o Luna costarán menos por ticket.
5. GPT-6 Astra: solo si necesitas Ultrafast ya
Ideal para: equipos que ya están en OpenAI y necesitan hoy el modo de generación más rápido, o el último punto de puntuación.
GPT-6 Astra es el modelo insignia de OpenAI. El problema es que 6.1 Sol ha hecho difícil justificarlo. Artificial Analysis da a Astra 52.7 por $3.26 la tarea, frente a 51.8 por $0.72 de 6.1 Sol. En mi prueba de soporte, Astra igualó el 15/15 de 6.1 Sol al quíntuple del coste, $9.09 por cada 1,000 tickets frente a $1.80. También fue más lento, con 5.2s por ticket.
Este mes en realidad solo hay una razón para elegirlo, y es Ultrafast. La página de precios de OpenAI lista tarifas de Ultrafast solo para Astra, $60 de entrada y $300 de salida por millón, con 6.1 Sol "coming soon". ¿Necesitas ese nivel de velocidad ahora mismo? Astra es el único modelo GPT-6 que lo tiene.
Ventajas: la puntuación más alta de OpenAI; Ultrafast disponible ahora; la menor tasa de alucinaciones de la familia GPT-6 en AA.
Inconvenientes: unas 4.5 veces el coste por tarea de 6.1 Sol por 1 punto más; más lento en mi prueba; Ultrafast es muy caro.
Precios: $10 de entrada, $1 en caché, $50 de salida por 1M de tokens; Batch y Flex con 50 % de descuento. Consulta precios de GPT-6 Astra.
Mi opinión: para la mayoría de los equipos, 6.1 Sol reemplazó a Astra y no al revés. Guardaría Astra para el trabajo poco frecuente en que un punto extra importa, o donde esperar a que Ultrafast llegue a Sol no es una opción.
6. Gemini 3.8 Flash: la opción de Google con nivel gratuito
Ideal para: equipos en el stack de Google Cloud, prototipos en el nivel gratuito y trabajos por lotes donde importa el precio por token.
Gemini 3.8 Flash pasó mi prueba 15/15 con esfuerzo bajo por $1.04 por cada 1,000 tickets, y acertó los $990 prorrateados mostrando el desarrollo. Las respuestas tardaron 3.0s de media. También usó más formato que cualquier otro que probé. Una respuesta de estado de pedido que necesitaba dos líneas volvió con listas con viñetas y etiquetas en negrita.
En precio, lee la letra pequeña. La página de precios de Gemini lista $0.75 de entrada y $3.75 de salida "through December 31, 2026", y luego $1.50 y $7.50 desde el 1 de enero de 2027. Los compradores recuerdan ese tipo de duplicación. Un comprador atento al presupuesto en una llamada de ventas de eesel dijo que el precio de un proveedor anterior había "more than doubled" y pidió una garantía de precio por contrato antes que cualquier otra cosa.
En Artificial Analysis, Gemini 3.8 Flash con esfuerzo alto puntúa 40.9 por $1.24 la tarea, por debajo de 6.1 Sol y con seis veces su coste por tarea. Además no es un modelo base nuevo. La ficha del modelo de Google dice que está basado en Gemini 3.7 Flash.
Ventajas: nivel gratuito; pasó mi prueba con las cuentas correctas; buen rendimiento; Batch y Flex con 50 % de descuento.
Inconvenientes: el precio se duplica el 1 de enero de 2027; más caro por tarea que 6.1 Sol en AA; respuestas verbosas.
Precios: $0.75 de entrada, $0.075 de lectura de caché, $3.75 de salida por 1M de tokens hasta el 31 de diciembre de 2026, luego $1.50/$0.15/$7.50. Consulta precios de Gemini 3.8 Flash.
Mi opinión: si ya trabajas en Google Cloud, es un segundo proveedor razonable. Calcula con la tarifa de 2027, no con la actual, para que la factura no te sorprenda en enero.
7. Grok 4.7: tarifa de salida más barata, no tareas más baratas
Ideal para: bucles de agente que se mantienen bajo 200K tokens por petición y equipos que ya construyen sobre xAI.
Grok 4.7 tiene un precio que, a primera vista, parece un asesino de Sol: $2 de entrada y $6 de salida por millón, un 40 % por debajo de la tarifa de salida de Sol, según la página de modelos de xAI. Está construido sobre un modelo base mayor que Grok 4.6 con un entrenamiento más largo orientado a tareas de agente de varias horas, y su corte de conocimiento es mayo de 2026.
El gráfico de coste por tarea dice otra cosa. Artificial Analysis da a Grok 4.7 con esfuerzo xhigh una puntuación de 46.4 por $3.74 la tarea, algo menos que 6.1 Sol en medium por unas 18 veces el coste. La razón es simple: escribe muchos tokens. Vigila también los precios de contexto largo: por encima de 200K tokens de prompt la tarifa salta a $4/$12 por cada token de la petición, no solo por el excedente.
Ventajas: tarifa de salida menor que Sol; grandes mejoras de agente sobre Grok 4.6; 500K de contexto; una herramienta gratuita Grok Build para programar.
Inconvenientes: coste por tarea mucho mayor que 6.1 Sol en AA; precipicio de contexto largo a 200K; Grok 4.7 Fast solo está en Cursor y Grok Build, no en la API pública.
Precios: $2 de entrada, $0.50 en caché, $6 de salida por 1M de tokens por debajo de 200K; $4/$1/$12 por encima. Consulta la reseña de Grok 4.7 para notas prácticas.
Mi opinión: Grok 4.7 tiene sentido si ya vives en las herramientas de xAI. Pero si la menor tarifa de salida es tu única razón, haz primero tu propia prueba de coste por tarea. En el índice, queda en el sentido contrario.
8. DeepSeek V4.1 Flash: pesos abiertos y una factura minúscula
Ideal para: equipos que necesitan pesos con licencia MIT para alojar por su cuenta, o el precio de API más bajo para trabajo en segundo plano.
DeepSeek V4.1 Flash es el modelo capaz más barato de esta lista y el más fácil de poseer por completo. Los pesos están en Hugging Face bajo MIT. La API usa el nombre de modelo deepseek-flash, y el nombre anterior deepseek-v4-flash ahora redirige a V4.1. Admite visión, llamadas a herramientas, una ventana de contexto de 1M y hasta 384K tokens de salida, según la página de precios de DeepSeek.
Hay una peculiaridad de zona horaria en el precio. Fuera de horas punta son $0.15 de entrada y $0.60 de salida por millón; en horas punta, exactamente el doble. Las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables, así que una cola de soporte de EE. UU. factura sobre todo a tarifa valle, y una cola en horario asiático sobre todo no.
Por tarea, está más cerca de 6.1 Sol de lo que sugiere el precio de lista. Artificial Analysis da a V4.1 Flash con esfuerzo máximo 39.5 por $0.27 la tarea, frente a 47.8 por $0.21 de 6.1 Sol en medium. Si hay datos de clientes de por medio, comprueba también dónde se ejecuta: la API propia de DeepSeek está alojada en China y sus términos de API no dicen nada sobre el uso para entrenamiento, por lo que muchos equipos lo alojan ellos mismos o usan un host de terceros con un acuerdo de datos.
Ventajas: pesos abiertos MIT; el precio de API por token más bajo de aquí; ahora admite imágenes; 1M de contexto.
Inconvenientes: puntuación menor que 6.1 Sol y coste por tarea algo mayor; precios de horas punta; el alojamiento propio del proveedor es difícil de vender para datos de clientes.
Precios: $0.003 acierto de caché, $0.15 de entrada, $0.60 de salida por 1M de tokens fuera de horas punta; el doble en horas punta. Consulta precios de DeepSeek V4.1 Flash.
Mi opinión: elige V4.1 Flash para alojarlo tú mismo o para trabajo por lotes nocturno. Como reemplazo directo de 6.1 Sol en un bot interactivo, en cambio, no te ahorrará dinero por tarea.
9. Kimi K3: pesos abiertos de frontera
Ideal para: equipos que necesitan el modelo de pesos abiertos más potente que puedan descargar y ejecutar.
Kimi K3, de Moonshot AI, es un modelo de mezcla de expertos de 2.8 billones de parámetros con 104B activos, una ventana de contexto de 1M y visión nativa. Los pesos completos están en Hugging Face bajo una licencia propia, así que puedes ejecutarlo tú mismo, suponiendo que tengas el hardware.
En la API alojada cuesta $3 de entrada, $0.30 en caché y $15 de salida por millón, según la página de precios de Kimi. Eso es más que Sol tanto en entrada como en salida. Artificial Analysis le da 43.6 con esfuerzo máximo por $2.00 la tarea. El razonamiento no se puede desactivar en ningún nivel, lo que hace que su ajuste más bajo sea más un control de velocidad que un nivel más barato.
Ventajas: los pesos descargables abiertamente más fuertes de esta lista; 1M de contexto; entrada de imagen y vídeo.
Inconvenientes: la API alojada cuesta más que 6.1 Sol por token y por tarea; licencia propia, no MIT ni Apache; el razonamiento siempre está activado.
Precios: $3 de entrada, $0.30 acierto de caché, $15 de salida por 1M de tokens. Consulta precios de Kimi K3.
Mi opinión: Kimi K3 es una elección para alojarlo tú mismo. Si solo quieres una API alojada, 6.1 Sol es más barato y puntúa más alto.
Qué dice mi prueba sobre cambiar de modelo en soporte
Esta es la parte a la que sigo volviendo. A lo largo de 135 ejecuciones y nueve configuraciones, de $0.09 a $9.09 por cada 1,000 tickets, los fallos fueron del mismo tipo todas las veces. Todas las configuraciones, Astra incluida, escalaron el ID de pedido con error tipográfico ("A1O43") en lugar de pedir al cliente que lo revisara. Las ejecuciones con none se rindieron con cálculos que podrían haber hecho. Subir de nivel no arregló nada de eso. Lo que lo arregla (o lo habría arreglado) es una línea en las instrucciones, más pruebas con tickets reales.
Eso coincide con lo que oigo de los compradores. Un responsable de CX con unos 7,000 tickets al mes le dijo al equipo de eesel en una llamada de ventas que la IA solo debería responder los tickets de los que esté segura y dejar discretamente el resto para las personas. Eso es una regla de derivación, no una función del modelo. Esa regla la defines en la capa que rodea al modelo, y luego la compruebas contra tu propio historial antes de que ningún cliente la vea.
Así que si cambias 6.1 Sol por Luna para ahorrar dinero en una cola de soporte, creo que es una decisión inteligente. Pruébalo primero con tus tickets pasados, eso sí, y mantén un camino claro hacia una persona para todo aquello de lo que no esté segura. La guía de escalado con IA explica cómo configurarlo.
Prueba eesel

Si comparas alternativas a GPT-6.1 Sol porque quieres automatizar el soporte, el modelo es el motor, y eesel es el compañero que contratas para conducirlo. El agente de helpdesk con IA se une a tu cola existente en Zendesk, Freshdesk o Gorgias, aprende de tu centro de ayuda y de tickets pasados, y ejecuta una simulación sobre tu historial de tickets para que veas sus respuestas y su tasa de resolución antes de que responda a nadie. ¿Ese fallo del ID con error tipográfico de mi prueba? Es exactamente el tipo de hueco que detecta la simulación.
Si trabajas desde una terminal, la CLI de eesel maneja el mismo compañero y el mismo espacio de trabajo que el panel. Puedes automatizar una prueba con un lote de tickets antiguos, llevar los resultados a tus propias herramientas o dejar que un agente de programación como Claude Code, Codex o Cursor gestione la configuración por ti. Es el mismo compañero en ambos casos, solo que sin interfaz. Puedes probar eesel gratis y ejecutarlo con tus propios tickets antes de elegir un modelo o un plan.
Preguntas frecuentes
¿Cuál es la mejor alternativa a GPT-6.1 Sol en 2026?
¿Hay una alternativa más barata a GPT-6.1 Sol?
¿Por qué GPT-6.1 Sol eliminó el esfuerzo de razonamiento none?
none devuelve un error. GPT-6 Sol y GPT-6 Luna siguen admitiendo none, y son los únicos modelos GPT-6 que permiten function calling en Chat Completions. Mi reseña de GPT-6.1 Sol cubre los cambios de la API.¿Es GPT-6.1 Sol mejor que Claude Sonnet 5.5?
¿Cuál es una buena alternativa de pesos abiertos a GPT-6.1 Sol?
¿Debería cambiar de GPT-6.1 Sol a GPT-6 Astra?
¿Funcionan las alternativas a GPT-6.1 Sol para atención al cliente?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.