

Vale la pena probar la Gemini Decisions API si tu código hace la misma llamada de conjunto cerrado miles de veces al día: enrutar este ticket, ¿esta foto muestra un daño?, ¿esta respuesta rompe una política? Gemini Decision 1 responde hasta 1.000 preguntas de sí/no, elección y rúbrica en una sola pasada y devuelve probabilidades, no texto, a 0,10 $ por millón de tokens de entrada con cero tokens de salida facturados. Su ventaja sobre los demás modelos de decisión es el input: lee audio, video y PDF de forma nativa. Sus carencias son la falta de caching, de batch y de Vertex AI por ahora. Clasifica tickets pero no puede responderlos, que es justo la tarea que hace el compañero de IA de helpdesk de eesel dentro de tu helpdesk. Con el eesel CLI, un agente de código puede subir tus reglas de triage y artículos de ayuda, y luego correr tickets de prueba antes de que nada salga a producción.
¿Qué es la Gemini Decisions API?
La Gemini Decisions API es un nuevo endpoint de la API de Gemini para decisiones rápidas de conjunto cerrado. Google la lanzó el 11 de noviembre de 2026, junto con un nuevo modelo llamado Gemini Decision 1 (gemini-decision-1). Envías un input compartido y una lista de preguntas tipadas, y te devuelve una respuesta por pregunta con una probabilidad calibrada y un confidence score.
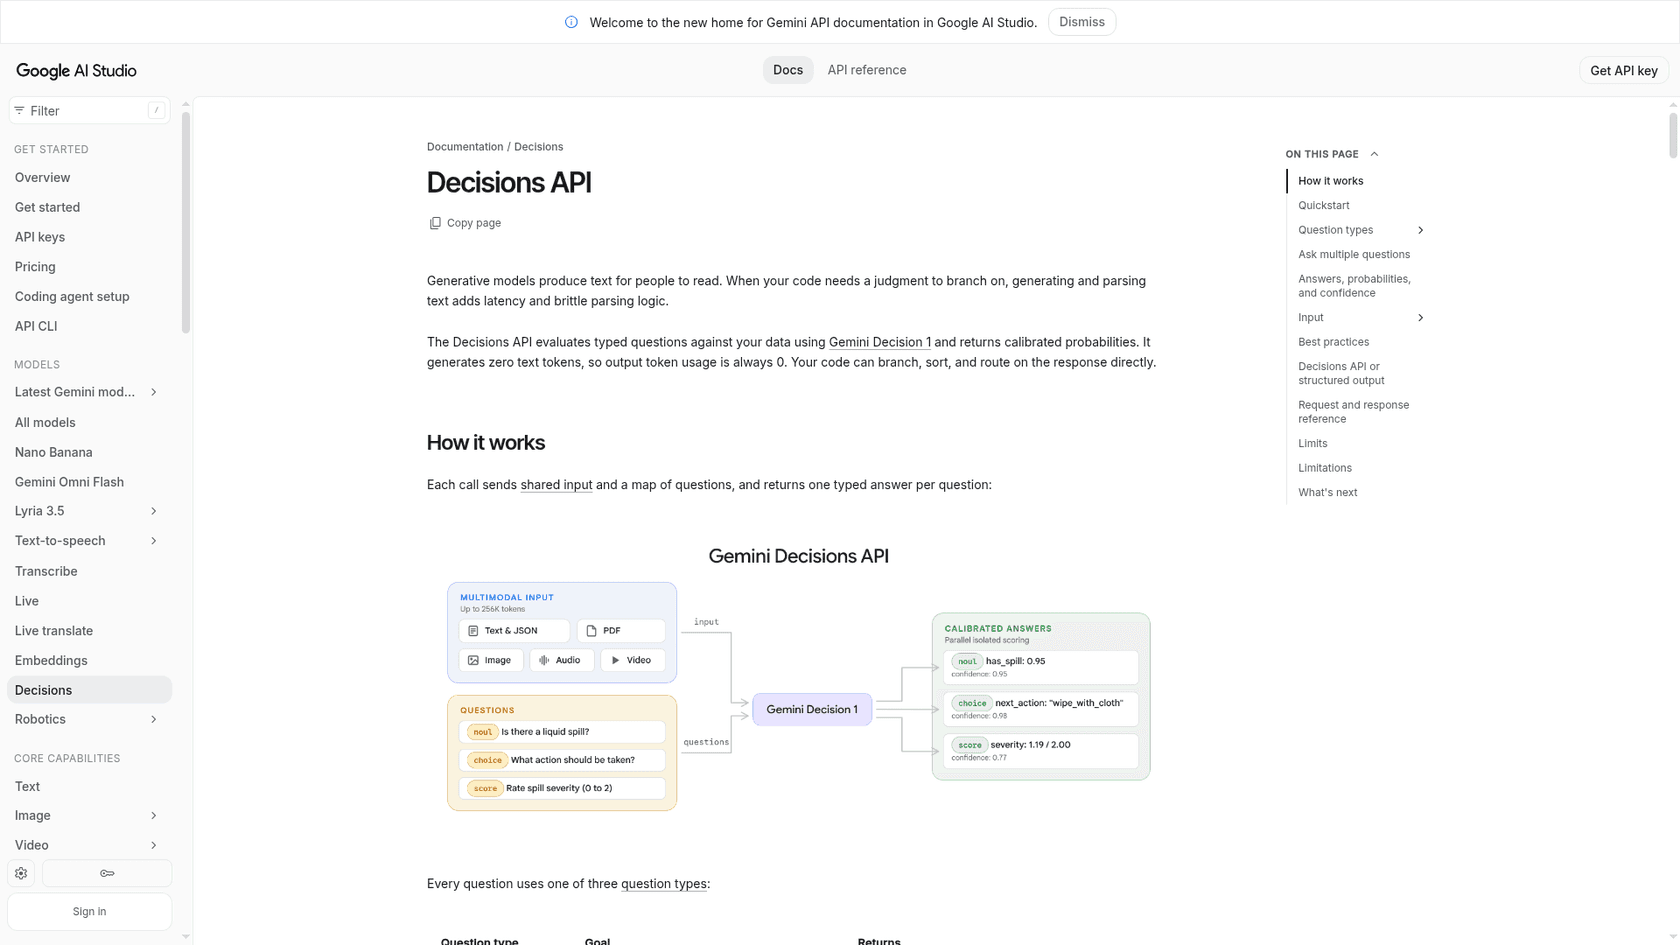
La frase clave en los docs de la Decisions API es que "generates zero text tokens, so output token usage is always 0." Tu código se ramifica sobre un número en lugar de parsear una frase.
Yo construyo integraciones y APIs en eesel, y la parte de ese trabajo que con gusto no volvería a escribir es el código pegamento alrededor de un LLM que se supone debe devolver una sola palabra. Pides "billing" o "shipping", te devuelve "Billing." con punto final, o un párrafo educado, y escribes un parser más un retry. Un endpoint de decisión elimina toda esa capa. Esa es la propuesta real aquí, más que la velocidad.
Esto es lo que Google confirmó en el lanzamiento:
| Especificación | Gemini Decision 1 |
|---|---|
| ID del modelo | gemini-decision-1 |
| Entradas | Texto, imágenes, audio, video y PDF, mezclados en una sola llamada |
| Salida | Probabilidades y confidence scores, 0 tokens de salida |
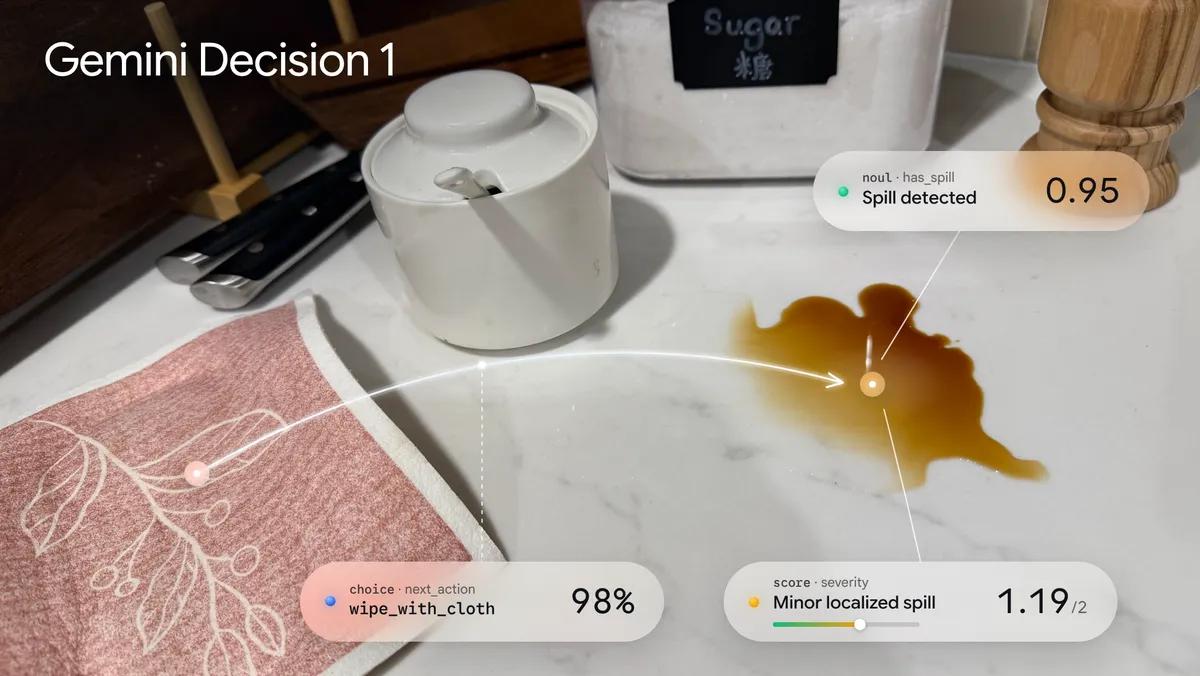
| Tipos de pregunta | Sí/no (noul), elección, puntuación |
| Preguntas por llamada | 1 a 1.000 |
| Ventana de contexto | 262.144 tokens, input compartido más todas las preguntas |
| Latencia (cifra de Google) | 150 a 250 ms de extremo a extremo |
| Precio | 0,10 $ por 1M de tokens de entrada, nivel gratis en AI Studio |
| Dónde corre | Gemini Developer API (v1beta), OpenRouter. Google Cloud "próximamente" |
| No soportado | Generación de texto, thinking, function calling, caching, Batch API, Flex y Priority |
Google llega tarde a esta categoría, y lo admite abiertamente. TypeSafe Jev la empezó en septiembre, y la OpenAI Decisions API pasó a beta pública a principios de octubre. Un comentarista de Hacker News resumió el momento sin rodeos:
"It took OpenAI 2 weeks after Jev to release a decision end point, and now google does it 2 months later."

¿Cómo funciona Gemini Decision 1?
Gemini Decision 1 lee tu input una sola vez y puntúa cada respuesta permitida en un único forward pass, en lugar de generar una respuesta token por token. Por eso la salida es gratis y la latencia se mantiene plana al añadir preguntas. Google dice que el cómputo mediano del modelo es de 50 a 100 ms, casi plano de 1 a 100 preguntas por llamada, para inputs de hasta 16.000 tokens.
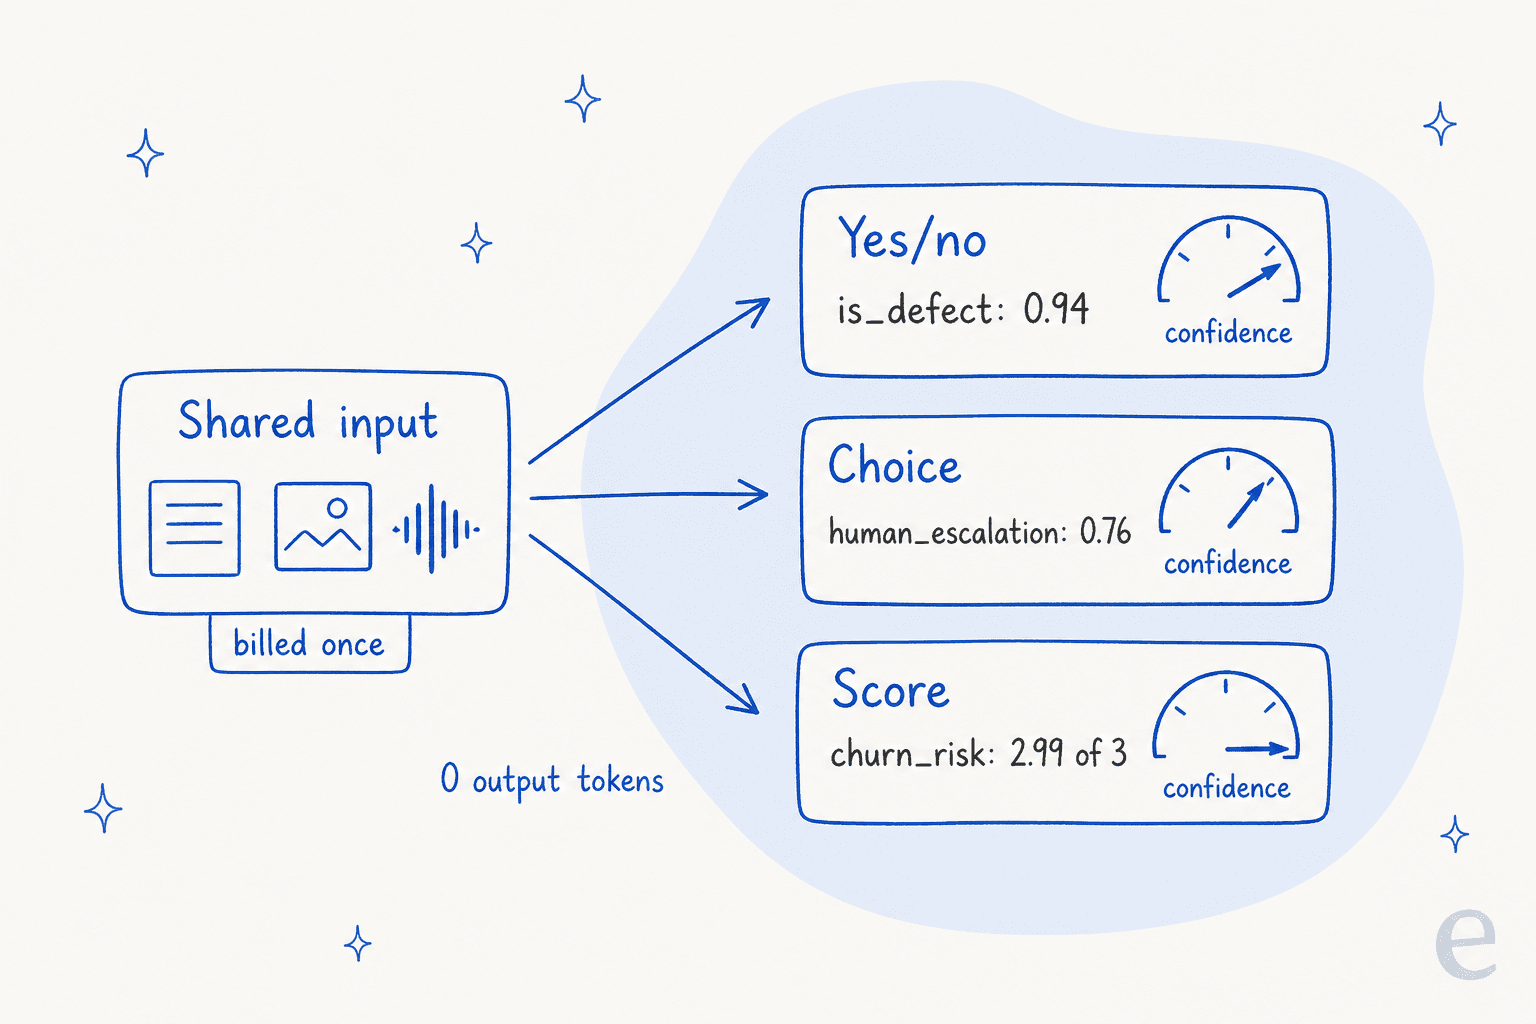
Los números de ese diagrama salen directo del propio ejemplo de ticket de soporte de Google en los docs, que merece la pena revisar paso a paso.
Los tres tipos de pregunta
Cada pregunta es de uno de tres tipos, y puedes mezclarlos en una sola llamada:
- Sí/no (
noul) devuelve la probabilidad de que una afirmación sea cierta, de 0,01 a 0,99. Puedes añadir unatrue_descriptiony unafalse_descriptioncuando "sí" sea ambiguo. El nombre raro sigue la API de Jev (comentaristas de HN creen que viene de "Bernoulli"), mientras que OpenAI llama a lo mismo unpredicate. - Elección elige una opción entre 2 y 255 y devuelve la ganadora más una probabilidad para cada opción, que suman 1.
- Puntuación valora el input según una rúbrica ordenada de 2 a 255 niveles (Google recomienda de 2 a 10) y devuelve un promedio ponderado por probabilidad. Una puntuación de 1,12 significa "sobre todo nivel 1, un poco de nivel 2".
Un ejemplo de soporte de los docs de Google
El propio ejemplo multi-pregunta de Google es un ticket de soporte. El input son datos del pedido (auriculares, 240 $, nivel Gold) más el mensaje "Audio cuts out on the left earcup. Fix it today or I cancel my membership." Corren tres preguntas sobre eso:
| Pregunta | Tipo | Respuesta | Confianza |
|---|---|---|---|
| ¿Es un defecto de hardware? | Sí/no | 0,94 | 0,94 |
| ¿Qué resolución corresponde? | Elección | human_escalation (0,76), replacement 0,18 | 0,76 |
| ¿Qué tan probable es el abandono? | Puntuación, 0 a 3 | 2,99 ("amenaza con cancelar") | 0,99 |
Todo esto usó 324 tokens de entrada y 0 tokens de salida. Luego el código hace la composición: si la probabilidad de defecto supera 0,9 y la confianza de la elección supera 0,6, se toma la acción, de lo contrario se envía a una persona. Google llama a esto "atomic checks, composed in code", y es la forma correcta de usar estos modelos. Cada pregunta no puede ver a las demás, así que añadir una nunca cambia el resto.
Así también funciona un buen enrutamiento de tickets en un helpdesk. No quieres un solo prompt gigante decidiéndolo todo. Quieres comprobaciones pequeñas y comprobables (intención, urgencia, sentimiento) y una regla clara para cuándo interviene una persona. Cubrí el lado del helpdesk en mis guías sobre clasificación de tickets con IA y tickets con detección de intención.
Trampas que señalan los docs
Los docs tienen algunas reglas que te van a morder si los lees por encima:
- Las claves de las opciones se ordenan alfabéticamente antes de puntuar. Un catch-all llamado
none_of_the_abovecae antes deshipping, así que llámaloother. - La elección siempre distribuye probabilidad entre tus opciones, incluso cuando ninguna encaja. Revisa la confianza, o añade una comprobación de alcance sí/no aparte, como "¿Este mensaje trata de un pedido?"
- El modelo nunca ve las claves de tus preguntas. Pon la pregunta completa en
instructions. - Haz las cuentas en el código. Compara fechas, montos y duraciones tú mismo, y luego pasa el resultado.
- Trata el input como no confiable. Google advierte que el texto del usuario "can argue for its own classification", así que mantén a una persona o una segunda comprobación en pagos y reembolsos. Es la misma lógica detrás de los guardrails de IA en cualquier configuración de soporte.
¿Qué la diferencia de Jev y OpenAI?
Los tipos de input. Gemini Decision 1 lee texto, imágenes, audio, video y PDF en una sola llamada, con una ventana de 262K. La mayoría de los rivales son solo texto, o texto más imágenes, con 24K a 65K tokens.
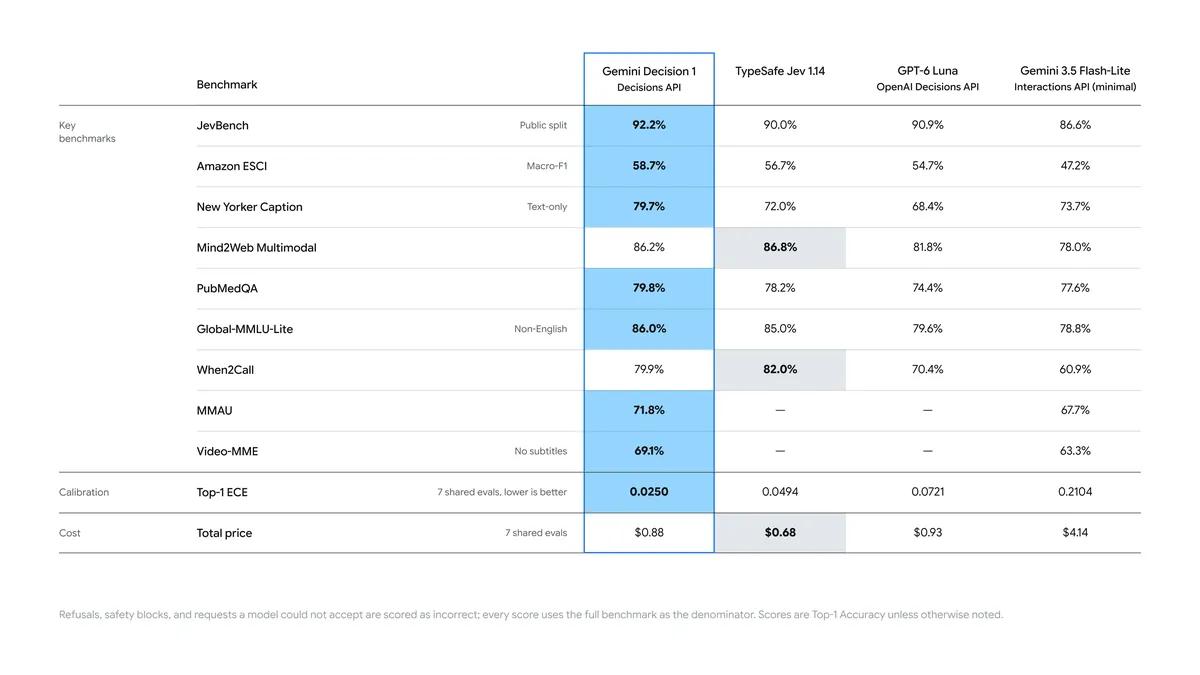
El post de lanzamiento de Google dice que Decision 1 "leads across the suite, with the lowest calibration error." Trata eso como Google calificando su propia tarea hasta que un comité externo lo pruebe. Así se ve la categoría en la página de cada proveedor:
| Modelo | Precio de entrada por 1M | Salida | Contexto | Lee |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 $ | Gratis | 262.144 | Texto, imágenes, audio, video, PDF |
| OpenAI Decisions API (GPT-6 Luna) | 0,10 $ | Gratis | Ventana de Luna, 2x input tras 272K | Texto, imágenes incrustadas |
| TypeSafe Jev | 0,042 $ | Gratis | 32.000 | Texto |
| Microsoft-Decision-1 | 0,042 $ | Gratis | 32.768 | No indicado |
| Cloudflare Clef | 0,24 $ | Sin precio de salida | 65.536 | Texto, JSON, imágenes, video |
| Cloudflare Clef-flash | 0,038 $ | Sin precio de salida | 24.576 | Texto, JSON, imágenes, video |
| Strands Decider 2B | Gratis (self-host) | Gratis | Ventanas de ejecución de 3K a 4K | Texto |
Cifras de Gemini comprobadas el 12 de noviembre de 2026. Cifras de los rivales según la página de cada proveedor, comprobadas por última vez el 11 de octubre de 2026.
Tres cosas destacan:
- Gemini igual el precio de OpenAI exactamente y cuesta unas 2,4 veces lo de Jev por token. Estás pagando por el input multimodal y la ventana grande.
- Audio y PDF son nuevos en esta categoría. Los propios ejemplos de Google combinan "a call recording with account metadata or a scanned PDF claim with damage photos." Sin cargo aparte por transcripción u OCR.
- El hosting es más limitado de lo que parece. Sin pesos abiertos, sin self-hosting, y sin Vertex AI por ahora. Jev está en Cloudflare, el modelo de Microsoft en Azure, y Strands corre en cualquier lugar.
El hilo de lanzamiento en Hacker News llegó a la misma conclusión sobre precio frente a input:
"Its bit more expensive than other other Decision Models in the same lane. However, it can accept Audio and Video as input as well and for those specific cases it can be extremely useful."
Si tus inputs son tickets de texto plano, Jev o Clef-flash te van a costar menos por decisión. Si tus inputs son mensajes de voz, grabaciones de llamadas, fotos de productos dañados o facturas en PDF, Gemini es el único modelo de decisión alojado que conozco que toma todos esos nativamente. Para una mirada más amplia a las opciones de solo texto, mira mi resumen de alternativas a Jev.
¿Cuánto cuesta la Gemini Decisions API?
Gemini Decision 1 cuesta 0,10 $ por millón de tokens de entrada en el nivel de pago, y la salida siempre es gratis porque no existe. El nivel gratuito es "Free of charge" para prototipar, y Google puede usar esos datos para mejorar sus productos (en el nivel de pago, no).
Dos detalles de facturación importan más que la tarifa:
- El input compartido se factura una vez por llamada, sin importar cuántas preguntas hagas. Cada pregunta solo añade sus propios tokens de instrucción y criterios. Así que diez preguntas sobre un ticket cuestan mucho menos que diez llamadas.
- Nada tiene descuento. No hay context caching, Batch API ni nivel Flex, así que el mismo contexto de sistema enviado en cada llamada se factura completo cada vez. Con una configuración de Gemini 3.5 Flash-Lite al menos tendrías input cacheado a 0,03 $.
Google afirma que Decision 1 es "nearly 5x cheaper" que Flash-Lite en su suite de referencia. Mi propio cálculo aproximado coincide. Toma 10.000 tickets al mes, 600 tokens cada uno, tres preguntas de unos 60 tokens cada una:
- Decision 1: 7,8M tokens de entrada x 0,10 $ = unos 0,78 $ al mes.
- Flash-Lite con structured output: 7,8M x 0,30 $ = 2,34 $, más unos 600K tokens de salida x 2,50 $ = 1,50 $, así que unos 3,84 $, antes de cualquier thinking token.
De cualquier forma, la factura del modelo para la triage es dinero de bolsillo frente al costo de que una persona lea cada ticket. Pon tus propios números aquí:
¿Qué puedes construir con ella?
Google menciona cuatro usos: enrutar una solicitud a un modelo, cola, agente o herramienta; comprobar inputs y outputs contra muchas reglas de política a la vez; decidir qué herramientas necesita un agente, o si debe compactar, escalar o detenerse; y filtrar o rankear candidatos contra una rúbrica. Sus propios equipos ya la usan en producción:
- Gemini Notebook enruta cada consulta al nivel de modelo y de thinking correcto, lo que Google dice que sirve consultas cotidianas con hasta un 40% menos de latencia.
- Google Search la usa como capa de seguridad para herramientas MCP, capturando contenido adversarial dentro de su presupuesto de latencia.
- CC de Google Labs elige una reacción de emoji entre más de 200 opciones en una fracción de segundo.
- Stitch la usa en un experimento rápido de canvas que construye wireframes jugables en segundos.
Para los equipos de soporte, los casos de uso son obvios, y los propios ejemplos de los docs de Google son sobre todo tickets de soporte. Aquí es donde la pondría a trabajar:
- Triage y enrutamiento. Departamento, prioridad e idioma en una sola llamada, antes de que una persona o un agente vea el ticket. Eso es auto-triage clásico.
- Comprobaciones de escalamiento. "¿El cliente amenaza con cancelar?" y "¿Es un tema legal o de seguridad?" como preguntas sí/no con un umbral fijo, que alimentan una regla de escalamiento.
- QA de respuestas. Pasar un borrador de respuesta por diez reglas de política (sin reembolsos prometidos, sin nombres de competidores, tono correcto) antes de enviarlo. Es el reemplazo barato de que un LLM evalúe cada borrador.
- Ingesta de voicemail y fotos. Puntuar una grabación de llamada por intención, o la foto de un cliente por daño visible, sin un paso de transcripción.
- Puntuación de sentimiento y abandono según una rúbrica, para que un "2,99 de 3" pueda subir un ticket en la cola.
Lo que no hace es escribir la respuesta. Cada uno de esos trabajos termina con "y luego algo le responde al cliente". Cuando alguien en el hilo de lanzamiento preguntó dónde son útiles estos modelos, una respuesta lo resumió como "Routing, classification, replacement for LLM-as-judge." Ese es el alcance honesto.
¿Qué significa esto para un equipo de soporte?
Para la mayoría de los equipos de soporte, la Gemini Decisions API es una pieza, no un producto. Si tienes ingenieros y quieres conectar la triage a tu propio stack, es una forma barata y rápida de hacerlo, y el confidence score te da un punto limpio para pasarle el caso a una persona. Si no los tienes, tendrías que construir tú mismo las reglas de enrutamiento, los umbrales, el arnés de pruebas y las escrituras al helpdesk, y nada de eso viene incluido.
Esa capa que lo rodea es justo lo que es el compañero de IA para helpdesk de eesel. Se une a tu cola existente en Zendesk, Freshdesk o HubSpot, toma las mismas decisiones de categorizar, enrutar y escalar, y luego hace la parte que un modelo de decisión no puede: redacta o envía la respuesta a partir de tus propios macros y tu centro de ayuda. Antes de tocar un ticket real, se simula contra tus conversaciones históricas, porque una etiqueta equivocada con confianza sigue siendo equivocada.
Dos clientes de eesel muestran cómo se ve eso:
- smava, un sitio alemán de comparación de préstamos en Zendesk, se acerca a un caso de libro de texto para un modelo de decisión. En un mes eesel manejó 27.000 tickets en dos marcas, categorizó 14.600 de ellos (idioma, elegibilidad de respuesta y categoría escritos en campos de Zendesk) y preparó 15.300 borradores de respuesta a partir de 820 macros y artículos sincronizados.
- MentorShow, una plataforma francesa de aprendizaje en línea sobre HubSpot, hace que cada ticket se analice con un borrador de respuesta adjunto. En un mes eso fueron 1.200 conversaciones y tickets leídos y 432 borradores escritos en francés, inglés o español.
En ambos casos las etiquetas solo son útiles porque algo actúa sobre ellas. Esa es la brecha entre una decision API y un compañero de equipo.
¿Deberías usar la Gemini Decisions API?
Úsala si ya escribes código alrededor de llamadas a LLM que devuelven una sola palabra, y sobre todo si tus inputs son audio, imágenes o PDF. El modelo de una sola pasada con muchas preguntas es una mejora real frente a parsear JSON de un modelo generativo, y 0,10 $ por millón de tokens con salida gratis es difícil de superar.
Elígela si necesitas decisiones multimodales, más de 32K de contexto, o decenas de comprobaciones sobre el mismo input, y te sirve la Developer API de Google. Elige otra cosa si tus inputs son texto plano (Jev y Clef-flash son más baratos por token), necesitas Vertex AI o self-hosting hoy, o dependes de input cacheado o en batch para mantener los costos bajos.
Y si lo que realmente quieres es que los tickets se clasifiquen y se respondan, sáltate el cableado. Para una mirada más amplia, mi resumen de IA para triage de tickets compara las herramientas que hacen ambas cosas.
Prueba eesel para una triage que termina en una respuesta
Un modelo de decisión puede decirte que un ticket es un defecto de facturación con 0,94 de confianza. eesel toma ese ticket en Zendesk, Freshdesk o HubSpot, lo etiqueta, lo enruta, y redacta la respuesta que tu equipo habría escrito, probada primero con tus propios tickets pasados. smava lo usa para clasificar y redactar 27.000 tickets alemanes de Zendesk al mes. Revisa los precios, o prueba eesel gratis.
Preguntas frecuentes
¿Qué es la Gemini Decisions API?
La Gemini Decisions API es un endpoint de Google, lanzado el 11 de noviembre de 2026, que responde preguntas de conjunto cerrado (sí/no, elegir una opción o puntuar según una rúbrica) sobre un input y devuelve probabilidades calibradas en lugar de texto generado. Funciona sobre el modelo Gemini Decision 1 y pertenece a la misma categoría de modelos de decisión que TypeSafe Jev.
¿Cuánto cuesta la Gemini Decisions API?
Gemini Decision 1 cuesta 0,10 $ por millón de tokens de entrada en el nivel de pago, con cero tokens de salida facturados, y el nivel gratuito no tiene costo para prototipar. El input compartido se factura una vez por llamada sin importar cuántas preguntas hagas. Como referencia, los precios de Gemini 3.5 Flash-Lite son 0,30 $ de entrada y 2,50 $ de salida por millón de tokens.
¿Qué modelo usa la Gemini Decisions API?
Usa gemini-decision-1, un modelo multimodal especializado que puntúa las opciones en una sola pasada de prefill. Tiene un límite de entrada de 262.144 tokens y un límite de salida de cero. No puede generar texto, llamar herramientas ni razonar, así que complementa modelos como Gemini 4 Carbon en lugar de reemplazarlos.
¿En qué se diferencia la Gemini Decisions API del structured output?
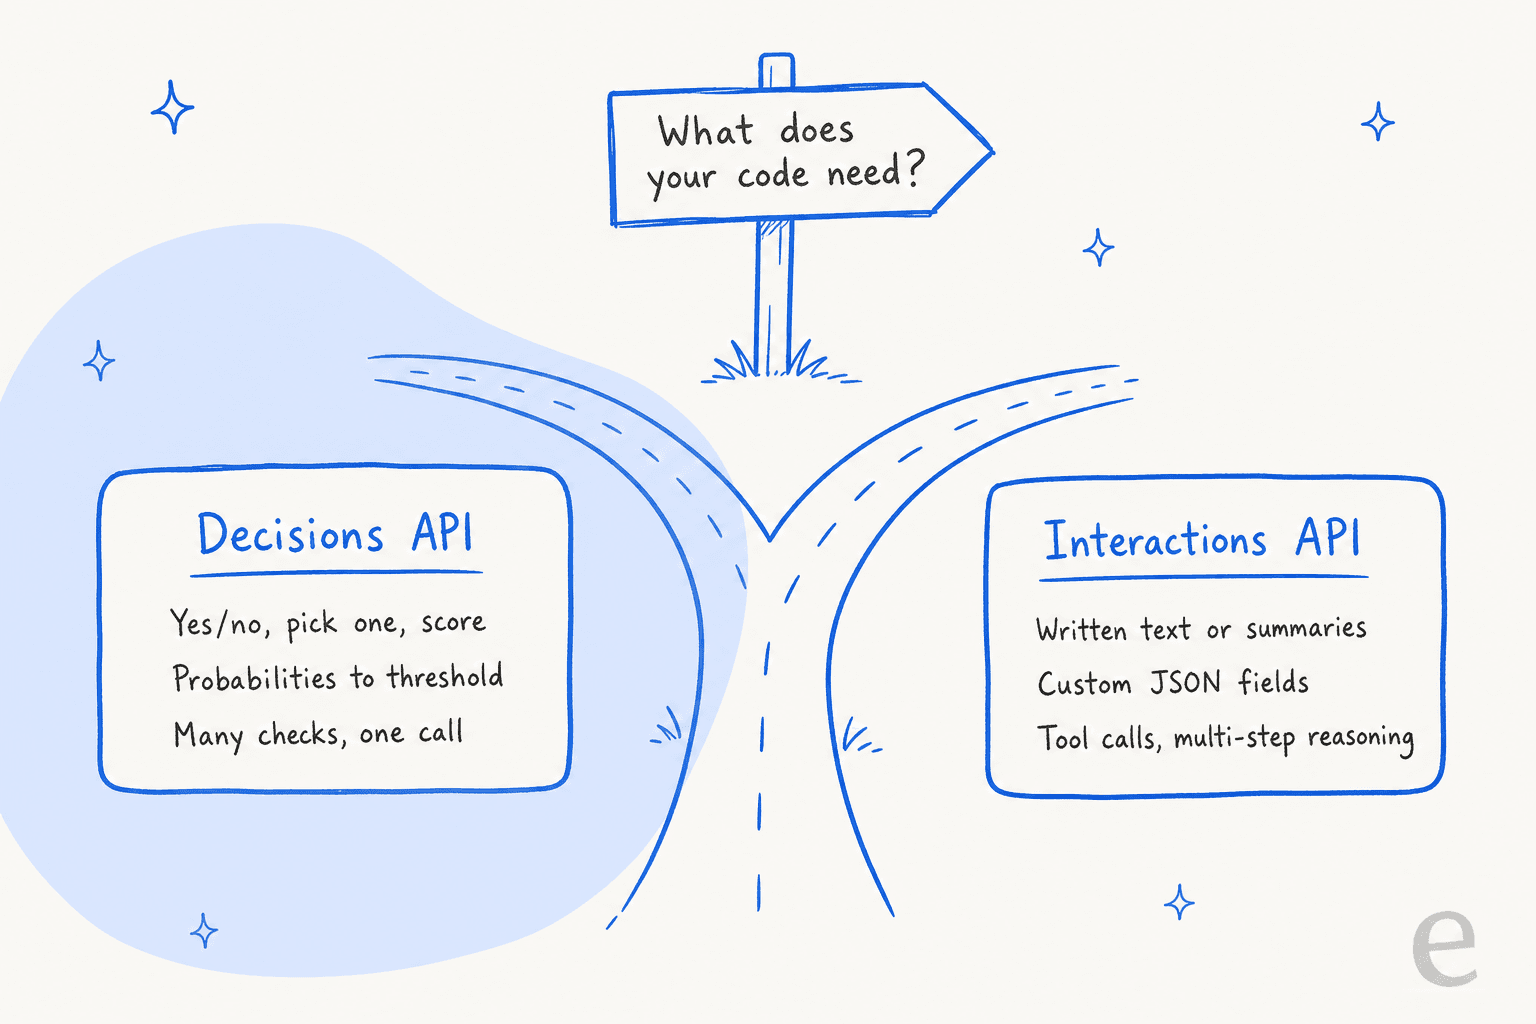
El structured output hace que un modelo generativo escriba JSON que se ajuste a tu esquema, y pagas por cada token de salida. La Gemini Decisions API nunca escribe texto: devuelve una probabilidad para cada respuesta permitida, que puedes filtrar con un umbral. Google dice que uses structured output cuando necesites valores extraídos u objetos personalizados, la misma disyuntiva que el modo JSON de OpenAI frente a un endpoint de decisión.
¿Es la Gemini Decisions API mejor que la OpenAI Decisions API?
Cuestan lo mismo, 0,10 $ por millón de tokens de entrada con salida gratis. Gemini lee audio, video y PDF además de texto e imágenes, mientras que la OpenAI Decisions API toma texto e imágenes incrustadas. El gráfico de referencia de Google pone a Decision 1 por delante, pero es la propia prueba de Google y todavía no se ha reproducido de forma independiente.
¿Puedo usar la Gemini Decisions API para la triage de tickets de soporte?
Sí. Los propios docs de Google usan ejemplos de soporte: enrutar un ticket a facturación o envíos, revisar si hay un defecto de producto y puntuar el riesgo de abandono en una sola llamada. Encaja muy bien para la triage de tickets, pero solo toma la decisión. Igual necesitas un sistema que escriba la respuesta, y ahí es donde entra un agente de helpdesk.
¿Está disponible la Gemini Decisions API en Vertex AI?
Todavía no. A 12 de noviembre de 2026 solo funciona en la Gemini Developer API (v1beta) a través de Google AI Studio, y Google dice que el soporte para Gemini en Google Cloud llegará pronto. También está en OpenRouter. Si la necesitas en Vertex hoy, mira las alternativas a Gemini o espera.
¿Cuáles son los límites de la Gemini Decisions API?
Una llamada admite de 1 a 1.000 preguntas, de 2 a 255 opciones por pregunta de elección y de 2 a 255 niveles por pregunta de puntuación, todo dentro de una ventana de 262.144 tokens. No hay context caching, Batch API ni niveles Flex o Priority, así que el input repetido se factura completo cada vez. Las instrucciones de las preguntas son solo texto, y los inputs que activan los filtros de seguridad devuelven un HTTP 400 en lugar de respuestas, así que planea una vía de escalamiento.