¿Qué es PostHog Jeeves?
Jeeves es un "reasoning Jev-style classifier with a diffusion drafter", publicado por PostHog el 29 de septiembre de 2026. Lo construyó Nicholas Waltz, ingeniero de investigación de IA en el equipo de AI Research de PostHog, que antes pasó dos años en una startup de YC creando modelos de RL para reparto con drones, según su perfil de PostHog.
Para entender Jeeves hay que saber qué copia. Un "modelo de decisión" no escribe texto. Le envías un estado (un correo, un ticket, un bloque JSON) y un conjunto de preguntas tipadas, y te devuelve una probabilidad para cada opción de respuesta. La categoría se popularizó dos semanas antes, cuando TypeSafe lanzó Jev con tres tipos de pregunta: un sí/no noul, un elegir-uno choice y una rúbrica score. Jev es cerrado y alojado. A los pocos días, Kev de Jared Palmer publicó pesos abiertos compatibles con Jev, y Jeeves cita a Kev como inspiración.
Lo que Jeeves añade es pensar. El README plantea el problema sin rodeos: los modelos tipo Jev "give calibrated decision probabilities, but at low accuracy", así que "a lot of pipelines therefore rely on a reasoning model as a fallback." Ese respaldo suele ser un LLM alojado que se factura por token, el tipo de coste que desglosé en Claude Sonnet 5.5 pricing. Jeeves intenta ser ese respaldo, con la forma propia de Jev.
Las especificaciones principales:
| PostHog Jeeves | |
|---|---|
| Modelo base | Qwen3.5-9B con LoRA y una cabeza de puntero (ver alternativas a Qwen) |
| Tipos de pregunta | noul (sí/no), choice, score, combinables en una solicitud |
| API | /v1/systemone compatible con Jev, más un SDK de Python directo |
| Licencia | Código MIT, pesos Apache-2.0 (heredada de Qwen3.5) |
| Tamaño de los pesos | 21 GB bf16, 11.5 GB con capas lineales FP8 |
| Hardware | GPU CUDA; Mac con Apple Silicon de 48 GB+ para inferencia |
| API alojada | Ninguna. Solo autoalojado |
| Tracción al lanzamiento | 241 puntos en Hacker News, 356 estrellas en GitHub |
Soy Alicia y construyo los agentes de IA dentro de eesel, así que paso mucho tiempo en justo esta capa: la parte del flujo que decide qué es un ticket antes de que se escriba nada. Así lo hace Jeeves y aquí es donde se gana su lugar.
¿Cómo razona Jeeves antes de decidir?
El mecanismo es un buen trabajo de ingeniería y explica tanto la mejora de precisión como el coste de latencia.
Jeeves carga el estado y cada pregunta en la plantilla de chat de Qwen usando tokens raros, casi sin uso, como marcadores (<|fim_prefix|> para el estado, <|box_start|> para cada opción, etc.). Luego hace algo que Jev no hace: genera una cadena de razonamiento en texto libre dentro de un bloque <think>. Cuando la cadena se cierra, la pregunta y las opciones se repiten, y una pequeña cabeza de puntero puntúa cada opción comparando el estado oculto en un token <decide> con el estado oculto al final de cada opción. Un softmax sobre esas puntuaciones, dividido por una temperatura ajustada con datos de desarrollo (1.859, según la ficha del modelo en Hugging Face), da las probabilidades finales.
Dos detalles de las ablaciones merecen atención si alguna vez entrenas uno de estos. Cambiar los tokens raros por palabras normales como "State" empeoró los resultados. También lo hizo quitar la pregunta repetida tras el bloque de razonamiento. El modelo necesita que le recuerden las opciones justo antes de comprometerse.
El entrenamiento tuvo tres etapas, todas documentadas en el repositorio:
- Ajuste fino supervisado: 2 épocas, 596 pasos en 8 GPU, con 19,126 preguntas de 12 conjuntos de datos públicos más datos sintéticos de políticas. La mitad de las preguntas llevaba una cadena de razonamiento muestreada del modelo base.
- Aprendizaje por refuerzo con CISPO: el método de RL de MiniMax-M1, con 9,992 preguntas y 8 rollouts cada una, limitado a 2,560 tokens de pensamiento. El plan de 624 pasos se detuvo en el paso 402, porque después "the head over-sharpens" y la calibración empeora.
- Calibración: una sola temperatura ajustada en desarrollo y guardada con el checkpoint.
Esa parada en el paso 402 es lo que subrayaría. El equipo cedió algo de puntuación bruta para mantener honestas las probabilidades, que es la razón de ser de un modelo de decisión. Un modelo que dice 90 % y acierta el 70 % de las veces es peor que inútil en un flujo de enrutamiento, y es el mismo problema de fondo de la mayoría de las alucinaciones de IA en soporte.
Para recuperar velocidad, Jeeves incluye un drafter de difusión que propone varios tokens de razonamiento a la vez para decodificación especulativa. En una pregunta sube la velocidad de la cadena de 109 a 176 tokens por segundo con drafting de bloque 4, y a unos 960 tokens por segundo en total cuando se agrupan ocho preguntas.
¿En qué supera Jeeves a Jev y dónde pierde?
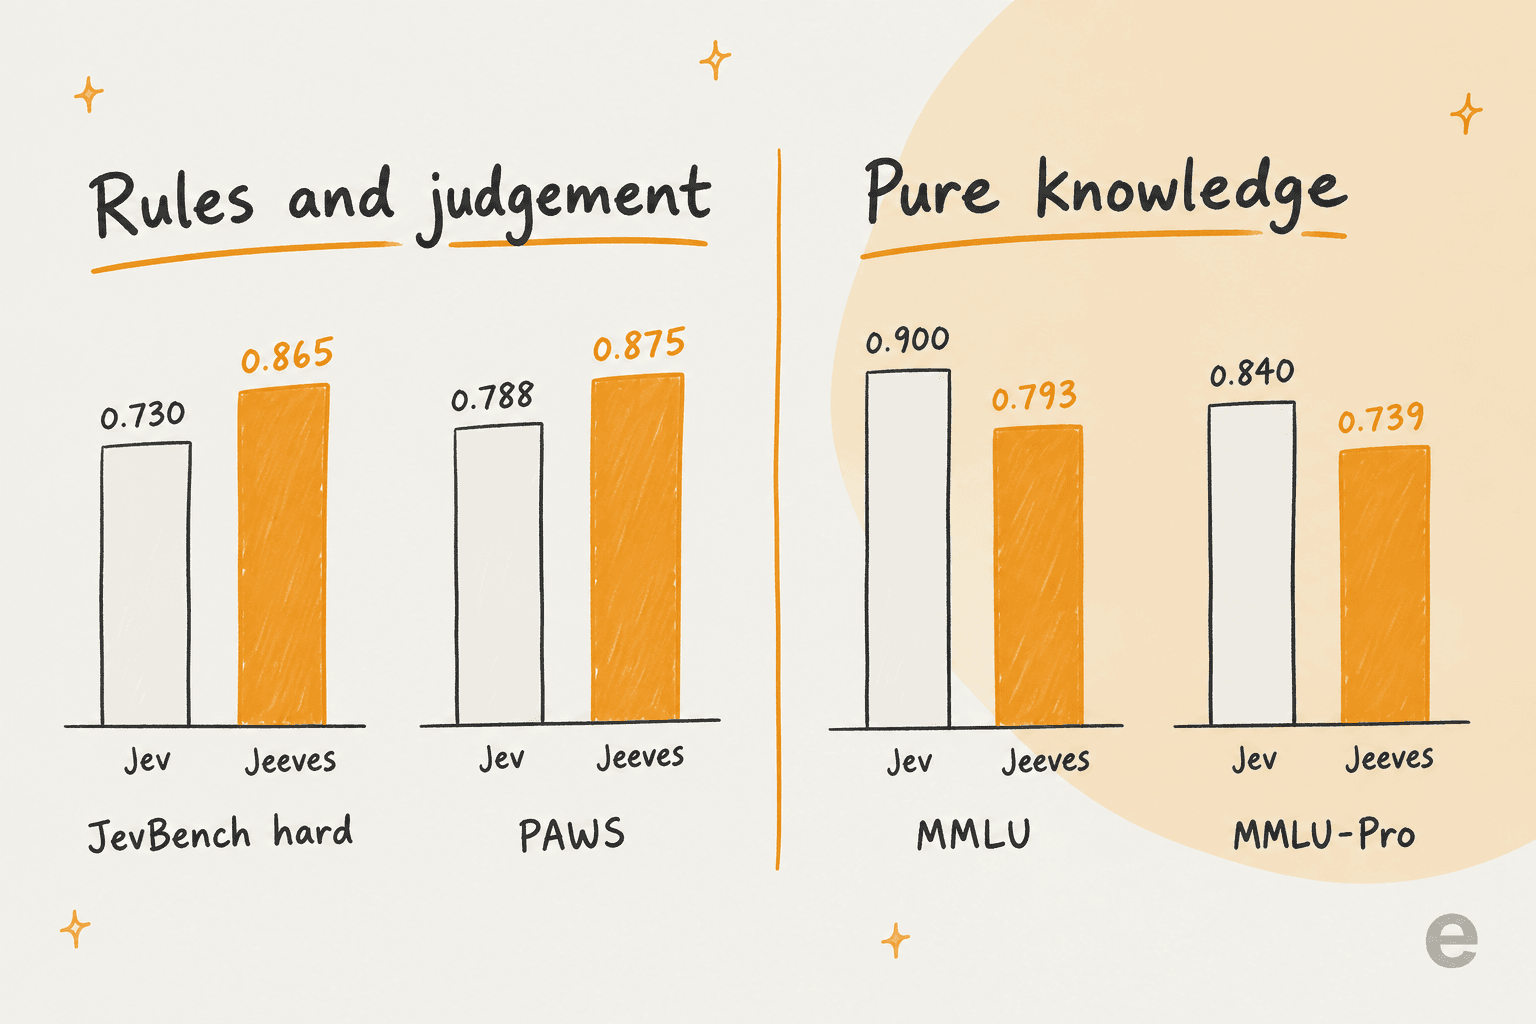
La tabla de resultados de PostHog es inusualmente franca, y el patrón que muestra es lo más útil del lanzamiento.
| Benchmark | Kev-9B | Jev | Jeeves |
|---|---|---|---|
| Prueba global (reservada y fuera de dominio) | 0.822 | 0.857 | 0.889 |
| JevBench global (231 ítems públicos) | 0.715* | 0.866 | 0.935 |
| JevBench hard (111 ítems públicos) | 0.451* | 0.730 | 0.865 |
| PAWS (detección de paráfrasis) | 0.763 | 0.788 | 0.875 |
| Estructuras de reglas reservadas | 0.896 | 0.885 | 1.000 |
| Políticas contrastivas | 0.900 | 0.963 | 1.000 |
| MMLU | 0.738 | 0.900 | 0.793 |
| MMLU-Pro (10 opciones) | 0.515 | 0.840 | 0.739 |
| Imposible de saber respondido con p ≥ 0.9 (menos es mejor) | 0.000 | 0.090 | 0.055 |
| Error de calibración en JevBench (menos es mejor) | 0.049 | 0.037 |
*PostHog señala que no hay resultado publicado de Kev-9B en JevBench, así que esas celdas son de Kev-8B. Todas las cifras proceden del README de Jeeves.
Al leer la tabla de arriba abajo aparece una división. Donde la pregunta trata de aplicar reglas a una entrada desordenada (estructuras de reglas reservadas, políticas contrastivas, detección de paráfrasis, JevBench hard), pensar gana, a veces por mucho. Donde la pregunta trata de saber un dato (MMLU, MMLU-Pro), Jev gana por unos 10 puntos. Razonar no puede conjurar conocimiento que un modelo de 9B no tiene. Para el conocimiento, los equipos de soporte suelen anclar el modelo en sus propios documentos, el compromiso que se explica en RAG vs fine-tuning.
Esa división encaja bien con el trabajo de soporte. "¿Entra esta solicitud de reembolso en nuestra política de 30 días, dada la fecha del pedido enterrada en el tercer párrafo?" es una pregunta de reglas. "¿Cuál es la capital de Perú?" nunca aparece en una cola de tickets. Si tus decisiones se parecen a las primeras, la tabla juega a tu favor.
Dos salvedades honestas de la propia PostHog: las comparaciones con Kev y Jev fuera de JevBench "use different items from the same sources", y las cadenas de razonamiento no son muy legibles, porque "no language consistency reward was included." Obtienes la respuesta y una cadena, pero no planees mostrar esa cadena a un auditor.
¿Qué tan lento es "pensar" en la práctica?
Aquí es donde el hilo de Hacker News apretó más, y con razón.
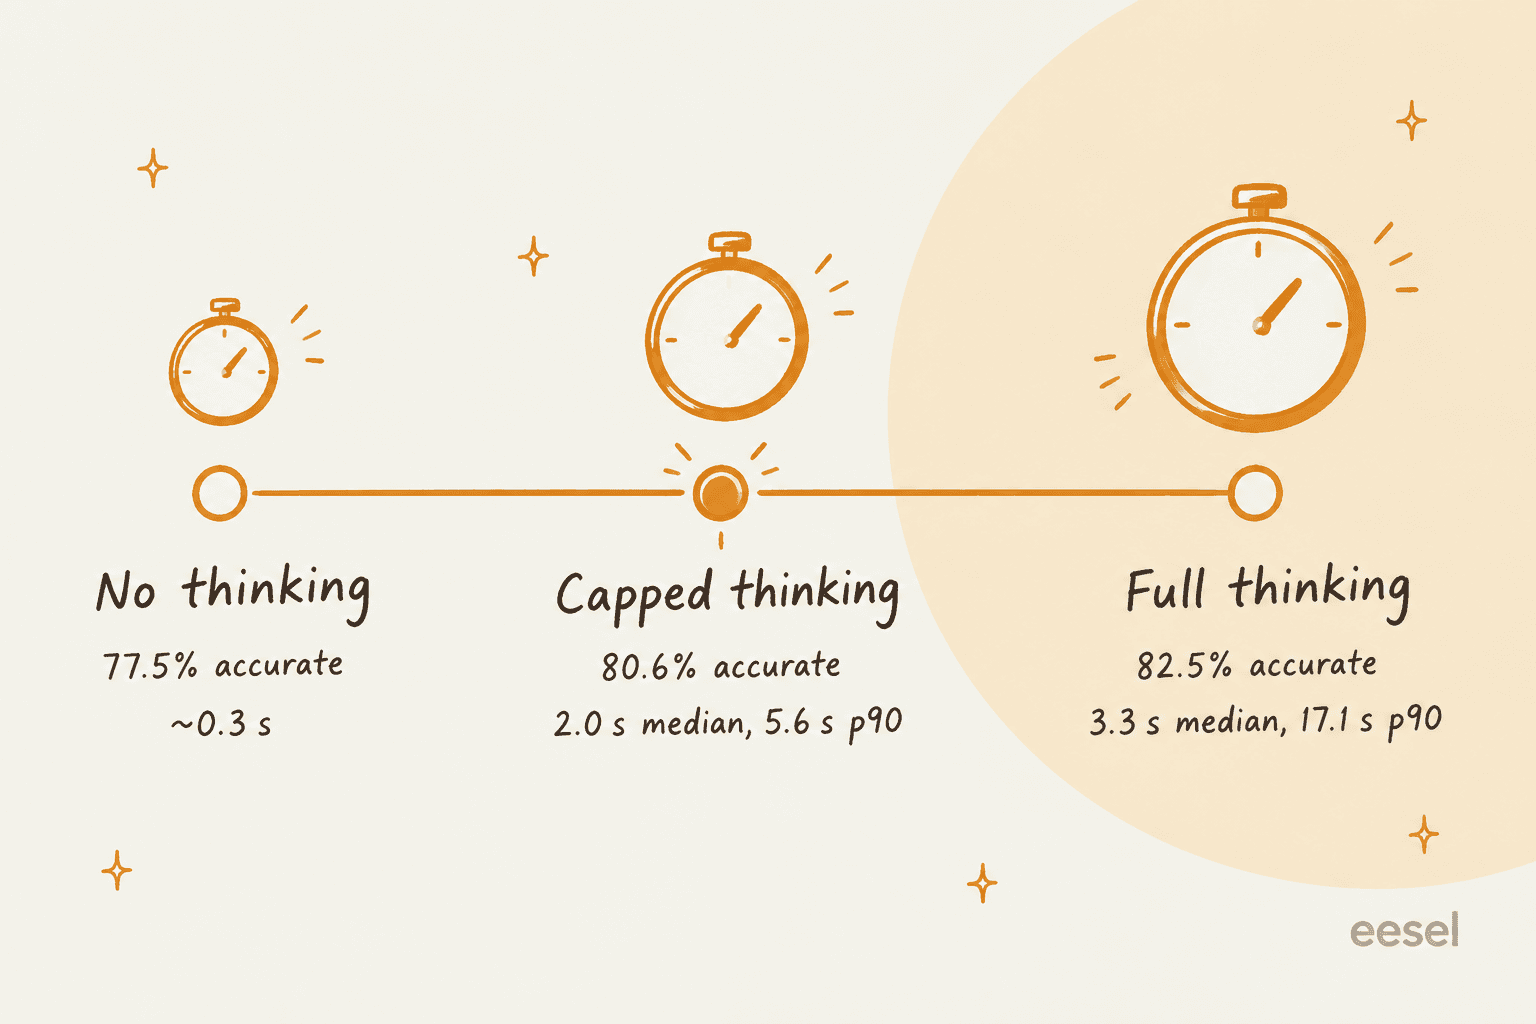
PostHog midió tres ajustes en 325 preguntas de desarrollo, en una H100 con FP8:
| Ajuste | Precisión | Tokens de razonamiento (media) | Latencia mediana / p90 |
|---|---|---|---|
| Pensamiento completo | 0.825 | 1,138 | 3.3 s / 17.1 s |
max_think 768, nothink_threshold 0.9 | 0.806 | 344 | 2.0 s / 5.6 s |
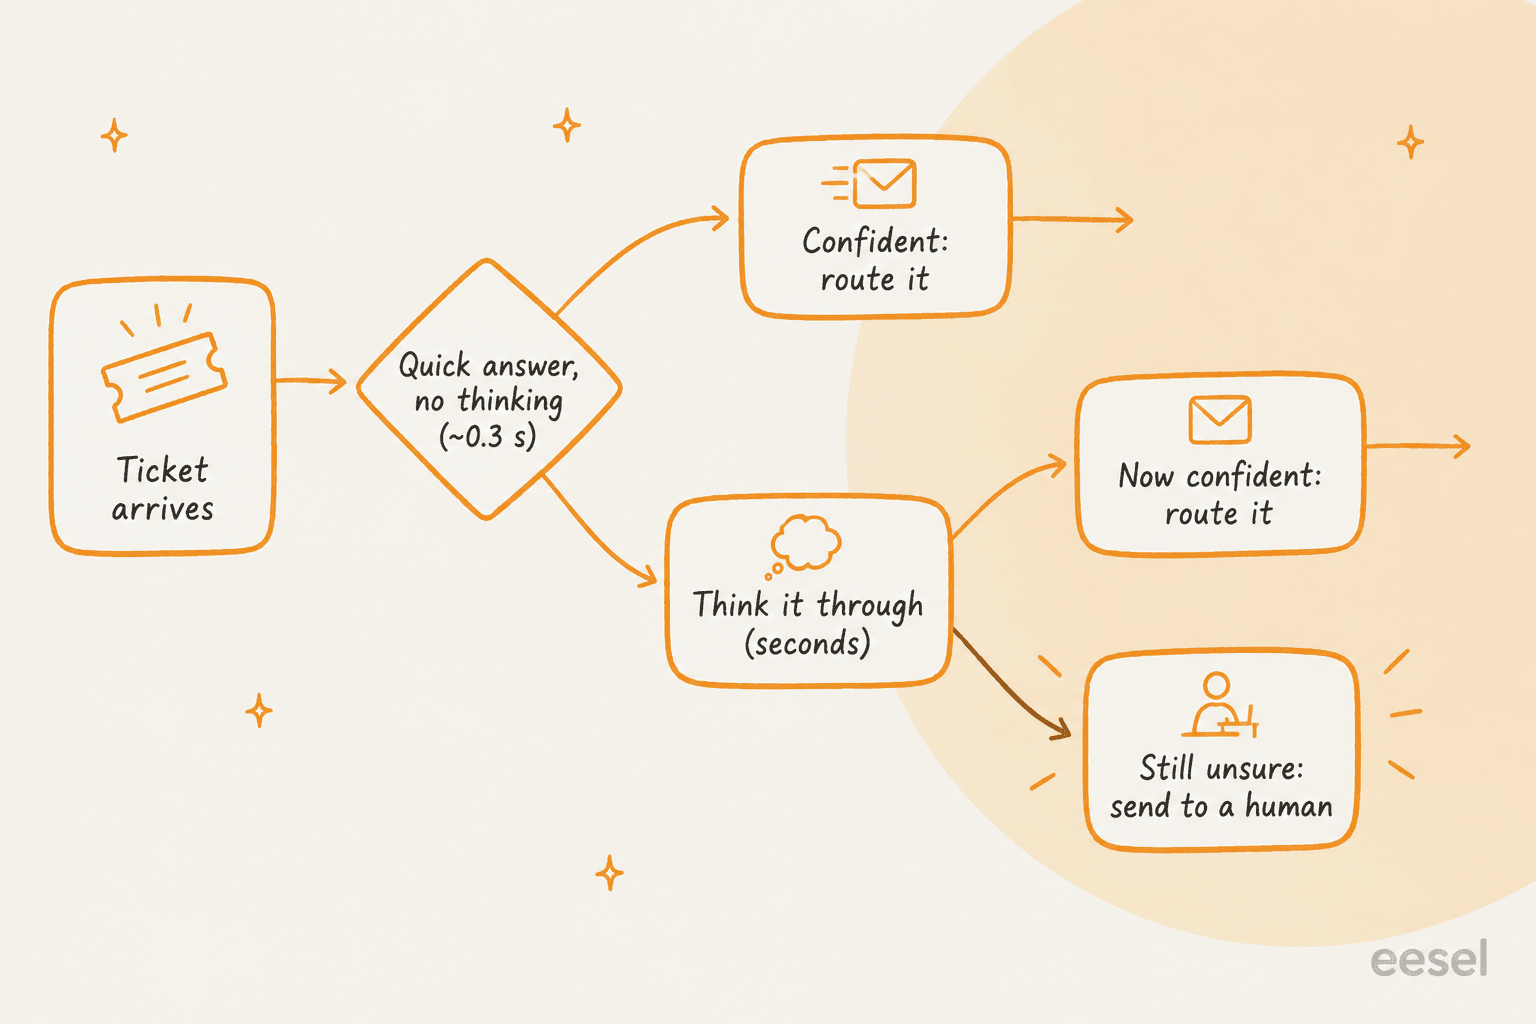
| Sin pensar | 0.775 | 0 | unos 0.3 s |
La fila del medio es la que yo pondría en producción. max_think corta cada cadena de razonamiento en un presupuesto de tokens, y nothink_threshold se salta el pensamiento por completo cuando la respuesta rápida ya es segura. Conservas la mayor parte de la mejora de precisión (0.806 vs 0.775) y recortas la latencia p90 en dos tercios.
Como comparación, la propuesta de Jev son de 70 a 500 milisegundos por llamada, que cubrí en mi prueba de velocidad de Jev. La gente de HN lo notó:
"Cool engineering, but 17s p90 latency kind of defeats the point of a Jev-class model, which is supposed to be fast and cheap."

Eso es cierto si tratas a Jeeves como un reemplazo de Jev. Lo es menos si lo tratas como lo que corre después de que el modelo rápido se encoge de hombros. Un comentarista describió la arquitectura con claridad:
"Seems like this is the way, a hybrid approach where some of the pipeline will be jev like and some traditional LLM depending on the nature of the work."
Jeeves colapsa ese híbrido en un solo modelo. Sin pensar es tu nivel rápido. Pensando es tu nivel lento. Y como ambos niveles comparten una API y una calibración, no tienes que conciliar las probabilidades de un clasificador con la respuesta en texto libre de un LLM.
¿Qué pasa con un ticket de soporte real?
La solicitud de demostración del README es un ticket de soporte, lo que me facilitó el trabajo. El estado dice: "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card." Van tres preguntas: qué departamento, si debe escalarse y qué tan frustrado está el cliente.
Jeeves respondió billing 0.46, returns 0.40, shipping 0.14, y una confianza de elección de solo 0.19. La escalada puntuó 0.72. La frustración quedó en 1.5 en una escala de 0 a 2. Toda la solicitud tardó 8.1 segundos, con las tres preguntas pensando en paralelo.
Aquí está el mismo ticket (más una frase extra) pasado por Kev-4B en el playground de Kev:
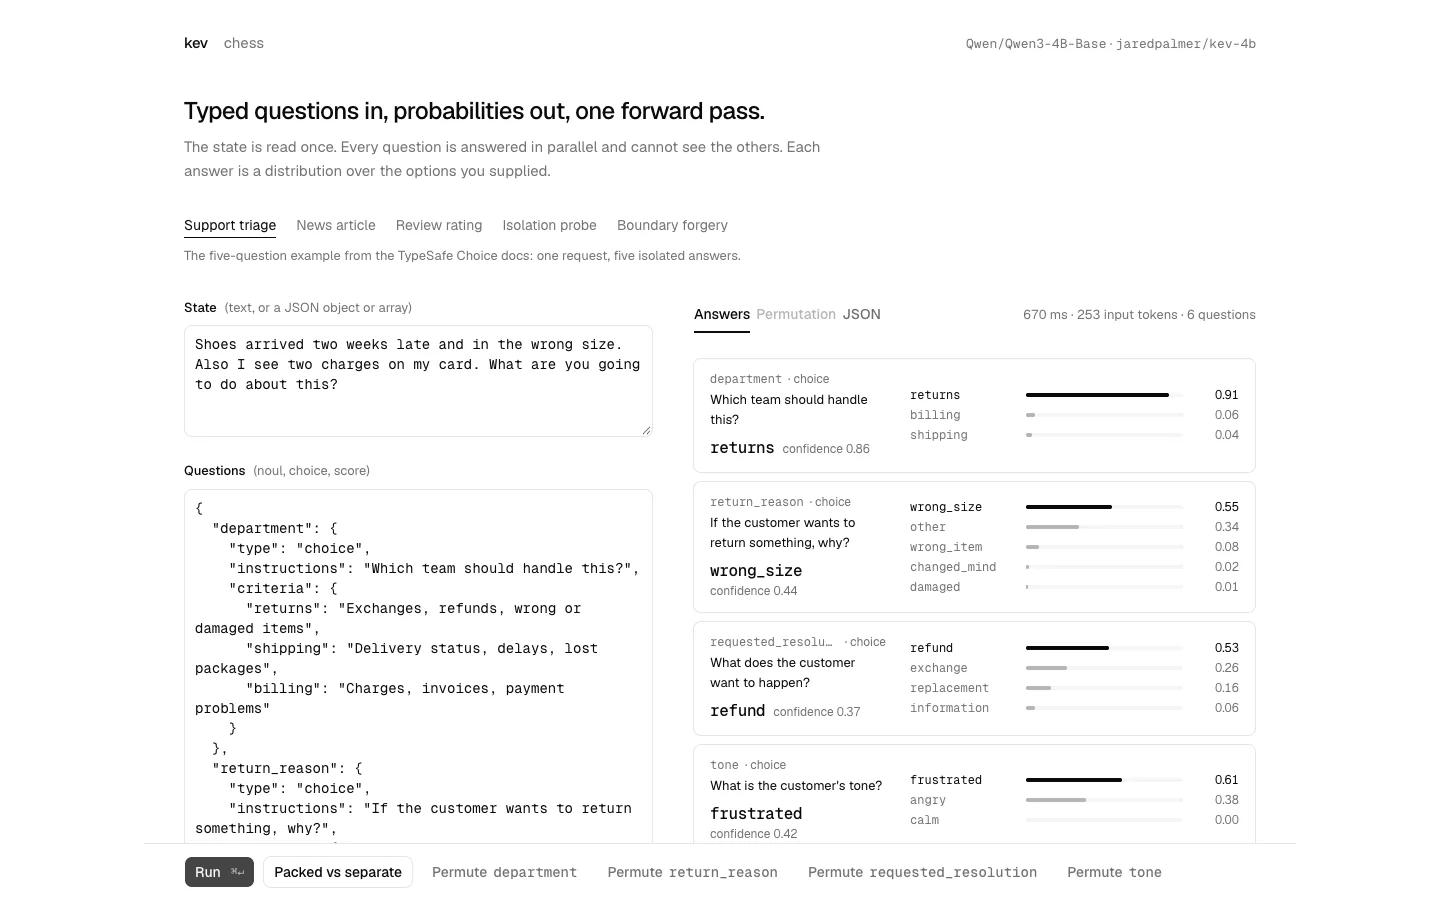
Kev-4B dijo returns con 0.91 en 670 milisegundos. Es un modelo más pequeño y el prompt es algo distinto, así que no es una comparación directa limpia. Pero mira el ticket. Contiene de verdad dos problemas de dos equipos. Kev respondió rápido y sonó seguro. Jeeves lo pensó y dijo, en esencia: "esto está parejo y no estoy seguro".
Para una cola de soporte, la segunda respuesta es la más útil. Una ruta equivocada con confianza significa que el cliente espera en la cola de devoluciones mientras su cobro duplicado queda sin tocar. Un reparto con baja confianza es una señal para hacer algo más inteligente: enrutar a facturación y etiquetar devoluciones, dividir el ticket o enviarlo a una persona con un traspaso de IA a humano limpio.
Esto coincide con lo que he visto ejecutando IA de eesel en colas reales. En una prueba con tráfico real en un buzón de e-commerce, las decisiones fueron la parte fiable: 93 % de precisión en la clasificación y 100 % de detección de spam sin falsos positivos. Donde fallaron fue en las respuestas generadas, con un 7 % de errores factuales en los borradores. La clasificación es la mitad de la IA de soporte en la que puedes confiar pronto, siempre que el modelo admita cuando no está seguro. También he visto bots que suenan seguros dar respuestas erróneas en silencio, por eso cada despliegue de eesel se simula con tickets históricos antes de tocar a un cliente real. Un "no lo sé" calibrado vale más que una suposición rápida.
¿Quién debería usar realmente PostHog Jeeves?
Jeeves es un lanzamiento de investigación, no un producto, y se nota, como gran parte del espacio de agentes de IA de código abierto: código de entrenamiento completo, datos de train/dev/test, un script de reproducción, ningún endpoint alojado. La página del modelo en Hugging Face indica que el modelo "isn't deployed by any Inference Provider."
Así lo clasificaría:
| Eres... | Elige | Por qué |
|---|---|---|
| Un equipo de ML que ya usa Jev o Kev, con respaldo de LLM | Jeeves | Misma API, un modelo para ambos niveles, mejor en casos límite con muchas reglas |
| Un equipo que necesita decisiones en menos de un segundo en cada llamada | Jev o Kev | Una pasada, sin cola de pensamiento |
| Un equipo que quiere pesos abiertos en un portátil | Kev-0.8B o Kev-4B, o Laya | Huellas mucho más pequeñas |
| Un equipo que quiere entrenar su propio modelo de decisión | Jeeves | La receta completa de SFT, CISPO y drafter está en el repositorio |
| Un equipo de soporte que quiere tickets clasificados y resueltos | Un agente de IA para helpdesk | Un modelo de decisión no responde, no actualiza campos ni escala |
Las primeras pruebas de la comunidad son alentadoras para trabajo de moderación. Un comentarista de HN lo probó con sus propios datos:
"Update: Jeeves took about 2 hours to moderate 394 data points and performed really well. It's not as good as Jev, but it's super close!"
Fíjate en las "2 hours". Es de nuevo el impuesto de pensar en hardware que no es una H100. Un ingeniero de PostHog, Robbie Coomber, respondió en el mismo hilo que había un port a MPS en marcha para acelerar Apple Silicon, y el repositorio muestra que ya se fusionó.
Si eres tú quien lo integra, conviene echar antes un vistazo al mapa completo de alternativas a Jev, porque las funciones de salida estructurada en LLM alojados podrían cubrir tu caso sin GPU.
Lo que un modelo de decisión no hará por tu helpdesk
Este es el cambio en el que insistiría. Un modelo de decisión responde muy bien a "¿qué es este ticket?". No responde a "¿y ahora qué hacemos?". Alguien aún tiene que escribir el código que convierte billing: 0.46 en una etiqueta del helpdesk, una respuesta, una consulta de reembolso, una escalada con nota y un registro del porqué.
Ahí aparece la brecha entre infraestructura y empleado. Jeeves, Jev y Kev son infraestructura: bloques excelentes y baratos de ejecutar para la clasificación de tickets, la priorización y el sentimiento. Un compañero de IA es el empleado que toma las mismas decisiones dentro de tu helpdesk real y luego hace el trabajo. Si estás comparando ambos, mi guía para automatizar la clasificación de tickets expone con más detalle el compromiso entre construir y contratar.
Prueba eesel

Si miras Jeeves porque quieres una clasificación más inteligente, probablemente no quieras alojar un modelo de 9B y escribir el código de unión. El compañero de IA para helpdesk de eesel se une a tu cola actual en Zendesk, Freshdesk o Help Scout, aprende de tus tickets pasados y tu centro de ayuda, y toma la decisión de enrutar, etiquetar y escalar en cada ticket, siguiendo las reglas de escalado que ya usas. Después redacta o envía la respuesta y pasa los casos realmente dudosos a una persona con una nota. Antes de salir en vivo, puedes simularlo con cientos de tus tickets pasados y ver exactamente dónde habría acertado y dónde se habría equivocado.
Si el atractivo del autoalojamiento de Jeeves es en realidad el control desde código, la CLI de eesel lo cubre. Ejecuta el mismo compañero desde tu terminal: eesel activity lista cada ejecución y muestra una en detalle, eesel approvals te deja aprobar o denegar acciones que requieren a una persona, y eesel instructions edita las reglas permanentes del compañero. Cada comando imprime JSON, los de escritura admiten --dry-run para ver la llamada exacta antes de que ocurra, y el espacio de trabajo funciona también como servidor MCP, así que agentes de programación como Claude Code pueden manejarlo directamente. Hay más en mi guía de la CLI de agentes de IA.
Si lo comparas con la IA integrada de tu helpdesk, el análisis eesel vs Zendesk AI es una buena siguiente lectura. Empezar es gratis con 100 créditos y sin tarjeta, y un ticket o chat cuenta como un crédito, según la página de precios. Prueba eesel en tu propia cola y mira cuántos tickets habría enrutado bien el mes pasado.
Preguntas frecuentes
¿Qué es PostHog Jeeves?
PostHog Jeeves es un modelo de decisión de 9B con pesos abiertos del equipo de investigación de IA de PostHog. Le das un estado (texto o JSON) y preguntas tipadas de sí/no, opción múltiple o puntuación, y escribe una cadena de razonamiento antes de devolver una probabilidad calibrada para cada opción. Copia el formato de solicitud de Jev de TypeSafe, así que encaja en los mismos flujos de clasificación.
¿Es gratis usar PostHog Jeeves?
Sí. El código tiene licencia MIT y los pesos en Hugging Face son Apache-2.0, así que descargar PostHog Jeeves no cuesta nada. En su lugar pagas el hardware: una GPU CUDA o un Mac con Apple Silicon de 48 GB o más. No hay API alojada, y esa es la principal diferencia con los precios por token de Jev.
¿En qué se diferencia PostHog Jeeves de Jev?
Jev responde en una sola pasada sin razonamiento visible. PostHog Jeeves piensa primero, lo que mejora la precisión en pruebas reservadas (0.889 vs 0.857) y en JevBench hard (0.865 vs 0.730), pero lleva la latencia p90 a 17.1 segundos con pensamiento completo. Jev sigue ganando en preguntas de conocimiento como MMLU. El análisis de Jev cubre en detalle el lado de pasada única.
¿Puede PostHog Jeeves clasificar tickets de soporte?
Puede encargarse de la parte de decisión de la clasificación de tickets: elegir un departamento, marcar la urgencia, puntuar la frustración. La demo del README es un ticket de soporte. No responde a clientes, no actualiza tu helpdesk ni escala por su cuenta, así que sigues necesitando código o un agente de IA para helpdesk a su alrededor.
¿Qué tan rápido es PostHog Jeeves?
En una H100 con FP8, PostHog Jeeves responde en unos 0.3 segundos sin pensar, 2.0 segundos de mediana con pensamiento limitado y 3.3 segundos de mediana (17.1 segundos en p90) con pensamiento completo. Es más lento que los modelos de decisión de pasada única, así que la mayoría de los equipos querrán la opción nothink_threshold para saltarse el pensamiento en los casos fáciles, algo parecido a un flujo de escalado por niveles.
¿Qué hardware necesito para ejecutar PostHog Jeeves?
Los pesos ocupan 21 GB en bf16 u 11.5 GB con capas lineales FP8. El README pide Python 3.12 y una GPU CUDA, y dice que la inferencia también funciona en Macs con Apple Silicon de 48 GB o más si reduces las cachés. Si prefieres no gestionar GPU en absoluto, una API de atención al cliente con IA gestionada es la vía más sencilla.
¿Es PostHog Jeeves mejor que Kev?
Según las cifras publicadas por PostHog, Jeeves supera a Kev-9B en datos de prueba reservados (0.889 vs 0.822) y en JevBench (0.935 vs 0.715 de Kev-8B). Kev es más pequeño y rápido, tiene cuatro tamaños de 0.8B a 27B y corre en un portátil. Elige Kev por velocidad y PostHog Jeeves para decisiones difíciles basadas en reglas. Ambos conviven con Laya en el espacio de modelos de decisión abiertos.


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.