

Resumen rápido
Le doy a Kimi K3.1 Pro 3,5 de 5: razona casi tan bien como Claude Opus 5.5, con una puntuación de 55.1 en el Artificial Analysis Intelligence Index (puesto #4 de 215), a 2 $ por entrada y 10 $ por salida por millón de tokens. Para tareas largas de agentes que puedes dejar ejecutándose sin supervisión, ahora mismo ofrece la mejor relación calidad-precio entre los primeros puestos de la clasificación.
Pierde puntos por cómo funciona, no por su inteligencia. Es lento, con unos 50 tokens por segundo, escribe respuestas largas que reducen la ventaja del precio bajo, los pesos abiertos están prometidos para "by Nov 4" pero aún no se han publicado, y los suscriptores de Kimi Code dicen agotar un límite de 5 horas en menos de una hora. Úsalo a través de la API para tareas sin prisa; descártalo para cualquier cosa que tenga a una persona esperando.
Si has llegado aquí para elegir un modelo para un agente de soporte, el modelo es la parte menos importante de la decisión. Desarrollo las integraciones y las API de eesel, y, tras años ejecutando IA en colas de soporte reales, lo que determina la calidad es la configuración que rodea al modelo. SamCart utiliza eesel en tickets de Freshdesk y en el chat de su sitio web, respondiendo a partir de 280 artículos del centro de ayuda, sin preocuparse nunca por qué modelo encabezaba una clasificación esa semana.
¿Qué es Kimi K3.1 Pro?
Kimi K3.1 Pro es el modelo insignia de Moonshot AI, lanzado el 23 de octubre de 2026. Moonshot lo describe como "a post-trained version of Kimi K3, with substantially larger post-training compute" en su artículo de lanzamiento, así que tiene la misma base de 2.8T parámetros que Kimi K3 (104B activos, mezcla de expertos), con mucho más entrenamiento adicional y una ventana de contexto de 1M tokens.
Está disponible en la aplicación Kimi, Kimi Work, Kimi Code y la API de Kimi, y ahora es el modelo predeterminado del cuadro de chat de kimi.com. Si quieres el repaso completo del lanzamiento (pruebas de rendimiento, comparación con K3 y vías de acceso), lo encontrarás en mi descripción general de Kimi K3.1 Pro. Este artículo es el veredicto, con el mismo formato que mi anterior reseña de Kimi K3.
¿Cómo probé y evalué Kimi K3.1 Pro?
Leí el artículo de lanzamiento de Moonshot, la guía de inicio rápido de la API y la página de precios, y después revisé los resultados independientes de Artificial Analysis y la primera tanda de pruebas prácticas, incluido el hilo de Hacker News con 674 comentarios. El modelo tiene cuatro días de vida, así que no voy a fingir que llevo meses usándolo en producción. Lo que sí puedo hacer es evaluarlo según los factores que determinan si merece la pena desarrollar sobre él.
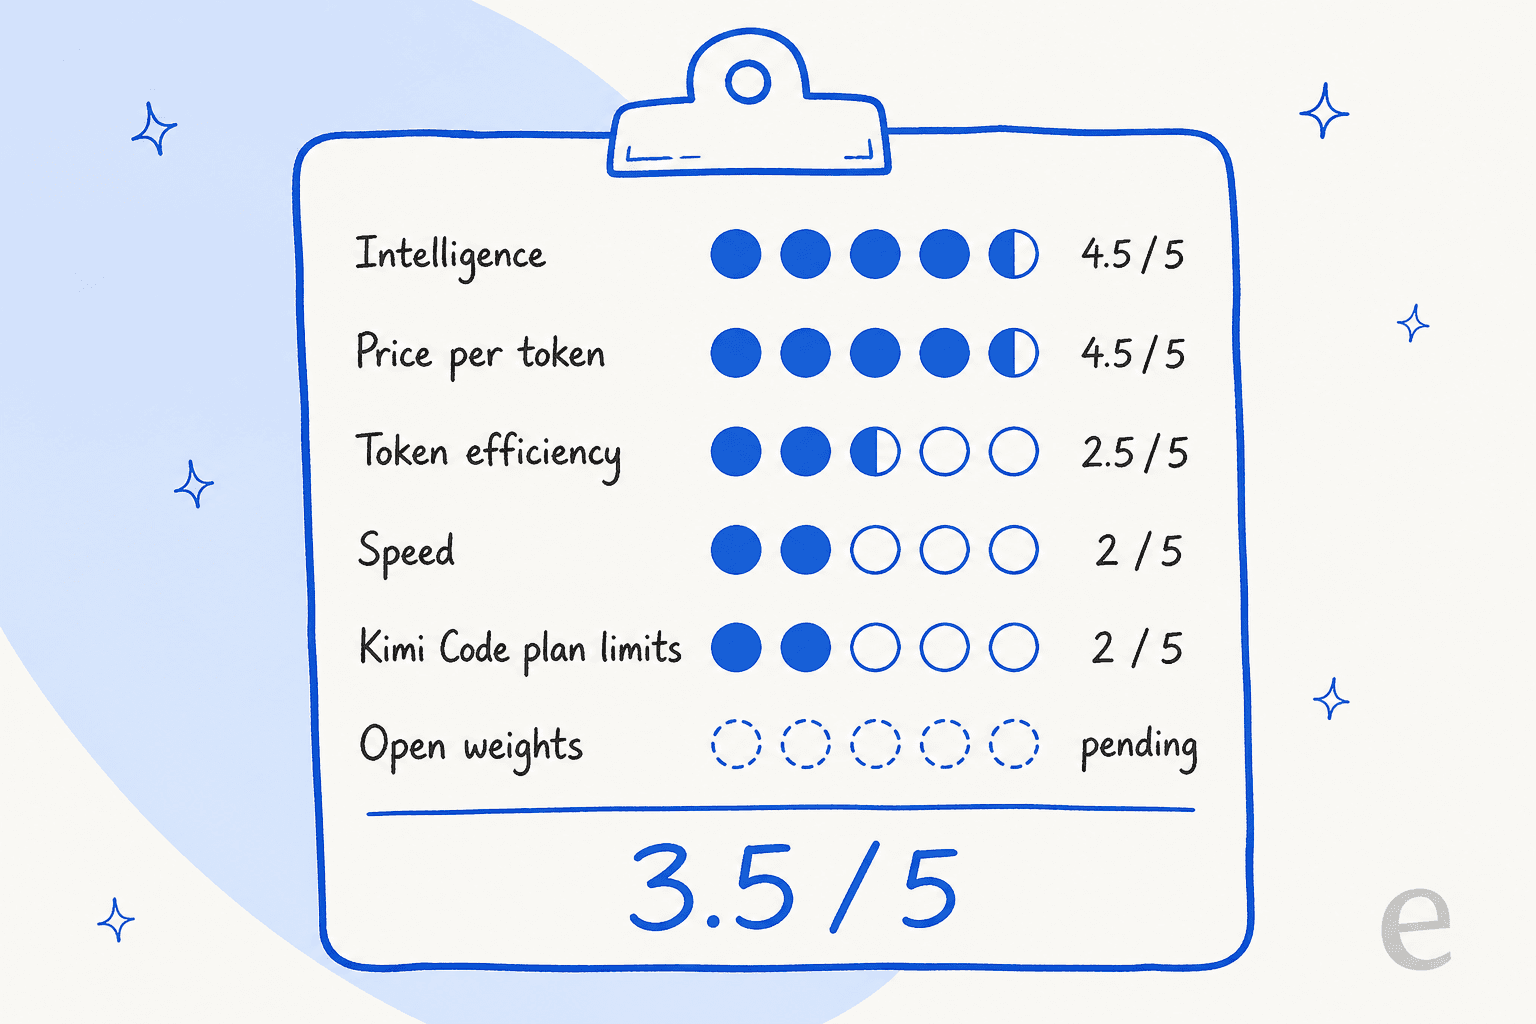
| Categoría | Puntuación | Motivo |
|---|---|---|
| Inteligencia | 4,5/5 | 55.1 en el índice de AA, 2.5 puntos por detrás de Opus 5.5 (Max) |
| Precio por token | 4,5/5 | 2 $ / 10 $, un tercio más barato que K3, sin recargo por contexto largo |
| Eficiencia de tokens | 2,5/5 | 150M tokens de salida para ejecutar el índice de AA frente a una mediana de 87M entre modelos comparables |
| Velocidad | 2/5 | 49.7 tokens por segundo, puesto 165 de 182 |
| Límites de los planes de Kimi Code | 2/5 | Varios suscriptores dicen alcanzar el límite de 5 horas en menos de una hora |
| Pesos abiertos | Pendiente | Prometidos para el 4 de noviembre, sin publicar a fecha del 27 de octubre |
| General | 3,5/5 | Motor potente, con aspectos por pulir en la forma de usarlo |
¿En qué destaca Kimi K3.1 Pro?
La versión corta: es lo más cerca que ha llegado un laboratorio no estadounidense a la cima de la clasificación, a un precio de gama media. Aquí es donde se nota.
Razonamiento cercano a los modelos más avanzados por 2 $ y 10 $
En Artificial Analysis, K3.1 Pro obtiene 55.1, frente a 57.6 de Claude Opus 5.5 (Max) y 56.0 de Claude Sonnet 5.5 (Max). Se sitúa por encima de GPT-6 Astra (Max), con 52.7, y de Gemini 4 Argon (High), con 52.6. En la misma versión del índice, Kimi K3 obtiene 43.6, así que esta versión supone un salto de más de 11 puntos a partir del mismo modelo base.
El precio es lo que lo hace interesante. K3.1 Pro tiene un precio de 2 $ por entrada, 0,20 $ por entrada en caché y 10 $ por salida por millón de tokens en la API de Kimi, lo que supone un tercio menos que los precios de Kimi K3 y el mismo precio de lista que Sonnet 5.5. Ejecutó el índice completo de Artificial Analysis por $3,117, frente a los $8,708 de Opus 5.5 (Max).
Tareas largas de agentes y trabajo de oficina
Aquí es donde se nota el entrenamiento adicional. Artificial Analysis midió un 67.2% en Terminal-Bench 4.0, la cifra más alta de todos los modelos representados en su página de K3.1 Pro, frente al 12.6% de K3. En las pruebas de la propia Moonshot, lidera SWE Marathon (51.7 frente a 46.3 de Opus 5.5) y OfficeQA Pro v2 (64.4 frente a 62.2), una prueba de rendimiento de finanzas y documentos de oficina.
También inventa menos cosas que K3. En Hallu Bench, la prueba interna de Moonshot, la tasa de alucinaciones por afirmación en preguntas difíciles con herramientas bajó del 23.4% al 8.3%. Es una prueba de la propia Moonshot, así que le doy poco peso, pero la cifra independiente apunta en la misma dirección: la tasa de alucinaciones de AA es del 43.9% para K3.1 Pro, frente al 53.2% de K3 y al 58.6% de Opus 5.5 (Max).
Las primeras experiencias prácticas coinciden con esto. Un desarrollador pasó directamente de K3 al nuevo modelo:
"Using it now via API (3.1 Pro on Open Router) in a HITL setup (Cline in VSCode). Off-hand it's quite good. I've been using K3 for the past few months almost exclusively for coding work and have been stunned by how good it is. Excited to see how far 3.1 Pro can be pushed."

Una ventana de contexto de 1M con precios uniformes
La guía de inicio rápido indica que K3.1 Pro tiene precios de pago por uso uniformes, sin tramos según la longitud del contexto, así que una instrucción de 900.000 tokens cuesta lo mismo por token que una corta. La entrada en caché se factura a 0,20 $ por millón, un descuento del 90 %, con una caché predeterminada de 5 minutos y una opción de 1 hora. Para los agentes que releen una gran base de código o un contrato largo en cada turno, eso se traduce en un ahorro real.
¿En qué se queda corto Kimi K3.1 Pro?
Todo lo que le hizo perder puntos está alrededor del modelo, no dentro de él. Estos son los cinco problemas que influirían en mi decisión de desarrollar sobre él hoy.
Es lento
Artificial Analysis midió 49.7 tokens de salida por segundo en la propia API de Moonshot, puesto 165 de 182, y lo calificó de "notably slow". La tarea media de su índice de pruebas tardó 1,011 segundos, unos 17 minutos. La solución de Moonshot es Kimi K3.1 Pro Highspeed, que, según afirma, funciona a "2-3× the speed" por exactamente el doble de precio (4 $ / 20 $).
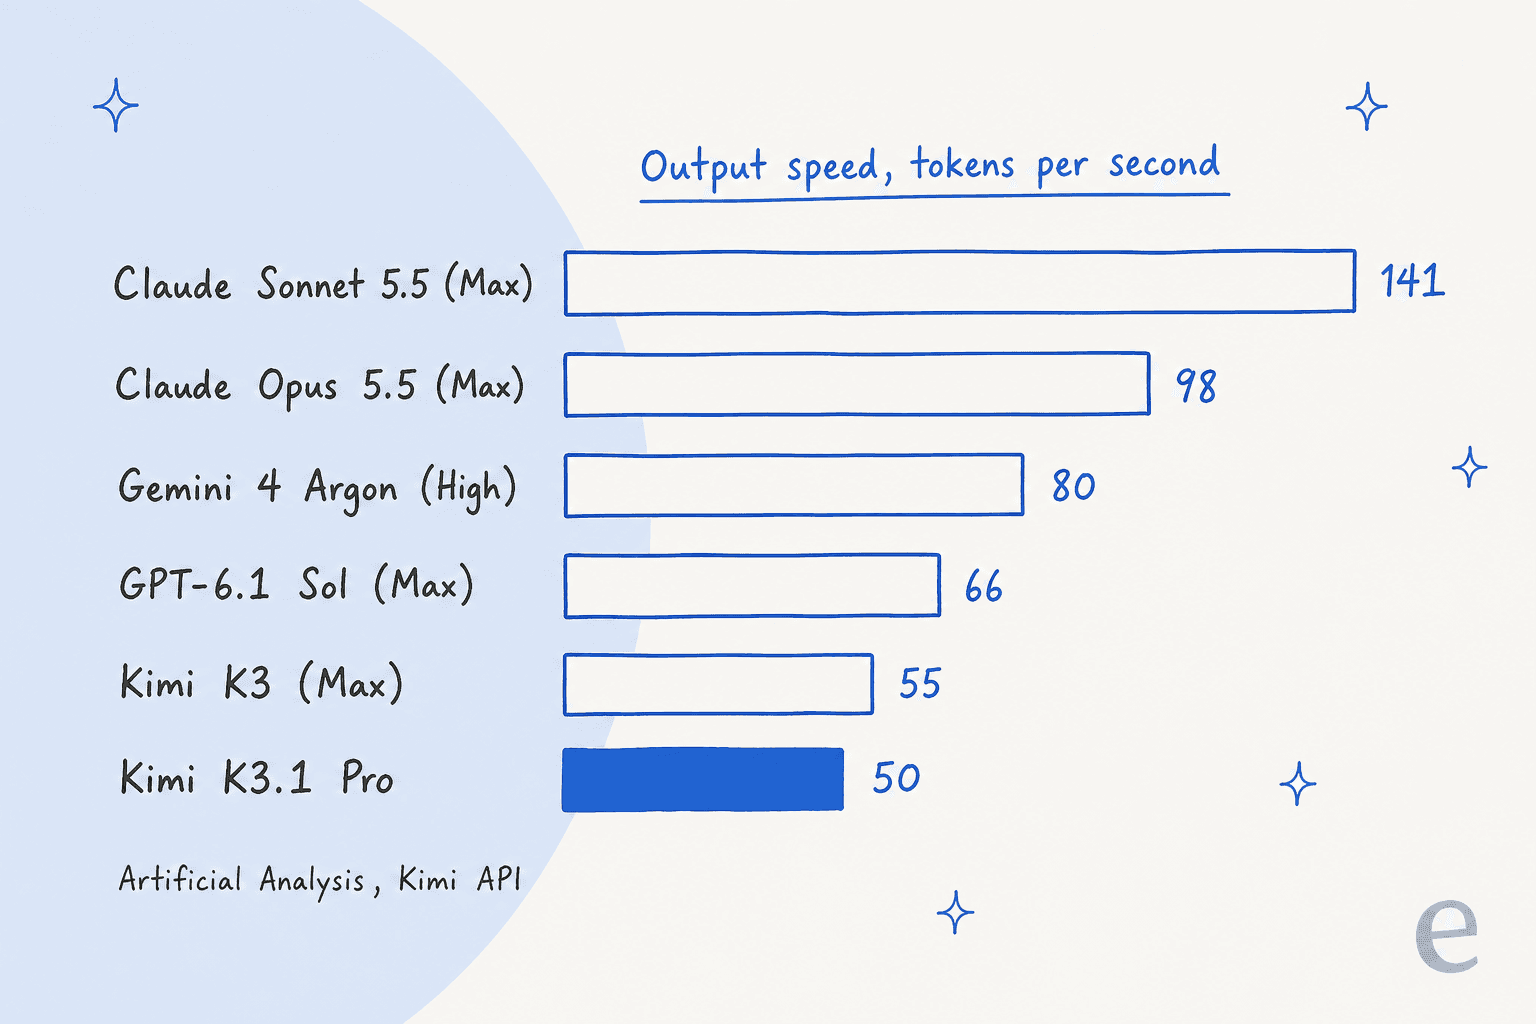
Sonnet 5.5 cuesta lo mismo por token y transmite respuestas casi tres veces más rápido. Para una tarea por lotes que se ejecuta durante la noche, 50 tokens por segundo no importan. Para una ventana de chat con una persona mirando la pantalla, sí.
Escribe mucho
K3.1 Pro utilizó 150M tokens de salida para ejecutar el índice de Artificial Analysis, frente a una mediana de 87M entre modelos comparables. La mayor parte corresponde al razonamiento: 34,883 tokens de razonamiento por tarea de media. Así que el descuento por token no se traslada por completo a la factura. Por tarea, el promedio fue de $2.11, frente a los $2.00 de K3, aunque el precio de lista de K3 es de 3 $ / 15 $. Desgloso esos cálculos en el artículo sobre los precios de Kimi K3.1 Pro.
"So their base price is 1/5th of Opus 5.5 per token, but if you want "highspeed" it's 2x that and then I guess it generates 2x the number of tokens as well? That might suggest that Opus is competitively priced after all."
El ajuste que tienes a tu disposición es reasoning_effort. La API admite low, high y max, y la página de claves de API indica que max es el valor predeterminado. Todas las cifras de las pruebas anteriores se obtuvieron con el esfuerzo al máximo, así que, si lo reduces, sacrificas puntuación a cambio de usar menos tokens.
Los límites de Kimi Code se agotan rápido
La queja más sonada del hilo de lanzamiento no es la calidad, sino la cuota. La página de Kimi Code de Kimi ofrece Plus por 19 $, Pro por 39 $, Max por 99 $ y Ultra por 199 $ al mes, y Highspeed requiere Pro o superior y consume el doble de créditos. Los nuevos planes mantienen una ventana móvil de 5 horas, además de una reserva mensual de créditos compartida con la aplicación Kimi.
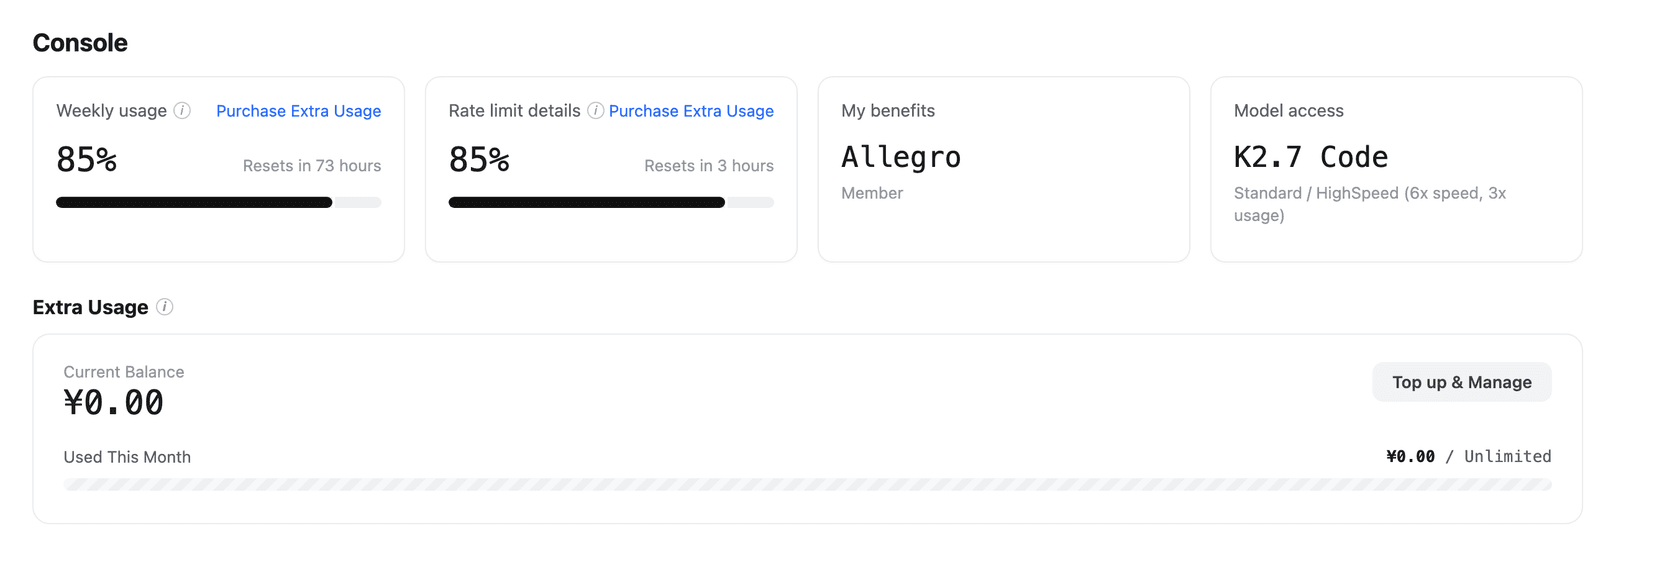
"If you are expecting any sort of usable limits on their subscription plan I suggest adjusting your expectations. I subscribed to $99 a month plan and within 47 minutes with one session (not asking for swarms or anything) was limited by 5-hour quota."
No todo el mundo llegó al límite, y el esfuerzo máximo predeterminado explica parte de lo ocurrido, ya que consume tokens más rápido. Aun así, si vienes de Claude Code y esperas el mismo margen de uso por dólar, pruébalo una semana con el plan mensual antes de pagar un año.
Los pesos aún no se han publicado
Moonshot llama a K3.1 Pro su "most capable 3T-class open-weight model", y tanto el artículo como la guía de inicio rápido dicen que los pesos completos se publicarán a más tardar el 4 de noviembre. El 27 de octubre, la API de modelos de Hugging Face no devolvía ningún repositorio de K3.1 en la cuenta de Moonshot, y Artificial Analysis clasifica la licencia como propietaria por ahora.
Eso importa por dos motivos. Todavía no puedes alojarlo por tu cuenta ni hacerle un ajuste fino, y solo Moonshot lo sirve: la ficha de OpenRouter muestra dos endpoints, ambos de la propia Moonshot. Artificial Analysis contabiliza 5 proveedores de API para K3.1 Pro, frente a 20 para K3. Incluso cuando lleguen los pesos, un modelo de 2.8T parámetros necesita un clúster de servidores, no una estación de trabajo.
Algunas de las pruebas más destacadas son internas
Varias de las afirmaciones más contundentes de Moonshot proceden de pruebas internas: Kimi Code Bench, Hallu Bench, las pruebas financieras y la evaluación de ciberseguridad. Sus pruebas de programación se ejecutaron en el entorno de evaluación de Claude Code, algo que una cuenta de X con muchos seguidores cuestionó el día del lanzamiento. Las cifras independientes de Artificial Analysis siguen siendo sólidas, así que no creo que las pruebas carezcan de fundamento. Simplemente confiaría primero en las independientes.
¿Cómo se compara Kimi K3.1 Pro con Claude, GPT y Gemini?
Todas las cifras siguientes proceden de la página de K3.1 Pro en Artificial Analysis, medidas en la API de cada fabricante, así que permiten una comparación en igualdad de condiciones.
| Modelo | Índice de AA | Precio entrada / salida (por 1M) | Velocidad (tokens/s) | Costo por tarea | Costo de ejecutar el índice | Terminal-Bench 4.0 |
|---|---|---|---|---|---|---|
| Claude Opus 5.5 (Max) | 57.6 | 4 $ / 20 $ | 98.1 | $5.98 | $8,708 | 59.6% |
| Claude Sonnet 5.5 (Max) | 56.0 | 2 $ / 10 $ | 141.3 | $5.46 | $7,260 | 63.6% |
| Kimi K3.1 Pro | 55.1 | 2 $ / 10 $ | 49.7 | $2.11 | $3,117 | 67.2% |
| Claude Fable 5.1 (Max) | 53.4 | 10 $ / 50 $ | 69.8 | $7.63 | $13,129 | 52.0% |
| GPT-6 Astra (Max) | 52.7 | 10 $ / 50 $ | 66.7 | $3.26 | $5,324 | 59.1% |
| Gemini 4 Argon (High) | 52.6 | 2 $ / 10 $ | 79.7 | $1.62 | $2,101 | 57.1% |
| GPT-6.1 Sol (Max) | 51.8 | 2 $ / 10 $ | 65.9 | $0.72 | $1,082 | 56.1% |
| DeepSeek V4.1 Flash 1017 (Max) | 45.1 | 0,30 $ / 1,20 $ | 169.3 | $0.26 | $445 | 33.8% |
| Kimi K3 (Max) | 43.6 | 3 $ / 15 $ | 54.5 | $2.00 | $3,658 | 12.6% |
Hay dos cosas que llaman la atención. Primero, entre los modelos con una puntuación de 55 o más, K3.1 Pro es, con diferencia, el más barato de ejecutar. Segundo, no es el modelo inteligente más barato en términos generales: GPT-6.1 Sol y Gemini 4 Argon se quedan a tres o cuatro puntos por una fracción del costo por tarea. El punto fuerte de K3.1 Pro es «casi al nivel de Claude, por un tercio de la factura de Claude», no «el más barato que funciona».
En cuanto a las sensaciones de uso, quienes lo han probado coinciden en su mayoría en que Opus sigue teniendo una ventaja que las pruebas no reflejan:
"I feel Opus still nails the subtle details better, like in the tractor example below. But I wonder if it matters when you can run Kimi 3x before it costs the same as one Opus?"
"TLDR: Kimi is a good model, especially for visual work, but I still find Opus 5.5 more useful for general-purpose tasks and white-collar work."
Si lo estás comparando específicamente con otros modelos abiertos, mis comparativas de Qwen 3.8 Max frente a K3 y DeepSeek V4 Flash frente a K3 siguen describiendo el panorama más amplio, y la lista de alternativas a Kimi K3 es una buena selección inicial.
¿Cómo es desarrollar sobre la API de Kimi K3.1 Pro?
Desde el lado de la integración, que es en lo que paso mis días, es una API clara con algunas particularidades que conviene tener en cuenta. Los identificadores de modelo son kimi-k3.1-pro y kimi-k3.1-pro-highspeed, y la documentación cubre la transmisión de respuestas, la entrada visual, las llamadas a herramientas, la salida estructurada y una función llamada "Dynamic tool loading".
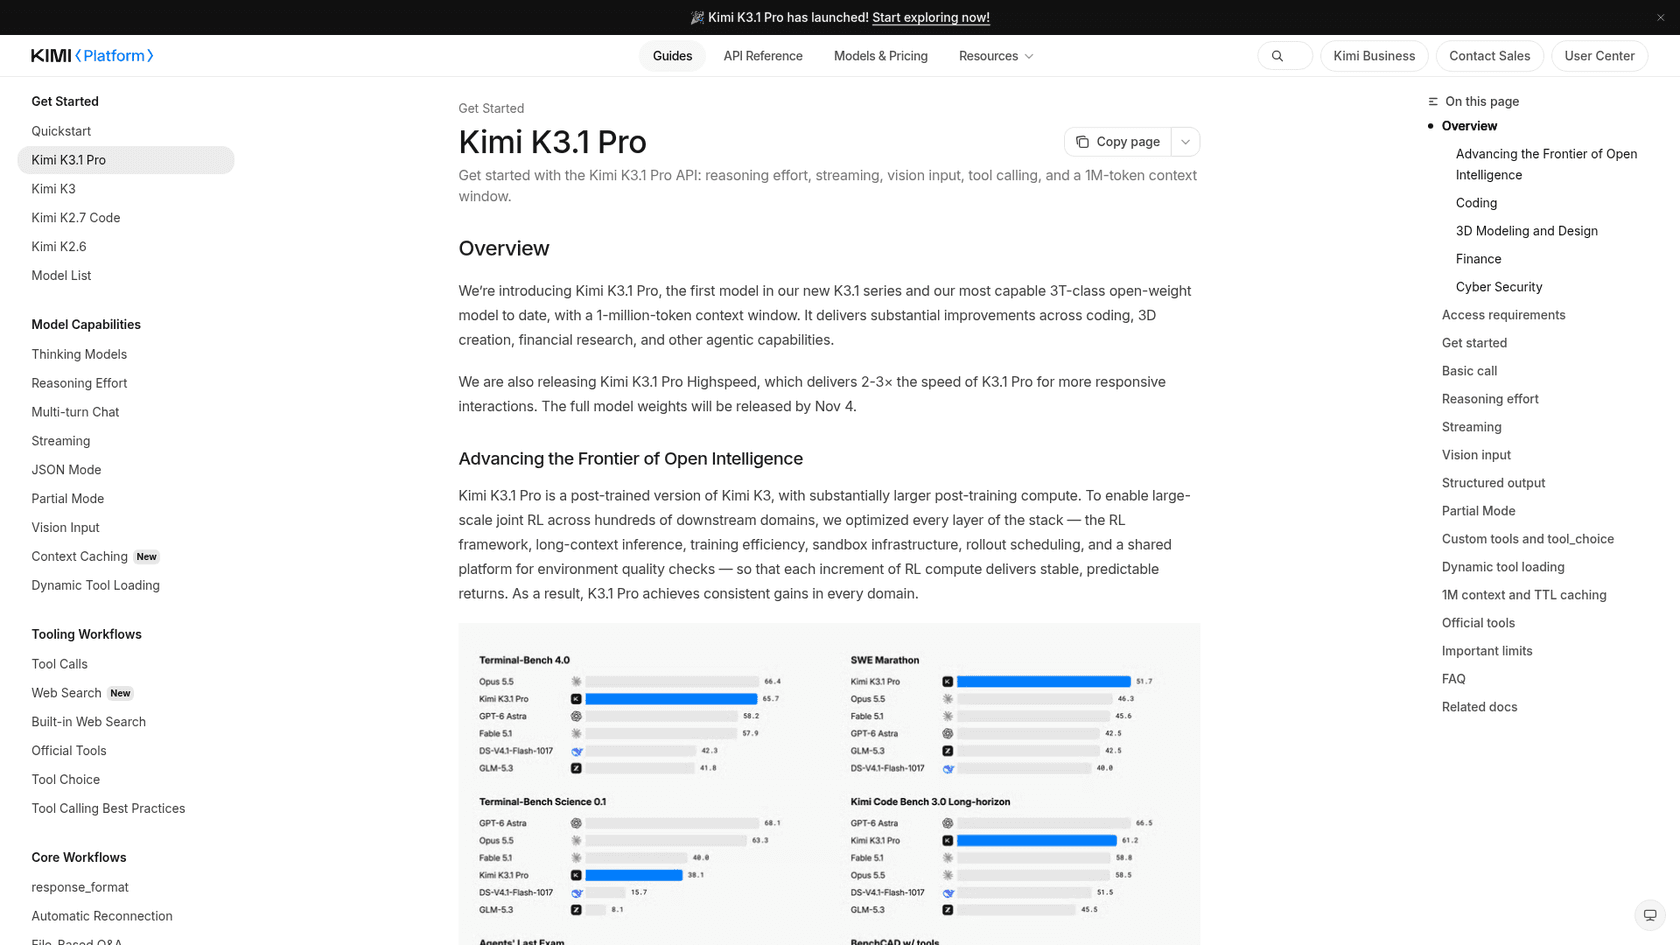
Lo que querría saber antes de escribir una línea de código:
- El acceso se desbloquea tras una recarga de 1 $, y tu límite de solicitudes depende de cuánto hayas recargado en total. En el nivel de 1 $ obtienes
3solicitudes por minuto; necesitas$10acumulados para llegar a100RPM, según la página de límites de solicitudes. - No hay descuento por lotes para K3.1 Pro. La API por lotes de Kimi cuesta el 60 % del precio estándar, pero solo cubre los modelos de la serie K2.
- El razonamiento está siempre activado, y
max_completion_tokenstiene un valor predeterminado de131,072. Prevé respuestas largas en tu presupuesto. - Zero Data Retention está disponible para los clientes de la API, según el artículo de lanzamiento.
- Los modelos K2 se están retirando. Los nuevos usuarios pierden el acceso a K2 a partir del 31 de octubre de 2026, y está previsto retirar todos los modelos K2 para finales de diciembre, así que, si usas Kimi K2.7 Code, tendrás que cambiar de todos modos.
Si lo que buscas principalmente es un modelo capaz con el que crear prototipos por poco dinero, merece la pena echar un vistazo a mi recopilación de API de IA gratuitas antes de recargar saldo en cualquier plataforma.
¿Quién debería usar Kimi K3.1 Pro?
Elígelo si ejecutas tareas largas sin supervisión en las que importa la calidad y nadie está esperando: sesiones de programación con agentes, informes de investigación, trabajo financiero con muchas hojas de cálculo, procesamiento de documentos con contextos enormes. Obtienes una calidad cercana a la de Opus por aproximadamente un tercio del costo de ejecución, sin recargo por contexto largo.
Descártalo si hay una persona esperando cada respuesta. A 50 tokens por segundo, el chat en vivo y los intercambios rápidos al programar se sienten lentos, y Highspeed duplica el precio para solucionarlo. Descártalo también si tu prioridad es el costo: GPT-6.1 Sol y Gemini 4 Argon completan las mismas tareas de las pruebas por menos dinero. Y, si necesitas pesos que puedas ejecutar tú mismo hoy, sigue con K3 hasta que el 4 de noviembre demuestre que Moonshot cumple su promesa.
El factor decisivo es la paciencia. K3.1 Pro está pensado para tareas que pones en marcha y dejas ejecutándose.
¿Debería un equipo de soporte ejecutar su agente de IA sobre Kimi K3.1 Pro?
Esta pregunta surge cada vez que un nuevo modelo encabeza una clasificación, y creo que no es la pregunta por la que hay que empezar. Kimi K3.1 Pro es infraestructura. Para responder un solo ticket con él, todavía tendrías que conectarlo a tu plataforma de soporte, sincronizar tu centro de ayuda y tus tickets anteriores, decidir qué hace por su cuenta y qué deriva a una persona, y ponerlo a prueba antes de que un cliente vea una respuesta. eesel es el empleado que funciona sobre modelos como este.
El problema de velocidad también afecta al soporte más que a la mayoría de los usos. Un cliente en un chat no va a esperar mientras un modelo escribe 35.000 tokens de razonamiento. En soporte, un modelo rápido con una buena recuperación de información suele superar a uno más inteligente pero más lento.
Y las respuestas incorrectas en soporte no suelen venir del modelo. Un ejemplo de las propias llamadas de ventas de eesel: un equipo de soporte de telemática de vehículos que usaba Zendesk vio cómo su bot decía a los clientes "yes, we support your car model" para marcas que no admitían, porque su base de conocimientos decía "we support all models". Ningún salto en una clasificación arregla eso. Lo que lo arregla es frenar las alucinaciones en la capa de conocimiento y simular el agente con tickets reales anteriores antes del lanzamiento, por eso eesel prueba primero cada implementación con los tickets históricos del equipo.
Esa es la capa de la que se encarga el compañero de soporte con IA de eesel. SamCart muestra cómo funciona en la práctica. Utiliza eesel en sus tickets de Freshdesk y en el chat de su sitio web, con un agente independiente para cada canal, y ambos responden a partir de los mismos 280 artículos de su centro de ayuda. En Freshdesk, el agente envía la primera respuesta solo mientras no haya ninguna persona asignada, se aparta en cuanto un compañero se hace cargo del ticket y etiqueta el ticket para su traspaso cuando un vendedor pide hablar con una persona. El espacio de trabajo ahora cuenta con 4 agentes, incluido uno para un segundo producto que SamCart lanzó en 2026.
Si lo que te atrae es el enfoque centrado en agentes y en la terminal de herramientas como Kimi Code, la CLI de eesel lleva eso al soporte. Ejecutas al mismo compañero desde una terminal: eesel activity para revisar lo que hizo, eesel approvals para aprobar o rechazar acciones pendientes, eesel instructions para editar sus reglas permanentes. Los comandos imprimen JSON y los comandos de escritura admiten --dry-run, así que los scripts y los agentes de programación pueden manejarlo de forma segura, y también hay un servidor MCP. Profundizo en ello en mi guía de la CLI de agentes de IA.
Prueba eesel
Si estás buscando un modelo porque quieres que la IA responda en tu plataforma de soporte, ahórrate un paso. El compañero de soporte con IA de eesel se conecta a Freshdesk, Zendesk o Gorgias, aprende de tu centro de ayuda y tus tickets anteriores, y te muestra cómo habría respondido a los tickets del mes pasado antes de tocar uno real.
Prueba eesel gratis en tu propia cola de tickets, o compáralo primero con los otros mejores compañeros de IA. Si todavía estás decidiendo entre contratar una IA o crear una, mi artículo sobre el empleado de IA explica la diferencia.
Preguntas frecuentes
¿Es bueno Kimi K3.1 Pro?
Sí, para el trabajo adecuado. En mi reseña de Kimi K3.1 Pro le doy 3,5 sobre 5: obtiene 55.1 en el Artificial Analysis Intelligence Index, cerca de Claude Opus 5.5, por 2 $/10 $ por millón de tokens. Pierde puntos por la lentitud al generar texto, las respuestas largas y los límites de los planes de Kimi Code. La descripción general de Kimi K3.1 Pro cubre el lanzamiento en detalle.
¿Es Kimi K3.1 Pro mejor que Claude Opus 5.5?
No en términos generales. Opus 5.5 (Max) obtiene 57.6 en Artificial Analysis frente a 55.1, y funciona aproximadamente al doble de velocidad. Kimi K3.1 Pro gana en coste: ejecutó el índice completo de pruebas de rendimiento por 3.117 $ frente a los 8.708 $ de Opus 5.5 (Max). Mi reseña de Claude Opus 5.5 ofrece la otra cara de esa comparación.
¿Cuánto cuesta Kimi K3.1 Pro?
En la API de Kimi cuesta 2 $ por millón de tokens de entrada, 0,20 $ por la entrada en caché y 10 $ por millón de tokens de salida. La versión Highspeed cuesta 4 $ y 20 $. Los planes de la aplicación Kimi van de 19 $ a 199 $ al mes. El desglose completo está en mi guía de precios de Kimi K3.1 Pro.
¿Por qué es tan lento Kimi K3.1 Pro?
Artificial Analysis midió 49.7 tokens de salida por segundo en la API de Kimi, en el puesto 165 de 182, y además escribe razonamientos largos antes de responder. Una tarea promedio de las pruebas de rendimiento tardó unos 17 minutos. Kimi K3.1 Pro Highspeed es 2-3x más rápido al doble de precio. Si la velocidad es lo más importante, Claude Sonnet 5.5 genera 141 tokens por segundo por el mismo precio de lista.
¿Es Kimi K3.1 Pro de código abierto?
Todavía no. Moonshot dice que los pesos completos se publicarán a más tardar el 4 de noviembre de 2026, pero el 27 de octubre no había repositorio en Hugging Face ni licencia. Kimi K3 es el modelo abierto que puedes descargar hoy, y mi lista de agentes de IA de código abierto cubre otras opciones.
¿Vale la pena Kimi K3.1 Pro para programar?
Para trabajos de programación largos y sin supervisión, sí: obtuvo 67,2 % en Terminal-Bench 4.0 en Artificial Analysis y 51.7 en SWE Marathon en las pruebas de Moonshot. Para la programación en pareja en tiempo real, la lentitud al generar texto resulta un obstáculo, y los usuarios de Kimi Code señalan que alcanzan rápido el límite de 5 horas. Compáralo con Claude Code antes de suscribirte.
¿Puedo usar Kimi K3.1 Pro para un agente de IA de atención al cliente?
Puedes, pero el modelo es la parte pequeña del trabajo. Aún necesitas una conexión con la mesa de ayuda, reglas de transferencia y pruebas con tickets anteriores, y a 50 tokens por segundo las respuestas del chat en vivo se sentirían lentas. Un agente de IA para mesas de ayuda listo para usar como eesel se encarga de esa capa por ti, que es como SamCart gestiona las primeras respuestas en Freshdesk.