

Recursive Flint es el modelo de programación más rápido que puedes ejecutar hoy en un portátil, y es gratuito, pero no es el mejor. En un MacBook M4 Pro genera 131 tokens por segundo, aproximadamente 10x el Qwen 3.8 27B denso, mientras que Qwen 3.8 sigue superándolo en cuatro de seis benchmarks de código en el gráfico propio de Recursive, incluido Terminal-Bench 2.1 por 18 puntos.
Mi puntuación es 3,5/5. Elige Flint si quieres un agente de programación sin conexión, con licencia Apache 2.0, que te siga el ritmo, y estás dispuesto a dividir el trabajo en pasos pequeños y explícitos. Descártalo si necesitas el modelo local más fuerte por respuesta, o un bucle de herramientas que nunca falle: en el endpoint gratuito de OpenRouter, el 17,74 % de las llamadas a herramientas da error actualmente.
Si lo que realmente necesitas es un agente que trabaje una cola de soporte y no un código base, un modelo en bruto es la capa equivocada. El compañero de helpdesk con IA de eesel es el empleado que se coloca sobre modelos como este, y tu agente de programación puede manejarlo desde la terminal con la CLI de eesel.
¿Qué es Recursive Flint?
Recursive Flint es un modelo de programación de mezcla de expertos de 40B parámetros que activa unos 2,5B parámetros por token, lanzado el 21 de octubre de 2026 por Recursive. Entra texto, sale texto, con razonamiento siempre activo y llamadas a herramientas, y está construido para un único trabajo: ejecutar un agente de programación que lee un repositorio, edita archivos y corre pruebas. Piensa en él como el motor bajo una CLI de programación agéntica, no como una aplicación de chat.
Recursive es el laboratorio dirigido por Richard Socher, que también es CEO de You.com. Su objetivo declarado es una «superinteligencia que se automejora de forma recursiva», y Flint es la primera prueba pública del sistema pensado para llegar ahí: la Eureka Machine, un bucle de investigación automatizado que propone ideas, las implementa, las prueba y elige qué probar a continuación. Recursive dice que un pequeño equipo de personas y agentes construyó Flint desde cero en menos de cuatro meses, con la Eureka Machine trabajando en los datos, las recetas de entrenamiento, la cuantización y los kernels.
Yo construyo las integraciones y las APIs detrás de los agentes de eesel, lo que significa que paso la mayor parte de la semana conectando modelos a bucles de herramientas y viendo dónde se rompen. Esa es la lente de esta reseña. Leí la ficha del modelo, la documentación de Recursive, el repositorio del motor rec y las estadísticas en vivo de OpenRouter, y juzgué a Flint por lo que un modelo de programación realmente tiene que hacer: terminar una tarea de varios pasos sin que tengas que vigilarlo.
Estas son las especificaciones que importan, directamente de la ficha del modelo:
| Especificación | Recursive Flint |
|---|---|
| Parámetros totales | 39,8B |
| Activos por token | ~2,5B (unos 2,2B sin la cabeza de salida) |
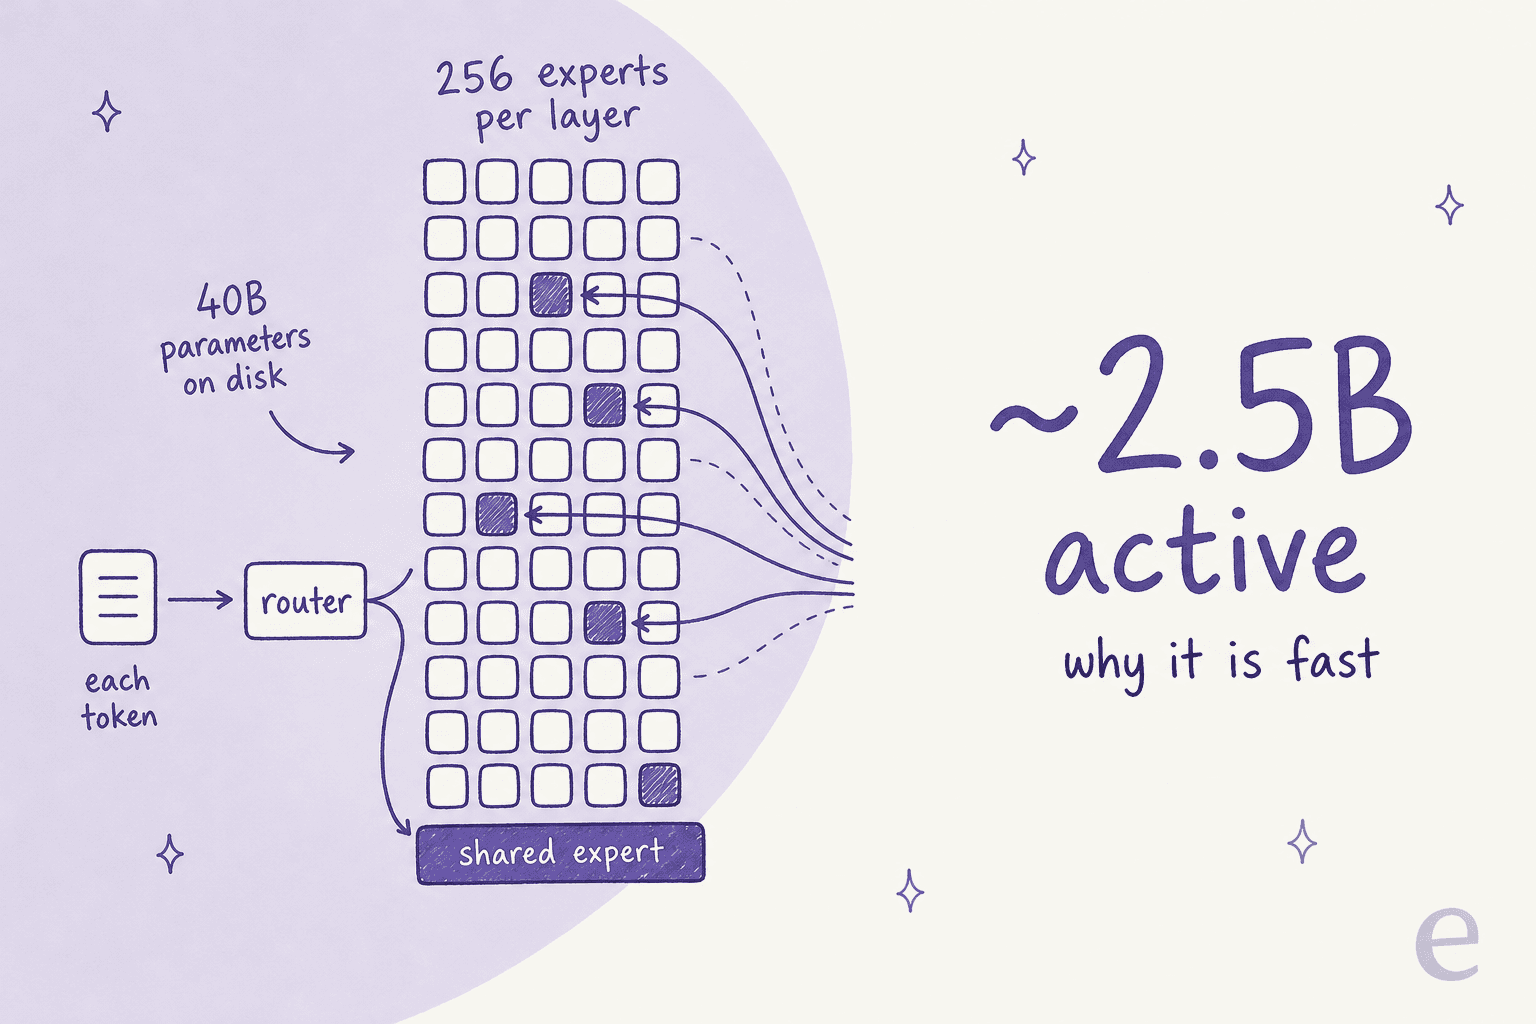
| Expertos | 256 por capa MoE, 6 enrutados por token, más 1 compartido |
| Capas | 49 (2 densas, 47 MoE; 35 de ventana deslizante, 14 de atención completa) |
| Contexto | 262.144 tokens documentados; hasta 512k admitidos, 256k recomendados |
| Salida máxima (alojado) | 65.536 tokens |
| Fecha de corte de conocimiento | Junio de 2026 |
| Licencia | Apache 2.0 |
| Entrada / salida | Texto / texto |
¿Cómo corre tan rápido un modelo de 40B en un portátil?
Corre rápido porque casi todo él permanece inactivo. Cada token pasa por un enrutador que elige 6 de los 256 expertos en cada capa, más un experto compartido que siempre se activa, así que el chip solo lee el equivalente a unos 2,5B parámetros de pesos por token. Un modelo denso de 27B lee los 27B en cada token.
Lo interesante es que Recursive no se detuvo en la arquitectura. Según el post de lanzamiento, la Eureka Machine también buscó recetas de cuantización y, contra la práctica habitual, comprimió la capa de salida a 4 bits. Con solo 2,5B parámetros activos, esa capa de salida es una parte grande de los pesos leídos por token, así que reducirla compra velocidad real. El modelo NVFP4 final queda a menos de 0,7 puntos del de 16 bits en los benchmarks de Recursive, y el listado de LM Studio muestra la diferencia por prueba: 53,7 frente a 54,9 en Terminal-Bench, 74,1 frente a 74,2 en SWE-bench Verified.
Después escribió kernels propios, incluido un «megakernel» de Metal que fusiona todo el paso de decodificación en chips M4 y M5. Por eso Recursive distribuye su propio motor, rec, en lugar de remitirte a llama.cpp. Más sobre eso abajo.
¿Qué tan rápido es Recursive Flint en la práctica?
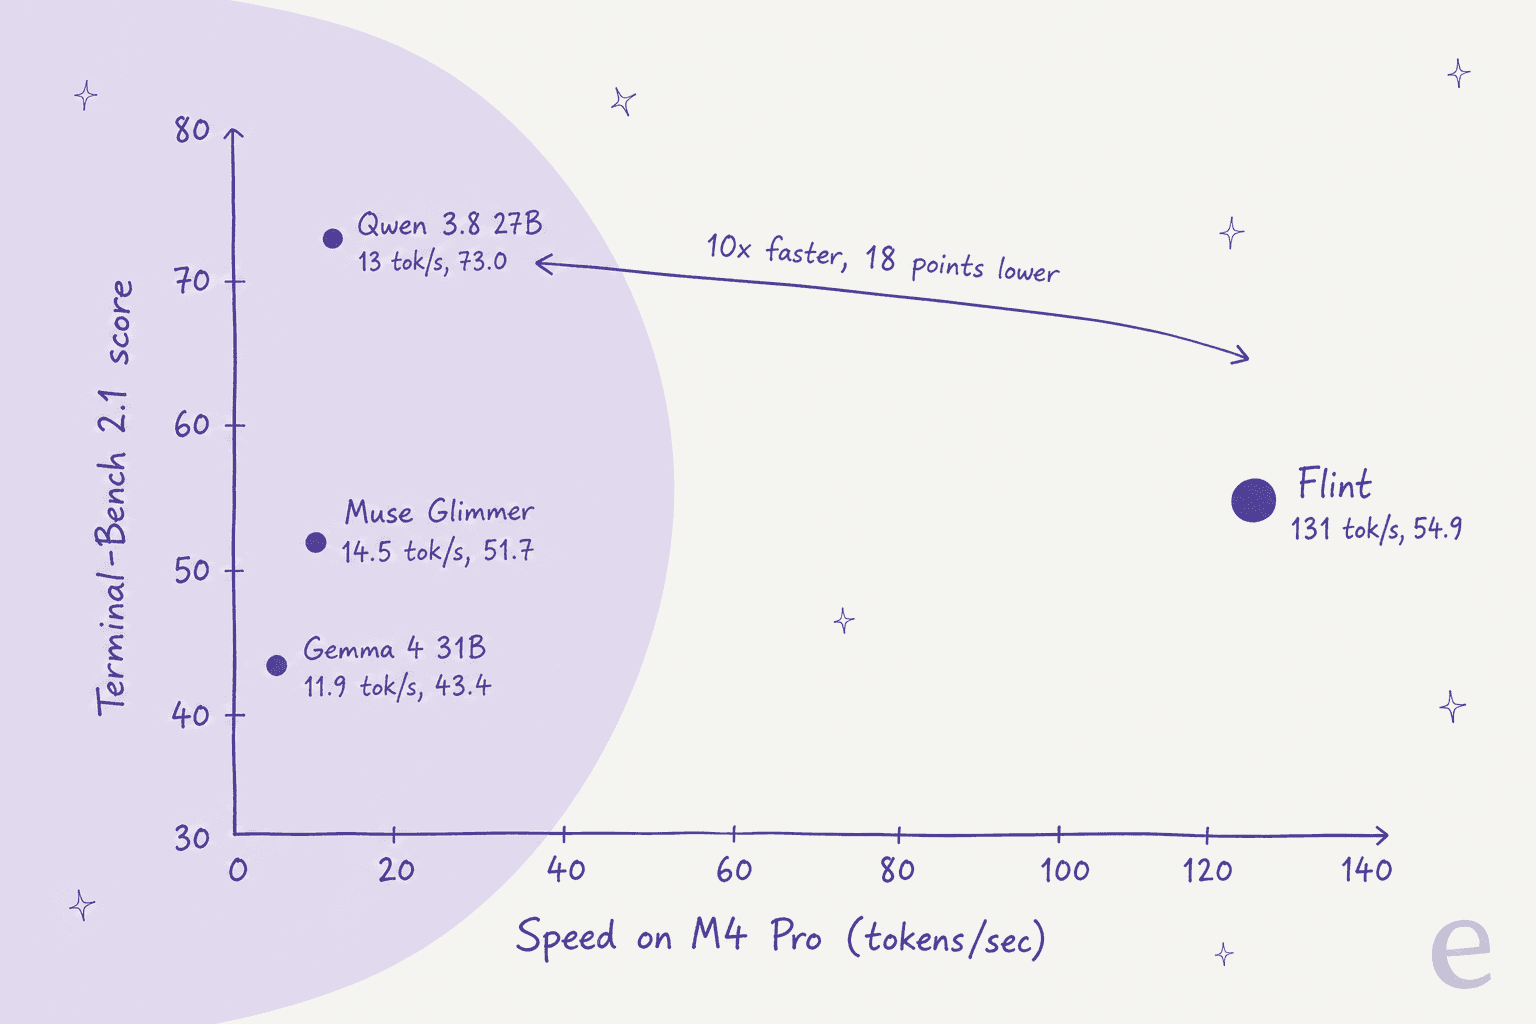
Muy. En el gráfico propio de Recursive para un Apple M4 Pro con 48 GB, Flint corre a 131,22 tokens/s con MLX en un contexto de 1K tokens, y 87,98 con llama.cpp. Los pares dispersos más cercanos son Laguna XS 2.1 con 68,84 y Qwen 3.6 35B-A3B con 65,55. Los modelos densos con puntuaciones de código comparables apenas se mueven: Muse Glimmer con 14,54, Qwen 3.8 27B con 13,01, Gemma 4 31B con 11,92.

Las cifras de contexto largo son las que me convencen de que esto no es un truco de prompts cortos. Promediando contextos de hasta 128K, Flint mantiene 68,89 tokens/s en el M4 Pro, mientras que Qwen 3.8 27B cae a 10,11. Un agente de programación pasa la mayor parte de su vida en lo profundo de un contexto largo (contenido de archivos, salida de pruebas, su propio razonamiento previo), así que el promedio importa más que la cifra destacada. En la RTX Spark de NVIDIA, la versión NVFP4 alcanza 155,82 tokens/s con contexto corto y 101,95 de media.
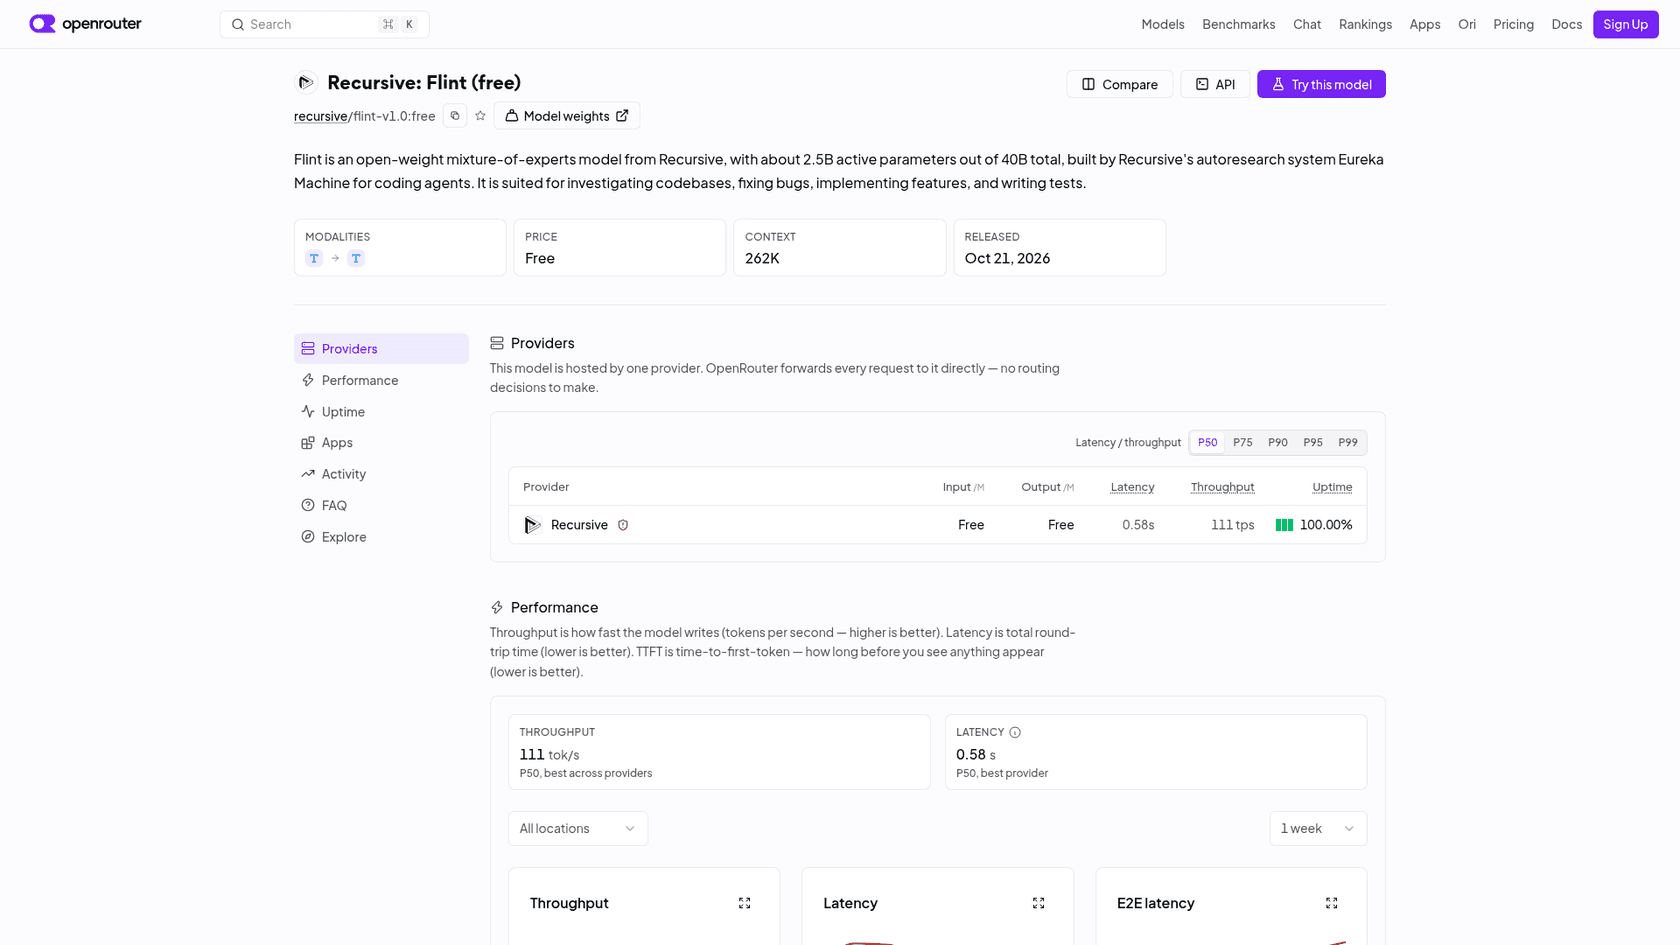
Alojado también es rápido. Las estadísticas en vivo de OpenRouter muestran un rendimiento P50 de 111 tokens/s y 0,58 s de latencia desde el único endpoint de proveedor de Recursive.
Dos salvedades. Son mediciones de Recursive, con el prefill excluido, así que el tiempo hasta el primer token con un prompt grande se sentirá más lento de lo que sugieren las barras. Y la velocidad solo aparece si usas un runtime que soporte bien Flint; la página de resolución de problemas dedica una entrada entera al offload a CPU y al intercambio de memoria.
¿Cómo puntúa Flint frente a Qwen 3.8, Gemma 4 y Muse Glimmer?
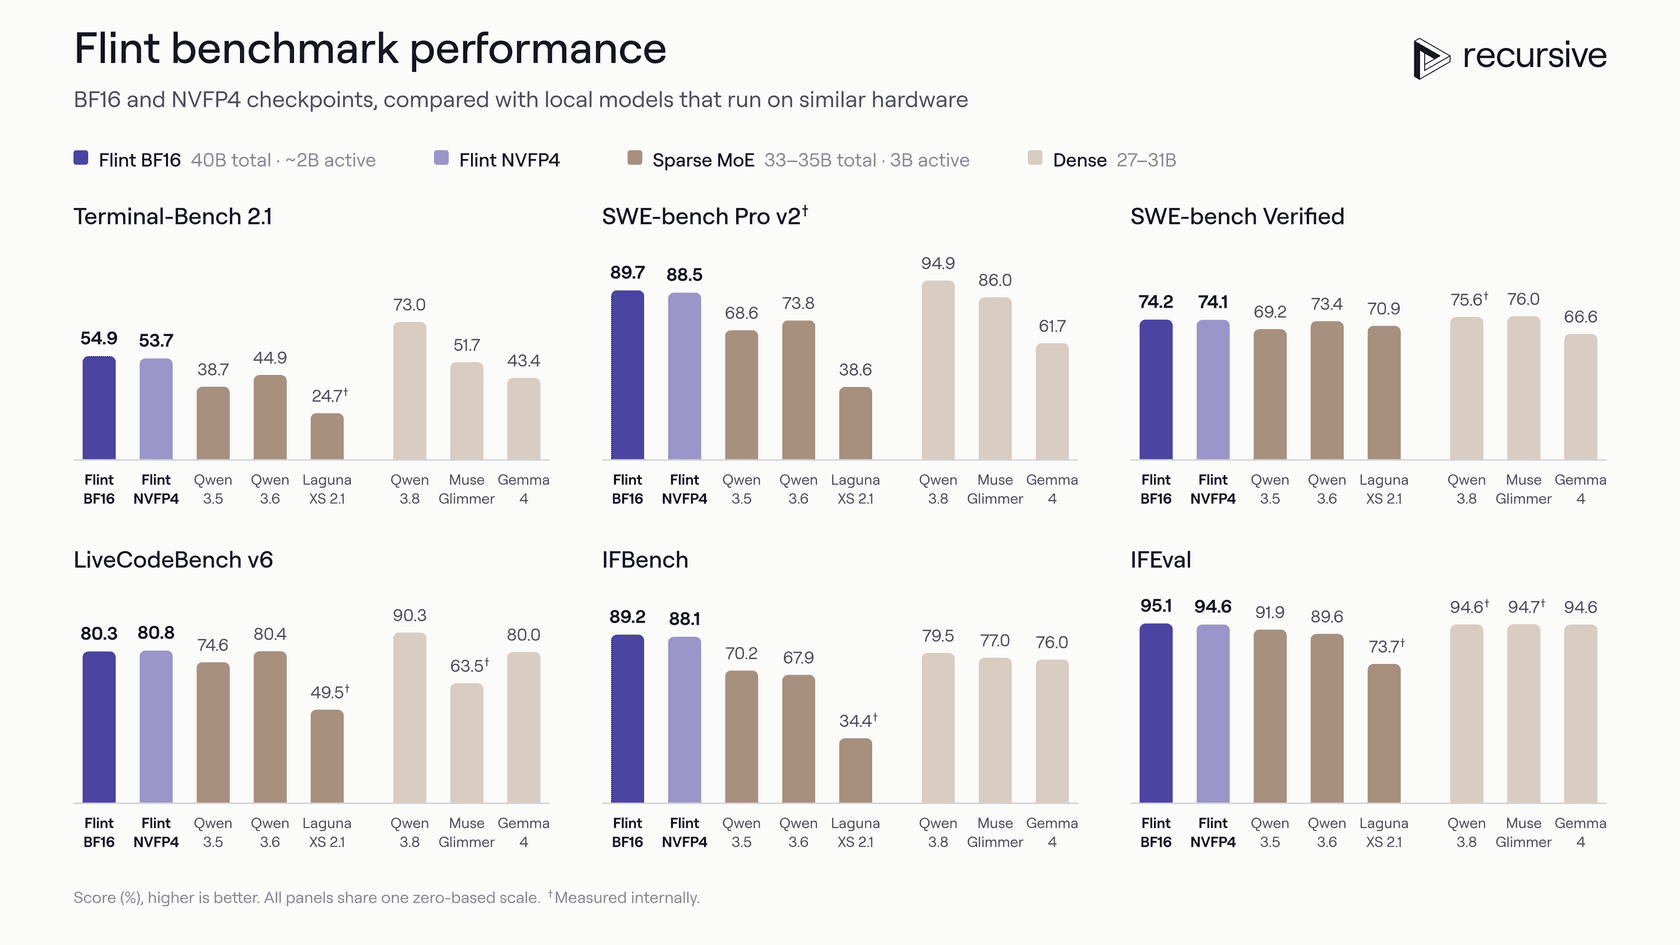
Aquí es donde el texto de lanzamiento y el gráfico se separan. Recursive dice que Flint «rivaliza con el rendimiento de programación de modelos densos de 25 a 40 mil millones de parámetros». En su propio gráfico, queda por detrás del más fuerte de ellos, Qwen 3.8 27B, en la mayoría de las pruebas que importan para la programación agéntica.
| Benchmark | Flint BF16 | Qwen 3.8 27B (denso) | Muse Glimmer (denso) | Gemma 4 (denso) | Qwen 3.6 35B-A3B (MoE) |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 73.0 | 51.7 | 43.4 | 44.9 |
| SWE-bench Pro v2 | 89.7 | 94.9 | 86.0 | 61.7 | 73.8 |
| SWE-bench Verified | 74.2 | 75.6 | 76.0 | 66.6 | 73.4 |
| LiveCodeBench v6 | 80.3 | 90.3 | 63.5 | 80.0 | 80.4 |
| IFBench | 89.2 | 79.5 | 77.0 | 76.0 | 67.9 |
| IFEval | 95.1 | 94.6 | 94.7 | 94.6 | 89.6 |
Leído con honestidad, destacan tres cosas:
- Frente a otros modelos MoE de su tamaño, Flint gana con claridad. Supera a Qwen 3.6 35B-A3B en cinco de seis filas (LiveCodeBench es un empate de 0,1 puntos), y por
10puntos en Terminal-Bench. Es la afirmación con la que Recursive abre, y se sostiene. - Frente a Qwen 3.8 27B, pierde cuatro de seis. La brecha de
18,1puntos en Terminal-Bench 2.1 es la que más pesaría, ya que esa prueba es la más cercana a «maneja una shell hasta terminar la tarea». - Su punto fuerte es seguir instrucciones. El
89,2en IFBench le saca casi10puntos a todos los modelos densos del gráfico, lo que encaja con el consejo de la documentación de darle instrucciones explícitas, paso a paso.
Recursive es transparente con la metodología, lo cual agradezco. Según su ficha del modelo, la ejecución de Terminal-Bench cuenta como fallos las soluciones encontradas mediante recuperación web, y la ficha señala que las puntuaciones de otros modelos reportadas por sus desarrolladores pueden no aplicar el mismo ajuste. Así que parte de esa brecha podría deberse a un evaluador más estricto. Parte, sin embargo, es simplemente un modelo denso de 27B pensando más por token.
Ese es el verdadero intercambio. Flint es 10x más rápido para una respuesta algo peor. Para un bucle de programación interactivo, donde de todos modos lees cada diff, muchas veces aceptaría ese trato. Para un agente desatendido durante la noche, no.
¿Dónde se queda corto Flint?
Los límites son en su mayoría los que la propia Recursive documenta, lo cual es buena señal sobre el laboratorio, aunque no sobre el modelo.
Necesita una correa más corta que los modelos de frontera. El post de lanzamiento lo dice claramente: «puede necesitar más orientación que los modelos de programación cerrados más grandes a los que estás acostumbrado», y recomienda dividir el trabajo en subtareas más pequeñas con instrucciones explícitas. Si estás acostumbrado a darle a Claude Code o a Cursor un ticket vago y marcharte, espera más ida y vuelta.
Las llamadas a herramientas fallan más de lo que querrías. OpenRouter reporta una tasa de error del 17,74 % en llamadas a herramientas para el endpoint gratuito. En un bucle de agente de 30 pasos, eso son varias llamadas rotas por tarea que tu entorno debe absorber. La documentación apunta a plantillas de chat y parsers que no coinciden como causa habitual, y la ficha del modelo te pide conservar reasoning_content en el historial, así que parte de esto se puede arreglar de tu lado. Aun así, es la primera cifra que vigilaría.
El razonamiento largo se come el presupuesto. El razonamiento está siempre activo. La ficha del modelo recomienda al menos 32.768 tokens de salida para problemas difíciles, y la guía de OpenCode sugiere 65.536. Si tu entorno limita la salida a menos, las respuestas terminan con finish_reason: length a mitad del razonamiento, el mismo problema de presupuesto que explico en la ventana de contexto de Claude Code.
El camino rápido es solo para Mac, y no para cualquier Mac. rec necesita un M4 Pro, M4 Max, M5 Pro o M5 Max con al menos 48 GB de memoria unificada, según su README. Una máquina de 24 GB puede cargar el GGUF más pequeño con LM Studio, pero el propio listado de LM Studio advierte que no se garantiza que quepa el contexto completo de 262K.
Todavía no hay una API de pago con SLA. El acceso directo a la API de Recursive está «limitado a socios seleccionados», según la página de versiones. Los niveles gratuitos de OpenRouter y OpenCode están sujetos a capacidad y límites de uso. Está bien para una prueba, no para nada que le cobres a un cliente.
La reacción de la comunidad coincide con el gráfico. El hilo de lanzamiento en Hacker News quedó impresionado por la velocidad de un modelo entrenado desde cero, con una dosis de «demuéstramelo»:
"Pretty amazing for being trained from scratch, to have ~Qwen 3.8 27b quality with such an increase in tok/s performance. Excited to try it out and see how snappy it is."

"not as good as qwen3.8 yet, even the chart says good numbers"
Ambos tienen razón. Yo lo pondría entre los dos: lo bastante cerca de Qwen 3.8 como para que la velocidad decida en el trabajo interactivo, no lo bastante cerca como para que decida en todo.
¿Cómo se ejecuta Recursive Flint?
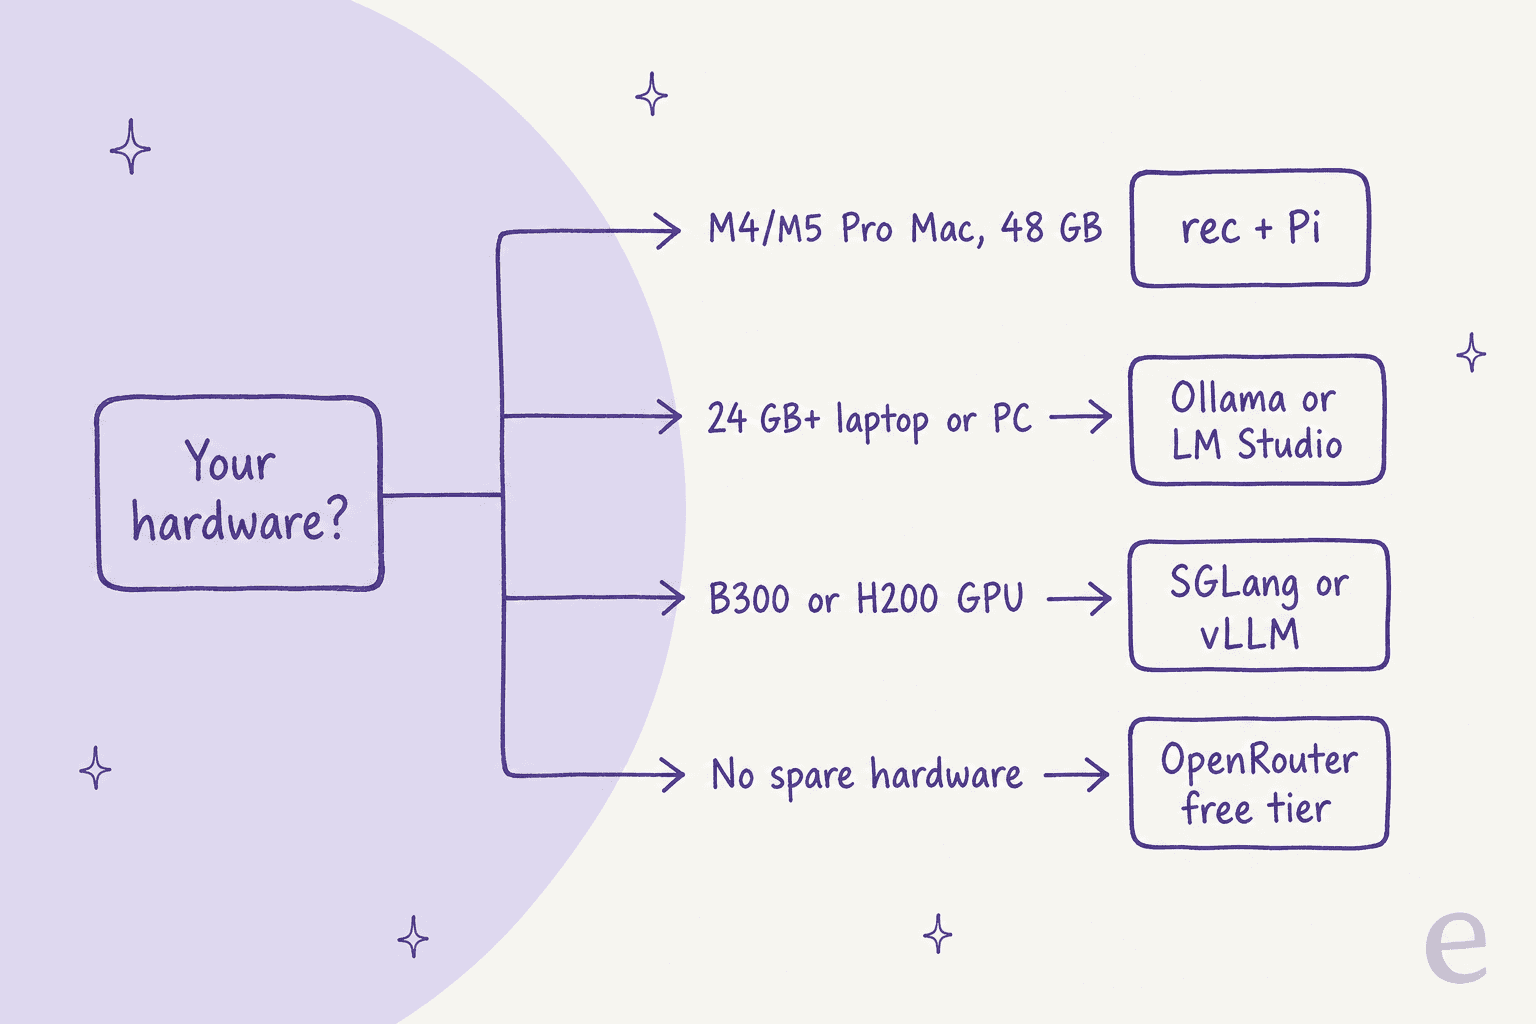
Tienes cuatro rutas, y tu hardware elige una por ti.
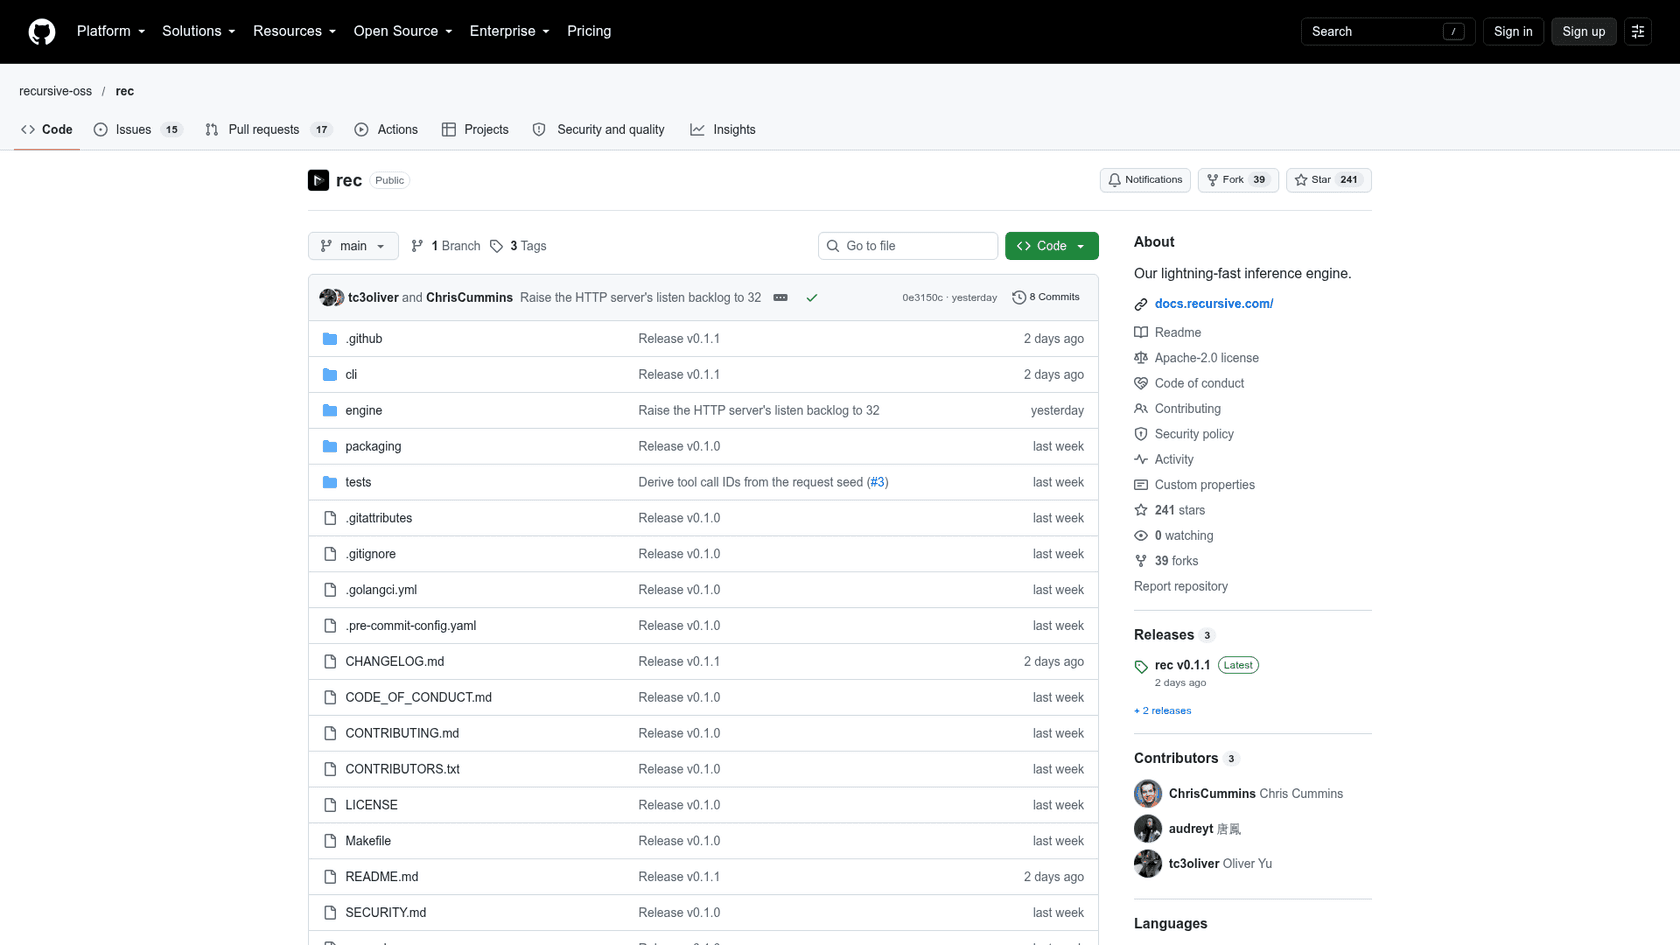
1. Un Mac compatible: usa rec. Este es el motor propio de Recursive, y su README afirma de 1,4 a 2,6x el rendimiento de llama.cpp en un M4 Pro. Instálalo con un solo comando curl y luego ejecuta rec launch pi desde la carpeta de tu proyecto. Descarga el modelo (unos 30 GB de disco) y el entorno Pi, e inicia un servidor local que habla tanto APIs compatibles con OpenAI como con Anthropic. Recursive dice que Flint rinde mejor emparejado con Pi; rec launch opencode es la alternativa. Un inconveniente: rec está hecho para una sola sesión, así que ejecutar varios agentes a la vez requiere otro runtime.
2. Cualquier portátil o PC decente: Ollama o LM Studio. ollama run flint:40b-a2b-qat-int4 descarga la versión empaquetada de 4 bits de Recursive, y ollama launch opencode, pi, codex o vscode la conecta a un entorno, según la guía de Ollama. LM Studio tiene un GGUF de 24,20 GB con un mínimo de 24 GB de RAM. Espera velocidades más cercanas a las barras de llama.cpp que a las de MLX.
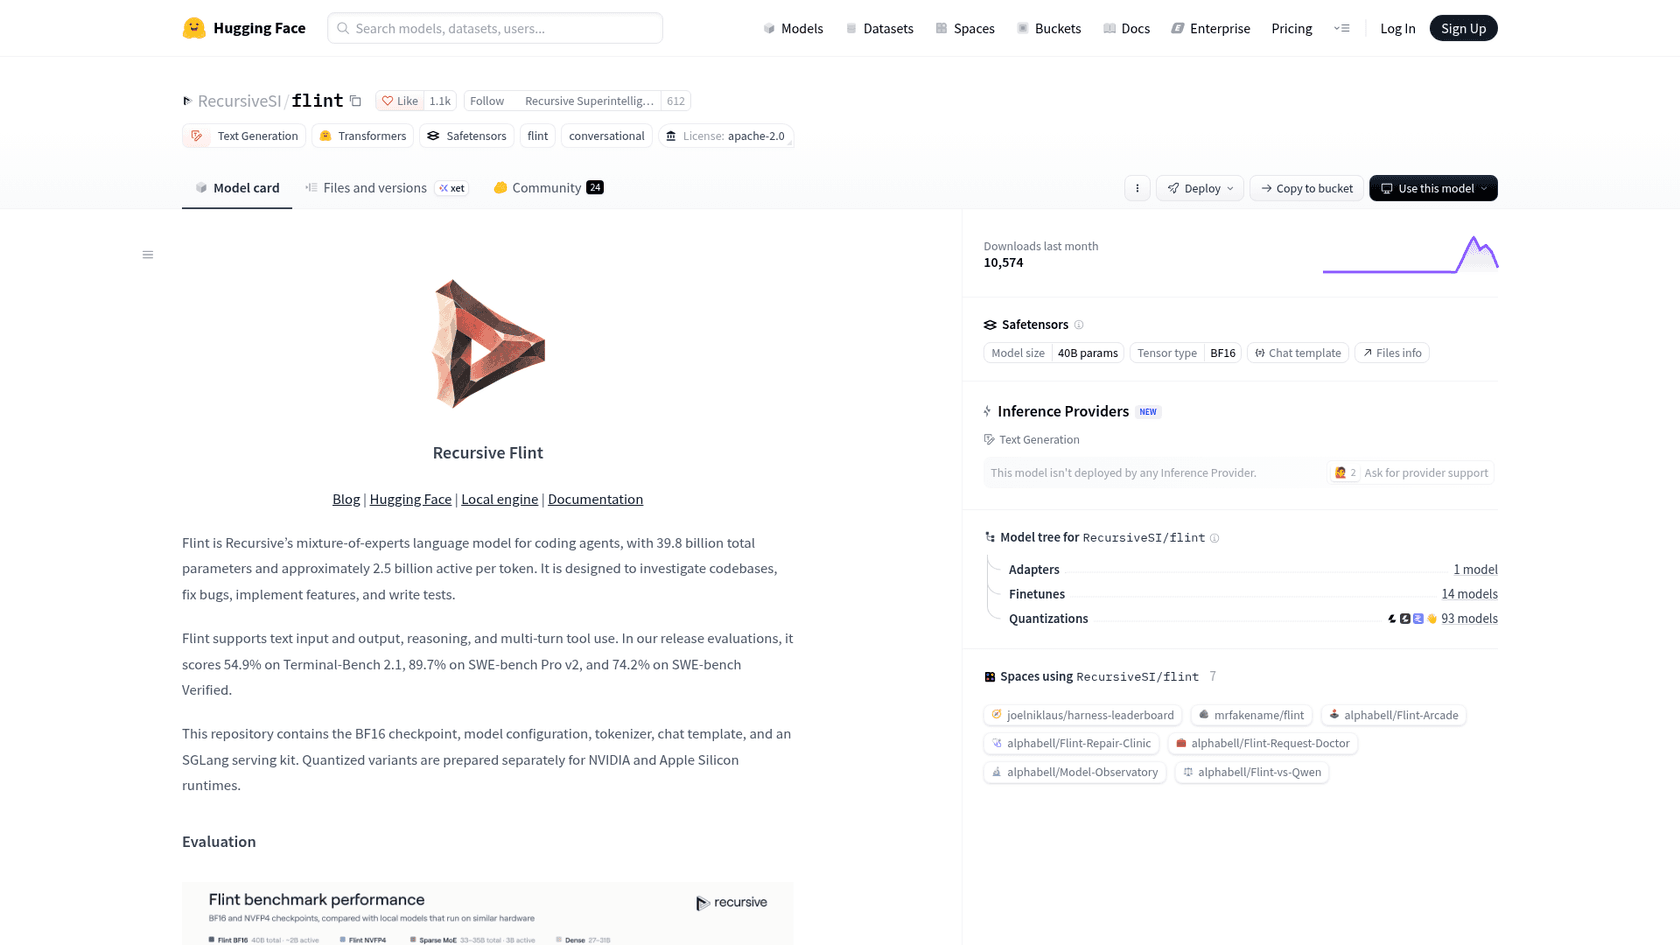
3. Un servidor con GPU: SGLang o vLLM. El repositorio de Hugging Face contiene el checkpoint BF16 de unos 80 GB más un kit de servicio SGLang que ejecuta una réplica en una sola B300 o H200. El repositorio ya acumula 93 cuantizaciones de la comunidad y 14 finetunes, así que hay mucho donde elegir si las versiones de Recursive no encajan con tu stack.
4. Sin hardware libre: los niveles gratuitos alojados. OpenRouter lista recursive/flint-v1.0:free a coste cero, y el selector de modelos de OpenCode tiene Flint-40B en su nivel gratuito. Las aplicaciones más activas en la página de OpenRouter son agentes de programación: Kilo Code ha pasado 32,9B tokens en una semana, Cline 12,2B. Si solo quieres ver si el estilo de Flint te va, esta es la prueba de cinco minutos.
Sea cual sea la ruta, la primera tarea que sugiere Recursive es buena: abre un repositorio pequeño que conozcas, pídele a Flint que explique una función, añade una prueba y luego arregla lo que la prueba deje al descubierto. Revisa el diff después de cada paso.
¿Cuánto cuesta Recursive Flint?
Nada, en términos de licencia. Los pesos son Apache 2.0, gratuitos para uso comercial, y las dos rutas alojadas son gratuitas hoy. El coste real es el hardware y la electricidad, y ahí es donde Flint ahorra dinero sin hacer ruido: un modelo que necesita un Mac de 48 GB en lugar de un rack de GPU, y que corre a 10x la velocidad de sus pares densos en ese Mac, hace más trabajo por hora de una máquina que ya tienes.
| Ruta | Precio | Límites |
|---|---|---|
| Pesos en Hugging Face | Gratis (Apache 2.0) | ~80 GB BF16; versiones cuantizadas para Mac y NVIDIA |
| rec en un Mac | Gratis | M4/M5 Pro o Max, 48 GB+, sesión única |
| Ollama / LM Studio | Gratis | 24 GB de RAM mínimo para el GGUF más pequeño |
OpenRouter flint-v1.0:free | $0 entrada, $0 salida | Un proveedor, se aplican límites de capacidad y de uso |
| Nivel gratuito de OpenCode | $0 | Se aplican límites de capacidad y de uso |
| API directa de Recursive | No pública | Solo socios seleccionados |
Compáralo con los modelos de frontera alojados, donde una sesión larga de programación agéntica puede costar dólares por tarea. Mi desglose de los precios de Kimi K3.1 Pro sitúa su coste por tarea en unos $2,11. Si ejecutas decenas de tareas pequeñas y bien acotadas al día, un modelo local gratuito que sea suficientemente bueno cambia las cuentas rápido.
¿Quién debería usar Recursive Flint y quién debería descartarlo?
Este es mi veredicto, y el factor decisivo es cuánto del pensamiento estás dispuesto a hacer tú mismo.
Usa Flint si:
- Quieres un agente de programación que funcione sin conexión y mantenga tu código en tu máquina, y tienes un Mac M4 o M5 Pro/Max de 48 GB.
- Trabajas de forma interactiva, leyendo cada diff, y valoras un modelo que responde en segundos más que uno que responde algo mejor en un minuto.
- Estás construyendo sobre pesos abiertos y necesitas una licencia comercialmente permisiva para hacer finetuning o redistribuir, la misma razón por la que los equipos recurren a los agentes de IA de código abierto.
Descártalo, por ahora, si:
- Quieres el modelo local más fuerte por respuesta. Qwen 3.8 de 27B denso sigue ganando en la mayoría de las pruebas de código, a una décima parte de la velocidad; mi lista de alternativas a Qwen cubre al resto de rivales de esa familia.
- Ejecutas agentes largos y desatendidos donde una llamada a herramienta rota te cuesta una ejecución entera.
- Necesitas una API de pago con soporte y SLA. Eso todavía no existe, así que una herramienta alojada como GitHub Copilot o Windsurf es la compra más segura.
Si estás comparando Flint con opciones alojadas, mi reseña de Kimi K3.1 Pro y mi reseña de DeepSeek V4 Flash cubren las alternativas cercanas, y las herramientas de asistentes de programación con IA cubren los entornos en los que las ejecutarías.
Para otros modelos abiertos que vale la pena mirar este mes, consulta Nemotron 3.5 Bolt, LFM3 y Nanbeige 4.3.
La historia más grande es el laboratorio, no el modelo. Un modelo de 40B construido desde cero en menos de cuatro meses, con un sistema automatizado haciendo gran parte de la investigación, es la afirmación a seguir. La apuesta de Recursive es que cada modelo convierte a la Eureka Machine en mejor investigadora. Si Flint 2 cierra la brecha con Qwen a la misma velocidad, esta reseña será mucho más positiva.
Qué significa Flint si diriges un equipo de soporte
Flint es infraestructura: un modelo sobre el que corre un agente de programación. Incluso elegir un modelo para soporte es una cuestión aparte, que cubro en mi guía de LLM para atención al cliente. Si tu problema es una cola de soporte y no un código base, el modelo nunca fue la parte difícil. Lo difícil es todo lo que lo rodea: conectarse a Zendesk o Freshdesk, aprender de tus tickets anteriores, saber cuándo derivar y demostrar que no dará una respuesta equivocada con total seguridad antes de que la vea un cliente. eesel lleva años poniendo agentes de IA en colas de soporte reales, y la lección que más veo reaprenderse es que cada despliegue tiene que simularse con tickets históricos antes de salir en vivo.
Eso es lo que son los compañeros de IA de eesel, y por eso dirigiría a un responsable de soporte hacia ellos antes que a cualquier kit de agentes de IA: empleados listos para trabajar en una tarea definida, no un modelo alrededor del cual montas un producto. El compañero de helpdesk con IA es el indicado para soporte.
SE Ranking, por ejemplo, ejecuta tres agentes de eesel en tres conexiones de Zendesk, una por producto, y gestionó 4.650 conversaciones en un mes, incluidos unos 2.100 chats en vivo respondidos primero por eesel. SamCart ejecuta un agente sobre tickets de Freshdesk y otro en el chat de su sitio web, respondiendo a partir de 280 artículos del centro de ayuda.
Y aquí es donde se encuentran los dos mundos. eesel tiene una CLI, así que el mismo agente de programación que ejecutarías con Flint, Claude Code o Codex puede operar tu compañero de soporte desde una terminal: eesel activity para leer lo que el agente hizo en cada ticket, eesel instructions para cambiar sus reglas permanentes, eesel approvals para autorizar las acciones que está esperando. Cada comando imprime JSON, y --dry-run muestra la llamada exacta que haría una escritura antes de enviarla. La documentación llega a decirles a los agentes de IA que usen la CLI en lugar de hacer clic en el panel. Si te interesa cómo se compara esto con construirlo por tu cuenta, escribí por separado sobre las CLI de agentes de IA y la ruta del servidor MCP.
Prueba eesel
¿Quieres una IA para tu helpdesk sin construirla sobre un modelo en bruto? El compañero de helpdesk de eesel se conecta en minutos a Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y tu centro de ayuda, y se prueba con ellos antes de responder a nadie. Cada acción aparece en un registro de actividad que puedes leer en el panel o consultar desde la CLI. Empezar es gratis, sin tarjeta.
