

¿Qué es Reflection AI Beam?
Beam es el primer modelo de Reflection AI, un laboratorio que dos ex investigadores de Google DeepMind fundaron en 2024. Por dentro es un modelo de mezcla de expertos (MoE) dispersa, con 501 mil millones de parámetros en total, 23 mil millones activos en cada token. El objetivo del entrenamiento fue el trabajo de programación y razonamiento, con cargas de trabajo de agentes además.
Eso lo coloca también en el mismo carril que Kimi K3, Qwen3.8 Max y DeepSeek V4 Flash.
También está junto a la otra apuesta open-weight estadounidense de este año, Inkling.
Me dedico a construir agentes de IA, así que suelo leer un anuncio de lanzamiento como la ficha técnica de un coche antes de la prueba de conducción: los números que importan son los que acaban en tu factura y en tus registros de latencia. Con Beam, lo interesante de los números es sobre todo cómo se obtuvieron:
- Preentrenamiento:
23.8Ttokens, ejecutado de principio a fin en menos de cuatro semanas con6,144GPUs NVIDIA GB300, según el anuncio de lanzamiento de Reflection. - Aprendizaje por refuerzo:
10.5KGPUs GB300 durante cuatro semanas, generando más de100 millionde rollouts en casi un millón de entornos de entrenamiento. - Arquitectura:
52capas, atención local y global intercaladas y expertos enrutados de grano fino con una utilización casi uniforme (el experto más ocupado funciona a solo1.04xla carga media). - Entrada: solo texto. La API no admite entradas de imagen, audio ni archivos, según la documentación de compatibilidad con OpenAI.
- Licencia: Apache 2.0, prometida "este mes" junto con versiones cuantizadas FP8 y NVFP4, según el hilo de lanzamiento de Reflection.
El lanzamiento recibió mucha atención. La publicación oficial en X superó los 8,492 likes, mientras que el hilo de Hacker News alcanzó 549 puntos y 174 comentarios en sus primeros días.
Qué se puede usar hoy frente a lo que se anunció
La mayor parte de la cobertura del lanzamiento se salta esta parte, y es una pena, porque decide si Beam entra siquiera en tus planes de este mes. El anuncio describe el modelo que Reflection entrenó, y la documentación para desarrolladores describe el modelo al que realmente puedes llamar. Por ahora, no son lo mismo.
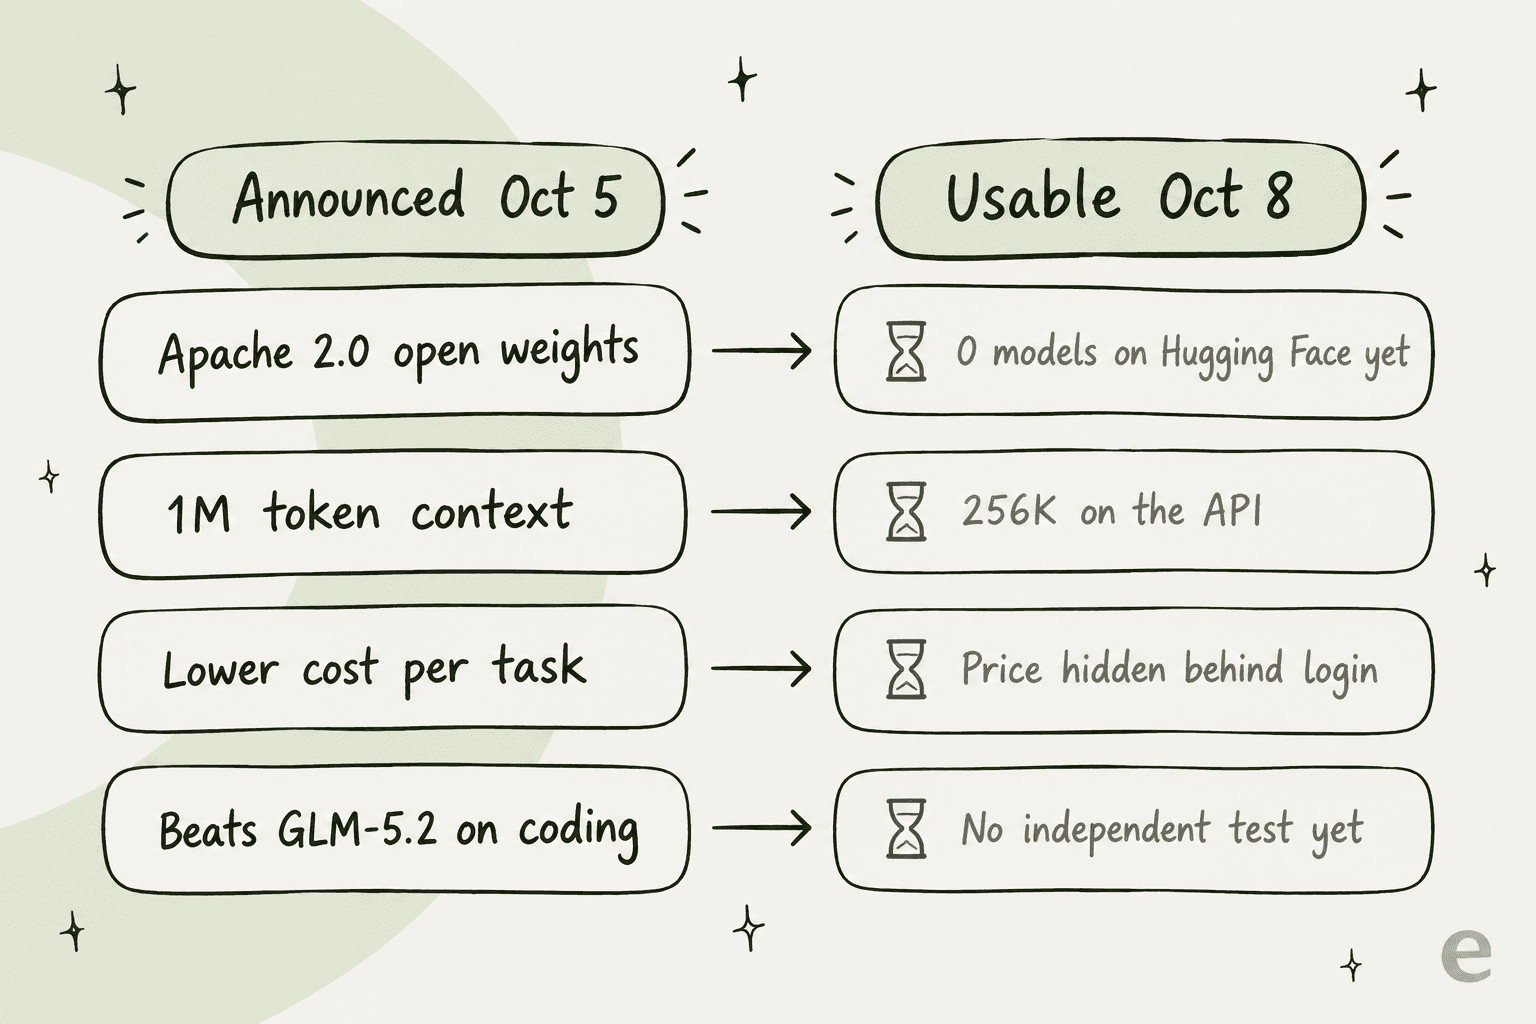
| Lo que dice el lanzamiento | Lo que dicen la API y la documentación (8 oct. 2026) | |
|---|---|---|
| Pesos | Apache 2.0 "este mes" | La organización de Hugging Face de Reflection tiene 0 modelos |
| Ventana de contexto | Contexto efectivo ampliado a 1M tokens | 256K de contexto, 128K de salida máxima, "may change during beta" (Models) |
| Acceso | Acceso anticipado para "a select group of users" | Lista de espera; claves solo cuando se habilita el acceso (Authentication) |
| Precio | "Lower cost" gracias a la eficiencia | Sin tarifa pública; la página de precios está tras el inicio de sesión |
| Límites de uso | No se mencionan | Límites por organización y una cuota diaria de tokens, sin cifras publicadas (Rate limits) |
| Razonamiento | Esfuerzo controlable | Siempre activo, cinco niveles de low a max, por defecto medium (Reasoning) |
| Fecha de corte de conocimiento | No indicada | 30 de junio de 2026 |
La ventana de contexto es la brecha que más señalaría. Si tu plan es un flujo de documentos largos o repositorios enteros construido en torno a "1M tokens", la API beta de hoy te limita a una cuarta parte. No lo llamaría una promesa rota, ya que la capacidad de entrenamiento y los límites de servicio son cosas distintas, pero sí cambia lo que puedes construir en octubre.
El usuario de Hacker News adrian_b explicó la fecha límite sin rodeos:
"They claim that they will release the model as open weights later this month. That means that they have the 31th of October as the deadline to make true their claims."

Cómo funciona Beam: 23B trabajando, 501B almacenados
El diseño MoE es prácticamente toda la historia de Beam, así que vale la pena dedicarle un minuto en lenguaje sencillo. Un modelo de mezcla de expertos divide sus pesos en muchas redes pequeñas de "expertos", y para cada token un enrutador elige un puñado de ellos, y solo esos expertos hacen cálculo. Por eso un modelo de 501B puede costar por token aproximadamente lo mismo que uno denso de 23B.
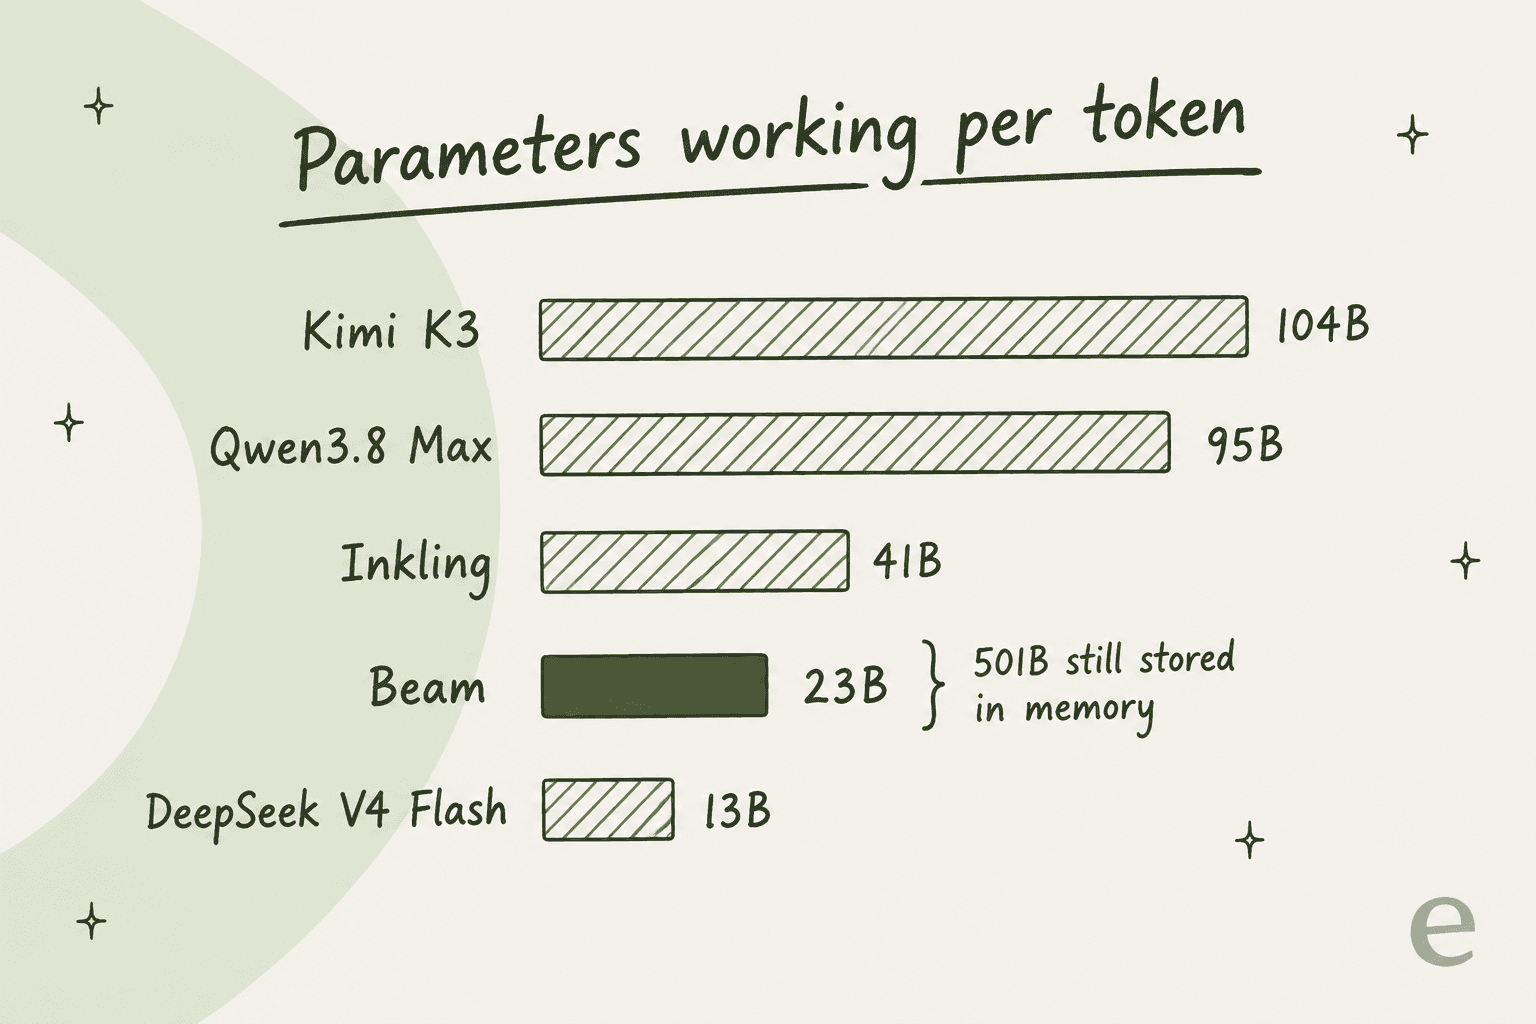
La trampa que mucha gente pasa por alto es esta: los parámetros activos fijan tu factura de cómputo, los parámetros totales fijan tu factura de hardware. Los 501B tienen que estar en memoria, porque en el siguiente token el enrutador puede elegir cualquier experto. Así que por token Beam es barato de ejecutar, pero no es pequeño de alojar. Junto a Kimi K3, con 2.8T totales y 104B activos, Beam es más ligero en ambos aspectos, y junto a DeepSeek V4 Flash, que activa solo 13B, hace más trabajo por token.
La longitud del razonamiento es la otra palanca. Reflection entrenó Beam con una penalización por longitud que premia las respuestas correctas y desalienta los tokens innecesarios, y luego expuso ese equilibrio mediante el parámetro reasoning_effort. En sus gráficos de eficiencia, la puntuación se representa frente a cuántos tokens gasta cada modelo:
Bajo el gráfico, Reflection indica una salvedad honesta: las estimaciones de cómputo dejan fuera el prefill del prompt, los costes de atención y la sobrecarga de servicio, así que "represent an approximate compute comparison rather than measured inference cost." Dicho de otro modo, lo que ves es la forma de la eficiencia y no una factura.
Benchmarks de Beam: dónde se sitúa realmente
Reflection publicó una tabla de benchmarks amplia y, en su favor, incluye modelos que superan a Beam. Abajo están las filas que miraría para trabajo de agentes y programación, y cada número procede de la tabla de la propia Reflection. "NR" significa not reported (no reportado).
| Benchmark | Beam | GLM-5.2 | Kimi K3 | Qwen3.8 Max | DeepSeek V4.1 Flash | Inkling |
|---|---|---|---|---|---|---|
| SWE-bench Verified | 80.9 | NR | NR | NR | NR | 77.6 |
| SWE-bench Pro v1 | 65.5 | 62.1 | NR | 67.7 | NR | 54.3 |
| Terminal Bench v2.1 | 80.1 | 81.0 | 88.3 | 86.6 | 90.6 | 63.8 |
| DeepSWE v1.1 | 44.4 | 44.0 | 68.0 | 51.0 | 74.2 | NR |
| MCP Atlas | 78.7 | 77.8 | 82.3 | 84.5 | NR | 76.0 |
| tau3 banking | 38.0 | 37.1 | 37.1 | 55.2 | NR | 25.0 |
| HLE (no tools) | 36.2 | 40.5 | 46.9 | 43.6 | 39.1 | 29.7 |
| GPQA Diamond | 90.5 | 91.2 | 93.5 | 92.6 | 90.9 | 87.2 |
Al leer las filas de lado a lado, el panorama es bastante claro: Beam se intercambia golpes con GLM-5.2 y supera con holgura a Inkling, pero queda por detrás de Kimi K3, Qwen3.8 Max y DeepSeek V4.1 Flash donde estos reportaron resultados. El propio planteamiento de Reflection concuerda, al decir que Beam es "competitive with larger open models like GLM 5.2 and approaching Qwen 3.8-Max on coding and agentic tasks," mientras que "frontier open models like Kimi K3 remain ahead on raw capability."
El 80.9 destacado en SWE-bench Verified necesita una nota al pie, y un usuario de X llamado LuChai lo explicó bien:
"The 80.9 on SWE Bench Verified is the standout, but worth flagging that GLM-5.2 and Qwen 3.8 Max are both NR there"
Tampoco hay todavía un árbitro independiente. A 8 de octubre, Beam no aparece en Artificial Analysis (su lista de 696 modelos no tiene entrada de Beam), y tampoco está en el ranking tau-bench de Sierra. Como referencia, Artificial Analysis puntúa actualmente a Qwen3.8 Max con 45.4, a Kimi K3 con 43.6 y a GLM-5.2 con 33.7 en su Intelligence Index. Si Beam realmente está cerca de GLM-5.2, esperaría verlo en algún punto de los 30 una vez lo prueben, y Mistral Large 4, otro lanzamiento occidental reciente, es una vara de medir útil para eso.
Algo más que me gustó es que Reflection muestra que su ejecución de RL siguió mejorando sin estancarse, una buena señal para el siguiente modelo de la serie.
¿Cuánto costará Reflection AI Beam?
Respuesta corta: nadie fuera de la lista de espera lo sabe todavía. Tanto la plataforma de Reflection como su página /pricing no muestran más que una pantalla de inicio de sesión. Según los términos comerciales, las tarifas están "set forth in the pricing documentation" de la plataforma, y esa documentación está tras el mismo inicio de sesión.
La documentación de errores y facturación sí revela una cosa, que es la forma de la facturación:
- Un saldo de créditos o prepago (
402 insufficient_credits,prepaid_balance_exhausted) - Una tarjeta verificada antes de que algunas organizaciones puedan crear claves de API (
403 payment_method_required) - Niveles de facturación y una cuota diaria de tokens según tu plan
Como no hay precio de Beam que citar, este es el rango en el que Beam tendría que caer para que su historia de eficiencia importe. Abajo están las tarifas de API de los propios fabricantes para los modelos de la tabla de comparación de Reflection, por 1M de tokens:
| Modelo | Entrada | Entrada en caché | Salida | Fuente |
|---|---|---|---|---|
| Kimi K3 | $3.00 | $0.30 | $15.00 | Kimi platform |
| Qwen3.8 Max | $2.00 | $0.25 | $6.00 | Qwen Cloud |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | Z.ai pricing |
| DeepSeek V4.1 Flash | $0.30 | $0.006 | $1.20 (peak) | DeepSeek pricing |
| Reflection Beam | No publicado | No publicado | No publicado | Solo lista de espera |
Supongamos que Beam queda cerca de GLM-5.2 en calidad. Entonces el argumento de eficiencia solo compensa si su precio es igual o inferior a los $1.40 / $4.40 de GLM-5.2, y aun así tiene que justificarse frente a DeepSeek V4.1 Flash, que puntúa más alto en la mayoría de las filas de la propia Reflection a una fracción de esas tarifas. Para ver cómo se traducen esos números por tarea, consulta mis análisis más detallados de los precios de GLM y los precios de Qwen3.8 Max.
Autoalojarlo cambia las cuentas, aunque no la factura de hardware. Una respuesta en X a una publicación de "run it on your desk" lo planteó en términos directos:
"m5 studio 512GB is like $20 grand... this is realistically a $40k investment, to use 6 month old AI."
Términos de datos que conviene leer antes de enviar datos reales
Los términos de Reflection dividen el servicio en dos tipos. En los Standard Services de pago, licencias tu contenido a Reflection "solely to operate and provide the Services." En los servicios gratuitos o Discounted Services, la licencia es mucho más amplia e incluye el derecho a "create derivative works of, and otherwise exploit" tu contenido. En ambos casos, el contenido se conserva 30 días por seguridad y cumplimiento, y el contenido marcado hasta 12 meses. Si estás probando Beam con conversaciones de clientes en un plan de acceso anticipado con descuento, esa cláusula es la que leería dos veces.
Cómo usar Beam ahora mismo
Una vez que salgas de la lista de espera, la API es fácil de integrar. Reflection ofrece un endpoint compatible con OpenAI en https://api.reflection.ai/openai/v1, lo que significa que el código construido con los SDK de OpenAI funciona tras cambiar la URL base y la clave. El ID del modelo es Beam-501B-A23B.
Hay algunas trampas en la documentación que conviene conocer antes de construir:
- Solo se admiten Chat Completions y Models. Sin Responses API, embeddings, batch, files ni assistants.
- Las secuencias
stopse aceptan pero se ignoran. La generación no se detendrá en ellas, así que no cuentes con ellas para el parseo. - El razonamiento no se puede desactivar. Elige
lowpara velocidad,maxpara tareas difíciles. El texto de razonamiento llega en un campo separado,reasoning_content. nestá fijado en 1 y los logprobs están desactivados. Si tu arnés de evaluación muestrea varias completions por llamada, necesita un bucle.- El tool calling y las salidas estructuradas funcionan, incluidos
parallel_tool_callsyjson_schema.
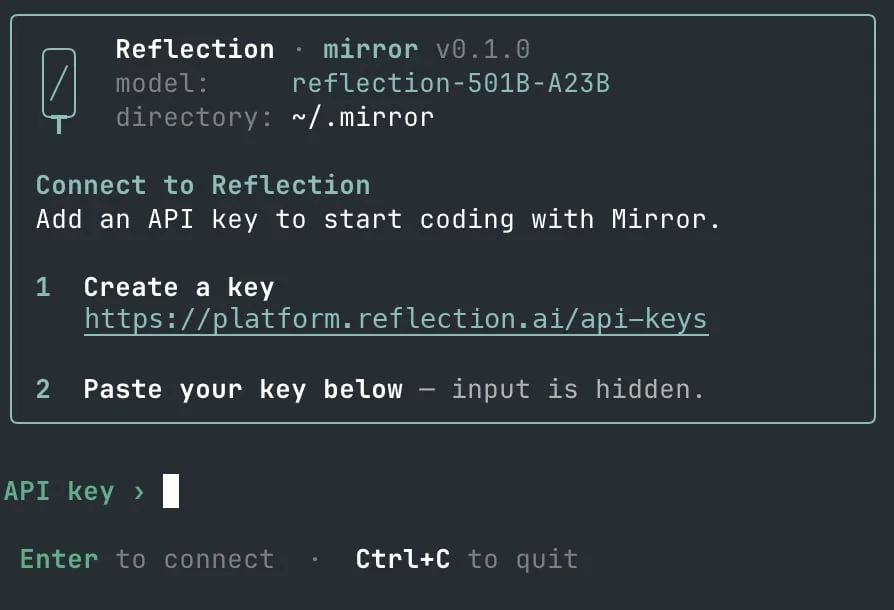
Para trabajo de programación, Reflection incluye su propio agente de terminal, Mirror CLI, con Beam como modelo por defecto. Sigue en beta temprana y admite worktrees paralelos e instrucciones AGENTS.md, además de conexiones MCP a herramientas como Linear y Notion. La guía de inicio rápido de Reflection también explica cómo conectar Beam a Pi, OpenCode y Hermes Agent, lo cual es útil si ya trabajas con alguno de ellos.
Si todavía estás eligiendo un arnés, ese lado lo cubren mis artículos sobre el agente de programación Pi y la CLI de programación agéntica.
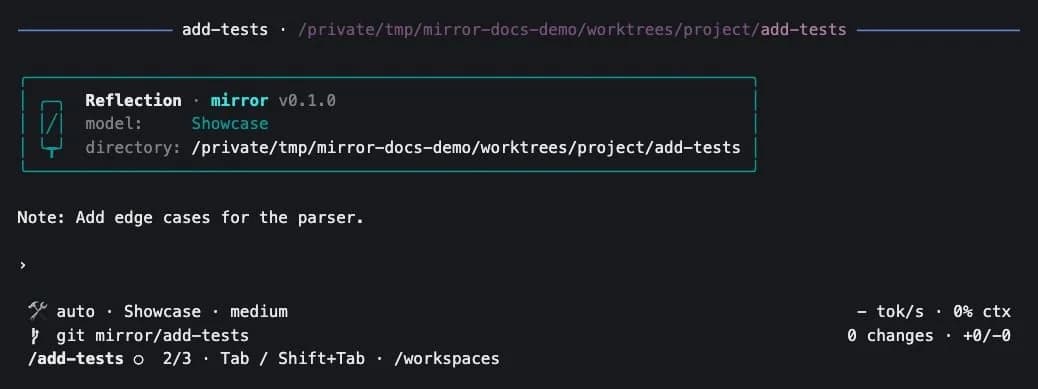
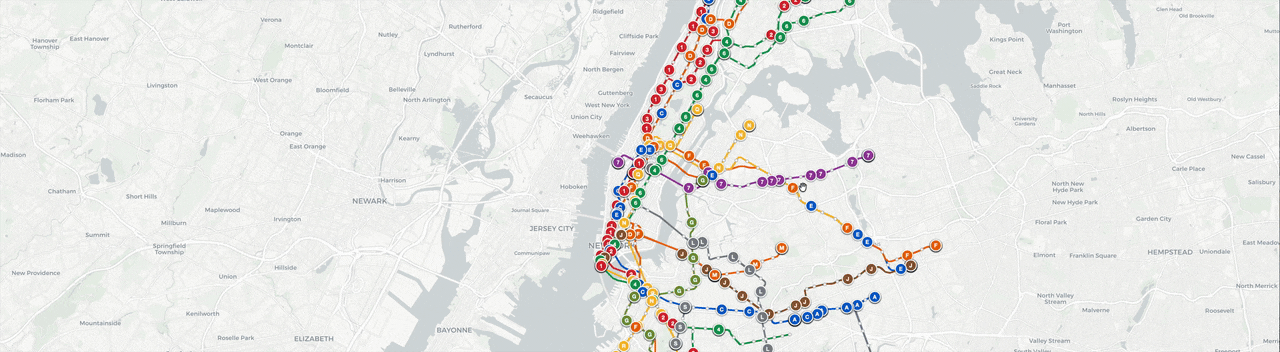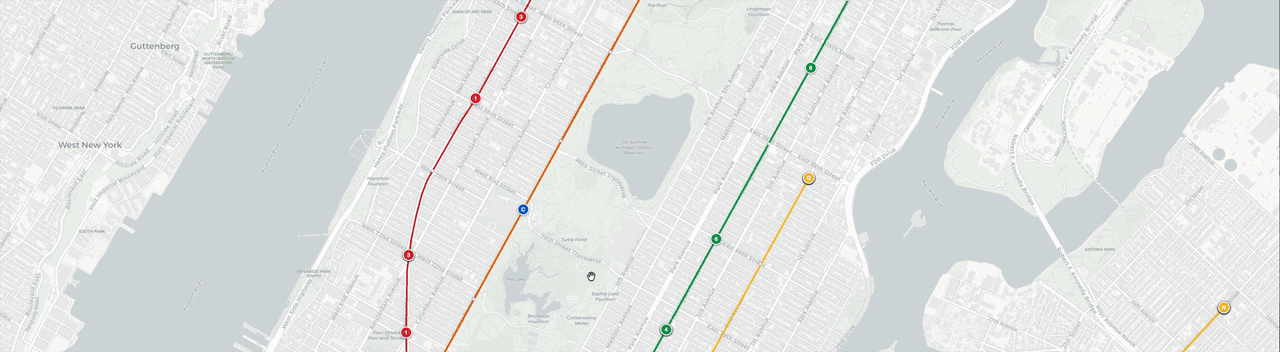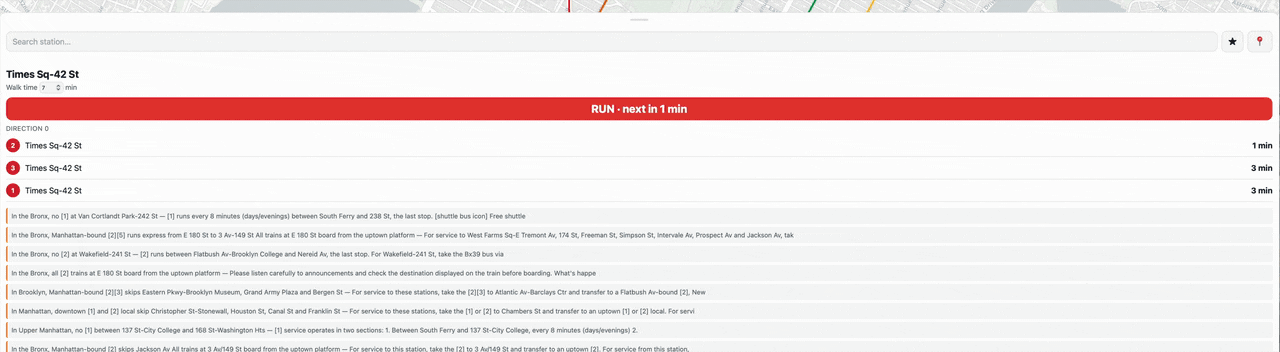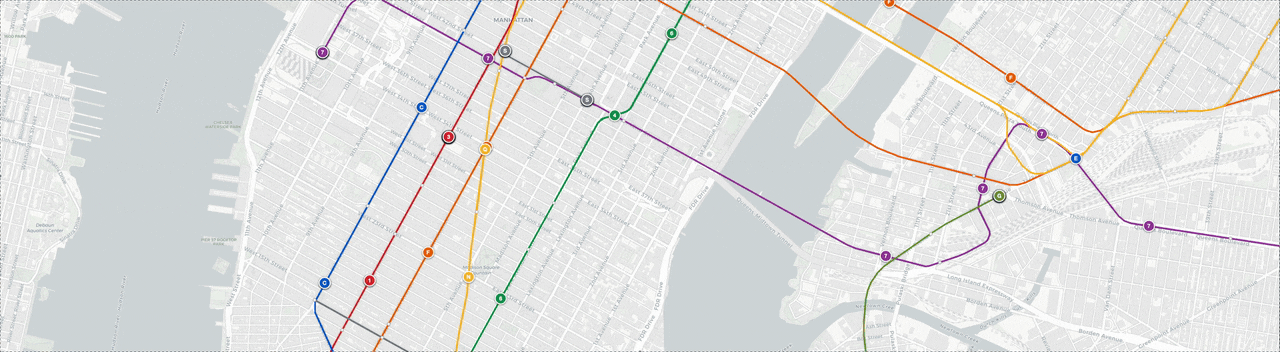
Las propias demos de Reflection apuestan fuerte por este ángulo de agentes. Mi favorita es el mapa en vivo del metro de Nueva York, donde Beam buscó en la documentación de la MTA y resolvió la autenticación, luego encontró la geometría del metro y construyó tanto el frontend como el backend:
Una demo necesitó una corrección tras el lanzamiento. La demo "Land or Water" de Reflection afirmó al principio que el puzle tenía solo unos días, así que no podía estar en los datos de entrenamiento. Después de que un usuario de HN señalara que era más antiguo, un miembro del equipo de Reflection respondió que se había cambiado el pie de foto. Es algo menor y se gestionó con transparencia, pero conviene tenerlo en cuenta al leer las demos.
Qué dicen los desarrolladores sobre Beam
Revisé el hilo de Hacker News y r/LocalLLaMA, además de X y LinkedIn, y los mismos tres temas se repetían.
"Show me the weights." Hasta que salgan los pesos, mucha gente simplemente no contará Beam como abierto. Los moderadores de r/LocalLLaMA eliminaron el hilo del lanzamiento por exactamente ese motivo:
"Until such time that weights become available, this is off-topic for LocalLLaMA."

"It's a generation behind, but it's American." La mayoría de los comentaristas sitúan a Beam en torno a GLM-5.2, que es un modelo de junio. La emoción tiene más que ver con dónde se construyó, y para los equipos que no pueden usar modelos de origen chino, esa es toda la decisión:
"I'm in a similar situation to you where we can't use Chinese AI models but we want to host on-prem due to data sovereignty concerns. ... I'm also keeping an eye on Reflection Beam"
"Nice efficiency claim, now let someone check it." Incluso las opiniones positivas vienen con esa salvedad. Tyler Folkman, Chief AI Officer de JobNimbus, resumió cómo los profesionales van a dimensionarlo:
"Nobody outside Reflection has verified any of this yet. ... When Beam's weights ship, I'm sizing them for my boxes by active parameters and quantized footprint, not the leaderboard."

Reflection también recibió algo de reconocimiento por su franqueza. Un comentarista de HN elogió a Reflection por admitir que Kimi K3 va por delante "instead of making false claims." Estoy de acuerdo, ya que un anuncio de lanzamiento que nombra a los modelos que te superan es más raro de lo que debería.
¿Es Beam un buen modelo para atención al cliente?
Esta es la pregunta que más me importa, ya que mis días los dedico a la IA que responde tickets de soporte. La buena noticia es que Reflection reportó una puntuación en un benchmark que de verdad se parece al trabajo de soporte.
tau3 banking procede de tau-bench de Sierra. Sitúa al modelo en un helpdesk bancario simulado con 698 documentos de políticas y le pide resolver solicitudes de clientes mediante herramientas. Una tarea solo se aprueba cuando la cuenta del cliente acaba en el estado correcto, lo que significa que una respuesta amable pero equivocada puntúa cero. Cada tarea necesita unos 18.6 documentos y 9.5 llamadas a herramientas.
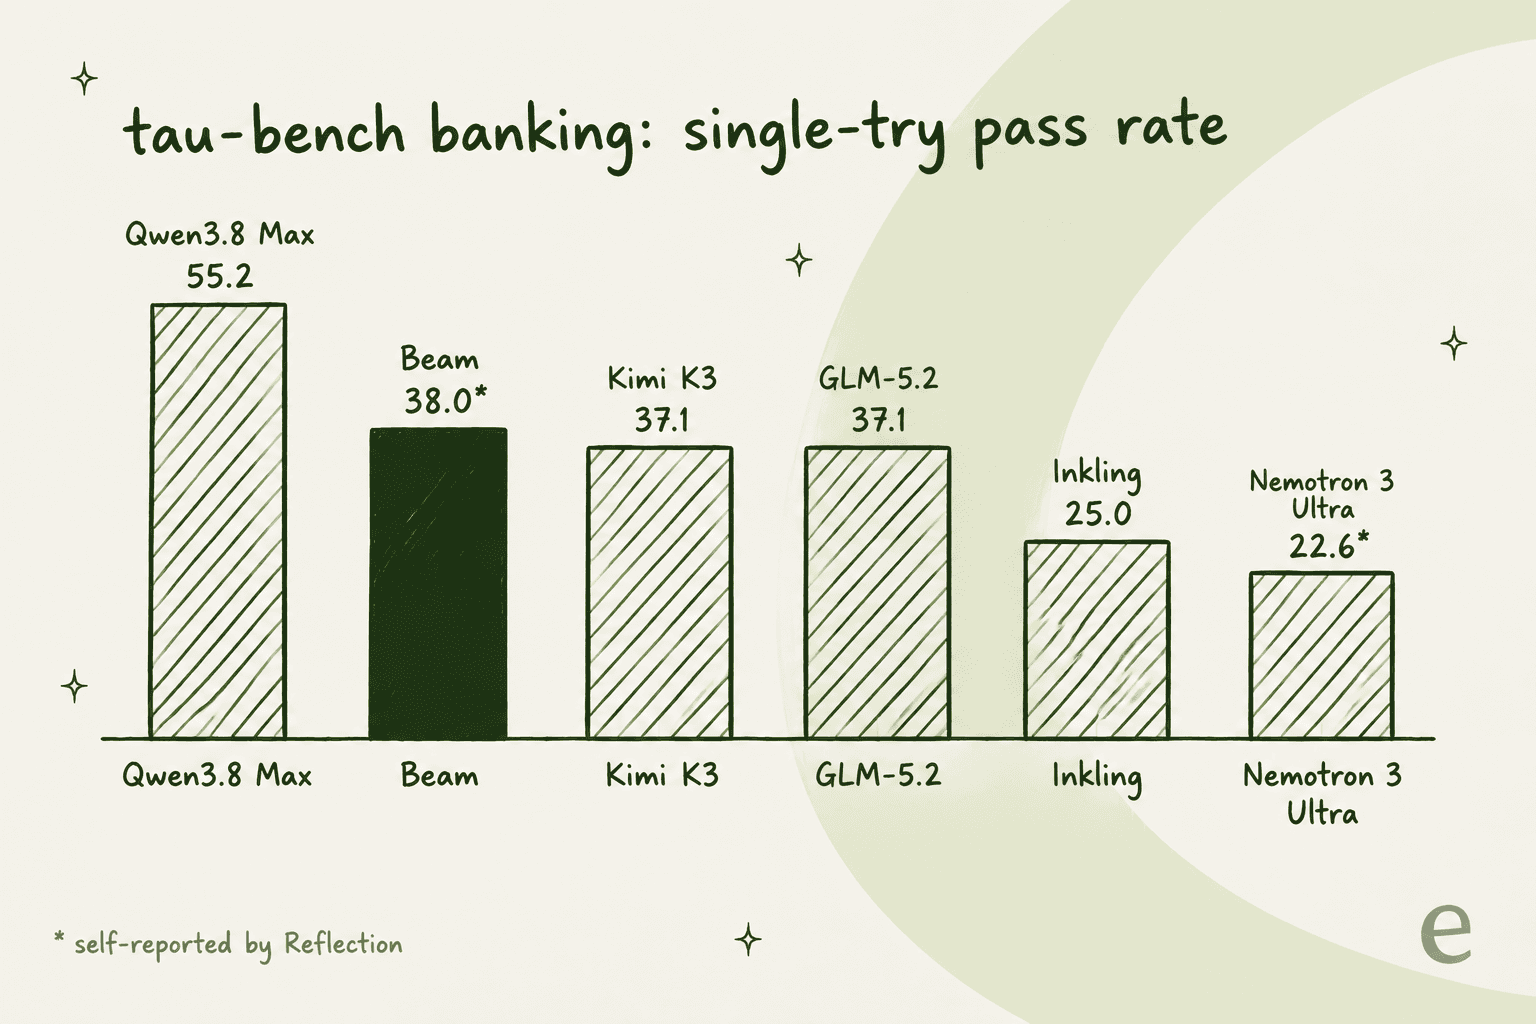
Los 38.0 de Beam están más o menos al nivel de Kimi K3 y GLM-5.2 (ambos 37.1 en el ranking de Sierra) y bastante por detrás de Qwen3.8 Max con 55.2. Reflection no dice qué configuración de prueba dio sus 38.0, así que lo trataría como cercano más que exacto. Todo el campo también cae cuando se exige consistencia: en el ranking de Sierra, Qwen3.8 Max baja de 55.2 a 35.1 cuando una tarea tiene que aprobar los cuatro intentos.
Ese último número es la verdadera lección para los equipos de soporte, y lo traté en profundidad en mi análisis del mejor modelo de IA para tickets de soporte: incluso el mejor modelo acierta un ticket con muchas políticas todas las veces solo alrededor de un tercio de las veces. Cambiar a un modelo nuevo no lo arregla.
Lo que lo arregla es la capa alrededor del modelo, es decir, basar las respuestas en tu base de conocimiento real y en tickets pasados y escalar a una persona las respuestas de baja confianza, además de probar con tu propio historial antes de que nada salga en vivo. Mi guía de implementación recorre ese orden de despliegue.
He visto ese fallo en colas reales. Un equipo de telemática de vehículos en Zendesk tenía un bot que decía con seguridad a los clientes "yes, we support your car model" para marcas que no estaban en su base de datos, todo porque un artículo de ayuda decía "we support all models." Ninguna puntuación de benchmark lo habría detectado, pero una simulación con sus propios tickets pasados sí.
Así que, para soporte en concreto, Beam es un candidato razonable como motor una vez que tenga precio y los pesos estén disponibles, más aún si tu empresa descarta modelos de origen chino. Por sí solo, sin embargo, no es un agente de soporte. Para esa parte necesitas un agente de helpdesk con IA que conozca tu cola, y mi recopilación de helpdesks con IA compara los que lo hacen.
¿Quién es Reflection AI?
Reflection fue cofundada en 2024 por Misha Laskin (CEO) e Ioannis Antonoglou, ambos ex investigadores de Google DeepMind. En su anuncio de lanzamiento, Laskin atribuye su propio cambio de la física a la IA a AlphaGo en 2016.
Hay mucho dinero detrás. La publicación propia de Reflection anunció una ronda de $2 billion en 2025 con inversores como NVIDIA, Sequoia, Lightspeed, DST, CRV y Eric Schmidt, y su sala de prensa indica una valoración pre-money de $25 billion para su ronda de abril de 2026. En el anuncio de lanzamiento, Laskin también argumenta por qué optaron por lo abierto:
"Open also means safer. The best defence is a distributed one."
Antonoglou añadió en X que el equipo ya está "already training the next, larger model." Beam, en otras palabras, es explícitamente el primero de una serie.
También surgió una aclaración en HN: este Reflection no tiene relación con el modelo "Reflection 70B" de 2024. Un comentarista corrigió la confusión en el hilo del lanzamiento, y la persona que la había planteado se retractó.
Entonces, ¿deberías esperar a Beam?
Aquí es donde me quedaría, según el lector:
| Si eres... | Mi veredicto |
|---|---|
| Un equipo que necesita un modelo abierto hecho en EE. UU. (gobierno, sectores regulados, política de "sin origen chino") | Únete ya a la lista de espera y planifica una evaluación para principios de noviembre |
| Quien construye hoy agentes de programación con poco presupuesto | Usa ahora DeepSeek V4 Flash o GLM, y vuelve a probar Beam cuando esté en Artificial Analysis |
| Quien busca el modelo abierto más fuerte | Kimi K3 o Qwen3.8 Max, según la propia tabla de Reflection |
| Quien planea autoalojar | Espera a los pesos FP8 y NVFP4, y luego dimensiona por memoria para 501B, no por cómputo para 23B |
| Quien elige un modelo para una cola de soporte | Elige primero el agente y luego el modelo; ver más abajo |
eesel para equipos de soporte que siguen la carrera de modelos
Si has llegado aquí porque estás eligiendo un modelo para responder a clientes, el atajo es que no tienes que apostar tu cola a un único lanzamiento. El compañero de helpdesk con IA de eesel se conecta a Zendesk, Freshdesk o Gorgias y aprende de tus tickets anteriores y tu centro de ayuda, y luego ejecuta una simulación con tu historial real de tickets antes de responder a nadie. Cuando sale un modelo mejor o más barato, el compañero mejora y no tienes que reconstruir nada.

También sirve para el público de terminal que lee un artículo sobre Beam. Con la CLI de eesel puedes ejecutar el mismo compañero desde una shell, para cosas como conectar un helpdesk, editar sus instrucciones permanentes, aprobar o denegar acciones pendientes y leer su registro de actividad. Cada comando devuelve JSON, y un flag --dry-run muestra la llamada exacta antes de enviarla. Además, cada workspace es un servidor MCP, así que un agente de programación como Claude Code puede manejarlo directamente.
Los resultados suelen llegar rápido cuando el agente se basa en tus propios datos. Así lo expresó Gridwise tras su prueba:
"In the first month, eesel is resolving 73% of our tier 1 requests."

Prueba eesel gratis con 100 créditos, sin tarjeta, o consulta los planes de pago en la página de precios.