

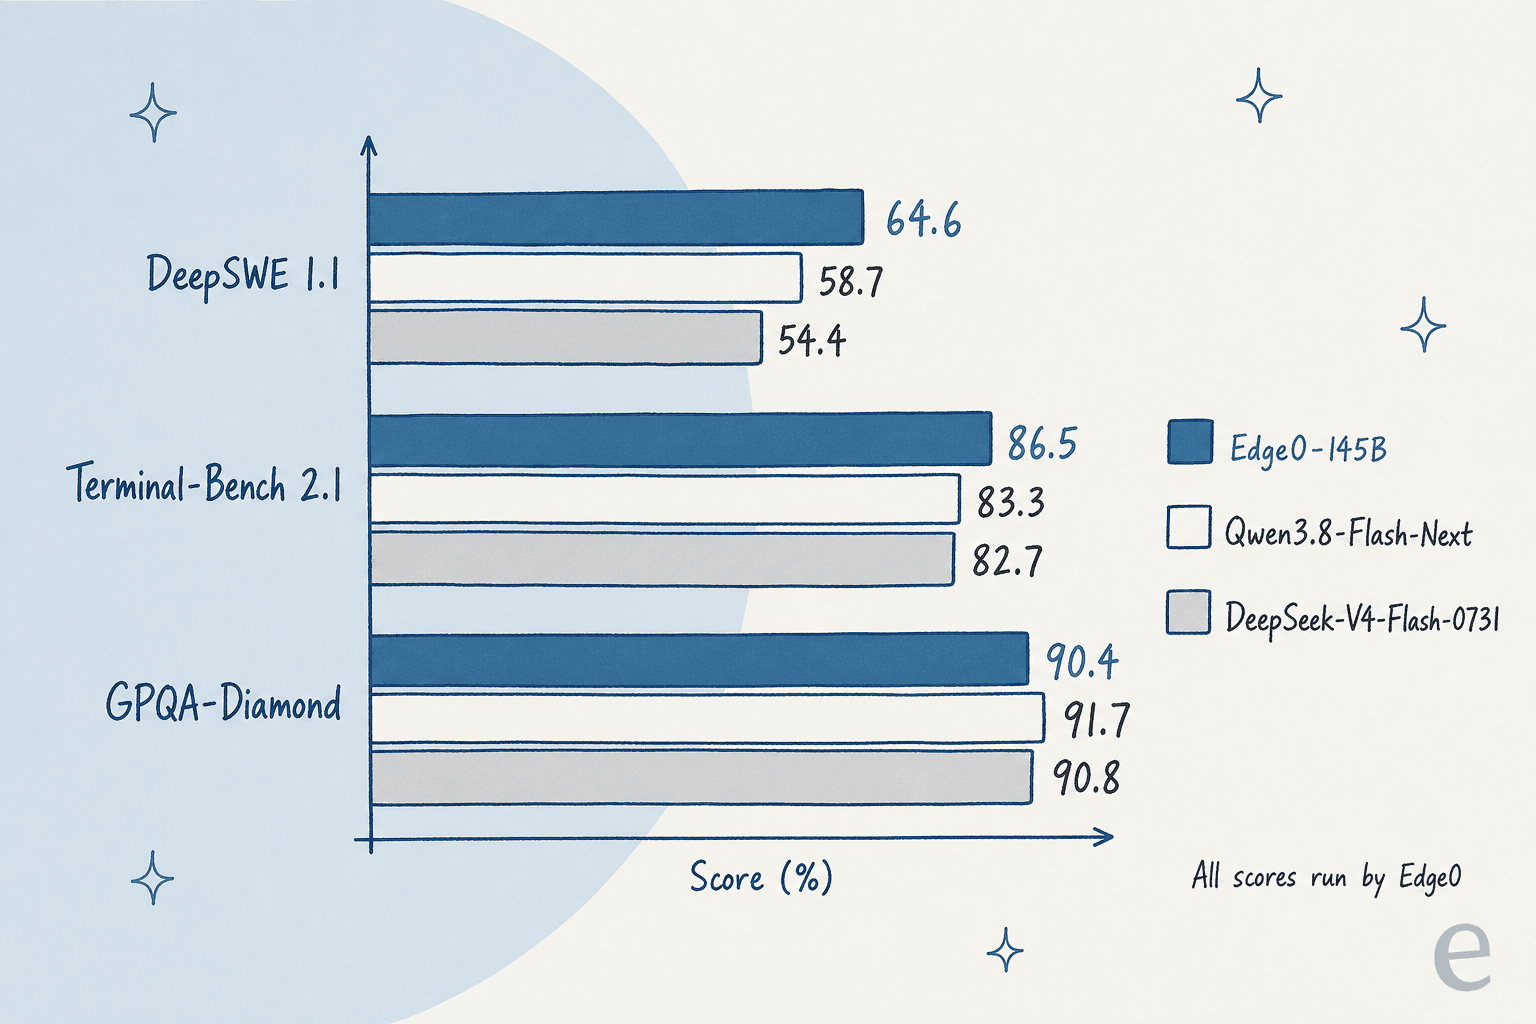
Edge0-145B es un modelo de 145 mil millones de parámetros construido para correr en una sola tarjeta gráfica de consumo, y la ingeniería detrás es real. En las propias pruebas de Edge0 obtiene 86.5 en Terminal-Bench 2.1 y 64.6 en DeepSWE 1.1, por delante de su modelo base, Qwen3.8-Flash-Next.
Las afirmaciones de lanzamiento necesitan matices, sin embargo. La cifra de "29GB" deja fuera unos 31 GiB de RAM del sistema, el soporte para macOS no está en el lanzamiento, y los pesos llevan una licencia que restringe los servicios comerciales. Mi veredicto: 3/5, vale la pena probarlo en una máquina NVIDIA, no vale la pena reconstruir tu stack alrededor de él todavía.
Para los equipos de soporte que buscan privacidad, el modelo importa menos que lo que el bot puede leer. eesel responde solo con tu conocimiento aprobado, y con el eesel CLI cualquier agente de codificación puede subir ese conocimiento y hacer preguntas de prueba antes de que algo salga en vivo.
Cómo revisé Edge0-145B
Edge0 publicó el lanzamiento el 13 de noviembre, así que esta revisión es de dos días después. Yo construyo integraciones y APIs en eesel, así que leo lanzamientos como este tal como leo la documentación de cualquier proveedor: la publicación de lanzamiento te dice lo que quieren que creas, y el README te dice lo que realmente se envía. Trabajé con tres fuentes, en este orden de confianza:
- Los propios archivos de lanzamiento de Edge0. El README de GitHub, la ficha del modelo en Hugging Face, y el archivo de procedencia de licencia en el repositorio. Estos llevan los números medidos.
- La publicación de lanzamiento de Edge0. Útil para la intención y las demostraciones, pero donde no coincide con el README, me quedo con el README.
- Los primeros usuarios. El hilo de lanzamiento en Hacker News superó los 330 puntos y 100 comentarios, con algunas personas probándolo en su propio hardware.
No corrí mi propia suite de benchmarks, y ningún laboratorio independiente como Artificial Analysis tenía una página para Edge0-145B el 14 de noviembre. Trata cada puntuación de abajo como de Edge0. Si quieres el panorama más amplio de modelos primero, los artículos de mis colegas sobre DeepSeek V4 Flash y Qwen 4 Max cubren las dos familias con las que Edge0 se compara.
¿Qué es Edge0-145B?
Edge0-145B es un modelo de mezcla de expertos latente de Edge0, un equipo que antes lanzó el modelo para teléfonos Edge0-35B en septiembre y los modelos de voz Audio8. Tiene 145B de parámetros totales pero solo unos 10.12B activos por token, que es cómo cabe en hardware que nunca podría contener un modelo denso de 145B.
Esto es lo que dice la ficha del modelo sobre él:
| Especificación | Edge0-145B | Edge0-120B |
|---|---|---|
| Parámetros totales / activos | 145B / 10.12B | 120B / no indicado |
| Capas y expertos | 48 capas, 512 expertos, 10 enrutados + 1 compartido por token | Igual |
| Ancho latente de experto | 1,792 | 1,280 |
| Ventana de contexto | 256K (KV int8, 32K residente) | 256K |
| Builds en Hugging Face | Q3_K (40.81 GiB), NVFP4 (47.79 GiB) | Q3_K (27.98 GiB), NVFP4 (32.96 GiB) |
| Modelo base | Qwen3.8-Flash-Next | Qwen3.8-Flash-Next |
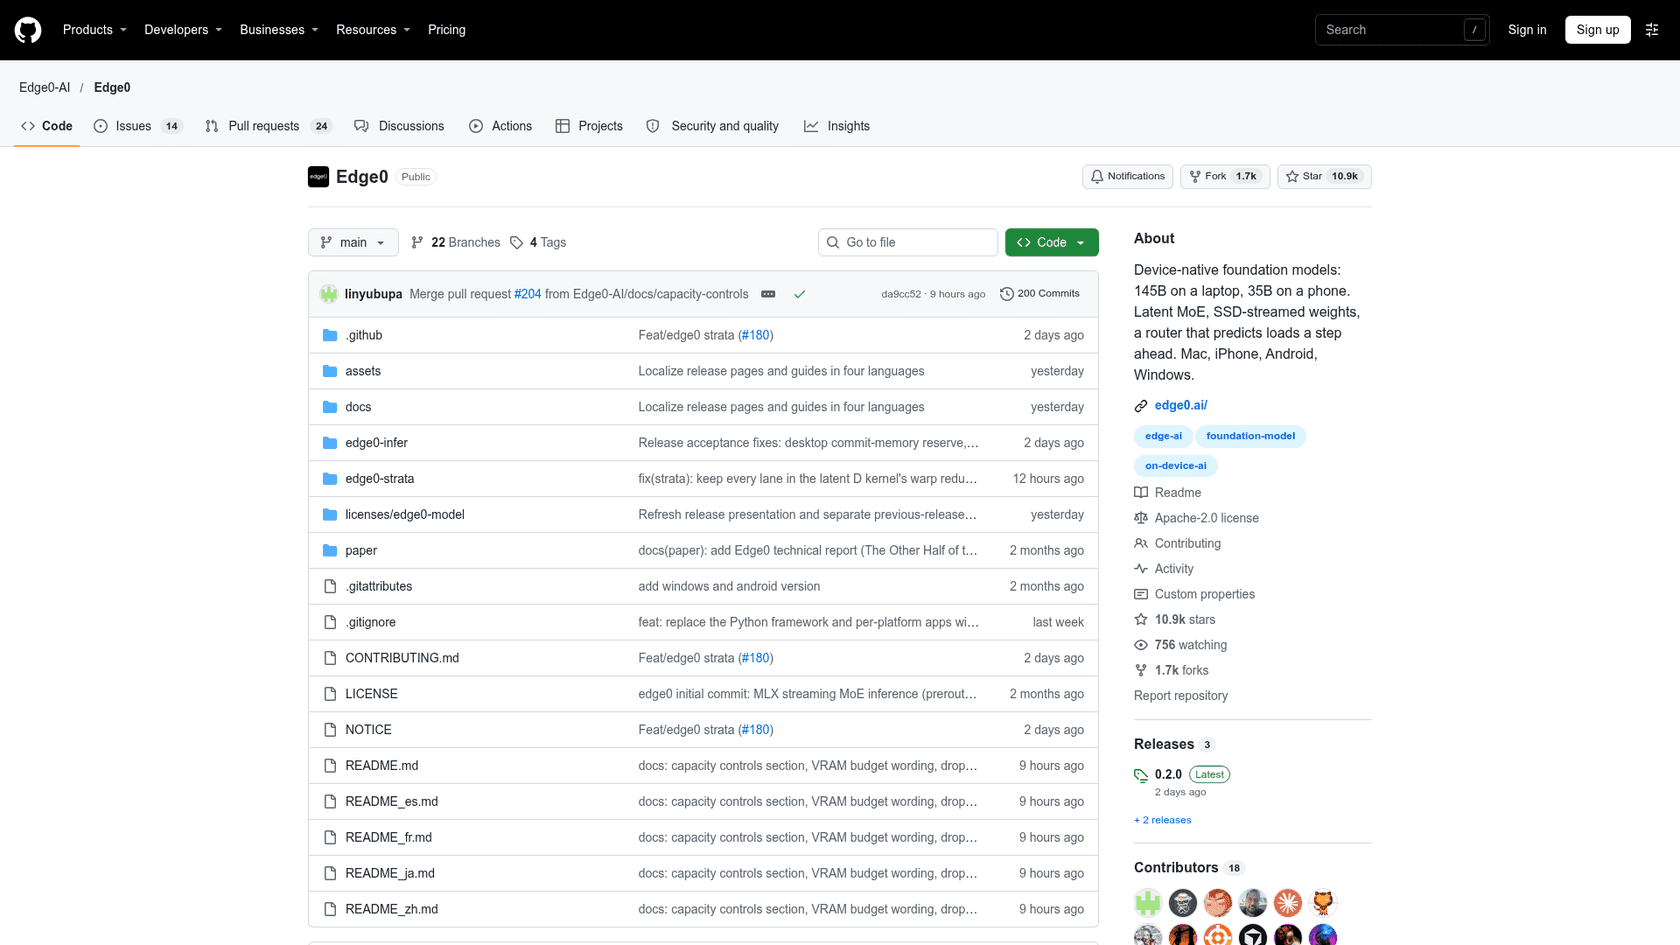
| Motor | edge0-strata (fork de Strata) | edge0-strata |
Dos líneas de esa tabla cuentan la mayor parte de la historia. El modelo base es Qwen, y el motor es un fork del proyecto de código abierto Strata. Edge0 lo dice claramente en el README, aunque la publicación de lanzamiento nunca menciona a Qwen en absoluto. Esa brecha es en lo que se fijaron la mayoría de los primeros comentaristas:
"Based on Qwen3.8-Flash-Next and Strata. They made some interesting tweaks and did some fine tuning on the model, but it's interesting how much marketing speak was layered on their website to hide this fact."

Ser un derivado no es un defecto. La mayoría de los buenos modelos abiertos ahora parten de la base de otro, y la pregunta real es si los cambios de Edge0 aportan algo. En eso, la respuesta parece ser que sí.
Qué hace bien Edge0-145B
Tres cosas destacaron, y todas tienen que ver con la ingeniería más que con la inteligencia bruta.
El diseño de expertos es ingenioso
Edge0 comparte dos matrices grandes entre cada grupo de 64 expertos, y cada experto conserva solo un pequeño conjunto de sus propios parámetros. La ficha del modelo detalla el resultado: cada experto es un registro fijo de 1,630,720 bytes, así que el motor puede mantener en la tarjeta gráfica unos pocos miles de los expertos más usados y transmitir el resto desde la memoria del sistema. El costo de esa transmisión sigue cuántos expertos permanecen residentes, no cuán grande es el modelo.
Edge0 también entrenó el modelo con esta forma desde el inicio, de forma nativa a 4 bits, en lugar de reducir un modelo de nube después del hecho. La decodificación especulativa a través de una cabeza borrador de 1.26B reparte el costo de cada lectura de peso entre varios tokens de salida. Nada de esto es magia, pero es un trabajo cuidadoso, y es por lo que un modelo de 145B corre siquiera en una tarjeta de 24 GB.
Sus puntuaciones de codificación y agente superan a su modelo base
La tabla de benchmarks de Edge0 muestra las mayores ganancias donde importan para los agentes locales:
| Modelo | DeepSWE 1.1 | Terminal-Bench 2.1 | HLE | GPQA-Diamond | IFBench | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 35.4 | 90.4 | 80.6 | 79.3 |
| Edge0-120B | 51.3 | 75.3 | 31.0 | 87.4 | 79.3 | 81.0 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 35.9 | 91.7 | 81.3 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 33.8 | 90.8 | 79.2 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 30.8 | 89.2 | 79.5 | 82.0 |
| Claude Opus 4.6 (Max) | n/a | 78.2 | 40.0 | 91.3 | 62.5 | 78.0 |
El patrón es honesto en un sentido: Edge0-145B supera a su base en los dos benchmarks de agente y queda ligeramente por detrás en conocimiento y razonamiento (GPQA, HLE, IFBench). Eso es lo que esperarías de un ajuste fino orientado a agentes de codificación. Terminal-Bench en particular tiende a reflejar qué tan bien un modelo maneja una shell, y un usuario temprano lo puso en contexto:
"This score is roughly on par with 5.6 Terra max, which in my direct experience is perfectly capable of driving a cloud agent harness that can do pretty complex knowledge work."
Si prefieres comparar con los modelos alojados actuales, las revisiones de mis colegas sobre GPT-6.1 Terra y Claude Opus 5.5 tienen los números independientes que le faltan a la tabla de Edge0.
Es rápido en el hardware adecuado
En la propia máquina RTX 5090 D de 24 GB de Edge0, la build Q3_K alcanzó 121.2 tokens por segundo en decodificación de agente y 3,554.9 tokens por segundo en un prefill de 16K tokens. Eso es suficientemente rápido para que un bucle de codificación local se sienta interactivo. Las demostraciones de lanzamiento (una escena de ciudad en Blender, un programa de drones, una placa de KiCad) muestran para qué sirve esa velocidad: docenas de rondas de planificar, ejecutar y verificar sin factura por token. La página de GitHub de Edge0 tiene la tabla de velocidad completa y un video de presentación de dos minutos.
Dónde se queda corto Edge0-145B
Aquí la publicación de lanzamiento y los archivos de lanzamiento cuentan historias distintas. Cada punto de abajo viene de los propios documentos de Edge0.
"29GB de memoria pico" no es toda la huella
La publicación de lanzamiento destaca 29GB de memoria pico y dice que el modelo corre en un laptop de 48GB. La misma publicación describe más adelante una biblioteca de expertos de unos 40GB en RAM del sistema y unos 48GB de datos de vocabulario en el SSD. Los números medidos del README lo resuelven:
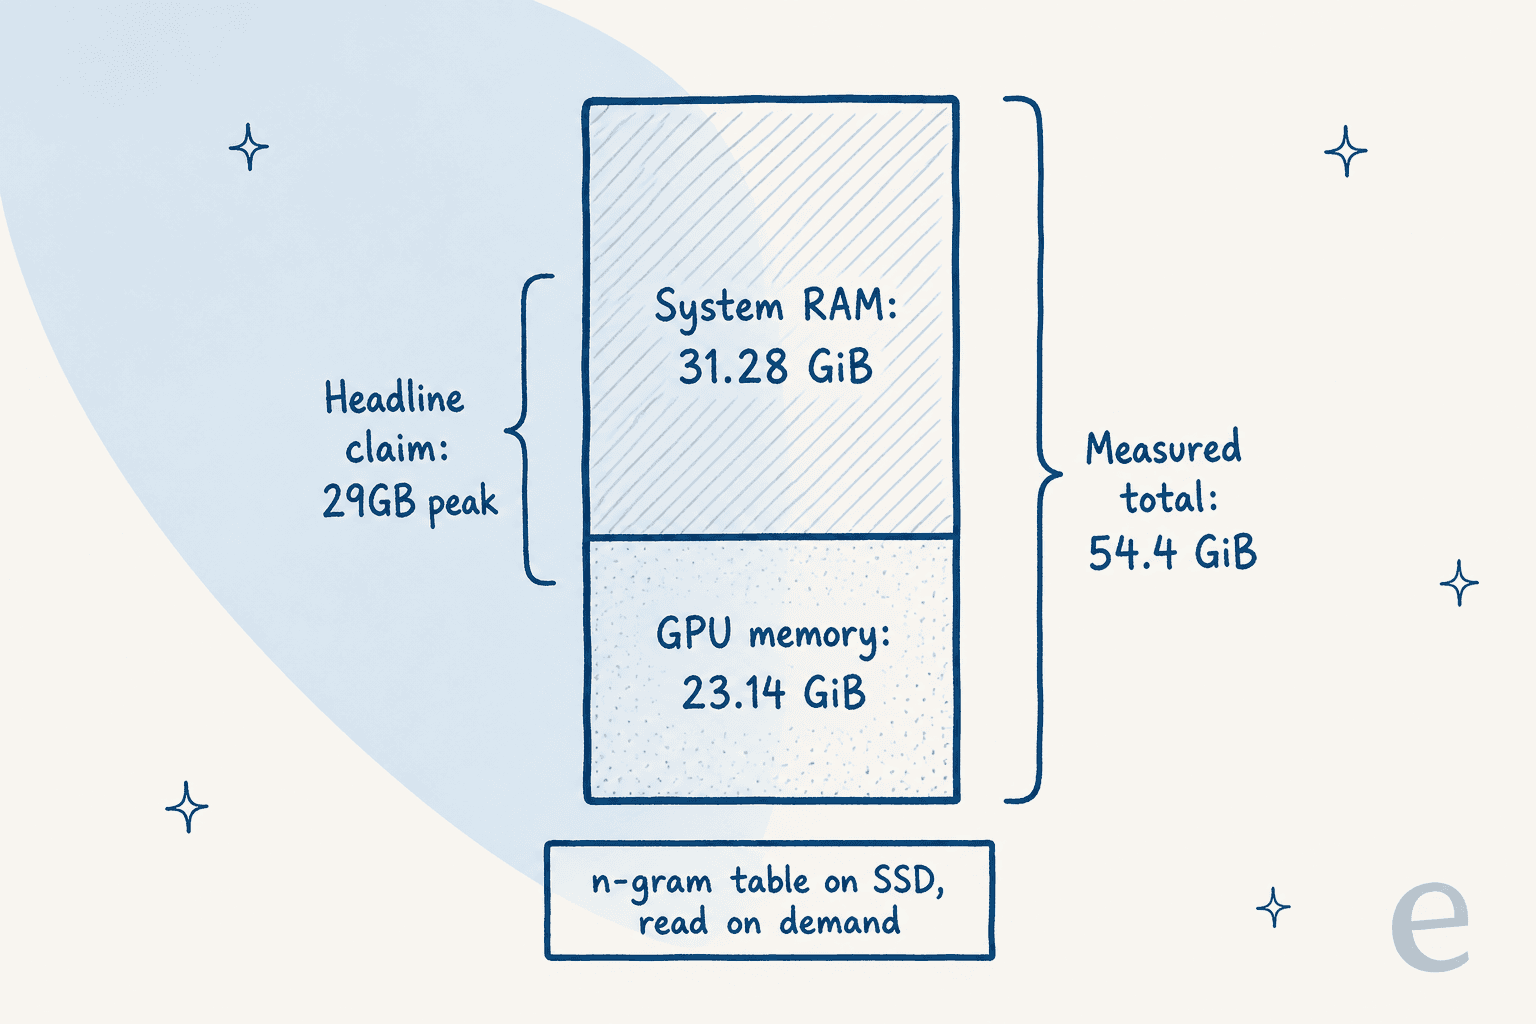
Con la residencia de expertos activada, la build Q3_K usó 23.14 GiB de memoria de GPU más 31.28 GiB de RAM del sistema. La build NVFP4 usó 23.25 GiB más 38.27 GiB. La cifra de 29GB parece ser una sola porción de eso, probablemente el lado de la GPU más algo de margen, presentada como el total.
Para ser justos con Edge0, también corrió el modelo en un presupuesto más ajustado: 16 GiB de VRAM y 20 GiB de RAM, con expertos no almacenados en caché leídos desde el SSD. Aun así funcionó, a 36.8 tokens por segundo en chat y 44.9 en modo agente. Así que una máquina más pequeña puede correrlo, solo mucho más lento. Un lector de Hacker News que esperaba correrlo en un MacBook de 48GB resumió la decepción:
"If we're talking about ~70GB combined RAM footprint then that's not going to cut it. Still very interesting though."
macOS está en la publicación de lanzamiento, no en el lanzamiento
La publicación de lanzamiento dice que el soporte del primer día cubre macOS, Windows y Linux, incluyendo chips Apple de la serie M. La tabla de plataformas del README dice algo más estrecho: los modelos 145B y 120B corren en Linux o Windows con una GPU NVIDIA y CUDA 13, y las columnas de macOS, iOS y Android están vacías para ellos. Edge0 sí publicó un resultado en un Apple M2 Ultra (57.0 tokens por segundo en decodificación de agente) y añade que eso "no establece la disponibilidad del lanzamiento en macOS". La app de escritorio Edge0 Chat es solo para Windows por ahora.
Así es lo que eso significa en la práctica:
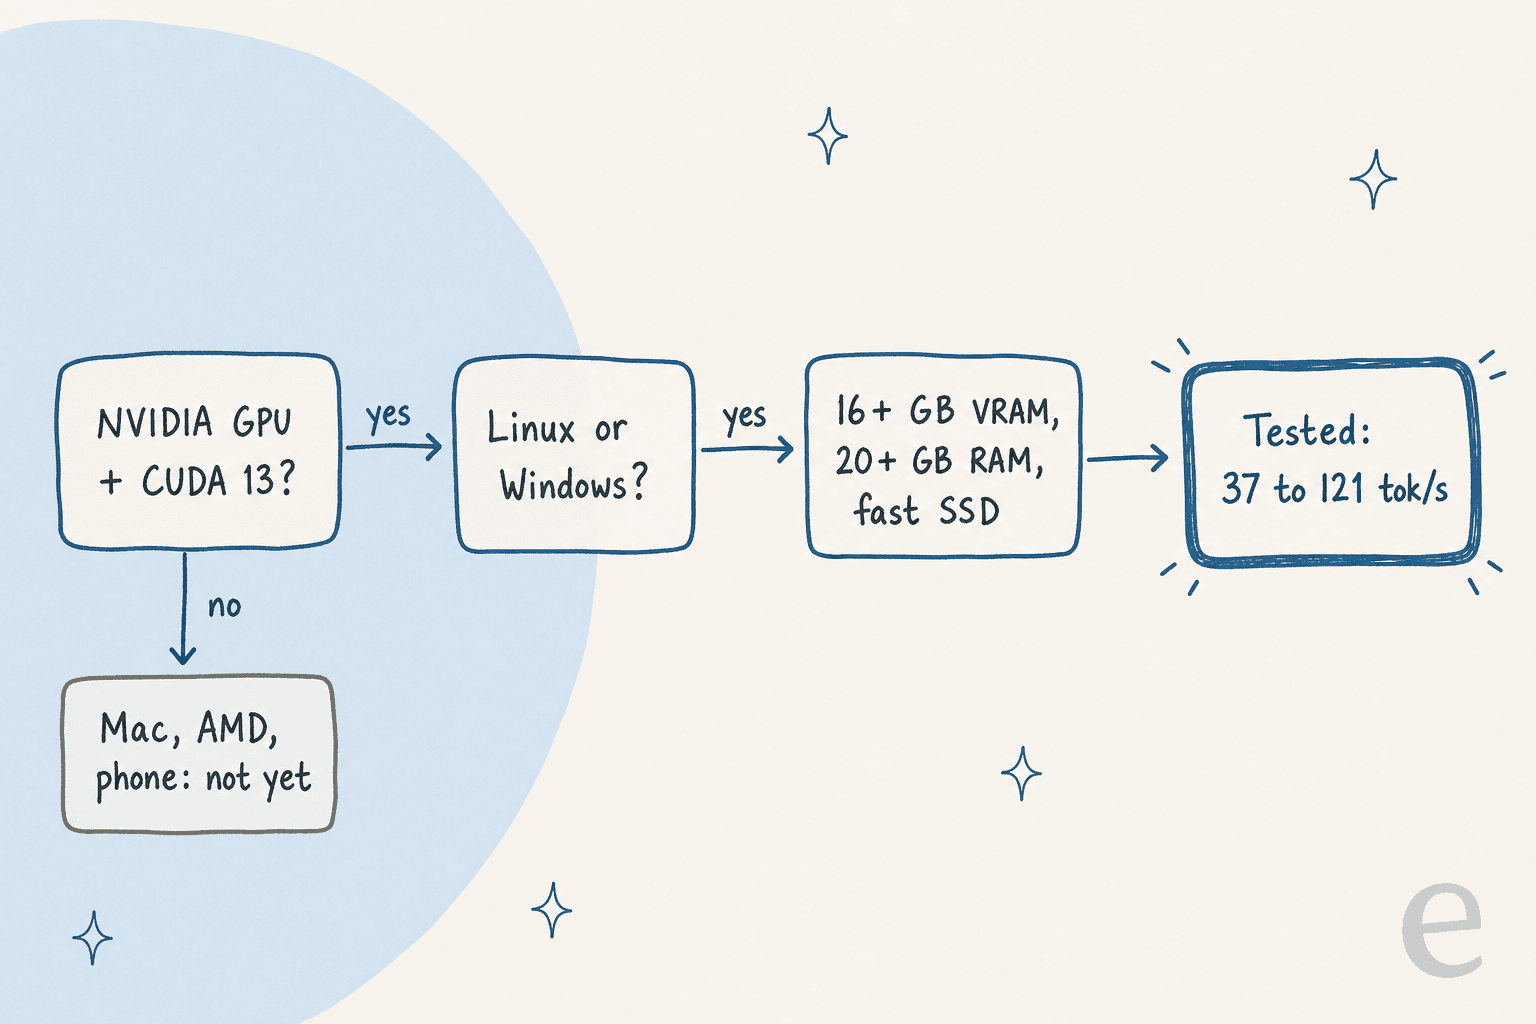
Los usuarios de Mac todavía pueden correr el más antiguo Edge0-35B en Metal. Para el 145B, hoy necesitas una máquina NVIDIA.
Los benchmarks son autoinformados, y no coinciden del todo
Cada puntuación de Edge0, Qwen, DeepSeek y Claude en la tabla viene de las evaluaciones internas de Edge0. Edge0 dice que la configuración completa y los pasos de reproducción se están "publicando con nuestro informe técnico", y el único informe técnico publicado hasta ahora cubre el modelo 35B. Los números también cambian entre documentos: la publicación de lanzamiento lista a Edge0-120B con 53.6 en DeepSWE y 81.3 en Terminal-Bench, mientras que el README lista 51.3 y 75.3.
Los primeros informes de uso práctico son mixtos. Un probador en una NVIDIA DGX Spark no pudo obtener una respuesta útil:
"It spent 8,000+ tokens at default thinking and never produced a coherent answer."
Una prueba no es un veredicto, pero es una razón para esperar una tabla de puntuaciones independiente antes de confiar en la tabla. La revisión de DeepSeek V4.1 Flash de mis colegas muestra cómo se ve eso cuando un laboratorio ha corrido los números.
"Código abierto" viene con una trampa comercial
La publicación de lanzamiento dice que Edge0 está "abriendo el código" de los modelos. El código del framework es Apache 2.0, y Strata se mantiene en MIT. Los pesos son diferentes. La ficha del modelo los pone bajo la Edge0 Community Model License 1.0, con los materiales de Qwen todavía bajo la Qwen Community License. Se permiten el uso personal, la investigación, la modificación, el uso interno y el uso comercial de las salidas. Vender o empaquetar el modelo, operar un servicio de modelo comercial, u ofrecer un asistente comercial de codificación u ofimática necesita una licencia escrita por separado.
Para un aficionado o un equipo de herramientas internas, eso está bien. Para cualquiera que planee construir un producto sobre él, lee la licencia antes que el README. La revisión de Hugging Face en nuestro blog cubre cómo aparecen estas licencias personalizadas en todo el hub.
Edge0-145B frente a las alternativas
Así es como lo ubicaría junto a lo que un desarrollador realmente consideraría esta semana:
| Si quieres... | Elige | Por qué |
|---|---|---|
| El agente de codificación local más fuerte en una sola tarjeta NVIDIA | Edge0-145B | Las mejores puntuaciones autoinformadas de Terminal-Bench y DeepSWE en su clase, 91.7 a 121.2 tok/s en tarjetas de 24 GB |
| La misma familia con menos sorpresas | Qwen3.8-Flash-Next | El modelo base, soporte de ejecución más amplio, puntuaciones cercanas en razonamiento |
| Un modelo local en una Mac hoy | Edge0-35B u otro modelo abierto listo para Metal | Edge0-145B aún no tiene runtime de macOS |
| Benchmarks independientes y sin hardware | DeepSeek V4 Flash o Kimi K3.1 Pro | Alojados, medidos por terceros, precios bajos por token |
| Calidad de frontera y estás dispuesto a pagarla | Claude Opus 5.5 o GPT-6 Sol | Todavía por delante en el razonamiento más difícil |
Si el costo es lo que te empuja a lo local, haz los números primero. Las guías de precios de la API de Anthropic y precios de la API de OpenAI te ayudan a comparar las facturas por token contra una GPU que también consume unos 120W mientras trabaja.
Mi veredicto sobre Edge0-145B
| Área | Puntuación | Nota |
|---|---|---|
| Ingeniería | 4.5/5 | Los expertos de matriz compartida y la transmisión desde SSD son un paso real para la inferencia local |
| Puntuaciones de codificación y agente | 4/5 | Fuertes, pero solo autoinformadas |
| Honestidad de las afirmaciones de lanzamiento | 2/5 | 29GB, macOS y "código abierto" necesitan todos matices |
| Facilidad de configuración | 2.5/5 | Compilar desde el código fuente, solo NVIDIA más CUDA 13, app solo para Windows |
| Licencia | 2.5/5 | Bien para uso interno, restrictiva para productos |
En general: 3/5. Si tienes una RTX 4090 o 5090 y quieres un agente de codificación local, vale una tarde. Si estás en una Mac, planeando un producto, o necesitas prueba independiente, espera el informe técnico y una tabla de puntuaciones de terceros. Los desarrolladores que ya usan Claude Code pueden probarlo a través de su endpoint local compatible con Anthropic, aunque yo mismo no he probado esa combinación.
Qué significa esta revisión para los equipos de soporte
El argumento que llegará a los líderes de soporte es la privacidad: corre el modelo en tu propio hardware y los datos de los tickets nunca salen del edificio. Entiendo el atractivo. En las llamadas de ventas, la pregunta sobre los datos suele ser la primera. Un evaluador técnico de una empresa de hardware de semiconductores nos preguntó si el bot recurriría a "algún otro ChatGPT" cuando no supiera una respuesta, y si eso se podía desactivar. Un comprador danés de telemática se preocupaba por los números de tarjeta y las contraseñas dentro de los tickets.
Ninguna de las dos preocupaciones era realmente sobre dónde corre el modelo. Ambas eran sobre lo que la IA tiene permiso para leer y decir. Un modelo local que responde desde su entrenamiento general sigue siendo el "otro ChatGPT" que preocupaba a ese evaluador. Lo que lo resolvió para ellos fue un agente que responde solo con conocimiento aprobado y dice cuándo no lo sabe, más la redacción de campos sensibles.
Así es como funciona eesel, y por eso enmarcaría a Edge0 como infraestructura mientras eesel es el empleado. Contratas a un compañero de equipo de IA para helpdesk que se une a tu helpdesk existente, aprende de tu centro de ayuda, tus macros y respuestas pasadas, y se simula contra tickets históricos antes de hablar con los clientes. La licencia de Edge0 también bloquearía la mayor parte de lo que hace un proveedor de soporte con un modelo, ya que un servicio de modelo comercial necesita un acuerdo aparte.
Dos clientes muestran cómo se ve una configuración cuidadosa. Dokument 24, un servicio danés de documentos legales, hace que eesel redacte respuestas en danés como notas internas a partir de unas 2,600 páginas web e ítems de Zendesk, y la nota lo indica cuando el conocimiento no cubre una pregunta. smava, una empresa alemana de comparación de préstamos en finanzas reguladas, hace pasar unos 27,000 tickets de Zendesk al mes por eesel, que categorizó 14,600 y preparó 15,300 respuestas borrador que esperan la aprobación de un asesor.
Para más sobre mantener a los bots con los pies en la tierra, mira nuestra guía sobre alucinaciones de IA en soporte, la explicación de MCP para soporte al cliente, y el resumen de plataformas de chatbot de código abierto si el autohospedaje es un requisito obligatorio.
Prueba eesel
Si estás leyendo una revisión de Edge0-145B porque tu equipo de soporte quiere IA sin entregar los tickets a una caja negra, empieza con la parte que realmente decide la privacidad y la precisión: lo que el agente lee y cuándo hace el traspaso. eesel se conecta con Zendesk, Freshdesk y los demás helpdesks principales, responde solo con tu conocimiento aprobado, y te deja ver cómo responde tickets pasados reales antes de salir en vivo. Los precios son un plan fijo de créditos mensuales, no por asiento.
Los desarrolladores pueden manejar el mismo espacio de trabajo desde el eesel CLI. Un agente de codificación, incluso uno apuntado a un modelo local, puede subir conocimiento aprobado como artículos de ayuda exportados y respuestas guardadas, ajustar las instrucciones del compañero de equipo, y hacer preguntas de prueba para verificar las respuestas. Conectar el propio helpdesk todavía necesita a alguien con acceso de administrador para aprobarlo.
Prueba eesel gratis, o reserva una demo para verlo correr en tus propios tickets.