

Edge0-145B es un modelo gratuito de código y agentes con pesos abiertos de 145B que corre en una sola GPU NVIDIA con 16 GiB de memoria más 20 GiB de RAM del sistema, manteniendo los expertos calientes en la tarjeta y leyendo el resto desde RAM y SSD. Es una versión fuertemente reelaborada de Qwen3.8-Flash-Next, y en las pruebas propias de Edge0 supera a esa base en código. Dos cosas que el post de lanzamiento pasa por alto: macOS aún no es compatible, y la licencia bloquea los servicios de modelo comerciales sin un acuerdo aparte. Si tu objetivo es IA en los tickets de soporte en lugar de una GPU local, eesel hace eso con modelos alojados, y el CLI de eesel deja que un agente de código suba artículos de ayuda aprobados y pruebe las respuestas antes de que nada salga en vivo.
¿Qué es Edge0-145B?
Edge0-145B es un modelo de lenguaje con pesos abiertos de Edge0, anunciado el 12 de noviembre de 2026 junto a un hermano más pequeño, Edge0-120B. El post de lanzamiento de Edge0 lo presenta como el primer modelo de 145.000 millones de parámetros construido para correr en una computadora personal, con habilidades de código, razonamiento y agentes cercanas a los modelos en la nube.
Yo construyo los agentes de IA dentro del producto de eesel, así que leo lanzamientos como este primero por el mecanismo y después por el marketing. Eso resultó importante aquí, porque la model card de Hugging Face y el repositorio de GitHub cuentan una historia más precisa que el post de lanzamiento. No tengo una tarjeta RTX en mi escritorio, así que todo lo que sigue viene de esos documentos y de las notas de la versión, no de una prueba propia. Para un veredicto sobre la calidad, el análisis de Edge0-145B de mi colega entra en eso por separado.
Esto es lo que Edge0 ha publicado sobre el modelo:
| Especificación | Edge0-145B |
|---|---|
| Parámetros totales | 145B, unos 10.12B activos por token |
| Modelo base | Derivado de Qwen3.8-Flash-Next |
| Arquitectura | Mezcla de expertos dispersa latente, 48 capas, 512 expertos por capa |
| Expertos por token | 10 enrutados más 1 compartido |
| Contexto | 256K tokens (caché KV en int8, 32K mantenidos en la GPU) |
| Builds | Q3_K con 40.81 GiB, NVFP4 con 47.79 GiB |
| Decodificación especulativa | Draft head integrado de 1.26B |
| Motor | edge0-strata, ejecutado a través de edge0-infer |
| Plataformas hoy | Linux y Windows, GPU NVIDIA con CUDA 13 |
| Licencia | Edge0 Community Model License 1.0 más la Qwen Community License |
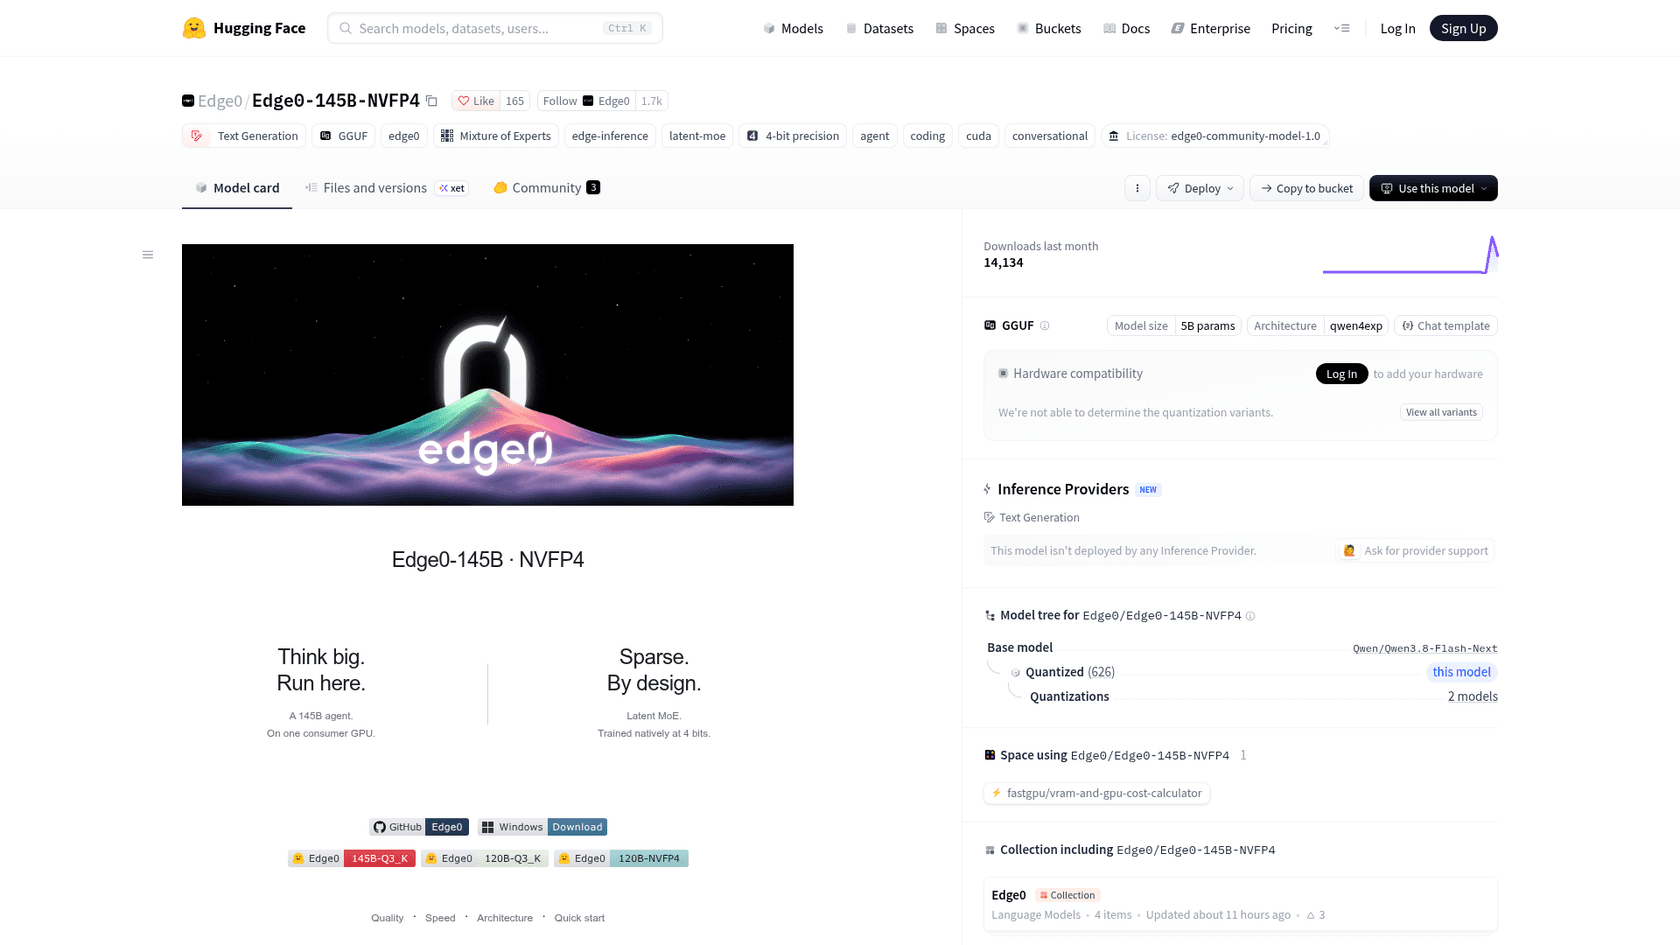
El modelo base es la parte que el post de lanzamiento entierra. La model card lista Qwen/Qwen3.8-Flash-Next como la base, y los agradecimientos acreditan tanto a Qwen como al motor de inferencia abierto Strata. Eso es práctica normal en los pesos abiertos, y es útil saberlo: si ya corres Qwen3.8-Flash-Next, Edge0-145B es una versión re-arquitecturada y reentrenada de un modelo que conoces, no una familia sin relación.
¿Cómo cabe un modelo de 145B en una sola GPU?
No cabe, no todo a la vez. El truco es que solo unos 10B de los 145B parámetros trabajan en cada token, así que el motor solo necesita tener esos cerca de la GPU. Edge0 combina cuatro ideas para lograrlo:
- Matrices de expertos compartidas. En un modelo normal de mezcla de expertos, cada experto guarda su propio conjunto completo de pesos. Edge0 proyecta cada token a un ancho "latente" más pequeño, y las grandes matrices de proyección se comparten entre expertos. Cada experto conserva solo un registro pequeño (alrededor de 1.6 MB), así que miles de ellos pueden caber en la memoria de la GPU.
- Tres niveles de almacenamiento. Los expertos usados con frecuencia viven en la GPU. El resto se queda en la RAM del sistema. Una tabla de búsqueda de 51.2B de parámetros que el modelo lee con moderación se queda en la SSD y se lee según se necesite.
- CPU y GPU juntas. La GPU calcula los expertos que ya tiene mientras la CPU maneja los demás en paralelo.
- Decodificación especulativa. Un pequeño draft head de 1.26B propone varios tokens, y el modelo principal los verifica en una sola pasada, lo que reparte el costo de leer pesos entre más salida.
Edge0 también entrenó el modelo con esta forma desde el inicio, en lugar de comprimir un modelo en la nube después. La arquitectura explica tanto la buena noticia (corre en una tarjeta gaming) como la trampa (depende mucho de la velocidad de la RAM del sistema y la SSD), de lo que trata la siguiente sección.
¿Qué hardware necesitas en realidad?
Aquí es donde el post de lanzamiento y los archivos de la versión no coinciden. El titular del post de lanzamiento es "29GB de memoria pico" en "una laptop personal compatible, como una MacBook Pro". Los archivos dan una imagen más completa.
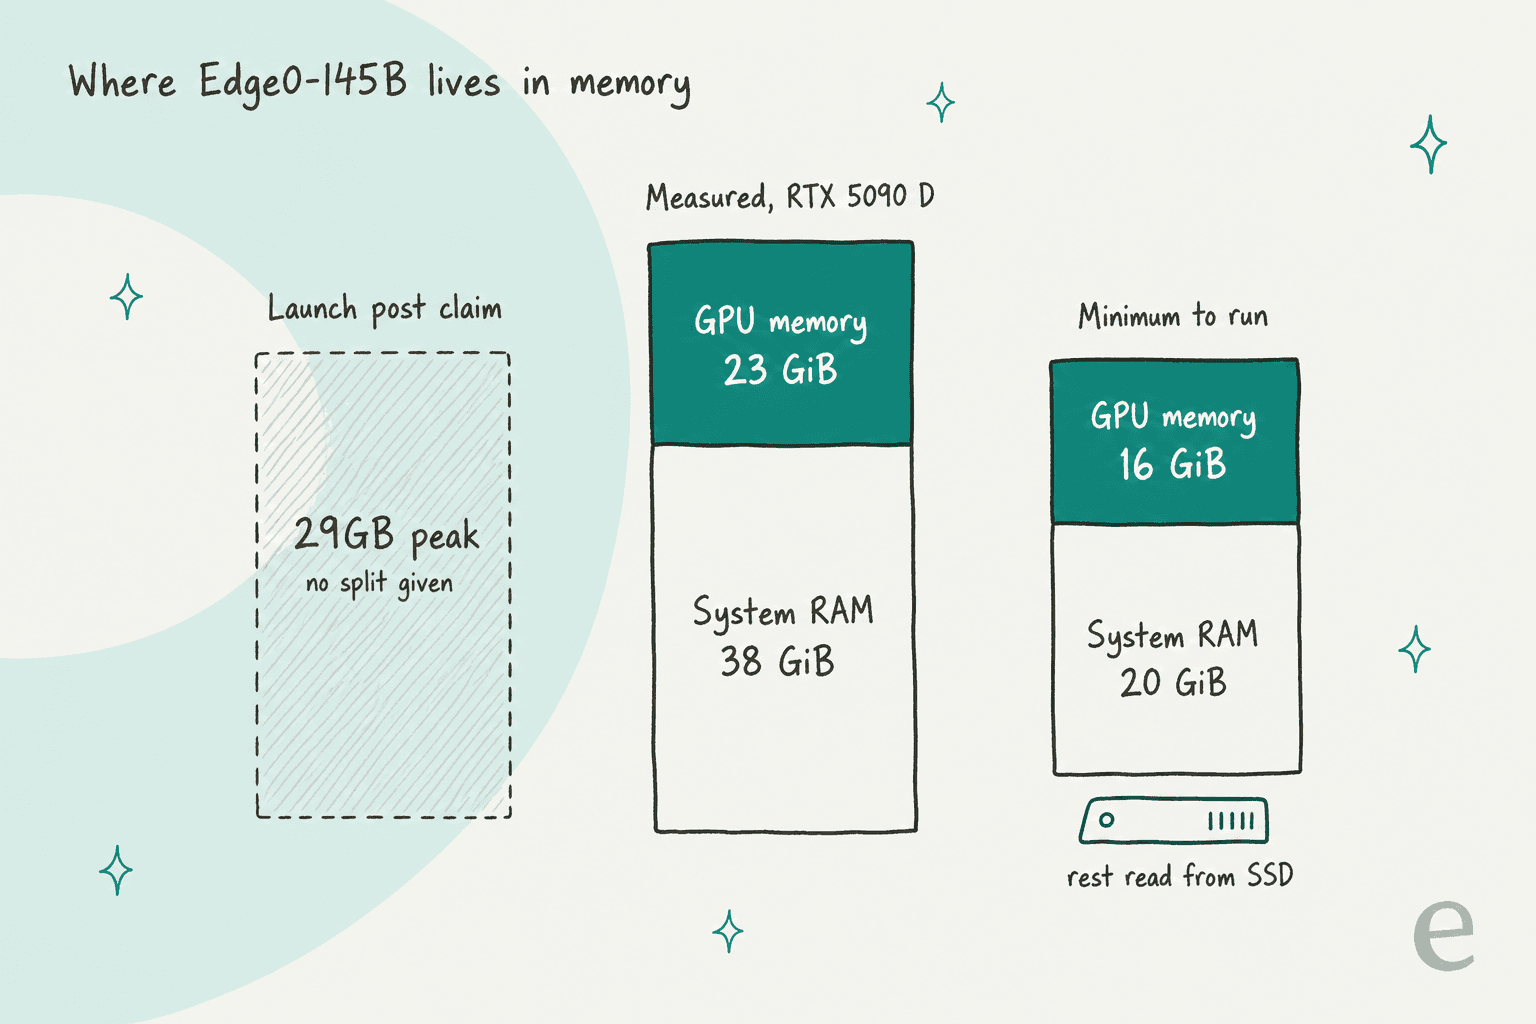
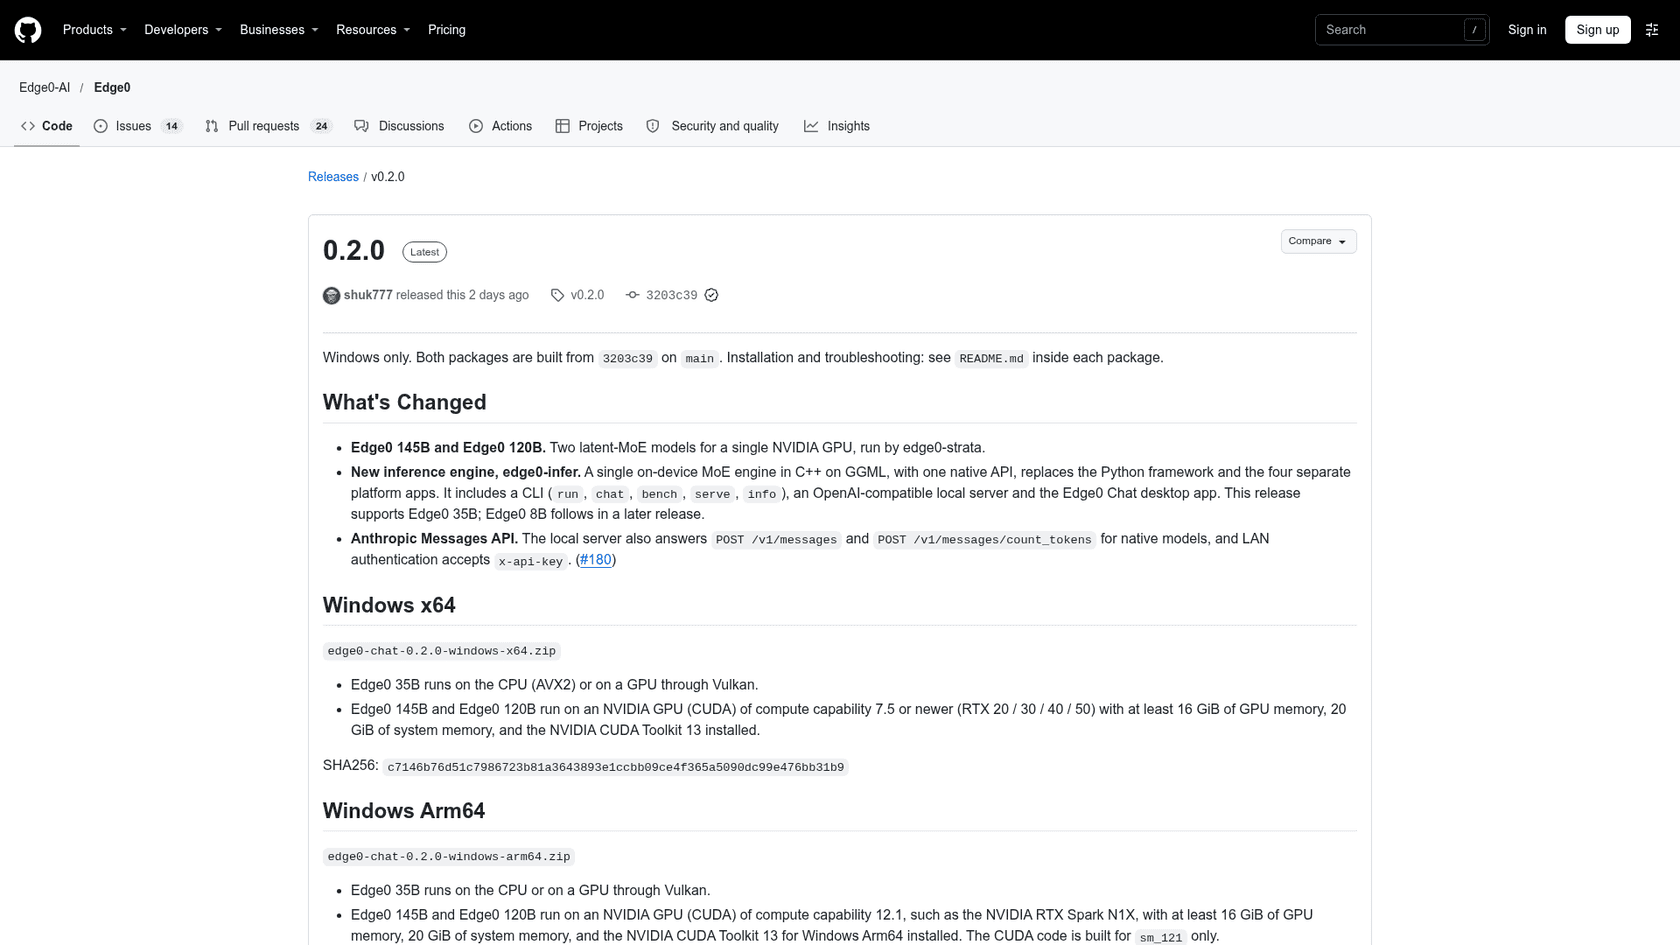
Las notas de la versión v0.2.0 fijan el mínimo para Windows x64: una GPU NVIDIA con capacidad de cómputo 7.5 o más reciente (series RTX 20, 30, 40 o 50), al menos 16 GiB de memoria de GPU, 20 GiB de memoria del sistema, y el CUDA Toolkit 13. En Windows Arm64 el objetivo es la RTX Spark N1X.
A toda velocidad usa más. La model card dice que, con la residencia activada, el build NVFP4 usó 23.25 GiB de VRAM más 38.27 GiB de RAM del host en una RTX 5090 D de 24 GB, y el build Q3_K usó 23.14 GiB más 31.28 GiB. Las cifras de 16 GiB más 20 GiB vienen de la misma tarjeta con límites aplicados, a menor velocidad.
La afirmación sobre la Mac es la brecha mayor. La tabla de plataformas del README de GitHub marca macOS como no compatible para los modelos de 145B y 120B, y la model card dice que su benchmark en Apple M2 Ultra "does not establish macOS release availability". Lectores en Hacker News lo notaron el primer día:
"The blog post mentions Mac repeatedly, saying things like 'day-one support covers macOS'. But the released stuff so far seems to be CUDA only."

Así que si estás en Apple Silicon, el Edge0-35B más pequeño es el modelo de Edge0 que corre hoy. Para algo más grande en una Mac, un modelo alojado como Qwen 3.8 Max o DeepSeek V4.1 Flash es la ruta práctica por ahora.
Elige tu máquina para ver dónde quedas:
¿Mi máquina puede correr Edge0-145B?
¿Qué tan rápido es Edge0-145B?
Rápido en la tarjeta correcta. La tabla de velocidad de la model card, toda de mediciones propias de Edge0, en tokens por segundo:
| Máquina | Build | Prefill 16K | Decode de chat | Decode de agente |
|---|---|---|---|---|
| RTX 5090 D 24 GB | Q3_K | 3,554.9 | 99.7 | 121.2 |
| RTX 5090 D 24 GB | NVFP4 | 3,165.7 | 79.6 | 98.3 |
| RTX 4090 24 GB | Q3_K | 3,179.4 | 69.9 | 91.7 |
| RTX Spark N1X 60 GiB | NVFP4 | 922.4 | 40.1 | 46.0 |
| Apple M2 Ultra (Metal) | Q3_K | 800.3 | 60.9 | 57.0 |
| 16 GiB VRAM + 20 GiB RAM | Q3_K | 335 | 36.8 | 44.9 |
El "decode de agente" corre más rápido que el chat porque la salida del agente (código, llamadas a herramientas) es más predecible, así que las suposiciones del draft head aciertan más seguido. Dos notas prácticas: el build Q3_K es más chico y más rápido que NVFP4 en la misma tarjeta, y la RTX 5090 D es una variante para el mercado chino de la 5090, así que una 5090 estándar debería ser al menos igual de rápida.
¿Qué tan bueno es, según Edge0?
En las evaluaciones internas de Edge0, Edge0-145B supera a su base Qwen en las dos pruebas de agentes y código, y queda un poco detrás en conocimiento:
| Modelo | DeepSWE 1.1 | Terminal-Bench 2.1 | GPQA-Diamond | IFBench | HLE | AA-LCR |
|---|---|---|---|---|---|---|
| Edge0-145B | 64.6 | 86.5 | 90.4 | 80.6 | 35.4 | 79.3 |
| Qwen3.8-Flash-Next | 58.7 | 83.3 | 91.7 | 81.3 | 35.9 | 79.1 |
| DeepSeek-V4-Flash-0731 | 54.4 | 82.7 | 90.8 | 79.2 | 33.8 | 79.7 |
| Qwen3.8-27B | 42.2 | 73.0 | 89.2 | 79.5 | 30.8 | 82.0 |
| Claude-Opus-4.6 (Max) | n/a | 78.2 | 91.3 | 62.5 | 40.0 | 78.0 |
Tres advertencias antes de confiar en esas cifras. Primero, Edge0 las corrió por su cuenta, y un informe técnico completo con pasos de reproducción está prometido pero aún no ha salido. Segundo, la comparación en la nube es con Claude Opus 4.6, dos generaciones por detrás del actual Claude Opus 5.5 y Claude Fable 5.2. Tercero, las propias páginas de Edge0 no coinciden en el 120B: el post de lanzamiento le da 53.6 en DeepSWE y 81.3 en Terminal-Bench, mientras el README de GitHub dice 51.3 y 75.3.
Terminal-Bench sigue siendo una señal útil para el trabajo con agentes, como señaló un desarrollador:
"TerminalBench scores often correspond to real world performance for coding agents that rely heavily on bash."
Si quieres una forma más amplia de juzgar modelos en tus propias tareas, mis notas sobre benchmarking de agentes de IA de soporte y la recopilación de herramientas de seguimiento de LLM cubren el método.
¿Cómo instalas y ejecutas Edge0-145B?
Hay dos rutas, y ambas necesitan la configuración de NVIDIA de arriba.
La app de escritorio (solo Windows). Descarga edge0-chat-0.2.0-windows-x64.zip de la página de releases, descarga una carpeta de modelo desde Hugging Face, abre Edge0 Chat y elige la carpeta. Edge0 dice que las funciones principales de la app funcionan sin conexión, sin cuenta ni cuota de uso.
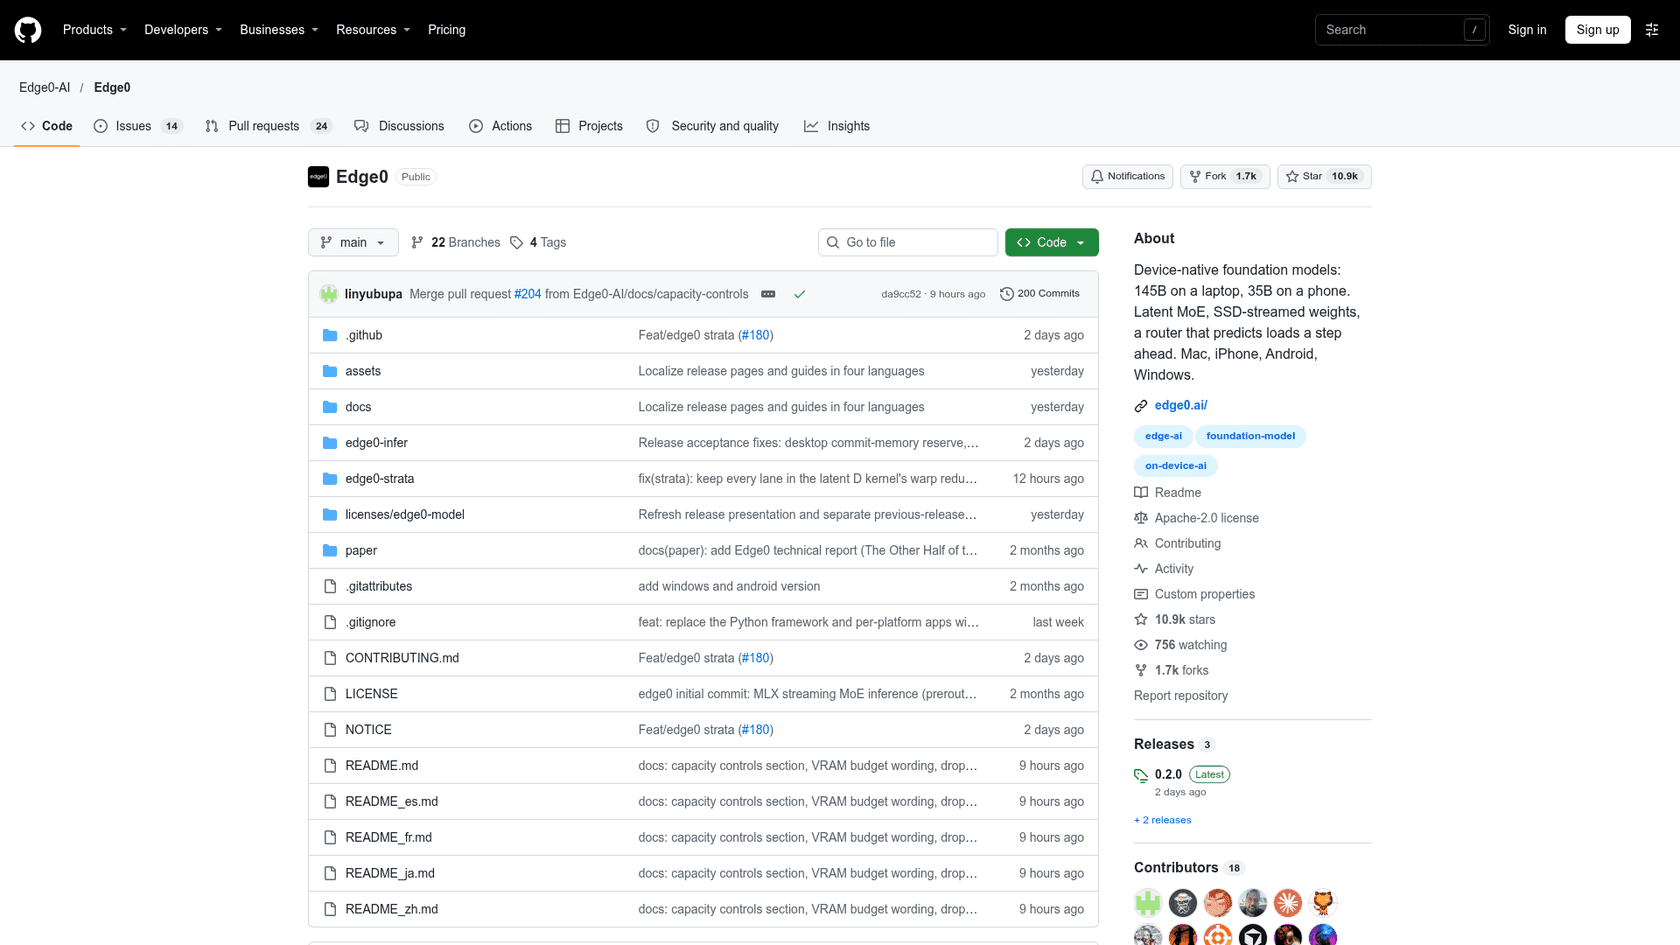
La línea de comandos (Linux o Windows). Clona el repositorio, compila el motor edge0-strata y edge0-infer siguiendo las instrucciones del repositorio, y luego apúntalo a una carpeta de modelo:
git clone https://github.com/Edge0-AI/Edge0.git edge0
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-Q3_K
Una vez que los pesos cargan, imprime Listening: http://127.0.0.1:8000 y sirve endpoints compatibles con OpenAI y Anthropic bajo el nombre de modelo edge0_145b. edge0-infer chat abre una sesión interactiva en su lugar.
Dos configuraciones importan más si la memoria está ajustada. --mmap-experts lee los expertos sin caché desde la SSD en lugar de mantenerlos en RAM, y --resident-budget-gib 20 limita la caché de expertos en RAM a 20 GiB, lo que necesita un archivo de perfil de expertos estático. Ambas viven en el model.json de la carpeta del modelo, así que la app y el CLI las toman.
Usarlo desde un agente de código
Porque el servidor local habla el formato de Anthropic Messages, las herramientas que aceptan una base URL propia pueden, en principio, apuntar ahí. Para Claude Code, eso significa configurar ANTHROPIC_BASE_URL a http://127.0.0.1:8000 y elegir edge0_145b como modelo, el mismo patrón que para cualquier endpoint propio. Mis guías de variables de entorno de Claude Code y selección de modelo cubren las variables.
OpenClaw y otras herramientas compatibles con OpenAI pueden usar el endpoint /v1/chat/completions. No he probado ninguna de las dos rutas yo mismo, así que tómalo como la ruta documentada y no como una verificada.
¿Qué permite la licencia?
El post de lanzamiento llama a Edge0-145B "open-source". La licencia es más estrecha de lo que esa palabra sugiere, un punto que se planteó en minutos en Hacker News:
"This is not open source, this is open weights"
Según la model card, la Edge0 Community Model License 1.0 permite:
- Uso personal, investigación y modificación
- Compartir sin fines comerciales y uso interno en una empresa
- Uso comercial de las salidas generadas por el modelo
Requiere una licencia escrita separada de Edge0 para:
- Vender o empaquetar comercialmente el modelo
- Operar un servicio de modelo comercial
- Ofrecer un asistente comercial independiente de código u oficina construido sobre él
La licencia comunitaria de Qwen aplica además, ya que el modelo deriva de materiales de Qwen. El código del motor en sí es Apache-2.0. En la práctica: bien para la máquina propia de un desarrollador o una herramienta interna, no bien como motor de un producto que vendes sin hablar primero con Edge0. Mi recopilación de agentes de IA de código abierto lista herramientas con condiciones más sueltas si eso es un obstáculo.
¿Qué significa Edge0-145B para los equipos de soporte?
El atractivo para el soporte es obvio: datos de clientes que nunca salen de tu hardware, y ninguna factura por token. Esa es una preocupación real que escucho. En una llamada de ventas de eesel, un evaluador técnico en una empresa de hardware quería la garantía de que la IA respondería solo desde conocimiento aprobado, no desde la web o datos generales de entrenamiento, antes de seguir adelante.
Pero un modelo local responde una pregunta distinta. Dónde corre el modelo decide dónde se procesan los datos. Lo que le dice a un cliente depende de la capa que lo rodea: qué artículos de ayuda y tickets anteriores puede leer, qué hace cuando no encuentra una respuesta, cuándo traspasa a una persona, y si alguien lo probó antes con conversaciones reales. Un modelo de 145B en una tarjeta RTX llega sin nada de eso, y la licencia descarta convertirlo en un asistente de soporte comercial sin un acuerdo.
Esa capa es el trabajo del compañero de IA de eesel para el helpdesk. Se suma a la cola que ya corres en Zendesk o Freshdesk, responde desde tu propio conocimiento, y se simula contra tickets anteriores antes de salir en vivo.
SE Ranking corre un agente de eesel por producto en Zendesk a través de tres productos, manejando 4,650 conversaciones en un mes desde unas 16,800 páginas de conocimiento, con reembolsos y solicitudes de una persona traspasados al equipo. Innr, una empresa holandesa de iluminación inteligente, hace que eesel redacte respuestas de Freshdesk en el propio idioma del cliente desde 1,500 artículos de ayuda y tickets anteriores.
Si estás evaluando modelos para tu propio contenido de soporte, mis guías sobre conectar Claude a tu helpdesk, MCP para soporte al cliente y traspasos de agentes de IA van más lejos de lo que puede una model card.
¿Deberías probar Edge0-145B?
Sí, si tienes una tarjeta RTX con 16 GiB o más, 32 GiB o más de RAM y una SSD rápida, y quieres un modelo de código local sólido sin factura por token. Usa el build Q3_K, córrelo en Claude Code o tu agente habitual en una tarea que ya hayas resuelto, y compáralo con tu modelo en la nube.
Espera, si estás en una Mac, en AMD, o planeas incluirlo dentro de un producto comercial. Las primeras dos necesitan soporte de plataforma que no está lanzado, y la tercera necesita una conversación de licencia. Mientras tanto, Qwen3.8-Flash-Next es la base a seguir, y mis textos sobre Qwen en general y Kimi K3 cubren las alternativas abiertas más cercanas.
Prueba eesel para IA en tu cola de soporte
Si la razón por la que miraste Edge0-145B fue IA que responda a tus clientes, eesel te lleva ahí sin comprar una GPU. Es un compañero de IA de helpdesk que se conecta a Zendesk, Freshdesk y otros helpdesks, responde solo desde tu centro de ayuda y tickets anteriores, y se prueba con conversaciones históricas antes de tocar una en vivo, como lo corre SE Ranking en tres productos. Mira los precios o prueba eesel gratis.
Preguntas frecuentes
¿Qué es Edge0-145B?
¿Qué hardware necesita Edge0-145B?
¿Puedo ejecutar Edge0-145B en una Mac?
¿Edge0-145B es de código abierto?
¿Cuánto cuesta Edge0-145B?
¿Cómo se compara Edge0-145B con Qwen3.8-Flash-Next?
¿Puedo usar Edge0-145B con Claude Code?
edge0-infer serve expone endpoints compatibles con OpenAI y Anthropic en 127.0.0.1:8000 con el nombre de modelo edge0_145b, así que las herramientas que aceptan una base URL propia pueden apuntar ahí. Configura ANTHROPIC_BASE_URL al servidor local y elige el modelo, como en mi guía de variables de entorno de Claude Code. Revisa la licencia antes de usarlo dentro de un producto comercial.