

llama.cpp v1.0.0 salió el 13 de noviembre de 2026, y el titular es una promesa, no un salto de velocidad: un cambio disruptivo en la API pública en C ahora implica un salto de versión mayor. Eso importa más si construyes sobre libllama. Los usuarios de servidor notarán primero la seguridad: llama-server ahora se niega a exponer herramientas en una dirección de red sin clave de API. Instálalo con una línea desde llama.app, o usa la nueva app Llama de 1 MB. ¿Quieres IA en tu cola de soporte en su lugar? eesel la ejecuta sobre modelos alojados, y la CLI de eesel deja que un agente de código suba artículos de ayuda y pruebe respuestas antes.
¿Qué es llama.cpp?
llama.cpp es un motor de código abierto que ejecuta modelos de lenguaje grandes y modelos de visión en tu propio hardware, escrito en C/C++ puro sin dependencias. El README describe el objetivo como inferencia de LLM "con una configuración mínima y rendimiento de última generación en una amplia gama de hardware", de forma local y en la nube.
Unos números dan la escala. El repositorio de GitHub tiene 135,055 estrellas y 25,608 forks bajo la licencia MIT, se creó el 10 de marzo de 2023, y el anuncio de la v1.0 dice que ahora admite más de 150 variantes de arquitectura de modelo. El proyecto lo dirige ggml-org, el equipo liderado por Georgi Gerganov que forma parte de Hugging Face.
Yo construyo integraciones y APIs para el producto de eesel, así que me importa menos el anuncio y más lo que un número de versión le hace al código que depende de él. Esa es la óptica de todo este artículo. Leí las notas de la versión, la política de versionado y los pull requests detrás de los cambios; no lo he probado en mi propia máquina, así que las cifras de velocidad de abajo vienen de los números de los propios mantenedores.
El motor central debajo es ggml, una librería de tensores con backends para casi cualquier chip que se te ocurra:
| Backend | Funciona en |
|---|---|
| Metal | Apple Silicon |
| CUDA | GPUs NVIDIA |
| HIP | GPUs AMD |
| Vulkan | La mayoría de las GPUs |
| SYCL | GPUs Intel |
| OpenCL | GPUs Qualcomm Adreno |
| Hexagon | Snapdragon |
| CANN | NPUs Huawei Ascend |
| WebGPU | Navegadores y cualquier dispositivo con WebGPU |
| CPU (AVX, NEON, RVV) | x86, Arm y RISC-V |
Ese alcance explica por qué tantas herramientas de IA local se construyen sobre esto. Si has usado una app de chat de escritorio para modelos abiertos, hay buenas probabilidades de que llama.cpp estuviera haciendo el trabajo. También es por eso que los modelos de pesos abiertos como Gemma 4 y Qwen3.8-Flash-Next suelen publicar archivos GGUF, el formato de modelo de llama.cpp, el primer día.
¿Qué promete en realidad la etiqueta v1.0?
Promete límites estables, no funciones nuevas. En el anuncio en Hugging Face, el equipo dice que tanto llama.cpp como ggml "reflejarán incompatibilidades de API y ABI con saltos de versión mayor". Las reglas ahora se aplican a todo proyecto de ggml-org:
| Salto de versión | Cuándo ocurre |
|---|---|
| Mayor (2.0.0) | Cambio disruptivo en la API pública en C en ./include |
| Menor (1.1.0) | Función compatible con versiones anteriores, actualización de backend, nuevo soporte de modelo o adición de API |
| Parche (1.0.1) | Corrección de bug sin cambio de API |
Esto es lo que la mayoría de la cobertura se salta: la promesa cubre los headers públicos en C, libllama y libggml. No dice nada sobre los flags de línea de comandos de llama-server, la interfaz web, o la app de escritorio. Esa distinción decide si v1.0 cambia algo para ti.
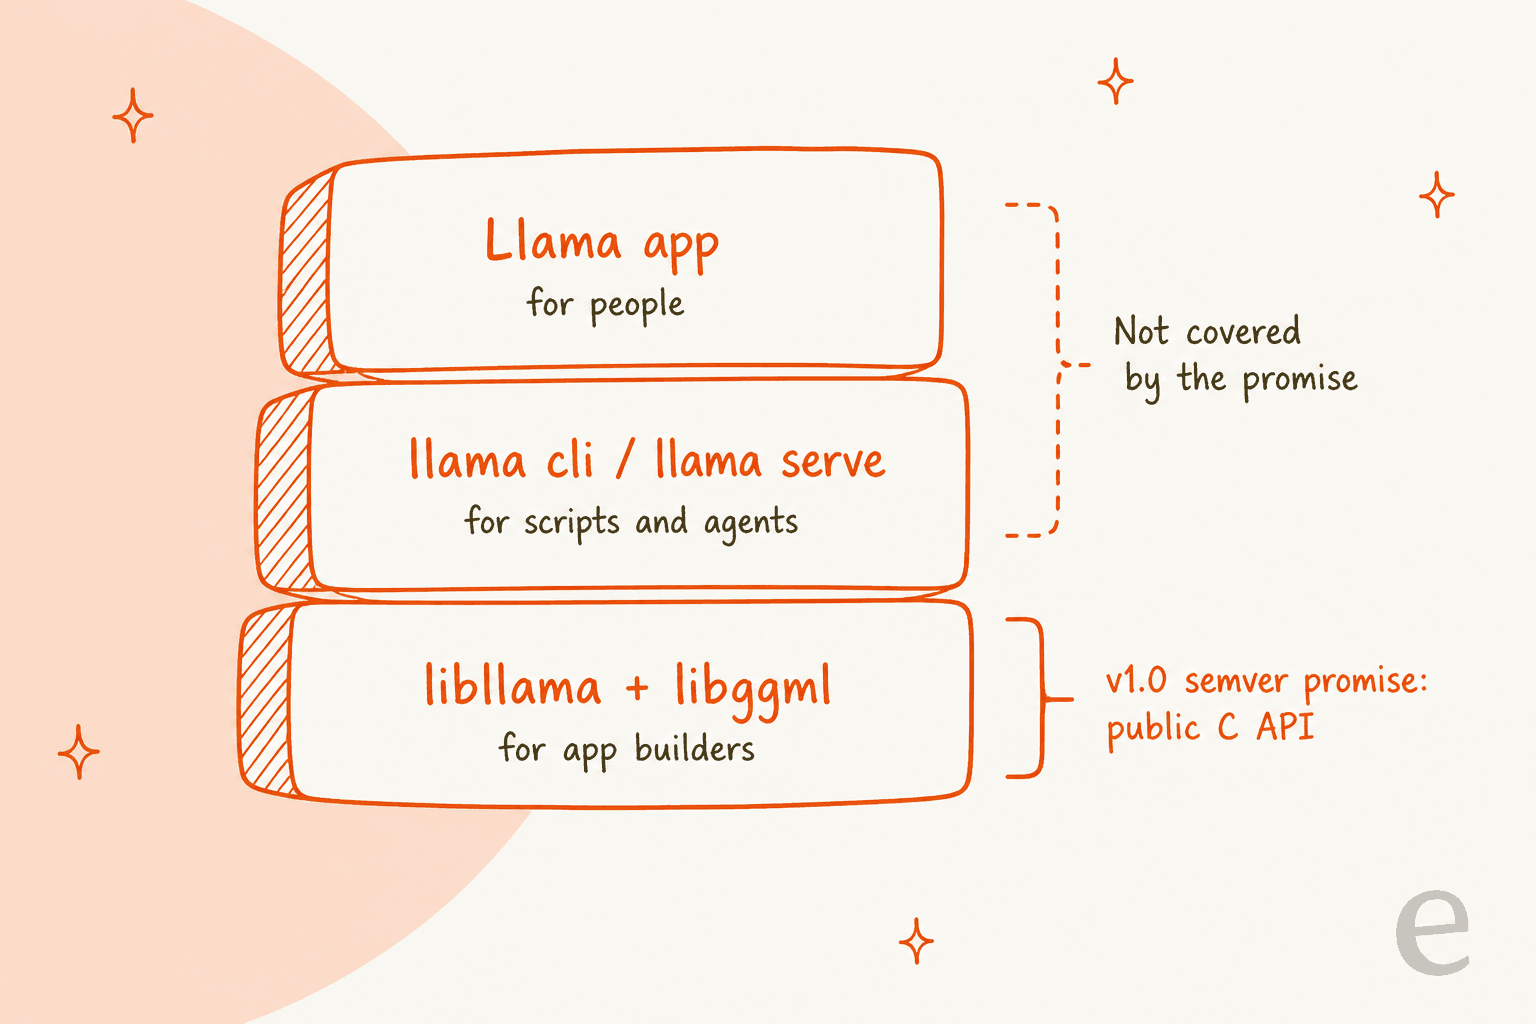
Si incrustas llama.cpp en una app, esta es la versión que has querido durante tres años. Los empaquetadores también la querían. En la discusión de versionado, alguien que lo empaqueta para Debian escribió que el versionado semántico "nos permitirá en Debian distribuirlo como librería en rutas de búsqueda públicas", porque los cambios disruptivos ahora se pueden señalar con saltos de versión de librería. Así es como llama.cpp deja de ser algo que vendorizas en tu repo y pasa a ser una librería del sistema.
Si solo ejecutas modelos a través de un servidor o una app, v1.0 es sobre todo un hito de limpieza. Útil, pero no una razón para reconstruir tu stack.
Las builds nocturnas siguen
Un detalle confunde a la gente. llama.cpp sigue publicando builds nocturnas etiquetadas por número de commits, como b12387, y publicó cinco solo el 14 de noviembre, según la página de releases. La etiqueta v1.0.0 es una vía separada y más lenta. Las notas de versionado dicen que una etiqueta de release solo se corta cuando la copia interna de ggml de llama.cpp coincide con el ggml publicado, así que cualquier cosa construida desde la etiqueta puede enlazarse con seguridad contra un ggml a nivel de sistema.
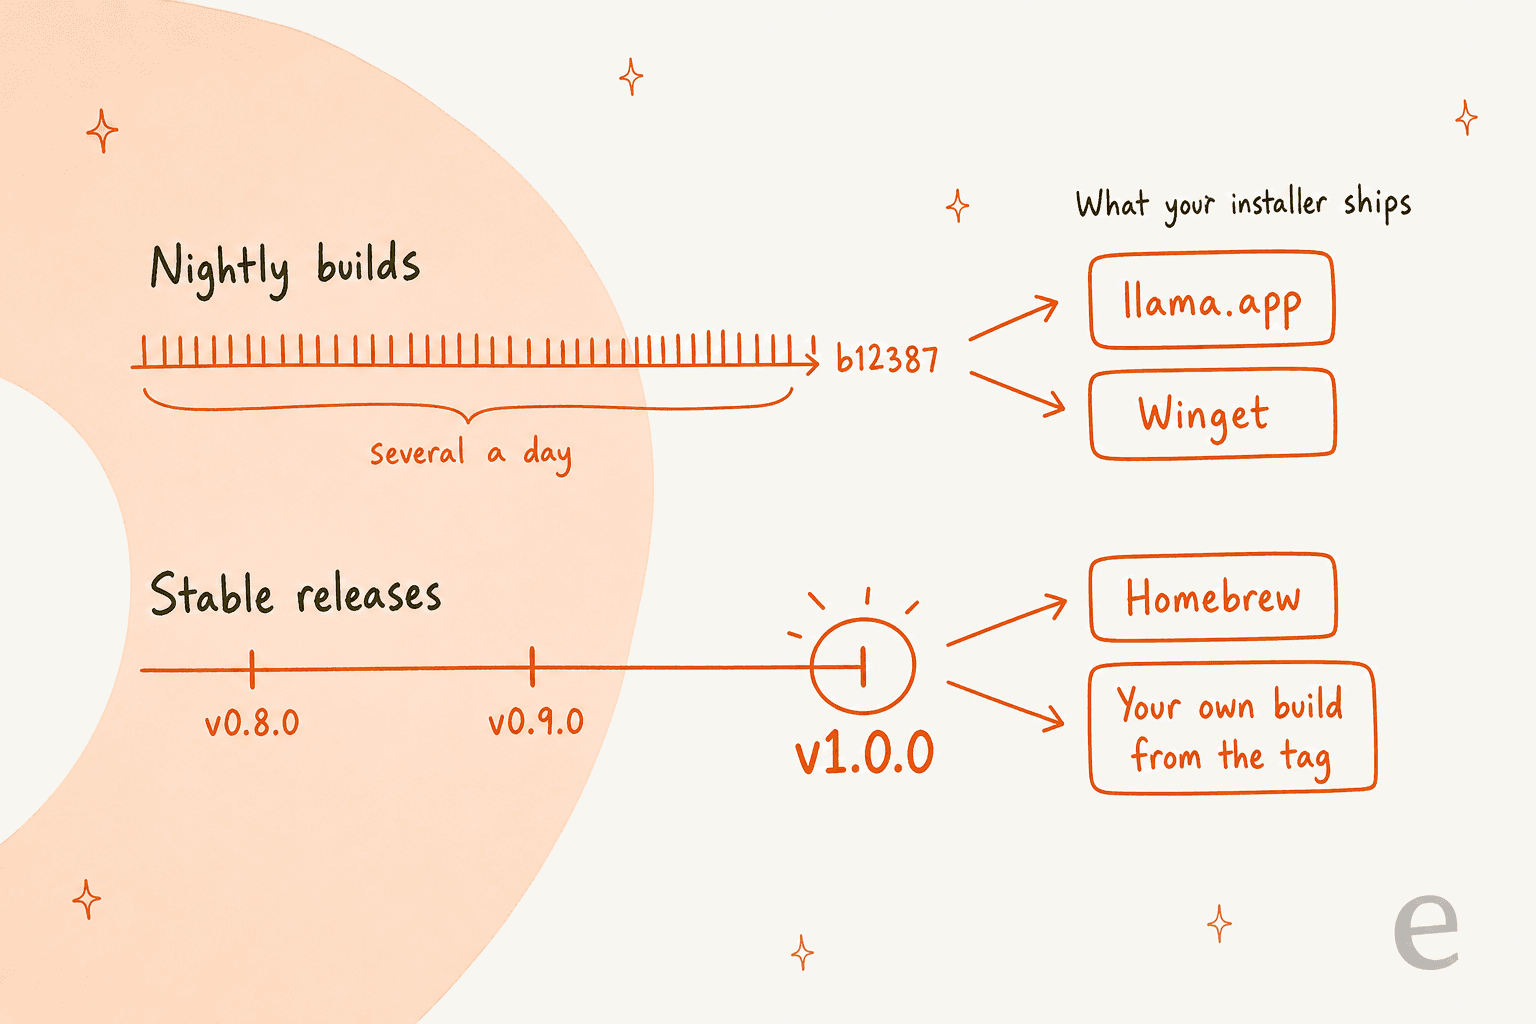
En qué vía estás depende de cómo lo instalaste. Según esas mismas notas, el instalador de llama.app y Winget publican las builds nocturnas, no los releases oficiales (marcado como pendiente de cambiar), mientras que la fórmula de Homebrew ahora se construye desde la etiqueta de release. Así que "estoy en v1.0" solo es verdad si lo has comprobado.
¿Qué cambió en llama.cpp v1.0.0?
Las notas de la versión cubren cientos de commits desde v0.9.0. Estos son los cambios que vale la pena conocer, agrupados por a quién afectan.
| Área | Cambio | A quién afecta |
|---|---|---|
| API en C | Elimina llama_set_warmup, 35 funciones obsoletas y --defrag-thold; mueve la API NextN (decodificación especulativa) de llama-ext.h a llama.h | A quien enlace libllama |
| Memoria | Cachés FP8 KV vía -ctk/-ctv f8_e4m3 | Usuarios de contexto largo con poca VRAM |
| Memoria | Caché de expertos MoE en memoria del host con una cuota de CPU configurable | Modelos grandes mixture-of-experts en GPUs pequeñas |
| Modelos | Kimi-K3.1-Pro, Ripple-65B-Preview, xing4_0, TTS drama-3; visión Kimi-K3.1 y MageVL-Cowork | Quien pruebe modelos abiertos nuevos |
| Servidor | Endpoint /v1/audio/speech; correcciones de seguridad para CORS, DNS rebinding y SSRF | Quien ejecute llama-server |
| Interfaz web | Grupos de chat, editor de markdown en vivo, diseño móvil, miniaturas de PDF | Gente que usa el chat integrado |
Modelos nuevos desde el primer día
Las arquitecturas nuevas coinciden con lanzamientos recientes que ya he cubierto: Kimi-K3.1-Pro, que las notas describen como K3 con sus capas de atención completa cambiadas por DSA, y Ripple-65B, añadido como nueva arquitectura densa de 65B. Si has leído mi reseña de Kimi K3 o la reseña de Ripple-65B, son los mismos modelos, ahora ejecutables localmente desde archivos GGUF.
Cachés FP8 KV
La caché KV es la memoria que un modelo usa para recordar la conversación hasta ahora, y en contextos largos puede rivalizar con el modelo mismo. El PR #28392 añade cachés FP8 OCP con escalas opcionales por tensor. No todo el mundo sabe todavía qué opción de 8 bits elegir:
"Sounds like now, 8 bit KV cache is ok for coding, but the question is which one? I see f8_e4m3, q8_0. Would be great to get more info about that."

Mi lectura: las notas de la versión no responden eso, así que prueba ambas en una sesión larga de tu propio trabajo antes de cambiar una configuración de código.
La caché de expertos MoE
Este es el cambio que más vigilaría. Los modelos mixture-of-experts solo usan una porción de sus pesos por token, así que el PR #30966 mantiene a los expertos activos en la memoria de la GPU y puede resolver los fallos de caché en la CPU. La prueba de ajuste del autor en Qwen3.8-Flash-Next muestra por qué importa la cuota de CPU: con una caché de 6,464 MiB, la decodificación pasó de 24.2 tokens por segundo sin cuota de CPU a 47.6 con una cuota de 0.95. Con una caché más grande de 19,392 MiB, los números se invierten y una cuota de CPU alta es más lenta. El PR trae un script de ajuste, scripts/moe-cache-tune.py, para encontrar tu propio punto óptimo en lugar de adivinar.
Es el mismo truco detrás de gigantes de una sola GPU como Edge0-145B, ahora integrado en el motor principal.
¿Qué cambió en la seguridad de llama-server?
Este es el cambio con más probabilidades de romper una configuración que funciona el día de la actualización. El PR #32113 significa que activar herramientas o MCP con un --host que no sea loopback y sin clave de API ahora se rechaza con un error. Tienes que añadir --api-key, o habilitarlo explícitamente con --allow-unauthenticated-tools.
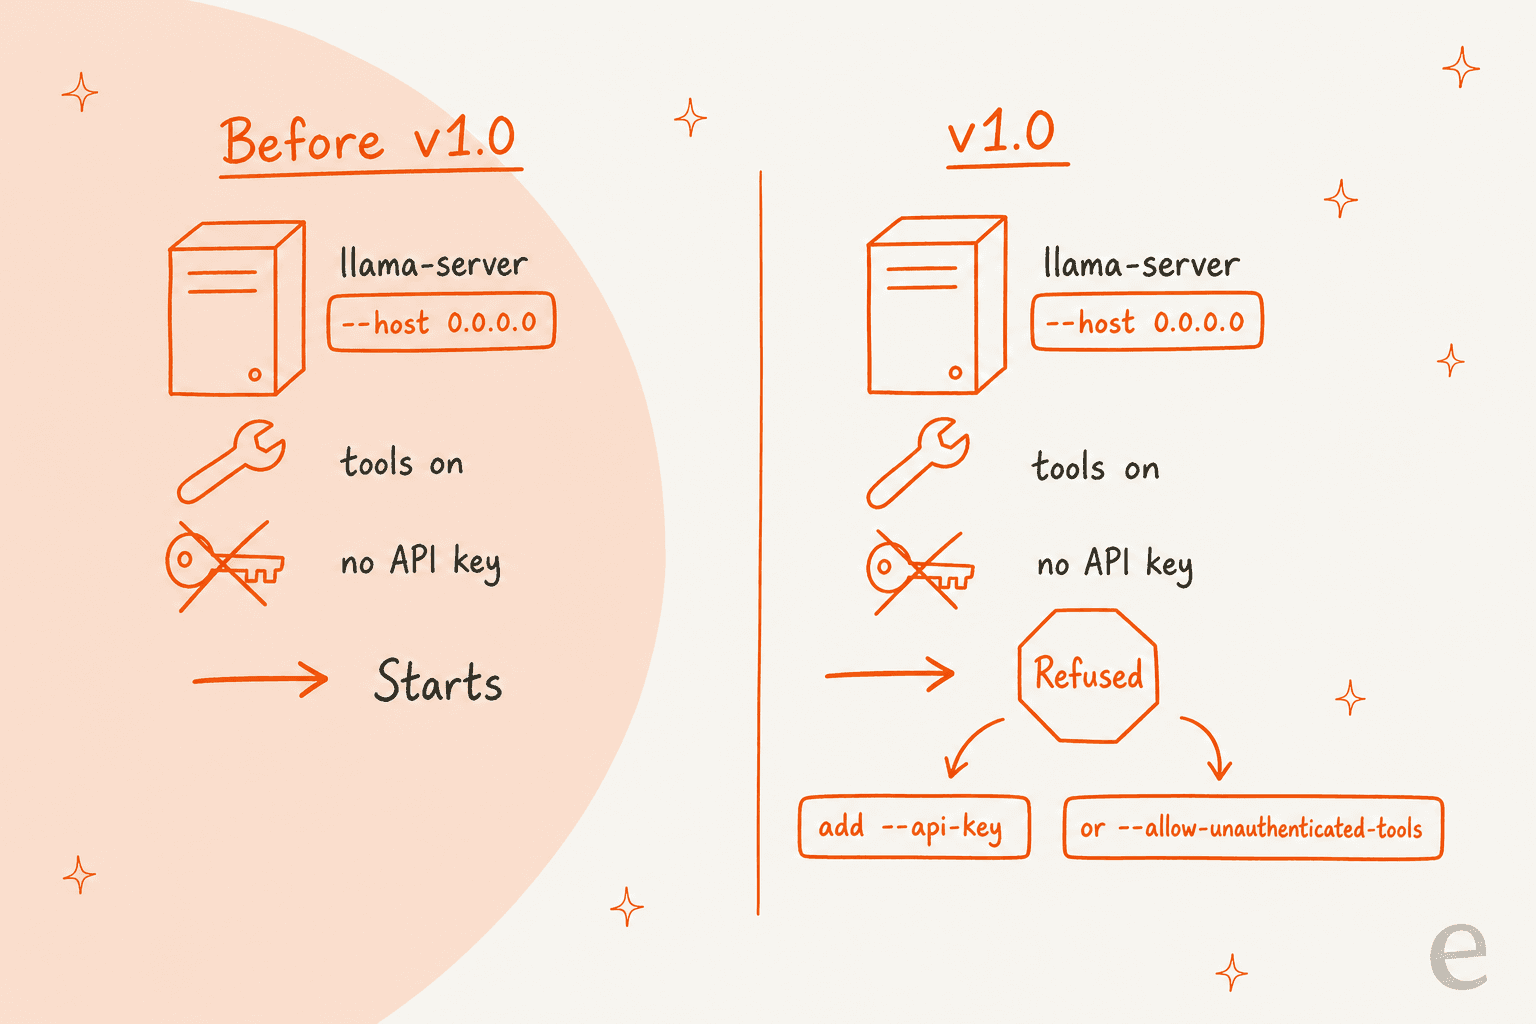
El mantenedor que lo escribió fue sincero sobre el tradeoff en la descripción del PR:
"None of those are actually vulnerability, but since people nitpick this too much, we now forced to hurt the UX a bit"
Yo seguiría optando por el valor predeterminado más estricto. Las herramientas en llama-server pueden leer archivos y ejecutar comandos de shell, y el conjunto integrado en la interfaz web incluye read_file, exec_shell_command y write_file. Dejar eso abierto en una LAN sin clave es el tipo de configuración que va bien hasta que alguien más en el Wi-Fi lo encuentra. El mismo release también restringe el HF_TOKEN a hosts de huggingface.co, corrige el manejo de --cors-origins y el DNS rebinding, añade una opción --media-allow-private-urls, y cancela las llamadas a herramientas de MCP cuando un cliente se desconecta.
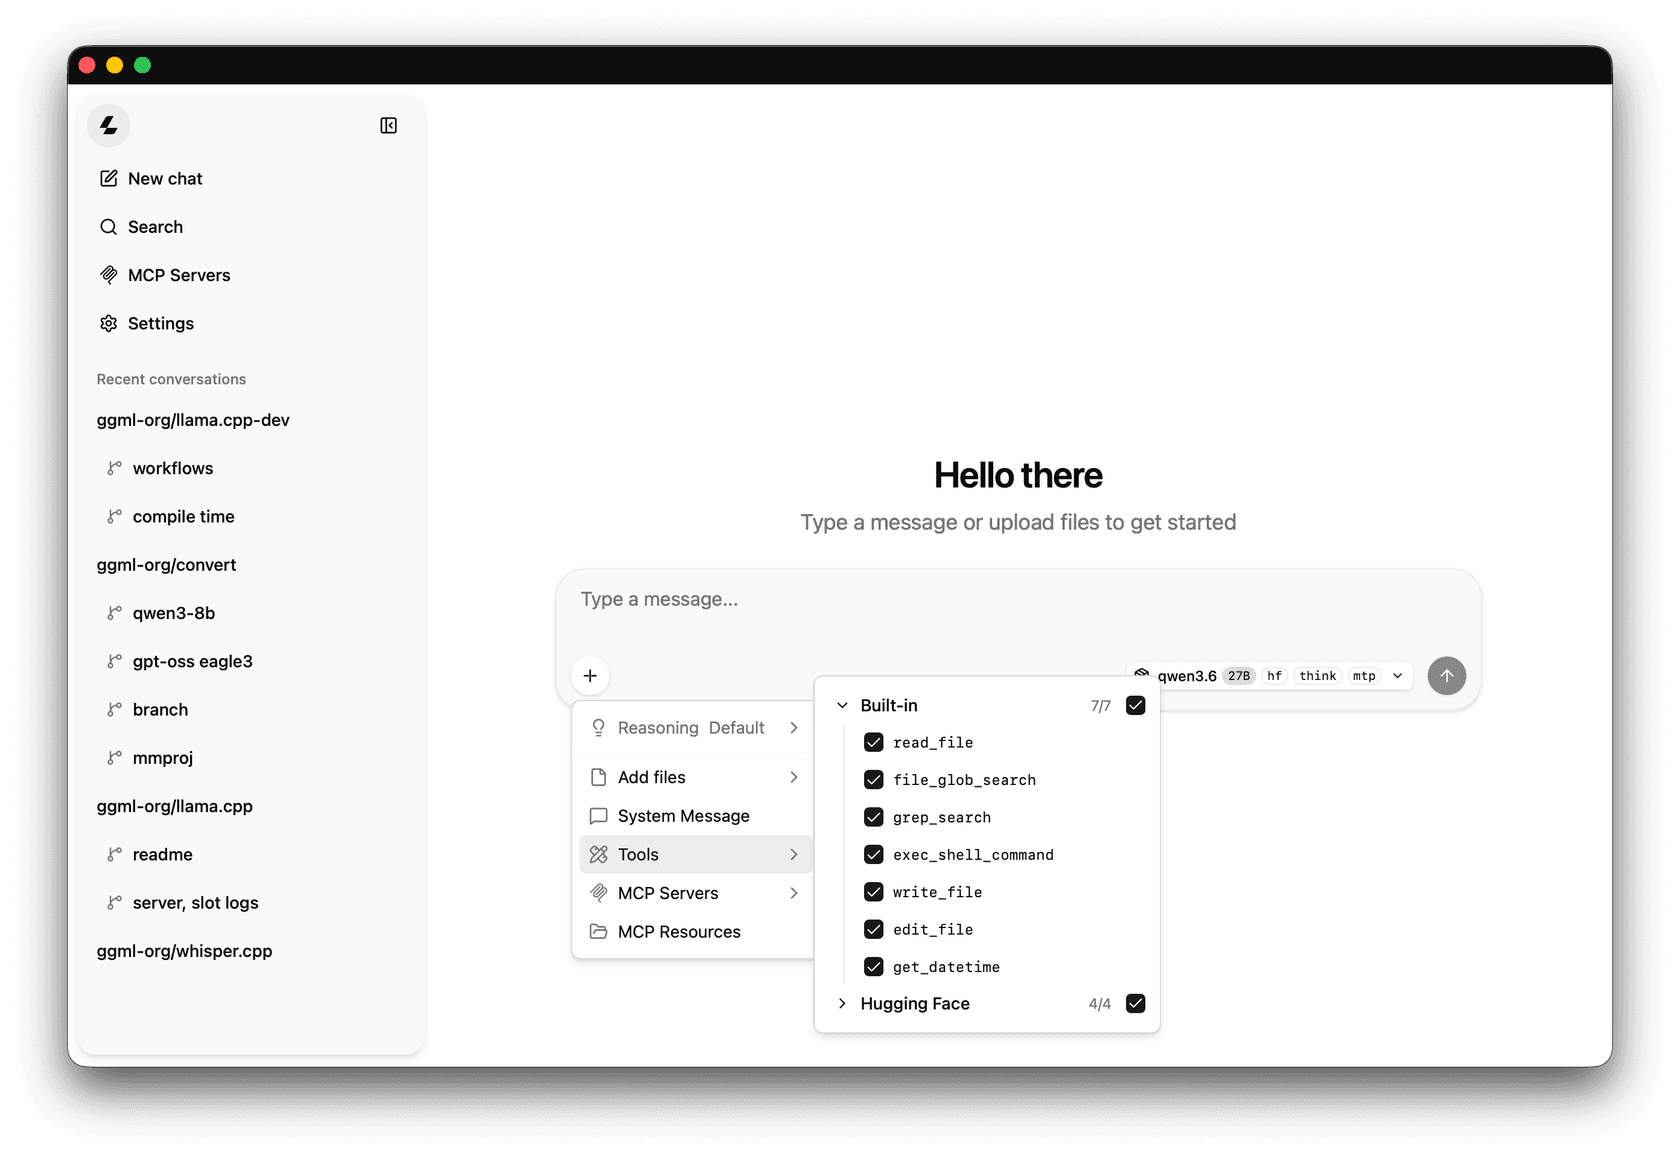
Si estás conectando un modelo local a algo que puede ejecutar acciones, mis notas sobre servidores MCP para agentes de IA y seguridad en Claude Code cubren el mismo principio: el acceso a herramientas es la superficie de ataque real, no el modelo.
¿Cambia algo llama.cpp v1.0 para ti?
Elige cómo lo usas y tendrás la versión corta.
¿Cómo usas llama.cpp?
--host que no es loopback y herramientas o MCP activados, v1.0 se niega a iniciar sin --api-key. Añade una clave en lugar de usar --allow-unauthenticated-tools. Revisa también cualquier valor de --cors-origins, ya que el puerto ahora se valida de forma estricta.llama_set_warmup y a las 35 funciones obsoletas, renombra llama_set_embd_state_src a llama_set_ctx_state_src, y fíjate en v1.x. Desde aquí, un cambio disruptivo en la API en C significa un 2.0.libggml a nivel de sistema y usar saltos de versión de librería para señalar cambios disruptivos.¿Cómo instalas y ejecutas llama.cpp?
Hay tres rutas, y la nueva es la más amigable. Todos los comandos de abajo vienen del README y de llama.app.
1. La app de escritorio Llama (Mac y Windows). El mismo equipo ahora distribuye Llama, una app de barra de menú en Mac y una app de bandeja de sistema en Windows 11. El sitio la lista como una descarga de 1 MB, 4 MB instalada, gratuita, de código abierto y capaz de funcionar sin conexión. Revisa tu hardware y elige la cuantización, el tamaño de contexto y la decodificación especulativa para cada modelo, y los modelos se descargan de memoria tras cinco minutos inactivos.
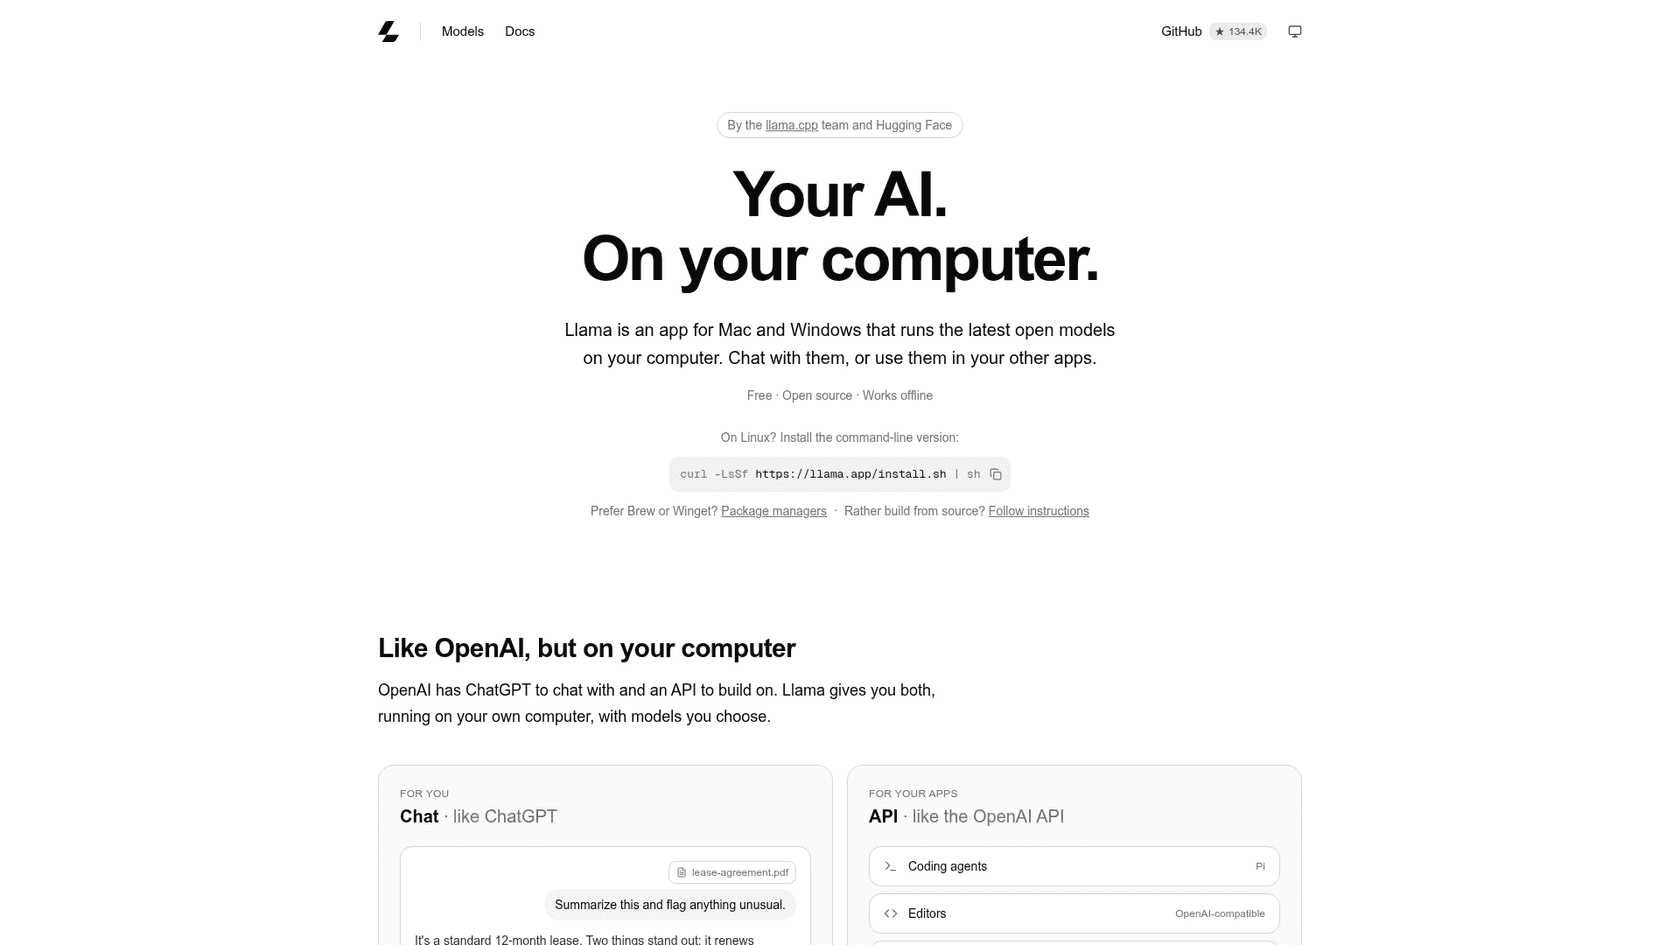
Sugiere un modelo inicial según la memoria: Gemma 4 para un Mac de 16 GB, GPT-OSS a 24 GB, y Qwen 3.8 a 32 GB. En Mac también puedes instalarla con brew install --cask llama-app.
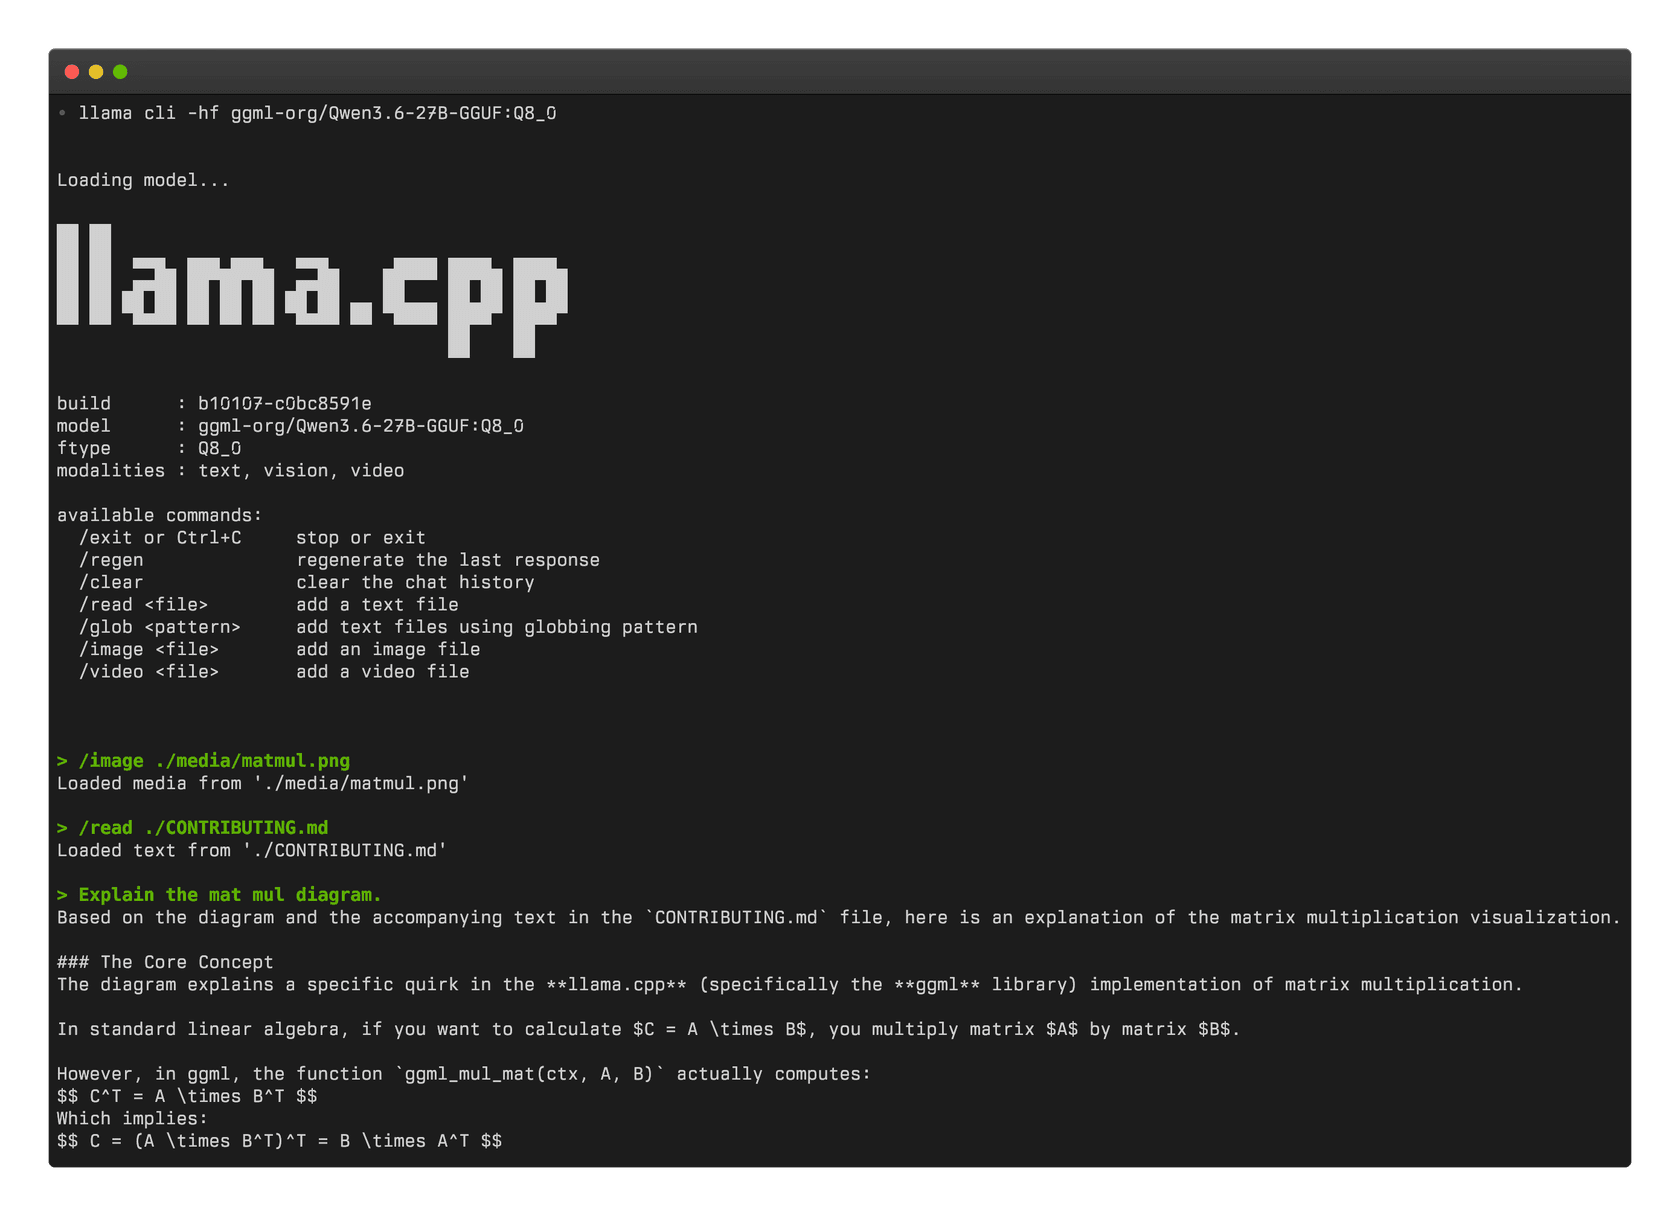
2. La línea de comandos (cualquier sistema operativo). Una línea instala el binario unificado llama:
curl -LsSf https://llama.app/install.sh | sh
En Windows PowerShell, es irm https://llama.app/install.ps1 | iex. Luego descarga un modelo de Hugging Face y chatea, o inicia un servidor compatible con OpenAI:
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
3. Gestores de paquetes o código fuente. El anuncio de la v1.0 lista Docker, Debian, Homebrew, conda-forge, MacPorts, Winget y un XCFramework para iOS y macOS, además de binarios precompilados para Linux, macOS, Windows, Android e iOS. Construir desde el código fuente está en la guía de build.
Apuntar agentes de código hacia él
La app Llama sirve su API en localhost:9931/v1, y el sitio dice que habla endpoints compatibles tanto con OpenAI como con Anthropic, con streaming, llamadas a herramientas, salida estructurada y visión. Eso significa que herramientas como Cursor, OpenClaw o Claude Code pueden apuntar a un modelo local cambiando solo la URL base, el mismo patrón que descrito en mi guía de variables de entorno de Claude Code. No he probado esa ruta yo mismo en v1.0, así que trátalo como la ruta documentada.
Una comprobación rápida de calidad: un modelo local pequeño no igualará a un modelo frontera alojado en trabajo de código difícil. Mis comparaciones de DeepSeek V4 Flash y Qwen 3.8 Max son una mejor guía de lo que puede hacer cada nivel.
¿Qué falta todavía?
Tres huecos destacan del release y de las reacciones a él.
- Sin app de escritorio para Linux. Llama es solo para Mac y Windows; los usuarios de Linux tienen la línea de comandos. Un comentarista en el anuncio preguntó justo por eso.
- Procesamiento de prompts en entradas enormes. Otro comentarista en la misma publicación dijo que llama.cpp "todavía necesita mejorar en el procesamiento de prompts enormes", es decir, el paso de prefill antes del primer token. El release trae trabajo de prefill (una ruta de FlashAttention para Vulkan en Intel, matmuls de pocas filas en CUDA), pero sin un número destacado al que señalar.
- Los instaladores aún no están en v1.0. Como se cubrió arriba, el instalador de llama.app y Winget todavía publican nightlies. Eso está bien para la mayoría de usuarios, pero significa que la promesa de estabilidad de v1.0 solo te llega si construyes desde la etiqueta o usas Homebrew.
Nada de esto es razón para saltártelo. Son razones para comprobar en qué build estás antes de confiar en la promesa.
¿Qué significa llama.cpp para los equipos de soporte?
El atractivo es obvio: datos de clientes que nunca salen de tu hardware, y sin factura por token. Es un tema que escucho en las llamadas de ventas de eesel. Un comprador de una empresa danesa de telemática B2B tuvo que superar una revisión interna de seguridad estricta antes de cualquier prueba, y su primera pregunta fue si los datos de tickets con números de tarjeta y contraseñas se quedarían en su entorno.
Un modelo local responde a parte de eso. No responde al resto: qué artículos de ayuda puede usar el agente, cuándo entrega un ticket a una persona, cómo saber que tiene razón antes de que los clientes lo vean. Esas son las preguntas detrás de la mayoría de las revisiones de seguridad de IA en soporte que he visto, y la lista de verificación de seguridad de proveedores y la guía de SOC 2 y GDPR las tratan en detalle.
Esa capa es el trabajo del compañero de IA de eesel para helpdesk. Se une a la cola que ya tienes en Zendesk o Freshdesk, responde desde tu propio conocimiento, y se simula contra tickets pasados antes de salir en vivo. smava, una empresa berlinesa de comparación de préstamos, lo usa en 27,000 tickets de Zendesk al mes, con 15,300 borradores de respuesta preparados en alemán a partir de 820 macros y artículos del centro de ayuda. SE Ranking ejecuta un agente de eesel por producto en Zendesk, con reembolsos y solicitudes de una persona entregados al equipo.
Si estás sopesando modelos para tu propio contenido de soporte, mis guías sobre conectar Claude a tu helpdesk, traspasos de agentes de IA y prevenir alucinaciones de IA en soporte van más allá de lo que puede dar una nota de release.
¿Deberías actualizar a llama.cpp v1.0?
Sí, si enlazas libllama: esta es la primera versión con una promesa de compatibilidad escrita, así que fíjate en v1.x y deja de perseguir cambios disruptivos en builds nocturnas. Haz la limpieza una vez y listo.
Sí, con cuidado, si ejecutas llama-server en una red: añade una clave de API antes de actualizar para que el nuevo control de herramientas no detenga tu servicio.
No necesitas hacer nada si usas una app de escritorio. Probablemente ya estás en una build nocturna que incluye todo lo de v1.0, y la nueva app Llama de Hugging Face es la forma más fácil de probar modelos locales si aún no lo has hecho. Para alternativas alojadas, mi resumen de alternativas a Hugging Face y mi lista de herramientas de seguimiento de LLM son buenas próximas lecturas.
Prueba eesel para IA en tu cola de soporte
Si te fijaste en llama.cpp porque quieres IA respondiendo a clientes, eesel te lleva ahí sin elegir una cuantización ni dimensionar una GPU. Es un compañero de IA para helpdesk que se conecta a Zendesk, Freshdesk y otros helpdesks, responde solo desde tu centro de ayuda y tickets pasados, y se prueba con conversaciones históricas antes de tocar una en vivo, igual que smava lo ejecuta en 27,000 tickets al mes. Con la CLI de eesel, tu agente de código puede subir artículos de ayuda y macros exportados, hacer preguntas de prueba y revisar las respuestas; conectar el helpdesk en sí todavía necesita a alguien con acceso de administrador. Prueba eesel gratis.
Preguntas frecuentes
¿Qué es llama.cpp?
¿Qué cambió en llama.cpp v1.0.0?
¿Es gratis llama.cpp?
¿Cómo instalo llama.cpp?
curl -LsSf https://llama.app/install.sh | sh; en Windows, ejecuta irm https://llama.app/install.ps1 | iex. Homebrew, Winget, Docker, conda-forge y binarios precompilados también funcionan. Luego llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF descarga un modelo desde Hugging Face y abre un chat.¿Rompe llama.cpp v1.0 mi configuración actual?
llama_set_warmup y la opción --defrag-thold ya no existen. Si ejecutas llama-server en una dirección de red con herramientas o MCP activados y sin clave de API, v1.0 se niega a iniciar hasta que añadas --api-key o lo habilites explícitamente con --allow-unauthenticated-tools. Mi guía de MCP para soporte al cliente explica por qué el acceso a herramientas merece esa barrera.¿Cuál es la diferencia entre llama.cpp y la app Llama?
localhost:9931/v1. Herramientas como Claude Code u OpenClaw pueden apuntar a ese endpoint local.¿Puede llama.cpp ejecutar un chatbot de soporte al cliente?
¿Es llama.cpp v1.0 la versión que obtengo del instalador?
llama --version, y mira mi entrada sobre precios de Hugging Face si piensas alojar modelos tú mismo.