

Resumen rápido
Nanbeige 4.3 es un modelo abierto gratuito de 33 mil millones de parámetros con licencia Apache 2.0 que supera a Qwen3.8-27B en 18 de las 20 comparativas que publicó su laboratorio, con las mayores ventajas en codificación agentiva: 65,5 frente a 42,5 en DeepSWE y 23,8 frente a 6,3 en Terminal-Bench 4.0. Se lanzó en Hugging Face el 24 de octubre de 2026, y Nanbeige lo define como un "profesor": el objetivo real es un Nanbeige4.3-3B destilado que aún no se ha enviado.
El truco está en la memoria. Es un modelo denso estándar de estilo Llama, por lo que su caché de contexto cuesta aproximadamente 0,2 MB por token. Con un contexto de 128K, eso supone unos 28 GB de caché además de unos 21 GB de pesos de 4 bits, lo que descarta a la mayoría de las GPU de consumo individuales.
Y si está pensando en usarlo para tareas de soporte, lea la letra pequeña: en el gráfico JobBench de la propia Nanbeige, obtuvo un 21,1 en tareas de servicio al cliente frente al 31,6 de Qwen. Un agente de soporte depende totalmente de la configuración de su helpdesk, no de una puntuación de codificación, razón por la cual equipos como smava ejecutan un compañero de helpdesk de IA listo para usar sobre modelos como este, en lugar de configurar uno ellos mismos.
¿Qué es Nanbeige 4.3?
Nanbeige 4.3 es la cuarta generación y media de modelos de Nanbeige LLM Lab, el equipo de IA dentro de BOSS Zhipin, la plataforma de reclutamiento china gestionada por Kanzhun Limited. La serie cuenta con un modelo público hasta ahora, Nanbeige4.3-33B, además de su modelo base sin ajustar. Ambos se publicaron el 24 de octubre de 2026, y el laboratorio lo anunció en X al día siguiente, donde la publicación alcanzó los 2.248 me gusta.
Como desarrollo integraciones y API en eesel, un nuevo modelo abierto siempre me suscita la misma primera pregunta: ¿qué se necesitaría para ejecutar esto realmente detrás de un producto real? Ese es el enfoque aquí.
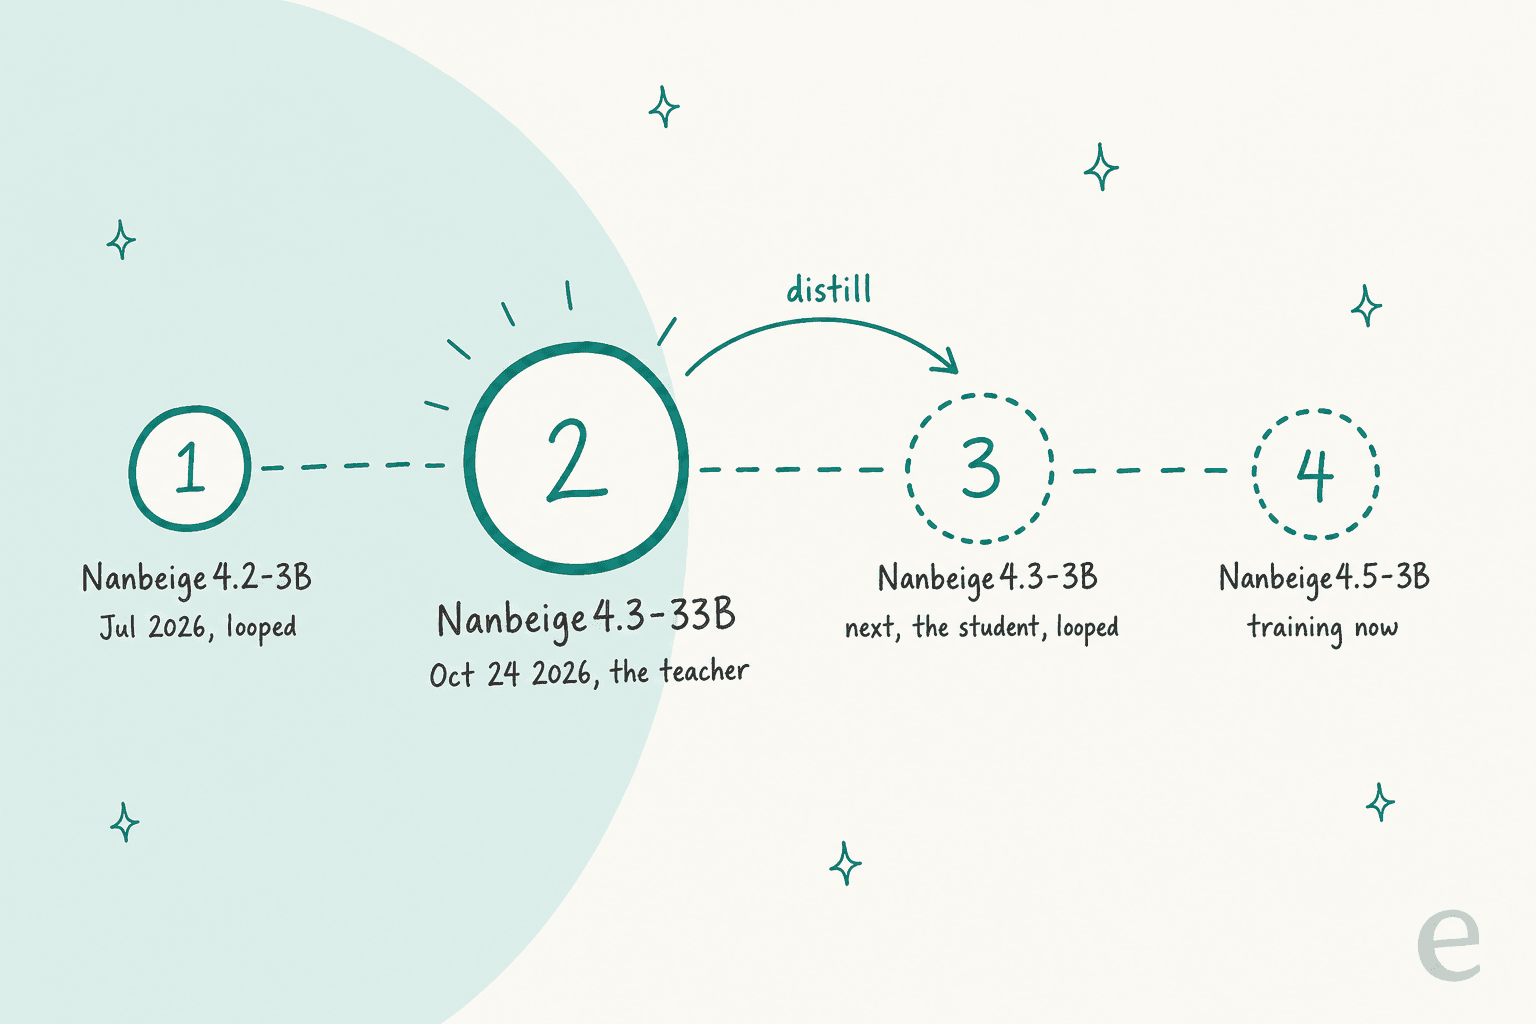
Lo interesante no es el tamaño. Nanbeige se dio a conocer con modelos de lenguaje pequeños: Nanbeige4.2-3B, un "Transformador en Bucle" de 3B que reutiliza sus capas para pensar más por token (la misma idea que llamó la atención en torno a GPT-6 Astra), tiene más de 116.000 descargas en el último mes. Entonces, ¿por qué lanzar un 33B? La tarjeta del modelo responde directamente: la estrategia es "construir primero un agente profesor de alta capacidad", para luego destilar sus habilidades en modelos pequeños, lo cual, según la publicación de lanzamiento, comenzará "con Nanbeige4.3-3B".
En otras palabras, el 33B es un paso en el camino. Es útil por sí mismo, pero el modelo que realmente le importa a Nanbeige es el estudiante de 3B.
Las especificaciones de un vistazo
Todo lo que aparece a continuación proviene de la tarjeta del modelo y del archivo de configuración en el repositorio.
| Especificación | Nanbeige4.3-33B |
|---|---|
| Parámetros | 33,1 mil millones, denso |
| Arquitectura | LlamaForCausalLM, 52 capas, 56 cabezales de atención, 8 cabezales de clave-valor |
| Ventana de contexto | 524.288 tokens (512K) |
| Entrada / salida | Solo texto, inglés y chino |
| Licencia | Apache 2.0 |
| Tamaño de los pesos | 66,2 GB en BF16 en 14 archivos |
| Variantes | Modelo Instruct y modelo Base |
| Modo de pensamiento | Activado por defecto, alternar con enable_thinking |
| Llamada a herramientas | XML recomendado, JSON compatible |
| Se ejecuta en | Transformers, vLLM, SGLang |
Una respuesta bajo la publicación de lanzamiento ahorró la descarga a mucha gente:
"33B denso, solo texto, sin visión, por si le ahorra tiempo a alguien"
¿Qué tan bueno es Nanbeige 4.3 en las comparativas?
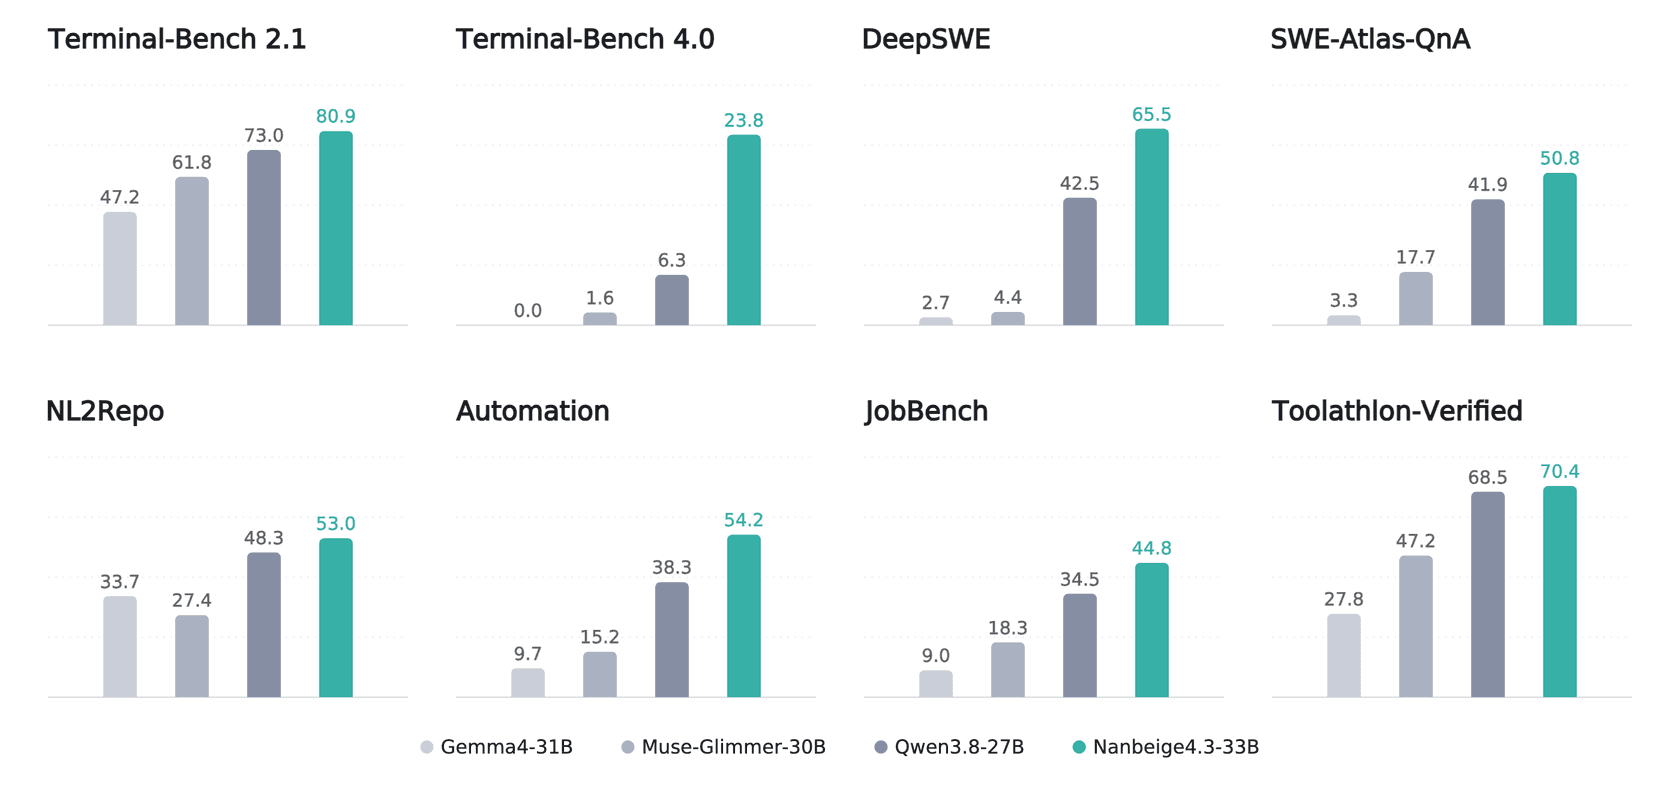
Muy bueno, sobre el papel. Nanbeige lo comparó con tres modelos abiertos de tamaño similar, todos en su nivel máximo de esfuerzo de pensamiento, y publicó 20 puntuaciones. Nanbeige4.3-33B supera a sus tres rivales en 17 de ellas y vence a Qwen3.8-27B, su competidor más cercano, en 18. Aquí está la tabla completa de la tarjeta del modelo:
| Comparativa | Nanbeige4.3-33B | Qwen3.8-27B | Muse-Glimmer-30B | Gemma4-31B |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 80,9 | 73,0 | 61,8 | 47,2 |
| Terminal-Bench 4.0 | 23,8 | 6,3 | 1,6 | 0,0 |
| DeepSWE | 65,5 | 42,5 | 4,4 | 2,7 |
| SWE-Bench Pro | 60,3 | 61,7 | 36,9 | 51,2 |
| SWE-Atlas-QnA | 50,8 | 41,9 | 17,7 | 3,3 |
| NL2Repo | 53,0 | 48,3 | 27,4 | 33,8 |
| Scicode | 52,6 | 46,7 | 44,9 | 45,5 |
| SkillsBench | 61,1 | 56,4 | 39,7 | 28,9 |
| Automation Bench | 54,2 | 38,3 | 15,2 | 9,7 |
| JobBench | 44,8 | 34,5 | 16,6 | 9,0 |
| GDPval | 84,8 | 86,4 | 75,8 | 71,4 |
| Claw-Eval (pass^3) | 78,3 | 75,2 | 57,3 | 44,2 |
| Toolathlon-Verified | 70,4 | 68,5 | 47,2 | 27,8 |
| DeepPlanning | 63,3 | 49,2 | 21,4 | 19,4 |
| EnterpriseOps-Gym | 41,0 | 40,2 | 30,5 | 27,3 |
| YC-bench | $1,025,437 | $641,290 | $513,978 | $265,152 |
| Tau3-Bench | 48,8 | 48,5 | 33,7 | 18,6 |
| GPQA Diamond | 89,5 | 89,2 | 83,5 | 91,3 |
| AIME 2026 | 95,2 | 94,5 | 94,7 | 89,2 |
| AA-LCR | 84,0 | 82,0 | 83,3 | 72,0 |
Las cifras de codificación son lo más destacado. Terminal-Bench 4.0 es una versión más nueva y mucho más difícil de la prueba de línea de comandos, y Nanbeige obtiene un 23,8 donde el siguiente mejor modelo de su clase saca un 6,3. DeepSWE cuenta la misma historia: 65,5 frente a 42,5. Si usted ejecuta un agente de codificación de terminal como Claude Code o OpenClaw contra un modelo local, esa es la diferencia que notaría. Mi guía de CLI de codificación agentiva explica en qué se diferencian estas estructuras.
Tres advertencias honestas antes de que nadie guarde esa tabla:
- Son las ejecuciones del propio laboratorio. Nanbeige utilizó la misma estructura y configuración para cada modelo, lo cual es justo, pero ningún probador independiente las ha repetido todavía. Artificial Analysis incluye modelos anteriores de Nanbeige, pero no este por ahora.
- La estructura importa. Terminal-Bench 2.1 se ejecutó en Terminus 2, DeepSWE en mini-swe-agent v2.4.6, NL2Repo dentro de Claude Code. La configuración de su agente modificará estos números.
- La letra pequeña fluctúa. El gráfico de barras y la tabla no coinciden en dos celdas (el JobBench de Muse-Glimmer es
18,3en el gráfico y16,6en la tabla). Es un detalle menor, pero conviene saberlo si se cita.
¿En qué falla Nanbeige 4.3?
Si miramos más allá de las filas de codificación, la ventaja se reduce rápidamente. Contra Qwen3.8-27B específicamente (un hermano menor de Qwen3.8 Max), se queda atrás en SWE-Bench Pro (60,3 frente a 61,7) y GDPval (84,8 frente a 86,4), y básicamente empata en Tau3-Bench, la comparativa que simula a un agente de IA atendiendo a clientes de una aerolínea o un minorista (48,8 frente a 48,5).
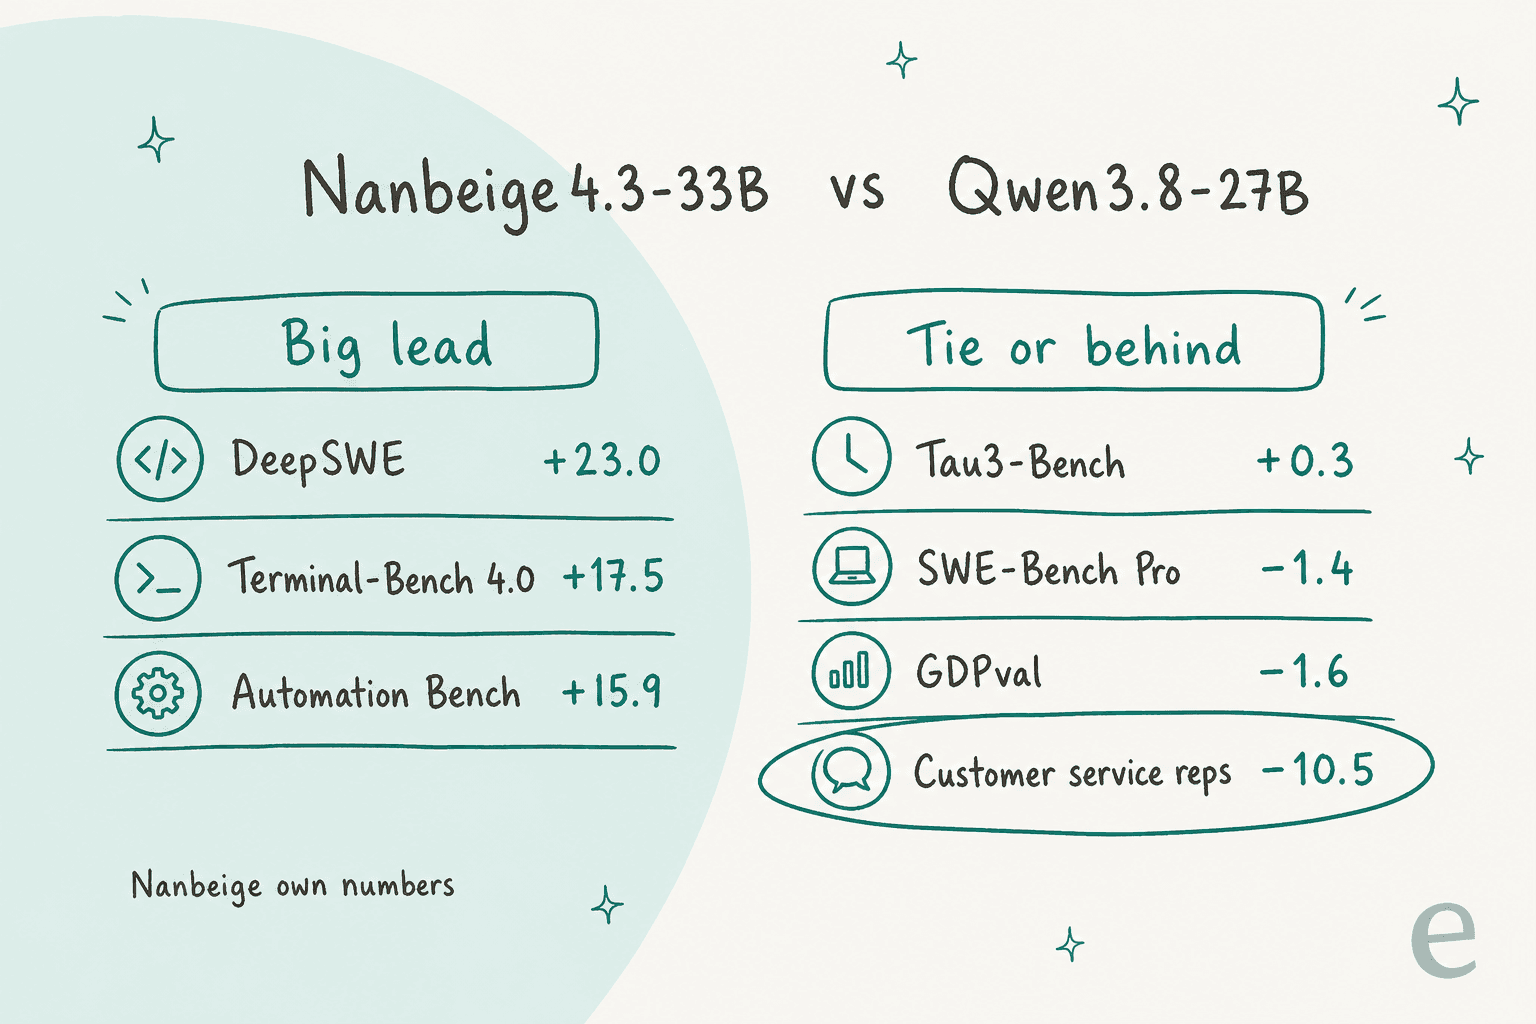
El detalle que yo destacaría se encuentra dentro del gráfico JobBench, que desglosa la puntuación en 35 ocupaciones. Nanbeige gana en la mayoría de ellas, y con gran margen en administradores web (72,0 frente a 36,0) y redactores técnicos (72,1 frente a 53,7). Pero en tareas de representante de servicio al cliente obtiene un 21,1 frente al 31,6 de Qwen, y también pierde en secretarios y asistentes administrativos (28,8 frente a 47,5).
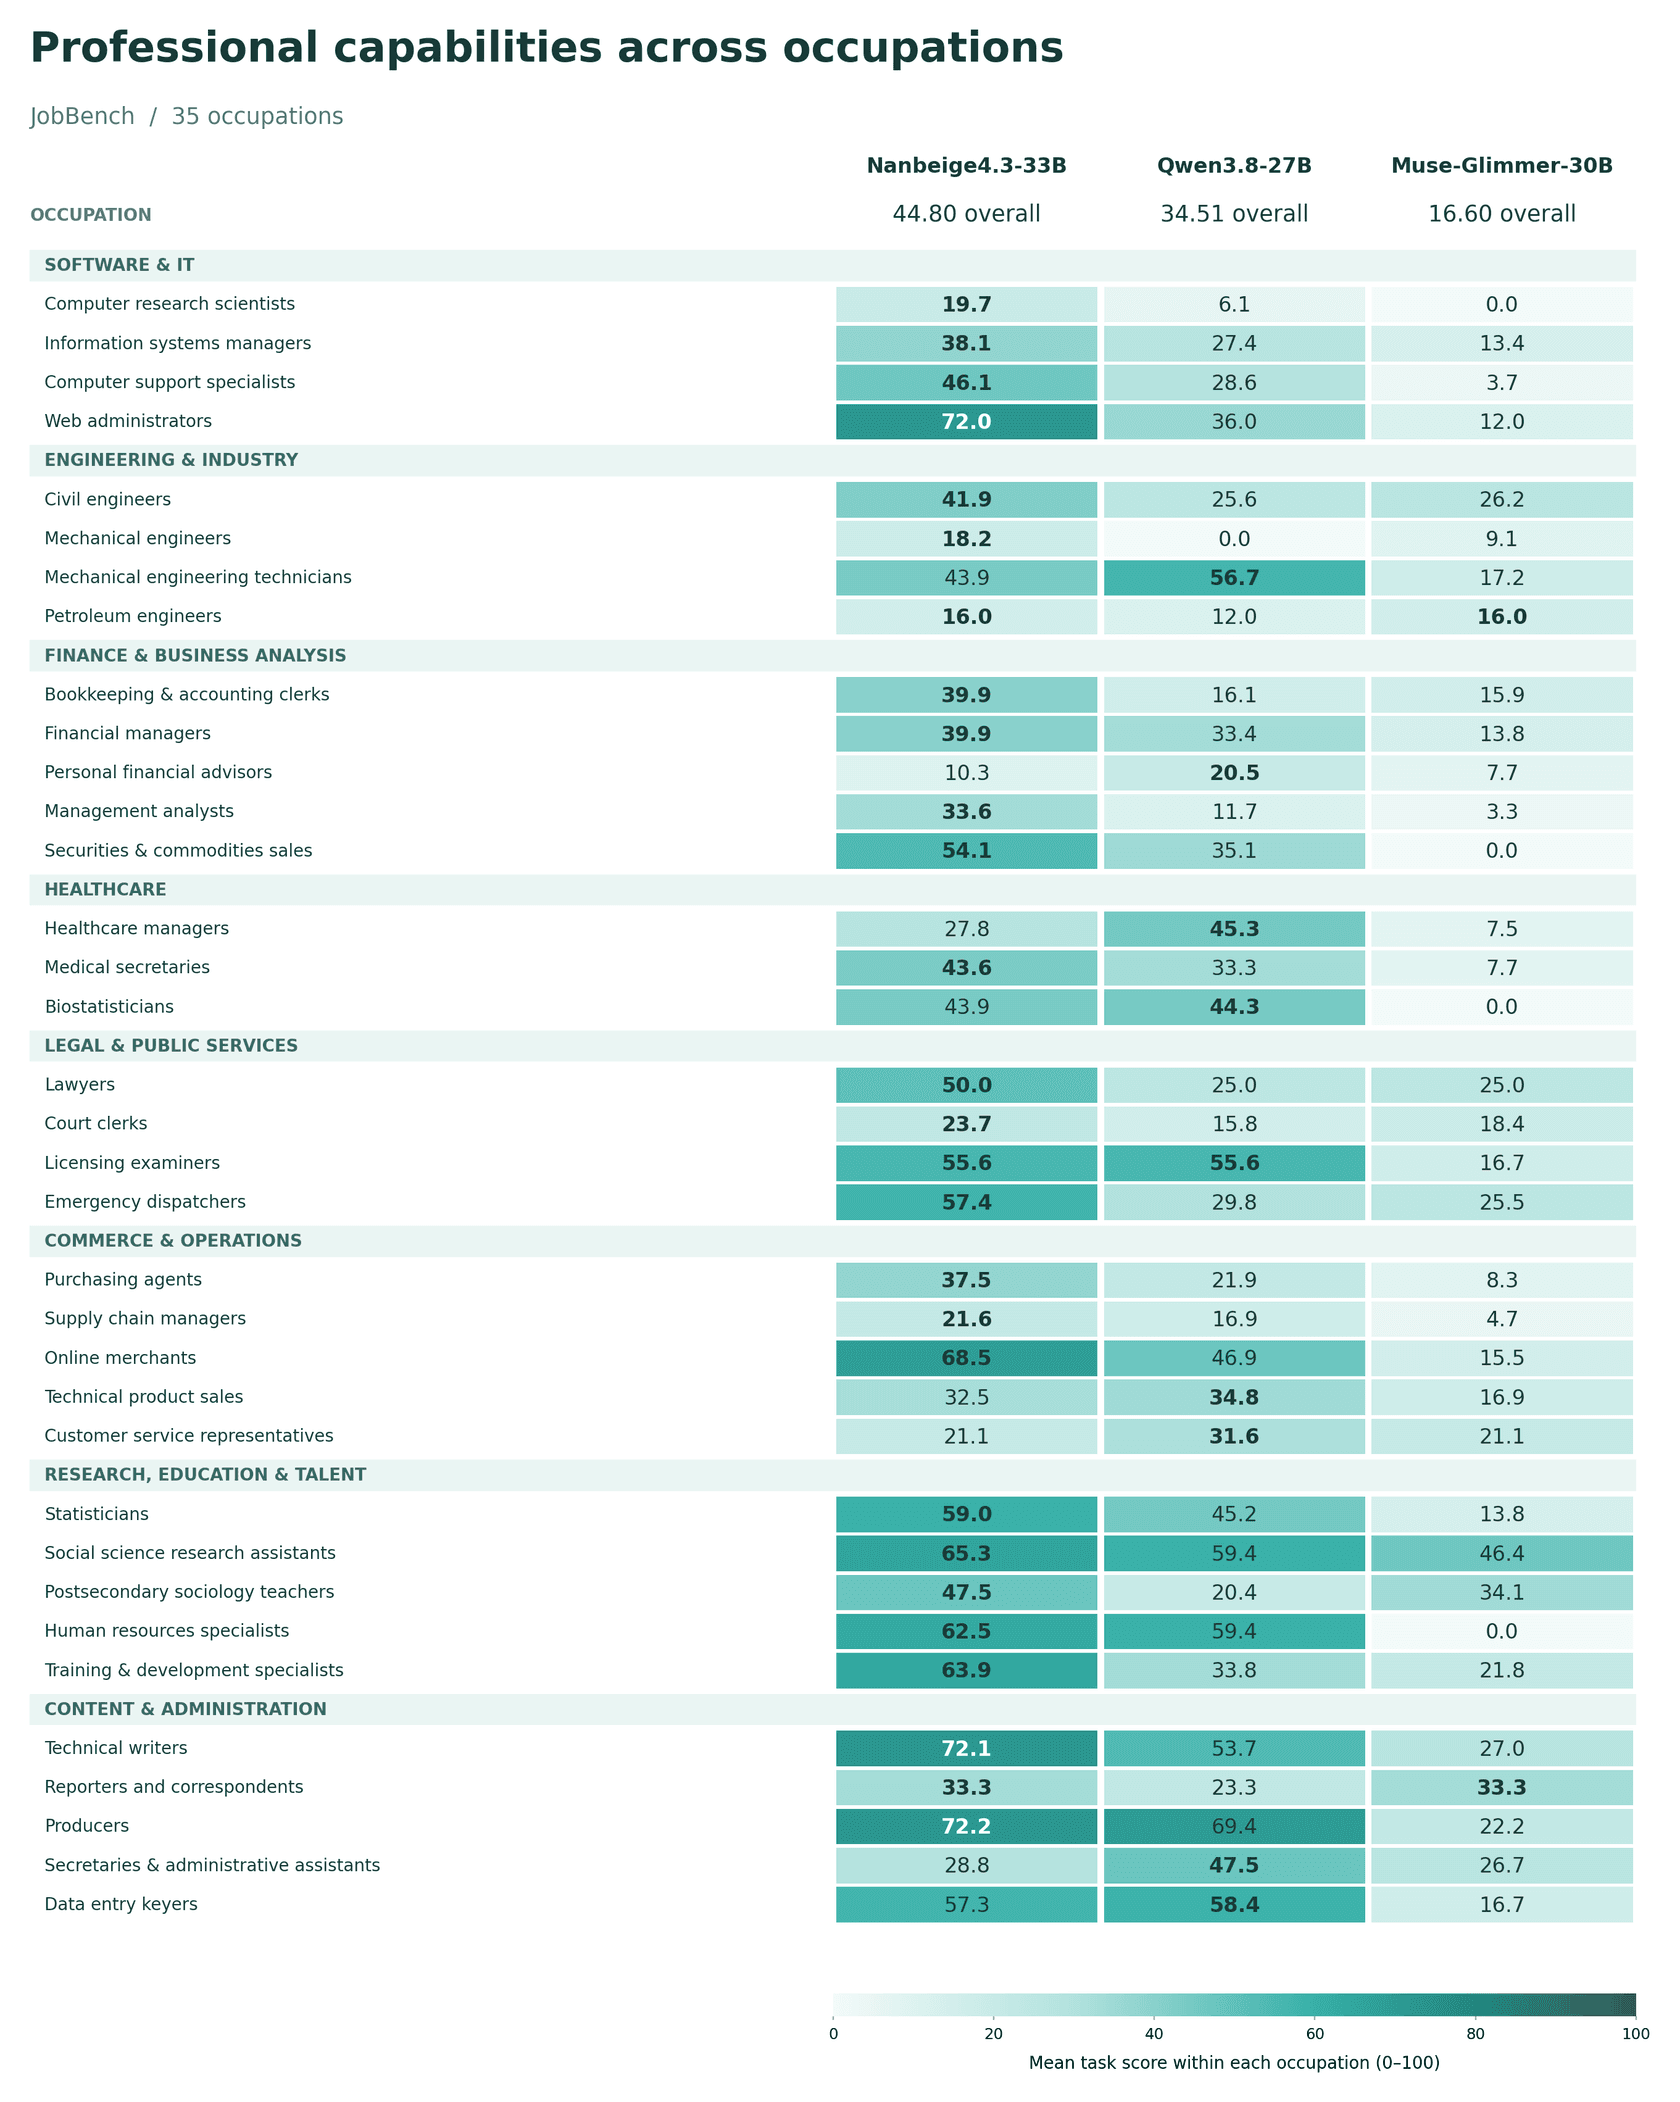
Eso coincide con lo que veo en el trabajo de soporte. Ser excelente escribiendo código en una terminal no se traduce automáticamente en responder a un cliente molesto por un reembolso, razón por la cual un agente de IA y un chatbot no son la misma compra. La calidad del soporte depende mucho más de lo que el modelo pueda consultar que del modelo en sí. En mi recopilación de modelos para tickets de soporte, el mismo modelo bajó 68 puntos en la comparativa Tau de Sierra en el momento en que la respuesta se encontraba en documentos en lugar de en una herramienta.
Nanbeige ejecutó Tau3-Bench con el repositorio oficial, pero su puntuación no aparece en la tabla de clasificación pública de Sierra, así que no la compare con esos números.
¿Cuánta memoria necesita Nanbeige 4.3?
Esta es la parte que la publicación de lanzamiento omite. Los pesos son manejables: un GGUF de 4 bits de la comunidad de bartowski es de 20,79 GB en Q4_K_M y de 35,2 GB en Q8_0. El problema es el contexto.
Nanbeige4.3-33B es un transformador denso clásico con atención de consulta agrupada: 52 capas, 8 cabezales de clave-valor de 128 dimensiones cada uno. Cada token que usted mantiene en contexto cuesta 2 × 52 × 8 × 128 × 2 bytes, o 212.992 bytes por token a 16 bits. Esa es la cifra que decide su GPU, no el recuento de parámetros.
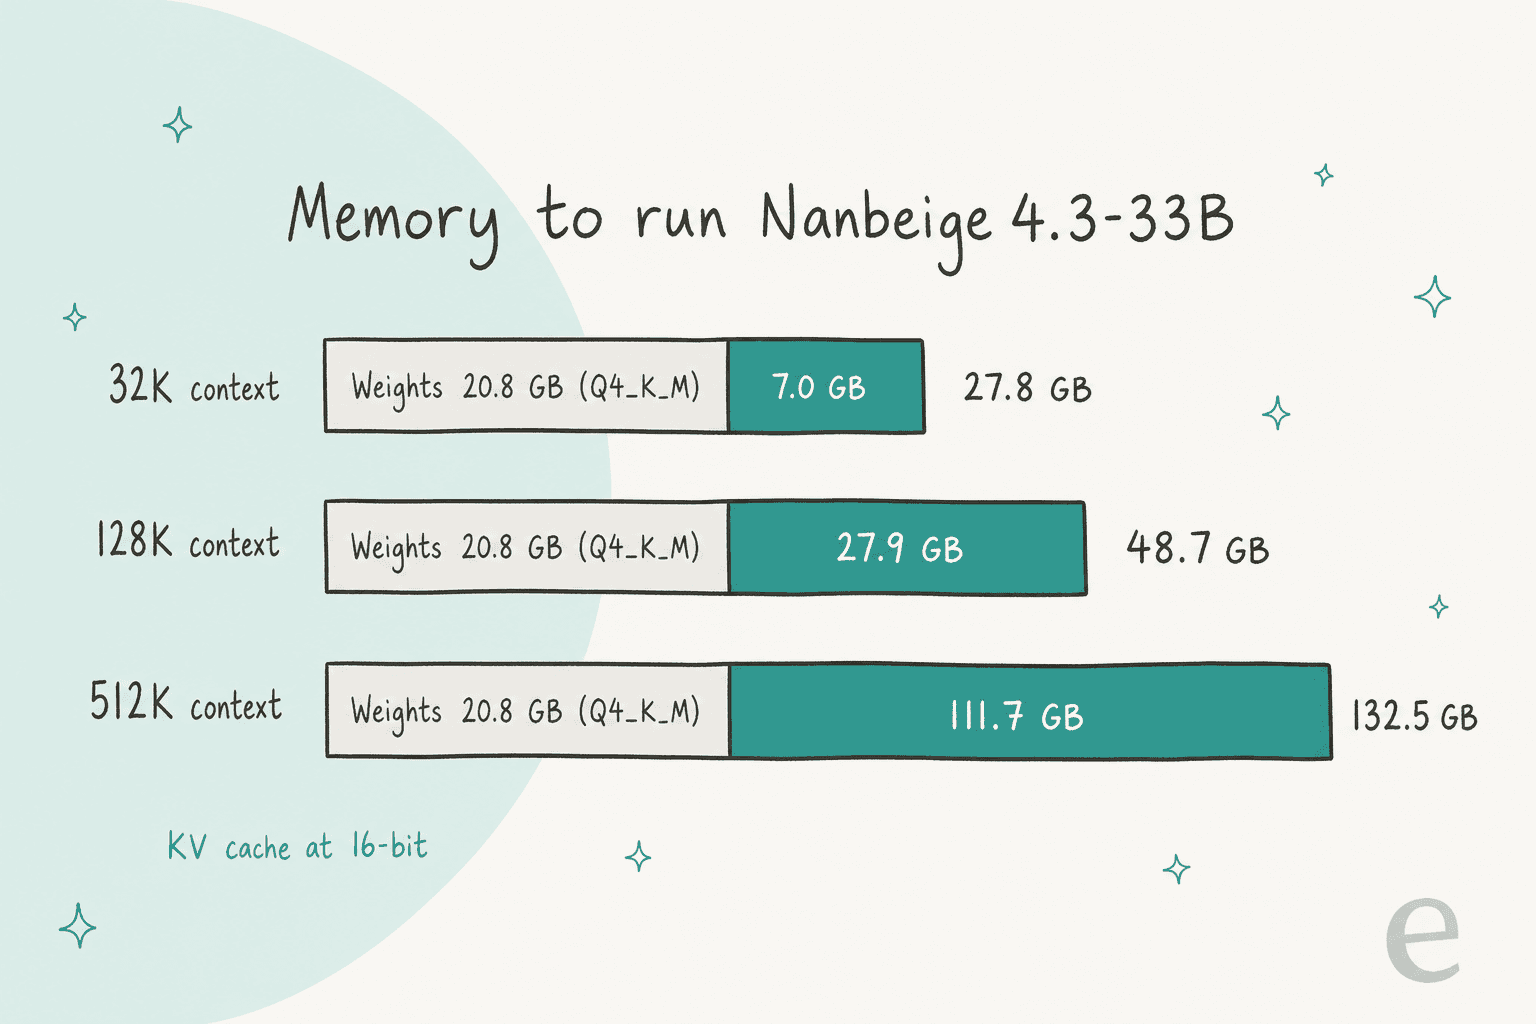
| Longitud de contexto | Caché KV (16 bits) | Caché KV (8 bits) | Total con pesos Q4_K_M (caché 16 bits) |
|---|---|---|---|
| 32K | 7,0 GB | 3,5 GB | ~27,8 GB |
| 128K | 27,9 GB | 14,0 GB | ~48,7 GB |
| 256K | 55,8 GB | 27,9 GB | ~76,6 GB |
| 512K | 111,7 GB | 55,8 GB | ~132,5 GB |
Por lo tanto, el titular de "contexto de 512K" es real, pero usarlo todo requiere hardware de servidor. Los propios ejemplos de servicio de Nanbeige para vLLM y SGLang configuran el paralelismo de tensores en 4, lo que significa cuatro GPU.
Los usuarios se dieron cuenta en un día. El hilo más discutido en el repositorio es una solicitud para optimizar el caché KV, donde la gente señala que algunos rivales en esta clase de tamaño necesitan varias veces menos caché para el mismo contexto. Es un punto válido frente a la línea de "rentable" de la tarjeta del modelo: con un contexto largo, un 33B denso es lo opuesto a barato.
La ventaja del diseño sencillo es la compatibilidad. Al tratarse de una arquitectura Llama estándar, aparecieron al menos 30 conversiones de la comunidad (GGUF, MLX para Apple Silicon, NVFP4, FP8) en Hugging Face en dos días, y funciona en vLLM y SGLang de serie con los analizadores de razonamiento y llamadas a herramientas de Qwen.
¿Cómo se ejecuta Nanbeige 4.3?
No hay una API alojada de Nanbeige, y OpenRouter no incluía el modelo en su lista a fecha de 26 de octubre de 2026. Usted descarga los pesos y los ejecuta. La tarjeta del modelo ofrece tres caminos:
- Transformers para pruebas rápidas. Cargue
Nanbeige/Nanbeige4.3-33Bcontrust_remote_code=Trueydevice_map='auto'. - vLLM para servir. El ejemplo de la tarjeta utiliza
--tensor-parallel-size 4,--reasoning-parser qwen3y--tool-call-parser qwen3_coder. - SGLang, con los mismos dos analizadores y
--tp-size 4.
Dos interruptores de la plantilla de chat importan más de lo que parece:
enable_thinkingestá activado por defecto. Desactívelo para respuestas rápidas.preserve_thinkingmantiene el razonamiento de turnos anteriores. Nanbeige recomiendaTruepara el uso de herramientas y agentes de codificación, yFalsepara el chat normal. Sus puntuaciones de comparativas se ejecutaron con esta opción activada.
Los ajustes recomendados también varían según la tarea: temperatura 1,0 con hasta 65.536 tokens nuevos para trabajo de agentes y herramientas, y temperatura 0,6 con hasta 262.144 tokens nuevos para razonamiento y chat.
Si está comparando opciones locales, los otros modelos abiertos que he analizado recientemente, como Gemma 4, Mistral Large 4 y DeepSeek V4 Flash, hacen diferentes concesiones entre tamaño, coste de contexto y acceso alojado. Mi lista de agentes de IA de código abierto cubre las estructuras en las que podría conectar cualquiera de ellos, y la recopilación de asistentes de codificación de IA cubre la parte alojada. Para acceso por API en lugar de alojamiento propio, Kimi K3 y MiniMax 3 son los lugares lógicos donde mirar.
¿Qué sigue para Nanbeige?
El equipo de Nanbeige ha estado respondiendo preguntas directamente en la página de Hugging Face del modelo, y tres respuestas esbozan la hoja de ruta. Al preguntar si el 33B reutiliza el diseño en bucle del 4.2, un miembro del equipo de Nanbeige dijo que no, y explicó por qué:
"Según nuestros experimentos, la arquitectura Looped Transformer ofrece un mejor equilibrio entre calidad y computación en tamaños de modelo más pequeños. Nuestros próximos modelos pequeños, como Nanbeige4.3-3B y Nanbeige4.5-3B, utilizarán la arquitectura Looped Transformer y ofrecerán un rendimiento mejorado".
El mismo miembro del equipo dijo que se publicará un informe técnico con Nanbeige4.3-3B, que se ha planificado un módulo de decodificación especulativa DFlash2 para una generación más rápida, y que los pesos FP8 "llegarán pronto". En septiembre, el laboratorio también dijo en X que Nanbeige4.5 ya se estaba entrenando.
Mi interpretación: si usted ejecuta agentes pequeños en hardware modesto, el lanzamiento que debe esperar es Nanbeige4.3-3B, no este. El 33B es la prueba de que el profesor es sólido. La verdadera pregunta es si el estudiante 3B mantendrá gran parte de esa ventaja en codificación en un modelo que quepa en un portátil, y nadie podrá responder a eso hasta que se lance.
¿Debería usted usar Nanbeige 4.3?
Depende de lo que esté construyendo, y la tabla de comparativas ya le dice casi todo:
- Agentes de codificación en su propio hardware: sí, pruébelo. Las ventajas en Terminal-Bench 4.0 y DeepSWE son lo suficientemente grandes como para sobrevivir a cierto ruido de la estructura, y Apache 2.0 significa que no habrá problemas de licencia. Reserve presupuesto para el caché KV o limite el contexto a entre 32K y 64K.
- Trabajo con documentos largos en una sola GPU: probablemente no. Un prompt de 128K necesita unos 49 GB con pesos de 4 bits.
- Ajuste fino de su propio agente: el modelo Base es un buen punto de partida. Nanbeige informa que supera a Gemma4-31B-Base en las ocho comparativas base que probó, incluida MMLU-Pro (
66,9frente a59,3). - Atención al cliente: no con estas cifras. Pierde frente a Qwen en tareas de servicio al cliente y solo empata en Tau3-Bench, y además, un modelo por sí solo no responde tickets. Mi selección del mejor agente de IA para servicio al cliente analiza la configuración completa en su lugar.
Ejecutar IA en tickets de soporte reales, no en comparativas
Ese último punto es a lo que dedico mi día a día. Un modelo como Nanbeige4.3-33B es infraestructura. Para responder a un ticket real, algo tiene que estar en su helpdesk, leer sus macros y tickets anteriores, saber qué clientes pertenecen a un humano y seguir las reglas sobre lo que nunca se le permite decir. Ese es el trabajo para el que se ha creado el compañero de helpdesk de IA de eesel, uno de los compañeros de IA listos para trabajar que usted contrata para un rol específico. Se ejecuta dentro de herramientas como las configuraciones de Zendesk AI en lugar de reemplazarlas, y el cálculo del coste por ticket es lo que suele decantar la decisión.
smava, una plataforma berlinesa de comparación de préstamos, muestra cómo se ve eso en la práctica. eesel gestionó unos 27.000 tickets de Zendesk en un mes entre smava y su marca hermana Finanzcheck, categorizando unos 14.600 y preparando unos 15.300 borradores de respuesta a partir de aproximadamente 820 macros y artículos del centro de ayuda. Los clientes que ya tienen un asesor de crédito son omitidos para que reciban noticias de su asesor, y eesel nunca envía las respuestas listas para el cliente por sí solo: un agente aprueba cada una. Nada de eso aparece en una comparativa de codificación, y todo ello decide si la IA ayuda o perjudica.

Antes de entrar en funcionamiento, eesel ejecuta su configuración contra cientos de sus tickets anteriores para que usted vea sus respuestas antes que un cliente, lo que le dice más que cualquier comparativa que cite un proveedor. Escribí sobre cómo funcionan esas pruebas por separado. SamCart siguió el mismo camino en Freshdesk, con un agente para los tickets de correo electrónico y otro para el chat de su sitio web, ambos respondiendo a partir de unos 280 artículos del centro de ayuda. Si prefiere trabajar desde la terminal como lo haría con un modelo local, la CLI de eesel le permite a usted, a un script o a un agente de codificación como Claude Code conectar integraciones, editar las instrucciones permanentes del agente, aprobar o denegar sus acciones pendientes y leer su registro de actividad, todo ello en formato JSON.
Pruebe eesel
Nanbeige 4.3 es un potente motor abierto para agentes de codificación. Si lo que realmente necesita es un agente que responda a su cola de soporte esta misma semana, el compañero de helpdesk de IA de eesel se une a su Zendesk, Freshdesk o Gorgias en minutos, aprende de sus tickets anteriores y de su centro de ayuda, y redacta o envía respuestas dentro de las reglas que usted establezca. El precio de eesel AI es de 0,40 $ por ticket o sesión de chat y 4,00 $ por publicación de blog, con una prueba gratuita de 50 $ (sin mínimos mensuales ni tarifas de plataforma). Es gratis para empezar con 100 créditos y sin necesidad de tarjeta, para que pueda probarlo con tickets reales antes de decidirse. Pruebe eesel.
Preguntas frecuentes
¿Qué es Nanbeige 4.3?
Nanbeige 4.3 es una serie de modelos del Nanbeige LLM Lab en BOSS Zhipin (Kanzhun). Su primer lanzamiento, Nanbeige4.3-33B, se publicó en Hugging Face el 24 de octubre de 2026 bajo la licencia Apache 2.0. Es un modelo de texto denso de 33 mil millones de parámetros con una ventana de contexto de 512K, diseñado para tareas de codificación agentiva y de oficina, y tiene como objetivo enseñar a un modelo más pequeño, Nanbeige4.3-3B. Se sitúa en el mismo grupo de modelos abiertos que Gemma 4 y Qwen.
¿Es Nanbeige 4.3 gratuito?
Sí. Los pesos de Nanbeige4.3-33B y Nanbeige4.3-33B-Base se han publicado bajo Apache 2.0, lo que permite su uso comercial. En su lugar, usted paga por el hardware: solo los pesos BF16 ocupan 66 GB, y un GGUF de 4 bits pesa unos 21 GB antes de contar la memoria de contexto. Para tener una idea de lo que cuestan los modelos alojados, consulte los precios de DeepSeek V4 Flash.
¿Cuánta VRAM necesita Nanbeige 4.3 33B?
Aproximadamente 21 GB para los pesos de 4 bits, más unos 0,2 MB de caché KV por token a 16 bits. Esto se traduce en unos 28 GB en total con un contexto de 32K, 49 GB con 128K y más de 130 GB con el contexto completo de 512K. Los ejemplos de vLLM y SGLang de Nanbeige utilizan paralelismo de tensores de 4 vías. Si necesita algo que quepa en una sola tarjeta pequeña, los modelos de lenguaje pequeños anteriores de la línea Nanbeige son de 3B.
¿Es Nanbeige 4.3 mejor que Qwen3.8-27B?
Según la propia tabla de Nanbeige, Nanbeige4.3-33B supera a Qwen3.8-27B en 18 de 20 comparativas, con las mayores diferencias en DeepSWE (65,5 frente a 42,5) y Terminal-Bench 4.0 (23,8 frente a 6,3). Qwen sigue ganando en SWE-Bench Pro y GDPval, y ningún laboratorio independiente ha vuelto a ejecutar las cifras todavía. El hermano mayor de Qwen se analiza en la reseña de Qwen3.8 Max.
¿Puedo usar Nanbeige 4.3 para atención al cliente?
Puede hacerlo, pero sus propias cifras no lo respaldan del todo. En JobBench obtuvo una puntuación de 21,1 en tareas de representante de servicio al cliente frente a los 31,6 de Qwen3.8-27B, y su puntuación en Tau3-Bench es un empate de 48,8 a 48,5. Un agente de soporte también necesita que su helpdesk, macros y reglas de transferencia estén integrados, que es la parte que un agente de helpdesk de IA como eesel gestiona por usted.
¿Tiene Nanbeige 4.3 una API?
Nanbeige distribuye los pesos, no una API alojada. La tarjeta del modelo explica cómo ejecutarlo usted mismo con Transformers, vLLM o SGLang, y OpenRouter no lo incluía en su lista a fecha de 26 de octubre de 2026. Si prefiere llamar a un modelo abierto alojado, Kimi K3 y GLM-5.3 Flash están disponibles a través de API.
¿Cuándo saldrá Nanbeige4.3-3B?
Nanbeige no ha dado una fecha. Un miembro del equipo de Nanbeige mencionó en la página de Hugging Face del modelo que el informe técnico de la serie 4.3 se publicará junto con Nanbeige4.3-3B, y que el 3B utilizará el diseño de Transformador en Bucle (Looped Transformer) de Nanbeige4.2-3B. Para obtener más información sobre los modelos en bucle, consulte la explicación de GPT-6 Astra.