

El precio de Ripple-65B es de $0.20 por millón de tokens de entrada y $0.60 por millón de salida, con la entrada en caché a $0.05, y detrás hay un solo proveedor: GMI Cloud, directamente o a través de OpenRouter. Para una sesión de agente de programación con 1M de tokens de entrada (80 % en caché) y 50K de salida, son unos $0.11, una quinta parte menos que Reflection Beam y más o menos a la par de GPT-5.6 Luna. Alojarlo uno mismo rara vez compensa: dos B200 alquiladas cuestan unos $7,300 al mes, lo que solo supera a la API a unas 91 tareas por hora, sin parar. Si estabas calculando el coste de Ripple para atender una cola de soporte, el modelo es la parte barata; el compañero de IA de helpdesk de eesel cubre el resto, y su CLI permite que un agente de programación cargue tus documentos de ayuda y pruebe respuestas antes de salir en producción.
¿Cuánto cuesta Ripple-65B?
Ricursive Intelligence lanzó Ripple-65B Preview el 4 de noviembre de 2026 como un modelo de programación denso de 65B con licencia Apache 2.0 (el resumen de Ripple-65B explica qué es y cómo puntúa). Los pesos no cuestan nada. El acceso alojado cuesta lo mismo en todas partes, porque todas partes es las GPU de una sola empresa.
| Vía | Entrada / 1M | Salida / 1M | Entrada en caché / 1M | Contexto | Estado (5 nov 2026) |
|---|---|---|---|---|---|
| GMI Cloud (directo) | $0.20 | $0.60 | $0.05 | 1,000,000 | Activo, BF16, sin plan gratuito listado |
| OpenRouter | $0.20 | $0.60 | $0.05 | 1,048,576 en la API (la página dice 16K) | Activo, GMI Cloud es el único proveedor |
| Together AI | No listado | No listado | No listado | 1M en el panel de especificaciones | "Próximamente" |
| Pesos en Hugging Face | Gratis | Gratis | n/d | Hasta 1M | Apache 2.0, sin proveedor de inferencia alojado |
Unos detalles importan más que el precio de lista:
- La unidad facturable es el token, en ambos sentidos. La salida cuesta el triple que la entrada. Un agente de programación que lee mucho y escribe poco depende de los $0.20; uno que escribe diffs largos paga más de los $0.60.
- El caché es una gran palanca. GMI cobra $0.05 por token de entrada en caché y no lista ninguna tarifa de escritura en caché. El panel de precios de OpenRouter mostraba un promedio ponderado de unos $0.11 por millón de tokens de entrada realmente pagados, porque los prompts repetidos aciertan en la caché.
- No hay plan gratuito. OpenRouter no tiene variante
:free, y la página del modelo de GMI no muestra ninguna.
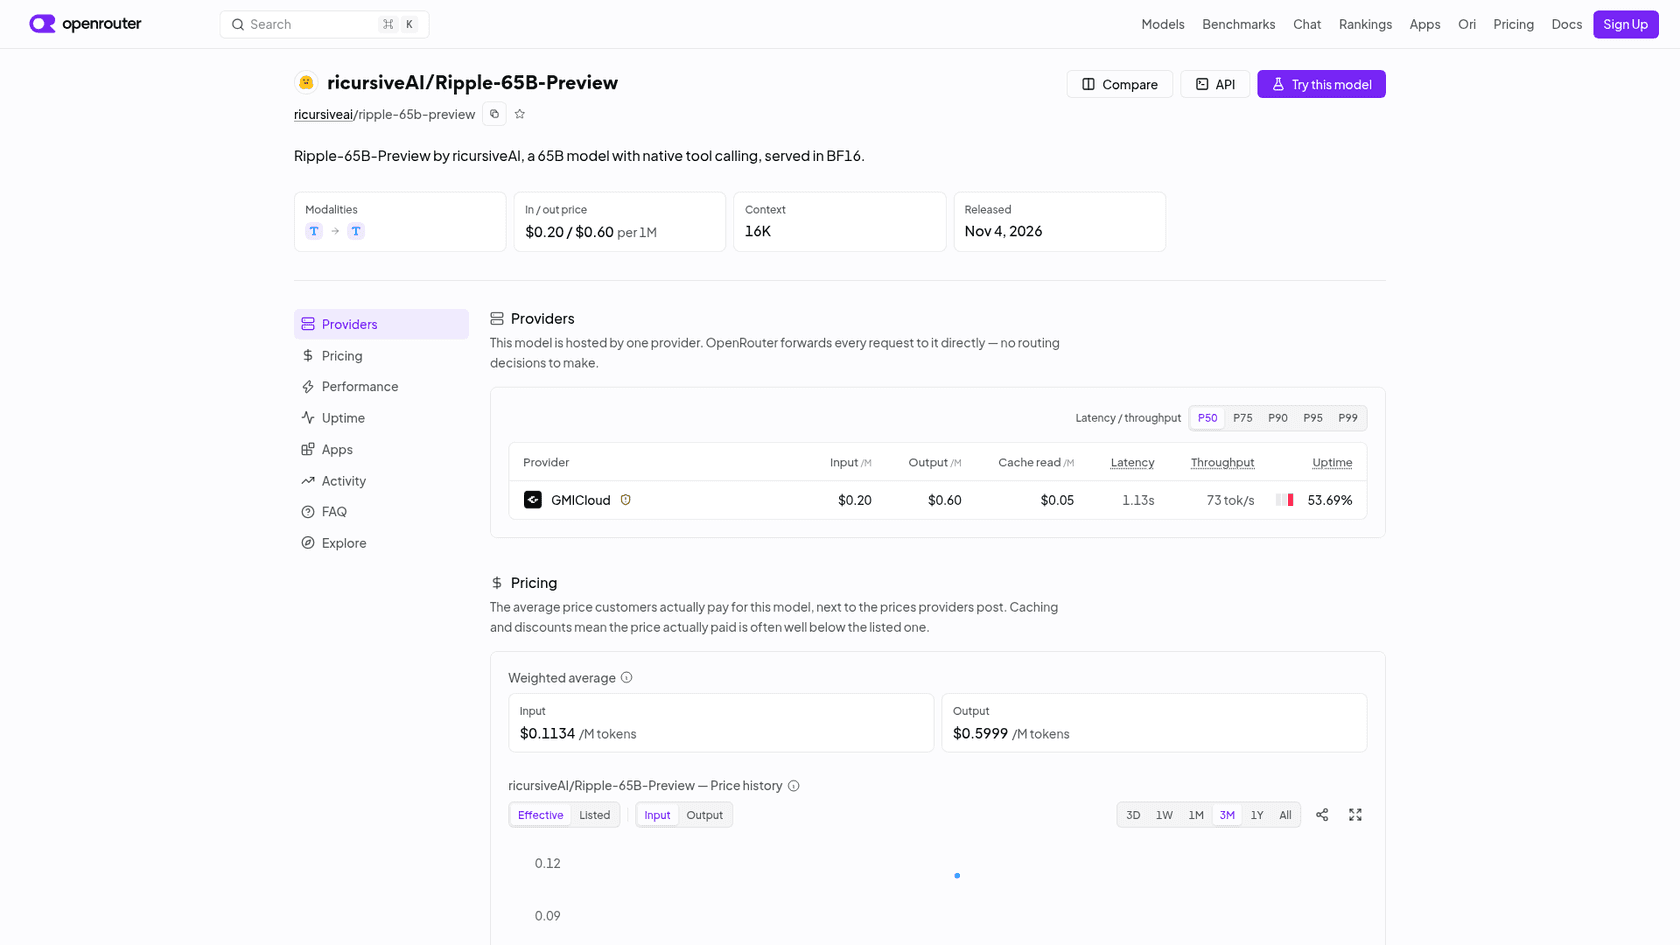
La ventana de contexto cambió mientras escribía esto
La mañana del 5 de noviembre, la API de endpoints de OpenRouter limitaba Ripple a 16,384 tokens de contexto y 14,745 tokens de salida. Por la tarde, la misma API informaba de 1,048,576 tokens de contexto y 131,072 de salida, mientras que la página del modelo seguía mostrando "16K". La propia página de GMI decía 1,000,000 desde el principio. Mi lectura: la ventana mayor se está desplegando y la página no se ha puesto al día. Antes de presupuestar un agente que necesite una ventana de contexto larga, envía un prompt largo y comprueba que no se trunca.
¿Dónde se puede comprar Ripple-65B hoy?
Ahora mismo, en un único lugar con dos puertas de entrada. OpenRouter reenvía cada petición a GMI Cloud, al mismo precio, así que elegir entre ellos es cuestión de comodidad: OpenRouter si ya enrutas varios modelos con una sola clave, GMI directo si quieres su endpoint compatible con OpenAI sin capa intermedia.
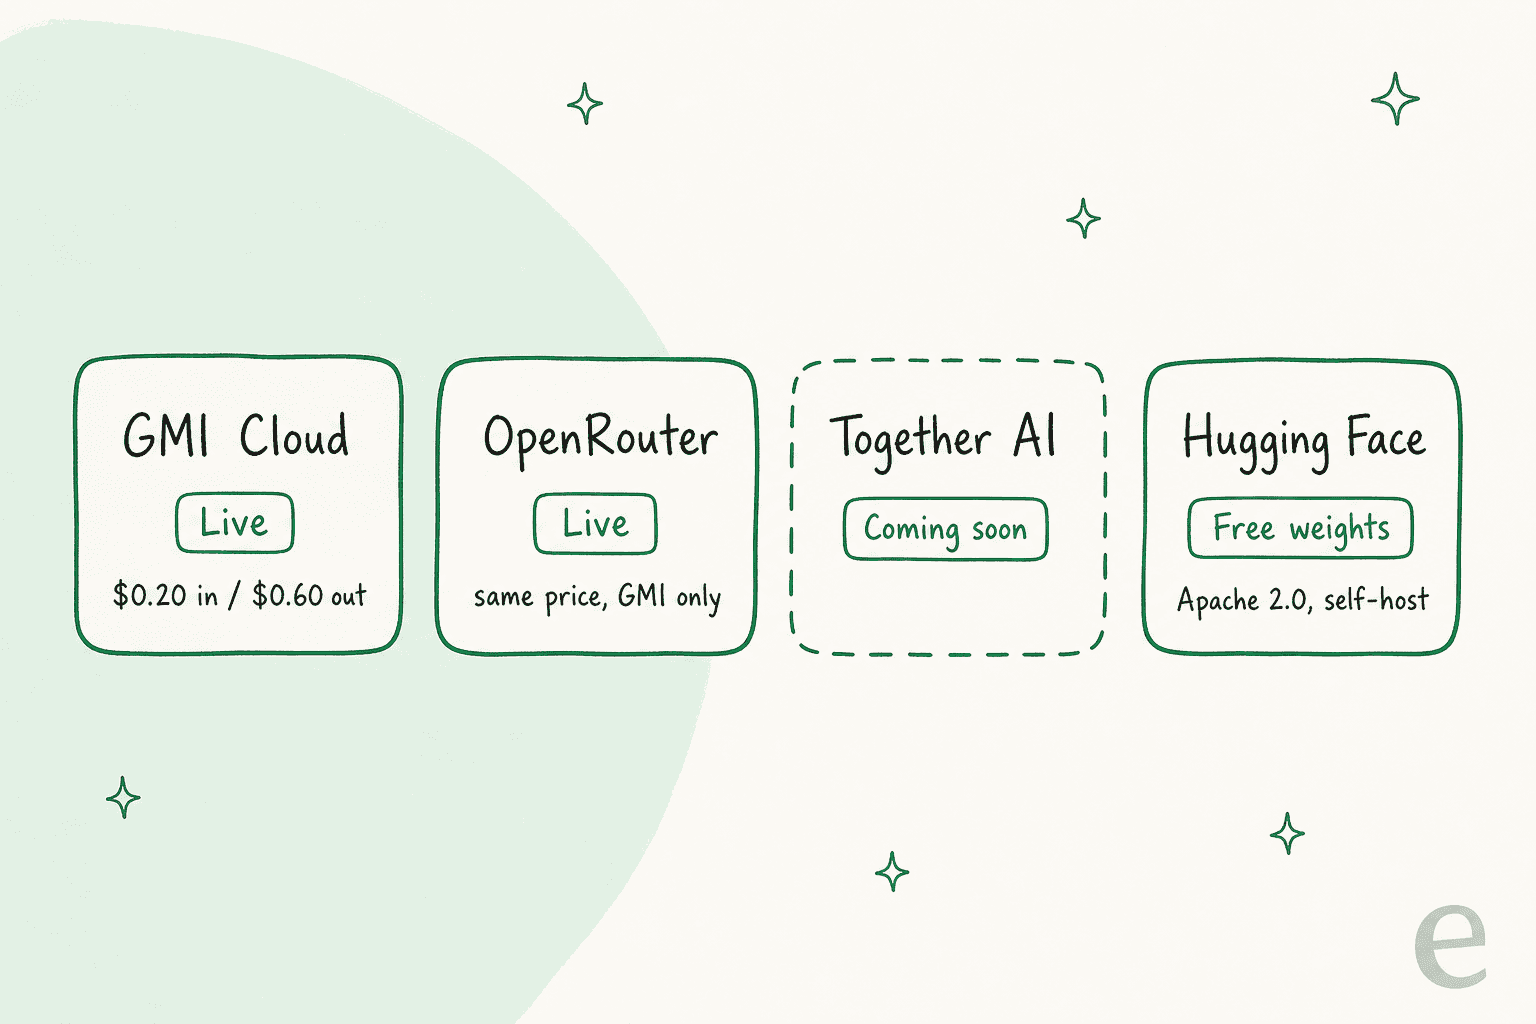
Un solo proveedor tiene un coste que no aparece en la tarifa: la capacidad. El dato de disponibilidad de OpenRouter para el endpoint de GMI estuvo entre el 51 % y el 60 % durante el día anterior cuando lo comprobé el 5 de noviembre, lo cual es normal en un modelo añadido el día antes, pero duro para cualquier uso de cara al cliente. Ricursive ha dicho que Ripple llegará a Together AI y Fireworks; la página de Together sigue diciendo "próximamente" con un botón "Notify me" y sin precio.
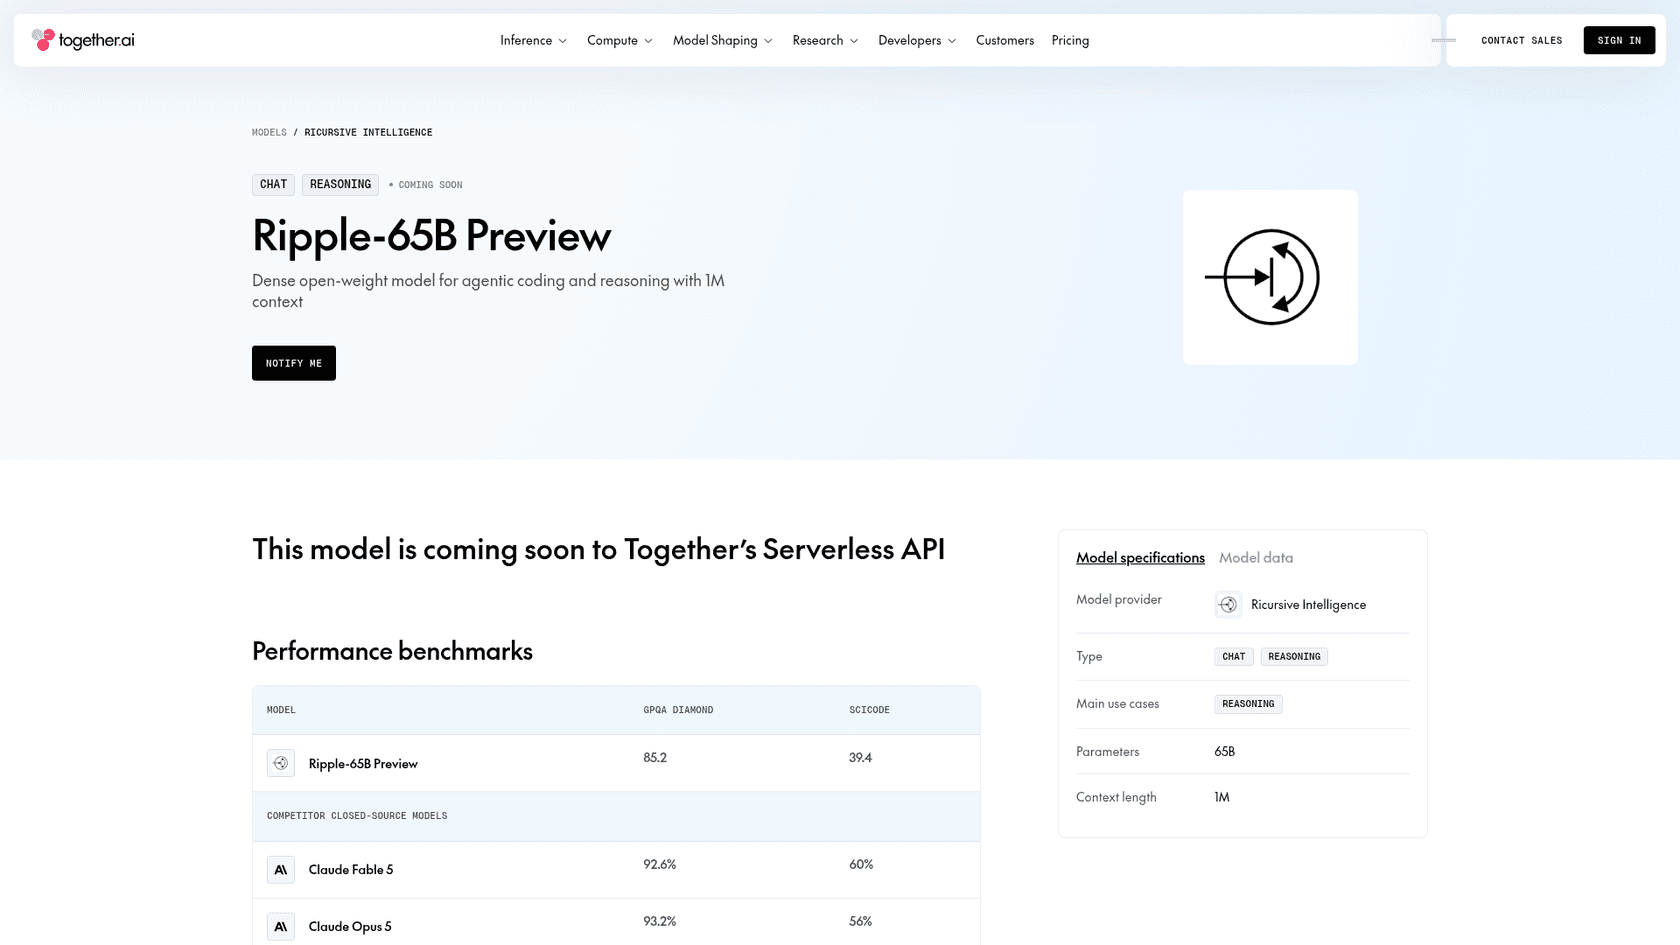
Si necesitas hoy un segundo proveedor para conmutación por error, no lo tienes. Ese es el argumento más fuerte para esperar unas semanas antes de que Ripple soporte tráfico de producción, y no tiene nada que ver con el precio.
¿Cuánto cuesta una tarea de agente de programación en Ripple-65B?
Los precios por millón no significan mucho hasta que calculas un trabajo real. Así que aquí va un comprador: una sesión de agente de IA de programación que envía 1M de tokens de entrada entre todos sus turnos, el 80 % aciertos de caché, y escribe 50K tokens de salida. Es una forma razonable para un agente que lee un repositorio, ejecuta pruebas y parchea unos cuantos archivos.
En Ripple, la cuenta es corta:
- 200K de entrada nueva × $0.20 por millón = $0.04
- 800K de entrada en caché × $0.05 por millón = $0.04
- 50K de salida × $0.60 por millón = $0.03
- Total: unos $0.11 por tarea, o $110 por 1,000 tareas
Sin caché, la misma tarea cuesta $0.23, más del doble. Aquí está la misma tarea en modelos cercanos, con los precios de lista de OpenRouter del 5 de noviembre de 2026:
| Modelo | Entrada / 1M | Salida / 1M | Caché / 1M | Coste por tarea | Por 1,000 tareas |
|---|---|---|---|---|---|
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | $0.048 | $48 |
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | $0.110 | $110 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | $0.116 | $116 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | $0.140 | $140 |
| Qwen3.8 27B | $0.15 | $1.875 | $0.0375 | $0.154 | $154 |
| Inkling Small | $0.45 | $1.20 | $0.10 | $0.230 | $230 |
| Nemotron 3 Ultra 550B | $0.60 | $2.40 | $0.12 | $0.336 | $336 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | $0.583 | $583 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | $0.980 | $980 |
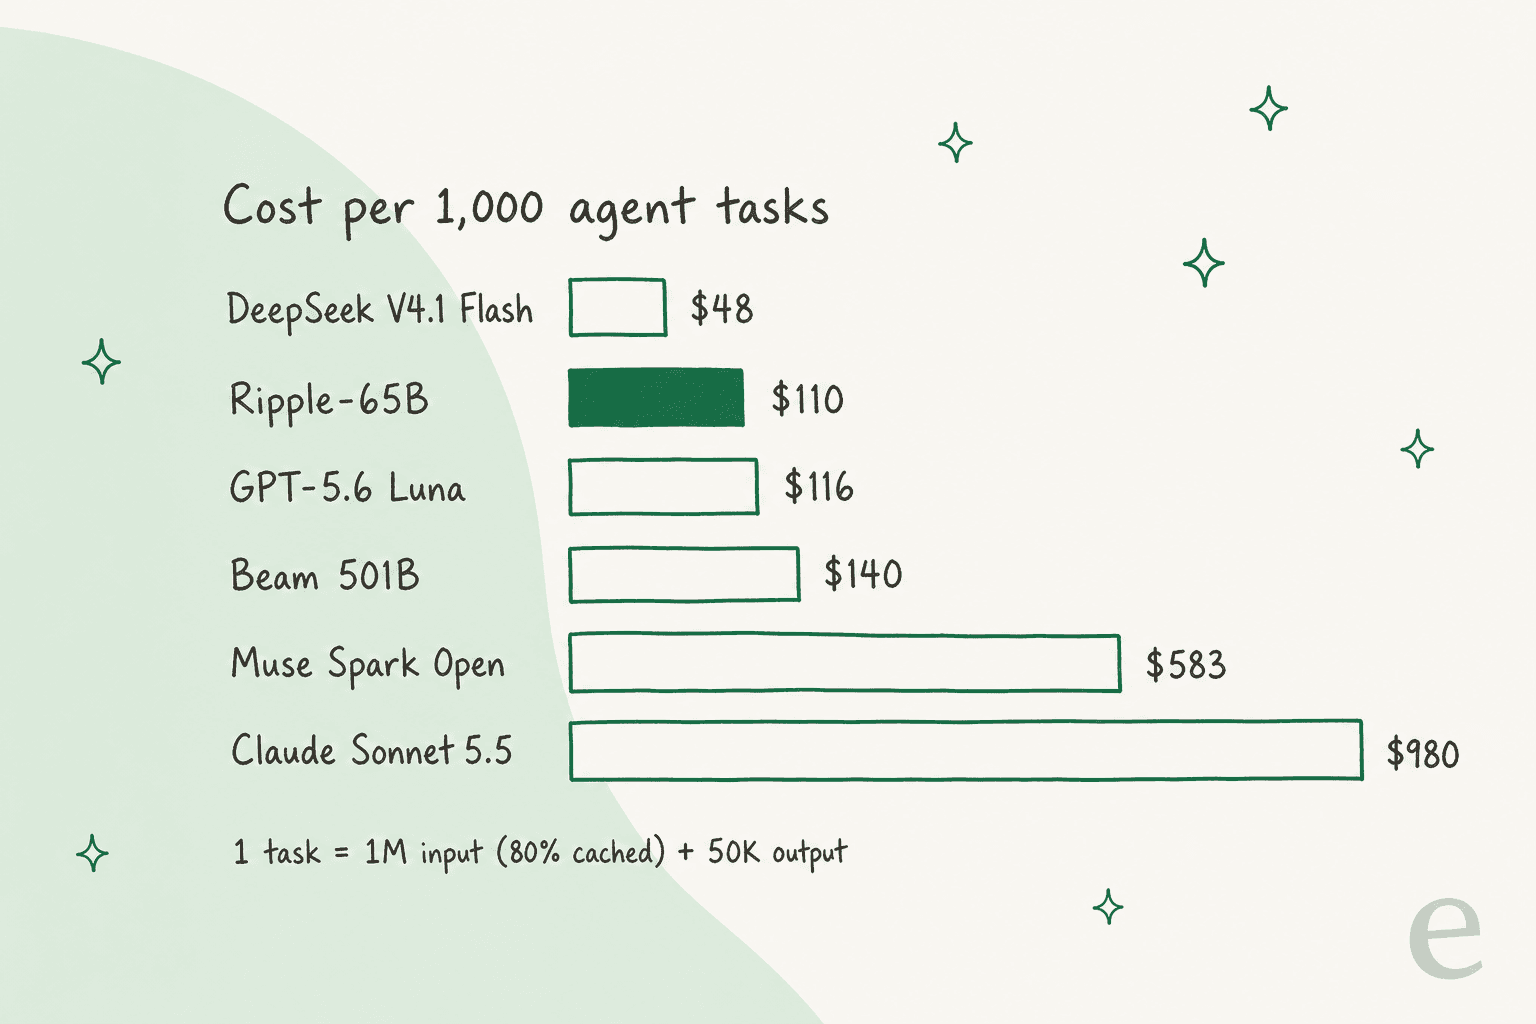
Dos cosas saltan a la vista. Primero, Ripple es el modelo de pesos abiertos de fabricación estadounidense más barato de la tabla, alrededor de un 21 % por debajo de Beam, el modelo con el que empata en Terminal-Bench 2.1 (80.5 frente a 80.1 en la ficha del modelo). Si solo puedes usar modelos estadounidenses, esa es la comparación que importa, y Ripple la gana en precio.
Segundo, no es el modelo más barato, sin más. DeepSeek V4.1 Flash hace la misma tarea por menos de la mitad, y GPT-5.6 Luna queda a menos de un centavo. Así que "barato" solo es motivo para elegir Ripple si ya has filtrado la lista a pesos abiertos estadounidenses. Para el panorama más amplio, mis análisis de los precios de Kimi K3.1 Pro y los precios de DeepSeek V4.1 Flash hacen el mismo tipo de cálculo.
¿Quieres poner tus propias cifras? Esta calculadora recalcula un mes de trabajo de agente en cada modelo. Fija tu volumen de tareas y la mezcla de tokens, y te muestra dónde queda Ripple y si un servidor 2x B200 alquilado superaría a la API.
¿Cuándo supera alojar Ripple-65B uno mismo a la API?
Más tarde de lo que crees. Apache 2.0 hace que alojarlo uno mismo sea legal y gratuito en licencia, y un modelo denso de 65B es lo bastante pequeño como para tentar. Pero la API ya tiene un precio ajustado, así que tu hardware tiene que estar muy ocupado para competir.
Ricursive publica dos formas de ejecutarlo, ambas en la ficha del modelo en Hugging Face y su repositorio NVFP4:
- Centro de datos: BF16 en dos GPU NVIDIA B200 con SGLang y un modelo borrador DFlash2, que según la ficha alcanza "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels."
- Escritorio: una versión experimental NVFP4 en un NVIDIA DGX Spark, limitada a una petición a la vez y 128K de contexto.
Esto es lo que cuesta cada una frente a la API:
| Opción | Coste | Qué ofrece | Punto de equilibrio frente a la API |
|---|---|---|---|
| API de Ripple | $0.20 / $0.60 por 1M | Pago por token, un solo proveedor | n/d |
| 2x B200, alquiladas | GMI Cloud "from $5.00/GPU-hour" = $10/hora, unos $7,300 por un mes de 730 horas | 1M de contexto, servicio por lotes | ~66,000 tareas al mes, o ~91 por hora las 24 horas |
| DGX Spark, comprado | $6,950 en el marketplace de NVIDIA (128 GB) | Una petición a la vez, 128K de contexto | ~63,000 tareas durante la vida útil del equipo |
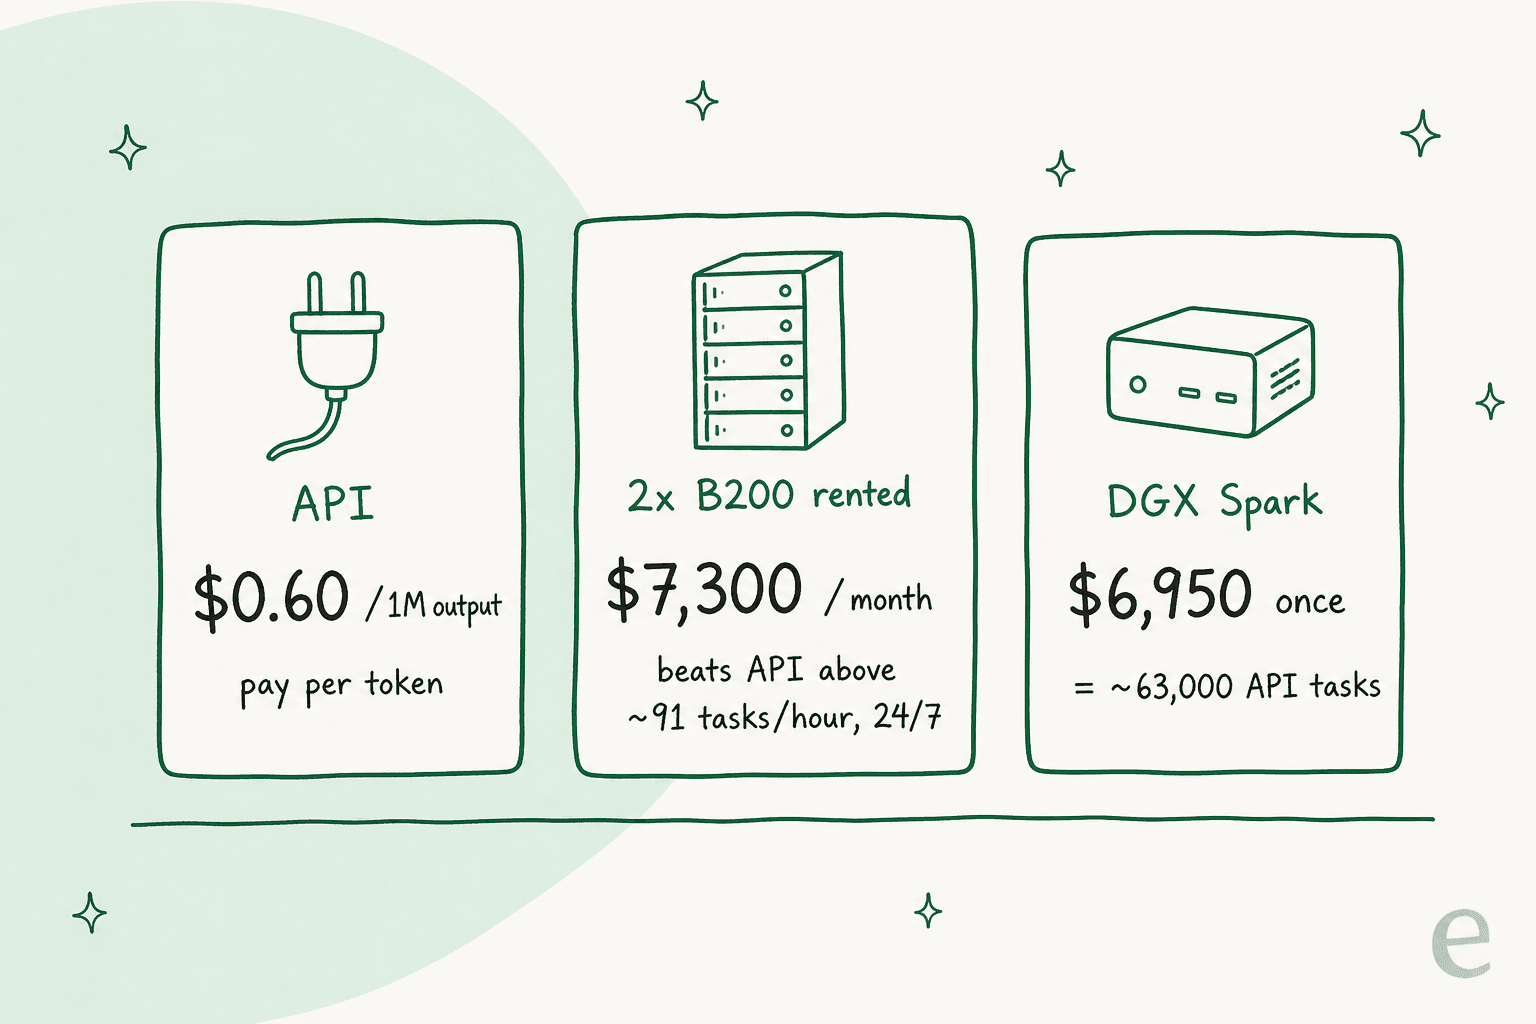
El cálculo de las B200 depende de cómo se lean esos 250 tok/s. Si son por petición, ocho peticiones a la vez dan unos 2,000 tokens de salida por segundo, o 144 de mis tareas de ejemplo por hora en el mejor caso, así que necesitas el servidor ocupado al 63 % aproximadamente, cada hora del mes, solo para igualar a la API (y eso antes del tiempo de prefill, las noches vacías y las horas de un ingeniero). Si son el total entre las ocho, el servidor llega a unas 18 tareas por hora como máximo y nunca alcanza a la API. Ricursive no dice cuál es. Además, las B200 figuran como "limited availability" en la página de GMI, y $5.00 es un precio "from".
El DGX Spark es una compra distinta. A $6,950 equivale a unas 63,000 tareas de agente en la API, u 11.6 mil millones de tokens de salida, y atiende una petición a la vez. Nadie lo compra para ahorrar con Ripple. Se compra para que el código y los datos nunca salgan del edificio, y algunos comentaristas de HN defendieron justo eso:
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States. It doesn't mean these models are competitive when looked at from a global view but it is also not an irrelevant differentiation."

Otros tenían más dudas sobre la velocidad en local. Un modelo denso de 65B lee todos los pesos para cada token, a diferencia de un modelo de mezcla de expertos que activa solo una parte:
"But as is, it's probably hard to become popular amongst hobbyists and local model enthusiasts like Qwen's 27B class models or MOE models because it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware, and seems like the goal/mission of the company behind this model is to automate chip design."
Mi opinión: aloja Ripple tú mismo cuando las normas te obliguen, o cuando puedas mantener dos B200 ocupadas la mayor parte del día. Para todos los demás, la API a $0.60 es la forma más barata de ejecutarlo, y el análisis de Ripple-65B incluye el detalle de los benchmarks para decidir si merece la pena usarlo.
¿Por qué Ripple-65B tiene un precio tan bajo?
En parte por el tamaño. Con 65B de parámetros densos en BF16 cabe en dos B200, mientras que rivales como Inkling (975B) y Muse Spark Open (816B) necesitan mucha más memoria por copia. En parte por el posicionamiento: Ricursive es un laboratorio nuevo que se lanza en un campo de modelos chinos más baratos, y su argumento es la eficiencia. Dijo que todo el modelo salió de un presupuesto pequeño:
"Ripple was built on a $32 million compute budget, one-tenth the cost of the previous open-weight SOTA on agentic coding. We're grateful to the open-source community, whose tools and research helped make this possible."
Eso es coste de entrenamiento, no de servicio, y no fija el precio de la API; lo fija GMI Cloud. Pero explica por qué el lanzamiento apostó por el valor y no por las puntuaciones brutas. Trata el precio de hoy como un precio de lanzamiento de un único proveedor. Cuando Together AI y Fireworks lo listen, la tarifa podría moverse en cualquier dirección, y un segundo proveedor importará más por la fiabilidad que por el coste.
¿Es Ripple-65B lo bastante barato para atender tu cola de soporte?
Los tokens, sí. Una respuesta de soporte es un trabajo mucho menor que una sesión de programación, a menudo unos miles de tokens de entrada y unos cientos de salida, así que 10,000 respuestas al mes con 3,000 tokens de entrada y 300 de salida salen por menos de $8 en Ripple. El precio no es el obstáculo.
El encaje sí. Ripple es un modelo de programación con poco post-entrenamiento, y sus puntuaciones en las filas más cercanas al soporte de la propia tabla de Ricursive son mediocres: 31.27 en τ³-bench banca (Beam: 36.1) y 71.67 en uso de herramientas de MCP Atlas (Muse Spark Open: 89.2), según la ficha del modelo. Y el modelo es el 5 % barato de un agente de soporte. El resto es la sincronización de la base de conocimiento, las reglas de escalado, las barreras de seguridad contra respuestas inventadas y una forma de comprobar las respuestas antes de que las vean los clientes. Ese es el coste real de cualquier decisión de construir o comprar, y se paga en meses de ingeniería, no en tokens.
Esa es la parte que gestiona eesel. El compañero de IA de helpdesk de eesel se une a tu helpdesk actual, aprende de tu centro de ayuda y de tickets anteriores, y se prueba con tickets históricos antes de responder a nadie, porque he visto a bots seguros de sí mismos dar respuestas erróneas en colas reales. Timengo, que vende software de correo seguro y Digital Post en Dinamarca, hace que eesel redacte respuestas técnicas en danés a partir de unos 5,300 tickets anteriores, preparando alrededor de 300 tickets de Freshdesk al mes. SE Ranking ejecuta un agente de eesel por producto en Zendesk, y gestionaron 4,650 conversaciones en un mes.
Si llegaste a Ripple porque vives en una terminal, la CLI de eesel te resultará familiar: un agente de programación puede subir conocimiento aprobado, como artículos de ayuda y macros exportados, ajustar las instrucciones del compañero y ejecutar preguntas de prueba antes de que nada salga en producción. Conectar el propio helpdesk sigue necesitando la aprobación de un administrador. Hay una guía sobre cómo gestionar agentes de IA desde la terminal.
¿Merece la pena pagar por Ripple-65B?
Esto es lo que concluyo tras calcularlo de todas las formas que pude:
- Paga por la API si estás probando un modelo de programación de pesos abiertos de fabricación estadounidense. Con unos $0.11 por tarea de agente con caché, es el más barato de su clase y un 21 % por debajo de Beam.
- Espera unas semanas si va a soportar tráfico de producción. Un solo proveedor, una disponibilidad diaria del 51-60 % y una ventana de contexto que cambió a mitad de día son problemas de la semana de lanzamiento, y un segundo proveedor resolverá la mayoría.
- Aloja tú mismo solo cuando las normas obliguen a mantener los datos en casa o puedas mantener dos B200 ocupadas unas dos terceras partes de cada hora.
- Busca otra opción si el precio es toda la decisión. DeepSeek V4.1 Flash cuesta menos de la mitad, y la comparativa de las mejores herramientas de asistente de programación con IA cubre el campo más amplio.
Prueba eesel
Si estabas poniendo precio a un modelo abierto para quitar tickets a tu equipo, la factura de tokens nunca fue la parte cara. El compañero de IA de helpdesk de eesel se conecta a Zendesk, Freshdesk, Gorgias y más en minutos, aprende de tus tickets anteriores y te muestra cómo los habría respondido antes de salir en producción. Los planes parten de $299 al mes, con un plan gratuito para probar.

Prueba eesel gratis.