

En resumen
Vale la pena probar LongCat 2.5 si quieres un agente de programación económico que también pueda leer capturas de pantalla y videos. Es el modelo de Meituan de 1.6T parámetros con entrada nativa de imágenes y video, a un precio de 0,30 $ de entrada y 1,20 $ de salida por millón de tokens, lo mismo que DeepSeek V4.1 Flash en horario de alta demanda. El inconveniente está en la propia tabla de pruebas de rendimiento de Meituan: DeepSeek V4.1 Flash gana en la mayoría de las filas de programación al mismo precio, y los pesos de LongCat 2.5 siguen figurando como "coming soon". Úsalo para tareas de agentes con un fuerte componente visual y no incluyas datos de clientes hasta que Meituan publique una política de datos. Para soporte, es más seguro un compañero de mesa de ayuda como eesel que puedas probar con tickets anteriores.
¿Qué es LongCat 2.5?
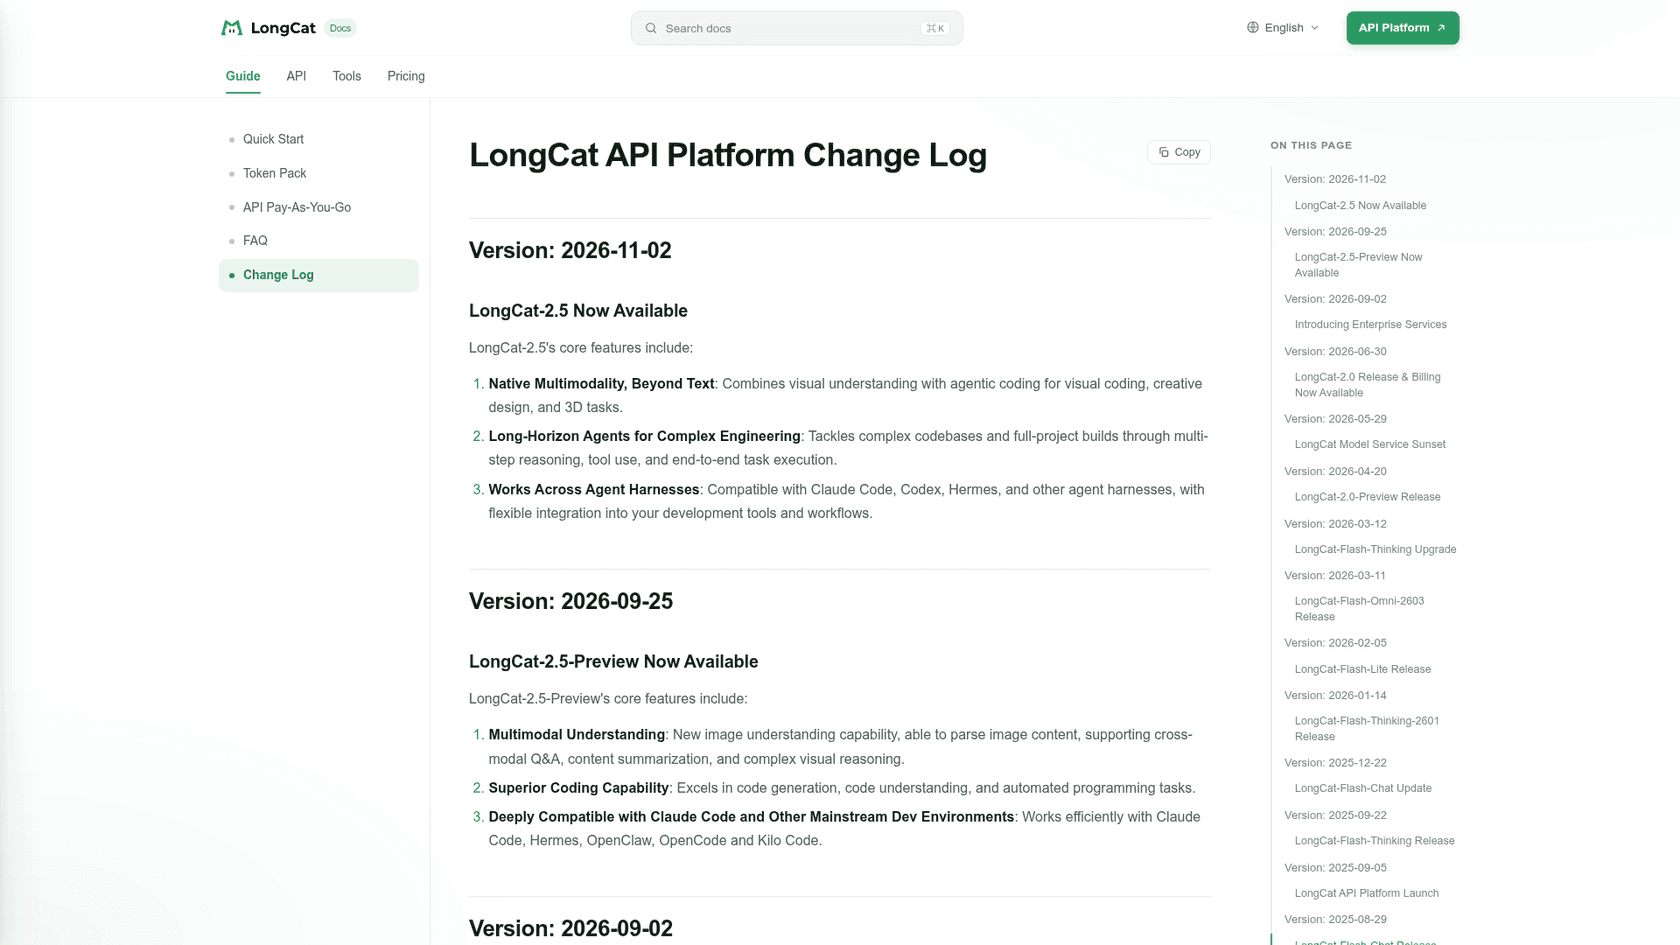
LongCat 2.5 es el modelo más reciente del equipo LongCat de Meituan. Pasó a estar disponible de forma general en LongCat API Platform el 2 de noviembre de 2026, cinco semanas después de que llegara una versión preliminar el 25 de septiembre. El registro de cambios de Meituan destaca tres características: "Native Multimodality, Beyond Text", "Long-Horizon Agents for Complex Engineering" y "Works Across Agent Harnesses".
Si te perdiste la versión anterior: LongCat 2.0 era un modelo fundacional de mezcla de expertos de 1.6 billones de parámetros con aproximadamente 48B parámetros activos por token, publicado bajo una licencia MIT con pesos en Hugging Face. Era un modelo exclusivamente de texto diseñado para tareas de programación con agentes.
Soy ingeniero de software en el equipo que desarrolla los agentes de IA de eesel, así que leo los anuncios de modelos con una pregunta en mente: ¿qué tendría que cambiar para poner esto a funcionar de verdad? Este artículo se basa en el blog técnico de LongCat 2.5 de Meituan, la documentación y el registro de cambios de la plataforma, su publicación de lanzamiento en X y lo que comentaron los desarrolladores que usaron la versión preliminar gratuita.
¿Qué cambió respecto a LongCat 2.0?
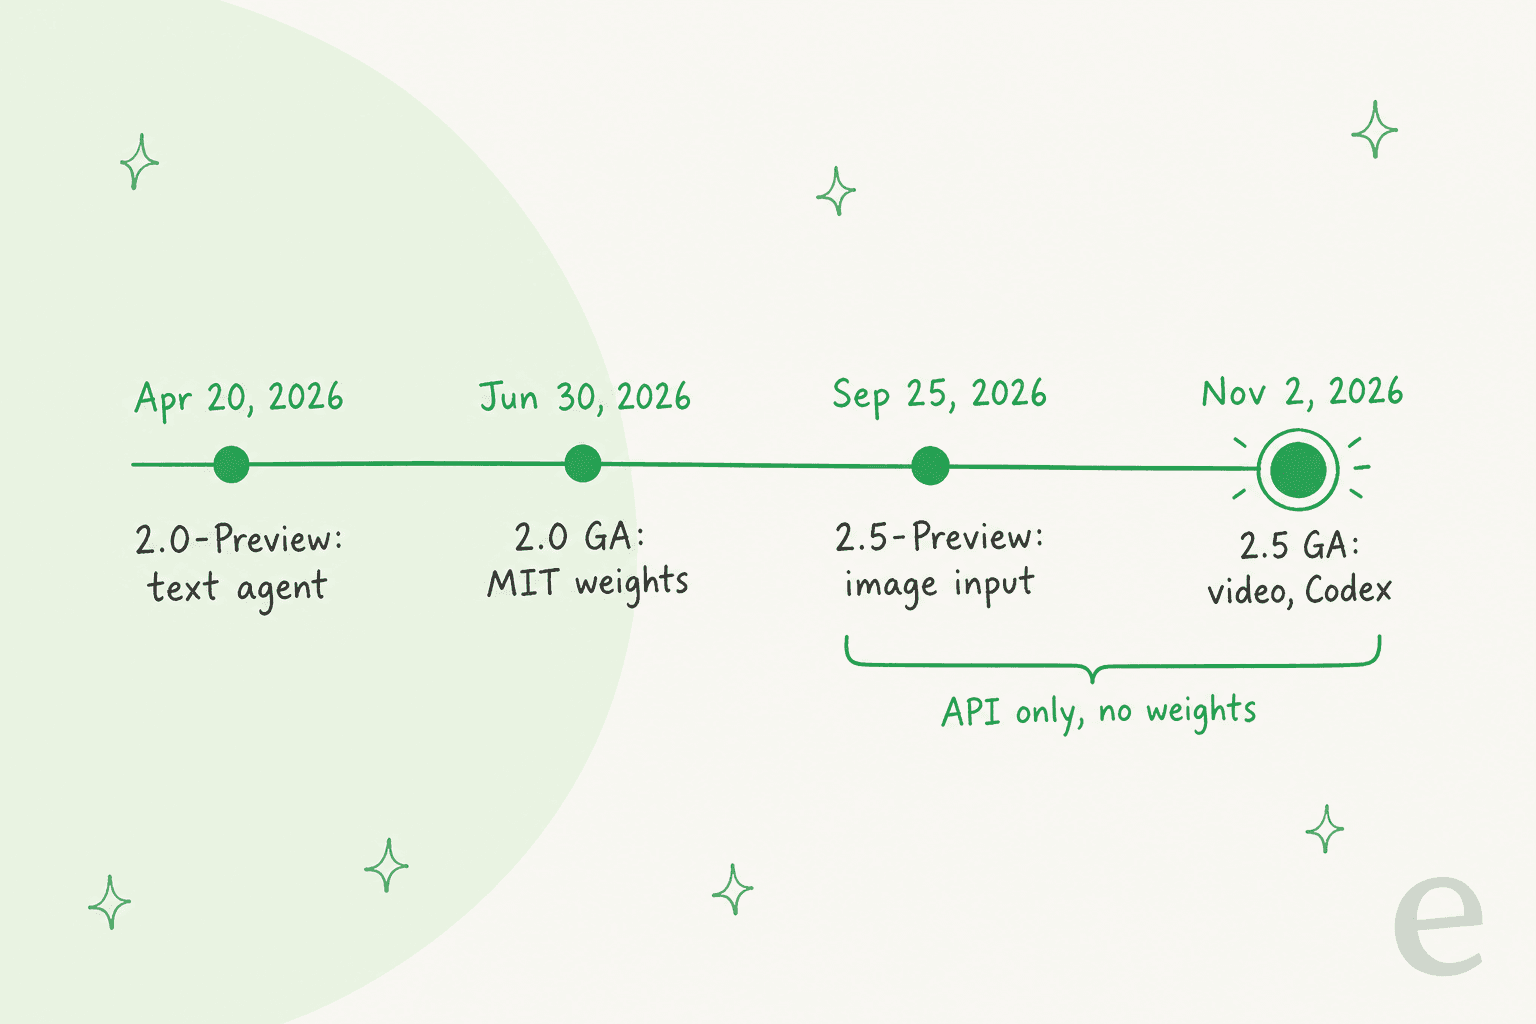
El mismo cuerpo, nuevos sentidos. El blog técnico de Meituan dice que 2.5 tiene "1.6 trillion total parameters and approximately 48 billion activated per token" y que "builds on LongCat-2.0". Así que no es un modelo nuevo y más grande. Es el diseño de mezcla de expertos de 2.0 con visión añadida y mucho más entrenamiento para agentes. Esta es la cronología.
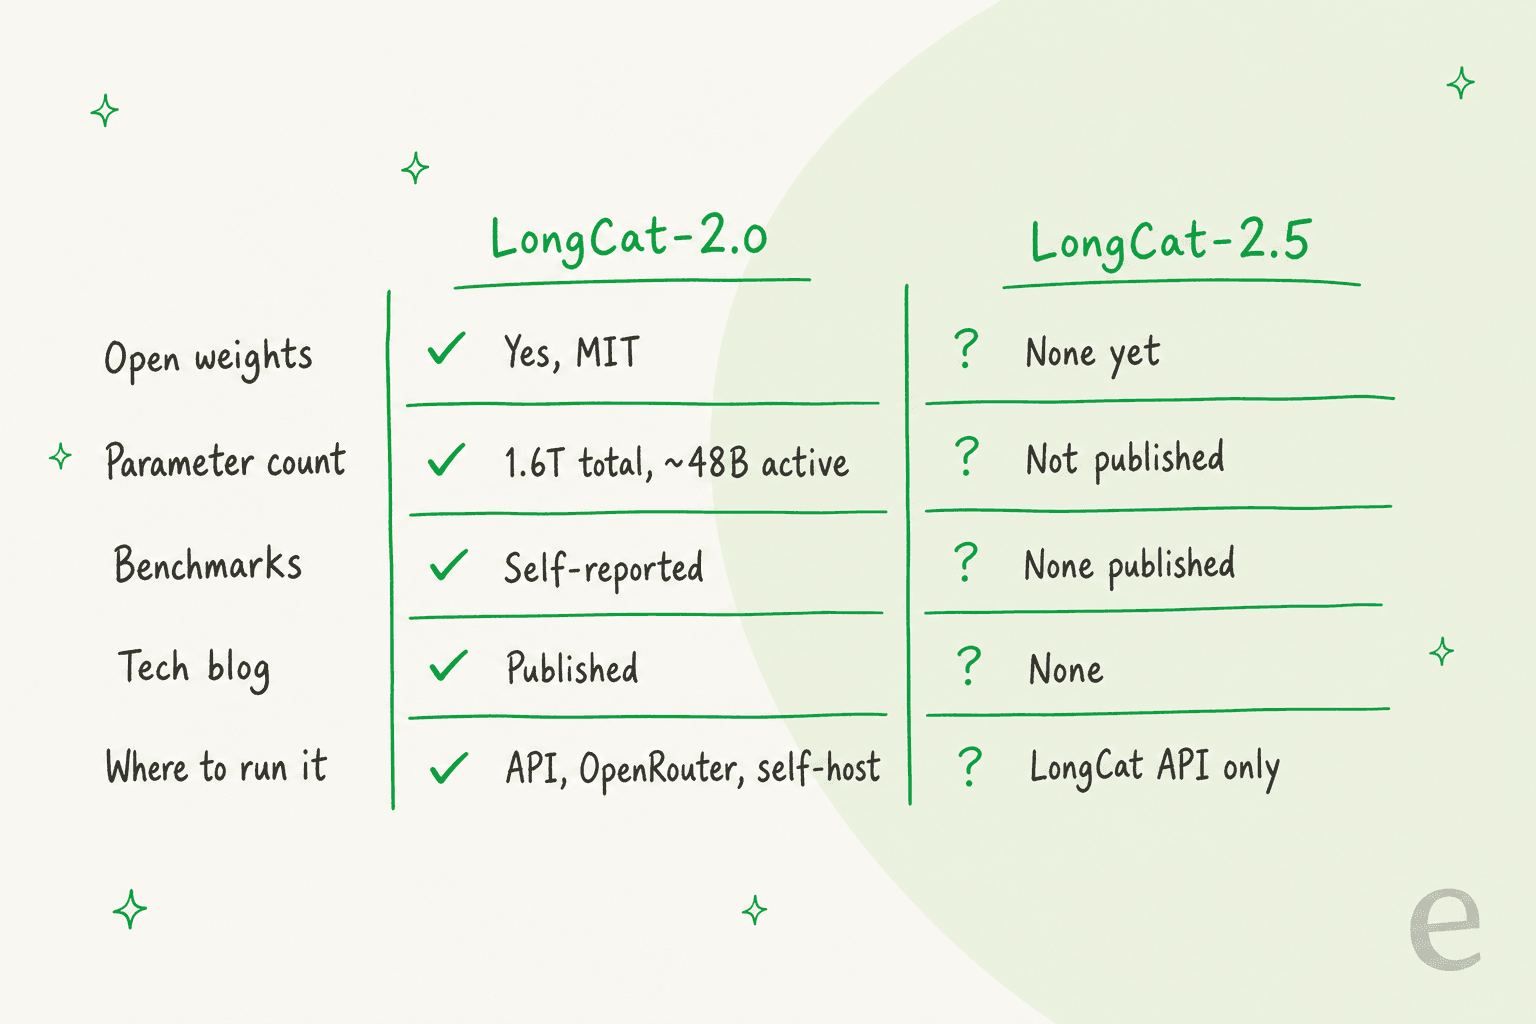
2.0 pasó de la versión preliminar a tener pesos con licencia MIT en unas diez semanas. 2.5 lleva cinco semanas disponible entre la versión preliminar y la de disponibilidad general. Su blog técnico muestra "GitHub Coming soon" y "HuggingFace Coming soon", y aún no ha aparecido nada en Hugging Face ni en GitHub. "Coming soon" es una etiqueta, no una fecha, y Meituan no ha dado ningún plazo.
Entrada de imágenes y video
Esta es la característica principal. La documentación de comprensión visual dice "The LongCat-2.5 model accepts images and videos alongside text", y los límites son generosos:
| Entrada | Formatos | Límite de tamaño | Por solicitud | Cómo enviarla |
|---|---|---|---|---|
| Imágenes | PNG, JPG, JPEG, WebP, GIF | 10 MB cada una | Hasta 50 | URL de datos Base64 o URL pública |
| Video | No se especifican | 100 MB cada uno, menos de 3.600 segundos | Hasta 10 | Solo URL pública |
La versión preliminar solo anunciaba comprensión de imágenes. El video llegó con la versión de disponibilidad general. La salida sigue siendo solo texto, así que es un modelo que lee capturas y grabaciones de pantalla, no uno que crea imágenes. No admite archivos SVG ni HEIC, y una imagen con una relación de aspecto superior a 200:1 genera un error. Tampoco hay una tarifa separada para imágenes o video en la página de precios; pagas por los tokens en los que se convierten.
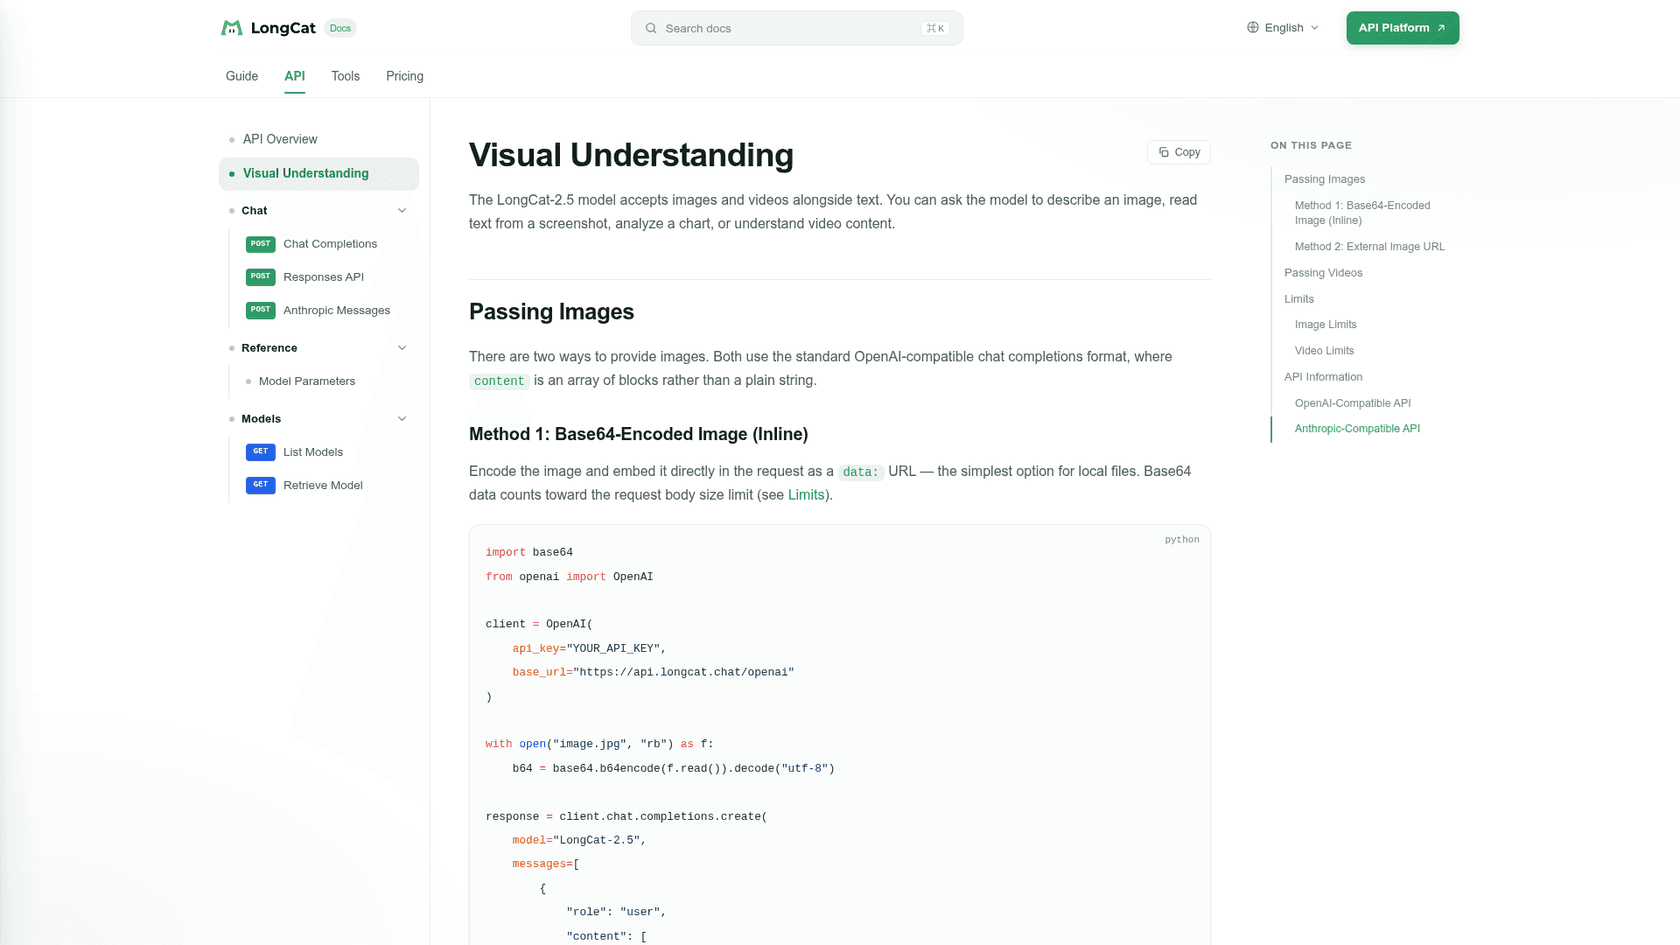
Por qué importa para programar: el registro de cambios lo presenta para "visual coding, creative design, and 3D tasks". En términos sencillos, puedes pegar una captura de pantalla de un diseño que no se ve bien y pedirle al agente que corrija el CSS. Es la misma dirección que tomó DeepSeek V4 Flash Vision, y era una carencia real de 2.0.
Cómo funciona la parte visual
La mayoría de los modelos de visión acoplan un codificador de imágenes a un modelo de texto. LongCat 2.5 convierte las imágenes en el mismo tipo de tokens que las palabras. El blog técnico dice que "represents visual signals as multi-level discrete tokens", así que la arquitectura principal lee un único flujo mixto de tokens de texto e imagen. Un tokenizador fijo permite calcular los tokens de imagen una sola vez y almacenarlos en caché sin conexión, por lo que Meituan pudo prescindir por completo del codificador visual durante el entrenamiento.
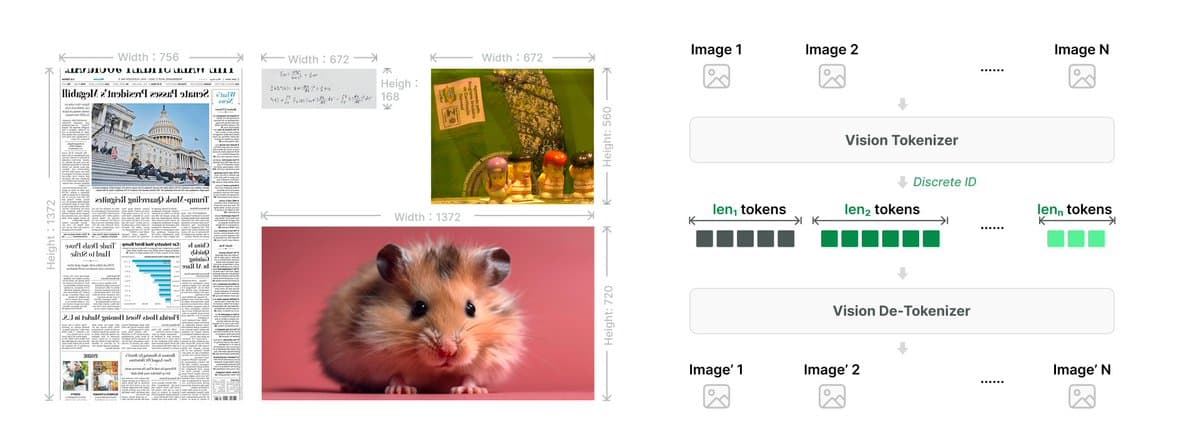
El resultado práctico es la resolución nativa: una captura de pantalla alta se convierte en más tokens en lugar de en una miniatura aplastada. En cuanto a los agentes, Meituan describe "large-scale long-horizon reinforcement learning" sobre tareas creadas a partir de solicitudes de incorporación de cambios de GitHub filtradas, con penalizaciones por "repetitive reasoning and repeated tool calls". Ten presente esa última frase para la sección sobre la comunidad.
Codex se suma a la lista de entornos de ejecución
La versión preliminar mencionaba Claude Code, Hermes, OpenClaw, OpenCode y Kilo Code. La versión de disponibilidad general añade Codex, y la documentación incluye ahora un nuevo endpoint Responses con formato OpenAI (POST /openai/v1/responses) que Codex necesita. Ese endpoint ofrece niveles de esfuerzo de none a xhigh, llamadas paralelas a herramientas activadas de forma predeterminada y salida con esquema JSON. La barra lateral de herramientas enumera 13 guías de configuración en total, desde Cline hasta Hermes Agent.
Un contexto real de 1M, sobre el papel
La publicidad de 2.0 hablaba de un contexto de 1M, mientras que la configuración publicada lo limitaba a 256K. Para 2.5 no hay una configuración que comprobar, solo la API, y la página de parámetros del modelo define la ventana de contexto como 1.048.576 tokens de entrada más salida por solicitud. En la salida es donde la documentación se contradice:
- La página de parámetros del modelo permite un
max_tokensde hasta 262.144. - Tanto la guía de inicio rápido como las preguntas frecuentes indican una salida máxima de 128K.
- La propia configuración de Claude Code de Meituan establece la salida en
131072, que equivale a 128K.
Yo planificaría con 128K de salida y trataría cualquier valor superior como un extra que debes probar.
¿Qué dicen las pruebas de rendimiento de LongCat 2.5?
Las cifras de Meituan muestran un gran salto respecto a 2.0 y un modelo cercano a la vanguardia de 2025-2026 en tareas de agentes. Su propia tabla cuenta una historia menos favorable dentro de su rango de precios. Todas las cifras siguientes proceden de la tabla de evaluación del blog técnico, con pruebas realizadas por Meituan con el razonamiento activado.
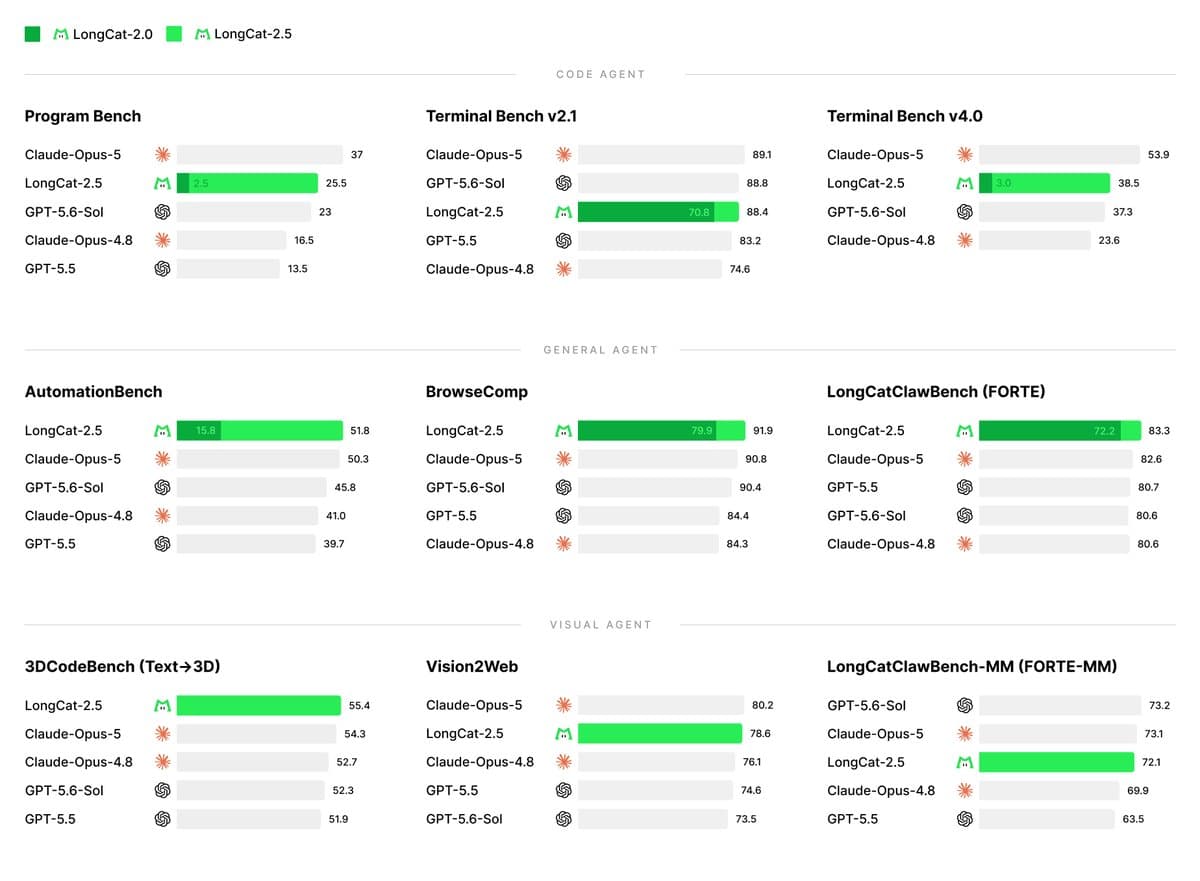
El salto de 2.0 a 2.5 es real sobre el papel. Terminal Bench 4.0 pasa de 3.0 a 38.5, AutomationBench de 15.8 a 51.8 y DeepSWE v1.1 de 9.7 a 64.6. Eso es lo que aportan meses de entrenamiento de agentes para tareas de largo recorrido.
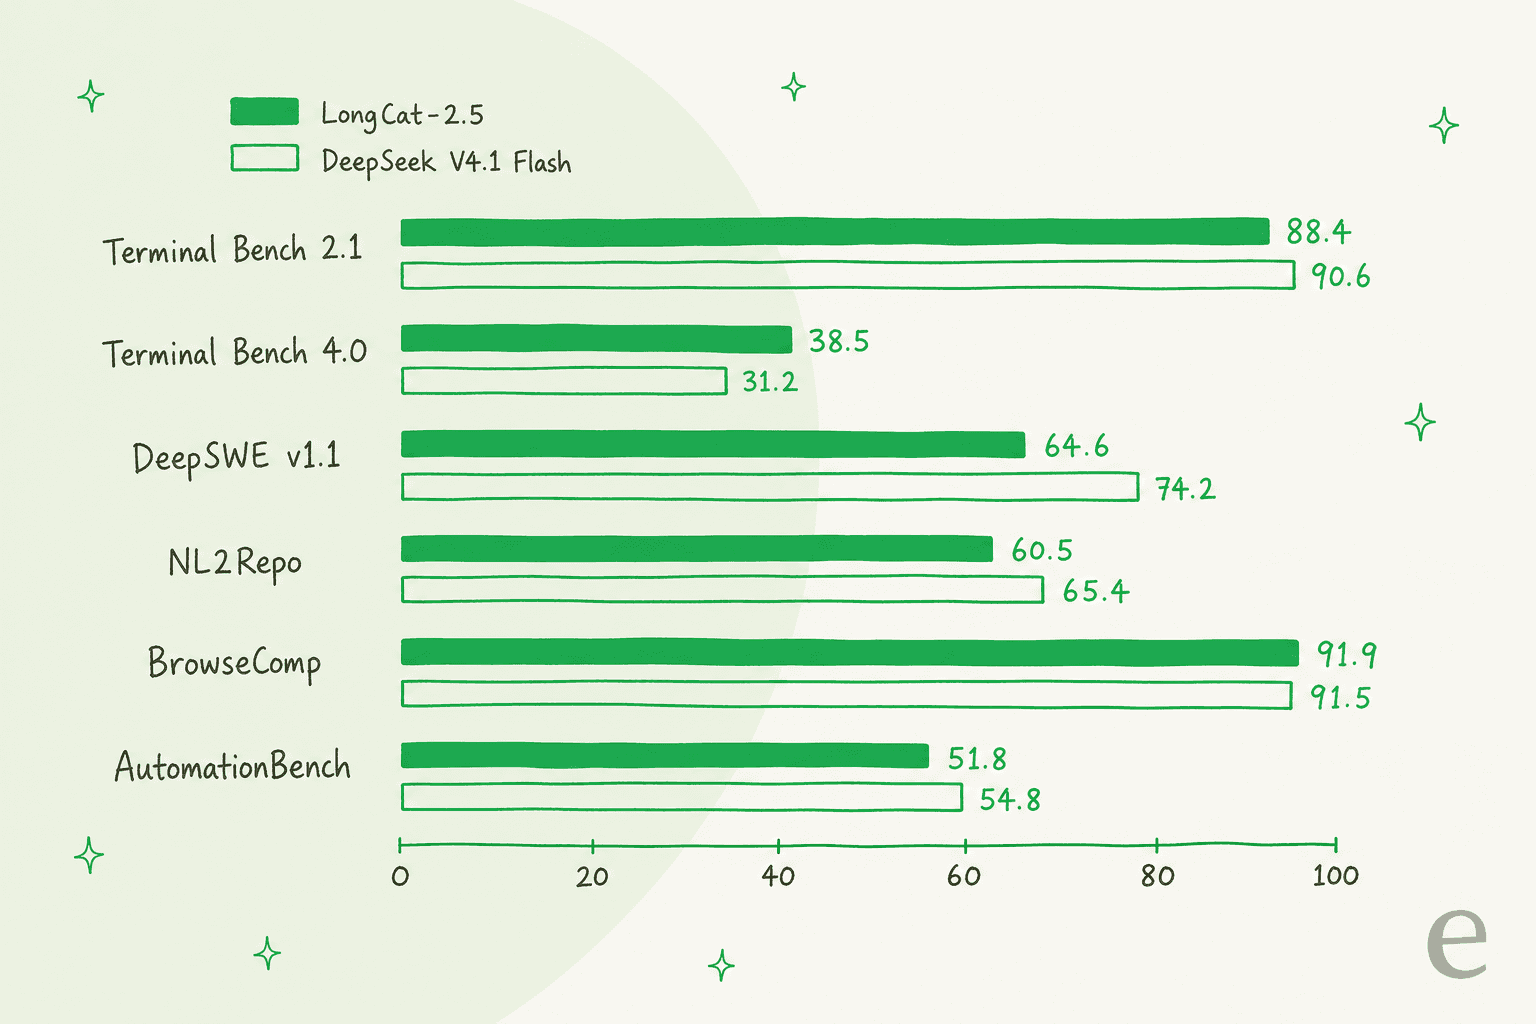
El problema está en los modelos elegidos para la comparación. Los gráficos principales lo comparan con GPT-5.5, GPT-5.6-Sol, Claude Opus 4.8 y Claude Opus 5. No aparece Claude Opus 5.5, ni GPT-6.1 Sol, ni Kimi K3.1 Pro. La tabla completa, más abajo en la página, sí añade GLM-5.3, Kimi K3 y DeepSeek V4.1 Flash, y esa última columna es la que yo leería primero, porque es el modelo que tiene exactamente el mismo precio.
| Prueba de rendimiento (tabla de Meituan) | LongCat 2.5 | LongCat 2.0 | DeepSeek V4.1 Flash | Kimi K3 | Claude Opus 5 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 70.8 | 90.6 | 88.3 | 89.1 |
| Terminal Bench v4.0 | 38.5 | 3.0 | 31.2 | 12.6 | 53.9 |
| DeepSWE v1.1 | 64.6 | 9.7 | 74.2 | 67.5 | 68.8 |
| NL2Repo | 60.5 | 40.9 | 65.4 | 58.0 | 75.3 |
| BrowseComp | 91.9 | 79.9 | 91.5 | 91.2 | 90.8 |
| MCP Atlas | 83.1 | 61.8 | 84.4 | 84.2 | 85.8 |
| VideoMME | 85.2 | - | - | 90.0 | - |
Fuente: blog técnico de LongCat-2.5. Las puntuaciones de otros modelos combinan cifras que Meituan tomó de informes públicos y de sus propias pruebas, que según el blog "are indicative only".
Leyéndolo sin rodeos: en las propias filas de programación de Meituan, DeepSeek V4.1 Flash gana más veces de las que pierde. LongCat 2.5 lidera en Terminal Bench 4.0, Program Bench, preguntas y respuestas sobre bases de código de SWE Atlas y BrowseComp, y es el único de los dos con puntuaciones publicadas de video. En las tareas de programación de largo recorrido que protagonizan el lanzamiento, el modelo de DeepSeek, más barato fuera del horario de alta demanda, va por delante.
Ningún evaluador independiente se ha puesto al día todavía. Artificial Analysis solo incluye LongCat 2.0 y LongCat Flash Lite, y la API de modelos de OpenRouter devuelve un modelo de Meituan, meituan/longcat-2.0. Una comprobación útil de la diferencia: Artificial Analysis midió LongCat 2.0 en 50,2 % en Terminal-Bench 2.1, mientras que la tabla de Meituan le da a 2.0 un 70.8. Son entornos de ejecución distintos, pero una diferencia de 20 puntos es motivo para hacer tu propia prueba en lugar de confiar en cualquiera de las dos columnas.
¿Cuánto cuesta LongCat 2.5?
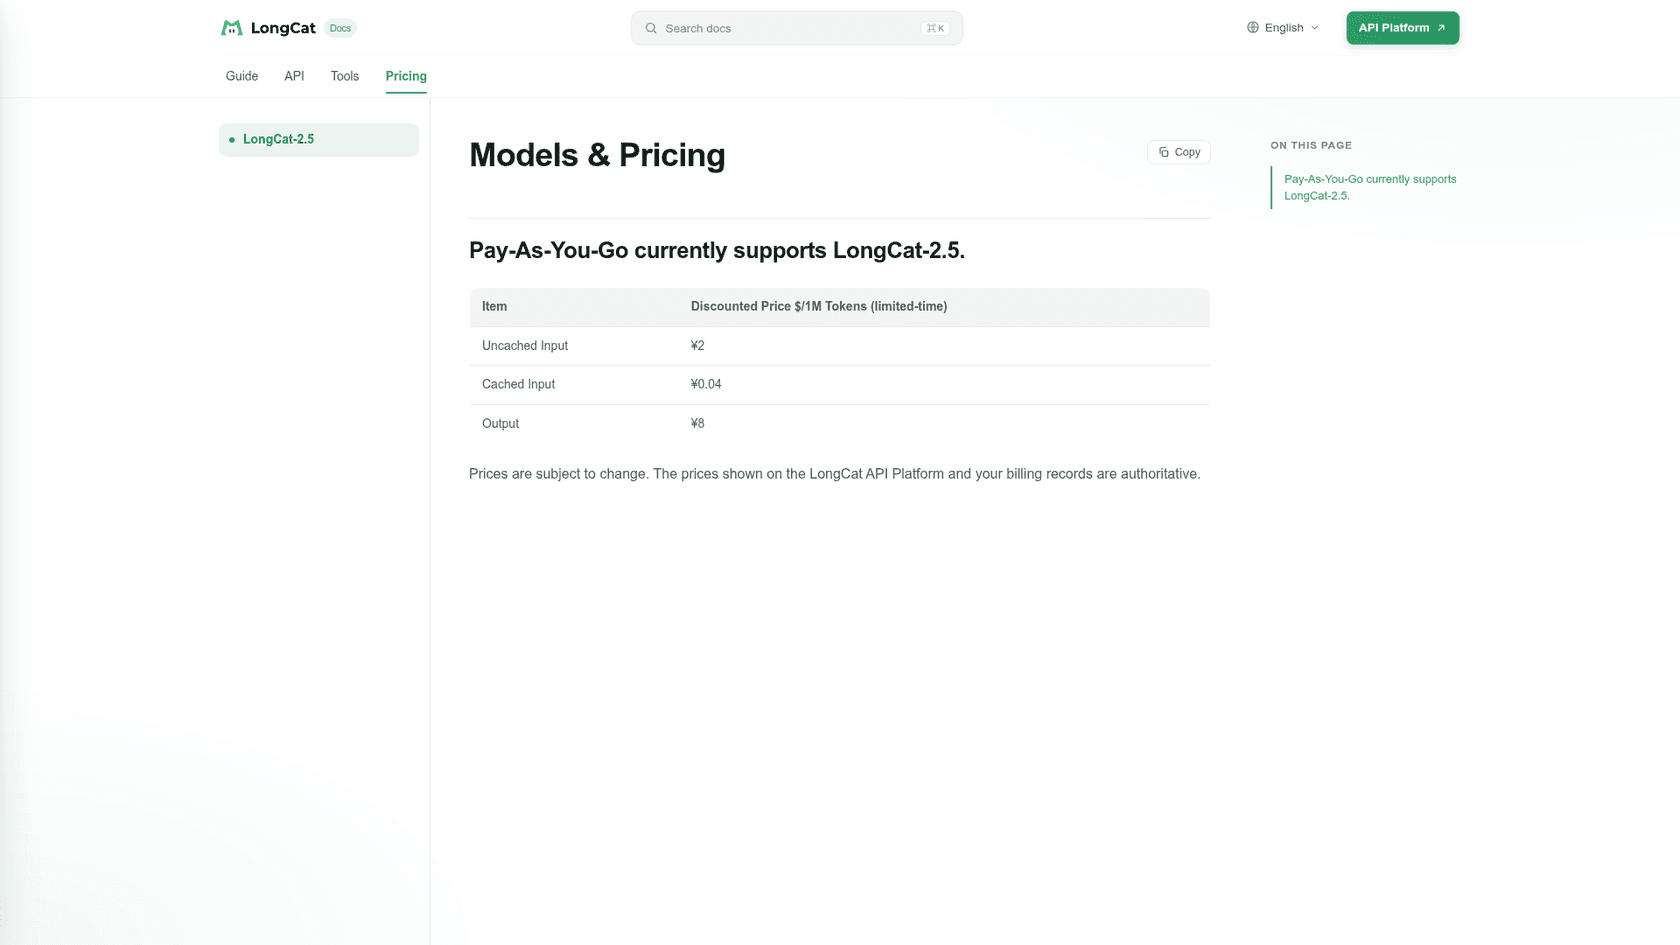
LongCat 2.5 cuesta 0,30 $ por millón de tokens de entrada y 1,20 $ por millón de tokens de salida, con la entrada en caché a 0,006 $. Todas las cifras de la página llevan la etiqueta "Discounted Price (limited-time)".
| Concepto | USD por 1M de tokens | CNY por 1M de tokens |
|---|---|---|
| Entrada sin caché | 0,30 $ | ¥2 |
| Entrada en caché | 0,006 $ | ¥0.04 |
| Salida | 1,20 $ | ¥8 |
| Recargo por longitud del contexto | Ninguno | Ninguno |
| Recargo por imágenes o video | No se indica ninguno | No se indica ninguno |
Fuente: precios de LongCat-2.5 y API Pay-As-You-Go.
Destacan dos cosas. La entrada en caché cuesta el 2 % del precio sin caché, lo que importa mucho para los agentes de programación que reenvían los mismos archivos en cada turno. Y no hay tramos según la longitud, así que una solicitud de 900K tokens cuesta lo mismo por token que una de 9K.
El propio ejemplo de cálculo de Meituan: una solicitud con 600.000 tokens de entrada sin caché, 400.000 tokens de entrada en caché y 500.000 tokens de salida cuesta 0,7824 $. Solo se facturan las llamadas exitosas (HTTP 200), el saldo prepago nunca caduca y no hay un compromiso mínimo.
¿Qué pasa cuando termina el descuento?
Nadie lo sabe, y ese es el verdadero riesgo del precio. La página de 2.5 solo muestra la columna con descuento. Una antigua página de precios de LongCat 2.0, sin enlaces que lleven a ella, todavía muestra el precio de lista de 2.0 junto al mismo descuento: 0,75 $ de entrada, 0,015 $ en caché y 2,95 $ de salida. Si 2.5 acaba adoptando el precio de lista de 2.0, el costo de salida sube unas 2.5 veces. Meituan no ha dicho que lo hará, ni ha dicho que no lo hará.
Cómo se compara en precio
| Modelo | Entrada / 1M | En caché / 1M | Salida / 1M | Contexto / salida máxima | Página de precios del proveedor |
|---|---|---|---|---|---|
| LongCat 2.5 (promoción) | 0,30 $ | 0,006 $ | 1,20 $ | 1M / 128K | LongCat |
| DeepSeek V4.1 Flash (alta demanda) | 0,30 $ | 0,006 $ | 1,20 $ | 1M / 384K | DeepSeek |
| DeepSeek V4.1 Flash (baja demanda) | 0,15 $ | 0,003 $ | 0,60 $ | 1M / 384K | DeepSeek |
| Qwen 3.8 Max | 2,00 $ | 0,25 $ | 6,00 $ | 1M / 131K | QwenCloud |
| Kimi K3.1 Pro | 2,00 $ | 0,20 $ | 10,00 $ | 1M | Kimi |
| Kimi K3 | 3,00 $ | 0,30 $ | 15,00 $ | 1M | Kimi |
La fila interesante es la de DeepSeek. La tarifa promocional de LongCat 2.5 es idéntica, centavo por centavo, a la tarifa de DeepSeek V4.1 Flash en horario de alta demanda, y DeepSeek la reduce a la mitad fuera de ese horario. Así que 2.5 no es barato de una forma que ningún otro modelo lo sea. Es barato dentro del mismo rango que el modelo económico más usado de la categoría, que cuenta con puntuaciones independientes, una salida máxima más larga y una guía de la API publicada. La ventaja de LongCat frente a él tiene que venir de la entrada de video y de la calidad de programación que tú mismo midas.
Ahora es más fácil pagar
Las recargas de 2.0 solo admitían Alipay y WeChat Pay, lo que dejaba fuera a la mayoría de los equipos occidentales. La página de Pay-As-You-Go ahora incluye tarjetas de crédito y débito y Google Pay para el sitio en USD, y fuera de China continental puedes registrarte por correo electrónico sin verificación de identidad. Los Token Packs (una cuota fija válida durante 30 días, a la venta en lanzamientos relámpago a las 10:00, 16:00, 21:00 y 23:00, hora de Pekín) siguen existiendo, pero sus tamaños y precios solo se ven en la consola tras iniciar sesión.
Las empresas verificadas también reciben descuentos por volumen en el gasto de Pay-As-You-Go:
| Gasto mensual (sitio en USD) | Gasto mensual (sitio en CNY) | Descuento |
|---|---|---|
| 75 $ o más | ¥500 o más | 10 % de descuento |
| 300 $ o más | ¥2.000 o más | 20 % de descuento |
| 1.200 $ o más | ¥8.000 o más | 30 % de descuento |
| 6.000 $ o más | ¥40.000 o más | 40 % de descuento |
Fuente: preguntas frecuentes de LongCat.
¿Cómo ejecutas LongCat 2.5 en Claude Code o Codex?
Apuntas el entorno de ejecución al endpoint de LongCat con formato Anthropic u OpenAI y estableces el nombre del modelo en LongCat-2.5. La guía de Claude Code lo coloca en ~/.claude/settings.json:
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "your_longcat_api_key",
    "ANTHROPIC_BASE_URL": "https://api.longcat.chat/anthropic",
    "ANTHROPIC_MODEL": "LongCat-2.5",
    "ANTHROPIC_SMALL_FAST_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "LongCat-2.5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "LongCat-2.5",
    "CLAUDE_CODE_MAX_OUTPUT_TOKENS": "131072",
    "CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC": 1
  }
}
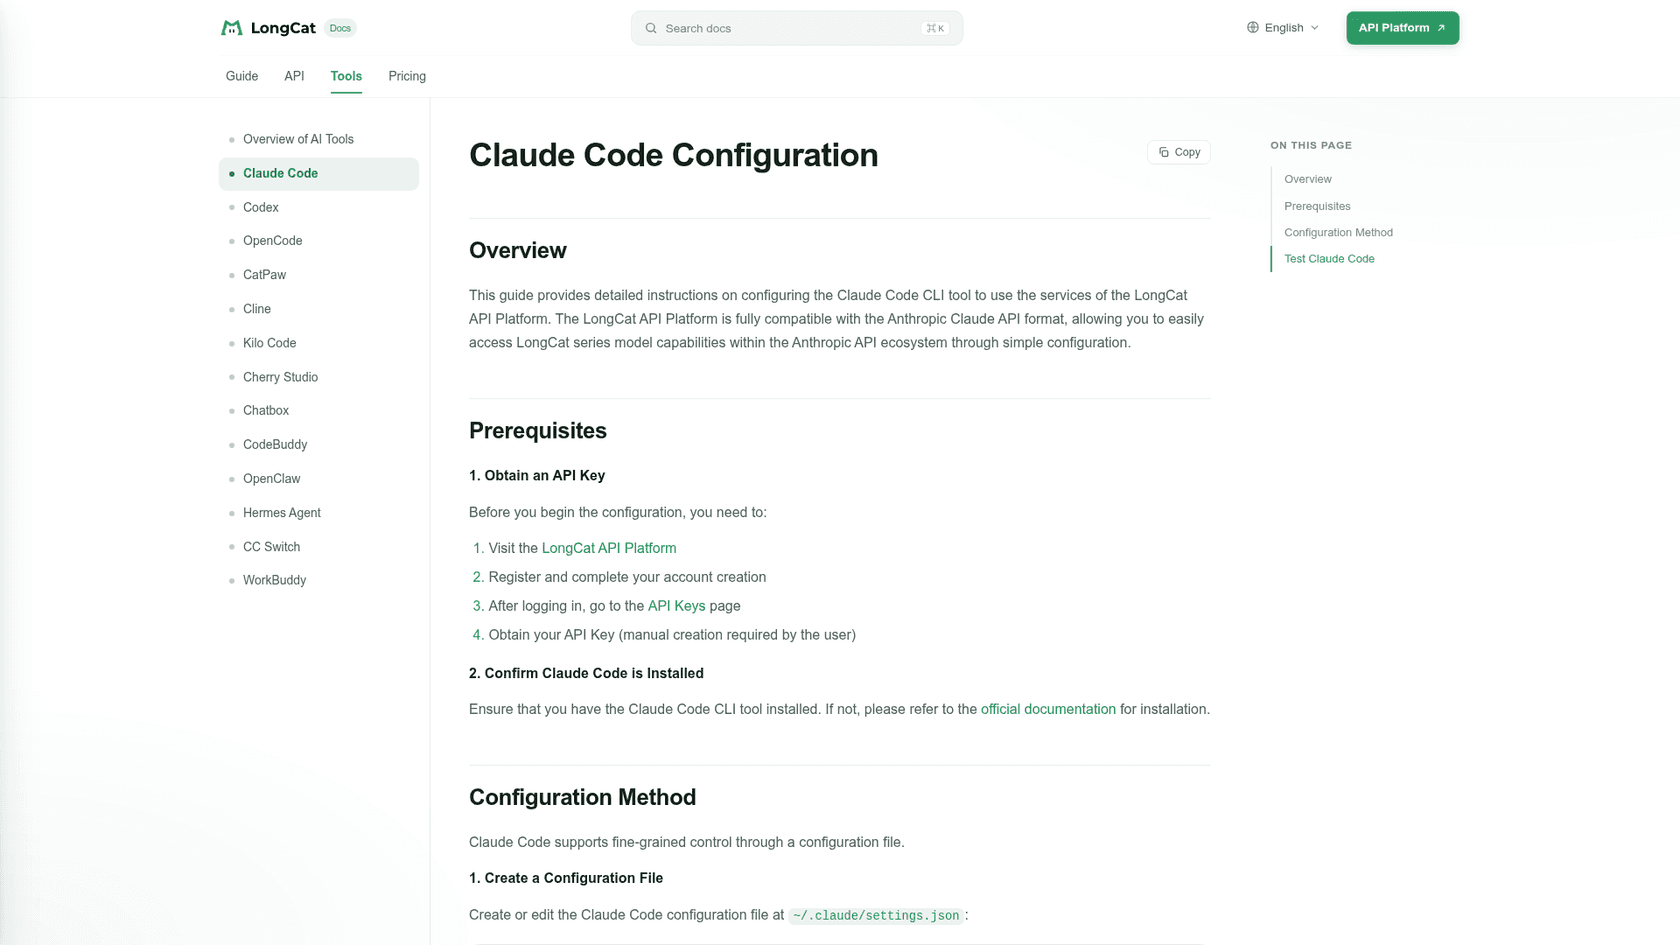
Fíjate en que todas las opciones de modelo apuntan al mismo, incluida la de "small fast" que Claude Code normalmente usa para llamadas económicas en segundo plano. Eso está bien con una salida a 1,20 $, pero significa que pierdes la diferencia de velocidad que tendrías con un modelo pequeño de verdad.
Para Codex, estableces model = "LongCat-2.5", model_reasoning_effort = "high", la URL base https://api.longcat.chat/openai/v1 y wire_api = "responses" en ~/.codex/config.toml, con la clave en ~/.codex/auth.json.
Tres particularidades que yo tendría en cuenta antes de la primera ejecución:
- La temperatura es fija. Es 1.0 con el razonamiento activado y 0.7 con él desactivado, y los demás valores se sustituyen silenciosamente en lugar de rechazarse (parámetros del modelo). Si tu entorno de evaluación prueba distintos valores de temperatura, no está haciendo lo que crees.
- Los límites de uso no están publicados. Los límites son por clave de API y devuelven un 429 con
retry_after: 60, pero no aparece ninguna cifra de solicitudes por minuto ni de tokens por minuto en la descripción general de la API. - Los identificadores de modelos antiguos pueden desaparecer. LongCat 2.0 y 2.5-Preview han desaparecido de todas las tablas de modelos compatibles sin un aviso de retirada con fecha. Si fijaste
LongCat-2.0, pruébalo hoy.
Si quieres una visión más amplia de los agentes de programación para terminal antes de elegir uno, la recopilación de CLI de programación con agentes los compara uno al lado del otro.
¿Qué dicen los desarrolladores sobre LongCat 2.5?
La versión preliminar estuvo disponible gratis dentro de OpenCode durante dos semanas, así que hay más opiniones basadas en el uso real de lo habitual para un modelo lanzado hace un día. El tema más recurrente es que entra en bucles en tareas largas.
"Longcat is fantastic until it get stuck in loops. I think around 200k tokens of context it loses it. I have been compacting and continuing."

Eso encaja con que Meituan haya añadido penalizaciones por "repetitive reasoning and repeated tool calls" durante el entrenamiento. Lo primero que probaría es si la versión de disponibilidad general lo ha solucionado. Como contrapunto justo, a quienes lo limitaron a una función concreta les gustó:
"Longcat is ok as cheap vision agent, tiny tasks, commit. But definitely not as planner, creative writing."
Un desarrollador probó por su cuenta la versión preliminar gratuita con Terminal-Bench 2.1 y obtuvo 48,7 % pass@1, con la mayor eficiencia en tokens de los cuatro modelos que probó, unos 0.54M tokens por ensayo (r/opencode). Se trata de una versión preliminar, un entorno de ejecución distinto y una configuración diferente de los que produjeron el 88.4 de Meituan, así que tómalo como una comprobación de plausibilidad, no como un veredicto.
En Hacker News, el hilo del lanzamiento se centró en el precio y la elección de rivales:
"Same price as DS4.1F ... On benchmarks they seem comparable. The wild cards are the cache hit rate and speed."

"LongCat-2.5's chart skips Opus 5.5 and every current frontier model. This always happens, and people defend it because they say it's not fair to compare them. But it absolutely is!"
Y un recordatorio de que el chat para usuarios finales está menos pulido que la API: un comentarista de HN encontró que el enlace del chat de longcat.ai redirigía a una página de inicio de sesión en otro dominio y que las respuestas salían en mandarín de forma predeterminada. Si solo lo pruebas a través de la aplicación de chat, no estás probando lo que te ofrece la API.
¿Deberías usar LongCat 2.5 para atención al cliente?
No como modelo detrás de una cola de soporte, al menos todavía no. La razón no es el precio ni la calidad. Son los datos. Las preguntas frecuentes de LongCat y las páginas de facturación no dicen nada sobre cuánto tiempo se conservan los prompts ni si el tráfico de la API se usa para entrenamiento. Cuando un prompt contiene el nombre, el pedido y la dirección de un cliente, ese silencio determina la decisión, el mismo obstáculo que señalé en el análisis de 2.0.
También hay una cuestión más importante. Un modelo es infraestructura. Para responder bien a los tickets también necesitas conexiones con la base de conocimientos, reglas de escalamiento, el tono y una forma de comprobar las respuestas antes de que los clientes las vean. Eso implica desarrollar muchas cosas sobre una API, que es la disyuntiva que se aborda en desarrollar o comprar para soporte con IA.
Ese es el vacío que cubre eesel. eesel es una plataforma de compañeros de equipo de IA, y su compañero de mesa de ayuda con IA se incorpora a tu mesa de ayuda actual, aprende de tu centro de ayuda y tus tickets anteriores, y responde en tu cola. Antes de entrar en producción, se prueba con tus tickets históricos para que puedas leer lo que habría dicho. He visto bots que suenan seguros dar respuestas incorrectas en colas reales, y por eso cada implementación de eesel se simula con tickets anteriores antes de tocar uno en vivo.
SE Ranking es un buen ejemplo de cómo se ve eso en la práctica. Gestiona tres productos en Zendesk con un agente de eesel para cada uno, y en un mes esos agentes atendieron 4.650 conversaciones, incluidos 2.100 chats en vivo respondidos primero por eesel, basándose en unas 16.800 páginas de conocimiento. SamCart usa un agente para los tickets de Freshdesk y otro en el chat de su sitio web, que responden a partir de 280 artículos del centro de ayuda.
Y si mirabas LongCat 2.5 porque te gusta trabajar desde Claude Code o Codex, eesel también te acompaña ahí. La CLI de eesel (@eesel/cli) te permite conectar una mesa de ayuda, leer y editar las instrucciones permanentes del agente, aprobar o rechazar acciones y leer lo que hizo el agente en cada ejecución, todo desde la terminal. Cada comando imprime JSON y las operaciones de escritura admiten --dry-run, así que un agente de programación puede manejarla de forma segura, y cada espacio de trabajo también es un servidor MCP que puedes añadir a Claude Code. El agente de programación configura al compañero de soporte; no tiene que convertirse en uno.
¿Quién debería usar LongCat 2.5?
Mi opinión, después de leer todas las páginas que publicó Meituan:
- Pruébalo si usas agentes de programación con un presupuesto ajustado y quieres uno que pueda leer capturas o grabaciones de pantalla. A 0,30 $ / 1,20 $ con entrada en caché al 2 %, una tarde de pruebas en tu propio repositorio cuesta unos pocos dólares. Compáralo directamente con DeepSeek V4.1 Flash al mismo precio.
- Espera si necesitas pesos abiertos, una licencia o alojamiento propio. Meituan dice que los pesos están "coming soon", y aun así un modelo de 1.6T necesita un nodo con varias GPU. Hoy LongCat 2.0 es el único de los dos que puedes descargar.
- Descártalo por ahora si tus prompts contienen datos de clientes o sujetos a regulación. Sin una política publicada de retención o entrenamiento no hay luz verde, sea cual sea el precio.
- Elige DeepSeek en su lugar si todo el trabajo consiste en programación de largo recorrido. Al mismo precio, la propia tabla de Meituan sitúa a DeepSeek V4.1 Flash por delante en DeepSWE, NL2Repo y Terminal Bench 2.1, y es más barato fuera del horario de alta demanda. Si necesitas puntuaciones medidas de forma independiente, Kimi K3.1 Pro y Qwen 3.8 Max cuestan más, pero ya se han probado.
El resumen justo: LongCat 2.5 es una mejora real respecto a 2.0, con visión integrada en lugar de añadida como un accesorio, y a un precio que no ha cambiado. Simplemente no es la elección obvia dentro de su rango de precios para programación pura, y eso se ve en su propia tabla de pruebas de rendimiento.
Prueba eesel
Si llegaste a LongCat 2.5 con la esperanza de que un modelo barato le quitara tickets de encima a tu equipo, ahórrate el trabajo de integración. El compañero de mesa de ayuda con IA de eesel se conecta a Zendesk, Freshdesk, Gorgias y los demás en minutos, aprende de tus tickets anteriores y te muestra cómo los habría respondido antes de entrar en producción. Los planes empiezan en 299 $ al mes, con una opción gratuita para hacer pruebas.

Prueba eesel gratis.