

Mi veredicto sobre MiniMax M3.1 Flash es 3,5/5: un caballo de batalla barato y rápido para agentes que no supera a DeepSeek en código. MiniMax lo lanzó el 19 de octubre de 2026 a un precio plano de $0.15 de entrada y $0.60 de salida por millón de tokens en su página de precios, sin recargo por contexto largo en su ventana de 1M. Lidera la tabla propia de MiniMax en Automation-Bench (62.8) y empata con Claude Opus 5 en BankerToolBench (76.2).
El problema está en esa misma tabla. Frente a DeepSeek V4.1 Flash 1017, que cuesta lo mismo fuera de horas punta, M3.1 Flash gana uno de seis benchmarks compartidos y queda por detrás en DeepSWE (73.7 frente a 77.0), Terminal-Bench 4.0 y NL2Repo. Su gráfico de coste por tarea valora a DeepSeek a tarifas de hora punta, lo que favorece a MiniMax. Los pesos están prometidos para el 23 de octubre.
Así que lo usaría para bucles de agentes tipo oficina, llamadas a herramientas y trabajo con documentos largos, y elegiría DeepSeek para trabajo duro en repositorios. Para los equipos de soporte, el modelo es la parte más pequeña del trabajo: el compañero de IA para helpdesk de eesel aporta la conexión con el helpdesk, el conocimiento y una reproducción de tus tickets pasados, que es como smava procesa unos 27,000 tickets al mes con él.
¿Cuál es mi veredicto sobre MiniMax M3.1 Flash?
Paso la mayor parte de la semana mirando lo que la gente busca antes de comprar, y las búsquedas en torno a este lanzamiento son directas: "is M3.1 Flash better than DeepSeek", "is it open source", "what does it cost". Esta reseña las responde, en ese orden. Si quieres la ficha técnica sencilla de los días de la vista previa, la descripción general de M3.1 Flash de mi colega sigue cubriendo el selector de esfuerzo y el contexto de 1M.
También formo parte de un equipo que lleva años ejecutando IA en colas de soporte reales, y esa historia condiciona cómo puntúo un modelo. Un modelo más barato hace que "lo construimos nosotros" suene fácil. Un cliente mediano que se dio de baja nos lo dijo exactamente así al marcharse:
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Modelos como M3.1 Flash son la razón por la que esa frase suena cierta. Que lo sea depende de todo lo que rodea al modelo, así que puntúo tanto el motor como hasta dónde te lleva.
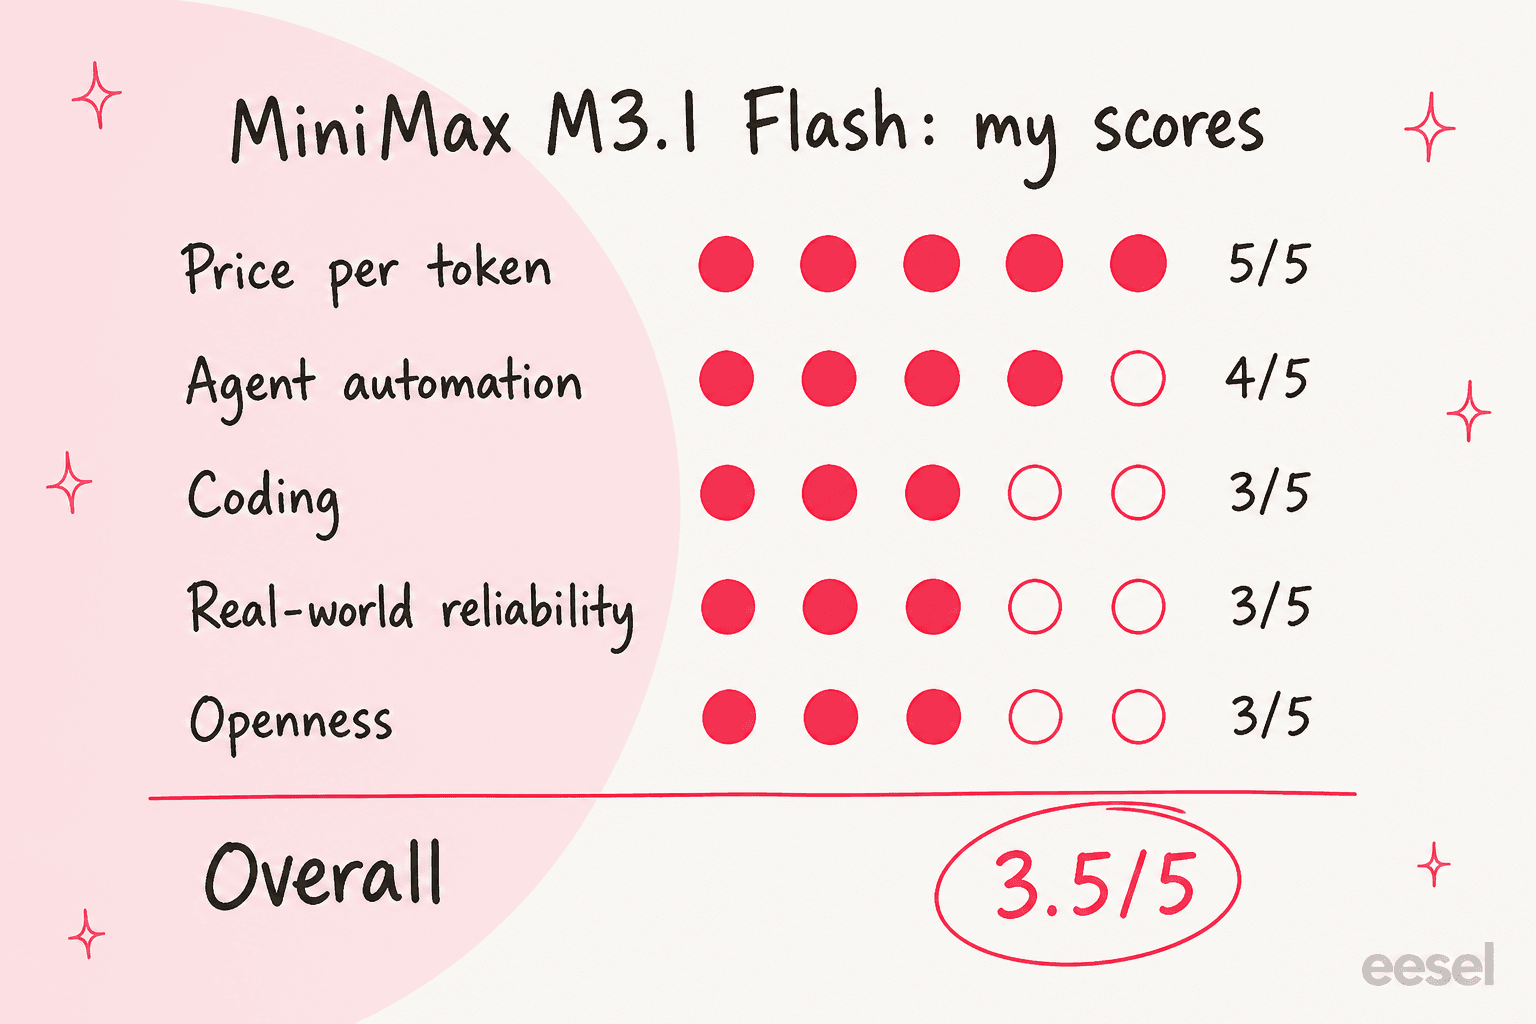
| Área | Nota | Por qué |
|---|---|---|
| Precio por token | 5/5 | $0.15/$0.60 plano en 1M de tokens, la mitad de la tarifa de contexto corto de MiniMax M3 |
| Automatización de agentes | 4/5 | Mejor en Automation-Bench en la tabla de MiniMax, empata con Opus 5 en BankerToolBench |
| Programación | 3/5 | Queda por detrás de DeepSeek V4.1 Flash 1017 en DeepSWE, Terminal-Bench 4.0 y NL2Repo |
| Fiabilidad en el mundo real | 3/5 | Los primeros probadores reportan pereza y divagación con esfuerzo alto |
| Apertura | 3/5 | Pesos prometidos para el 23 de octubre, aún no publicados |
| Total | 3,5/5 | Un motor barato y potente para bucles de agentes, no el rey barato de la programación |
Estas puntuaciones son mías. Proceden de la publicación de lanzamiento de MiniMax, sus páginas de documentación y precios, las páginas de precios de la competencia y lo que publicaron los desarrolladores en las primeras 24 horas.
¿Qué se lanzó realmente el 19 de octubre?
La vista previa sobre la que escribí en septiembre ya no existe. La documentación de MiniMax ahora lista MiniMax-M3.1-Flash como el último modelo de la serie M, y la documentación de M Plan dice que el antiguo nombre MiniMax-M3.1-Flash-Preview se ha retirado y que las solicitudes las atiende ahora el nuevo modelo. También confirmó el rumor del periodo sigiloso: "Space Bunny", el modelo anónimo que procesó más de 200 billones de tokens, era una versión temprana.
Esto es lo que cambió entre la vista previa y el lanzamiento general:
| Vista previa (27 sept.) | Lanzamiento general (19 oct.) | |
|---|---|---|
| ID del modelo | MiniMax-M3.1-Flash-Preview | MiniMax-M3.1-Flash |
| Dónde | Solo MiniMax Code y Token Plan | API, M Plan y MiniMax Code |
| Precio por token | Ninguno publicado | $0.15 entrada / $0.60 salida / $0.015 en caché |
| Afirmación de velocidad | Ninguna | 200+ tokens por segundo, P50 170+ |
| Benchmarks | Ninguno | Tabla de 15 filas frente a seis rivales |
| Pesos | Ninguno | Prometidos para el 23 de octubre |
Tres cosas siguen igual, y aún condicionan cómo se usa. La ventana de contexto es de 1.000.000 de tokens. La entrada puede ser texto, imágenes o vídeo. Y el razonamiento está siempre activado: se fija effort de low a max (por defecto max), y enviar effort: "none" devuelve un error 400, según la documentación de generación de texto.
Un detalle más importa para quien planee alojarlo por su cuenta. El nombre "Flash" no significa pequeño. La página de Code de MiniMax indica una arquitectura de mezcla de expertos con 428B parámetros totales y unos 23B activos, la misma clase de tamaño que MiniMax M3. Un comentarista de Reddit lo dijo bien:
"yeah fair point, the "flash" name is kinda misleading. same 428b / 23b active as m3, so if you could run m3 you can run this."

¿Dónde gana?
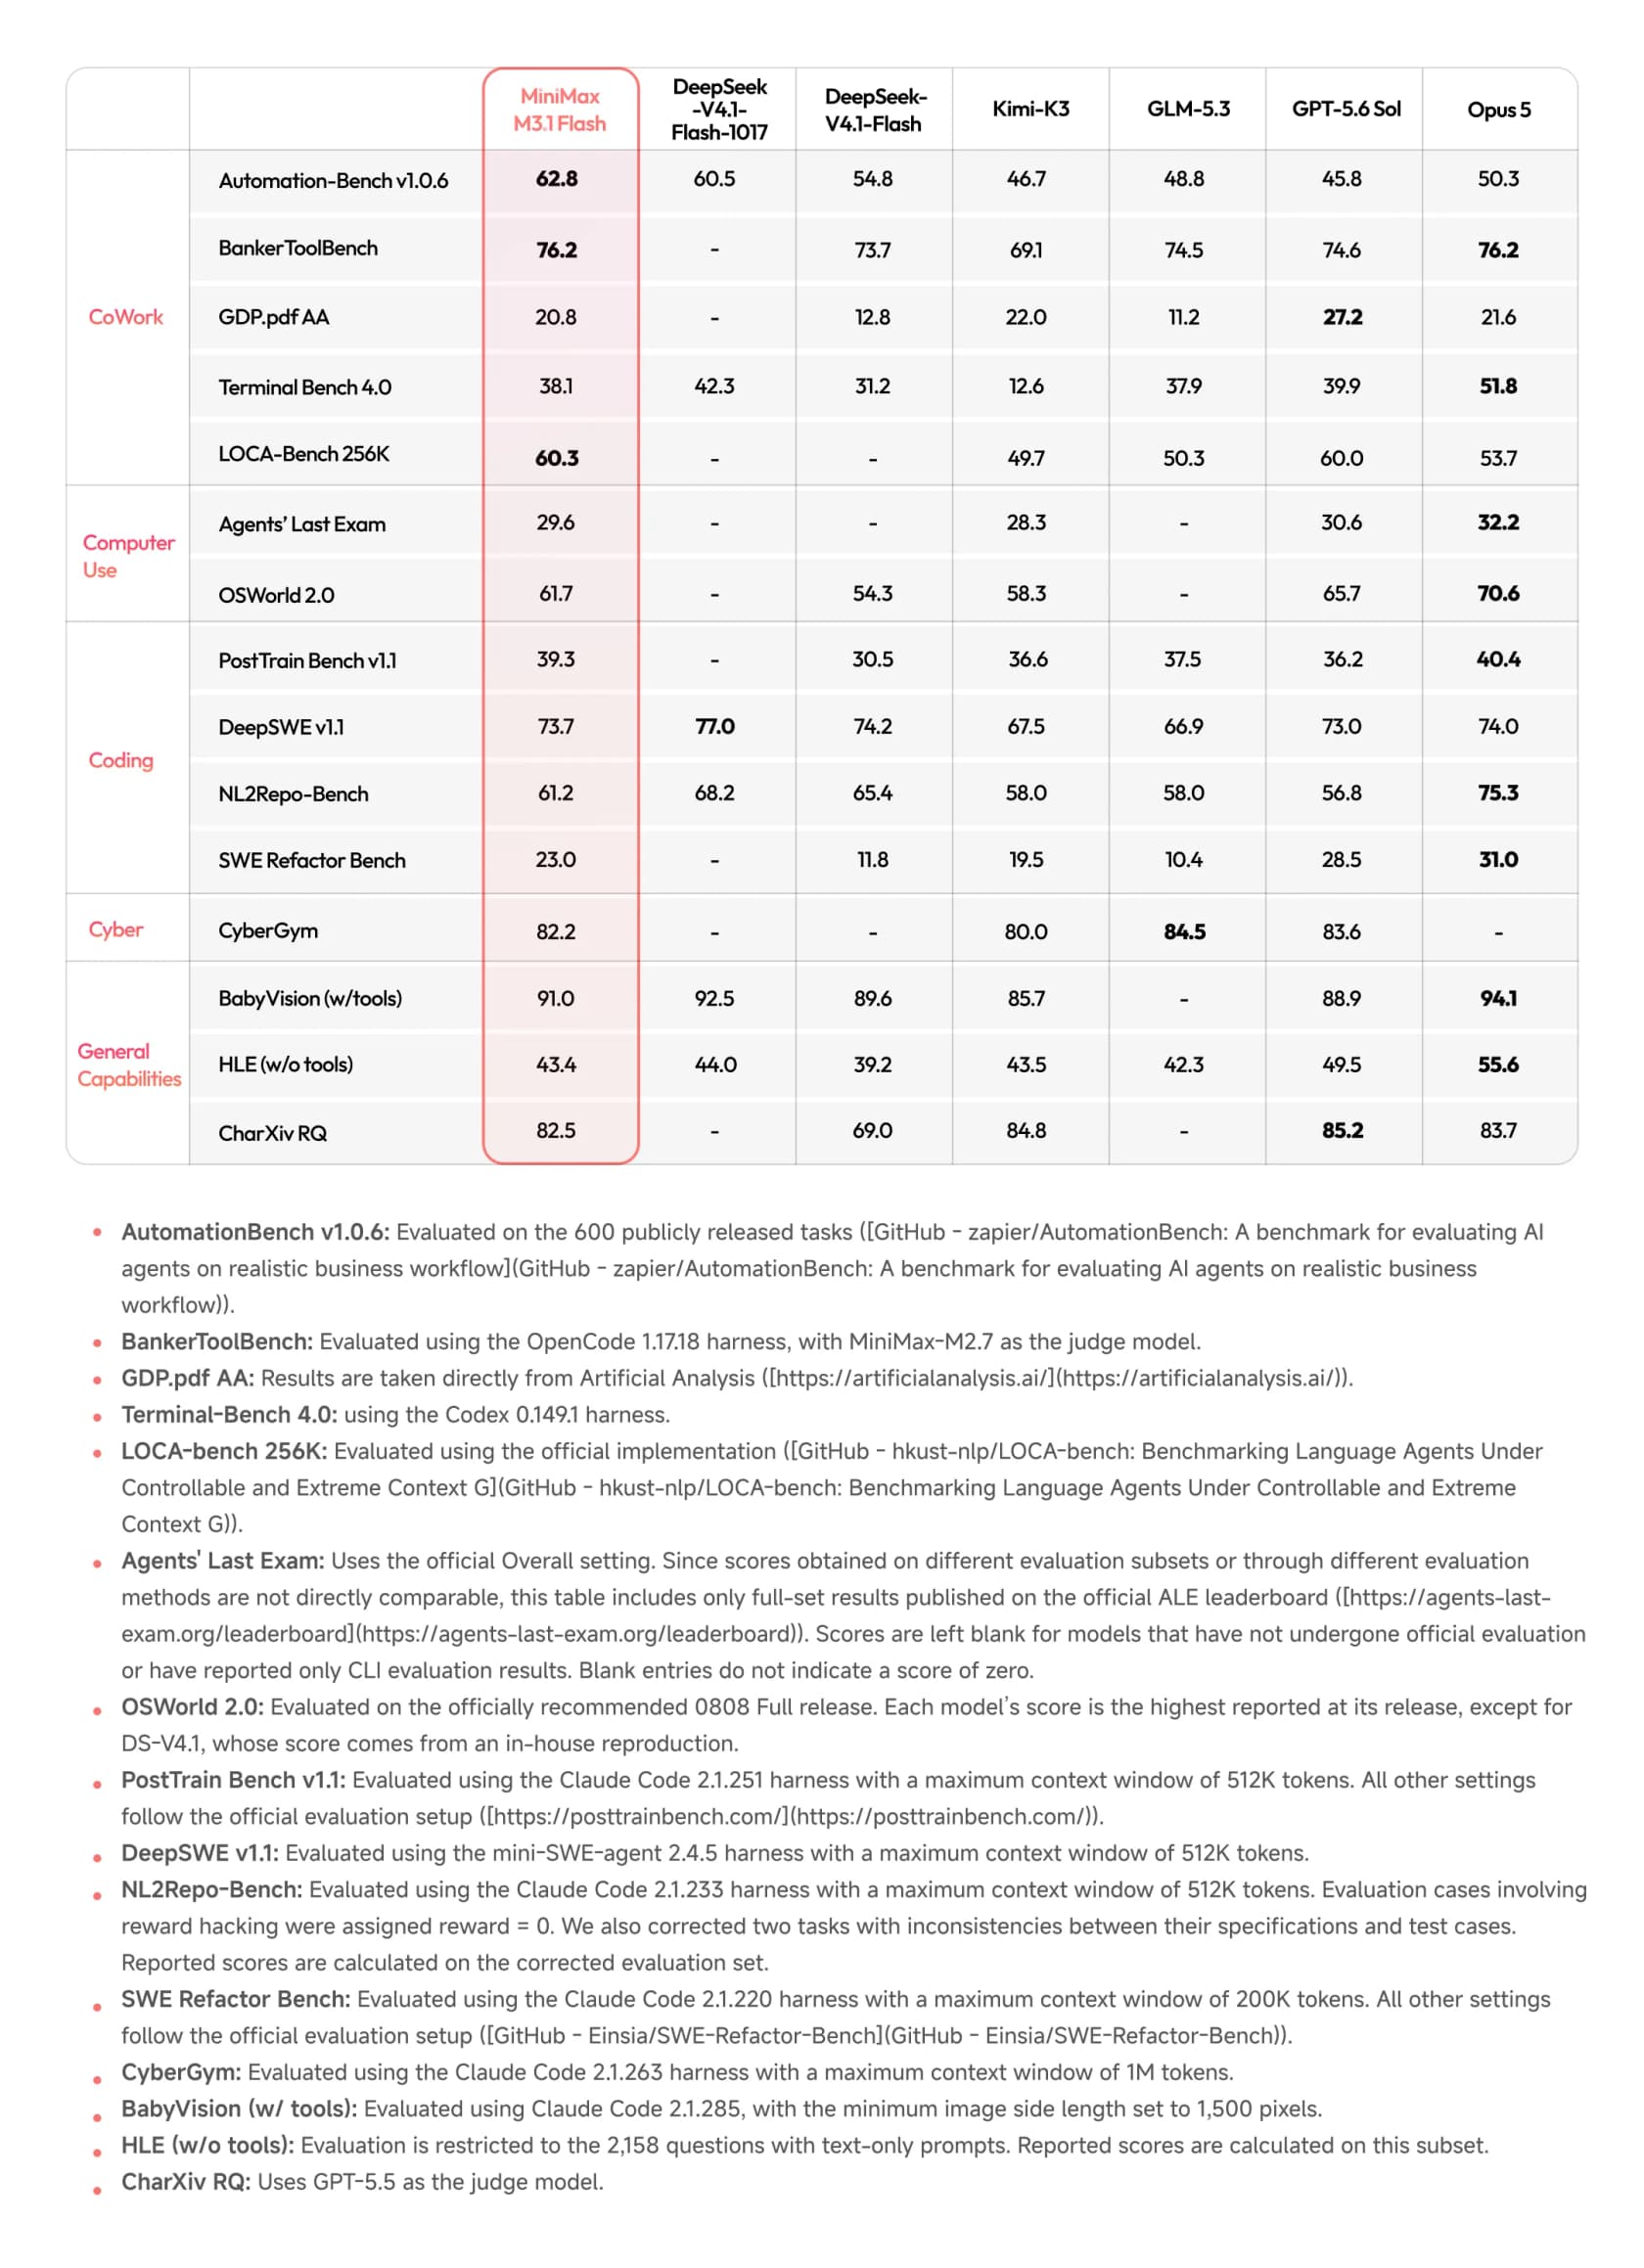
Las victorias se concentran en el trabajo de agentes tipo oficina: tareas de varios pasos en software de empresa, llamadas a herramientas encadenadas y documentos largos. La tabla propia de MiniMax es la fuente aquí, así que lee estas cifras como reportadas por el proveedor.
- Automation-Bench
62.8, la mejor puntuación de la tabla, por delante de DeepSeek 1017 (60.5), Claude Opus 5 (50.3) y GPT-5.6 Sol (45.8). MiniMax lo describe como flujos de trabajo reales en ventas, marketing, operaciones, atención al cliente, finanzas y RR. HH. - BankerToolBench
76.2, empate con Opus 5 y por delante de Kimi K3 (69.1). - LOCA-Bench 256K
60.3, la mejor puntuación de agentes de contexto largo de la tabla. - CyberGym
82.2, solo por detrás de GLM-5.3 (84.5) y GPT-5.6 Sol (83.6).
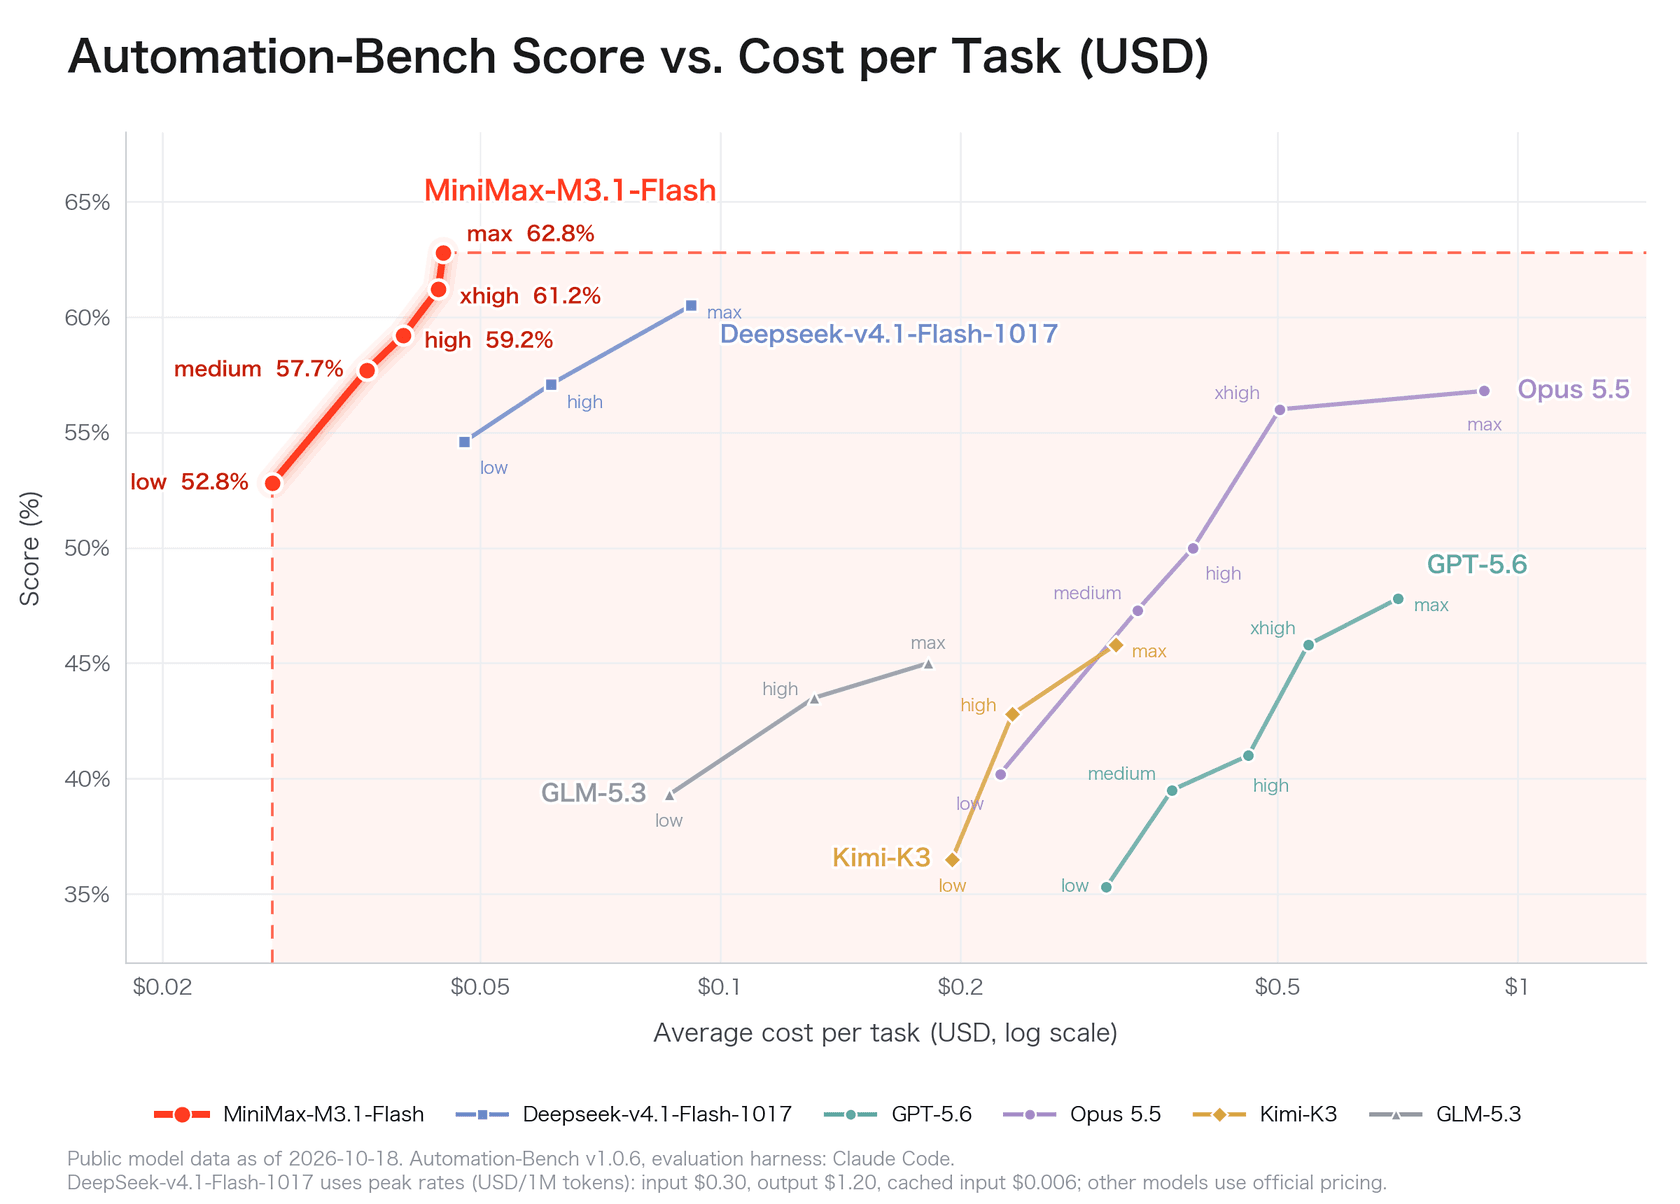
Los gráficos de coste son donde M3.1 Flash luce mejor. En el gráfico de Automation-Bench de MiniMax, M3.1 Flash con esfuerzo max llega a 62.8% por unos $0.045 por tarea, e incluso con esfuerzo low puntúa 52.8%, por encima de GPT-5.6, Kimi K3 y GLM-5.3 en sus mejores ajustes. En el gráfico de Agents' Last Exam alcanza 29.6% por $111 en total, el punto más barato de la frontera.
La velocidad es la otra victoria. MiniMax dice que la salida alcanza 200+ tokens por segundo, con una mediana de 170+, casi tres veces más rápido que M3. Los primeros usuarios confirmaron la sensación, aunque no la cifra exacta:
"first impression of minimax m3.1 flash been using model for the last few hours and it's a huge step up from m3. pretty good for flash model"
¿Dónde queda por detrás de DeepSeek V4.1 Flash 1017?
Esta es la sección que la mayoría de la cobertura del lanzamiento se saltó. DeepSeek V4.1 Flash 1017 tiene puntuación en seis de las filas de MiniMax y supera a M3.1 Flash en cinco de ellas:
| Benchmark (tabla de MiniMax) | M3.1 Flash | DeepSeek V4.1 Flash 1017 | Ganador |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | M3.1 Flash |
| Terminal-Bench 4.0 | 38.1 | 42.3 | DeepSeek |
| DeepSWE v1.1 | 73.7 | 77.0 | DeepSeek |
| NL2Repo-Bench | 61.2 | 68.2 | DeepSeek |
| BabyVision (with tools) | 91.0 | 92.5 | DeepSeek |
| HLE (no tools) | 43.4 | 44.0 | DeepSeek |
Tres de esas derrotas son pruebas de programación, por eso le doy un 3 en código. En el gráfico de coste de DeepSWE de MiniMax, la línea de DeepSeek 1017 queda más alta y más a la izquierda: cerca de 77% por unos $0.20 por tarea con max, frente a 73.7% por unos $0.27 de M3.1 Flash. La descripción general de DeepSeek 1017 explica por qué ese modelo salió tan barato por tarea.
Luego está la nota al pie. El gráfico de Automation-Bench valora DeepSeek 1017 a tarifas de hora punta, $0.30 de entrada y $1.20 de salida. La página de precios de DeepSeek cobra eso solo entre semana, de 01:00 a 04:00 y de 06:00 a 10:00 UTC. Cualquier otra hora es de tarifa reducida a la mitad, $0.15/$0.60, exactamente la misma que M3.1 Flash. Mi cálculo: con tarifas fuera de punta, el punto de esfuerzo máximo de DeepSeek pasa de unos $0.09 a unos $0.045 por tarea, justo donde está M3.1 Flash, con una puntuación solo 2,3 puntos menor.
Los lectores de Hacker News notaron el patrón en cuestión de horas:
"Not as strong as DeepSeek V4.1 Flash 1017 on deepswe so it's already dead to me."

Es más duro de lo que yo sería. M3.1 Flash sigue ganando en automatización de agentes y cobra menos sin dar nada de menos. Pero no es la historia limpia de "más barato y mejor" que cuenta la publicación de lanzamiento.
¿Cuánto cuesta de verdad?
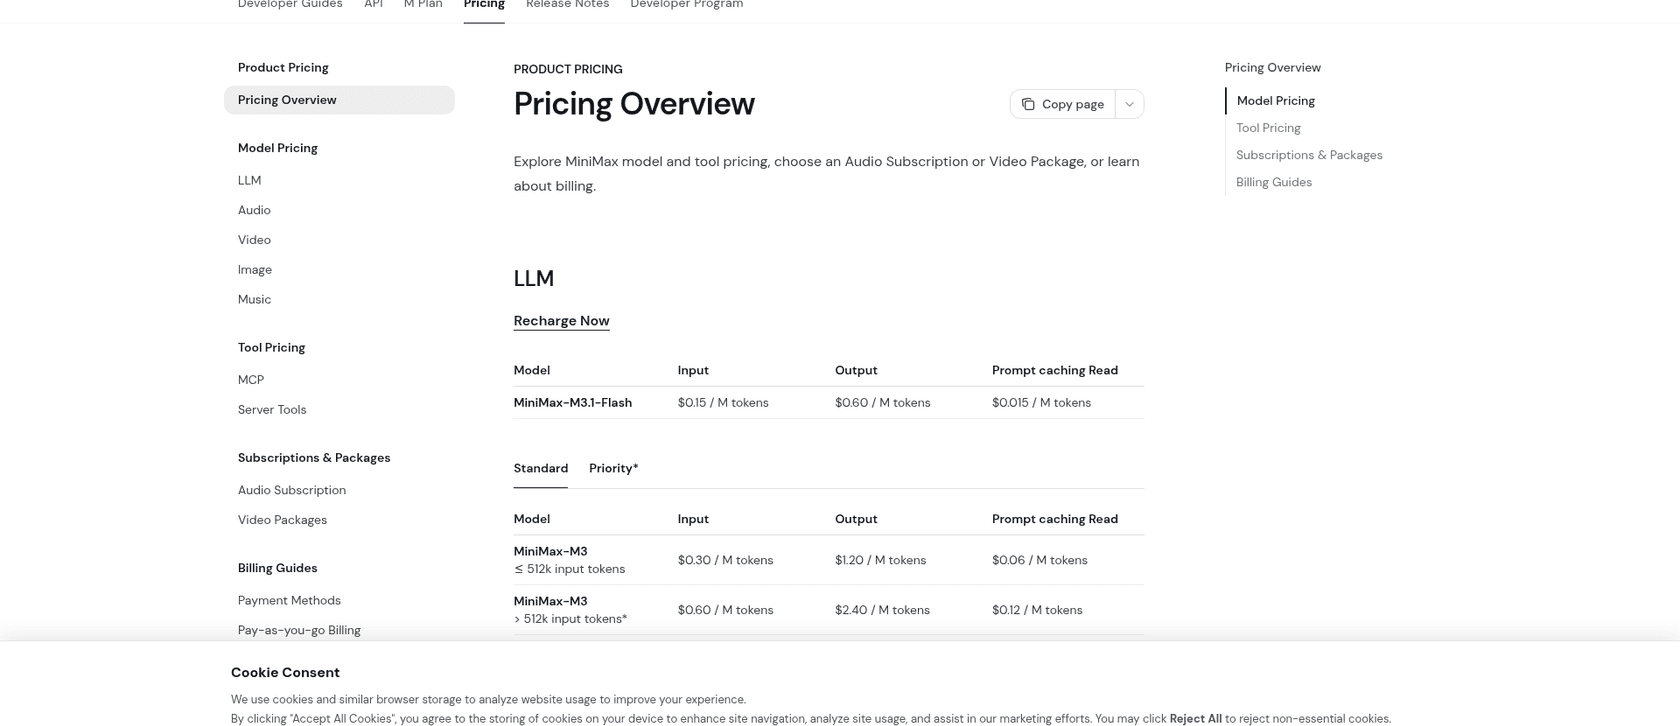
El precio es simple, lo cual me gusta. M3.1 Flash tiene una sola tarifa en toda la ventana de 1M, mientras que MiniMax M3 se duplica por encima de 512K tokens de entrada.
| Modelo (por 1M de tokens) | Entrada | Entrada en caché | Salida | Fuente |
|---|---|---|---|---|
| MiniMax M3.1 Flash | $0.15 | $0.015 | $0.60 | MiniMax |
| MiniMax M3 (hasta 512K) | $0.30 | $0.06 | $1.20 | MiniMax |
| MiniMax M3 (más de 512K) | $0.60 | $0.12 | $2.40 | MiniMax |
| DeepSeek V4.1 Flash, fuera de punta | $0.15 | $0.003 | $0.60 | DeepSeek |
| DeepSeek V4.1 Flash, hora punta | $0.30 | $0.006 | $1.20 | DeepSeek |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | OpenAI |
| Gemini 3.8 Flash (hasta el 31 dic. 2026) | $0.75 | $0.075 | $3.75 |
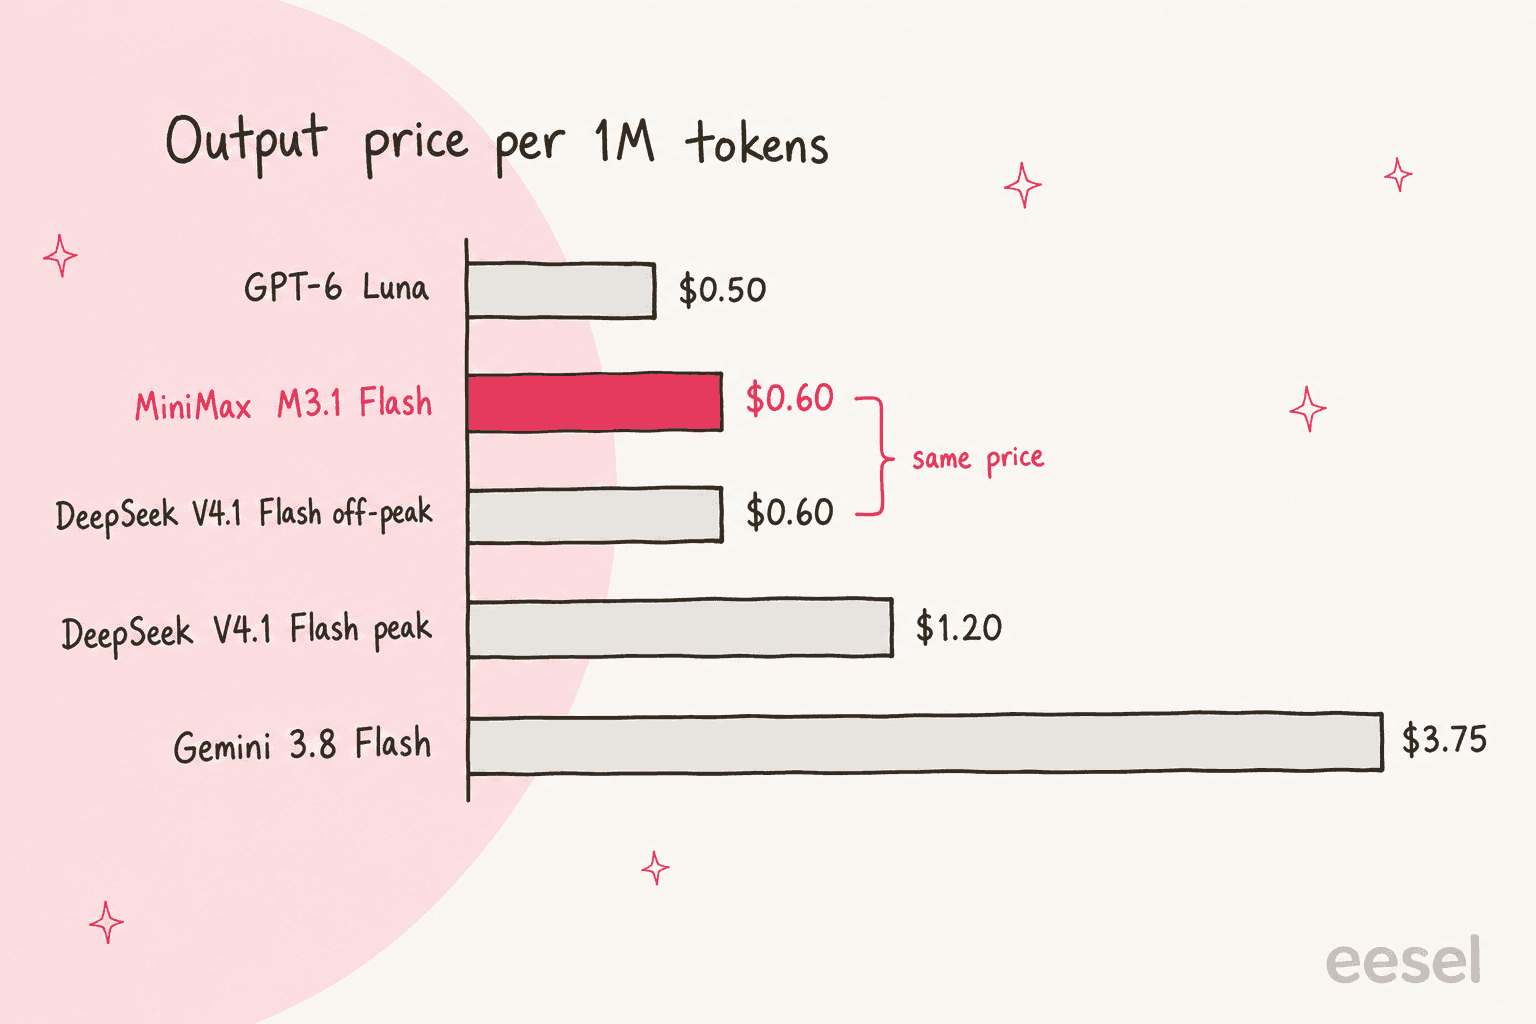
Destacan dos cosas. Primero, la entrada en caché es donde DeepSeek sigue ganando: $0.003 fuera de punta frente a los $0.015 de M3.1 Flash, cinco veces más barato. Los bucles de agentes releen el mismo contexto una y otra vez, así que una carga con mucha caché puede inclinar la factura hacia DeepSeek incluso con el mismo precio de cabecera. Segundo, GPT-6 Luna es más barato por token que ambos, y el desglose de precios de Luna muestra también su tarifa de caché. Pero en el gráfico de Agents' Last Exam de MiniMax, los $111 totales de M3.1 Flash quedan bastante por debajo del punto de GPT-5.6 Luna, así que el precio por token por sí solo no lo decide.
Si prefieres pagar una suscripción, el M Plan incluye M3.1 Flash junto con MiniMax Code y otros modelos. La facturación anual es de $220, $550 o $1,320 al año para los niveles Go, Explore y Build, que dan 1x, 3x y 7,5x el uso de Go, con reinicios en ventanas de 5 horas y semanales. La propia FAQ de M Plan de MiniMax dice que el plan está diseñado para uso individual e interactivo y recomienda pago por uso para producción. Tómalo al pie de la letra: la suscripción es para tus propias sesiones de programación, no para un producto que atienda a clientes.
¿Qué dicen los usuarios reales tras un día?
Las primeras reacciones se dividen con claridad. Los benchmarks impresionaron. Los probadores prácticos fueron más variados, y la queja más común es sobre el comportamiento con esfuerzo alto, que es el valor por defecto.
"I might get downvoted for this, but this model was WAY too lazy, even at Max effort"
El mismo tema vino de un probador en X al que, por lo demás, le gustó:
"hallucinates alot on xhigh or max and starts doing stuff i didn't ask for, and cuz of that model ends up being slow despite giving 100+ tok/s"
En Hacker News, un usuario que había probado la versión sigilosa señaló una brecha entre las puntuaciones y los resultados del día a día:
"The deepswe and terminalbench4.0 scores don't seem to jive with what many opencode users' experience has been of this model while it was being tested as "space bunny"."
MiniMax dice que Space Bunny era un checkpoint anterior, así que parte de eso puede estar corregido. No todos los informes fueron negativos. Un desarrollador que había usado la vista previa dentro de MiniMax Code valoró cómo gestionaba la incertidumbre:
"it found the real bug instead of patching around it, refused to pad weak results, wrote its own tests and got to 12/12 green, and said UNVERIFIED when it couldn't confirm something"
El comentario más justo que leí fue sobre el tiempo, no sobre los tokens. Los modelos baratos que tardan el doble son difíciles de vender en el trabajo:
"For a hobby project I do not mind that a cheaper model takes twice as long but at work it's hard to justify using a "cheaper" model if the time per task is so much higher than the frontier models."
¿Cuáles son los pros y los contras?
Pros
- Precio plano de
$0.15/$0.60en 1M de tokens, sin nivel de contexto largo. - Mejor puntuación de Automation-Bench en la tabla de MiniMax y empate con Opus 5 en BankerToolBench.
- 200+ tokens por segundo declarados, unas tres veces M3.
- Funciona con clientes estilo Anthropic y OpenAI, así que Claude Code, Codex, Cursor y OpenClaw pueden apuntar a él.
- Pesos abiertos prometidos para el 23 de octubre.
Contras
- Queda por detrás de DeepSeek V4.1 Flash 1017 en cinco de seis benchmarks compartidos, incluidas todas las pruebas de programación.
- La entrada en caché cuesta cinco veces la tarifa fuera de punta de DeepSeek.
- El razonamiento no se puede desactivar, y el valor por defecto es
max, donde los probadores reportan pereza y desvío. - 428B parámetros totales, así que el uso local requiere una máquina grande.
- El M Plan es para uso personal, así que el tráfico de producción va con claves de pago por uso.
¿Qué modelo barato encaja con tu trabajo?
Elige el trabajo que quieres ejecutar. El widget muestra el modelo con el que yo empezaría y por qué.
¿Quién debería usarlo y quién debería descartarlo?
Úsalo si ejecutas bucles de agentes sobre herramientas de negocio, hojas de cálculo o documentos largos y te importa el coste por tarea. Los resultados de Automation-Bench y BankerToolBench apuntan directamente a ese trabajo, y el precio plano hace indoloros los contextos largos. También encaja con desarrolladores que ya están dentro de MiniMax Code y quieren un modelo rápido por defecto.
Descártalo, por ahora, si tu trabajo principal es el trabajo duro en repositorios. DeepSeek V4.1 Flash 1017 puntúa más alto en todas las filas de programación de la tabla por el mismo precio fuera de punta, y Qwen 3.8 Flash Next sale a menudo entre quienes alojan por su cuenta.
Si quieres un modelo de frontera y puedes pagarlo, GPT-6 Sol y Claude Opus 5.5 siguen un nivel por encima.
Espera si quieres ejecutarlo tú mismo. Los pesos llegan el 23 de octubre, y por su tamaño necesitas una máquina grande con varias GPU o un equipo con mucha memoria unificada.
¿Qué significa para un equipo de soporte?
AutomationBench lista la atención al cliente entre sus flujos de trabajo, así que es tentador leer una puntuación alta como "listo para mi cola". Yo no lo haría. Un benchmark comprueba si el modelo terminó una tarea guionizada. Tu cola pregunta si la respuesta fue correcta para este cliente, según tu política, con tus reglas de reembolso, y si el modelo supo dejar un ticket en paz.
Si construyes tu propio flujo de soporte sobre M3.1 Flash, esto es lo que sigue siendo tuyo:
- La canalización de conocimiento que le da tu centro de ayuda y tus tickets pasados.
- La conexión con el helpdesk que lee tickets y escribe respuestas.
- Las reglas para cuándo traspasar, el núcleo de la desviación de nivel 1.
- Pruebas con historial real, que es como detectas las alucinaciones en soporte.
Nada de eso es un problema del modelo, por eso un modelo más barato reduce una línea de la factura, no el proyecto. La guía del coste de la IA en atención al cliente cubre el resto, y el desglose de coste de agente de IA frente a humano lo sitúa en contexto.
¿Cómo encaja eesel junto a M3.1 Flash?
MiniMax M3.1 Flash es infraestructura. eesel es el empleado. eesel es una plataforma de compañeros de IA donde contratas compañeros listos para trabajar en tareas concretas, y para soporte ese es el compañero de IA para helpdesk. Se incorpora a la cola que ya tienes, como Zendesk o Freshdesk, aprende de tu centro de ayuda y tus tickets pasados, y reproduce tickets históricos para que veas sus respuestas antes que un cliente.
Así se ve a escala. smava, una plataforma berlinesa de comparación de préstamos, ejecuta tres agentes de eesel en un Zendesk para dos marcas: uno categoriza cada ticket, otro redacta la respuesta a partir de unas 820 macros y artículos del centro de ayuda, y uno por marca prepara la respuesta lista para el cliente. Entre el 8 de agosto y el 8 de septiembre de 2026 fueron unos 27,000 tickets, con personas aprobando los borradores. SE Ranking ejecuta un agente independiente para cada uno de sus tres productos en el chat en vivo de Zendesk, unas 4,650 conversaciones en un mes, con reembolsos y casos de nivel 2 traspasados al equipo con los datos del cliente adjuntos.

Si eres de los que leen una reseña de modelos, probablemente querrás la terminal. La CLI de eesel (@eesel/cli) maneja al mismo compañero que ves en el panel. eesel integrations connect zendesk conecta un helpdesk, eesel files upload añade conocimiento, eesel instructions edita las reglas permanentes, eesel approvals lista las acciones que esperan a una persona y eesel activity muestra lo que hizo el agente. Cada comando imprime JSON, así que Claude Code o Cursor pueden ejecutar la configuración por ti, y cada espacio de trabajo funciona también como servidor MCP. La guía de la CLI de agentes muestra el patrón.
Para comparar opciones de soporte lado a lado, empieza con la lista de los mejores agentes de atención al cliente o con el argumento más amplio a favor de los compañeros de IA.
Prueba eesel
Usa M3.1 Flash donde brilla: bucles de agentes baratos y rápidos que puedas comprobar. Si lo que necesitas es IA respondiendo tickets en tu helpdesk la semana que viene, el compañero de IA para helpdesk de eesel se conecta a la herramienta que ya usas, aprende de tus tickets pasados y muestra cómo los habría respondido antes de que ningún cliente vea una respuesta. Así consigue smava 15,300 borradores al mes sin ceder el control. Prueba eesel gratis y ejecútalo primero sobre tu propio historial de tickets, o consulta los precios de eesel antes de empezar.