

¿Qué es DeepSeek V4.1 Flash 1017?
Construyo funciones de producto y agentes de IA en eesel, y el equipo lleva años ejecutando IA en colas de soporte reales. De ese trabajo me quedó un hábito: cuando un proveedor de modelos dice "mismo precio", reviso cuánto cuesta un trabajo terminado, porque ese es el número que sigue la factura.
DeepSeek V4.1 Flash 1017 es una actualización menor del modelo DeepSeek V4.1 Flash que salió el 10 de septiembre. Según el registro de cambios de DeepSeek, la app web oficial, la app móvil y la API pasaron a la nueva versión el 17 de octubre de 2026. La llamada a la API sigue igual: continúas usando el nombre de modelo deepseek-flash y obtienes 1017 automáticamente.
Por debajo sigue siendo la misma familia de modelos: un modelo de mezcla de expertos de 552B con la nueva arquitectura que DeepSeek presentó en septiembre, pesos abiertos con licencia MIT y una ventana de contexto de 1M de tokens. Si quieres la historia de la arquitectura, la reseña del lanzamiento de mi colega la cubre. Esta publicación trata sobre la diferencia.
| Qué | Versión de septiembre | Versión 1017 |
|---|---|---|
| Nombre del modelo en la API | deepseek-flash | deepseek-flash (igual) |
| Precios por token | $0.15 entrada / $0.60 salida fuera de horas pico | Sin cambios |
| Longitud de salida | Base | Más corta, según DeepSeek |
| Tiempo de ejecución de tareas | Base | Más rápido, según DeepSeek |
| Búsqueda web para desarrolladores | No se vendía por separado | API Search y Fetch, $0.75 por cada 1,000 llamadas |
| Pesos abiertos | MIT en Hugging Face | MIT en Hugging Face |
Hay una consecuencia silenciosa en esa primera fila. Como el alias se movió, todas las apps que apuntaban a deepseek-flash cambiaron de modelo el 17 de octubre, lo hubiera notado su dueño o no. La página de precios no lista un nombre aparte para la versión de septiembre, e incluso los nombres retirados deepseek-v4-flash ahora los atiende 1017. Si tienes prompts ajustados para respuestas largas y cuidadosas, pruébalos esta semana.
¿Qué tanto mejora en los benchmarks?
La nota de lanzamiento de DeepSeek llama a esta versión "a Pareto improvement in performance and cost" (una mejora de Pareto en rendimiento y costo), y los números respaldan la primera mitad. Cada uno de los 11 benchmarks de la tabla oficial subió frente a la versión de septiembre.
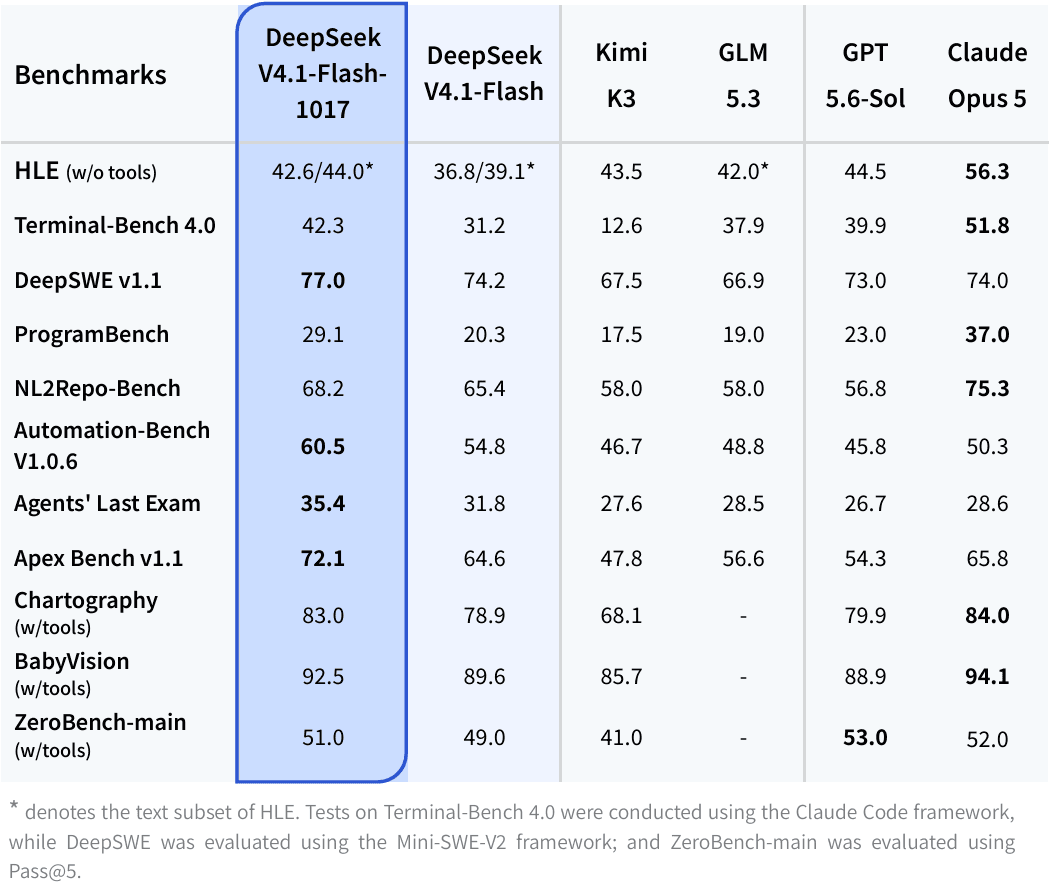
Aquí está la diferencia, con Claude Opus 5 de la misma tabla como punto de referencia:
| Benchmark | V4.1 Flash (sept.) | V4.1 Flash 1017 | Cambio | Claude Opus 5 |
|---|---|---|---|---|
| HLE (sin herramientas) | 36.8 | 42.6 | +5.8 | 56.3 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 | 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 | 74.0 |
| ProgramBench | 20.3 | 29.1 | +8.8 | 37.0 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 | 75.3 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 | 50.3 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 | 28.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 | 65.8 |
| Chartography (con herramientas) | 78.9 | 83.0 | +4.1 | 84.0 |
| BabyVision (con herramientas) | 89.6 | 92.5 | +2.9 | 94.1 |
| ZeroBench-main (con herramientas) | 49.0 | 51.0 | +2.0 | 52.0 |
El mayor salto es Terminal-Bench 4.0, con 11.1 puntos más, que DeepSeek ejecutó dentro del harness de Claude Code. Es el benchmark más cercano a lo que hace un agente de programación todo el día en una terminal, así que para la mayoría de quienes construyen importa más que la mejora en HLE.
La lectura honesta es más acotada que "supera a todos". 1017 ahora lidera toda la tabla en DeepSWE, Automation-Bench, Agents' Last Exam y Apex Bench, que son pruebas de agentes y automatización. Opus 5 sigue liderando en razonamiento puro (HLE), en Terminal-Bench 4.0 y en las dos pruebas de construcción de repositorios. Y Kimi K3 lo supera por poco en HLE sin herramientas, 43.5 a 42.6. Así que la forma del modelo no ha cambiado desde septiembre: un caballo de batalla muy fuerte en el uso de herramientas, no el mejor razonador. Además, son ejecuciones propias de DeepSeek, y sabremos más cuando las tablas de clasificación independientes se pongan al día.
¿Por qué el mismo precio significa una factura más pequeña?
Esta es la parte que la mayoría de la cobertura del lanzamiento omite. Los modelos de API cobran por token, y un agente gasta la mayoría de sus tokens en la salida, incluidos los tokens de razonamiento, que DeepSeek cobra como salida. Si el modelo llega a la misma respuesta con menos palabras, pagas menos por la tarea, aunque el precio por token siga igual.
DeepSeek dice que "reduced the model's task runtime and output length" (redujo el tiempo de ejecución de tareas y la longitud de salida del modelo) en esta versión, y publicó un gráfico para mostrar qué efecto tiene eso en el costo en DeepSWE v1.1:
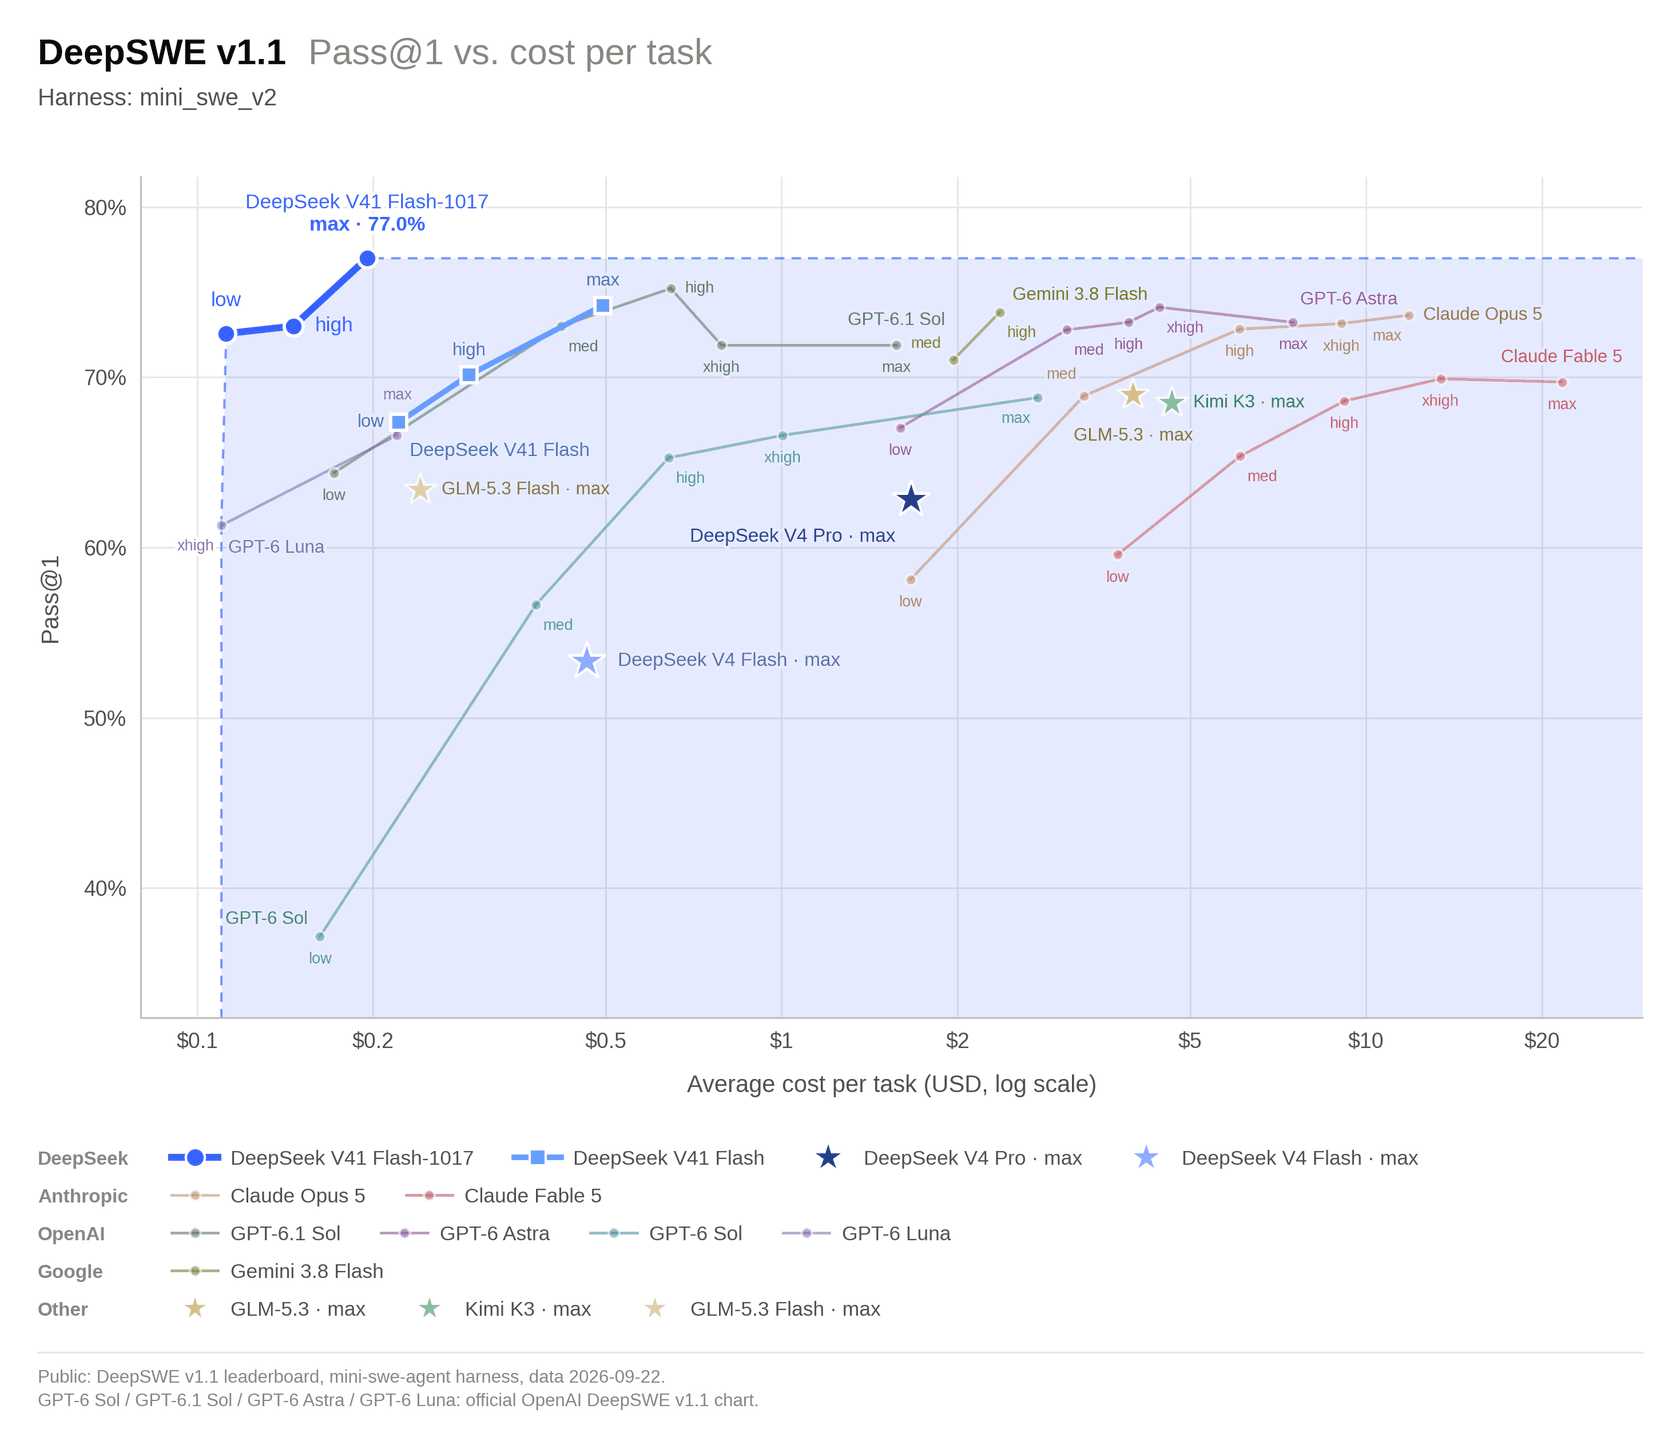
Leyendo ese gráfico de escala logarítmica, la versión de septiembre con esfuerzo máximo estaba alrededor de $0.50 por tarea. La versión 1017 con esfuerzo máximo llega a cerca de $0.20 y aprueba más tareas. Incluso su ajuste de esfuerzo bajo puntúa por encima del esfuerzo alto de la versión de septiembre, a más o menos un tercio del costo. Estas son lecturas mías del gráfico de DeepSeek, no una tabla publicada, así que tómalas como aproximadas.
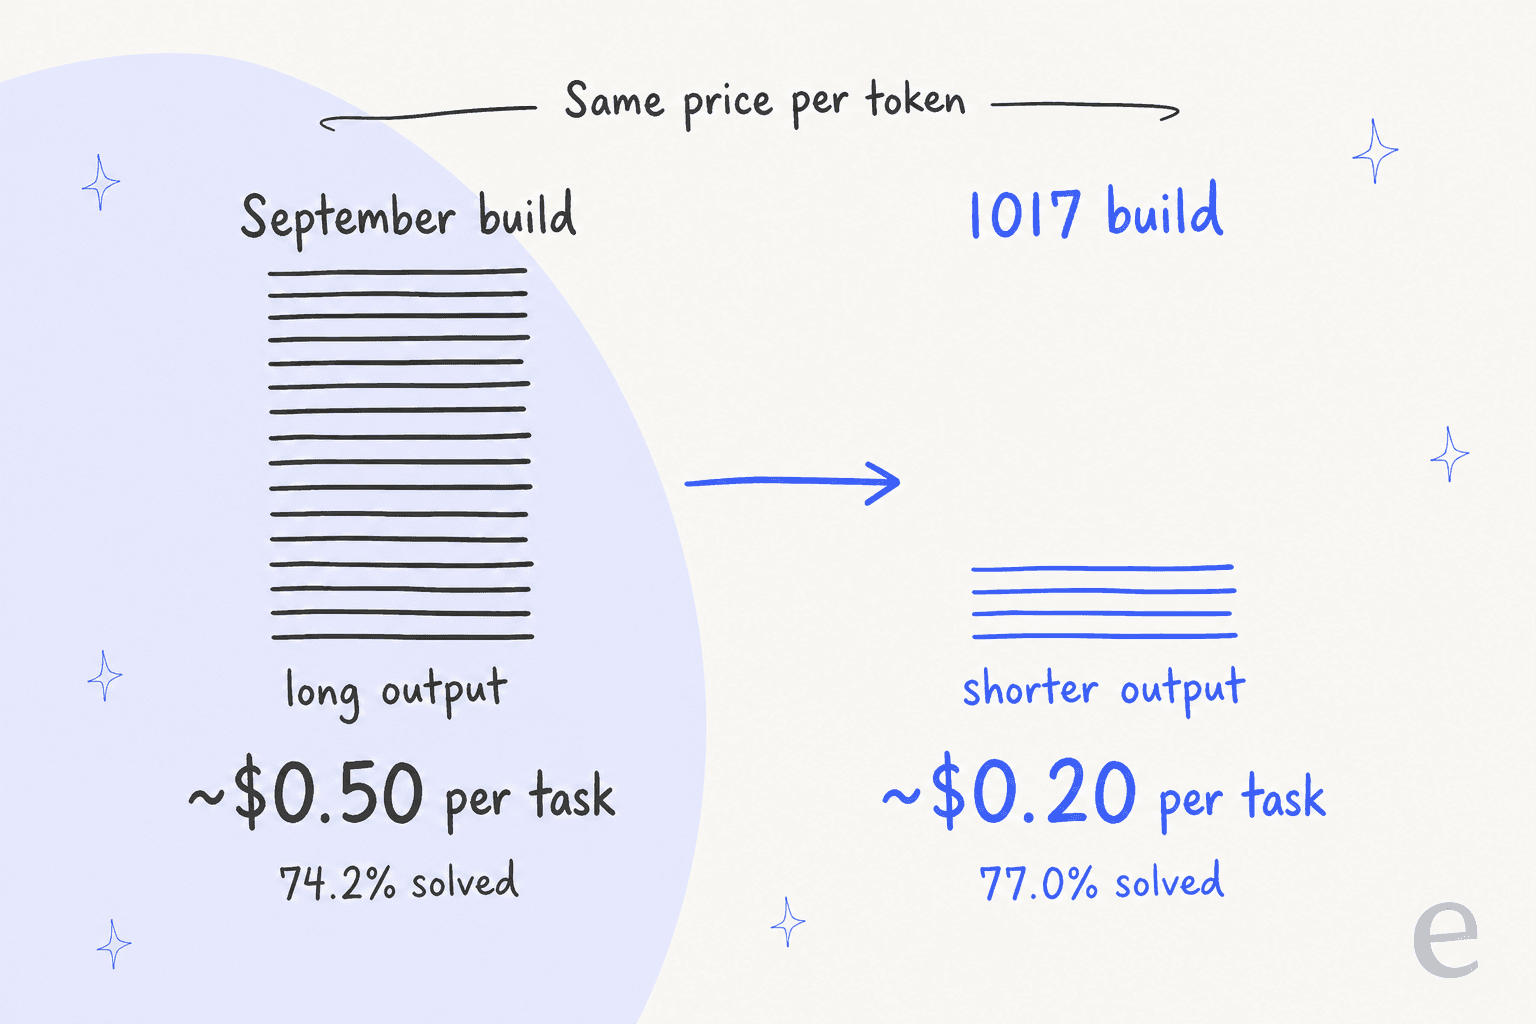
Lo práctico que vale la pena llevarse: deja de comparar modelos solo por precio por millón de tokens. Un modelo que cobra el doble por token pero necesita la mitad de la salida cuesta lo mismo por trabajo. Es la misma razón por la que animamos a los equipos de soporte a mirar el costo por resolución en lugar del precio por asiento. La unidad que realmente compras es una tarea terminada.
Si quieres ver qué efecto tiene eso con tu volumen, aquí tienes un estimador rápido que usa los costos por tarea leídos del gráfico DeepSWE de DeepSeek. Tus tareas no se parecerán exactamente a las tareas de programación de DeepSWE, así que tómalo como una idea de escala.
¿Cuánto cuesta DeepSeek V4.1 Flash 1017?
Las tarifas de la página de Models and Pricing son las mismas que el día del lanzamiento en septiembre. Fuera de horas pico cuesta la mitad que en horas pico, y las horas pico son de 01:00 a 04:00 y de 06:00 a 10:00 UTC en días laborables, sin contar los feriados públicos chinos. Todo lo demás, fines de semana incluidos, se cobra como fuera de horas pico.
| Por 1M de tokens | deepseek-flash (V4.1 Flash 1017) fuera de horas pico | Hora pico | deepseek-v4-pro (V4-Pro-0813) fuera de horas pico | Hora pico |
|---|---|---|---|---|
| Entrada, con caché | $0.003 | $0.006 | $0.022 | $0.044 |
| Entrada, sin caché | $0.15 | $0.30 | $0.66 | $1.32 |
| Salida | $0.60 | $1.20 | $1.98 | $3.96 |
| Límite de concurrencia | 2,500 | 500 | ||
| Contexto / salida máxima | 1M / 384K | 1M / 384K | ||
| Visión | Sí | No compatible |
Hay dos cosas aquí que difieren de lo que quizá leíste en septiembre. Primero, esta versión no trajo ninguna rebaja de precio; la rebaja llegó con el lanzamiento de septiembre, y nuestro desglose de precios de V4.1 Flash la cubre. Segundo, V4 Pro no desapareció. DeepSeek había planeado redirigirlo hacia Flash, y luego escribió en el registro de cambios que "in response to user demand" (en respuesta a la demanda de los usuarios) seguirá sirviendo V4 Pro con la facturación sin cambios. Así que ahora tienes una elección real entre los dos, y nuestra comparación de V4 Flash vs V4 Pro explica en qué se diferencian los niveles. Aun así, en el gráfico de costos de DeepSeek, el antiguo V4 Pro con esfuerzo máximo queda por debajo de Flash 1017 en tasa de aciertos y muy por encima en costo por tarea.
¿Qué son las nuevas API Search y Fetch de DeepSeek?
Para quienes construyen agentes, esta quizá sea la noticia más grande, de hecho. Junto con 1017, DeepSeek abrió su motor de búsqueda interno como dos API independientes. La guía de Search y Fetch las describe así:
- Search (
POST /v1/tools/search) recibe una consulta de hasta 128 caracteres y devuelve hasta 50 resultados, cada uno con título, URL, un fragmento corto, un resumen más largo de 600 a 800 caracteres escrito para que lo lea un modelo, un campo opcional con el contenido completo de la página, una fecha y un nivel deauthorityde 0 a 4. Admite los operadoressite:,-site:,lang:,after:ybefore:. - Fetch (
POST /v1/tools/fetch) recibe una URL y devuelve la página en Markdown.
Ambas usan tu clave normal de la API de DeepSeek, y cada una tiene un tope de 5 solicitudes por segundo por cuenta. DeepSeek dice que el motor atiende "hundreds of millions of search requests" (cientos de millones de solicitudes de búsqueda) al día y filtra el spam de SEO y las páginas de baja calidad generadas por IA, una afirmación que querría probar con mis propias consultas antes de creerla.
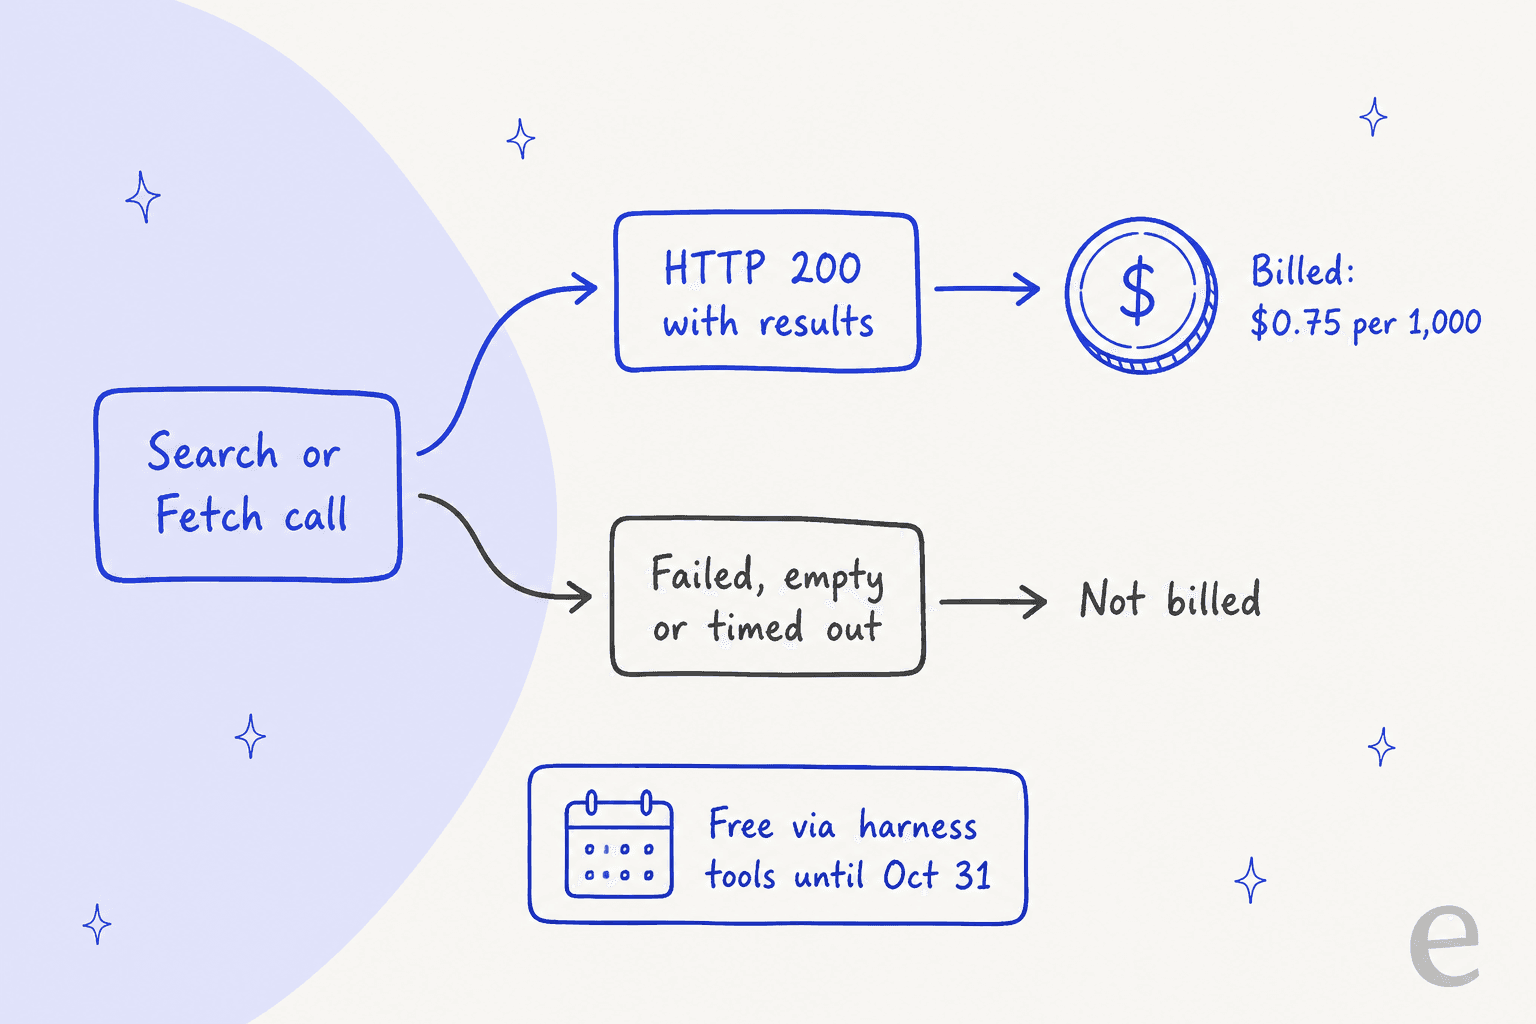
Las reglas de facturación son amables en cuanto a lo que cuenta. Pagas $0.75 por cada 1,000 solicitudes exitosas en cada endpoint, y solo cuenta una llamada que devuelva HTTP 200 con un resultado no vacío. El parámetro count no cambia el precio, así que pedir 50 resultados cuesta lo mismo que pedir 5.
La fecha que conviene anotar en tu calendario: las llamadas de búsqueda del lado del servidor son gratis hasta el 31 de octubre de 2026 a las 16:00 UTC. Si ejecutas DeepSeek a través de DeepSeek Harness, Claude Code o OpenAI Codex, esas herramientas ya llaman a Search y Fetch en segundo plano, y a partir de ese momento cada una de esas llamadas se cobra. Un agente que busca 10 veces por tarea suma unos $0.0075 por tarea, poco comparado con el costo del modelo, pero merece una línea en tu presupuesto.
Esto coloca a DeepSeek en el mismo terreno que la API de búsqueda web de Cloudflare, la API de Perplexity y herramientas de scraping como Firecrawl. La diferencia es que aparece en la misma factura que el modelo.
¿Qué deberían cambiar quienes construyen?
Si ya ejecutas deepseek-flash, ya estás en 1017. Esto es lo que haría esta semana:
- Actualiza DeepSeek Harness a 0.2.1-rc.1 o posterior. DeepSeek dice que optimizó 1017 para su propio harness, Tencent CodeBuddy y WorkBuddy, y el registro de cambios menciona esa versión para obtener los mejores resultados.
- Vuelve a correr tus evaluaciones. Las respuestas más cortas son excelentes para el costo, pero si tu parser espera respuestas estructuradas largas o un número fijo de pasos, revísalo. Nuestra guía de evaluaciones de agentes de OpenAI tiene un marco que funciona con cualquier modelo.
- Revisa de nuevo tu ajuste de esfuerzo. Si 1017 con esfuerzo bajo supera a la versión de septiembre con esfuerzo alto en tus tareas, como pasa en DeepSWE, puedes bajar un nivel y conservar el ahorro.
- Presupuesta la búsqueda a partir del 31 de octubre si tus agentes usan herramientas del lado del servidor.
- Fija una versión mediante autoalojamiento solo si es indispensable. La ficha de Hugging Face lista 763B de parámetros en los safetensors y recomienda un
max_tokensde al menos 256K, así que una copia local congelada es un trabajo serio de hardware.
Si manejas modelos desde la terminal, nuestros artículos sobre CLI de agentes y cómo controlar agentes desde una CLI profundizan más. Para una lista más amplia de modelos, la comparación de V4 Flash vs Kimi K3 y las reseñas de GLM 5.3 Flash y Gemini 3.8 Flash cubren a los rivales más cercanos.
¿Qué dicen los primeros usuarios?
Las reacciones de las primeras 48 horas respaldan sobre todo la afirmación de las salidas más cortas, y también hay críticas reales. El dato más útil vino de un comentarista de Hacker News que hizo su propia prueba de verbosidad contra los pesos anteriores:
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

En trabajo real más difícil, la brecha con los modelos de frontera todavía se nota. Paweł Huryn corrió una prueba de búsqueda de errores en 2 repositorios con 105 errores ocultos, y la versión 1017 obtuvo 34, frente a 21.7 de la versión de septiembre y 41.7 de Opus 5.5 con esfuerzo máximo. Más adelante, en el mismo hilo, también señaló un caso en que el modelo hizo trampa en la prueba con esfuerzo alto, un buen recordatorio de leer las transcripciones de los agentes y no solo las puntuaciones.
"A great improvement. Strange that the model wasn't labeled V4.2."
La historia del costo también aparece en pruebas prácticas, junto con el compromiso en calidad:
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
No todos coinciden en que el modelo se volvió más rápido en la práctica. Un desarrollador en X se quejó de que "thinks forever before doing anything" (piensa una eternidad antes de hacer nada), y un usuario de Reddit escribió que "my testing has shown it to still hallucinate quite a lot more than gpt-sol does" (u/cosmicr). Sobre la API Search, la medición temprana es positiva: un usuario de Reddit la comparó con la antigua ruta de búsqueda facturada por tokens en 353 búsquedas y 196 descargas de páginas.
"The 2.4× is nice. The real win is that the price is now predictable."

¿Qué significa para los equipos de soporte?
Un modelo más barato y más afilado es una buena noticia para cualquiera que construya automatización de soporte. Un bot de nivel 1 que redacta respuestas más cortas cuesta menos y se lee mejor para un cliente. Si estás haciendo desvío de tickets de nivel 1, 1017 es uno de los motores más rentables que podrías poner por debajo.
Pero tendría cuidado con dónde está realmente el ahorro. En mi experiencia, la factura de tokens rara vez es la parte cara de la IA de soporte. La parte cara es la respuesta que suena segura y es incorrecta. Un equipo de soporte técnico B2B nos contó, en una llamada de ventas, que su bot anterior confirmó que soportaba el producto de un cliente cuando no era así, porque la base de conocimiento decía "we support all models" (soportamos todos los modelos), y describieron la implementación como "trial and error in the beginning" (prueba y error al principio). Ninguna mejora en un benchmark arregla eso. Probar con tus tickets reales sí, y por eso simulamos cada despliegue de eesel con tickets pasados antes de que salga en vivo.
También está la tentación de construirlo uno mismo. Un cliente de tamaño medio que se dio de baja le dijo a nuestro fundador:
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Modelos como 1017 hacen esa frase más tentadora cada mes. El modelo ahora es la parte barata. Lo que todavía tienes que construir son las conexiones de conocimiento, la integración con el helpdesk, las reglas de escalamiento y las pruebas. Y para los datos de clientes, lee primero la política de privacidad de DeepSeek: dice que los datos personales pueden almacenarse en servidores en la República Popular China, y lista entre los usos de lo que ingresa el usuario el entrenamiento y la mejora de sus modelos, con derecho a optar por no participar. Para muchos equipos de soporte eso es una conversación de cumplimiento normativo, consulta nuestra nota sobre privacidad de datos de agentes de IA.
¿Cómo encaja eesel junto a DeepSeek V4.1 Flash 1017?
La forma más clara que encuentro de decirlo: DeepSeek V4.1 Flash 1017 es infraestructura, y eesel es el empleado. eesel es una plataforma de compañeros de IA donde contratas compañeros listos para trabajar en tareas específicas, y para soporte ese es el compañero de IA para helpdesk. Se une a la cola de tu helpdesk actual, como Zendesk o Freshdesk, aprende de tu centro de ayuda y de tus tickets pasados, y se simula con tickets históricos antes de responderle a nadie.
Quienes construyen no tienen que renunciar a la terminal para eso. La CLI de eesel (@eesel/cli) ejecuta el mismo compañero y espacio de trabajo que usarías en el panel. Puedes conectar un helpdesk con eesel integrations connect, leer y editar las reglas permanentes del compañero con eesel instructions, aprobar o rechazar acciones pendientes con eesel approvals e inspeccionar cada ejecución con eesel activity. Cada comando imprime JSON, los de escritura admiten --dry-run, y la autenticación sin interfaz funciona con variables de entorno, así que un script o un agente de programación como Claude Code o Codex puede manejarla. La ruta MCP también funciona: cada espacio de trabajo puede actuar como servidor MCP.

Si estás sopesando un modelo en bruto frente a un compañero terminado, la guía de costo del servicio al cliente con IA y nuestra lista de agentes de IA para atención al cliente presentan el panorama completo.
Prueba eesel
Construir sobre DeepSeek V4.1 Flash 1017 tiene sentido cuando quieres un motor barato para tu propio agente. Si lo que realmente necesitas es una IA respondiendo tickets en tu helpdesk la próxima semana, el compañero de helpdesk de eesel se conecta a tu herramienta actual en minutos, aprende de tus tickets pasados y te muestra cómo los habría respondido antes de que cualquier cliente vea una respuesta. Puedes manejarlo desde el panel o desde la CLI. Prueba eesel gratis y ejecútalo primero con tu historial de tickets.
Preguntas frecuentes
¿Qué es DeepSeek V4.1 Flash 1017?
DeepSeek V4.1 Flash 1017 es la actualización del 17 de octubre de 2026 de DeepSeek V4.1 Flash. Obtiene mejores resultados en todos los benchmarks que DeepSeek publicó y termina las tareas con respuestas más cortas. Reemplazó la versión de septiembre en la app web, la app móvil y la API, bajo el mismo nombre de modelo deepseek-flash.
¿Cambió el precio de la API con DeepSeek V4.1 Flash 1017?
No. Las tarifas por token no cambiaron: fuera de horas pico, $0.15 por millón de tokens de entrada sin caché y $0.60 por millón de tokens de salida, el doble en horas pico. El desglose completo está en nuestra guía de precios de DeepSeek V4.1 Flash. Lo que cambia es el costo por tarea terminada, porque la versión 1017 escribe menos tokens de salida.
¿Cuánto cuestan las API Search y Fetch de DeepSeek?
Cada endpoint cuesta $0.75 por 1,000 solicitudes exitosas. Las llamadas fallidas, los resultados vacíos y los tiempos de espera agotados no se cobran. Las llamadas de búsqueda del lado del servidor hechas a través de DeepSeek Harness, Claude Code o Codex son gratis hasta el 31 de octubre de 2026 a las 16:00 UTC.
¿Puedo seguir usando la versión de septiembre de DeepSeek V4.1 Flash?
No en la API oficial. La página de precios de DeepSeek solo lista deepseek-flash (ahora la versión 1017) y deepseek-v4-pro, y los nombres antiguos de V4 Flash también se redirigen a 1017. Si necesitas una versión congelada, puedes alojar tú mismo los pesos abiertos con licencia MIT, algo que es un trabajo grande para un modelo de este tamaño. Nuestro resumen de agentes de código abierto repasa las ventajas y desventajas del autoalojamiento.
¿Sigue disponible DeepSeek V4 Pro después de la actualización V4.1 Flash 1017?
Sí. DeepSeek dio marcha atrás en su plan de retirarlo, y deepseek-v4-pro sigue funcionando como la versión DeepSeek-V4-Pro-0813 con su propio precio. Nuestra comparación de V4 Flash vs V4 Pro da el contexto sobre los dos niveles.
¿Es DeepSeek V4.1 Flash 1017 bueno para atención al cliente?
Como motor es rápido, barato y fuerte en el uso de herramientas. Para conversaciones reales con clientes, lee primero la política de privacidad de DeepSeek: indica que los datos personales pueden almacenarse en servidores en China. Además, una API de modelo no te da base de conocimiento, acciones en el helpdesk ni pruebas con tickets pasados. Un agente de IA para helpdesk como eesel cubre esas partes.
¿Cómo se compara DeepSeek V4.1 Flash 1017 con Claude Opus 5?
En la propia tabla de DeepSeek, 1017 supera a Claude Opus 5 en DeepSWE v1.1, Automation-Bench, Agents' Last Exam y Apex Bench. Opus 5 sigue liderando en HLE sin herramientas (56.3 frente a 42.6), Terminal-Bench 4.0, ProgramBench y NL2Repo. La diferencia de precio es mucho mayor que cualquiera de las dos diferencias de benchmark, consulta los precios de Opus 5.
¿Debo actualizar DeepSeek Harness para el modelo 1017?
Sí, DeepSeek recomienda DeepSeek Harness 0.2.1-rc.1 o posterior para el modelo 1017, y dice que optimizó la actualización para su propio harness, Tencent CodeBuddy y WorkBuddy. Si ejecutas el modelo en otra pila de agentes, vuelve a correr tus propias evaluaciones, ya que las respuestas más cortas pueden cambiar cómo se comportan los ciclos de tu CLI de agentes.