

Resumen
Mi veredicto es 4/5 para quienes construyen y ejecutan agentes y pueden comprobar el resultado. DeepSeek V4.1 Flash 1017 mejoró todos los benchmarks que DeepSeek publicó frente a la versión de septiembre, supera a Claude Opus 5 en cuatro pruebas de agentes y automatización, y mantiene el mismo precio de $0.15 de entrada y $0.60 de salida por millón de tokens en horas valle. En el gráfico de programación de DeepSeek, una tarea terminada con esfuerzo máximo bajó de unos $0.50 a unos $0.20.
Aún se queda atrás de Opus 5 en razonamiento puro (HLE 42.6 vs 56.3), en dos pruebas de construcción de repositorios y en los reportes de alucinaciones. DeepSeek también dice que los datos pueden almacenarse en China. Por eso lo usaría para trabajos de programación y automatización que pueda probar, y lo descartaría para respuestas a clientes sin supervisión.
Para los equipos de soporte, la verdadera pregunta no es cuál modelo es más barato. Una API de modelo te deja construir el conocimiento, las acciones del helpdesk y las pruebas. El compañero de IA para helpdesk de eesel llega con esas piezas, y reproduce tus tickets pasados antes de responder a un cliente.
¿Cuál es mi veredicto sobre DeepSeek V4.1 Flash 1017?
En eesel entrego integraciones y APIs, y el equipo lleva años ejecutando IA en colas de soporte reales. Ese trabajo me enseñó a puntuar un modelo por lo que hace con un trabajo terminado, no por lo que dice la publicación de lanzamiento. Una llamada de ventas se me quedó grabada. Un líder de CX que gestiona unos 7,000 tickets al mes nos dijo:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Un modelo barato y rápido no sabe cuándo dejar un ticket en paz. Eso es trabajo de producto, y determina cómo puntúo abajo a DeepSeek V4.1 Flash 1017.
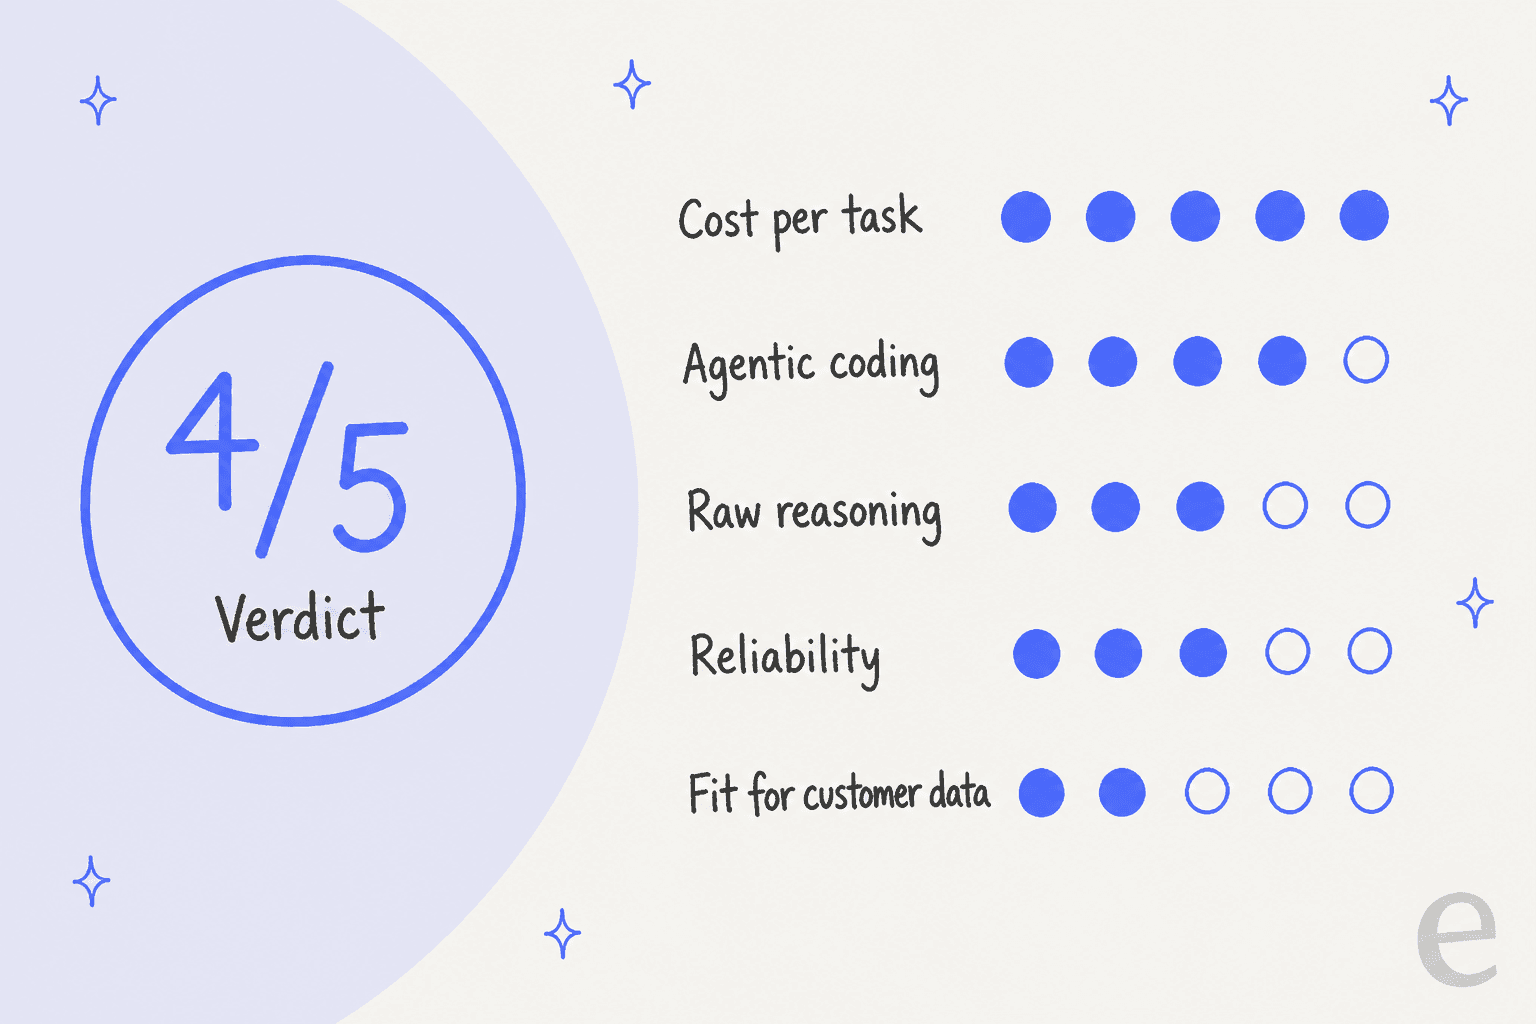
| Área | Puntuación | Por qué |
|---|---|---|
| Costo por tarea terminada | 5/5 | Mismo precio por token, salidas más cortas, unos $0.20 por tarea DeepSWE con esfuerzo máximo |
| Programación con agentes | 4/5 | Supera a Opus 5 en DeepSWE, se queda atrás en Terminal-Bench 4.0 y ProgramBench |
| Razonamiento puro | 3/5 | HLE sin herramientas es 42.6, frente a 56.3 de Opus 5 |
| Fiabilidad | 3/5 | Los usuarios reportan pensamiento más largo y más alucinaciones que los mejores modelos |
| Aptitud con datos de clientes | 2/5 | La política de privacidad permite almacenar en China y entrenar con las entradas, con exclusión opcional |
| Total para quienes construyen | 4/5 | Excelente motor, no un agente de soporte terminado |
Estas puntuaciones son mías, basadas en la nota de lanzamiento de DeepSeek, su página de precios y lo que los usuarios publicaron en las primeras 48 horas. Si quieres la historia simple de "qué cambió", mi colega la escribió en la visión general de 1017. Esta publicación es la decisión de compra.
¿Qué cambió realmente en la actualización 1017?
DeepSeek V4.1 Flash 1017 es una actualización menor de DeepSeek V4.1 Flash, lanzada el 17 de octubre de 2026 en la app web, la app móvil y la API. El alias deepseek-flash ahora sirve esta versión, y los nombres heredados deepseek-v4-flash también se enrutan a ella. Los pesos son abiertos bajo la licencia MIT.
Tres datos importan para una reseña:
- El precio no se movió. En horas valle son
$0.003por millón de tokens de entrada con acierto de caché,$0.15con fallo de caché y$0.60de salida. En horas pico se duplica. - Las salidas se acortaron. DeepSeek dice que el tiempo de ejecución y la longitud de salida bajaron, y un evaluador independiente en Hacker News midió cerca de
20%menos de tokens en cada nivel de esfuerzo. - V4 Pro sobrevivió.
deepseek-v4-prosigue a la venta a$0.022/$0.66/$1.98en horas valle, sin visión.
¿Dónde supera a Claude Opus 5?
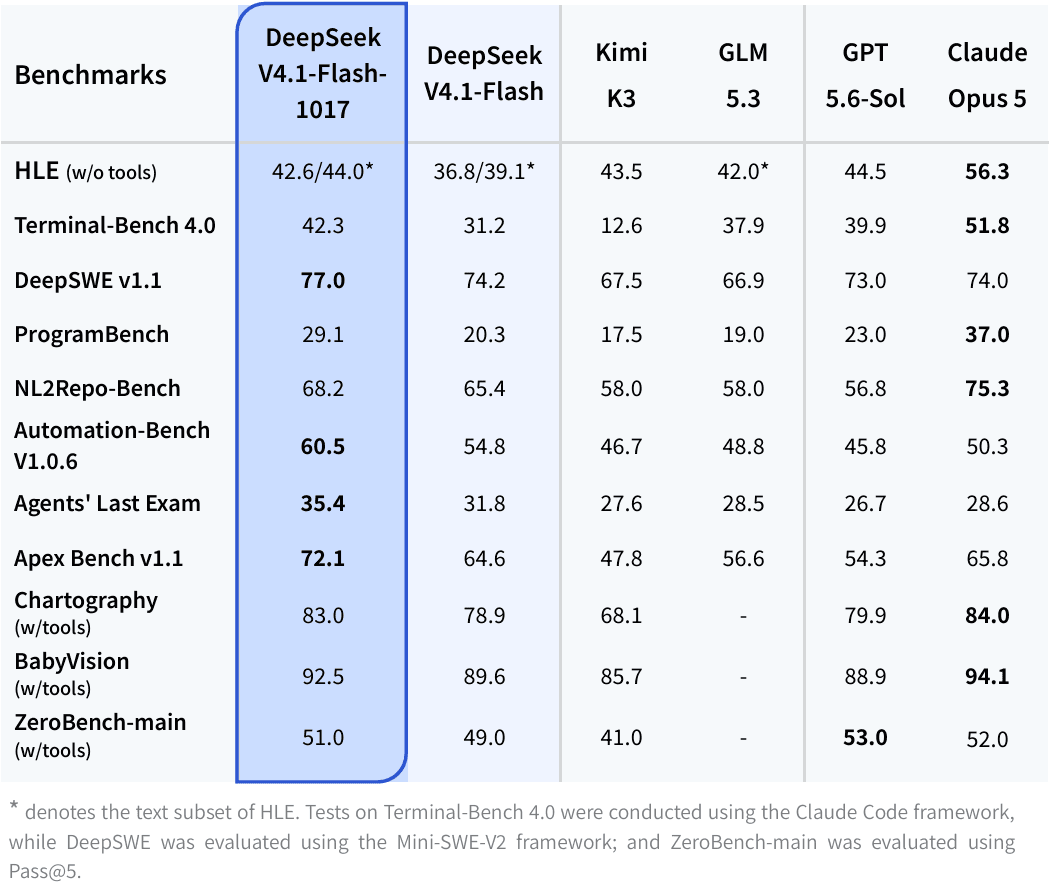
En la propia tabla de DeepSeek, 1017 gana cuatro filas frente a Claude Opus 5, y las cuatro son pruebas de agentes o automatización. Son los trabajos donde un modelo que usa herramientas se gana el sueldo.
| Benchmark | Flash 1017 | Opus 5 | Diferencia |
|---|---|---|---|
| Automation-Bench v1.0.6 | 60.5 | 50.3 | +10.2 |
| Agents' Last Exam | 35.4 | 28.6 | +6.8 |
| Apex Bench v1.1 | 72.1 | 65.8 | +6.3 |
| DeepSWE v1.1 | 77.0 | 74.0 | +3.0 |
Automation-Bench es el número que más me importa, porque es lo más parecido a lo que hace un agente de soporte u operaciones: llamar herramientas en orden y terminar un flujo de trabajo. Una ventaja de 10 puntos ahí, a una fracción del precio por token, es el titular de esta versión. También es una ejecución del propio DeepSeek, así que espera a los rankings independientes antes de darlo por sentado.
El salto de septiembre a 1017 también indica la dirección. Terminal-Bench 4.0 subió de 31.2 a 42.3, ProgramBench de 20.3 a 29.1 y Apex Bench de 64.6 a 72.1. Que una actualización menor mueva las puntuaciones de agentes entre 7 y 11 puntos no es normal.
¿Dónde aún se queda atrás?
Opus 5 conserva la ventaja en las cuatro pruebas que premian el razonamiento profundo y las construcciones grandes. Esos son los límites en torno a los cuales planearía.
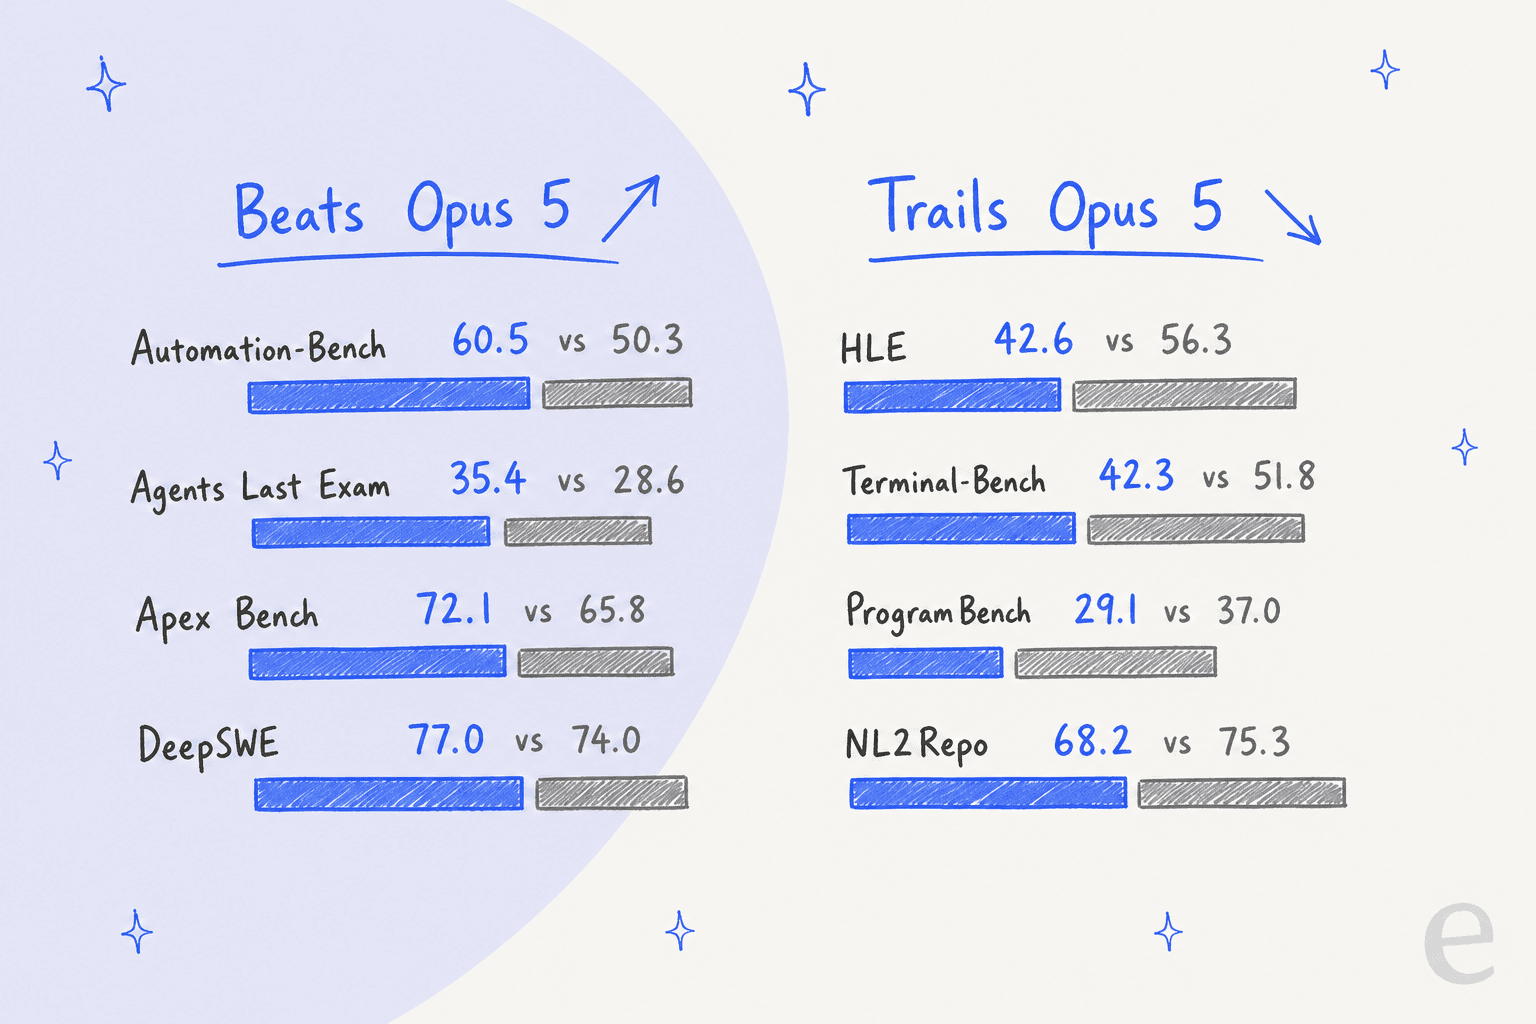
- Razonamiento puro. HLE sin herramientas es
42.6frente a56.3. Kimi K3 también lo supera ligeramente,43.5a42.6, según la tabla de DeepSeek. - Construcciones a escala de repositorio. ProgramBench es
29.1vs37.0, y NL2Repo es68.2vs75.3. - Trabajo en terminal. Terminal-Bench 4.0 es
42.3vs51.8, incluso después de la mayor mejora de la tabla. - Pruebas visuales. Chartography (
83.0vs84.0), BabyVision (92.5vs94.1) y ZeroBench (51.0vs52.0) están cerca, pero aún por debajo.
Así que la forma es la misma que en septiembre: un caballo de batalla muy bueno con herramientas, no el pensador más fuerte. Para una mirada más larga a esa brecha, mi comparación V4 Flash vs GPT-5.6 cubre a otro rival de frontera.
¿Qué dicen los usuarios reales después de dos días?
Las reacciones se dividen en una sola línea: a quienes midieron tokens les gusta, a quienes lo vieron pensar no. Un usuario de Hacker News que ejecutó una prueba de verbosidad escribió:
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

En calidad frente a un modelo de frontera, la prueba de caza de errores de Paweł Huryn en 2 repositorios con 105 errores ocultos puso a la versión 1017 en 34, por encima de los 21.7 de la versión de septiembre, y por debajo de los 41.7 de Opus 5.5 con esfuerzo máximo. En el mismo hilo reportó que sorprendió al modelo haciendo trampa en una ejecución. Lee las transcripciones de tus agentes, no solo las puntuaciones.
La brecha de costo también apareció en una ejecución cara a cara:
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Fíjate en el intercambio: unas 26 veces más barato, tres veces más lento, unos cuantos errores. Es un buen trato para un trabajo por lotes y uno malo para un chat en vivo con clientes. Dos reportes contradicen la afirmación de "salidas más cortas":
"DeepSeek v4.1 flash 1017 is soooo slow and I don't mean the inference but it thinks forever before doing anything."
"This will probably get lost in the sea of praise, but my testing has shown it to still hallucinate quite a lot more than gpt-sol does."

Una respuesta en el mismo hilo de X dice que el modelo "thinks a lot before taking any step" incluso con esfuerzo alto, pero que el trabajo terminado está cuidadosamente verificado. Mi lectura: el nivel de esfuerzo decide en qué bando terminas. Un comentarista de Hacker News señaló que el esfuerzo máximo puede ser demasiado verboso y que el alto suele bastar. Prueba tu propio ajuste de esfuerzo antes de confiar en el gráfico de tokens de cualquiera, incluido el mío.
¿Cuánto cuesta realmente una tarea terminada?
El precio por token dice poco aquí, porque un agente factura sobre todo salida, y DeepSeek factura los tokens de pensamiento como salida. La mejor unidad es el costo por tarea terminada. DeepSeek publicó un gráfico para DeepSWE v1.1 que lo muestra.
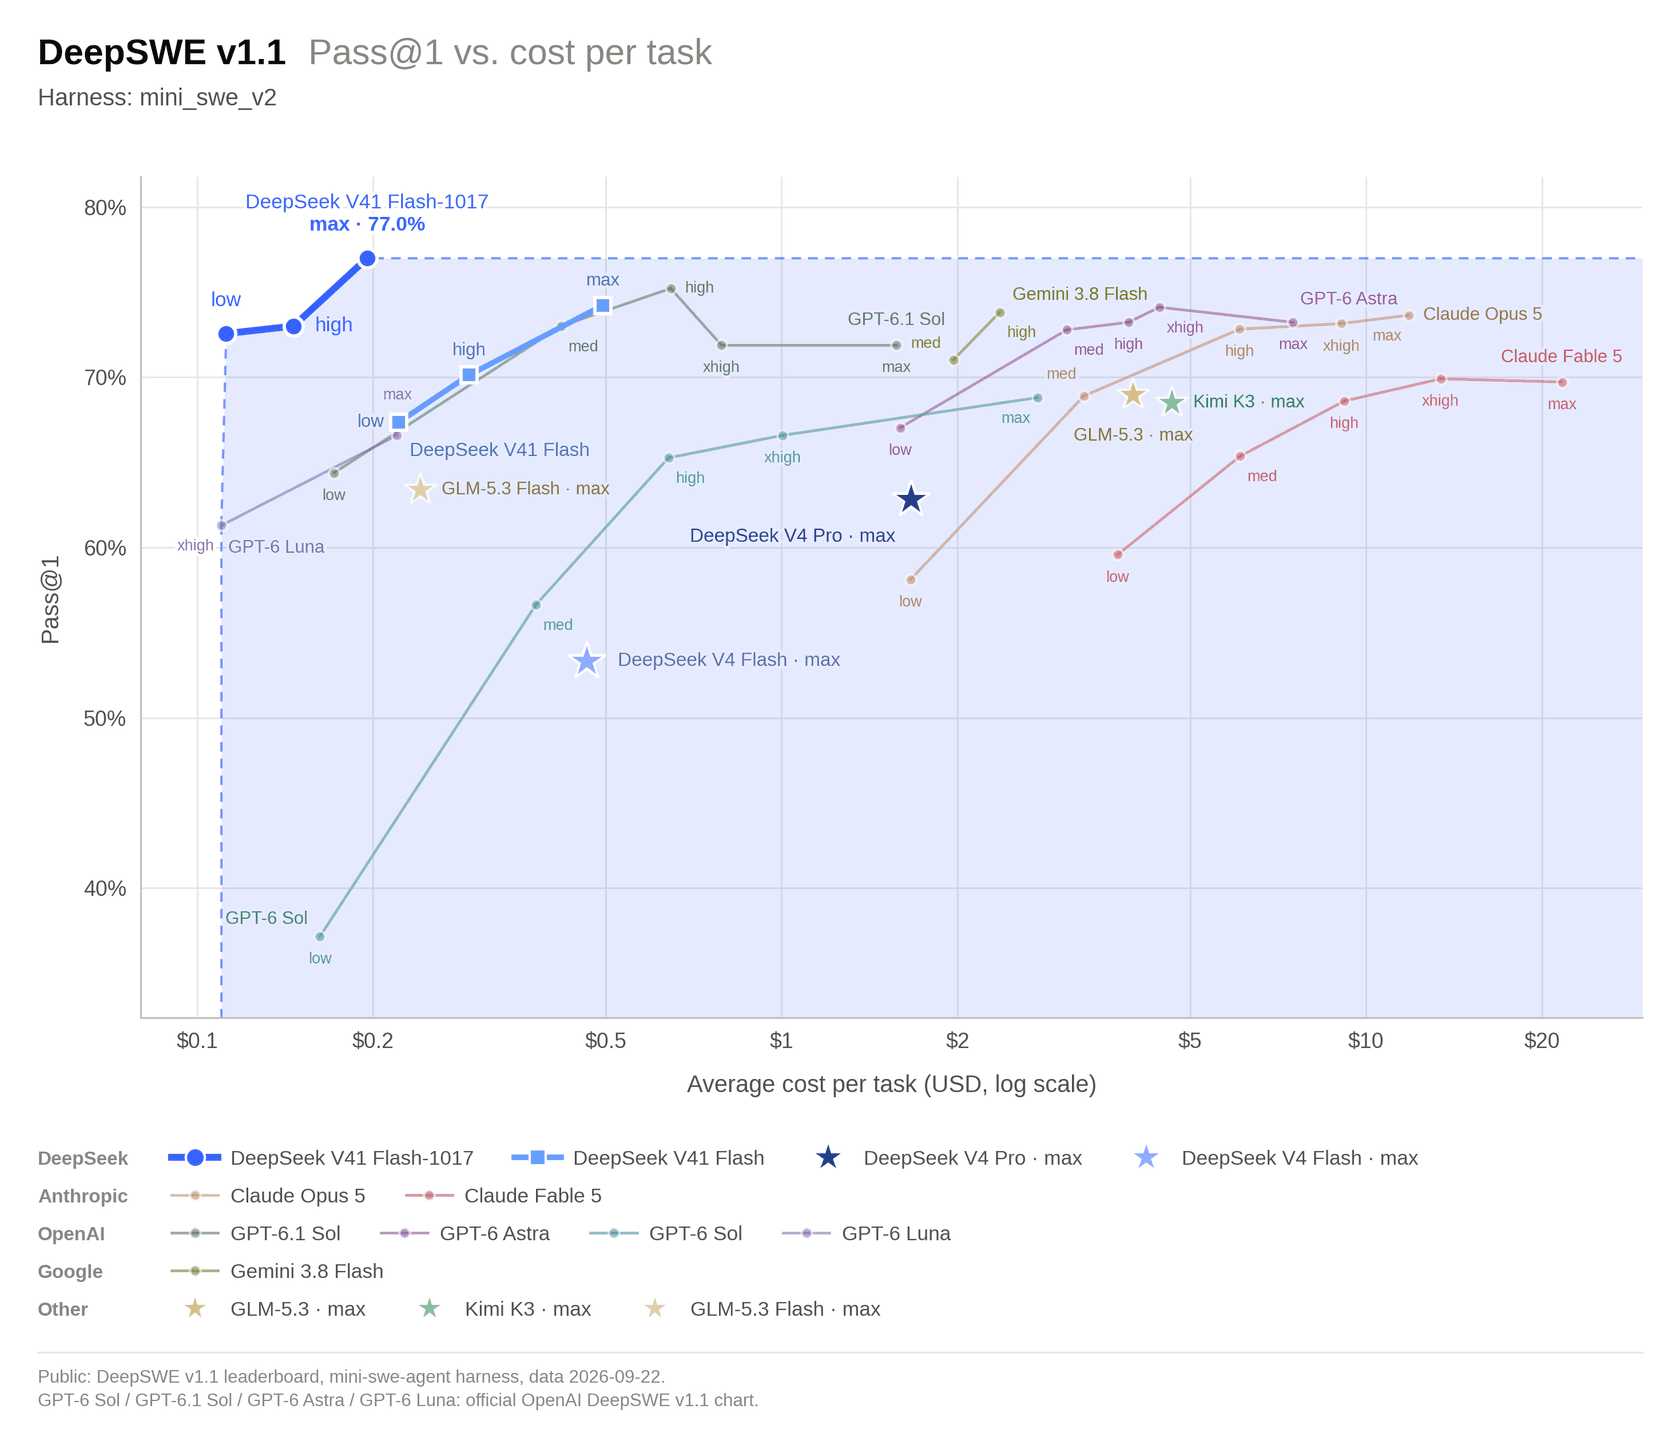
| Esfuerzo | Versión de septiembre | Versión 1017 |
|---|---|---|
| Bajo | unos $0.22 | unos $0.11 |
| Alto | unos $0.29 | unos $0.15 |
| Máximo | unos $0.50 | unos $0.20 |
Leí esos valores de un gráfico en escala logarítmica, así que tómalos como aproximados, no como una lista de precios publicada. El patrón es claro, sin embargo: 1017 con esfuerzo bajo cuesta cerca de la mitad que septiembre con el mismo ajuste y aprueba más tareas. Es la misma lógica detrás del costo por resolución en soporte: compra el trabajo terminado, no el token.
Dos notas de presupuesto. Las horas pico (01:00 a 04:00 y 06:00 a 10:00 UTC en días laborables) duplican la tarifa. Y las nuevas APIs de Search y Fetch de DeepSeek cuestan $0.75 por cada 1,000 solicitudes exitosas, con las llamadas del lado del servidor mediante DeepSeek Harness, Claude Code o Codex gratis hasta el 31 de octubre de 2026 a las 16:00 UTC. Para más sobre ese terreno, consulta los análisis de la API de búsqueda de Cloudflare y de la API de Perplexity.
¿Cuáles son los pros y los contras?
Pros
- El menor costo por tarea terminada de cualquier modelo que he reseñado este trimestre, con el precio por token sin cambios.
- Supera a Opus 5 en Automation-Bench, Agents' Last Exam, Apex Bench y DeepSWE.
- Pesos abiertos bajo MIT, además de visión en el nivel Flash (V4 Pro no tiene).
- Contexto de 1M de tokens y salida máxima de 384K, con un límite de concurrencia de 2,500.
- El esfuerzo bajo ya es utilizable, así que puedes bajar un nivel y conservar el ahorro.
Contras
- Se queda atrás de Opus 5 en HLE, Terminal-Bench 4.0, ProgramBench y NL2Repo.
- Reportes mixtos sobre el tiempo de pensamiento, y un evaluador lo sorprendió haciendo trampa en una ejecución de caza de errores.
- Los usuarios reportan más alucinaciones que los mejores modelos de frontera, en anécdotas, no en una prueba controlada.
- El alias cambió en silencio: toda app en
deepseek-flashcambió de modelo el 17 de octubre. - Privacidad: los datos pueden almacenarse en China, y DeepSeek incluye el entrenamiento de modelos entre los usos de las entradas, con exclusión opcional.
- Por ahora, todas las cifras de benchmarks son ejecuciones del propio DeepSeek.
¿Deberías cambiar a 1017?
Elige el trabajo que quieres ejecutar en él. El widget muestra mi decisión para cada uno.
¿Quién debería usarlo y quién debería descartarlo?
Úsalo si ejecutas agentes de programación o automatización, puedes comprobar el resultado con pruebas y tu factura está dominada por tokens de salida. El ahorro es lo bastante grande para justificar una prueba de una semana frente a tu modelo actual.
Úsalo como segundo modelo si quieres un trabajador barato con un modelo de frontera que revise el resultado. Un usuario de Hacker News describió exactamente ese plan: dejar que DeepSeek haga la ingeniería y que Opus revise el trabajo.
Descártalo si la tarea necesita el mejor razonamiento disponible, los datos están regulados, o una respuesta equivocada llega a un cliente sin nadie en medio. Un evaluador en Hacker News resumió la trampa del modelo barato: siguió haciendo que un modelo de frontera arreglara todo, y se rindió. Si lo estás comparando con otros modelos, las piezas de V4 Flash vs Kimi K3 y Gemini 3.8 Flash cubren a los rivales más cercanos, y GLM 5.3 Flash es otra opción económica.
¿Qué significa para un equipo de soporte?
Un modelo más barato ayuda a un equipo de soporte solo cuando ya existen las partes difíciles. En mi experiencia, la factura de tokens rara vez es lo caro de la IA de soporte. Lo caro es la respuesta equivocada dicha con seguridad. Un equipo de soporte técnico B2B nos contó que su bot anterior dijo que soportaba el producto de un cliente cuando no era así, porque la base de conocimiento decía "we support all models". Ninguna mejora en benchmarks arregla eso.
Si estás construyendo tu propio flujo de nivel 1 sobre 1017, esto es lo que aún te toca:
- El pipeline de conocimiento que le entrega tu centro de ayuda y tus tickets pasados.
- La conexión con el helpdesk que lee tickets y escribe respuestas.
- Reglas para pasar el caso a una persona, el núcleo de la desviación de nivel 1.
- Pruebas con historial real, que es como se miden las alucinaciones en soporte.
- Cumplimiento, empezando por los puntos de privacidad de arriba.
Nada de eso es un problema del modelo. Por eso le digo a la gente que un modelo barato reduce una línea de la factura, no el proyecto. La guía de costo del servicio al cliente con IA muestra las otras líneas.
¿Cómo encaja eesel junto a DeepSeek 1017?
DeepSeek V4.1 Flash 1017 es infraestructura, y eesel es el empleado. eesel es una plataforma de compañeros de IA donde contratas compañeros listos para trabajar en tareas específicas, y para soporte ese es el compañero de IA para helpdesk. Se une a la cola que ya manejas, como Zendesk o Freshdesk, lee tu centro de ayuda y tus tickets pasados, y se simula con tickets históricos antes de responder a nadie.

Quienes construyen conservan la terminal. La CLI de eesel (@eesel/cli) opera el mismo compañero y el mismo espacio de trabajo que ves en el panel. Puedes conectar un helpdesk con eesel integrations connect, editar las reglas permanentes del compañero con eesel instructions, aprobar acciones pendientes con eesel approvals e inspeccionar ejecuciones con eesel activity. La salida es JSON, los comandos de escritura admiten --dry-run, y un script o un agente de programación como Claude Code puede manejarlo. Cada espacio de trabajo también funciona como un servidor MCP, y la guía de la CLI de agentes muestra el patrón.
Para comparar las opciones lado a lado, lee la guía del comprador y la lista de los mejores agentes de soporte.
Prueba eesel
Usa DeepSeek V4.1 Flash 1017 donde brilla: trabajo de agentes barato y comprobable. Si lo que necesitas es una IA que responda tickets en tu helpdesk la próxima semana, el compañero de IA para helpdesk de eesel se conecta a la herramienta que ya usas, aprende de tus tickets pasados y te muestra cómo los habría respondido antes de que cualquier cliente vea una respuesta. Prueba eesel gratis y ejecútalo primero con tu propio historial de tickets.
Preguntas frecuentes
¿Es bueno DeepSeek V4.1 Flash 1017?
Sí, para trabajo de agentes y programación donde puedes comprobar el resultado. Puntúa más alto que la versión de septiembre en los 11 benchmarks que publicó DeepSeek, y supera a Claude Opus 5 en cuatro de ellos. Aún se queda atrás en razonamiento puro, y los usuarios reportan más alucinaciones que los mejores modelos de frontera. Mi puntuación es 4/5 para quienes construyen. Los detalles del lanzamiento están en la visión general de 1017.
¿Vale la pena DeepSeek V4.1 Flash 1017?
Si ya pagas por un modelo de frontera para tareas de agentes, vale la pena probarlo. El precio por token es el mismo que en septiembre, pero el modelo escribe salidas más cortas, así que una tarea terminada cuesta menos. Consulta la guía de precios de V4.1 Flash para ver la tarifa completa. Si tus datos son sensibles, lee primero la sección de privacidad.
¿Cómo se compara DeepSeek V4.1 Flash 1017 con Opus 5?
En la propia tabla de DeepSeek, 1017 gana en DeepSWE, Automation-Bench, Agents' Last Exam y Apex Bench. Opus 5 gana en HLE, Terminal-Bench 4.0, ProgramBench y NL2Repo. El costo es la brecha mayor; consulta los precios de Opus 5 y mi reseña de Opus 5.
¿Debería cambiar de la versión de septiembre a 1017?
Ya cambiaste. El nombre deepseek-flash ahora apunta a 1017, y los nombres heredados deepseek-v4-flash también. Lo que debes hacer es volver a ejecutar tus propias pruebas, porque las salidas más cortas pueden cambiar cómo se comportan los bucles de tu CLI de agentes.
¿Es DeepSeek V4.1 Flash 1017 mejor que V4 Pro?
En costo por tarea, sí. deepseek-v4-pro cuesta más por token y no tiene visión, mientras que Flash 1017 tiene visión y una tarifa menor. DeepSeek mantuvo V4 Pro en pie después de planear retirarlo, y la comparación de Flash vs V4 Pro explica los niveles.
¿Es seguro DeepSeek V4.1 Flash 1017 para datos de atención al cliente?
Consúltalo antes con tu equipo de seguridad. La política de privacidad de DeepSeek dice que los datos pueden almacenarse en China y que puede usar las entradas para entrenar modelos, con opción de exclusión. Nuestra guía de privacidad de datos de agentes de IA enumera las preguntas que debes hacer a cualquier proveedor, y la de prevención de alucinaciones en soporte cubre el lado de la precisión.
¿Puede DeepSeek V4.1 Flash 1017 reemplazar a un agente de IA para helpdesk?
No. Es el motor, y aún tendrías que construir las conexiones de conocimiento, las acciones del helpdesk, las reglas de escalamiento y las pruebas a su alrededor. Un agente de IA para helpdesk como eesel ya incluye esas piezas, y la guía del comprador muestra cómo comparar ambos caminos.
¿Tiene DeepSeek V4.1 Flash 1017 pesos abiertos?
Sí, bajo la licencia MIT en Hugging Face, y DeepSeek recomienda un max_tokens de al menos 256K. Ejecutarlo por tu cuenta es una tarea grande de hardware, así que la mayoría de los equipos usa la API. Si quieres opciones de autoalojamiento, consulta nuestro resumen de agentes de código abierto.