

Una semana de lectura, toda sobre deepseek-v4-flash-vision-exp. La documentación. La tabla completa de benchmarks. Tres días de telemetría de producción y, después, los 153 comentarios del hilo de lanzamiento. El hallazgo más útil es que este es un mejor modelo de texto con ropaje de lanzamiento de visión. Seis de siete filas de agentes de texto se las lleva frente a V4-Flash, según la propia tabla de DeepSeek. ¿Y el mayor consumidor público hasta ahora? Una herramienta de programación que nunca envía una imagen.
Sobre la parte de visión en sí, el resumen honesto es más acotado que la nota de lanzamiento, y también más acotado que la reacción en contra. El diseño lo maneja, las formas de los gráficos también, y la estructura de una captura. Lo que se rompe son los glifos pequeños, porque cada imagen se aplana hacia 800 por 800 antes de que ocurra nada más, y no hay un modo de alta resolución que activar. El conjunto de verificación de pies de foto de un probador: 6 de 12, frente a un rival con 11 de 12. La forma en que falló vale más que la puntuación. Al darle una foto de la catedral de Wells etiquetada como "Salisbury", estuvo de acuerdo. La historia de los benchmarks también se ablanda en una segunda lectura. Esa cifra destacada de DeepSWE cae dentro de la barra de error de un competidor, las mejoras multimodales miden en parte "un modelo ve y el otro no", y toda la tabla sale del propio arnés de DeepSeek el día del lanzamiento.
Si vas a apuntar todo esto a una cola de soporte, el fallo de la complacencia es la parte en la que conviene detenerse. Un modelo que confirma cualquier etiqueta que le des es exactamente el modo de fallo que cuesta dinero en soporte, y un modelo más grande no lo arregla. Lo que lo arregla es fundamentar al agente en tu contenido de ayuda real y luego reproducirlo sobre tus propios tickets pasados antes de que un cliente vea una sola palabra. Eso es justo para lo que está hecho eesel.
Qué probé y qué no
Construyo agentes de IA en eesel, así que ante un lanzamiento como este mi instinto es ir primero al mecanismo. Qué ve realmente el modelo. Qué hace el arnés antes de que los pesos vean un solo píxel. Y dónde va a caer el fallo cuando empiecen a llegar entradas reales. Esa es la lente de toda esta reseña.
Esta es la metodología, dicha sin rodeos para que la descuentes en su justa medida. Leí la guía de visión línea por línea, hice lo mismo con la página de precios y luego extraje tres días de telemetría real de producción de OpenRouter.
Después repasé uno por uno todos los comentarios del hilo de lanzamiento, que llegó a 495 puntos y 153 comentarios. Cuando aquí se cita un resultado de uso real, las manos son de otra persona, y digo de quién.
Lo que no hice: ejecutar una evaluación de visión controlada propia sobre unos cientos de imágenes. Importa, porque la mayor lección de este hilo es que las pruebas de visión con muestras pequeñas producen conclusiones seguras y equivocadas, y cometer justo el error del que trata este artículo quedaría fatal. Así que trata esto como una revisión de la evidencia, no como un benchmark mío.
Si lo que quieres es el lanzamiento explicado de principio a fin, con la aritmética de precios y la tabla completa de límites, eso está en mi análisis del lanzamiento. Este artículo trata solo de si la cosa es buena.
La prueba del reloj es un caso de estudio de cómo no reseñar un modelo de visión
El intercambio más leído de todo el hilo de lanzamiento trata de un reloj. Vale la pena repasarlo en orden, porque es la ilustración más limpia que he visto de cómo se desvían las reseñas de visión.
Empezó con un informe de fallo sencillo:
"It fails the simple clock test for me which Qwen3.8 27B got (nearly) right."

El detalle es peor que ese resumen. Ante un reloj analógico renderizado, DeepSeek respondió 5:10, falló la hora por tres horas y además confundió qué aguja era de qué color. Qwen3.8 27B dijo 8:10. La hora real era 08:09:25, así que ambos se equivocaron, solo que de maneras distintas, y la lectura de un comentarista sobre la diferencia es más aguda que la mayoría de los comentarios sobre benchmarks:
"Also worth noting that both models got it wrong. Qwen made a mistake that humans very good at reading clocks would make. Deepseek made a mistake that a human who had just learned to read clocks would make."
Entonces alguien repitió la prueba, y el hallazgo se dio la vuelta.
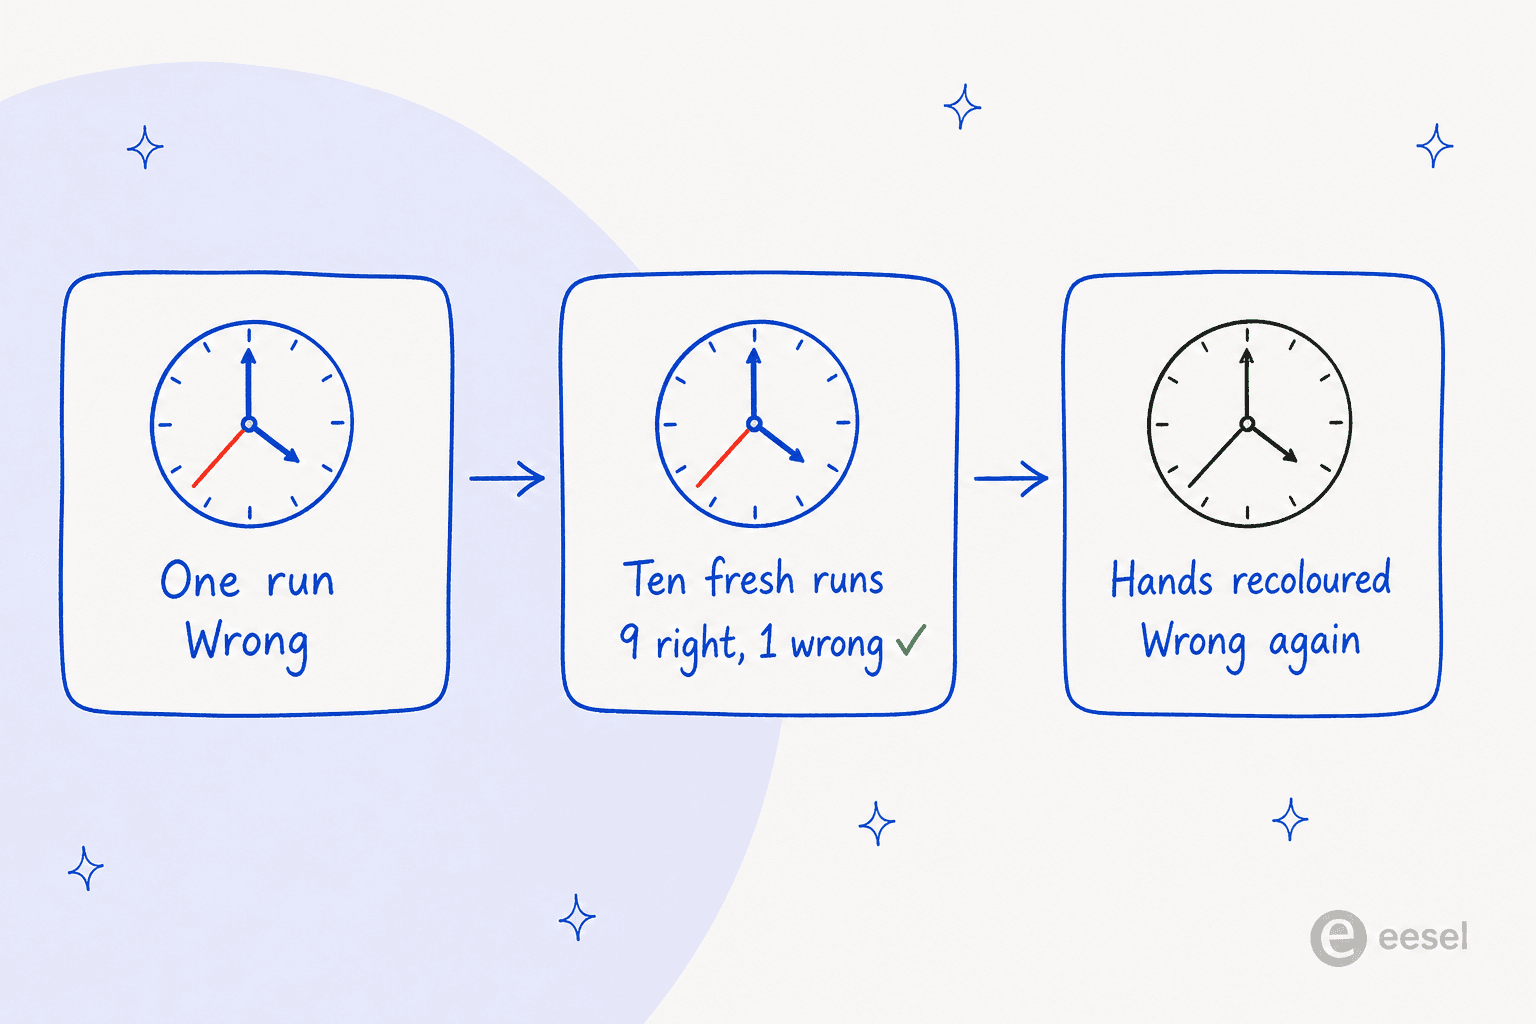
"I now ran the test 10 times total, fresh session every time, and DS4 got it right 9 out of 10 times. Lesson learned to double check what I read on the internet."
¿Entonces el modelo está bien? No exactamente, y aquí se pone interesante. Tres personas distintas desmontaron la repetición.
Primero, la corrección fue indulgente. Esas nueve respuestas "correctas" fueron todas 8:10, mientras que la hora real en la esfera era 8:09:25, y un lector lo señaló directamente:
"fwiw the clock reads 8:09:25 not 8:10:25 although it would be passable to read it as 8:10 if there were no second hand"
Segundo, la propia imagen de prueba era rara. Cada aguja del reloj tenía un color distinto, algo que no es en absoluto como se ven normalmente los relojes, y un lector admitió que el diseño también lo había engañado:
"I know that the hand lengths and thicknesses on this image are correct but for some reason I, a totally human person who grew up when analog clocks were still common, see this and think the hand on the 5 is the minute hand."
Tercero, y este es el diagnóstico, el autor original aceptó esa sugerencia y repitió la prueba con todas las agujas dibujadas en negro. DeepSeek respondió entonces 8:25, perdiendo por completo el segundero y ascendiéndolo a minutero. Lo cual es una fuerte pista de que se había estado fijando en el color de las agujas todo el tiempo y no en su longitud. Así que el 9 de 10 era real. La razón de fondo no era la que todos suponían.
Y el hallazgo que reencuadra todo el subhilo vino de alguien que simplemente ejecutó la misma imagen en todos los demás sitios:
"Gemini 3.7 Flash and 5.6-Sol (on all reasoning levels) also answer 8:10:25. The new "stealth" Ox Alpha also replies with the same. Opus 5 replies with 8:10 (no seconds). Not sure why this is so hard for them; Gemini is especially good at vision and I would have expected better from it."
Nada de lo que nadie probó llegó a 8:09:25. Ni Gemini, ni Opus 5, ni ningún nivel de razonamiento. Así que lo que parecía una debilidad de DeepSeek con n=1 resultó ser un punto ciego compartido por toda la frontera, y todo el revuelo se resolvió en un dato sobre relojes analógicos en lugar de un dato sobre este modelo.
Hay un contraargumento razonable sobre si esta prueba siquiera es relevante, y un lector lo expuso bien:
"Reading any analog clock at any time level (edit: and a non-noisy vector rendered image at that) is absolutely table stakes for an allegedly frontier flagship vision model. As much as 1:1 OCR."
Simpatizo con esa opinión. Y tampoco es una tarea hipotética: un comentarista describió que pidió a un agente de programación que hiciera QA de un juego de leer relojes para sus hijos tomando capturas de la compilación de Godot, que es exactamente este problema dentro de un flujo de trabajo de software real.
La lección operativa, sin embargo, es la que pegaría en la pared. Una sola prueba de visión no dice casi nada. La varianza entre ejecuciones idénticas fue lo bastante grande para dar la vuelta al veredicto por sí sola. El diseño del estímulo cambió el modo de fallo y el umbral de corrección cambió la puntuación. Si evalúas cualquier modelo de visión para trabajo real, este incluido, ejecútalo muchas veces con tus propias entradas y luego puntúalo con rigor. Es el mismo principio que hay detrás de un control de calidad de soporte en serio en lugar de fiarse de una demo.
Dónde muerde realmente el redimensionado y dónde no
El mecanismo es simple, y también lo más importante de este modelo. Antes de la inferencia, DeepSeek redimensiona cada imagen para que el total de píxeles quede más o menos donde quedaría una imagen de 800 por 800, manteniendo la proporción. De ahí sale un techo estricto de 384 tokens para una imagen, y la documentación enuncia la consecuencia sin rodeos: una imagen de 2000 por 2000 y una de 5000 por 5000 consumen el mismo número de tokens.
Un comentarista puso esa cifra en perspectiva mejor que la documentación:
"800x800 is 640,000 pixels, or 0.64 Megapixels. That is less than the resolution of computer screens from 1995, Super VGA which has around 0.79 MPs."
La pregunta útil aquí no es "¿bastan 0,64 MP?", sino "¿bastan para qué?". Y la respuesta se ordena casi por completo según el tamaño del glifo; la dificultad de la tarea apenas influye.
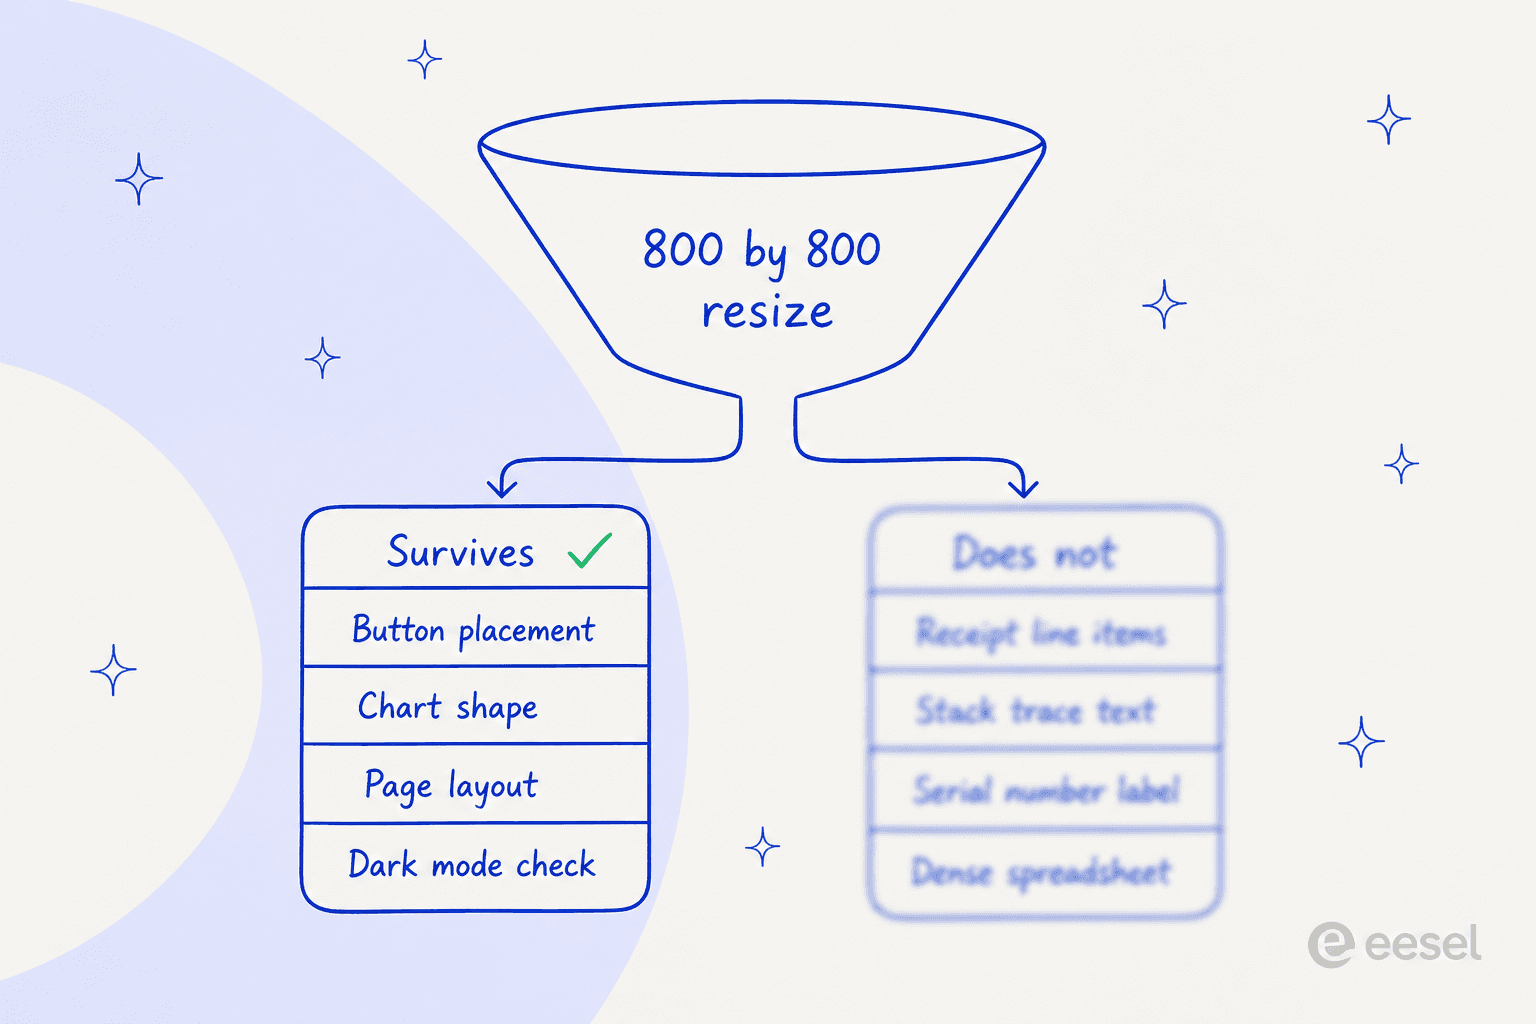
Comprobar que un botón se renderizó en el lugar correcto, leer la forma de un gráfico, verificar un diseño en modo oscuro, confirmar la estructura de una página: todo eso sobrevive cómodamente a una reducción. Leer las líneas de un recibo, un stack trace dentro de un diálogo de error, un número de serie en la etiqueta de un producto o una hoja de cálculo densa: ahí es donde se cae a pedazos. Una página completa de documento queda justo en el límite, y un lector lo señaló de inmediato:
"It's useful but for OCR and a lot of other applications it needs to be a bit higher (eg: putting in a full A4 / Letter sized page)"
Para hacerlo concreto en lugar de una regla general, aquí tienes la aritmética aplicada a tus propias entradas. Introduce las dimensiones de una imagen que enviarías de verdad, más la altura en píxeles del texto más pequeño que contiene.
Con una captura de 2560 por 1440 y texto de interfaz de 14 px, el texto más pequeño queda en 5,8 px. Baja a una captura normal de 1920 por 1080 y obtienes 7,8 px. Una captura normal con texto de interfaz normal no supera el listón, y esa es la versión incómoda de la historia, porque lo que vuelve es una respuesta plausible que a veces es incorrecta, nunca un fallo obvio.
La solución alternativa a la que llegó el hilo es una herramienta de recorte, y un comentarista detalló la canalización exacta que ejecuta:
"When the LLM tries to read an image, it will be resized by DeepSeek's server to 800x800, which might be a bit blurry. The LLM will then crop a smaller image from the high resolution image (using e.g. the
converttool via bash) and will then read the small cropped image. This image will still be resized to 800x800 by DeepSeek's server, but since it is already small, there is no or little loss of quality."
Funciona, y varias personas confirmaron que les funciona. Pero no es gratis. La variante de recorte en cuadrícula de la misma idea, en la que se divide una imagen grande en teselas y se procesa cada celda, cuesta al menos el doble de tokens según la estimación de un comentarista, y recomponer nueve recortes en una comprensión espacial única es un problema aparte. Si lo construyes tú mismo, es un buen trozo de trabajo de arnés encima de un bucle de llamadas a herramientas que ya tienes que mantener. Varios de los agentes de código abierto que merecen un vistazo ya incluyen algo parecido.
Y la defensa de que un modelo barato y rápido simplemente tiene que limitar su resolución no sobrevive del todo al contacto con la competencia. Alguien argumentó justo eso, y la respuesta llegó enseguida:
"Gemini "flash" models have an option for media resolution, including a high resolution option for screenshots."
Es la comparación individual más justa de todo el hilo. Un competidor del mismo nivel de velocidad y coste sí expone el control, y Google ha estado construyendo visión agéntica sobre él. El parámetro detail de DeepSeek parece que debería hacer lo mismo, pero no lo hace. low sí reduce a 512 por 512, mientras que high, original y auto significan ahora mismo exactamente lo mismo: conservar el original y aplicar el redimensionado estándar de todos modos.
También conviene decir que mucha gente informó de que el tope no era un problema para su trabajo real. Uno lo dijo sin rodeos:
"It can read and extract information from screenshots and PDFs just fine (my setup). No need to worry about edge cases."
Otro señaló que si sus capturas superan los 800 px, probablemente habría podido encuadrar mejor la captura desde el principio. Ambos puntos son razonables. El tope es una restricción y no un defecto, y que te afecte depende por completo de a qué lo apuntes.
La tabla de benchmarks es más blanda de lo que parece
Ahora los números, la parte que la mayoría de las reseñas reimprimen sin leer de cerca.
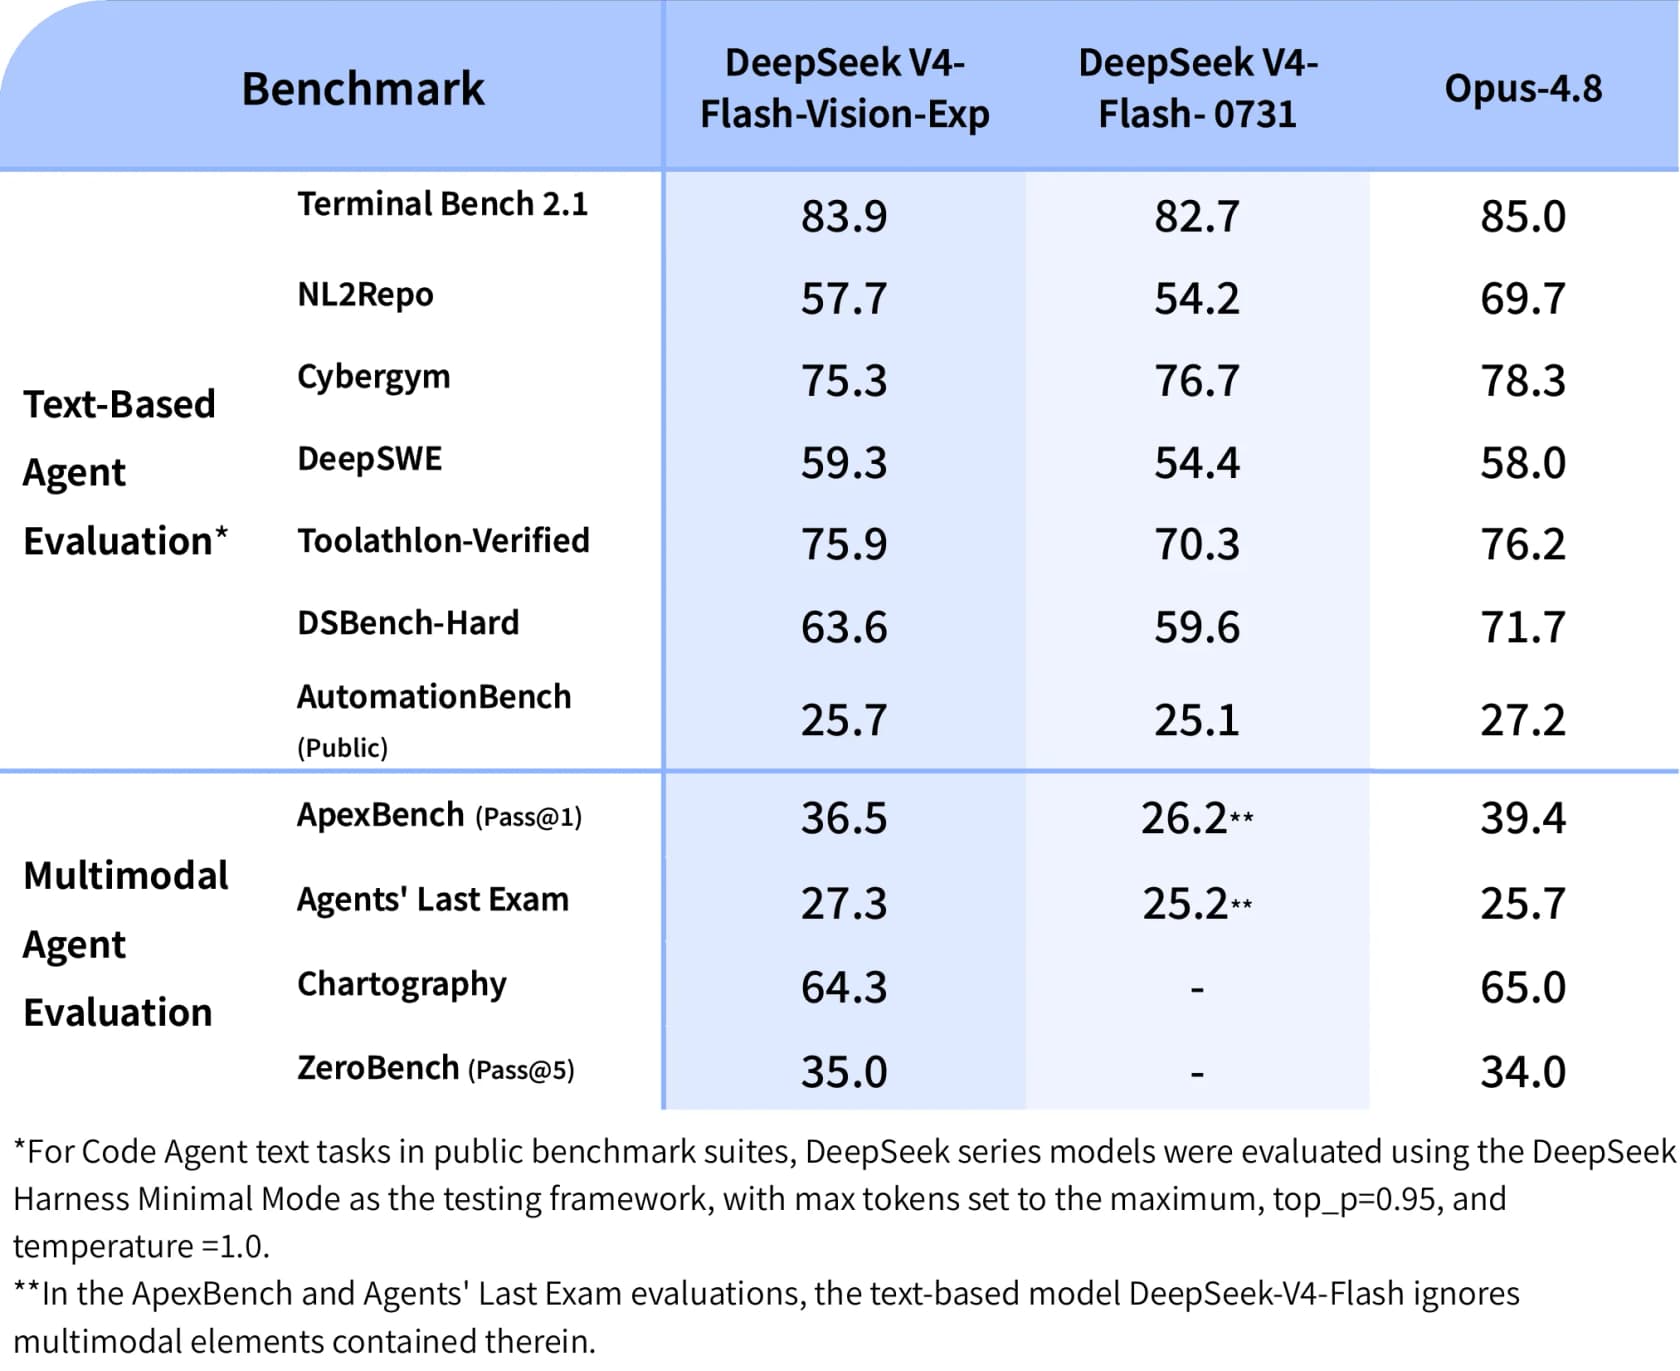
Empecemos por lo que se sostiene. En las siete filas de agentes de texto, la versión con visión supera a V4-Flash solo de texto en seis: DeepSWE 59,3 frente a 54,4, Toolathlon-Verified 75,9 frente a 70,3, NL2Repo 57,7 frente a 54,2, DSBench-Hard 63,6 frente a 59,6, Terminal Bench 2.1 83,9 frente a 82,7, AutomationBench 25,7 frente a 25,1. La única derrota es Cybergym, 75,3 frente a 76,7. La propia nota de lanzamiento de DeepSeek dice que "iguala" a V4-Flash en texto, lo cual resta mucho valor a su propio resultado.
Encima de eso hay tres salvedades, y cada una vino de alguien que leyó la tabla con más cuidado que la cobertura del lanzamiento.
La cifra destacada se solapa con la barra de error de un competidor. En la fila de DeepSWE, un lector alineó los intervalos:
"The DeepSWE benchmark they report (59.3%) overlaps with the confidence interval of 5.6-Sol Medium (61% +/- 2%), but likely at 1/18th the cost (they did not report the DeepSWE benchmark cost, but v4-flash had this cost ratio against Sol Medium)."
Así que "supera a un modelo de frontera en DeepSWE" es en realidad "estadísticamente indistinguible de uno, a una fracción del precio". Sigue siendo un buen resultado, y es una afirmación distinta. También conviene señalar que la proporción de coste de 1/18 se infiere de V4-Flash en lugar de estar publicada para esta ejecución, y que todo el conjunto no está verificado oficialmente por DeepSWE.
El modelo de comparación es favorecedor. Un segundo lector señaló que el par elegido para la historia del coste no es el más cercano disponible:
"The closer comparison would be 5.6-Luna. On DeepSWE at Xhigh it's 57% at 1/6 the cost of Sol M, on Max it's 67% at 1/3rd the cost."
Frente a una variante con descuento de GPT-5.6, la brecha de coste y rendimiento se estrecha bastante. Sigue siendo un avance. Mucho menos un cambio de escala.
El "salto" multimodal mide en parte la capacidad de ver. Eso está en la propia nota al pie de DeepSeek. En ApexBench y Agents' Last Exam, la columna de V4-Flash solo de texto se puntuó ignorando los elementos multimodales de la tarea, razón por la que queda en 26,2 y 25,2. Así que comparar 36,5 con 26,2 mide tanto "un modelo ve y el otro no" como cualquier mejora de capacidad. La comparación honesta es la columna de Opus-4.8, donde DeepSeek queda 2,9 por detrás en ApexBench y 0,7 en Chartography, y luego se adelanta por poco en Agents' Last Exam y en ZeroBench.
Un punto más de encuadre, fácil de pasar por alto. Cada cifra de la serie DeepSeek en esa tabla salió de DeepSeek Harness Minimal Mode con top_p=0.95 y temperature=1.0, que es el andamiaje del propio proveedor, el día del lanzamiento. Las tablas de primera mano son útiles, pero no son réplicas. Trátalas como tratarías la tabla de cualquier proveedor, incluidas las de mis propias comparativas de modelos.
La complacencia segura de sí misma es el peor fallo
Este es el resultado de uso real al que sigo volviendo, porque es el único de ese hilo con un conjunto puntuado y un patrón de fallo con nombre.
Un comentarista mantiene un pequeño benchmark de validación de pies de foto: le das al modelo una imagen más un sujeto afirmado y le preguntas si la afirmación es cierta o no. La pregunta es "¿es esto lo que digo que es?", nunca "¿qué es esto?". Lo ejecutó sobre DeepSeek y sobre seed 2.1 turbo de ByteDance:
"Asked "Is this Salisbury Cathedral" and supplied a picture of Wells Cathedral, it answers "Yes, the west facade of Salisbury Cathedral". Bytedance seed 2.1 turbo correctly says no. Similar results for a picture of Manhattan Bridge sent as Brooklyn Bridge, Chartres Cathedral sent as Notre Dame, etc."
La puntuación en su conjunto de 12 imágenes: DeepSeek 6, seed 2.1 turbo 11. La clasificación más amplia sobre ese mismo conjunto puso a Gemini 3.7 Flash arriba, luego seed, luego GPT-5.6-Luna y después dos versiones de Qwen, más o menos el mismo orden al que llega mi comparativa de Qwen frente a V4-Flash también en texto. Él mismo ofrece la salvedad de que es un conjunto minúsculo frente a una suite de benchmarks VLM real, y alguien en el hilo argumentó con razón que un modelo pequeño orientado a programación nunca se entrenó para reconocer monumentos.
Ambas cosas son ciertas. Aun así, lo interesante no es en absoluto la puntuación de monumentos, a mi juicio. Lo interesante es que no dijo "no", dijo "sí, y aquí tienes un detalle seguro que me inventé". La fachada oeste de la catedral de Salisbury es una elaboración específica y de apariencia autorizada pegada al edificio equivocado. Eso no es un problema de resolución, y ningún modo de alta resolución lo arreglaría. Es el modelo dando la razón a la premisa que le entregaron.
Si trabajas en soporte, ya te has topado con este mismo fallo. En una llamada que releí en mis propias notas, un equipo de soporte técnico B2B había visto a un bot responder "sí, soportamos el modelo de tu coche" para marcas que no estaban en absoluto en su base de datos, porque el centro de ayuda decía "soportamos todos los modelos". El bot leía bien y razonaba a partir de la premisa equivocada, y su propia expresión para la fase de configuración fue "trial and error in the beginning". Misma forma, otro ámbito. La complacencia segura de sí misma es más peligrosa que una lectura borrosa errónea, porque una lectura borrosa errónea suele parecer incorrecta y la complacencia segura nunca lo parece. También es la línea entre un agente de verdad y un chatbot con guion, y decide si la desviación de tickets acaba siendo una victoria o una cola de quejas.
Por eso "¿puede el modelo ver la captura?" es la mitad fácil de la pregunta de soporte, y la mitad fácil es la que un lanzamiento de modelo puede responder. La mitad difícil es si la respuesta es correcta. Eso sale de en qué se le permite basarse al agente, y de cómo se comporta en el momento en que no sabe. Un problema de recuperación y de salvaguardas, en otras palabras, no un problema de visión, y es la diferencia entre RAG y una llamada en bruto a un LLM.
El panorama de fiabilidad que nadie captura en pantalla
En 153 comentarios nadie reportó un error de API, un 5xx, un límite de tasa ni una caída, lo cual es buena señal para un endpoint experimental de tres días. Tampoco nadie reportó distribuciones de latencia, y el número interesante vive justo ahí.
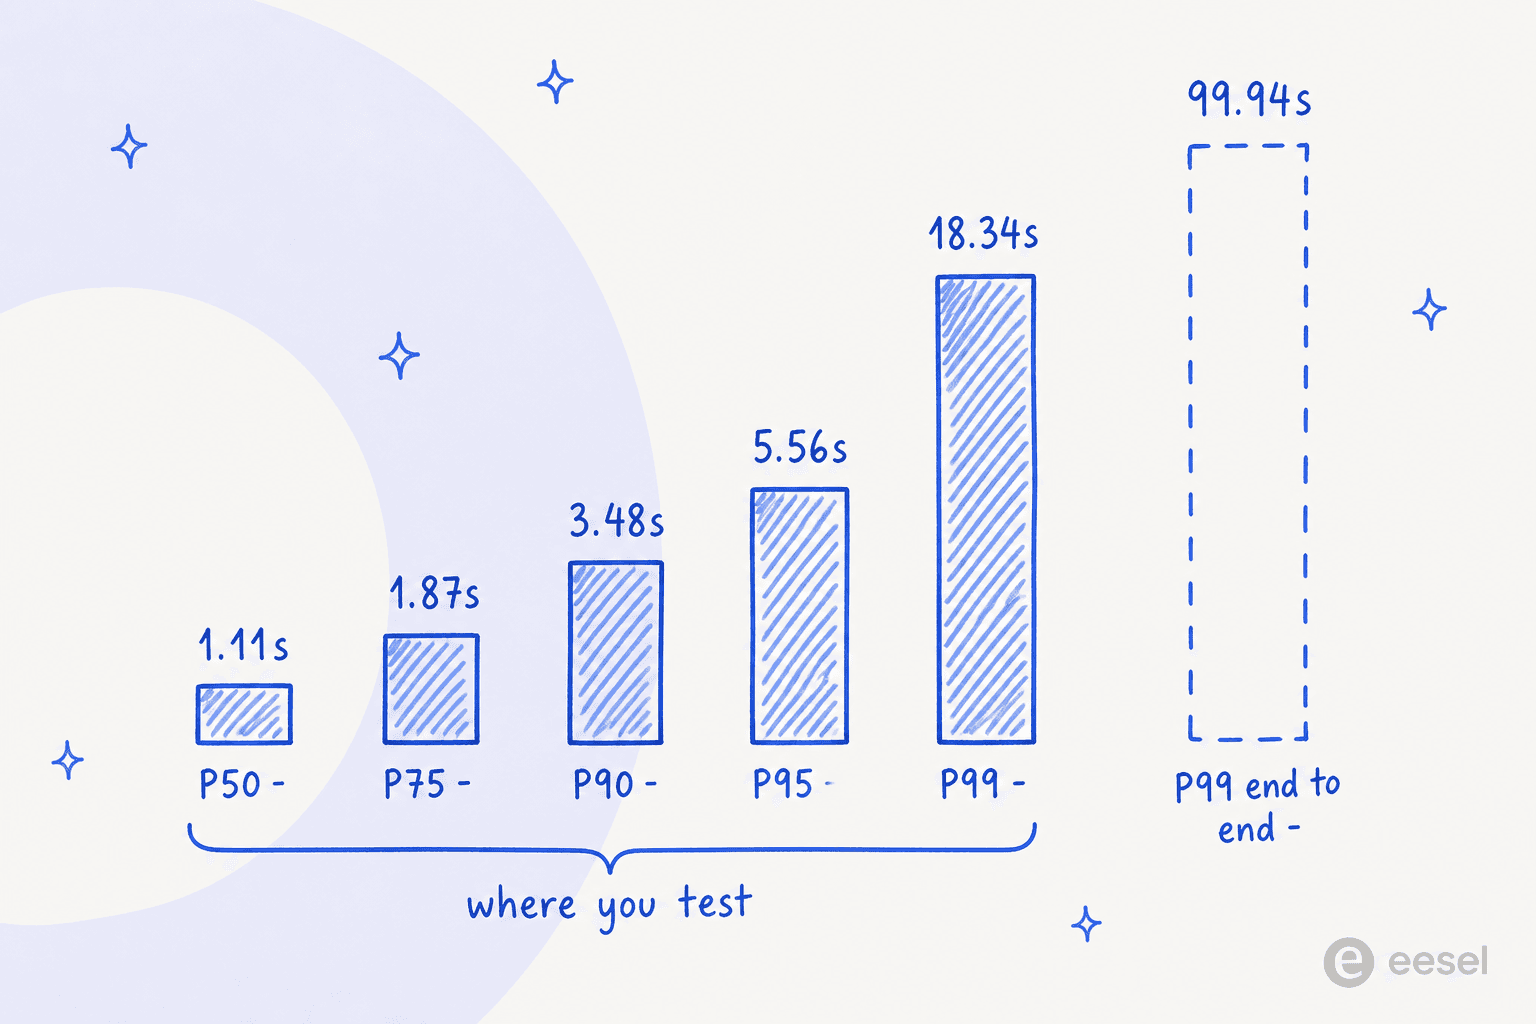
De tres días de tráfico de producción: latencia P50 de 1,11 segundos, rendimiento de 85 tokens por segundo, disponibilidad del 100 %. Es decir, un modelo rápido, y la mediana es excelente para esta franja de precio. La transcripción de un comentarista lo respalda: 368 ms de razonamiento y 4,4 segundos en total para una sola imagen.
Luego mira a la derecha. P90 es 3,48 s, P95 es 5,56 s y P99 es 18,34 segundos. De extremo a extremo, P99 sube a 99,94 segundos. La tasa de error de llamadas a herramientas promedia un 1,27 %, que es competitiva (Gemini 3.7 Flash está en 1,41 % en su mejor endpoint), y la disponibilidad en la misma ventana fue del 99,93 %.
La consecuencia práctica es un presupuesto de timeout, no un benchmark. Si fijas un timeout de cliente de 10 segundos porque tu mediana es de un segundo, perderás aproximadamente una petición de cada cien. En un bucle de agente que ejecuta doce llamadas a herramientas por tarea, una de cada cien por llamada se convierte en algo más parecido a una tarea de cada nueve. Tampoco hay conmutación por error: un único proveedor sirve este modelo, así que en el momento en que se ralentiza, un enrutador no tiene adónde enviar la petición. Si has montado cualquier tipo de automatización de primera respuesta, la cola es lo que viven tus clientes, no la mediana.
Quién está llamando realmente a este modelo
Este es el hallazgo que no esperaba en absoluto, y el que movió mi veredicto.
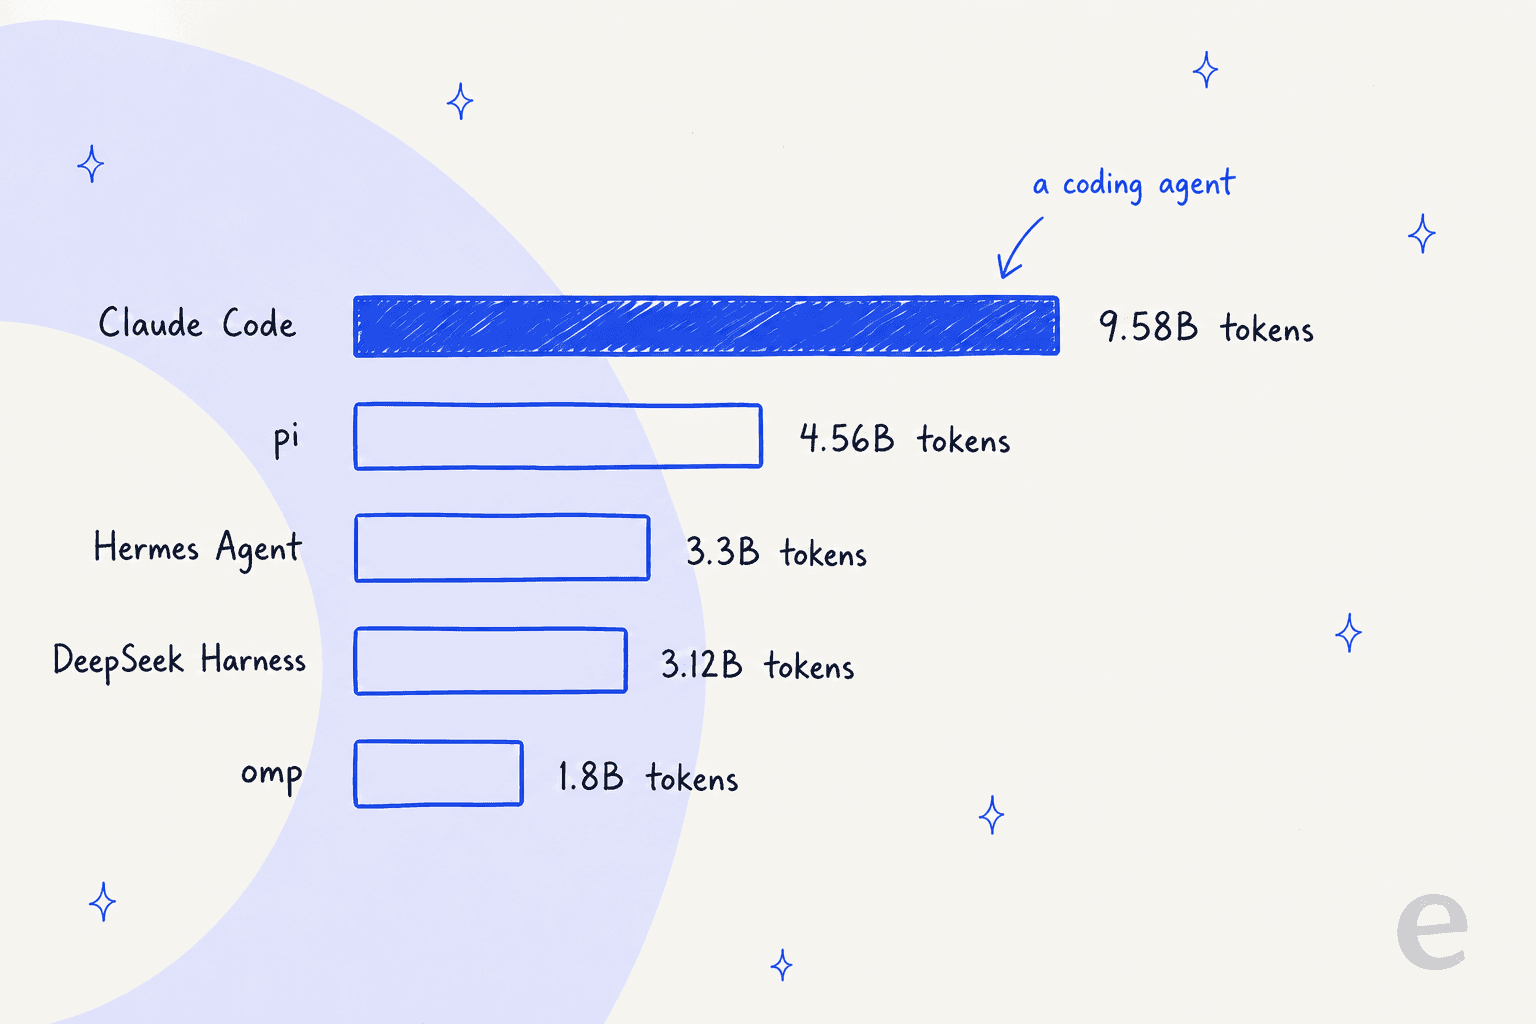
Las apps públicas que más tráfico enviaron a deepseek-v4-flash-vision-exp en sus primeros días, por orden: Claude Code con 9.580 M de tokens, pi con 4.560 M, Hermes Agent con 3.300 M, el propio arnés puente multimodal de DeepSeek con 3.120 M y omp con 1.800 M. El mayor consumidor individual del primer modelo de visión de DeepSeek es una herramienta de programación. De ese top cinco, solo una entrada trata explícitamente de imágenes.
La mezcla de tokens cuenta la misma historia desde otro ángulo. En esos primeros días: 25.000 M de tokens de prompt, 69,6 M de tokens de completion y 139 M de tokens de razonamiento. La relación prompt a completion ronda 359 a 1, que es la firma de un agente que mete grandes bases de código y salidas de herramientas en una ventana de contexto, y no la de una carga de subtitulado de imágenes. También señala una trampa de costes que conviene conocer. El razonamiento va a más o menos el doble de la completion, el modo de razonamiento está activado por defecto y el razonamiento se factura a la tarifa de salida. Así que si tu modelo de costes trata la salida como la longitud de la respuesta, se queda corto en algo así como 3 veces, la misma trampa que recorre el desglose de precios de V4-Flash.
Alguien en el hilo hizo la pregunta de seguimiento obvia, y creo que es la correcta:
"I've been using v4-flash without vision for this months — it's my go-to for code tasks. Now with vision, I'm wondering: if this model can do everything the text-only version does (plus see images), why keep the text-only one around?"
Nadie le dio una respuesta clara, y con la evidencia publicada no hay ninguna que dar, aparte de las dos funciones ausentes de abajo y esa palabra exp en el nombre.
Dos cosas que faltan en silencio
Ambas aparecen solo en la tabla de especificaciones, y ambas importan más que el marketing.
La compleción FIM ha desaparecido. La página de precios lista la compleción Fill-in-the-Middle como disponible en modo sin razonamiento tanto para deepseek-v4-flash como para deepseek-v4-pro, y luego como "Not supported" para la versión con visión. Si usas FIM para completar código en línea, este modelo no sustituye directamente al modelo del que deriva, por buena que parezca esa fila de DeepSWE.
No hay marca de fecha. El campo MODEL VERSION dice DeepSeek-V4-Flash-Vision-Exp, mientras que los hermanos dicen DeepSeek-V4-Flash-0731 y DeepSeek-V4-Pro-0813. No se puede fijar la compilación. Con todo lo dicho arriba sobre la varianza entre ejecuciones, eso se convierte en un problema real de evaluación: el modelo que evaluaste el lunes no tiene garantizado ser el modelo que atiende tu tráfico el viernes, y no hay una cadena de versión a mano que demuestre lo contrario. En un endpoint experimental es defendible. En cualquier cosa que pongas frente a clientes, no.
Hay una tercera carencia que conviene reportar con cuidado, porque el hilo se corrigió a sí mismo al respecto. Un comentarista dijo que las imágenes no podían volver como resultados de llamadas a herramientas, lo que sería una limitación seria para cualquier bucle de agente de verificación de capturas. Otro lo corrigió: la restricción se aplica a Chat Completions, mientras que la Responses API y el endpoint Messages compatible con Anthropic sí aceptan imágenes en la salida de herramientas. El comentarista original citó entonces la documentación confirmando que input_image dentro de function_call_output se procesa como una imagen real para este modelo. Así que la capacidad está ahí, en dos superficies de tres. Si construyes sobre Chat Completions, para ti eso es una reescritura.
Siguiendo con las reescrituras, una restricción más que afectará a un agente existente: las imágenes solo se aceptan en mensajes user. Pon una en un mensaje system o assistant y recibirás un 400. Muchos bucles de agente guardan la salida de herramientas en un turno de assistant, y esos bucles hay que cambiarlos primero, antes de que pase una sola imagen. Quien haya migrado entre el manejo de archivos de OpenAI y el de otro proveedor sabe cómo se acumulan estas pequeñas diferencias de forma.
Cómo se compara con los otros modelos de visión
Tarifa y rendimiento medido real, todo de la misma fuente para que las columnas sigan siendo comparables. Una salvedad: la ventana de DeepSeek es de tres días, porque el modelo tiene tres días, mientras que las demás son ventanas de una semana. Para el cara a cara en texto en lugar de imágenes, consulta V4-Flash frente a Kimi K3.
| Modelo | Entrada /M | Salida /M | Lectura de caché /M | Mejor latencia P50 | Mejor rendimiento | Disponibilidad | ¿Control de resolución? |
|---|---|---|---|---|---|---|---|
| DeepSeek V4 Flash Vision Exp | $0.22 | $0.66 | $0.007 | 1.11s | 85 tps | 100.00% | Sin modo de alta resolución |
| Gemini 3.7 Flash | $1.50 | $7.50 | $0.15 | 1.70s | 197 tps | 99.74% | Sí, resolución de medios |
| Qwen3.8-Max | $2.00 | $6.00 | $0.25 | 1.83s | 45 tps | 100.00% | No documentado |
| GPT-5.6 | $4.00 | $20.00 | $0.40 | 3.55s | 45 tps | 98.50% | Sí, niveles de detalle |
En precio no hay color. DeepSeek es aproximadamente 6,8 veces más barato en entrada listada que Gemini 3.7 Flash y 18 veces más barato que GPT-5.6, y además tiene la latencia mediana más baja de los cuatro. Dos asteriscos honestos. Gemini lleva ahora descuentos promocionales en OpenRouter (75 % vía Vertex, 50 % vía AI Studio) que cierran temporalmente buena parte de esa brecha, y el mismo probador cuyo benchmark de pies de foto puso a Gemini primero señaló que solo entró en su lista corta por el descuento.
La economía de la caché merece también una línea, porque cambia el panorama más que el precio de lista. La tasa de acierto de caché observada en DeepSeek es del 88,9 %, y eso baja el precio efectivo de entrada a 0,03073 $ por millón frente a los 0,22 $ listados. La salida apenas se mueve, 0,6595 $ efectivos frente a 0,66 $ listados. Así que tu factura aquí es una factura de salida con un error de redondeo añadido, y cualquier comparación que alinee precios de entrada listados está comparando la columna equivocada. Si estás calculando lo que de verdad te cuesta una carga de trabajo de IA, mis notas sobre el coste por resolución son un marco más útil que cualquier tarifa por millón. La comparación con agentes humanos es la otra mitad de la misma suma.
Mi veredicto
Úsalo si tu carga de trabajo son agentes de texto, programación o uso de herramientas, y hoy estás en DeepSeek V4 Flash. Seis de siete filas del benchmark apuntan en una dirección y el perfil real de tráfico apunta en la misma, el precio es idéntico y cambiar la cadena del modelo es toda la migración. Mi reseña de V4-Flash es la línea base con la que se mide esto. Revisa tu uso de FIM antes que nada.
Úsalo si tu trabajo con imágenes es estructural: revisiones de diseño, formas de gráficos, verificación de interfaz, triaje de capturas, de diseño a código. A unos 0,00008 $ por imagen en horario valle, el coste de mirar se redondea a nada, y 0,64 MP sobra para "¿se renderizó bien esto?". La misma lógica lo hace barato para la clasificación de tickets masiva sobre adjuntos.
Construye una herramienta de recorte si lo que necesitas es detalle fino. El patrón está probado y varias personas ya lo ejecutan en producción, y lo que te cuesta son tokens y complejidad de arnés, no precisión. Un intercambio razonable a este precio.
Busca en otra parte si el detalle fino es el trabajo, y sobre todo cuando necesitas que el modelo contradiga una afirmación en lugar de confirmarla. Texto pequeño, OCR de documentos a escala de página completa, validación de pies de foto: todo eso se sirve mejor con algo que exponga un control de resolución. La línea Flash de Gemini es la comparación obvia aquí. Mi resumen de alternativas a V4-Flash cubre el resto de la franja. Y si los pesos abiertos te importan, ten en cuenta que varias personas en el hilo esperan un lanzamiento, pero nadie ha confirmado ninguno, así que no hagas planes sobre eso.
Espera si la reproducibilidad es un requisito para ti. Sin marca de fecha, más una varianza real entre ejecuciones, es una mala combinación para cualquier cosa que tengas que certificar. El exp del nombre hace ahí un trabajo honesto.
La lectura más amplia, para quien elige modelos en lugar de reseñarlos: este lanzamiento es mejor argumento a favor de la línea de texto de DeepSeek que de la de visión. Ponlo frente a V4 Pro, luego frente a Kimi K3 y frente a dónde estaba V3.2 hace un año, y la curva de precio y rendimiento en agentes de texto sigue curvándose en la misma dirección. La parte de visión es un extra competente y barato que es borroso a propósito.
eesel para colas de soporte donde la respuesta tiene que ser correcta
Si llegaste aquí porque tu cola está llena de capturas de clientes, te seré directo sobre lo que resuelve un lanzamiento de modelo y lo que no.
Los clientes envían capturas porque algo pequeño y concreto ha salido mal. Un diálogo de error. Una línea de una factura o un campo que no se guarda. Es la entrada de más valor en soporte y el peor encaje posible para un techo de resolución, ya que el texto pequeño es la información. Y aun cuando el modelo lo lea a la perfección, el problema más difícil sigue esperando, que es el problema de la catedral de Salisbury: una respuesta fluida y segura de sí misma construida sobre la premisa equivocada, enviada a un cliente real bajo tu propia marca.

La respuesta de eesel a eso es hacer que mires las respuestas equivocadas antes que tus clientes. Conectas tu helpdesk y tu contenido de ayuda y, antes de que nada salga en vivo, reproduces el agente sobre tus propios tickets históricos. Así ves exactamente cuáles habría gestionado, cuáles habría estropeado y las palabras que habría usado. Tú decides qué se le permite responder por sí solo y qué va directamente a una persona, y cada acción queda visible y reversible en el registro de arriba. Empieza con él como un copiloto de IA que redacta para tus agentes, si entregarle la cola desde el primer día te parece demasiado. Es lo contrario de accionar un interruptor y leer la autopsia después.
Esa es la pieza que un modelo de visión barato no te da, y es también la pieza que decide si la IA en tu cola ahorra dinero o cuesta confianza. Si quieres verlo funcionar sobre tus propios tickets, prueba eesel gratis.
Si aún estás en la fase de preselección, empieza por mis notas prácticas sobre cómo elegir un modelo para soporte. Después, qué LLM encaja con el trabajo de soporte es una buena lectura, y lo que de verdad hace día a día un agente de helpdesk con IA es la otra que merece la pena.