

DeepSeek ha lanzado un modelo que puede ver. 21 de agosto de 2026. deepseek-v4-flash-vision-exp cuesta exactamente lo mismo que V4-Flash normal, la ventana de contexto de 1M se mantiene y las imágenes se facturan como tokens de entrada corrientes.
Sin embargo, el anuncio entierra lo interesante. La propia DeepSeek dice que la versión de visión "matches" V4-Flash en texto. Su propia tabla de pruebas dice más: la variante de visión supera al modelo solo de texto en seis de siete pruebas de agentes de texto. Casi cinco puntos en DeepSWE. Cinco y medio en Toolathlon-Verified. Así que la pregunta que vale la pena hacer no va de imágenes en absoluto, sino de si pasas tu tráfico de texto a una versión experimental.
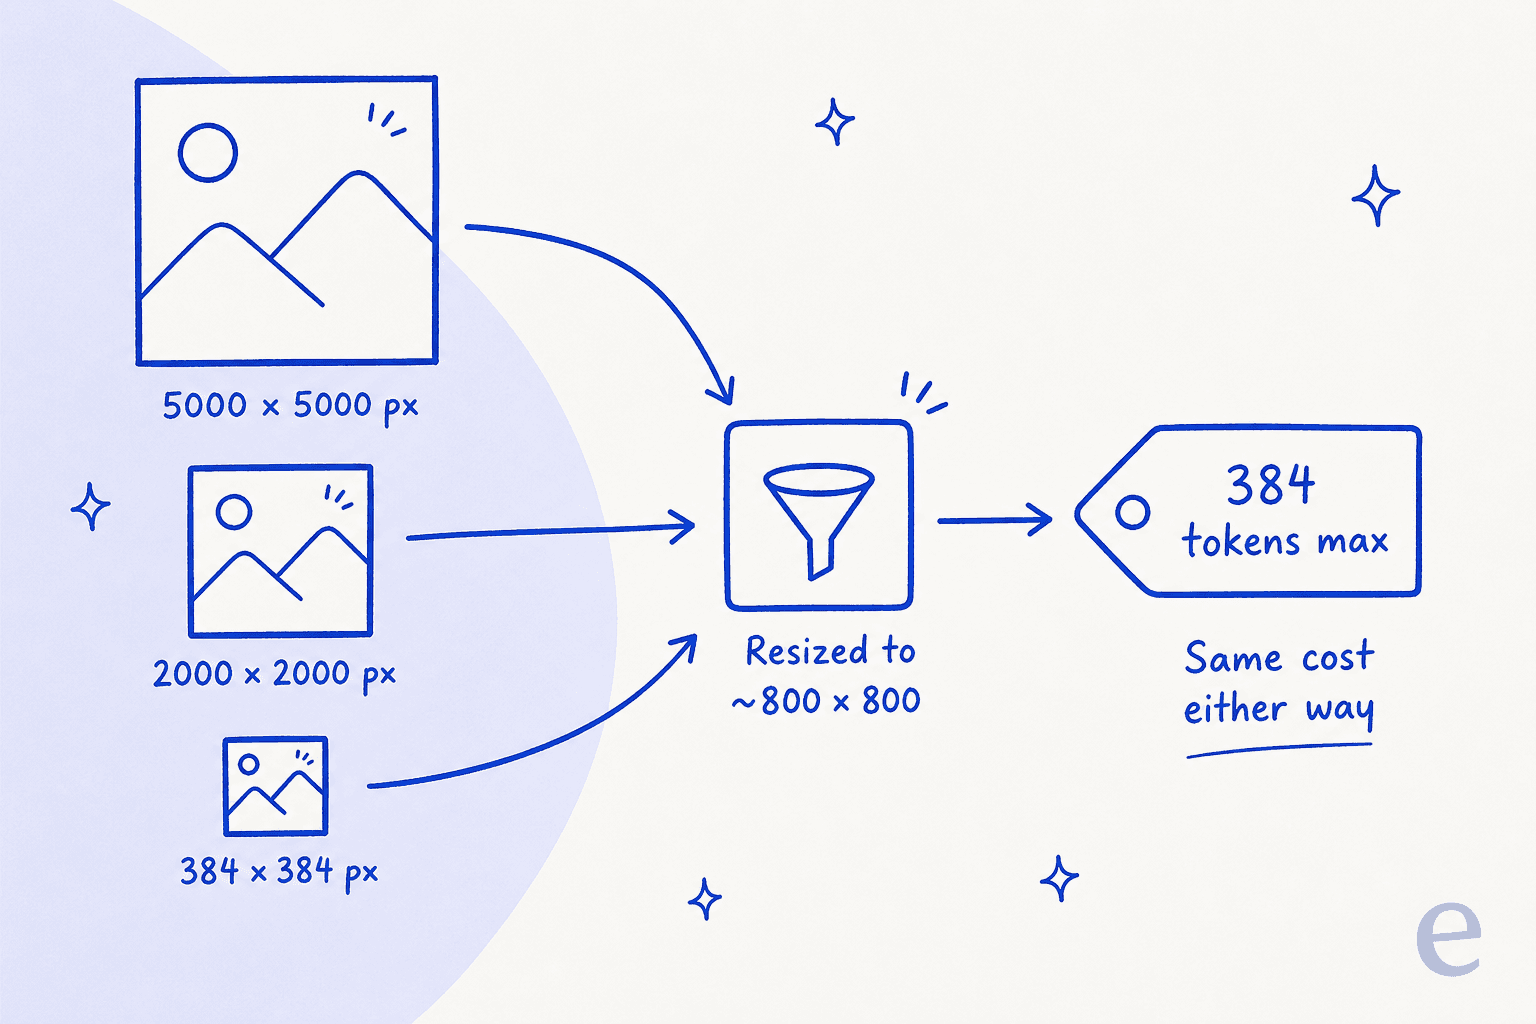
Luego, la trampa. Cada imagen se comprime a unos 800 por 800 píxeles antes de que el modelo la mire, con un tope de 384 tokens. Una captura de 5000 píxeles y una miniatura cuestan lo mismo, porque tras el redimensionado son lo mismo. Lo que significa que el precio plano no es generosidad. Es el techo de resolución, escrito como una tarifa.
En eesel me encargo de las integraciones y de la parte de API, y leo las notas de versión como se lee un diff: qué cambió, qué no cambió en silencio, qué me va a despertar a las 2 de la madrugada. Aquí las líneas interesantes son dos funciones que desaparecieron discretamente. La completación FIM se ha ido y la cadena del modelo no tiene fecha de compilación, así que lo que probaste el lunes no tiene por qué ser lo que sirve tráfico el viernes.
Y si vas a apuntar todo esto a una cola de soporte, ten claro qué resuelve. Leer la captura de un cliente es la mitad fácil. La mitad difícil es saber que la respuesta es correcta antes de que llegue a ese cliente, que es un problema de fundamentación y de pruebas, no de un modelo más grande. Esa es toda la razón por la que eesel reproduce un agente sobre tus tickets pasados reales antes de que responda uno en vivo.
Qué ha lanzado realmente DeepSeek
El lanzamiento son tres cosas a la vez, y solo una de ellas salió en los titulares.
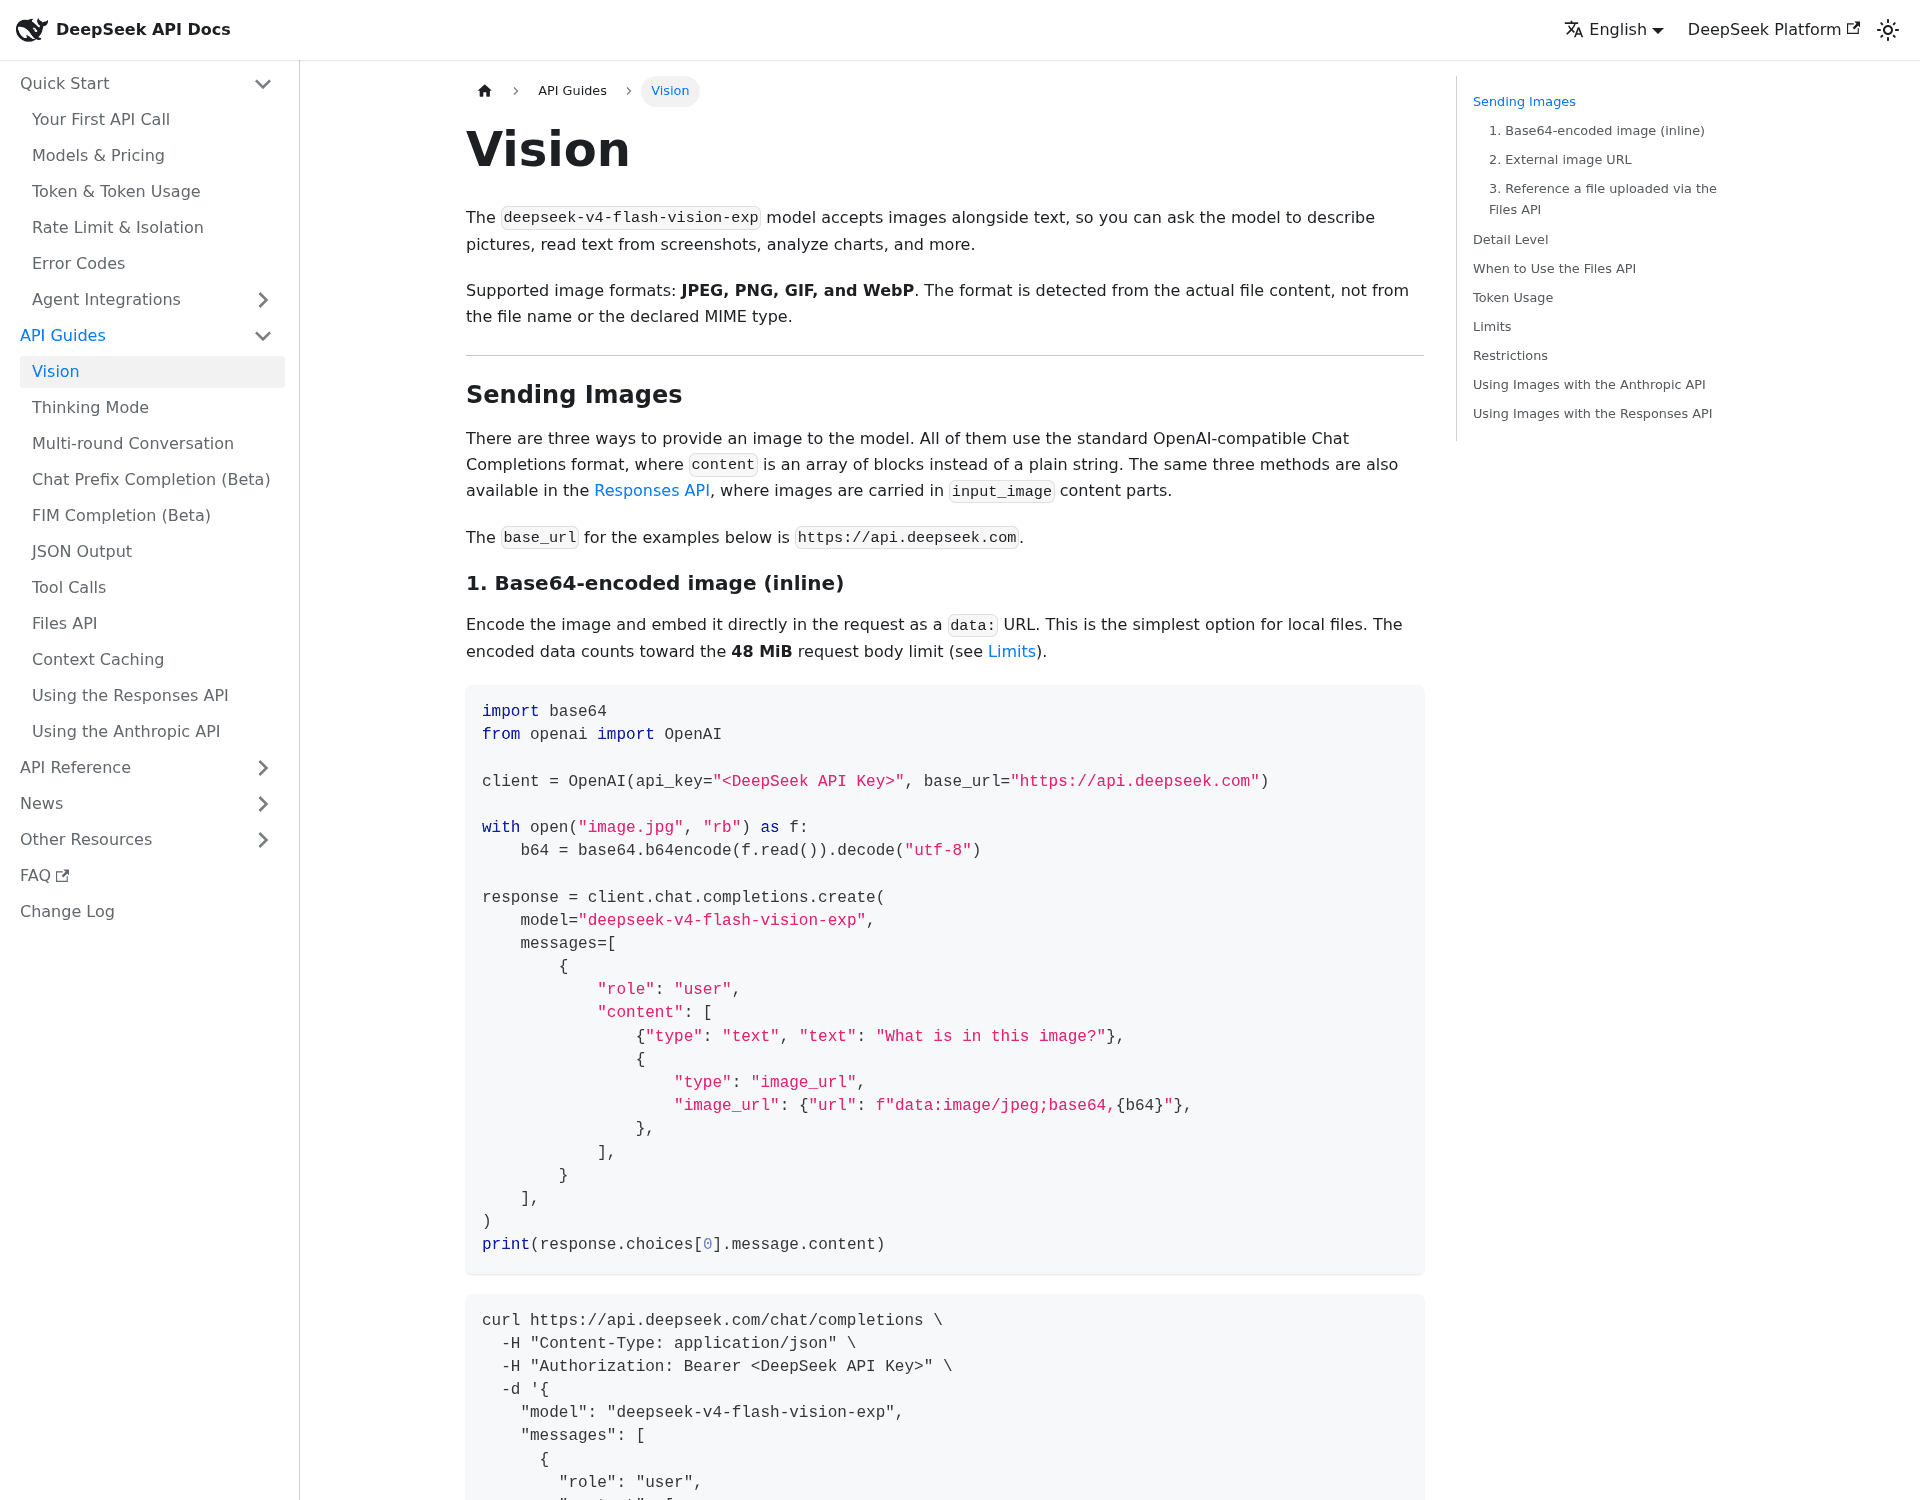
Un modelo de visión. deepseek-v4-flash-vision-exp acepta imágenes en la misma solicitud que tu texto, mediante Chat Completions, el endpoint /messages compatible con Anthropic o la API Responses. Los formatos admitidos son JPEG, PNG, GIF y WebP, y según la guía de visión el formato se detecta por el contenido del archivo, no por el nombre ni por el tipo MIME declarado.
Una API de archivos gratuita. Subes una imagen una vez y luego la referencias por file_id en distintas solicitudes. También sube el límite por imagen de 32 MiB a 64 MiB, lo que importa más de lo que parece.
Una versión del harness. DeepSeek Harness 0.1.1 salió el mismo día, con la compatibilidad ya incorporada.
En arquitectura no cambia nada respecto al modelo del que bifurca: una mezcla de expertos dispersa con 13B parámetros activos de 284B en total, según la página del modelo en OpenRouter. El contexto sigue en 1M de tokens, la salida máxima en 384K y la concurrencia en 2.500. Si ya construiste sobre DeepSeek V4 Flash, cambiar la cadena del modelo es toda la migración.
Un detalle que parece una nota al pie pero no lo es: las imágenes solo se aceptan en mensajes user. Si pones una en un mensaje system o assistant, recibes un 400. Si tu bucle de agente mete la salida de herramientas en un turno de asistente, eso es una reescritura para ti, no un cambio de configuración.
El tope de 384 tokens es todo el diseño
Esta es la parte que conviene entender antes de planificar nada en torno al modelo.
Antes de la inferencia, DeepSeek redimensiona cada imagen que entra. Todo lo que mide menos de unos 384 por 384 píxeles se amplía, conservando la proporción. Todo lo mayor se reduce, conservando de nuevo la proporción, hasta que el total de píxeles queda más o menos en el de una imagen de 800 por 800. El resultado es un techo duro de 384 tokens por imagen, y la documentación explica la consecuencia sin rodeos: una imagen de 2000 por 2000 y una de 5000 por 5000 consumen el mismo número de tokens.
Así que las imágenes salen casi gratis. A la tarifa fuera de hora punta de $0,22 por millón de tokens de entrada, 384 tokens cuestan unos $0,00008. Un comentarista de Hacker News hizo la cuenta y llegó más o menos al mismo sitio:
"400 tokens per image results in 2,500 images per dollar, if I'm not mistaken."

Tenía razón, y el número merece un segundo de reflexión. A esa tarifa, el coste de mirar se redondea a nada dentro de casi cualquier presupuesto de agente.
Pero aquí el precio y la resolución son una sola decisión, no dos. Es barato porque mira con menos detalle. La reacción más afilada de todo ese hilo ocupó cuatro palabras:
"Oof 800 by 800 kills a lot of use cases"
Es justo, y el hilo pasó luego mucho rato discutiendo cuánto importa de verdad. El apaño en el que se pusieron de acuerdo es una herramienta de recorte y zoom: le das al modelo la capacidad de pedir una subregión de una imagen de alta resolución, de modo que lee un recorte de 600 por 600 con el detalle nativo en lugar de toda la imagen borrosa. Varias personas dijeron que les funcionaba bien. Otras señalaron el límite obvio: recomponer nueve recortes en una sola comprensión espacial es un problema difícil por sí mismo, y contar cosas o seguir relaciones en un esquema es justo donde se rompe.
Ambos bandos tienen razón, solo que para cargas de trabajo distintas. Comprobar si un botón se renderizó en el sitio correcto sobrevive de sobra a una reducción a 800 por 800. Leer texto de 8 pt en un recibo, no.
También hay un parámetro detail, que vale la pena conocer sobre todo por lo que no hace. low reduce a 512 por 512 para ganar velocidad. high, original y auto significan hoy todos lo mismo: conservar el original y aplicar igualmente el redimensionado estándar. No existe un modo de alta resolución al que recurrir.
La tabla de pruebas dice más que el anuncio
La nota de versión de DeepSeek describe la parte de texto del modelo de visión con una palabra: "matches" V4-Flash. La tabla que publicaron junto a ella no dice exactamente eso.
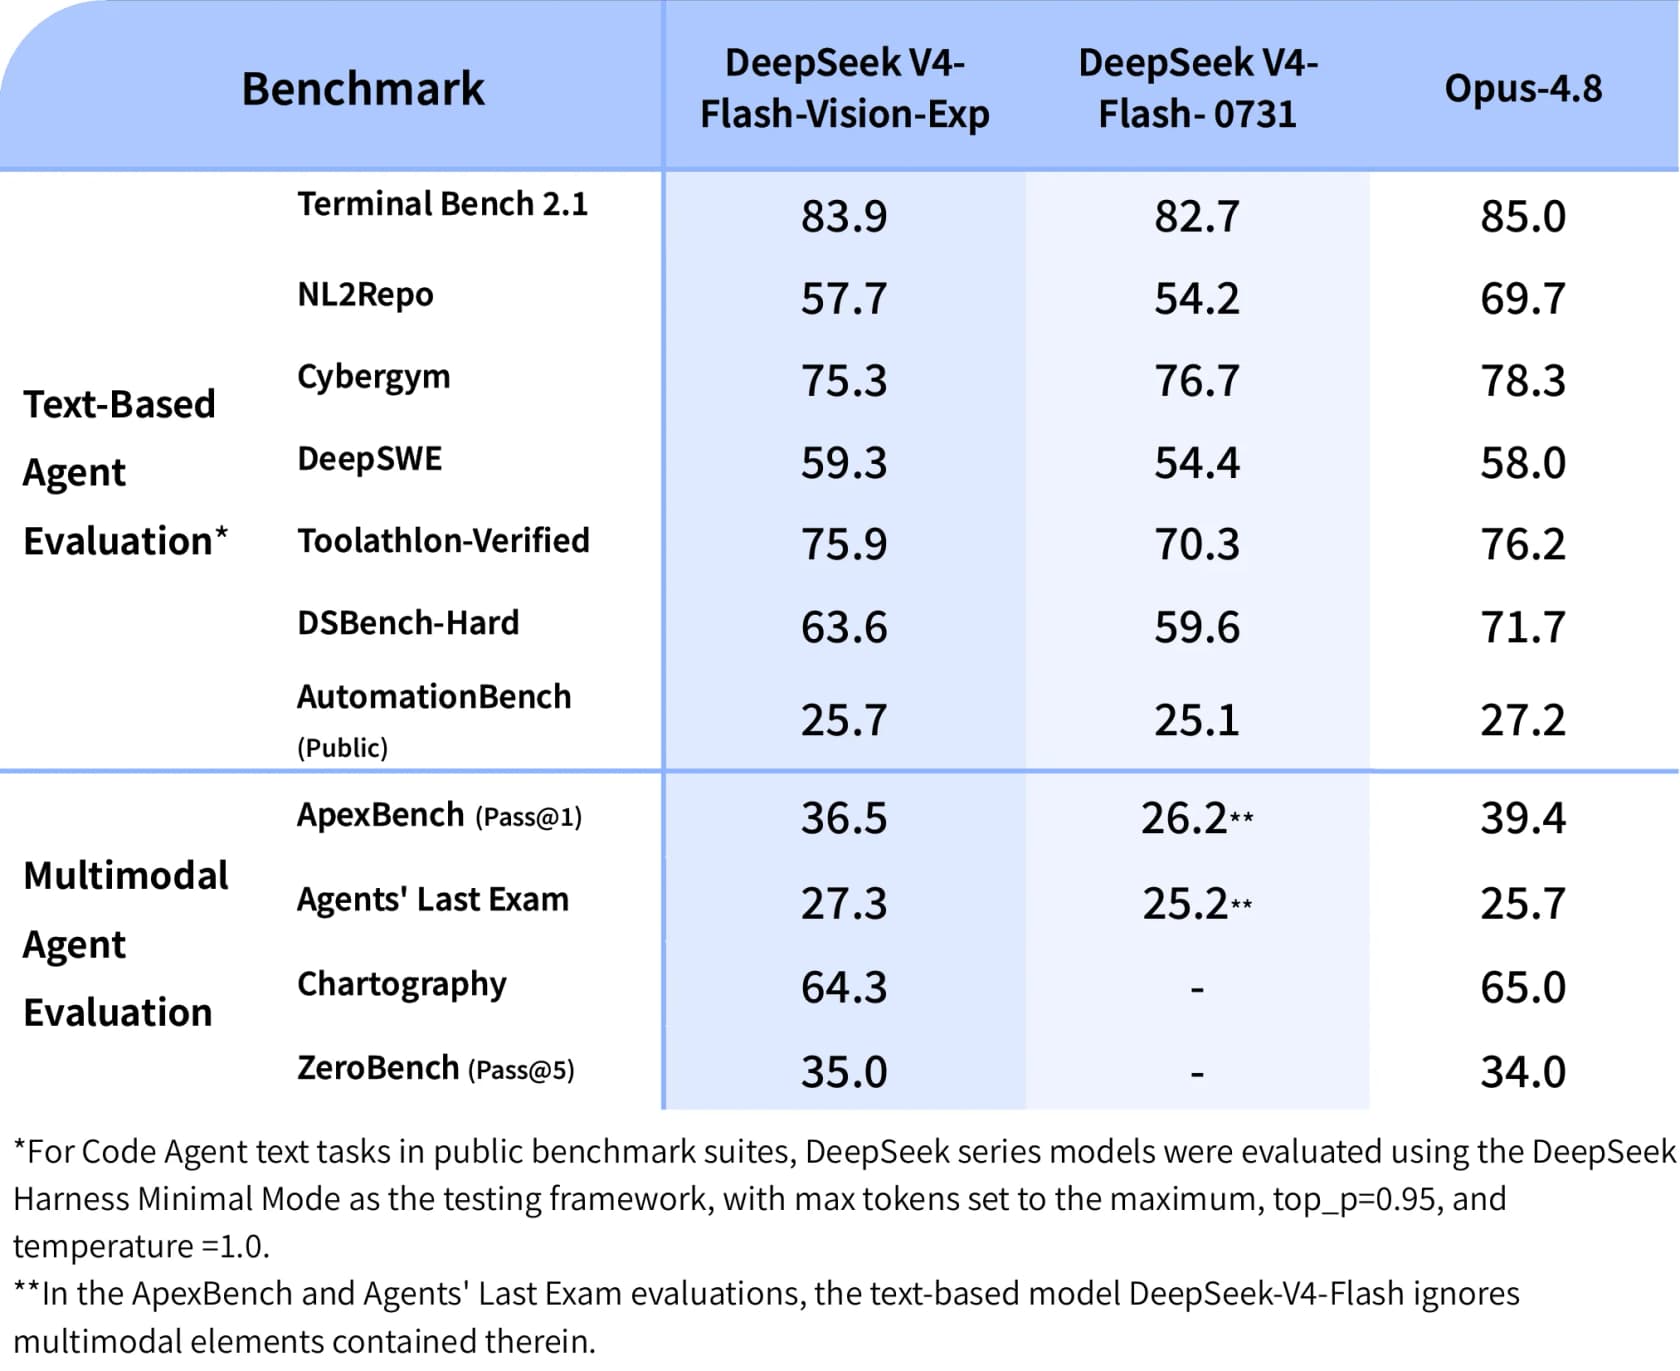
Si alineas las filas de agentes basadas en texto, la versión de visión se lleva seis de siete:
| Prueba de agente de texto | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
DeepSWE se mueve 4,9 puntos y Toolathlon-Verified 5,6. No son errores de redondeo. En DeepSWE, la variante de visión también supera a Opus-4.8, 59,3 frente a 58,0. "Matches on text" se queda corto frente a lo que midió el propio harness de DeepSeek, y si eliges un modelo de código o de uso de herramientas a partir de estas filas, la versión de visión es la mejor opción aunque nunca le envíes una sola imagen.
Ahora la mitad multimodal, donde el planteamiento merece una segunda mirada:
| Prueba multimodal | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | – | 65.0 |
| ZeroBench (Pass@5) | 35.0 | – | 34.0 |
*Nota al pie de la propia DeepSeek: en ApexBench y Agents' Last Exam, el V4-Flash basado en texto ignora los elementos multimodales de la tarea.
Esa nota al pie hace mucho trabajo. El "gran salto sobre V4-Flash" en las pruebas multimodales de agentes en parte solo mide que un modelo puede ver y el otro no, lo cual es cierto, pero no es lo mismo que una mejora de capacidad. La comparación honesta está en la columna de Opus-4.8, y ahí el panorama es ajustado: DeepSeek queda 2,9 por detrás en ApexBench y 0,7 en Chartography, y luego se adelanta por poco en Agents' Last Exam y en ZeroBench. "Cerca de Opus-4.8" es una afirmación razonable, y para un modelo a una fracción de los precios de la API de Anthropic ese es en realidad el titular.
Dos salvedades para leerlo bien. Todas las cifras de la serie DeepSeek salen del Minimal Mode de DeepSeek Harness con top_p=0.95 y temperature=1.0, que es el andamiaje del propio proveedor. Además, son cifras del día de lanzamiento del proveedor y no una réplica independiente. Trátalas como tratarías cualquier tabla de primera mano, incluidas las nuestras.
Cuánto cuesta realmente
La tarifa es idéntica a la de V4-Flash normal, que probablemente sea el dato más útil de todo el lanzamiento. Fuera de hora punta, por millón de tokens: $0,007 con acierto de caché, $0,22 con fallo de caché y $0,66 de salida. En hora punta, las tres se duplican. La hora punta va de 01:00 a 04:00 y de 06:00 a 10:00 UTC, de lunes a viernes, lo que significa que una carga de EE. UU. o de la UE se factura sobre todo a la tarifa barata por pura casualidad geográfica.
El precio de lista tampoco es lo que la mayoría paga en realidad. La propia telemetría de OpenRouter sitúa el precio de entrada efectivo en $0,03073 por millón frente a $0,22 de lista, porque la tasa de aciertos de caché observada ronda el 88,9 %. La salida apenas se mueve, $0,6595 efectivos frente a los $0,66 de lista. Así que, en cuanto a adónde va el dinero, la caché hace casi todo el trabajo en la entrada y nada en la salida, lo que convierte tu factura en una factura de tokens de salida con un error de redondeo pegado.
Prueba con tus propios números:
Pasa por ahí un agente realista guiado por capturas y la forma se mantiene: las imágenes apenas se notan, la factura son tokens de salida. Lo que lleva a un número que conviene señalar. En sus tres primeros días en OpenRouter, el modelo quemó 25B de tokens de prompt, 69,6M de tokens de completación y 139M de tokens de razonamiento, de modo que el razonamiento va aproximadamente al doble que la completación. El modo de razonamiento está activado por defecto y los tokens de razonamiento se facturan a la tarifa de salida. Así que si tu modelo de costes trata la salida como "la longitud de la respuesta", falla por algo así como 3x. La misma trampa aparece en nuestro desglose de los precios de DeepSeek V4 Flash, y explica buena parte de por qué comparar tarifas en bruto entre proveedores engaña tanto. Quien haya comparado los precios de la API de OpenAI con una herramienta de soporte que cobra por resolución ha vivido el mismo problema desde el otro lado.
Los límites que realmente te van a afectar
La mayoría son generosos. Dos no.
| Límite | Valor |
|---|---|
| Formatos admitidos | JPEG, PNG, GIF, WebP |
| Máx. de imágenes por solicitud | 600 |
| Tamaño del cuerpo de la solicitud | 48 MiB |
| Máx. por imagen (base64 / URL) | 32 MiB |
| Máx. por imagen (API de archivos) | 64 MiB |
| Máx. tamaño total de imágenes por solicitud | 64 MiB, o 200 MiB usando file_id |
| Dimensión máx. de imagen | 8192 px por lado |
| Dimensión máx. con 15+ imágenes | 4096 px por lado |
| Longitud de URL externa | 8192 caracteres |
| Tiempo límite de descarga de imagen externa | 60 segundos |
Seiscientas imágenes en una sola solicitud es mucho margen. Pero fíjate en cómo la regla de dimensión se reduce a la mitad en silencio cuando una solicitud lleva quince o más imágenes, que es justo la forma de un trabajo de procesamiento de documentos por lotes. Y esa ventana de descarga de 60 segundos en URL externas es de esas cosas que funcionan perfectamente en las pruebas y luego empiezan a dar fallos intermitentes la primera vez que las apuntas a un CDN lento de un cliente. Si las imágenes importan para tu pipeline, la API de archivos es la opción por defecto más segura y no la optimización que dejas para más adelante.
A qué renuncias
Dos cosas, y ninguna está en la lista de puntos del anuncio.
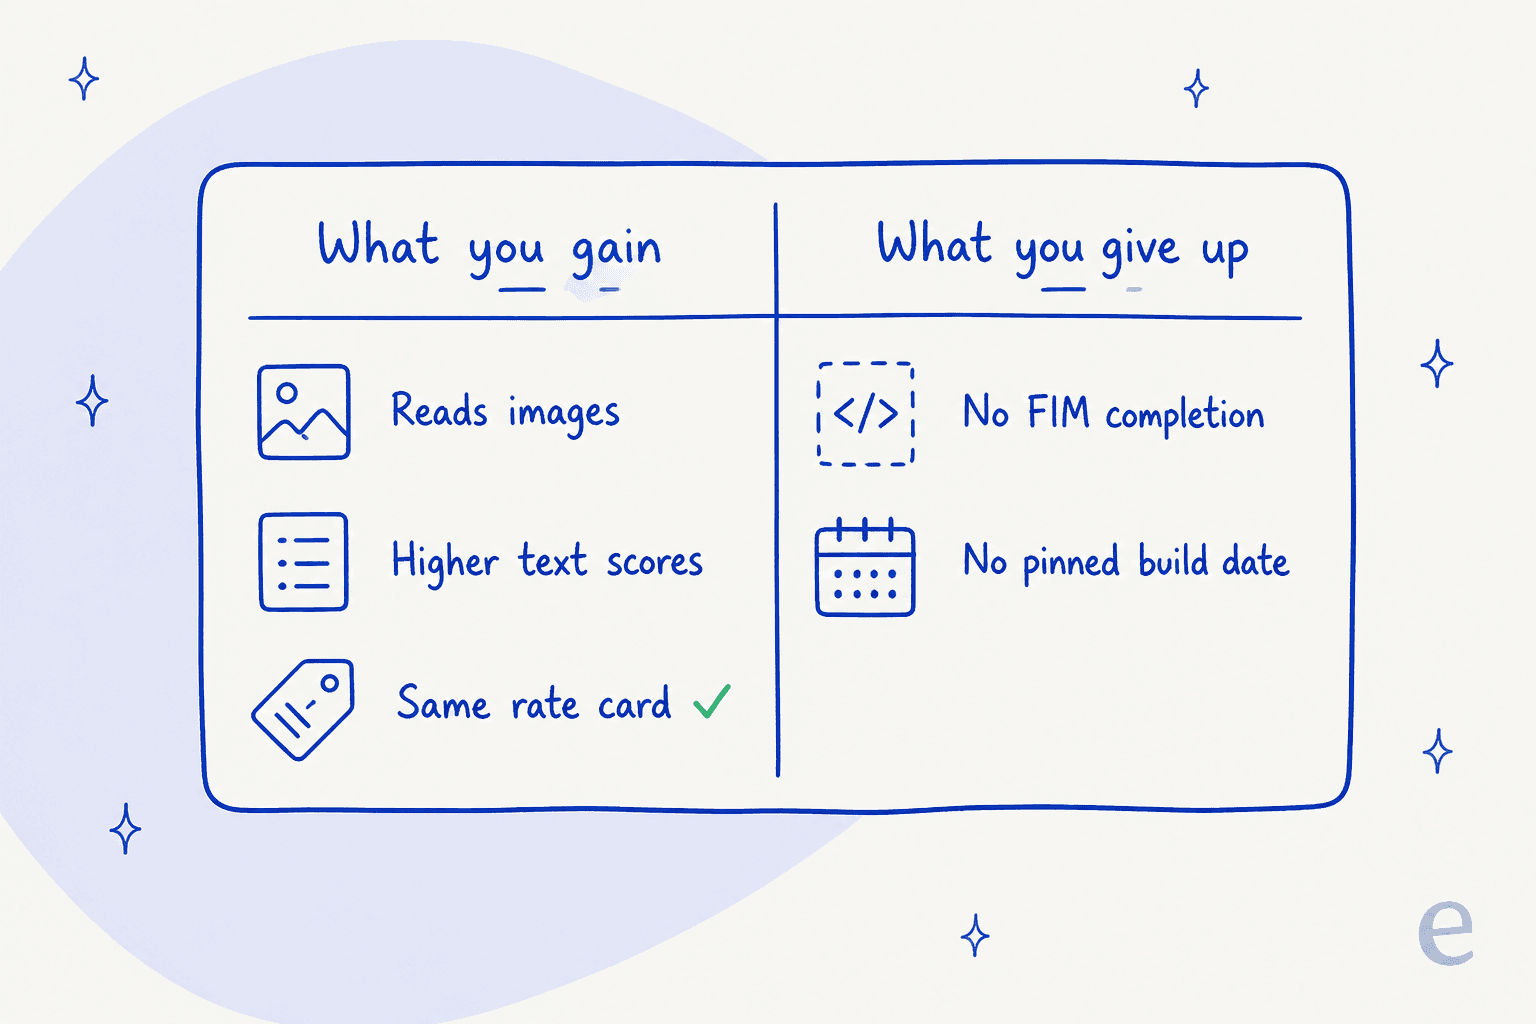
No admite la completación FIM. V4-Flash normal y V4-Pro ofrecen ambos fill-in-the-middle en modo sin razonamiento, mientras que la página de precios lo marca como "Not supported" para la versión de visión. Así que si usas FIM para completar código en línea, este modelo no puede ser un sustituto directo para ti, y ese es el único bloqueo duro del lanzamiento.
No hay fecha de compilación. Esto es más sutil, y es la razón por la que yo todavía no pasaría tráfico de producción. Fíjate en cómo nombra sus versiones la tarifa: Flash normal es DeepSeek-V4-Flash-0731, Pro es DeepSeek-V4-Pro-0813, y la versión de visión es simplemente DeepSeek-V4-Flash-Vision-Exp. Una compilación fechada es una compilación sobre la que se puede razonar. Una etiqueta exp sin sello es un blanco móvil, y un comentarista de Hacker News leyó la hoja de ruta del mismo modo:
"most likely a preview. they often release the preview via API, get more training data, post train some more then release the weight. i would expect to see it perform better in a few weeks or a month."
Si eso es cierto, las cifras de este artículo tienen fecha de caducidad, y también cualquier evaluación que ejecutes esta semana. Es un coste normal de usar endpoints experimentales. Solo se convierte en problema si olvidas que lo aceptaste.
Qué muestran las primeras 72 horas de tráfico real
Las pruebas del proveedor son una cosa. Esto es lo que midió la propia capa de enrutamiento, según OpenRouter, durante los tres primeros días del modelo.
- 85 tokens/segundo de rendimiento P50, con una latencia P50 de 1,11 segundos.
- 1,27 % de tasa de error en llamadas a herramientas. Para un modelo cuyo argumento entero es el trabajo multimodal de agentes, este es el número que miraría primero, y está bien.
- 100 % de disponibilidad de servicio, 99,93 % de disponibilidad, con un solo proveedor. DeepSeek lo sirve directamente, así que no hay conmutación por error a la que redirigir.
- 90,4 % de tasa de aciertos de caché, que es lo que baja el precio de entrada efectivo a aproximadamente una séptima parte de la lista.
La cola merece una mirada, sin embargo. La latencia P99 llega a 18,34 segundos y la de extremo a extremo P99 a 99,94 segundos. Es una buena distribución para un trabajo por lotes y una dura para cualquier cosa que una persona espera, el mismo equilibrio que se sopesa con cualquier agente de IA puesto delante de un cliente.
La mezcla de tráfico es lo más interesante. Los mayores consumidores son todos harnesses de programación: Claude Code con 9,58B de tokens, pi con 4,56B, Hermes Agent con 3,3B, más el propio harness de puente multimodal de DeepSeek con 3,12B. Nadie lo usa como modelo de chat. Lo apuntan a bases de código y a pantallas, lo que encaja bien con esas victorias en seis de siete pruebas de texto.
Un contexto más sobre por qué un modelo de visión barato ha calado tanto aquí. V4-Flash normal aparentemente pasó meses fingiendo que podía ver:
"It tried to recreate vision by analyzing pixels on 3 separate projects I had it working on."
Otro comentarista describió cómo tuvo que decirle a 0731 que dejara de abrir capturas, porque los intentos rompían las sesiones una y otra vez. Frente a esa referencia, un modelo que simplemente mira la imagen es una mejora real, aunque sea borrosa.
Quién debería usarlo y quién debería esperar
Úsalo ya si ejecutas bucles de agentes sobre pantallas y bases de código, ya estabas con V4-Flash y no dependes de FIM. Las pruebas de texto por sí solas justifican el cambio de la cadena del modelo, y la visión es un extra. El trabajo con documentos por lotes también encaja, siempre que hayas comprobado antes tus propios documentos frente al redimensionado.
Espera si necesitas una compilación fijada, o necesitas FIM, o tus imágenes dependen del detalle fino. Diales analógicos, esquemas densos, letra pequeña en recibos: prueba todo eso antes de planificar en torno a ello. La discusión sobre leer relojes que recorrió el hilo de Hacker News ilustra bien lo ruidosos que son los juicios de visión de un solo intento, ya que el fallo de un comentarista se convirtió en 9 aciertos de 10 cuando otro lo ejecutó diez veces, lo que provocó una frase que todos deberíamos pegar en el monitor:
"Lesson learned to double check what I read on the internet."
Piénsalo más si vas a apuntar esto a una cola de soporte. Las capturas de clientes están entre las entradas de más valor en soporte, y también son el peor encaje posible para un techo de 800 por 800, porque la razón de que un cliente envíe una captura es el texto pequeño que contiene. Lee nuestras notas sobre cómo elegir un modelo para soporte y sobre qué LLM encaja con el soporte antes de conectar un modelo en bruto a cualquier cola en vivo.
eesel para colas de soporte llenas de capturas
Quiero ser preciso sobre lo que este modelo resuelve para un equipo de soporte, porque tenemos la señal de demanda archivada. Un cliente, una empresa de soporte externalizado para alquileres vacacionales que usa eesel como copiloto de Zendesk, nos dijo claramente qué le impedía ser totalmente autónomo:
"Eesel is currently unable to analyze images, and our customers frequently share screenshots. Our agents are currently required to read these images and manually transfer the knowledge to Eesel."
Es una necesidad real sin cubrir, y un modelo como este es lo que acabará cerrándola. Pero conviene ser claro sobre qué mitad cierra realmente un modelo de visión. Leer los píxeles es la mitad fácil. Producir a partir de ellos una respuesta correcta y conforme a la política es la mitad difícil, y es también la mitad que ha quemado a todos los que han lanzado soporte con IA.
Hemos visto a un bot de apariencia segura decir en silencio a los clientes que admitíamos modelos de coche que no admitíamos, porque la base de conocimiento decía "we support all models" y el bot lo tomó al pie de la letra. Era un equipo de telemática en Zendesk, con unos 200 tickets al mes. Nada de un codificador de visión arregla ese fallo concreto. Lo que lo arregla es fundamentar al agente en tu historial real y demostrar el comportamiento antes de que un cliente lo conozca, por lo que cada despliegue de eesel se reproduce primero sobre tickets pasados y se acota a un tipo de ticket cada vez.

Así que si evalúas el modelo de visión de DeepSeek porque tu cola está llena de capturas, haz las dos pruebas en el orden correcto. Primero, si el modelo puede leer tus imágenes reales una vez redimensionadas. Segundo, y esta importa más, si la respuesta que devuelve es una que tú mismo habrías enviado. eesel resuelve esa segunda prueba simulando sobre tu historial de tickets antes de salir en vivo, facturando por ticket en lugar de por puesto y derivando a una persona todo lo que quede por debajo de tu umbral de confianza. Prueba eesel gratis, o reserva una demostración sobre tus propios tickets.
Dónde encaja en la gama de DeepSeek
Si estás situando a la familia, la versión corta es esta: deepseek-v4-flash-vision-exp es una bifurcación de la compilación 0731 de Flash, con un codificador de visión añadido y FIM retirado. No es un modelo de nivel Pro y no sustituye a nada.
- DeepSeek V4 Flash es la base de texto y sigue siendo la compilación fijada para producción.
- Flash frente a Pro trata la rara situación en que el nivel barato supera ahora al caro.
- Flash frente a Kimi K3 y Flash frente a GPT-5.6 se ocupan de las comparaciones entre proveedores.
- Qwen 3.8 Max frente a Flash es el duelo de pesos abiertos más cercano, y Kimi K3 es el otro a vigilar.
- DeepSeek V3.2 es la generación anterior, si todavía la usas.
- Nuestra reseña de V4-Flash y el resumen de alternativas cubren el panorama más amplio.
Y si llegaste aquí desde la automatización del soporte y no desde la elección de modelo, la lectura más útil está más abajo en la pila:
- Dónde encaja realmente un modelo: tickets con IA y agentes de helpdesk con IA.
- La cuestión de la recuperación, que suele importar más que el modelo: RAG frente a un LLM.
- Cómo es el trabajo de la cola: desvío de tickets y clasificación de tickets.
- Orden de triaje y volumen: priorización de tickets, automatización de la primera respuesta y reducción de tickets.
- El patrón con humano en el circuito: copilotos de IA para soporte.
- Terminología, si los discursos de los proveedores se confunden: agentes frente a chatbots.
- Las dos comparaciones que deciden presupuestos: coste por resolución y coste de agente de IA frente a agente humano, frente a una base del coste del servicio al cliente con IA.
Conclusión
DeepSeek ha lanzado un modelo que lee imágenes prácticamente gratis y, de paso, un mejor modelo de texto que aquel del que bifurcó. Ambas cosas son reales, y ambas son baratas.
Las dos cosas que hay que sopesar son las que el anuncio no pone al frente. Cada imagen se aplana a unos 800 por 800 antes de que el modelo la mire, así que la visión aquí es un vistazo y no una inspección. Y la compilación no lleva fecha, así que todo lo que midas esta semana es una medición sobre un blanco móvil.
Para bucles de agentes sobre pantallas y sobre código, es un buen trato a $0,22 de entrada y $0,66 de salida. Para una cola de soporte donde la captura es el ticket, prueba el redimensionado antes de planificar en torno a él, y recuerda que leer la imagen nunca fue la parte que iba a salir mal.
Preguntas frecuentes
¿Qué es DeepSeek V4 Flash Vision Exp?
model='deepseek-v4-flash-vision-exp' y acepta imágenes junto con texto en la misma solicitud. Es una variante de DeepSeek V4 Flash, con la misma arquitectura de mezcla de expertos (284B totales, 13B activos) y la misma ventana de contexto de 1M.¿Cuánto cuesta DeepSeek V4 Flash Vision Exp?
¿Cómo factura DeepSeek las imágenes?
¿Es DeepSeek V4 Flash Vision Exp mejor que V4-Flash?
¿Cuál es la trampa de DeepSeek V4 Flash Vision Exp?
DeepSeek-V4-Flash-Vision-Exp, no con un sello fijo del estilo 0731, así que una compilación experimental puede cambiar bajo tus pies entre el día de las pruebas y el día del lanzamiento.¿Puede DeepSeek V4 Flash Vision Exp leer capturas de clientes para soporte?
¿Cómo envío una imagen a la API de DeepSeek?
file_id de la nueva API de archivos, que es gratuita. La vía de la API de archivos también sube el límite por imagen de 32 MiB a 64 MiB. Nuestra guía de la API de DeepSeek cubre la autenticación y la URL base compatible con OpenAI.