

ERNIE 5.5 Flash es un modelo base abierto de 280B de parámetros de Baidu, con 14B activos por token, publicado el 5 de noviembre de 2026. En la propia tabla de Baidu, supera a DeepSeek V4 Flash Base en 26 de 30 pruebas. Pero es un checkpoint de preentrenamiento: no hay versión de chat ni de uso de herramientas, no hay precio de API alojada, y la licencia excluye a la UE, el Reino Unido y Corea del Sur. Para un agente de helpdesk, conviene esperar al modelo posentrenado. Este es el modelo; eesel es el compañero de equipo.
¿Qué es ERNIE 5.5 Flash?
ERNIE 5.5 Flash es un modelo transformer disperso de tipo mixture-of-experts de Baidu. Lo que Baidu publicó el 5 de noviembre de 2026 es ERNIE-5.5-Flash-Base, el checkpoint "al final del preentrenamiento, antes de cualquier entrenamiento intermedio o posterior". Baidu dice que es deliberado: los desarrolladores pueden tomar los pesos y elegir hacia dónde entrenarlos después.
Trabajo en los agentes de IA de eesel, así que lo primero que compruebo en el lanzamiento de cualquier modelo es en qué etapa de entrenamiento están los pesos. Aquí la respuesta es la etapa más temprana que se puede usar, y eso cambia casi todo sobre cómo hay que leer el resto de este artículo.
La hoja de especificaciones, de la model card de Baidu:
| Especificación | ERNIE-5.5-Flash-Base |
|---|---|
| Parámetros totales / activos | 280B / 14B por token |
| Capas | 43 (1 densa, 42 mixture-of-experts) |
| Expertos | 512 enrutados (top 10 por token) más 1 compartido |
| Datos de preentrenamiento | 33.5T tokens |
| Contexto | 128K en entrenamiento, 1M para fine-tuning e inferencia |
| Modalidad | Solo texto |
| Pesos | Safetensors FP8 y BF16 |
| Vocabulario | 201,216 tokens |
| Licencia | ERNIE 5.5 Flash Base Model License v1.0 |
Solo alrededor del 5% de los parámetros trabaja en un token dado, que es como un modelo de 280B puede funcionar como uno de 14B. Es la misma apuesta que hace DeepSeek V4 Flash con 284B totales y 13B activos.
¿Qué tiene de nuevo el diseño?
El blog técnico de Baidu habla sobre todo de costes: cuánta memoria consume un contexto largo, y cuán barato se puede seguir entrenando. Destacan cuatro decisiones.
- Atención económica. Una de cada siete capas mantiene la atención de contexto completo. El resto usa "Heavily Compressed Attention", que guarda una sola entrada de caché por cada 128 tokens, así que la ventana de contexto cuesta mucha menos memoria.
- Varios routers por capa. En lugar de que un único router elija los expertos, cada capa mixture-of-experts usa varios routers independientes, con el argumento de que las puntuaciones de un solo router son una guía débil sobre qué experto ayuda.
- Decodificación especulativa integrada. La última capa del modelo también hace de modelo borrador, un diseño que Baidu llama ECHO, de modo que generar más rápido no necesita un modelo auxiliar aparte.
- Código y documentos largos en los datos. El preentrenamiento se apoya mucho en código a escala de repositorio y datos de contexto largo, incluidos commits, pull requests y revisiones de código.
Nada de esto dice si el modelo es agradable para conversar. Dice que el modelo está construido para ser barato de fine-tunear y de servir, que es para lo que sirve una publicación base.
¿ERNIE 5.5 Flash es un modelo de chat?
No, y ese es el dato más importante sobre él. Los pesos son el checkpoint de preentrenamiento, y Baidu dice que el ERNIE 5.5 Flash posentrenado llegará después. No se dio ninguna fecha. La model card dice que se sirve a través del endpoint de completions, lo que significa que envías texto y el modelo lo continúa, sin formato de chat.
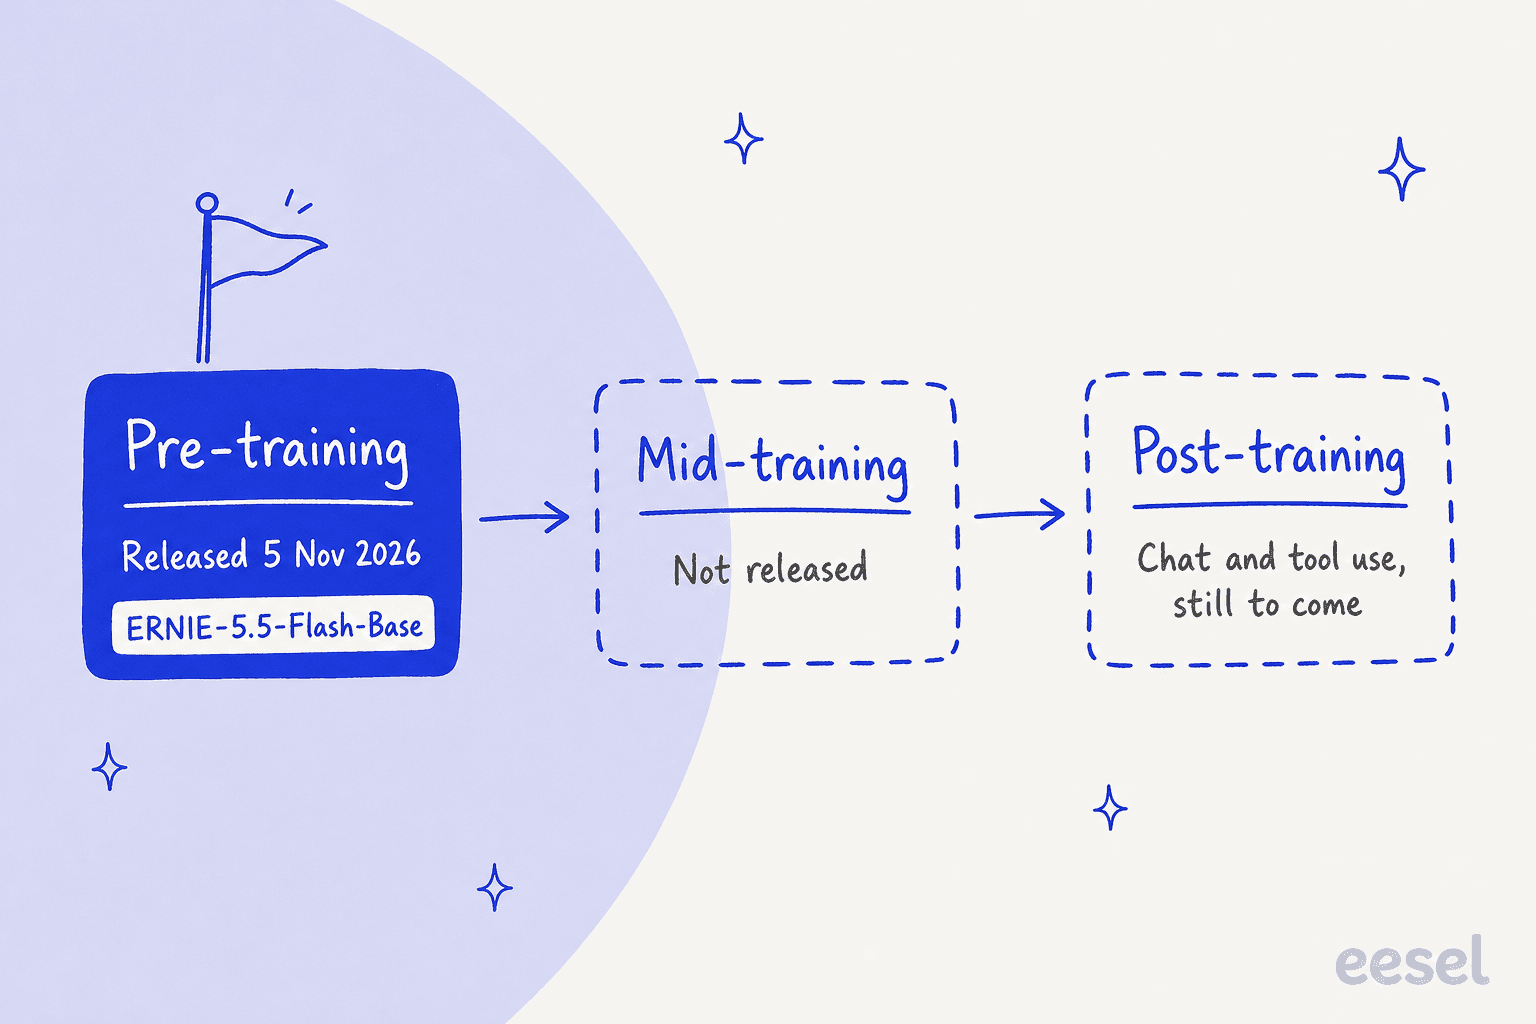
Un modelo posentrenado es el que sigue instrucciones, mantiene una persona, llama herramientas y dice que no. La línea insignia de Baidu es otra cosa: el lanzamiento de ERNIE 5.1 está fechado el 9 de mayo de 2026, y ERNIE 5.0 es un modelo multimodal de 2.4 billones de parámetros. ERNIE 5.5 Flash es una línea distinta, centrada en la eficiencia, y por ahora solo son públicos sus ingredientes crudos.
Un comentarista de Hacker News lo resumió con claridad en el hilo de lanzamiento, que llegó a 162 puntos:
"It's not instruction finetuned, so no, it's not good to use for anything like coding agents."

¿Qué dicen los benchmarks de ERNIE 5.5 Flash?
En la tabla de Baidu, el modelo base gana la mayoría de las filas. Baidu lo comparó con otros tres modelos base, DeepSeek-V4-Flash-Base (284B totales, 13B activos), Hy3-preview-Base (295B, 21B) y MiMo-V2.5-Base (310B, 15B), "todos evaluados con el mismo pipeline, los mismos prompts y los mismos ajustes de few-shot". Frente a DeepSeek, ERNIE puntúa más alto en 26 de 30 filas.
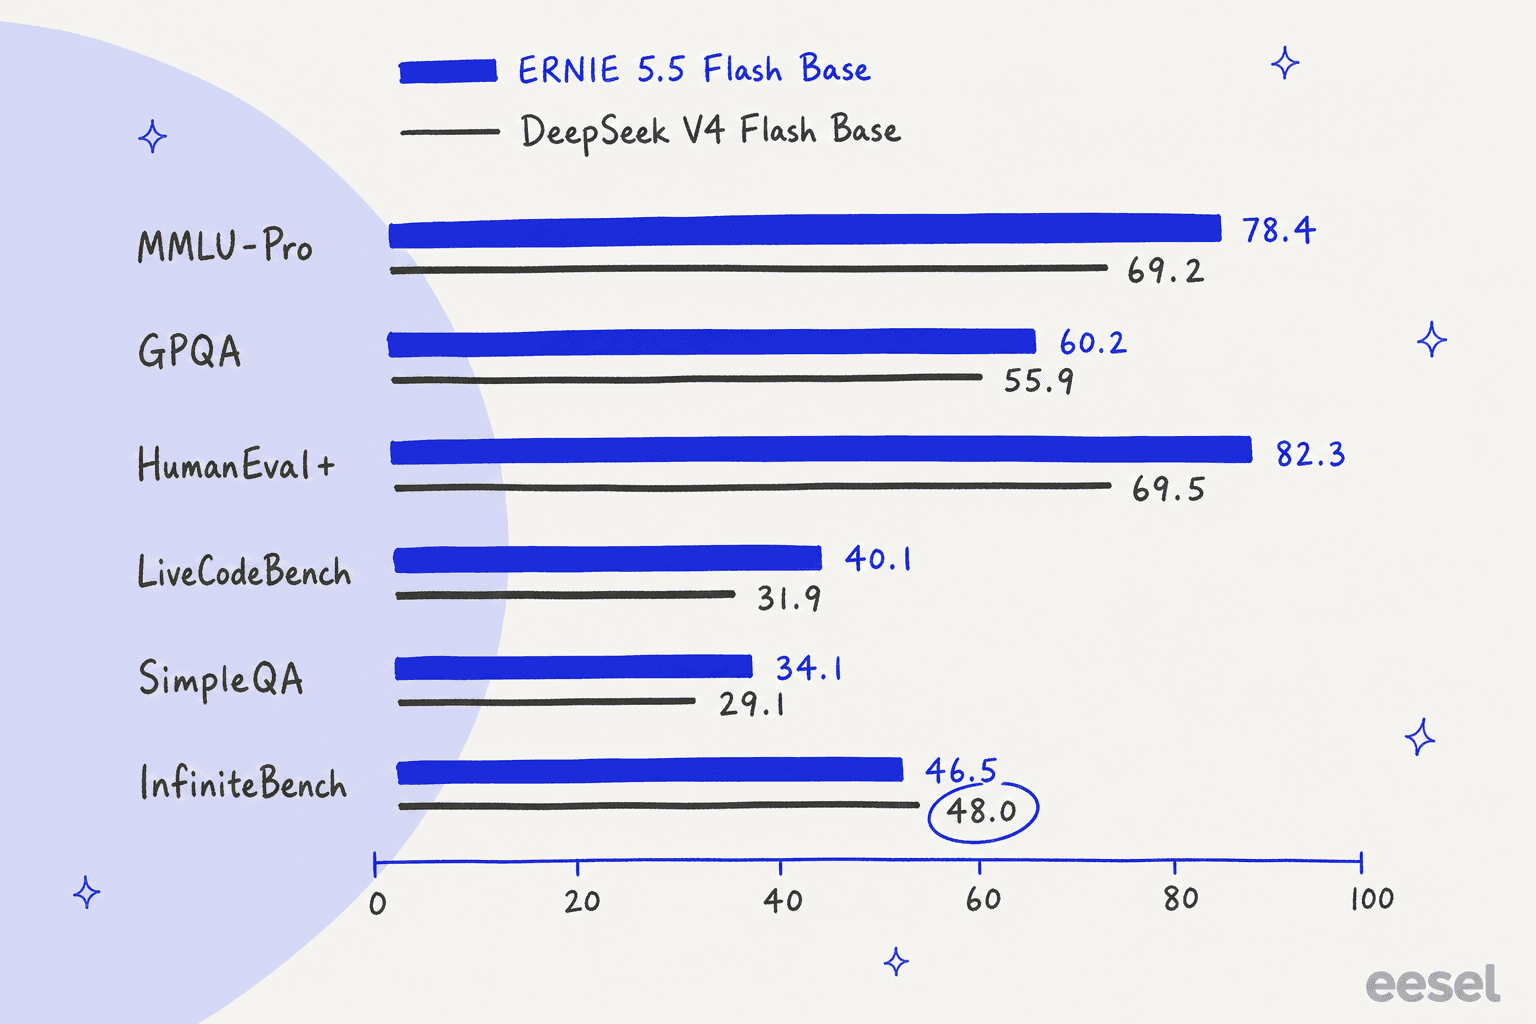
Aquí un fragmento de la tabla completa, con todas las filas en las que ERNIE perdió frente a DeepSeek:
| Benchmark | ERNIE 5.5 Flash Base | DeepSeek V4 Flash Base |
|---|---|---|
| MMLU-Pro | 78.4 | 69.2 |
| GPQA | 60.2 | 55.9 |
| HumanEval+ | 82.3 | 69.5 |
| LiveCodeBench | 40.1 | 31.9 |
| RepoQA (contexto largo) | 91.7 | 81.0 |
| SimpleQA | 34.1 | 29.1 |
| ChineseSimpleQA | 73.0 | 75.3 |
| INCLUDE-lite (multilingüe) | 79.5 | 79.8 |
| HELMET-Rerank (contexto largo) | 56.2 | 60.0 |
| InfiniteBench (contexto largo) | 46.5 | 48.0 |
Tres razones para tomar estas cifras con cautela:
- Son pruebas propias de Baidu. No pude encontrar una evaluación independiente. Artificial Analysis todavía no tiene página para ERNIE 5.5.
- Son pruebas de modelo base. Los benchmarks de conocimiento few-shot y de código miden lo que construyó el preentrenamiento. No miden si el modelo sigue un system prompt o termina una tarea de varios pasos.
- El rival no es el más nuevo. Un comentarista de Hacker News señaló que Baidu comparó con la base de V4 Flash más antigua, básicamente dos versiones por detrás de la última versión de DeepSeek Flash.
"They're comparing it to Deepseek-v4-Flash, not 4.1 and not the 4.1 1017 update, so essentially two versions behind the latest version of Deepseek Flash."
La lectura justa es que el preentrenamiento parece sólido, sobre todo en código y conocimiento, y que las filas de contexto largo son desiguales. Si eso sobrevive al posentrenamiento es la pregunta abierta.
¿Cuánto cuesta ERNIE 5.5 Flash?
Los pesos no cuestan nada para descargar, y no hay precio de API de Baidu que citar. La página de Hugging Face decía, cuando la capturé, que el modelo "isn't deployed by any Inference Provider", y tampoco encontré ningún listado en OpenRouter.
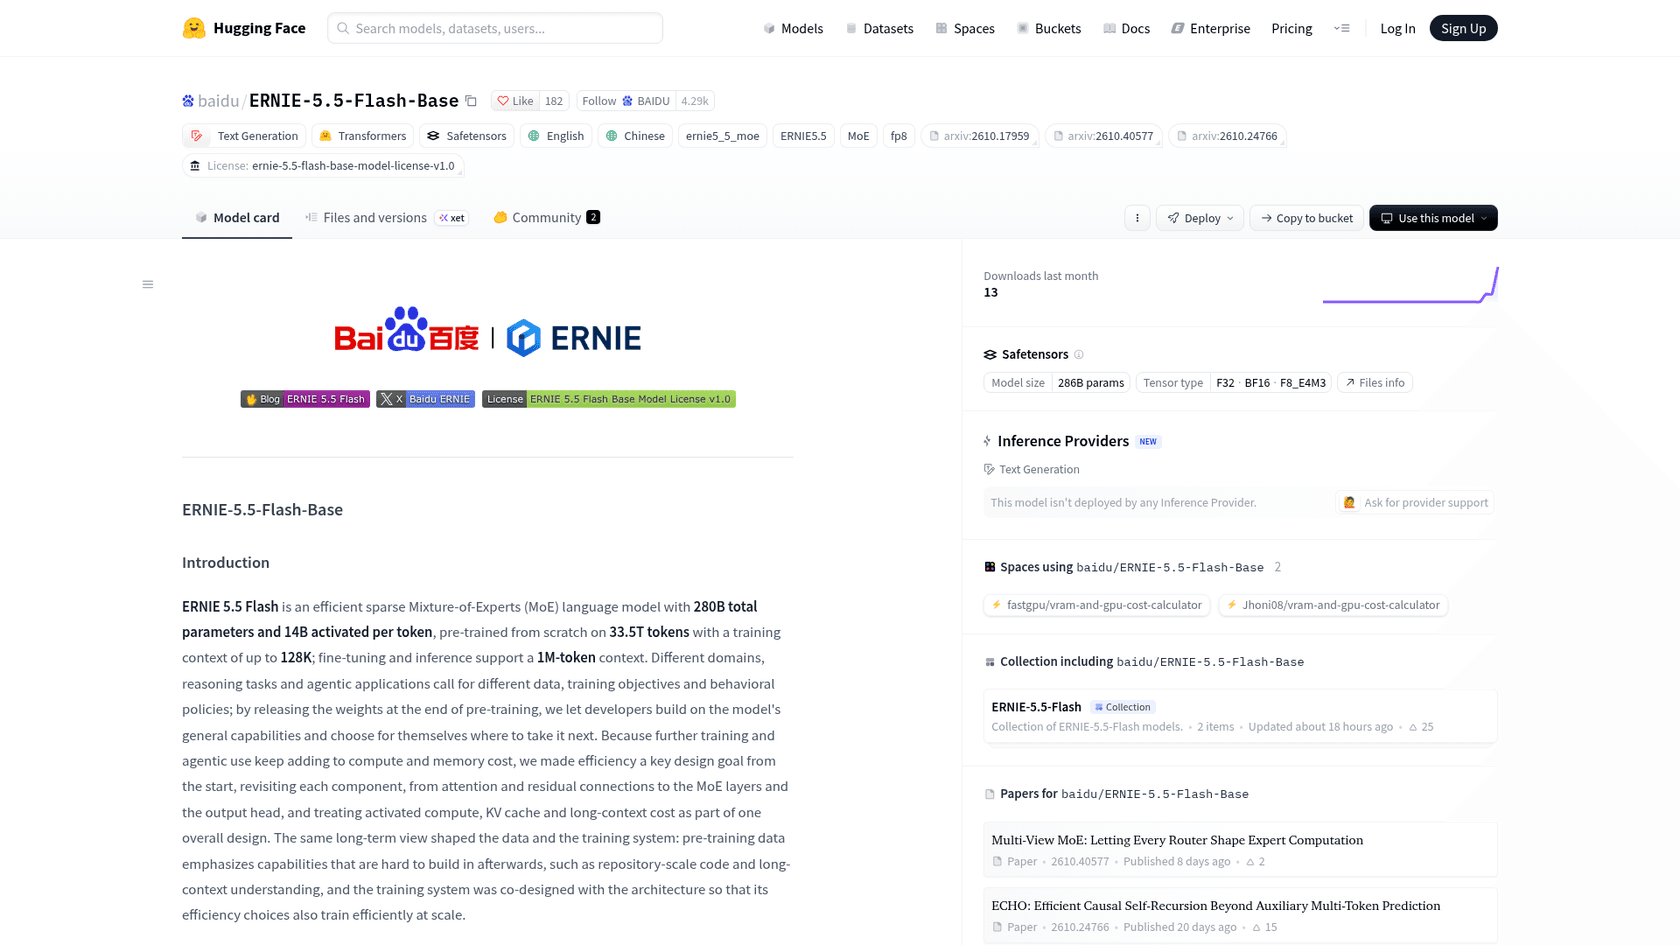
Así que el coste real es hardware e ingeniería. Hugging Face lista 286B de parámetros, y los pesos FP8 ocupan alrededor de un byte cada uno, así que, según mis cálculos, hacen falta unos 286 GB solo para mantener el modelo, antes de contar nada de caché KV. Los propios comandos de lanzamiento de Baidu están pensados para paralelismo de cuatro vías: --tp 4 para SGLang y --data-parallel-size 4 para vLLM.
Para ver cómo queda eso frente a opciones alojadas, aquí una carga de trabajo asumida: 10,000 conversaciones de soporte al mes, 3,000 tokens de entrada y 500 de salida cada una, es decir 30M de entrada y 5M de salida, sin caché y sin tokens de razonamiento. Los precios vienen de la página de cada proveedor.
| Modelo | Entrada / salida por 1M de tokens | Factura mensual para esa carga |
|---|---|---|
| ERNIE 5.5 Flash | Sin precio alojado publicado | Tus propias GPU |
| Claude Haiku 5.5 (prompts hasta 100K) | $0.10 / $0.50 | $5.50 |
| GPT-6 Luna | $0.10 / $0.50 | $5.50 |
| Qwen3.8-Flash (internacional) | $0.15 / $0.47 | $6.85 |
| DeepSeek V4.1 Flash (fuera de pico) | $0.15 / $0.60 | $7.50 |
| DeepSeek V4.1 Flash (hora pico) | $0.30 / $1.20 | $15.00 |
| Gemini 3.8 Flash (hasta el 31 de dic. de 2026) | $0.75 / $3.75 | $41.25 |
Son facturas minúsculas. A este volumen, los tokens alojados casi con seguridad costarán menos que mantener un servidor multi-GPU funcionando día y noche, aunque no he puesto precio al hardware. Autohospedar un modelo abierto compensa por otras razones, como mantener los datos en tu propia red o entrenar un modelo con el estilo de tu casa, y para eso sirve exactamente un modelo base: un fine-tune. Hay artículos de precios más a fondo en precios de DeepSeek V4.1 Flash y precios de Claude Haiku 5.5.
¿Quién puede usar ERNIE 5.5 Flash?
Menos gente de la que sugiere la palabra "abierto". La licencia de ERNIE 5.5 Flash es un acuerdo propio de Baidu, y cuatro cláusulas importan en la práctica.
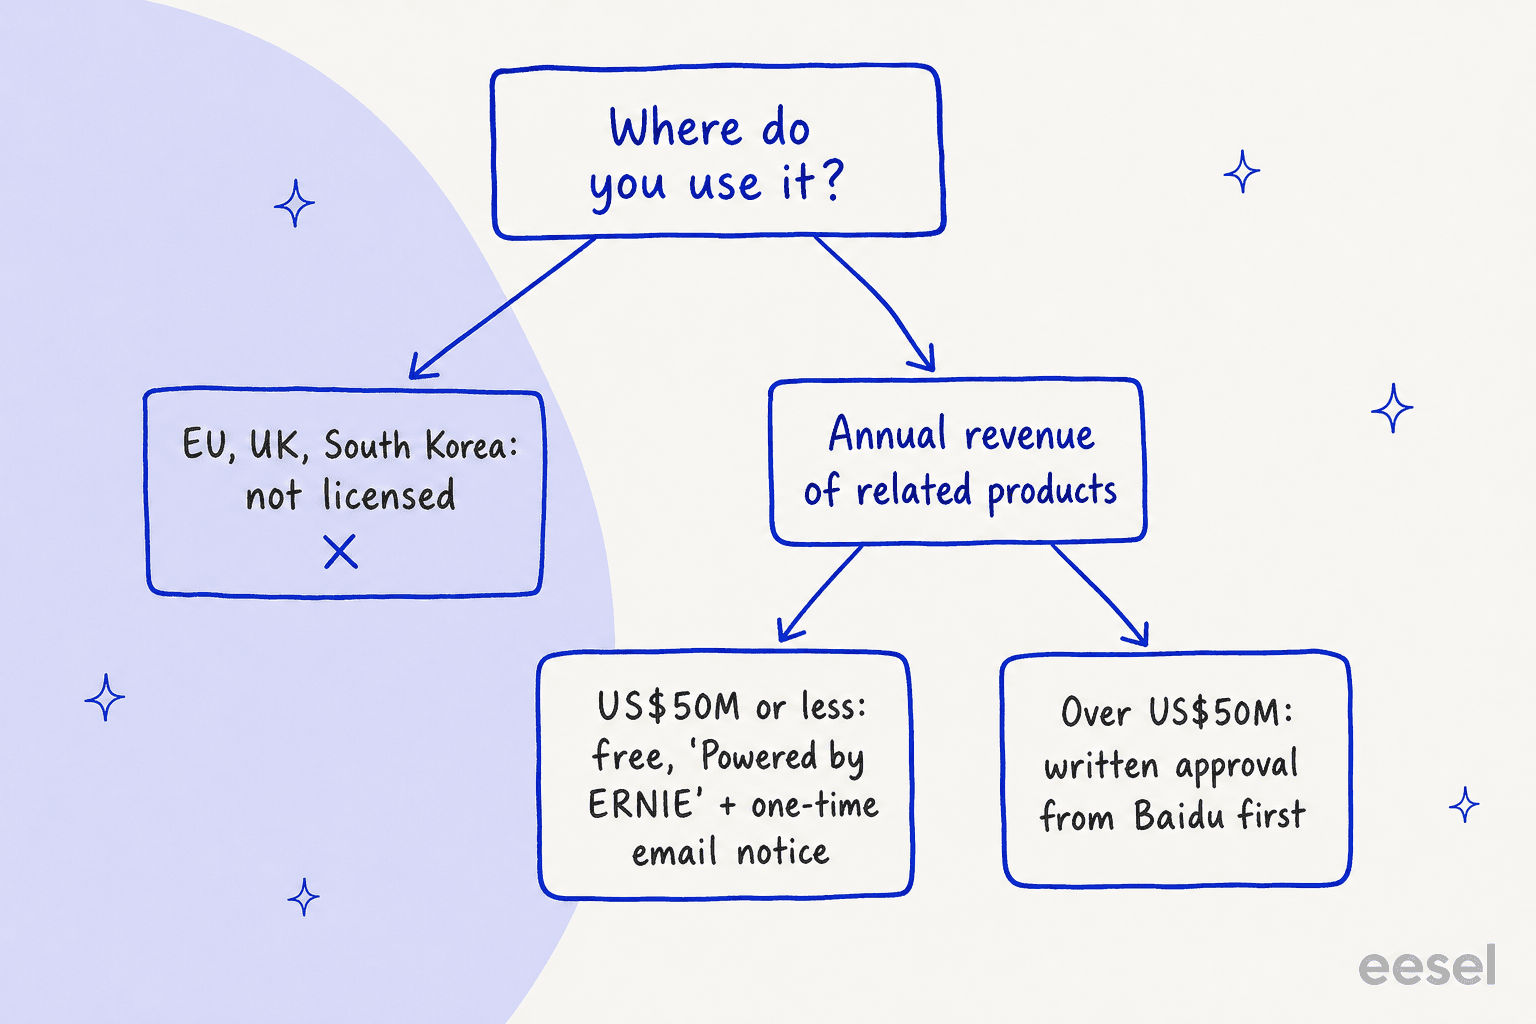
- Territorio. La concesión cubre todo el mundo "salvo la Unión Europea, el Reino Unido y Corea del Sur". La sección 5.3 también prohíbe usar las salidas del modelo fuera de ese territorio.
- Ingresos. El uso comercial no paga licencia hasta 50 millones de dólares de ingresos anuales del producto relacionado, sumando todas las filiales. Por encima de eso, necesitas la autorización por escrito de Baidu antes de empezar.
- Atribución. Un producto comercial debe mostrar las palabras exactas "Powered by ERNIE" en su interfaz, sitio web o documentación, y envías a Baidu un aviso único por correo electrónico.
- Sin destilar. La sección 5.5 prohíbe usar el modelo o sus salidas para mejorar cualquier otro modelo de IA, salvo derivados del propio modelo.
Los desarrolladores se dieron cuenta. En Hacker News, la licencia fue la principal queja:
"The license seems really restrictive for something intended to be built on. Entire countries are forbidden to use it at all (European Union, the United Kingdom and South Korea), and you are responsible for making sure no one in those places uses your derivative."
Un comentarista tuvo una lectura más relajada, al argumentar que la exclusión es una forma de evitar riesgo regulatorio, más que algo que Baidu piense vigilar. De cualquier modo, si tus clientes están en Europa, es tu problema resolverlo, y la guía de la Ley de IA de la UE y la guía de residencia de datos muestran cuánto peso tiene eso en soporte.
Los fans de los modelos base también encontraron mucho que celebrar:
"Absolutely glad to see the release of a base model, I think the trend away from that has been an issue for the field."
¿Cómo se ejecuta ERNIE 5.5 Flash fuera de China?
Descargas los pesos y los sirves tú mismo, si tu ubicación está dentro del territorio de la licencia. Los pesos están en Hugging Face y ModelScope en FP8, con una copia en BF16 también.
- SGLang: la imagen preconstruida es
lmsysorg/sglang:dev-ernie-55-flash, lanzada con--tp 4 --attn-dp-size 4. - vLLM: versión 0.32.0 más el plugin vLLM-ERNIE de Baidu, con
--data-parallel-size 4. - Contexto: ambos servidores aceptan hasta 1,048,576 tokens, y el contexto de entrenamiento fue 128K.
- Fine-tuning: Baidu remite a un ejemplo de Megatron Bridge de NVIDIA.
Todavía no hay atajo alojado. Si solo quieres un modelo de gama Flash barato y alojado hoy mismo, la tabla de arriba es tu lista de la compra, y la reseña de Qwen 3.8 Flash cubre uno de ellos a fondo.
¿ERNIE 5.5 Flash sirve para un agente de IA de helpdesk?
Hoy no. No pondría este checkpoint ni cerca de una cola de clientes, por cuatro razones.
- Todavía no sigue instrucciones. Un agente de soporte tiene que obedecer un system prompt, usar guardrails y saber cuándo escalar. Son comportamientos de posentrenamiento, y son justo lo que falta.
- No hay nada que llamar. Sin endpoint alojado, el coste de servirlo, la disponibilidad y la revisión de seguridad son todos tuyos.
- La licencia bloquea a los clientes europeos. Un equipo de soporte en Copenhague o Londres no puede usar las salidas bajo la concesión tal como está escrita.
- Nadie lo ha medido en trabajo de soporte. La tabla de Baidu no tiene ninguna prueba de seguimiento de políticas al estilo τ-bench, ninguna prueba de uso de herramientas y ninguna tasa de alucinación.
El modelo es también solo la mitad más pequeña del trabajo. Incluso una versión posentrenada perfecta seguiría necesitando una base de conocimiento, reglas de traspaso, retrieval y una forma de revisar las respuestas antes de que las vean los clientes. Ese es el coste real detrás de construir frente a comprar, y la razón por la que un modelo solo nunca se convierte en un agente de soporte. Mi regla breve: este es el modelo; eesel es el compañero de equipo.
eesel es una plataforma de compañeros de IA, y su compañero de IA de helpdesk se une a la cola que ya tienes en Zendesk, Freshdesk, Gorgias y otros. eesel lleva años poniendo IA en colas de soporte en vivo, por lo que cada despliegue se simula primero contra tus tickets históricos. Lees lo que el compañero de equipo habría dicho antes de que responda a nadie.
Timengo, una empresa danesa de correo seguro, usa eesel en Freshdesk. El compañero de equipo redacta respuestas en danés a partir de unos 5,300 tickets pasados y artículos del centro de ayuda, preparó 300 tickets en un mes y escribió 180 borradores de respuesta. Un ingeniero de soporte revisa y envía cada uno, y eesel nunca envía por su cuenta. SamCart usa un agente en los tickets de Freshdesk y otro en el chat del sitio web, ambos respondiendo a partir de unos 280 artículos del centro de ayuda. El agente de tickets responde solo mientras no hay ninguna persona asignada, y se retira en cuanto un compañero de equipo lo toma.
Ese comportamiento de "retirarse" es justo el tipo de cosa que un modelo base no ha aprendido. También es la razón por la que esperaría al ERNIE 5.5 Flash posentrenado en lugar de juzgar este lanzamiento como un agente. Cuando llegue, nuestra guía para elegir un LLM para soporte y el mejor modelo para tickets de soporte muestran qué probar primero, y la prevención de alucinaciones es la parte que más muerde.
Si te gusta trabajar desde una terminal, vale la pena mirar la CLI de eesel. Con ella, un agente de IA para programar puede subir conocimiento aprobado como artículos de ayuda exportados y macros, editar las instrucciones del compañero de equipo y hacer preguntas de prueba para comprobar las respuestas antes de que nada salga a producción. Conectar el helpdesk en sí todavía necesita a alguien con acceso de administrador que lo apruebe. Hay más en gestionar agentes de IA desde la terminal.
¿Quién debería usar ERNIE 5.5 Flash?
Mi opinión tras leer por completo el blog, la model card y la licencia de Baidu:
- Pruébalo si eres un equipo de investigación o una empresa fuera de la UE, el Reino Unido y Corea del Sur que quiere una base fuerte y eficiente para fine-tunear. Un modelo mixture-of-experts con 14B activos y 1M de contexto es un buen punto de partida, y un checkpoint base es justo lo que quieres para el fine-tuning.
- Espera si quieres un modelo de chat o de agente. Baidu ha prometido uno sin fecha, y las pruebas externas dirán más que una tabla del proveedor.
- Sáltatelo si atiendes a clientes europeos, o si solo necesitas tokens alojados baratos. DeepSeek V4.1 Flash, Claude Haiku 5.5 y GPT-6 Luna están listos hoy.
- Compáralo con otros modelos abiertos si estás comparando opciones: Kimi K3, GLM 5.3 Flash y Ripple-65B cada uno cede en algo distinto entre tamaño, precio y licencia.
El resumen que le daría a un colega: ERNIE 5.5 Flash es un ingrediente prometedor. Las cifras de preentrenamiento son fuertes en la propia tabla de Baidu y el diseño de ahorro de costes es real, pero falta el modelo de chat y la licencia tiene límites geográficos.
Probar eesel
Si llegaste a ERNIE con la esperanza de que un nuevo modelo abierto quitara tickets a tu equipo, puedes ahorrarte construir la capa de soporte tú mismo. El compañero de IA de helpdesk de eesel se conecta a Zendesk, Freshdesk, Gorgias y más en minutos, aprende de tus tickets pasados y te muestra cómo habría respondido antes de salir a producción. Los planes empiezan en $299 al mes, y hay un nivel gratuito para probar.

Prueba eesel gratis.