

Ripple-65B Preview es un modelo denso de 65B con licencia Apache 2.0 que iguala en programación con agentes a modelos de pesos abiertos de ocho a quince veces su tamaño, a $0.20 / $0.60 por millón de tokens alojado. Su ventaja es estrecha, sin embargo. La propia tabla de Ricursive lo pone primero en 2 de 22 benchmarks, y Terminal-Bench 2.1 es una victoria de 0,4 puntos sobre Reflection Beam. La razón real para prestarle atención es que cabe en un solo DGX Spark. Pruébalo si quieres un modelo de código que puedas alojar tú mismo; espera a pruebas independientes si necesitas evidencia. Para los equipos de soporte, el modelo es la parte fácil, y eesel es el compañero de equipo construido encima.
¿Qué es Ripple-65B?
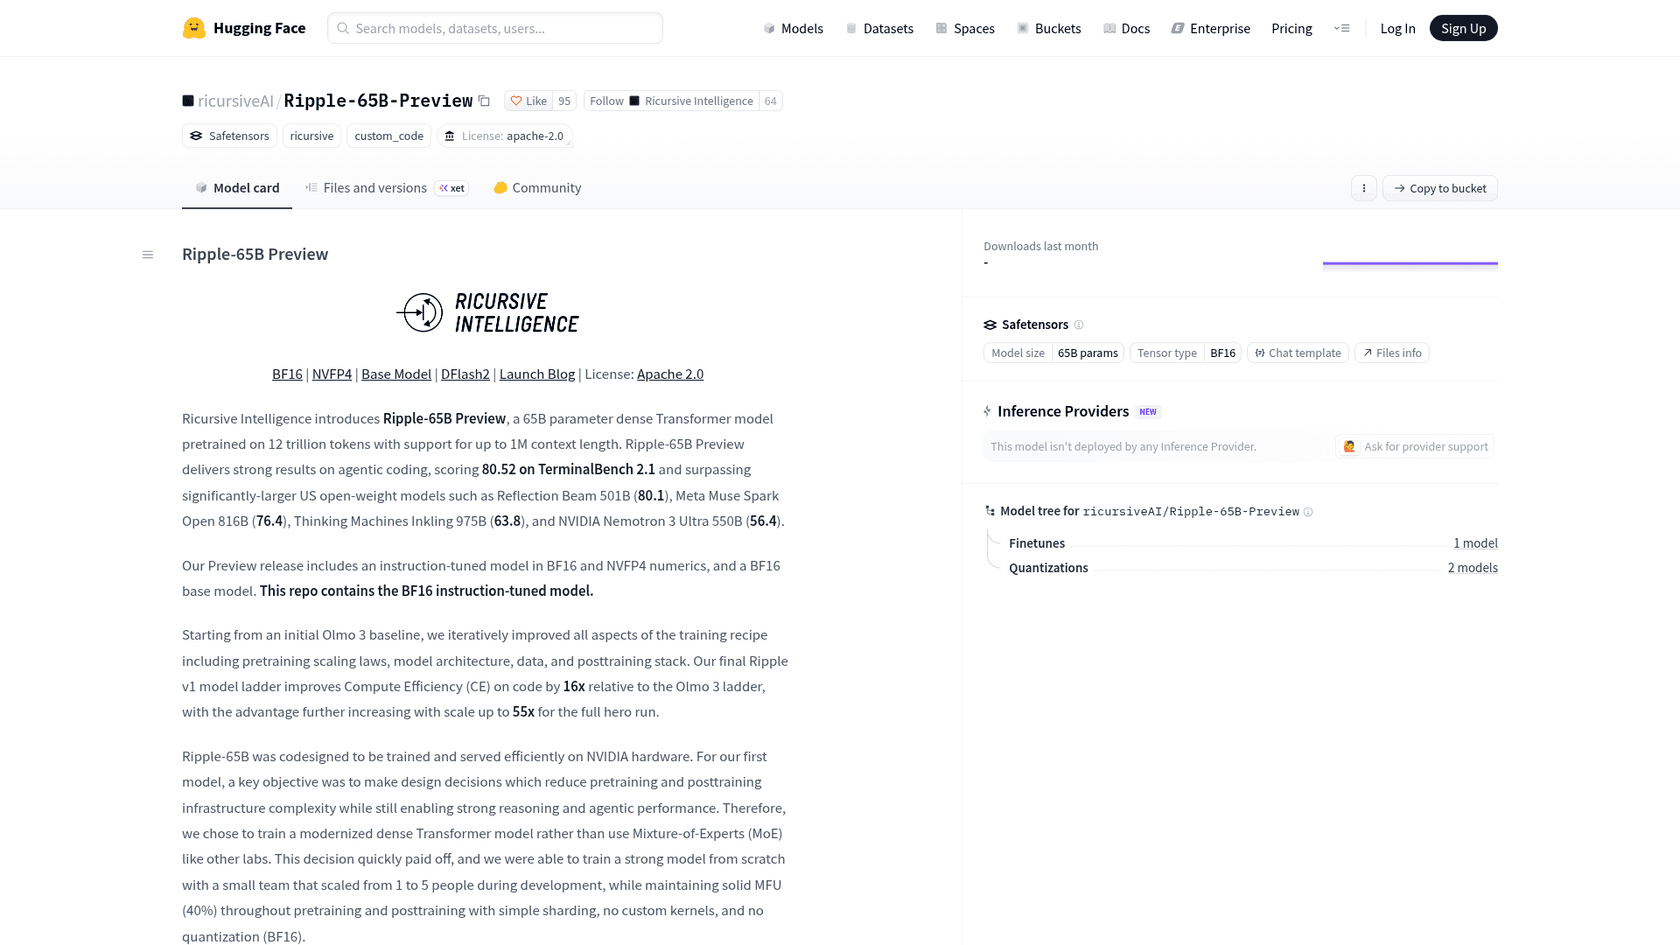
Ripple-65B Preview es el primer modelo público de Ricursive Intelligence, un laboratorio de Palo Alto cofundado por Anna Goldie y Azalia Mirhoseini que desarrolla IA para el diseño de chips. Se publicó el 4 de noviembre de 2026. Ricursive lo describe como "a general-purpose variant of the proprietary model that powers our AI chip design platform."
La ficha técnica, en resumen:
- Tamaño: 64,8B parámetros, todos activos en cada token. Es un modelo transformer denso, no una mezcla de expertos.
- Entrenamiento: preentrenado desde cero con 12 billones de tokens de texto y código, mayoritariamente en inglés. Sin imágenes ni audio.
- Contexto: hasta 1M de tokens admitidos, con 2M de posiciones permitidas en la configuración.
- Licencia: Apache 2.0 en todos los checkpoints, así que el uso comercial está permitido.
- Enfoque: Ricursive dice que la Preview tuvo "relatively light posttraining, with a focus on agentic coding."
Se publica en cuatro repositorios de Hugging Face: el modelo BF16 ajustado por instrucciones (unos 130 GB), una versión NVFP4 etiquetada como "Experimental" (unos 57 GB), un modelo base sin posentrenamiento y un modelo borrador "DFlash2" de 4B que acelera la generación mediante decodificación especulativa.
En eesel construyo integraciones y funciones de API, así que cuando sale un modelo como este, lo primero que leo no es el gráfico de lanzamiento. Es el archivo de configuración, la plantilla de chat y los scripts de servicio, porque ahí se descubre qué puedes usar realmente el lunes. Todo lo que sigue sale de esos archivos, la ficha del modelo y las páginas de los proveedores, revisados el 5 de noviembre de 2026.
¿Qué hay de nuevo en Ripple-65B?
Tres cosas lo distinguen de los demás lanzamientos de pesos abiertos de EE. UU. este año.
Es denso cuando todos los demás fueron a MoE. Reflection Beam, Meta Muse Spark Open, Inkling y Nemotron 3 Ultra usan diseños de mezcla de expertos, en los que solo corre una parte del modelo por token. Ripple ejecuta los 65B completos cada vez. El argumento de Ricursive, en la ficha del modelo, es que un modelo denso "reduce[s] pretraining and posttraining infrastructure complexity", lo que permitió a un equipo que pasó de 1 a 5 personas entrenarlo con "simple sharding, no custom kernels, and no quantization." La forma también es poco habitual: estrecho y profundo, con una capa oculta de solo 5.120 de ancho apilada en 80 capas, y cuatro capas de atención de ventana corta por cada una completa.
Afirma ser barato de fabricar. Ricursive dice que gastó $32M en todo el proyecto, y el blog aclara que es "our full R&D cost starting from scratch, including pretraining ladder development, data mixing, evals, debugging" y las ejecuciones finales, no solo un entrenamiento. La comparación de "una décima parte del coste" es más débil de lo que suena. Su nota al pie se apoya en un reportaje de TechCrunch según el cual Reflection comprometió $150M al mes en cómputo, más la declaración de Reflection de que Beam tomó unas ocho semanas. Es, por tanto, la estimación de Ricursive del gasto de un competidor, no una cifra publicada por Reflection.
Necesitó menos ejecuciones de aprendizaje por refuerzo. Ricursive dice que alcanzó su puntuación en Terminal-Bench con 1,4M de rollouts, "roughly 70x fewer rollouts than Reflection Beam." También dice que no compró datos de posentrenamiento y que construyó sus propios flujos de datos sintéticos.
¿Qué dicen los benchmarks de Ripple-65B?
Ripple-65B logra 80,5 en Terminal-Bench 2.1, la cifra principal, que mide si un modelo puede completar tareas reales dentro de una terminal. Eso supera por poco a Reflection Beam con 80,1 y a Muse Spark Open (76,4), Inkling (63,8) y Nemotron 3 Ultra (56,4), según las puntuaciones autorreportadas de cada laboratorio.
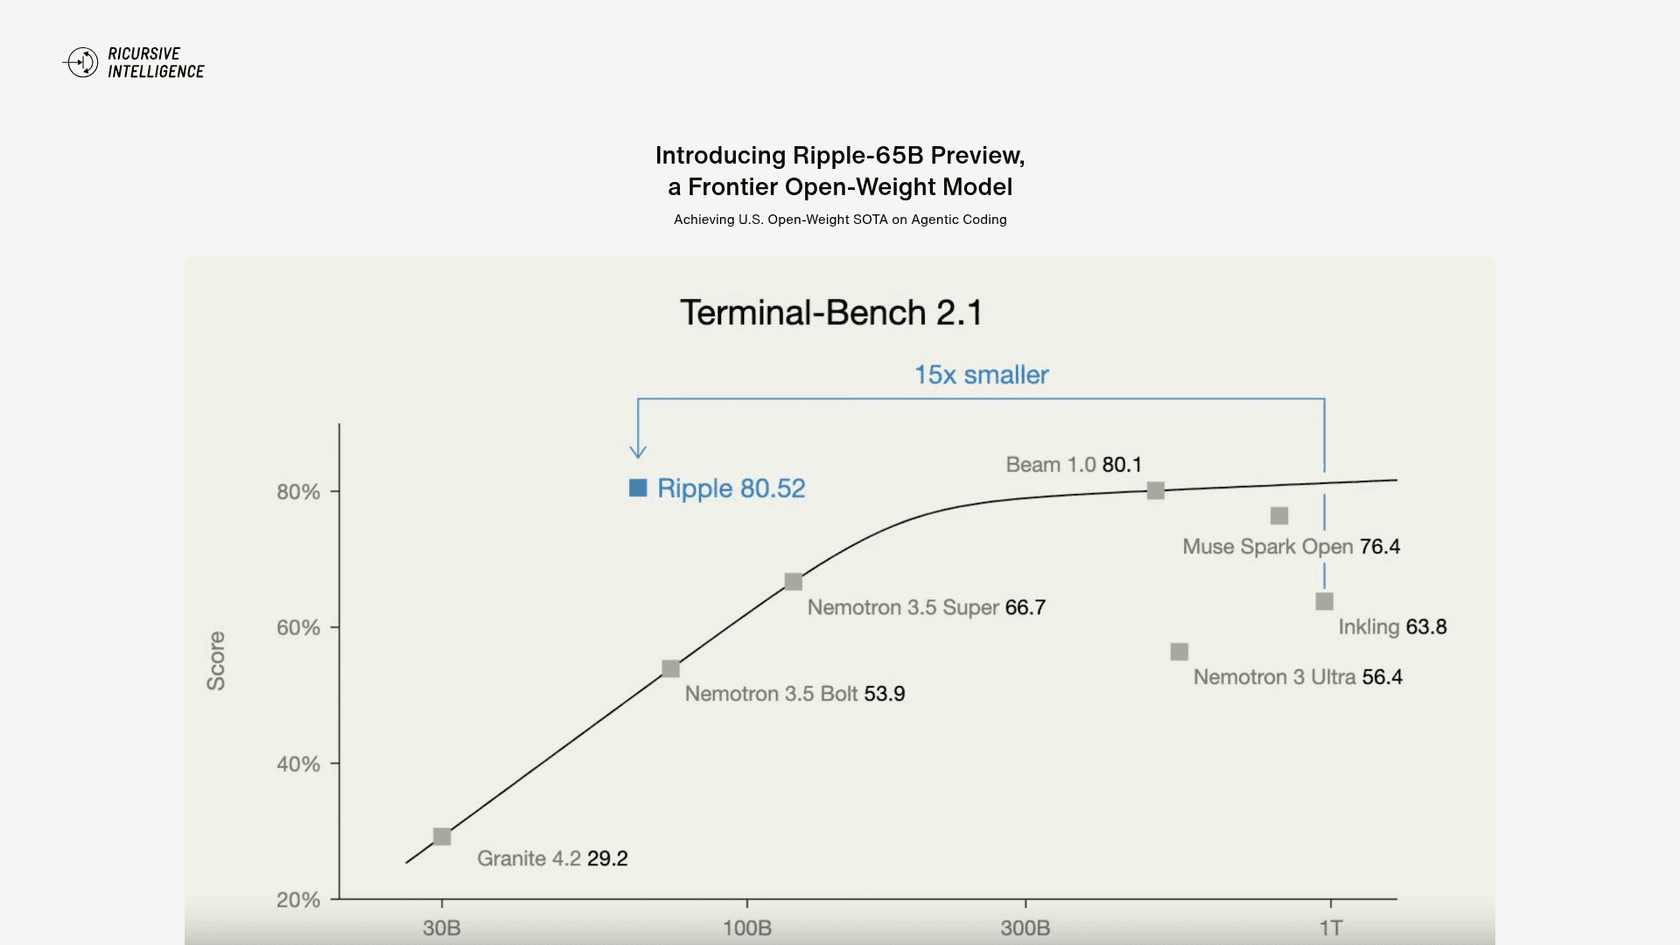
Ese gráfico es todo el argumento: puntuación frente a tamaño, con Ripple muy a la izquierda de la curva. También sitúa en la misma línea a modelos estadounidenses más pequeños como Nemotron 3.5 Bolt (53,9) y Nemotron 3.5 Super (66,7). Ajustando por tamaño en programación, Ripple va claramente por delante.
La tabla completa de la ficha del modelo cuenta una historia más mixta. Estas son las filas que importan para agentes de código, con las cifras de la propia Ricursive:
| Benchmark | Ripple-65B | Reflection Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Parámetros activos | 65B | 23B | 42B | 41B | 55B |
| Terminal-Bench 2.1 (autorreportado) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| Terminal-Bench 2.1 (repetición de Ricursive) | 80.5 | 70.8 | 78.7 | 56.2 | 55.1 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
| GPQA Diamond | 85.2 | 90.6 | 89.0 | 87.2 | 87.0 |
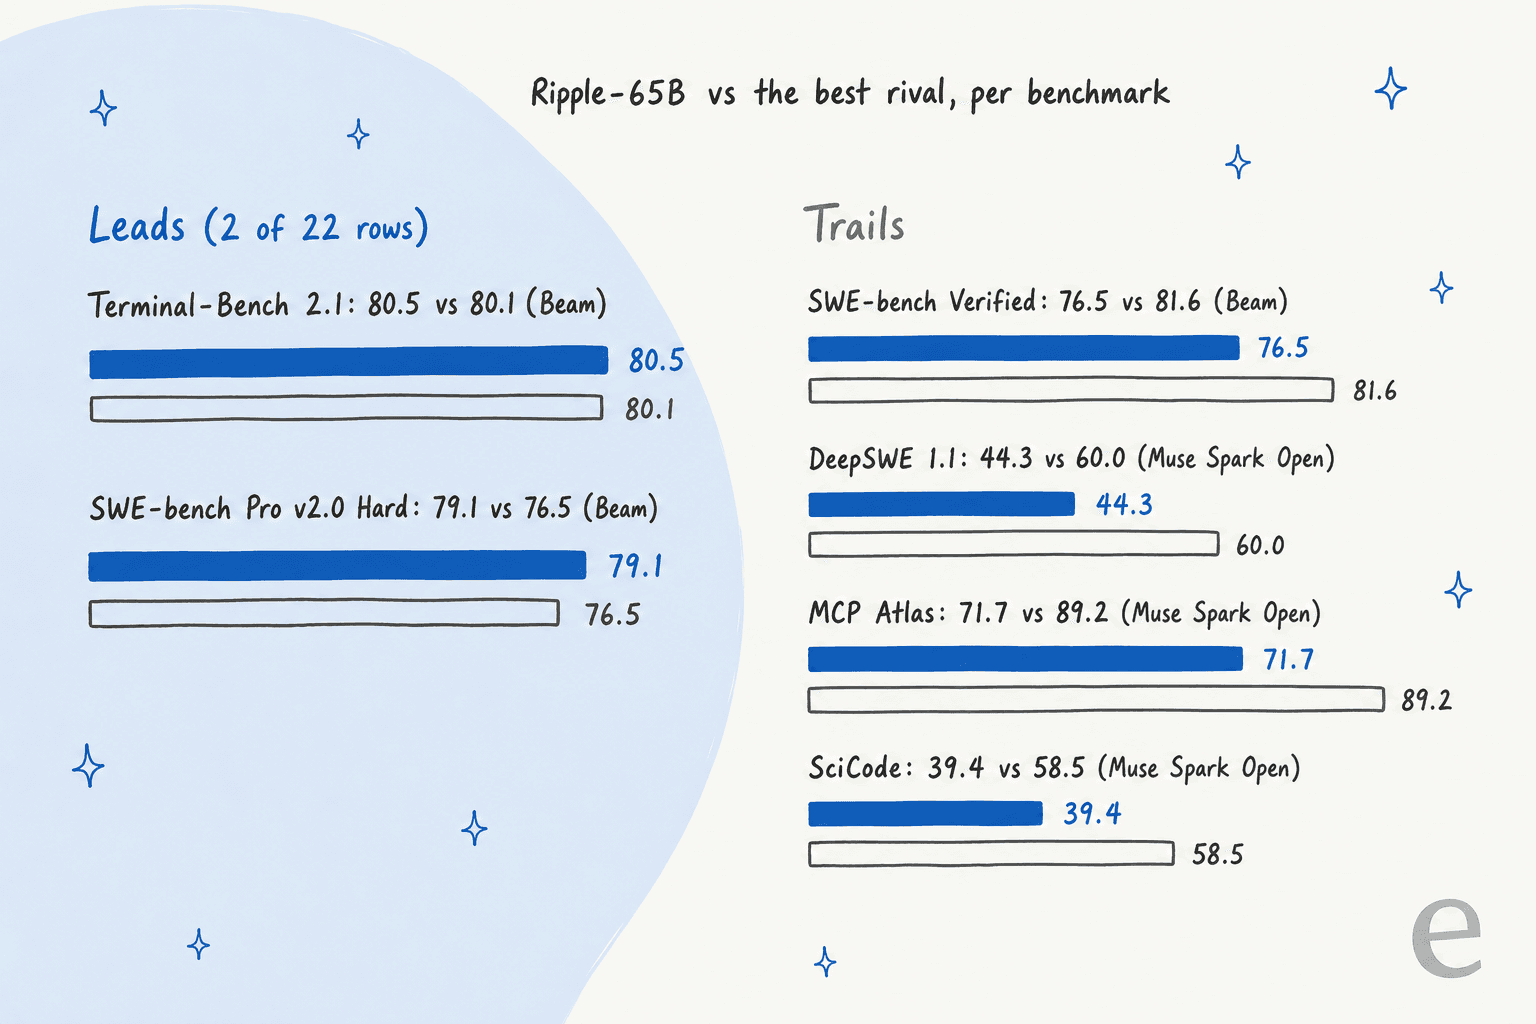
Al leer la tabla con atención destacan cuatro cosas.
- Lidera en 2 de 22 filas. Terminal-Bench 2.1 y SWE-bench Pro v2.0 Hard. En SWE-bench Verified y Pro v1.0 va por delante Reflection Beam. En DeepSWE, MCP Atlas y SciCode, Muse Spark Open.
- La repetición beneficia más a Ripple. Cuando Ricursive repitió Terminal-Bench 2.1 con el arnés oficial Terminus 2, Beam bajó de 80,1 a 70,8 mientras Muse Spark Open subió a 78,7. La ficha dice que las puntuaciones "were universally lower" en ese arnés salvo las de Muse, y califica sus resultados como "a best-effort attempt at a fair comparison." Es honesto, y también significa que la mayor distancia viene de las propias ejecuciones de prueba de Ricursive.
- Varias puntuaciones de los rivales son ejecuciones de Ricursive, no de los rivales. La ficha marca en cursiva los resultados propios, y esos cubren la mayoría de las cifras bajas, como el 2,0 de Inkling en SWE-bench Pro v2.0 Hard. El blog de lanzamiento de Ricursive muestra valores distintos para algunas de esas mismas celdas (39,6 para Inkling, 72,4 para Muse), así que trata esas filas con cuidado hasta que llegue el informe técnico.
- Se dejan fuera los modelos de pesos abiertos chinos. La comparación se plantea como "U.S. open-weight", así que no hay DeepSeek, Qwen ni Kimi en la tabla de instrucciones. Si tu lista corta incluye DeepSeek V4.1 Flash o Qwen 3.8 Flash Next, tendrás que hacer tu propia comparación.
Ninguno de estos benchmarks ha sido verificado todavía por un laboratorio externo. Hasta que alguien los repita, la lectura segura es "un modelo denso de 65B que compite con los mejores modelos de pesos abiertos de EE. UU. en programación", no "el mejor modelo de código de pesos abiertos".
¿Cuánto cuesta Ripple-65B?
Los pesos son gratuitos bajo Apache 2.0. Alojado, Ripple-65B cuesta $0.20 por millón de tokens de entrada y $0.60 por millón de tokens de salida, con la entrada en caché a $0.05. Es igual directamente en GMI Cloud y en OpenRouter, donde GMI Cloud es el único proveedor.
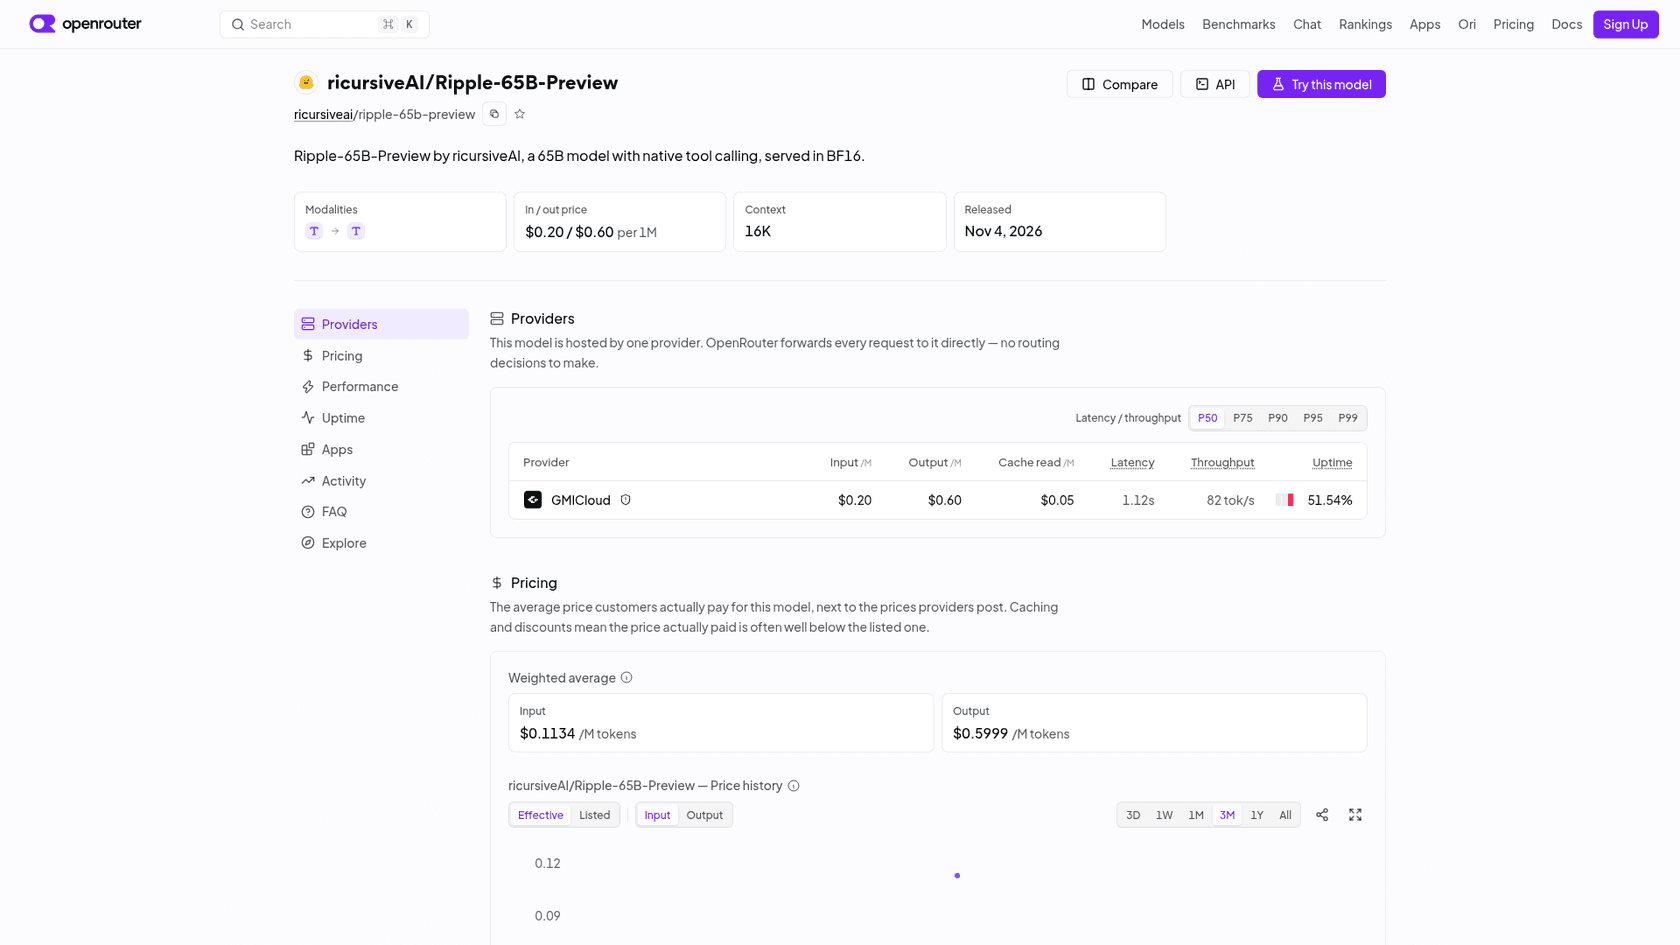
Así se compara con modelos cercanos, según los precios de lista de OpenRouter del 5 de noviembre de 2026:
| Modelo | Entrada / 1M | Salida / 1M | Entrada en caché / 1M | Contexto en OpenRouter |
|---|---|---|---|---|
| Ripple-65B Preview | $0.20 | $0.60 | $0.05 | 16,384 |
| Reflection Beam 501B | $0.25 | $1.00 | $0.05 | 1,048,576 |
| Muse Spark Open | $1.25 | $4.25 | $0.15 | 1,048,576 |
| Inkling | $1.00 | $4.05 | $0.17 | 524,288 |
| Inkling Small | $0.45 | $1.20 | $0.10 | 524,288 |
| DeepSeek V4.1 Flash | $0.045 | $0.50 | $0.018 | 1,048,576 |
| GPT-5.6 Luna | $0.20 | $1.20 | $0.02 | 1,050,000 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | $0.10 | 1,000,000 |
Ripple es la opción de pesos abiertos estadounidense más barata en salida de esa tabla. Dos cosas del listado importan más que el precio, sin embargo.
- El contexto alojado es de 16K. OpenRouter lo limita a 16.384 tokens con un máximo de salida de 14.745, aunque la ficha del modelo y la propia página de GMI dicen 1M. Un agente de código trabajando en un repositorio real consume 16K enseguida, así que revisa esto antes de conectar Ripple a nada.
- Un solo proveedor implica poca capacidad. Con GMI Cloud como único anfitrión, el panel de disponibilidad de OpenRouter mostraba cerca del 51 % del día anterior cuando lo comprobé. Ricursive también dijo que Ripple llegaría a Together AI y Fireworks. El 5 de noviembre, la página de Together aún decía "This model is coming soon to Together's Serverless API."
¿Se puede ejecutar Ripple-65B en local?
Sí, en hardware de NVIDIA, y esta es la parte más interesante del lanzamiento. Ricursive distribuye dos configuraciones documentadas, y la ventana de contexto que obtienes depende de cuál elijas.
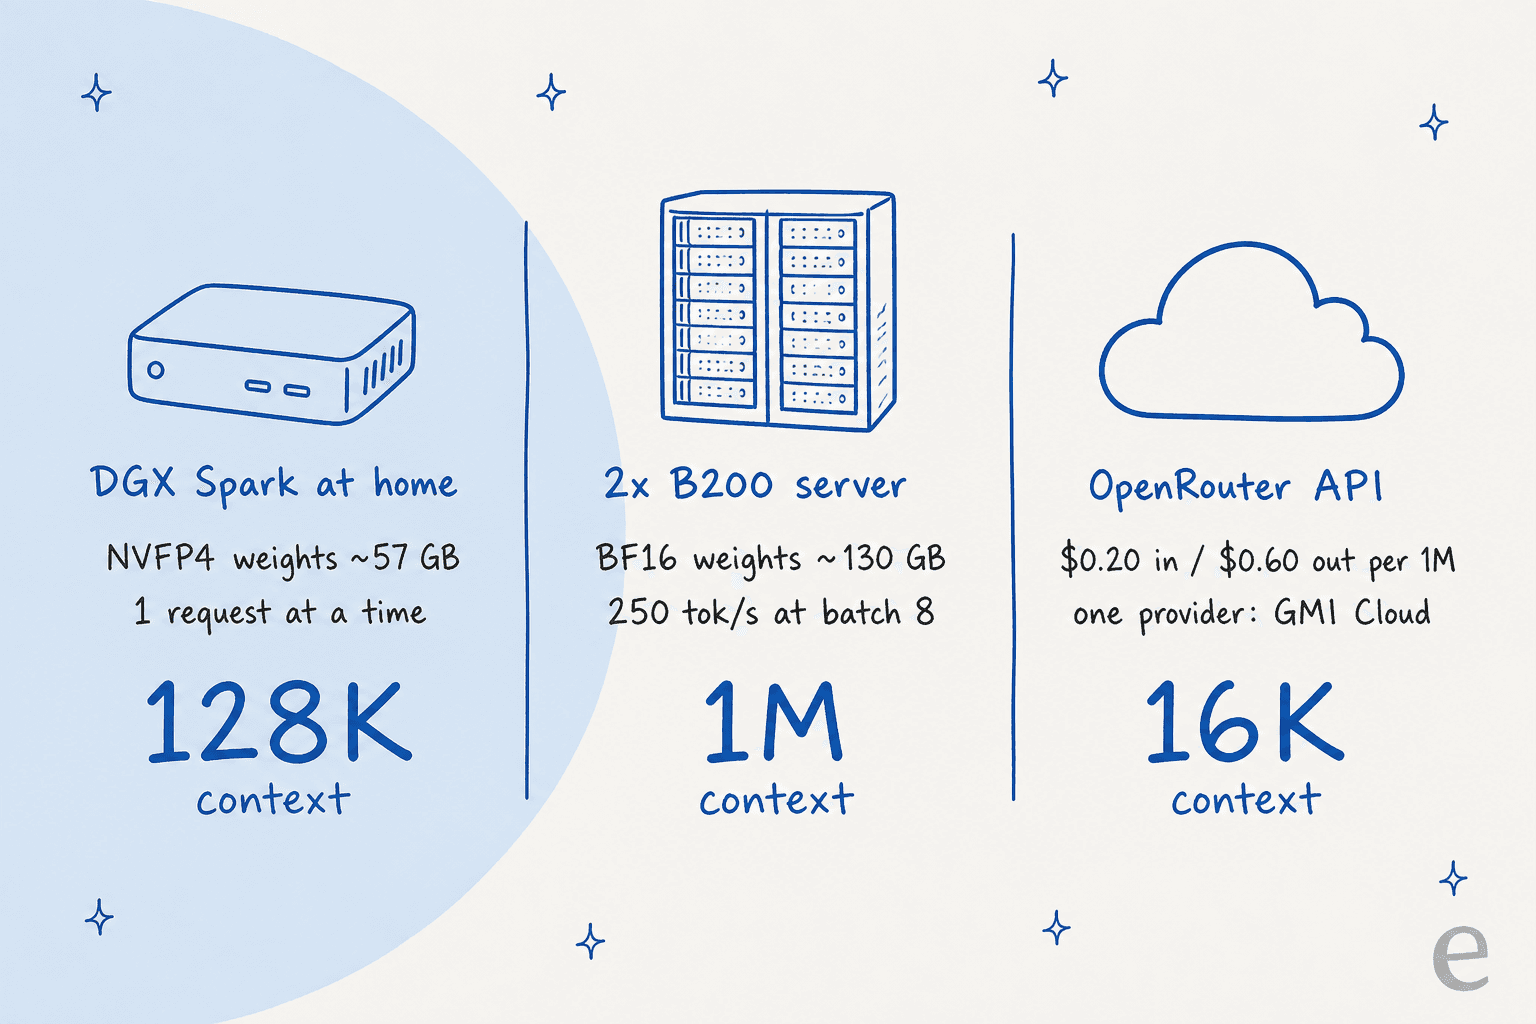
En un DGX Spark. El repositorio NVFP4 incluye un notebook y un script spark.py para la caja de IA de escritorio de NVIDIA. Carga los pesos NVFP4 (4 bits para las capas feed-forward, BF16 para la atención) más el modelo borrador DFlash2, y atiende una solicitud a la vez con 128K de contexto. El script se niega a ejecutarse en cualquier cosa que no sea un chip GB10. Ricursive no publica una cifra de tokens por segundo para el Spark.
En dos GPU B200. El repositorio BF16 trae una configuración de servidor con SGLang 0.5.19 que atiende el contexto completo de 1M, y Ricursive cita "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels." Con cuatro GPU obtienes dos copias independientes.
En un Mac o cualquier otra cosa. No hay vía oficial. La publicación de lanzamiento del cofundador decía "You can run Ripple-65B locally and efficiently on a MacBook Pro", pero no aparecen instrucciones para MacBook, MLX ni llama.cpp en el blog ni en ninguna de las cuatro fichas de modelo. Las conversiones GGUF de la comunidad aparecieron en Hugging Face en un día; Ricursive no las ha probado.
La velocidad es la incógnita. Un modelo denso lee todos los pesos para cada token, así que depende mucho del ancho de banda de memoria, el punto débil del Spark. Eso salió a la luz a las pocas horas del lanzamiento:
"What tok/s are you getting on the Spark? 65B dense on ~273GB/s of memory bandwidth has to crawl in an agent loop."
El modelo borrador es la respuesta de Ricursive a eso, ya que la decodificación especulativa permite que el modelo pequeño adivine varios tokens que el grande verifica en una sola pasada. Si eso lleva los bucles de agente a una velocidad utilizable en un Spark es algo que nadie había medido públicamente al 5 de noviembre.
¿Cómo se llama a Ripple-65B desde código?
Tanto GMI Cloud como OpenRouter exponen un endpoint de chat compatible con OpenAI, así que funciona cualquier SDK o framework de agentes que hable ese formato. En OpenRouter el ID del modelo es ricursiveai/ripple-65b-preview:
curl https://openrouter.ai/api/v1/chat/completions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "ricursiveai/ripple-65b-preview",
    "messages": [{"role": "user", "content": "Write a bash one-liner that finds the 10 largest files in a repo."}],
    "temperature": 0
  }'
Algunos detalles de la plantilla de chat que conviene conocer antes de construir sobre ella:
- La llamada a herramientas es nativa. Las herramientas van en el prompt del sistema y las llamadas vuelven como JSON dentro de etiquetas
<tool_call>, que el parserripplede SGLang convierte entool_callsestándar. Si fuerzas una llamada contool_choice: "required", definestrict: true, porque Ricursive encontró que "non-strict required calls produced extra argument fields." - El razonamiento siempre está activo. La plantilla envuelve el pensamiento en etiquetas
<think>y "does not implement a thinking on/off switch or reasoning-effort levels." Pagas tokens de salida por ese pensamiento en cada llamada. - Sin valores de muestreo por defecto. Ricursive no publica una temperatura recomendada; sus propios ejemplos usan 0.
Si piensas manejar Ripple desde un agente de código como Claude Code o una CLI de programación con agentes, el contexto alojado de 16K es el límite con el que chocarás primero. Alojarlo tú mismo es hoy la forma de evitarlo.
¿Qué dicen los desarrolladores sobre Ripple-65B?
El principal hilo de Hacker News alcanzó 181 puntos y 61 comentarios el día del lanzamiento. Dominaron dos temas: el planteamiento de los benchmarks y si un modelo denso de 65B es práctico en casa.
Sobre el planteamiento, la queja más común fue que la comparación se detiene en los modelos de EE. UU.:
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"

Otros señalaron el tamaño de la propia ventaja:
"Still they score 0.42 percentage points higher than the second-best model on their chosen benchmark, so it's hardly a meaningful lead."
El contrapunto vino de personas para quienes "fabricado en EE. UU." es un requisito real, no una etiqueta de marketing:
"US Gov won't let Chinese models be hosted on any internal infra ... So there is absolutely a market for US-made or non-Chinese models there."
Sobre ejecutarlo en casa, las opiniones se dividieron. Un comentarista esperaba que "inference will be prohibitively slow on consumer grade hardware" y interpretó el lanzamiento como dirigido a equipos de diseño de chips en entornos aislados, lo que encaja con el propio negocio de Ricursive. Los dueños de Mac Studio con mucha memoria fueron más optimistas, ya que 130 GB de pesos quedan muy por debajo de lo que caben en sus clústeres. Nadie había publicado velocidades medidas a la mañana del 5 de noviembre.
La afirmación sobre el coste fue la mejor recibida. swyx calificó el lanzamiento de "the avengers of open model SOTA" y citó la nota al pie de que los $32M cubren todo el esfuerzo de I+D, el detalle que a más gente le pareció llamativo.
¿Deberías usar Ripple-65B para atención al cliente?
Probablemente no como el cerebro de un bot de soporte, y la razón es el encaje, no la calidad. Ripple-65B es un modelo de código con un posentrenamiento ligero. Las filas de la propia tabla de Ricursive más cercanas al trabajo de soporte son mediocres: 31,27 en τ³-bench banca, que mide conversaciones de cumplimiento de políticas con un cliente (Beam logra 36,1), y 71,67 en MCP Atlas, que mide el uso de herramientas (Muse Spark Open logra 89,2). El único caso fuerte es el control de datos: si los datos de los clientes nunca pueden salir de tu red, un modelo Apache 2.0 en tu propio hardware es una opción real, y Ripple es uno de los más pequeños y potentes.
Aun así, el modelo es la parte fácil. Para responder bien a los tickets también necesitas conexiones con la base de conocimiento, reglas de escalamiento, protecciones contra respuestas inventadas y una forma de revisar las respuestas antes de que las vean los clientes. Ese es el dilema de construir o comprar IA para soporte, y es la mayor parte del trabajo.
Ese hueco es el que cubre eesel. eesel es una plataforma de compañeros de equipo de IA, y su compañero de IA para helpdesk se une a tu helpdesk actual, aprende de tu centro de ayuda y de tickets pasados, y trabaja en tu cola. He visto bots que suenan seguros dar respuestas erróneas en colas reales, por eso cada despliegue de eesel se ejecuta primero contra tickets históricos, para que puedas leer lo que habría dicho antes de que toque a un cliente.
Timengo es un buen ejemplo en el extremo técnico. Vende software de correo seguro y Digital Post en Dinamarca, y eesel redacta sus respuestas de soporte técnico en danés a partir de unos 5.300 tickets pasados y artículos del centro de ayuda, preparando alrededor de 300 tickets de Freshdesk al mes. SE Ranking ejecuta tres productos en Zendesk con un agente de eesel cada uno, que gestionaron 4.650 conversaciones en un mes.
Y si te interesó Ripple porque te gusta trabajar desde la terminal, la CLI de eesel encaja con ese hábito. Un agente de código puede usarla para subir conocimiento aprobado como artículos de ayuda y macros exportados, editar las instrucciones del compañero de equipo y hacer preguntas de prueba para comprobar las respuestas antes de que nada salga en vivo. Conectar el propio helpdesk sigue requiriendo que alguien con acceso de administrador lo apruebe. Hay más sobre ese flujo en gestionar agentes desde la terminal.
¿Quién debería usar Ripple-65B?
Esta es mi opinión después de leer todos los archivos que publicó Ricursive:
- Pruébalo si quieres un modelo de código que sea totalmente tuyo. Apache 2.0, una vía local en una sola máquina y $0.60 por millón de tokens de salida alojado hacen barato probarlo contra tu propio repositorio, y es un candidato natural para equipos que solo pueden ejecutar modelos fabricados en EE. UU.
- Alójalo tú mismo si necesitas contexto largo. El límite alojado de 16K descarta el trabajo serio con agentes hoy; el contexto de 1M solo llega con tus propias GPU.
- Espera si necesitas pruebas. Todavía no hay informe técnico, las fuentes de los benchmarks discrepan en algunas celdas y ningún laboratorio externo ha repetido las cifras. Unas semanas de pruebas independientes aclararán mucho.
- Busca en otra parte si el precio lo decide todo. DeepSeek V4.1 Flash es más barato en entrada y salida, y Kimi K3.1 Pro se ha probado más ampliamente. Para una lista más amplia, consulta las mejores herramientas de asistente de programación con IA.
El resumen justo: Ripple-65B Preview muestra que un equipo pequeño con un modelo denso de 65B puede llegar al mismo rango que modelos de pesos abiertos de EE. UU. de ocho a quince veces su tamaño en programación, por unos $32M declarados. Es un resultado real. "Estado del arte" solo se sostiene dentro de una categoría estrecha, y la forma de saber si se sostiene para tu trabajo es ejecutarlo con tus propias tareas.
Prueba eesel
Si llegaste a Ripple-65B esperando que un modelo abierto pudiera quitarle tickets a tu equipo, puedes ahorrarte construir tú mismo la capa de soporte. El compañero de IA para helpdesk de eesel se conecta en minutos con Zendesk, Freshdesk, Gorgias y más, aprende de tus tickets pasados y te muestra cómo los habría respondido antes de salir en vivo. Los planes empiezan en $299 al mes, y hay un nivel gratuito para probar.

Prueba eesel gratis.