

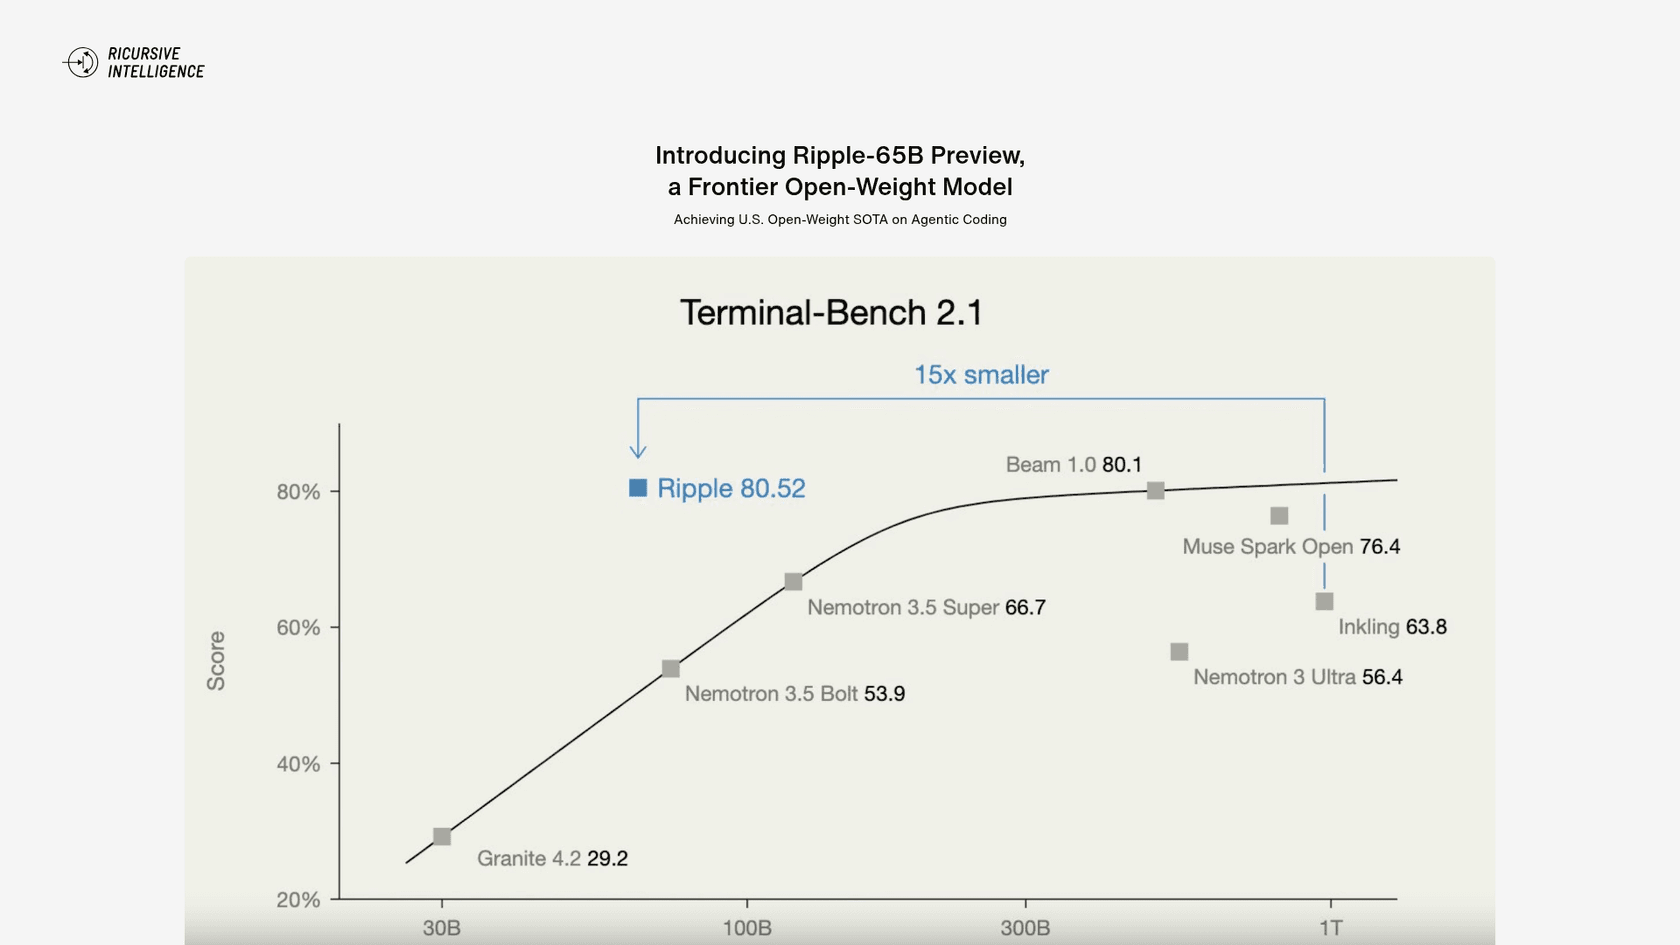
Ripple-65B es el mejor modelo abierto fabricado en EE. UU. que puedes ejecutar en una sola máquina, pero no es el mejor modelo abierto de programación en general. Obtiene 80.5 en Terminal-Bench 2.1, un pelo por encima de Beam de Reflection (80.1), un modelo casi ocho veces más grande. Fuera de esa fila, Beam lidera en cinco pruebas de programación y agentes, y su API ofrece 1M de tokens de contexto frente a los 16,384 de Ripple.
Mi veredicto: 3.5/5. Elige Ripple si quieres pesos estadounidenses con Apache 2.0 que quepan en un DGX Spark; usa Beam si solo quieres una API. Para un agente de soporte, un compañero ya hecho como eesel te ahorra elegir modelo, y su CLI permite que un agente de programación cargue tus documentos de ayuda y pruebe respuestas antes de salir en vivo.
¿Qué es Ripple-65B, en un minuto?
Ripple-65B Preview es un modelo de lenguaje de pesos abiertos lanzado el 4 de noviembre de 2026 por Ricursive Intelligence, un laboratorio que crea IA para diseño de chips. Ricursive lo entrenó desde cero y lo describe como "a general-purpose variant of the proprietary model that powers our AI chip design platform." Si quieres el repaso completo de las especificaciones, el explicativo de Ripple-65B de mi colega lo cubre; este artículo es el veredicto.
La ficha técnica, de la model card:
| Especificación | Ripple-65B Preview |
|---|---|
| Parámetros | 65B en total, todos activos (denso, no mezcla de expertos) |
| Capas | 80, con 4 capas de ventana deslizante por cada capa global |
| Datos de entrenamiento | 12T tokens, solo texto, sobre todo inglés y código |
| Contexto (declarado) | Hasta 1M de tokens |
| Licencia | Apache 2.0 |
| Checkpoints | BF16 instruct, NVFP4 instruct (experimental), base, modelo borrador DFlash2 |
| Razonamiento | Siempre piensa en etiquetas <think>, sin interruptor ni niveles de esfuerzo |
| Coste total de I+D | $32M, según Ricursive |
Esa última fila es de lo que habla todo el mundo. Ricursive dice que $32M cubren todo su coste de investigación y desarrollo desde cero, y lo califica como "one-tenth the cost of the previous open-weight SOTA on agentic coding." La nota al pie muestra que ese "one-tenth" es la estimación propia de Ricursive de la factura de cómputo de Beam, construida a partir de un reportaje y del calendario de entrenamiento de Reflection, así que tómalo como una comparación aproximada y no auditada.
¿Cómo lo analicé?
Construyo las integraciones detrás de los agentes de IA de eesel, así que leo una model card como leería la especificación de una API antes de llevarla a producción: cuáles son las cifras, de dónde salen y qué falla cuando de verdad la llamas. Algo que los años de eesel poniendo agentes en helpdesks reales me han enseñado es que un ranking no te dice qué hace un modelo con tus propios tickets, por eso cada despliegue de eesel se simula con tickets pasados antes de salir en vivo.
Con Ripple no tuve acceso a la API para ejecutar mi propio conjunto de pruebas el día del lanzamiento, así que este análisis se basa solo en fuentes primarias:
- La publicación de lanzamiento de Ricursive, más su model card en Hugging Face con los scripts de inferencia.
- Los listados en vivo de OpenRouter, GMI Cloud y Together AI, revisados el 5 de noviembre de 2026.
- El primer día de reacciones de desarrolladores en Hacker News y X.
Ripple aún no está en Artificial Analysis, así que cada benchmark de abajo es una cifra de Ricursive. Diré de qué página sale cada una porque, como verás, las dos páginas no siempre coinciden.
¿Cómo puntúa Ripple-65B frente a Beam y los demás modelos abiertos de EE. UU.?
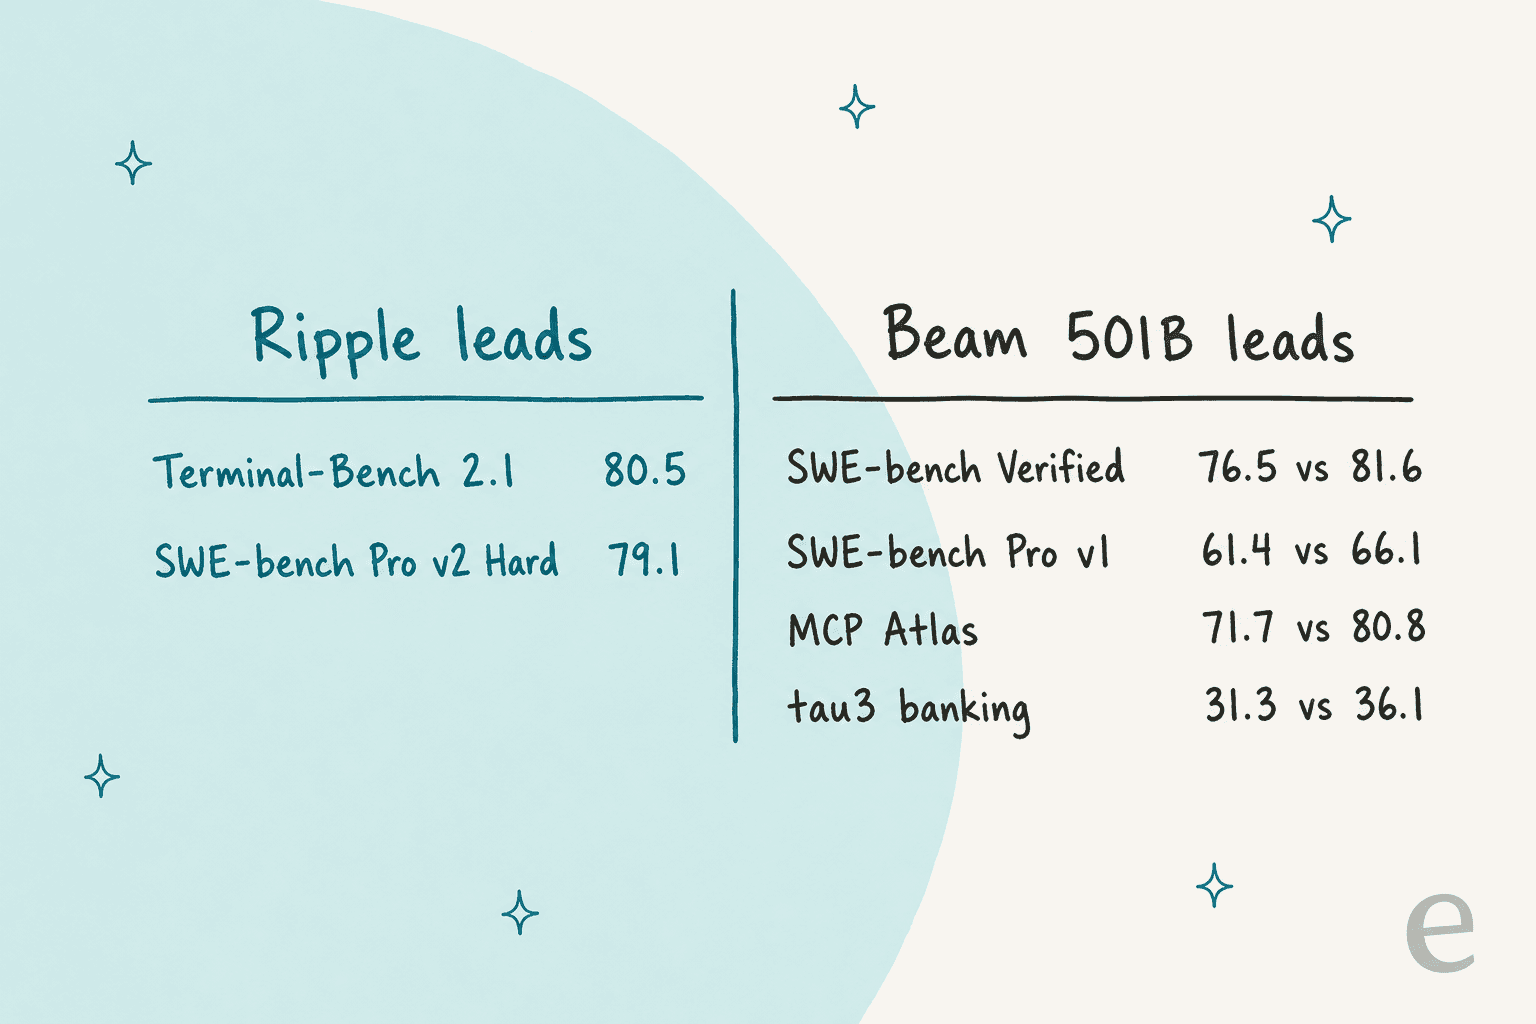
En las dos filas con las que Ricursive abre, Ripple gana. En la mayoría de las demás, no. Esta es la tabla instruct de la model card, recortada a las filas de programación y agentes que importan a quien compra un modelo de programación:
| Benchmark | Ripple-65B | Beam 501B | Muse Spark Open 816B | Inkling 975B | Nemotron 3 Ultra 550B |
|---|---|---|---|---|---|
| Terminal-Bench 2.1 (autodeclarado) | 80.5 | 80.1 | 76.4 | 63.8 | 56.4 |
| SWE-bench Pro v2.0 Hard | 79.1 | 76.5 | 52.3 | 2.0 | 30.7 |
| SWE-bench Verified | 76.5 | 81.6 | 78.7 | 77.6 | 71.9 |
| SWE-bench Pro v1.0 | 61.42 | 66.1 | 58.2 | 54.3 | 46.9 |
| DeepSWE 1.1 | 44.3 | 43.3 | 60.0 | 1.8 | 0.2 |
| MCP Atlas | 71.67 | 80.8 | 89.2 | 76.0 | 62.2 |
| τ³-bench banking | 31.27 | 36.1 | 14.4 | 23.7 | 22.6 |
| SciCode | 39.4 | 49.2 | 58.5 | 46.1 | 44.6 |
Dos cosas destacan. Primero, la ventaja en Terminal-Bench sobre Beam es de 0.4 puntos, un empate en cualquier lectura honesta. Segundo, Beam supera a Ripple en cinco filas de programación y agentes, y Muse Spark Open, que cubrí en mi análisis de Muse Spark Open, se lleva DeepSWE, MCP Atlas y SciCode.
Dicho esto, que un modelo de 65B iguale a uno de 501B en su mejor fila sigue siendo un resultado real. Beam tiene 23B de parámetros activos por token y Ripple tiene los 65B activos, así que la comparación es menos desigual de lo que sugiere "8x más pequeño", pero en términos de memoria Ripple es mucho más fácil de alojar.
¿En qué cifras puedes confiar?
Ricursive es franco sobre el desorden. La model card dice que las puntuaciones de la competencia son "official model card scores where available", y el resto son ejecuciones internas propias. También señala que las puntuaciones de Terminal-Bench 2.1 resultaron "universally lower (with the exception of Muse Spark Open)" en el arnés oficial Terminus 2, así que informa de ambas.
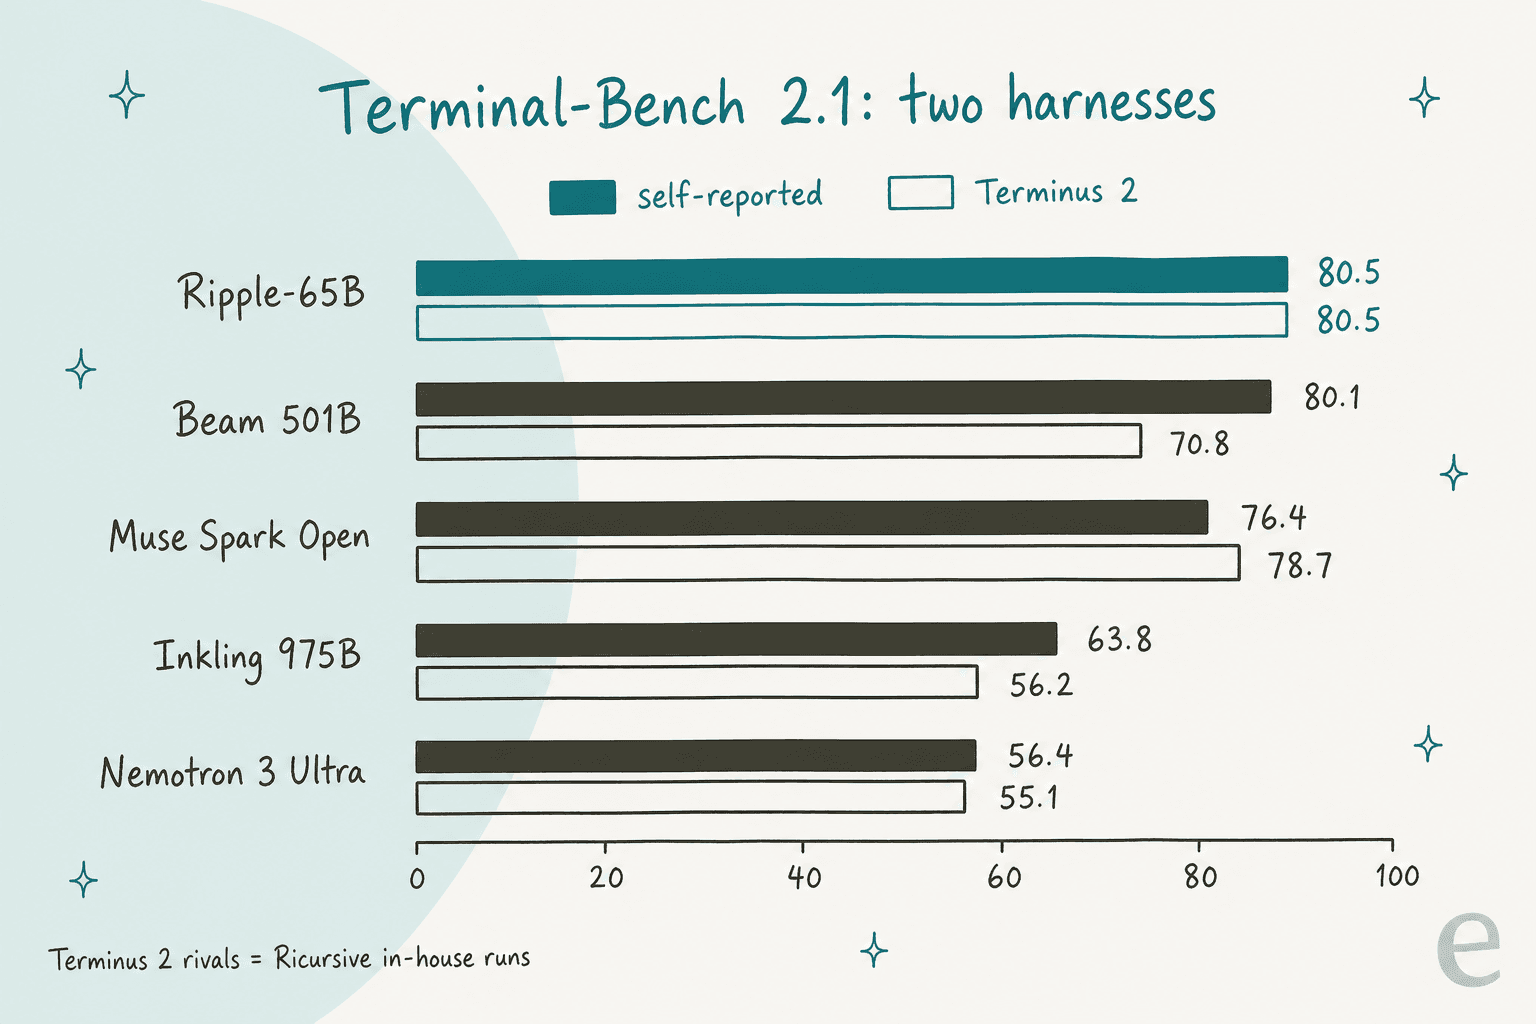
En el mismo arnés Terminus 2, la ventaja de Ripple sobre Beam crece a casi 10 puntos (80.5 frente a 70.8). Es la cifra más interesante del lanzamiento y también la que yo verificaría primero, porque la cifra de Beam ahí es una ejecución de Ricursive, no de Reflection.
Otra arruga: el gráfico de lanzamiento y la model card discrepan en algunas puntuaciones de la competencia. En SWE-bench Pro v2.0 Hard, la publicación de lanzamiento muestra a Muse Spark Open en 72.4 e Inkling en 39.6, mientras que la model card tiene 52.3 y 2.0. Las cifras de Ripple coinciden en ambas páginas. Es un lanzamiento en vista previa y probablemente se concilien, pero hasta entonces trataría las columnas de la competencia como aproximadas.
¿Cuánto cuesta Ripple-65B?
Ripple es barato de llamar, con un gran inconveniente. Los precios de abajo son el listado de cada proveedor, revisados el 5 de noviembre de 2026:
| Vía | Entrada / 1M | Salida / 1M | Lectura en caché / 1M | Contexto |
|---|---|---|---|---|
| GMI Cloud | $0.20 | $0.60 | $0.05 | 1,000,000 listado |
| OpenRouter (servido por GMI) | $0.20 | $0.60 | $0.05 | 16,384, salida máx. 14,745 |
| Together AI | Próximamente | Próximamente | n/a | 1M listado |
| Pesos en Hugging Face | Gratis (Apache 2.0) | Tu hardware | n/a | Hasta 1M en 2x B200 |
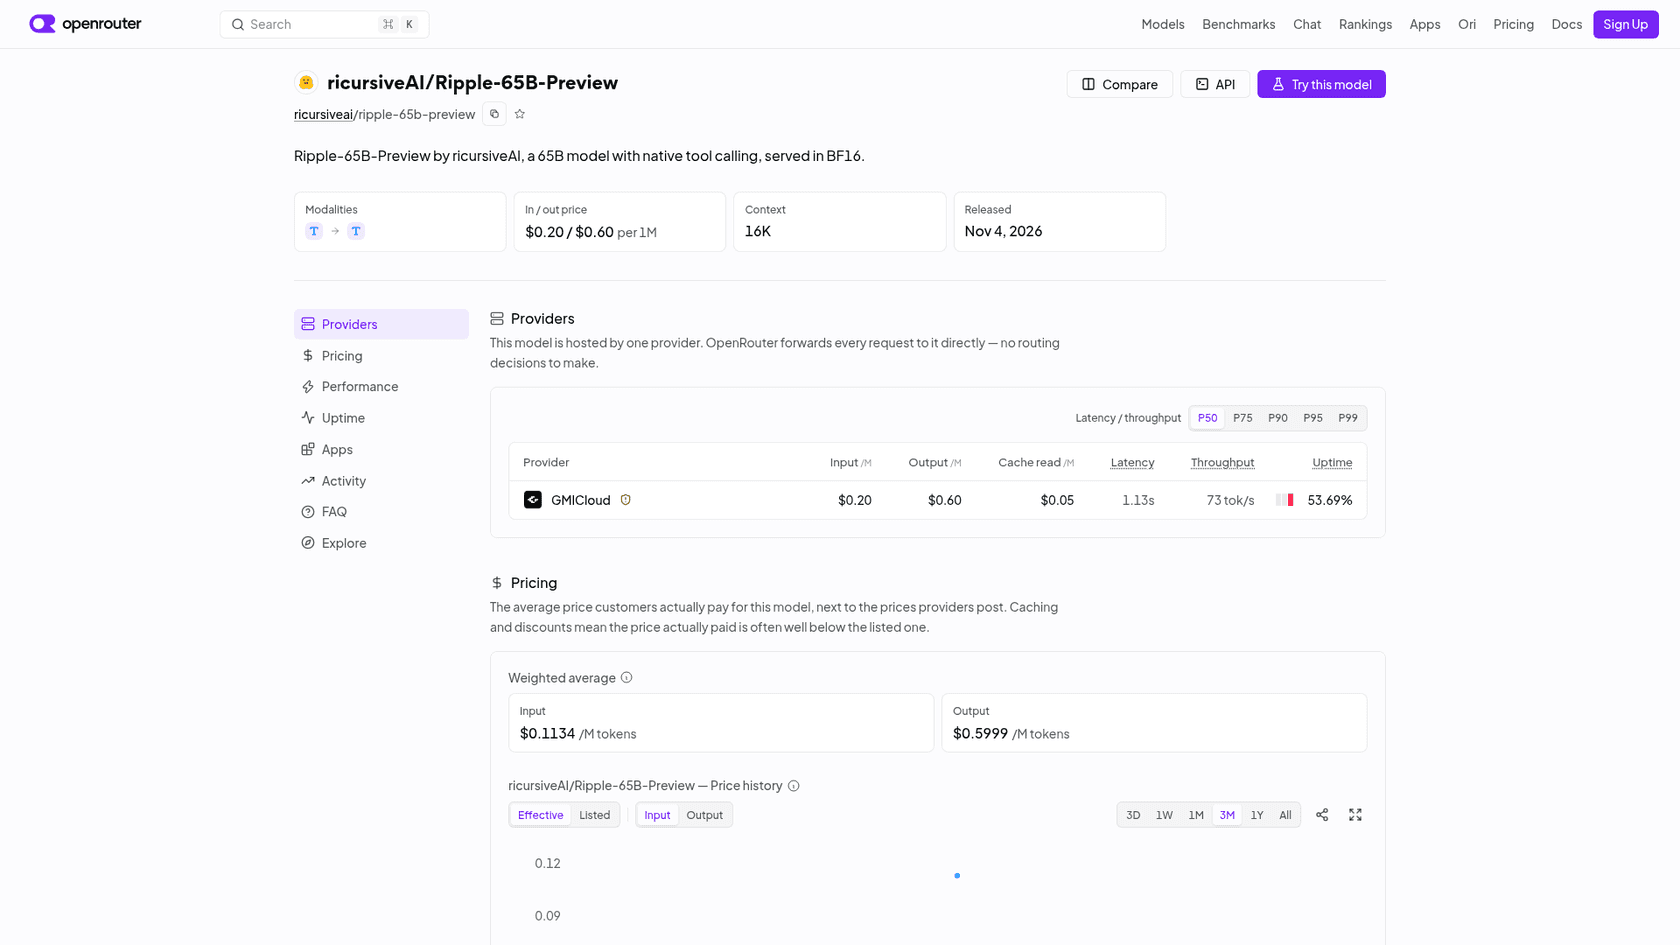
El inconveniente es esa ventana de 16K. Un agente de programación como Claude Code o las herramientas de mi guía de programación con IA en terminal puede consumir 16,384 tokens antes de terminar de leer el repositorio. A través de OpenRouter hoy, Ripple se queda corto de vista para la programación con agentes para la que fue creado. Cuando capturé la página, también mostraba un único proveedor con 53.69% de disponibilidad y 73 tokens por segundo, lo cual es normal en el segundo día, pero no es algo que poner en producción todavía.
Así sale el precio de una sesión de 10M de tokens de entrada y 1M de salida frente a los rivales abiertos, con los precios de lista de OpenRouter:
| Modelo | Entrada / salida por 1M | Coste de 10M entrada + 1M salida | Contexto en OpenRouter |
|---|---|---|---|
| Ripple-65B Preview | $0.20 / $0.60 | $2.60 | 16,384 |
| Beam 1.0 501B | $0.25 / $1.00 | $3.50 | 1,048,576 |
| Qwen3.8 27B | $0.15 / $1.875 | $3.38 | 1,024,000 |
| DeepSeek V4.1 Flash | $0.045 / $0.50 | $0.95 | 1,048,576 |
| Inkling | $1.00 / $4.05 | $14.05 | 524,288 |
| Muse Spark Open | $1.25 / $4.25 | $16.75 | 1,048,576 |
Así que Ripple es $0.90 más barato que Beam en esa sesión, con 64 veces menos contexto. Para la mayoría de compradores de API ese intercambio no compensa. DeepSeek V4 Flash sigue siendo la opción económica, y Qwen 3.8 es la comparación obvia no estadounidense que Ricursive dejó fuera de su gráfico. Igual que Kimi K3.
¿Puedes ejecutarlo de verdad en tu propio hardware?
Sí, y aquí es donde Ripple se gana su sitio. Un modelo denso de 65B es lo bastante pequeño para caber en una máquina, y Ricursive incluye los scripts para hacerlo. Lo que el marketing del día del lanzamiento pasa por alto es cuánto te exige cada vía:
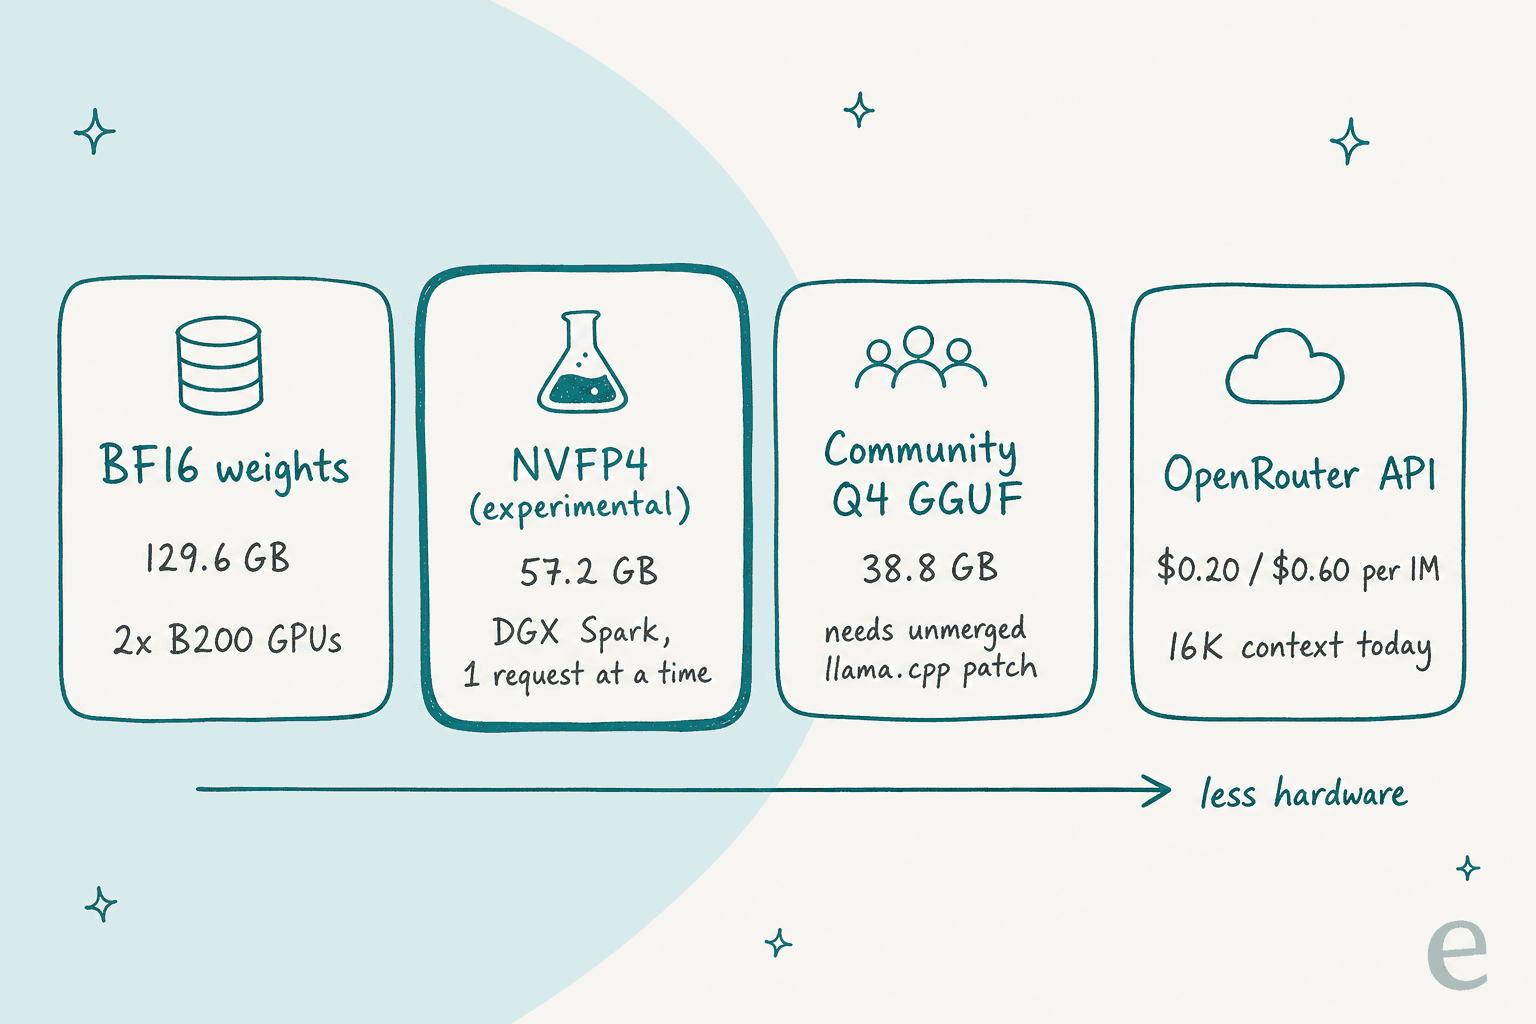
- BF16 en 2x B200. El README del servidor usa SGLang 0.5.19 con el modelo borrador DFlash2 y 1M de contexto por defecto. La ficha cita
250tokens por segundo con lote 8. - NVFP4 en un DGX Spark. El checkpoint NVFP4 está etiquetado como experimental, mantiene la atención en BF16, y el script local procesa una solicitud a la vez con 128K de contexto.
- GGUF de la comunidad. La cuantización de AtomicChat pesa
38.8 GBen Q4_K_M, pero llama.cpp, Ollama y LM Studio estándar no pueden cargarla hasta que llegue un parche de llama.cpp. - Sin build de MLX. El cofundador de Ricursive publicó que se puede ejecutar "on a MacBook Pro", pero ninguna guía oficial cubre aún Apple Silicon.
Un comentarista de Hacker News resumió bien el equilibrio de los modelos densos:
"it's a 65B dense model and inference will be prohibitively slow on consumer grade hardware"

Y el otro lado, de alguien con el hardware adecuado:
"Speaking as someone who has High-Memory Mac Studios, it is great that there is finally a model that will run at usable speeds with high quality."
Dos inconvenientes menores para quien lo integre en un agente. La plantilla de chat "does not implement a thinking on/off switch or reasoning-effort levels", así que cada respuesta paga una pasada de razonamiento. Y forzar una llamada a herramienta requiere esquemas estrictos: la ficha advierte que "Non-strict required calls produced extra argument fields." El endpoint de OpenRouter solo acepta por ahora tool_choice con none o auto.
¿Qué dicen los desarrolladores?
La reacción del primer día se divide con claridad. El coste de entrenamiento recibe elogios de casi todos, y el planteamiento de "estado del arte" recibe críticas. Del lado de X:
"this is like the avengers of open model SOTA"
Eso fue swyx reaccionando a la cifra de $32M de I+D total. En Hacker News, donde el hilo alcanzó 182 puntos, la queja con más respuestas fue la categoría tan estrecha:
"Category narrowing to this degree really has diluted the term "SOTA" quite a lot"
Varios comentaristas señalaron que el gráfico compara solo modelos abiertos de EE. UU. y deja fuera a Qwen. Uno puso la cifra de Terminal-Bench de Ripple junto a la de Alibaba:
"This model scores 80.5 on Terminal Bench 2.1 For reference Qwen 3.8 Flash Next (which is bigger than this model but probably cheaper to run due to MoE) scores 84.3, and Qwen 3.8-27B scores 73.0."
Y el comentario que, para mí, explica a quién va realmente dirigido este modelo:
"There are several situations where some of us are explicitly prohibited from using models from companies not under the jurisdiction of the United States."
Ese es el mercado real. Si tu equipo de seguridad ha descartado los pesos de laboratorios chinos, las alternativas de este tamaño eran escasas, y Ripple es ahora el modelo abierto estadounidense más potente que cabe en una sola estación de trabajo.
¿Deberías usar Ripple-65B para un agente de soporte?
No sería mi primera opción, y el motivo está en la propia tabla de Ricursive. τ³-bench banking es lo más parecido en la ficha a una prueba de atención al cliente: un agente que sigue políticas y llama a herramientas para un cliente de un banco. Ripple obtiene 31.27, por detrás de los 36.1 de Beam. Suma el razonamiento siempre activo (primeras respuestas más lentas), el posentrenamiento ligero "with a focus on agentic coding" y los 16K de contexto alojado, y está hecho para otro trabajo. Mi guía del mejor LLM para soporte profundiza en lo que importa ahí.
Lo más importante es que un modelo es infraestructura. Para un equipo de soporte, lo difícil es todo lo que lo rodea: leer el helpdesk, aprender de tickets pasados, saber cuándo traspasar. Para eso existe eesel. Es un compañero de IA que contratas para un trabajo, como el compañero de IA para helpdesk, en lugar de un modelo que alojas. Tres clientes muestran cómo funciona:
- SE Ranking ejecuta un agente de eesel por producto en Zendesk y gestionó
4,650conversaciones en un mes, pasando al equipo los reembolsos, las ampliaciones de prueba y las consultas de nivel 2. - Timengo lo usa en Freshdesk para redactar respuestas a tickets técnicos a partir de unos
5,300tickets pasados y artículos de ayuda, y eesel nunca responde por sí solo a un cliente allí. - SamCart ejecuta agentes separados en Freshdesk y en el chat del sitio web, respondiendo a partir de unos
280artículos del centro de ayuda.
Si te gusta manejar herramientas desde la terminal, la CLI de eesel permite que un agente de programación como Claude Code, Codex o Cursor suba conocimiento aprobado, como artículos de ayuda y políticas exportados, y luego haga preguntas de prueba al agente con eesel chat y revise las respuestas antes de que nada salga en vivo. Conectar el propio helpdesk sigue necesitando a alguien con acceso de administrador que lo apruebe. Más sobre ese patrón en la guía de la CLI de agentes de IA, y el explicativo del servidor MCP cubre la otra vía de entrada.
Los inconvenientes antes de cambiar
- El contexto alojado es de 16K. Suficiente para un chat, demasiado pequeño para trabajo de agentes a escala de repositorio hasta que GMI o Together lo amplíen.
- Los benchmarks aún no son independientes. No hay entrada en Artificial Analysis, y el gráfico de lanzamiento y la model card discrepan en algunas puntuaciones de la competencia.
- La instalación local prioriza NVIDIA. Las vías oficiales necesitan B200 o un DGX Spark; los usuarios de Mac esperan builds de la comunidad.
- Siempre piensa. No hay forma de desactivar el razonamiento para respuestas rápidas y sencillas.
- Es una vista previa. Ricursive califica el posentrenamiento de "relatively light", y el build NVFP4 es experimental.
Veredicto: ¿quién debería ejecutar Ripple-65B?
Mi puntuación: 3.5/5. Ripple es un primer modelo impresionante de un equipo de entrenamiento de cinco personas, y la cifra de $32M de coste total importa para el rumbo de los modelos abiertos. Pero la victoria principal es un empate de 0,4 puntos, y quien compare modelos por sus propios méritos verá a Beam por delante en más filas.
- Úsalo si necesitas pesos Apache 2.0 de un laboratorio estadounidense, tienes un DGX Spark o un par de B200, y tu agente vive en una terminal. Es un nicho real, y Ripple lo domina.
- Descártalo si llamas a una API. Beam 1.0 cuesta
$0.25/$1.00con una ventana de 1M, y DeepSeek V4 Flash es mucho más barato si el origen del laboratorio no te importa. - Espera un mes si usas un Mac. Cuando se fusione el soporte de llama.cpp y alguien publique cifras reales de tokens por segundo, el caso local quedará mucho más claro.
Para el panorama más amplio, mi análisis de Inkling cubre el mayor modelo abierto de EE. UU. El análisis de GLM-5.3 Flash cubre una opción china más barata.
El listado de alternativas a Kimi K3 clasifica los modelos abiertos lado a lado. Del lado cerrado, Claude Sonnet 5.5 sigue siendo el modelo por defecto de la mayoría de los agentes de programación, con GPT-5.6 pisándole los talones.
Prueba eesel
Si llegaste aquí porque estás eligiendo un modelo para un agente de soporte, puedes saltarte ese paso. eesel es un compañero de IA que se conecta a Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y se prueba con tus conversaciones reales antes de responder a nadie. SE Ranking pasó de la configuración a 4,650 conversaciones al mes en tres productos. Los planes empiezan en $299/month por 500 créditos en la página de precios, con prueba gratuita. Prueba eesel y ejecútalo primero contra tu propia cola.
