

Resumen
Cactus Whistle es un modelo abierto y gratuito de voz a texto que cabe en un único archivo de 16,9 MB y corre en una CPU normal. En un clip de 10 segundos llega a la primera palabra en 11,1 ms y, con voz leída y limpia, supera a Whisper base, un modelo 8,6 veces más grande.
El problema está en el propio gráfico de Cactus: Whisper base sigue ganando en reuniones, charlas TED y el promedio multilingüe de MLS, y un probador de Hacker News vio una precisión en texto libre de solo 70 de 170 comandos. Ese mismo probador consiguió 164 de 170 limitando Whistle a una lista fija de comandos. Esa es la lección real: Whistle es un front end para comandos de voz, no un reemplazo de Wispr Flow.
Si eres un equipo de soporte que mira la voz, la transcripción ya es la parte barata. El trabajo está en responder lo que dijo el cliente, y ahí entra un compañero de IA para helpdesk como eesel.
¿Qué es Cactus Whistle?
Whistle es un modelo de reconocimiento de voz de Cactus Compute, una startup de San Francisco de la hornada de verano de 2025 de Y Combinator, con un equipo de 8 personas. Cactus la dirigen el CEO Roman Shemet y el CTO Henry Ndubuaku, y toda su propuesta es IA para dispositivos sin GPU: móviles de gama baja, relojes, gafas, robots, coches y placas del tamaño de un microcontrolador.
Whistle es la mitad de voz de esa apuesta y un buen ejemplo de lo lejos que han llegado los modelos de lenguaje pequeños. Salió el 2 de octubre de 2026, y el hilo de lanzamiento en Hacker News llegó a 549 puntos y 121 comentarios el 8 de octubre, por eso de pronto está en todas partes. La ficha del modelo en Hugging Face muestra 2.594 descargas en su primer mes y licencia Apache 2.0.
Yo construyo integraciones y APIs para eesel, así que un anuncio de modelo me hace plantearme primero una cosa: ¿qué recibe realmente el desarrollador de vuelta tras una llamada? Con Whistle la respuesta es muy concreta, así que empecemos por ahí.
¿Qué hace realmente Whistle?
Cactus enumera tres tareas, todas ejecutadas en el dispositivo:
- Transcripción. Audio mono a 16 kHz, hasta 30 segundos de una sola pasada, en inglés, alemán, francés, español, italiano, neerlandés y polaco. El idioma se detecta salvo que lo indiques.
- Marcas de tiempo por palabra. Cada palabra con su inicio, su fin y su probabilidad, para que una app pueda resaltar, saltar o cortar por palabra.
- Embedding de voz. La salida bruta del codificador, una fila por cada 80 ms de audio, para comparar y buscar sin generar una transcripción.
Dos funciones menores importan más de lo que parece. El sesgo por palabras clave te permite pasar los nombres que tus usuarios dicen de verdad ("Siobhan", "Krzysztof", los nombres de tus productos) y orienta la búsqueda hacia ellos. Y el silencio devuelve una transcripción vacía en lugar de una frase inventada, un golpe directo a un vicio por el que se conocen los modelos tipo Whisper.
Esa afirmación se probó en público. Un usuario de Hacker News pasó Whistle por un episodio de televisión y contó esto:
“Tried it on a random TV episode and it seems to get stuck sometimes where it just outputs "Thank you." as a default - at one point emitting that for 60s of dialogue”

Es decir, el silencio está resuelto, pero el audio largo y desordenado que no cabe en la ventana de 30 segundos de Whistle aún puede producir relleno. Tenlo en cuenta para los benchmarks.
¿Cómo funciona Whistle por dentro?
La versión corta: Whistle es un front end de audio acoplado al modelo de texto que Cactus ya tenía, Needle, y comparte casi todo con él. Needle es el diminuto modelo de llamada a herramientas que hizo famosa a Cactus (su lanzamiento de mayo en Hacker News se titulaba "We Distilled Gemini Tool Calling into a 26M Model"). Needle 3 ocupa ahora entre 8 y 29 MB según la profundidad.
Según el post de lanzamiento, el proceso es este:
- El audio se convierte en 80 bins log-mel con un salto de 10 ms, así que 30 segundos son 3.000 fotogramas.
- Un bloque inicial convolucional lo reduce a 375 fotogramas, uno por cada 80 ms.
- Un codificador de 8 bloques lee todos los fotogramas a la vez (no es causal, así que una palabra en el segundo 12 puede informar a una palabra en el segundo 3).
- Un decodificador con forma de Needle lee el codificador mediante una atención cruzada con compuerta en cada capa, y 5 beams eligen la transcripción.
El truco de ingeniería que más me gusta: las claves y valores del codificador se calculan una vez por clip y se comparten entre todos los beams, así que cinco beams cuestan cinco cachés de texto cortas, no cinco pasadas sobre el audio. El decodificador además es "escalonado": cada profundidad desde 2 capas hacia arriba se entrenó como un modelo propio, y eliges una al cargar con --audio-depth.
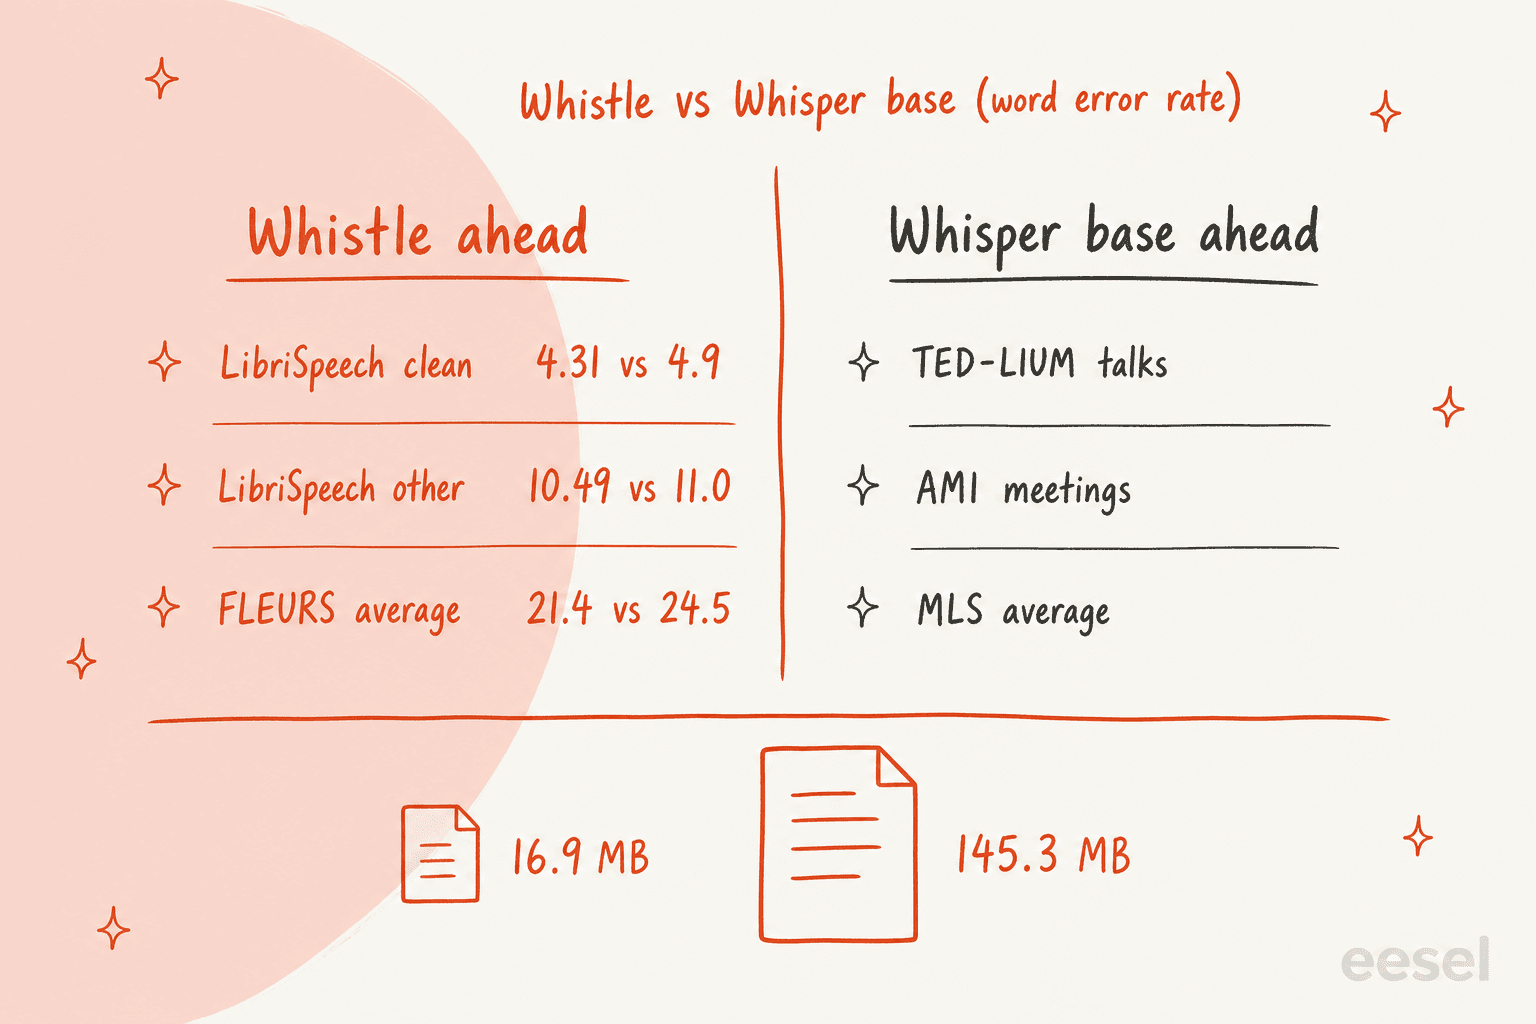
Ese motor compartido es el producto real. Carga ambos modelos en el mismo binario y una sola llamada recibe audio y devuelve una llamada a función. Este es el ejemplo exacto del post de Cactus:
needle --model needle3.cact --model whistle.cact --tools tools.json --audio clip.wav
{"function_calls":[{"name":"set_lights","arguments":{"room":"kitchen","on":false}}],
 "confidence":0.94,
 "audio_text":"turn off the kitchen lights",
 "audio_language":"en"}
Ninguna transcripción llega nunca al código de tu app. Si has conectado llamadas a herramientas en tiempo real contra una API en la nube, notarás lo que falta aquí: el viaje de ida y vuelta por la red, la clave de API y la factura.
Benchmarks de Whistle frente a Whisper base y Moonshine
Cactus compara Whistle con dos modelos: Whisper base de OpenAI (el checkpoint multilingüe, 145,3 MB) y Moonshine tiny v2 (41,9 MB). La tasa de error de palabras (WER) es el porcentaje de palabras que el modelo falla, así que cuanto menor, mejor.
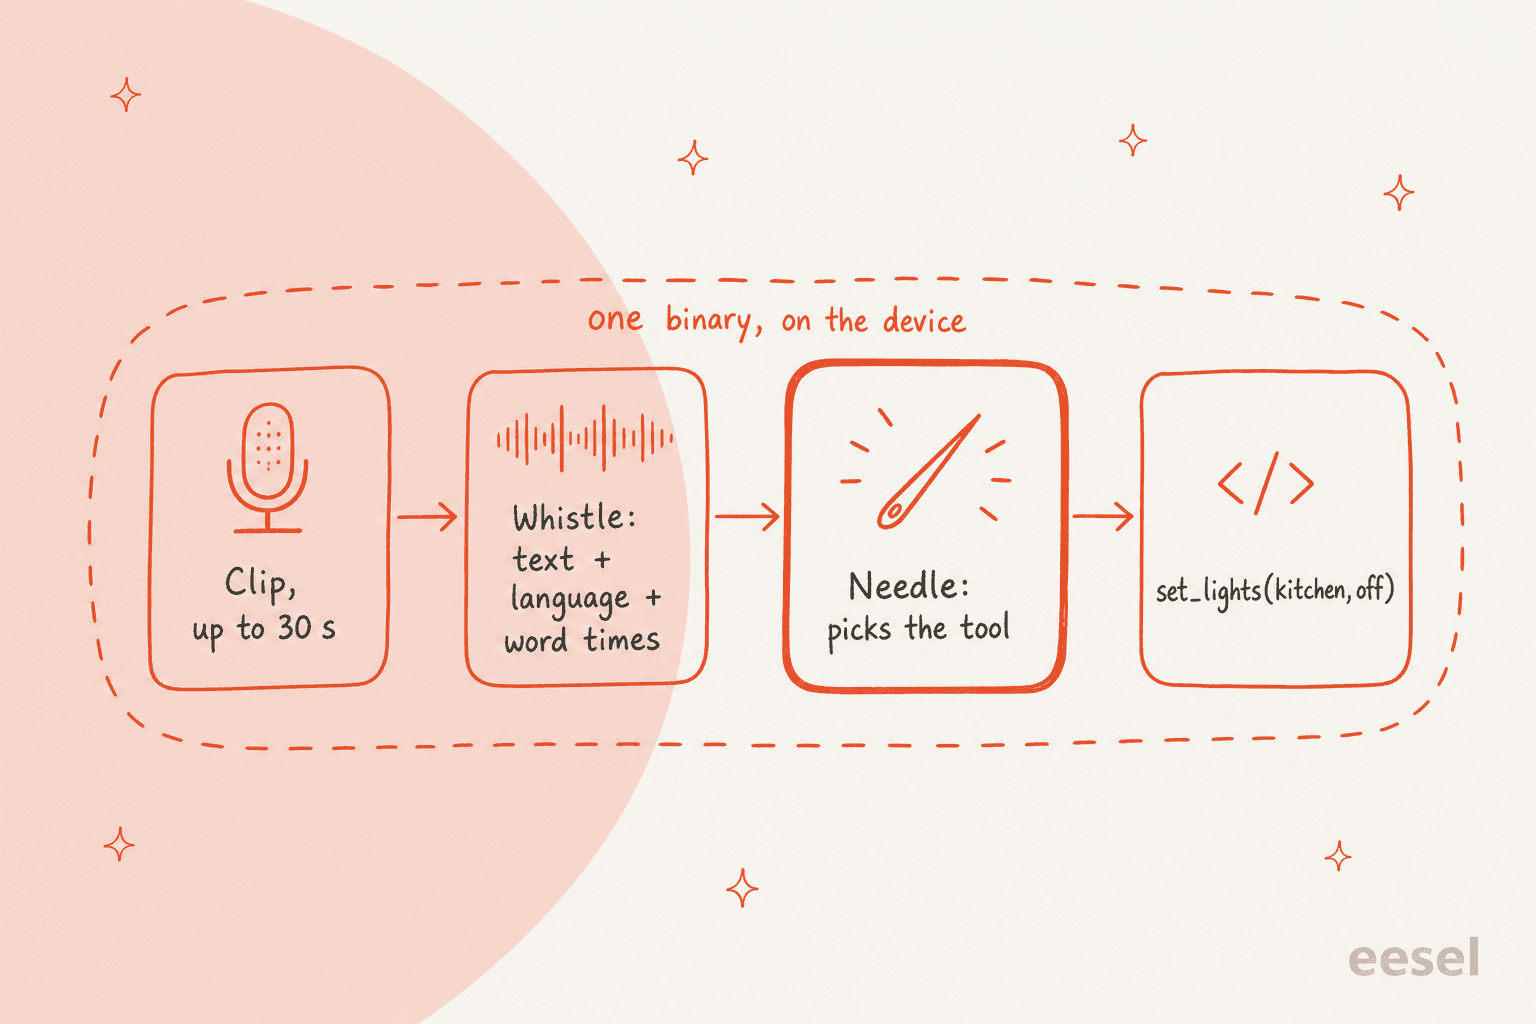
Este es el panorama completo de la tasa de error de palabras, con las cifras de Whistle de la ficha del modelo y las de Whisper base que Cactus citó en su hilo de lanzamiento en X:
| Benchmark | Qué audio es | WER de Whistle | WER de Whisper base | Quién va por delante |
|---|---|---|---|---|
| LibriSpeech test-clean | Lectura limpia de audiolibros | 4,31% | 4,9% | Whistle |
| LibriSpeech test-other | Lectura de audiolibros más difícil | 10,49% | 11,0% | Whistle |
| SPGISpeech | Llamadas financieras | 7,65% | No publicado | Whistle (frente a Moonshine) |
| Earnings-22 | Llamadas de resultados, con acentos | 19,01% | No publicado | Whistle (frente a Moonshine) |
| FLEURS (promedio de 7 idiomas) | Frases leídas, muchos idiomas | 21,4% | 24,5% | Whistle |
| TED-LIUM | Charlas grabadas | 7,61% | Menor | Whisper base |
| AMI | Grabaciones de reuniones | 26,07% | Menor | Whisper base |
| MLS (promedio de 6 idiomas) | Audiolibros, otros idiomas | 24,9% | Menor | Whisper base |
El post de lanzamiento expone la división con claridad, y respeto que lo haga. Si lees la tabla por tipo de audio, salta a la vista un patrón: Whistle es más fuerte con voz leída, limpia y de un solo hablante, y más débil en reuniones, donde la gente se habla encima. Una tasa de error del 26% en AMI significa que más o menos una de cada cuatro palabras es incorrecta.
La velocidad y el tamaño son otra historia, y aquí Whistle se despega. Diez segundos de audio en una CPU Apple M4 Pro:
| Whistle | Whisper base | Moonshine tiny v2 | |
|---|---|---|---|
| Tamaño del archivo | 16,9 MB | 145,3 MB | 41,9 MB |
| Tiempo hasta el primer token | 11,1 ms | 73,2 ms | 22,8 ms |
| Velocidad de decodificación | 1.319 tokens/s | 266 tokens/s | 262 tokens/s |
| Precisión | 2 a 4 bits | fp32 | int8 |
El titular de Cactus dice "9x menos tamaño de archivo y 6x de velocidad". Comprobé la aritmética: la diferencia de tamaño es de 8,6x, la de tiempo hasta el primer token es de 6,6x y la de decodificación es de unas 5x. Un redondeo razonable. Además, el tiempo hasta el primer token de Whistle crece con el clip, de 5,9 ms con 5 segundos a 36,3 ms con 30, mientras que Whisper rellena todo hasta 30 segundos, así que la brecha es mayor en los clips cortos para los que Whistle está pensado.
Hay una comparación que Cactus no hace: los modelos abiertos más grandes que la gente realmente ejecuta en portátiles. En Hacker News, los usuarios preguntaban una y otra vez por Parakeet de NVIDIA, y la respuesta más útil resumió bien el equilibrio:
“It might not be as good as parakeet, but it gets you 80% of the way there.”
¿Qué dice la gente después de probar Whistle?
El hilo de Hacker News es la mejor prueba en condiciones reales hasta ahora, porque Cactus puso un sandbox en el navegador en la página de lanzamiento y cientos de personas le hablaron. Las reacciones se dividen justo por las líneas que predicen los benchmarks.
Con inglés claro, frases cortas y términos técnicos, la gente quedó impresionada. Un desarrollador comprobó que superaba al dictado del propio móvil con jerga:
“This works much better than the speech recognition in iOS when you use technical terms.”
El habla natural en los otros seis idiomas recibió críticas más duras. Un hispanohablante de Madrid escribió que solo aguantaba al dictar despacio:
“If I use a more natural/conversational rhythm (no slang, no abbreviations...) it easily confuses words.”
Un probador polaco dijo algo parecido, y otro comentarista señaló lo que la demo no muestra: la salida en streaming mientras sigues hablando, en la que se apoyan la mayoría de las apps de dictado en vivo. Un equipo competidor también se sumó en Reddit y afirmó, con su propio benchmark, que Whistle más Needle alcanzaba un 20,7% de precisión en herramientas a partir de voz sin procesar. Es la prueba de un rival, así que tómala con cautela, pero apunta en la misma dirección que todo lo demás.
Por el lado de los constructores, un desarrollador ya había conectado Whistle a un plugin de voz a texto para DeepSeek Harness a los pocos días del lanzamiento.
La lección real: acota el vocabulario
El comentario más útil de todo el hilo vino de alguien que ya había puesto Whistle en producción. Lo usó para desconectar un Amazon Echo Show de la nube de Amazon, sustituyendo el asistente de voz original por una domótica que corre en local, y compartió cifras.
Con transcripción libre, Whistle acertó 70 de 170 comandos hablados, frente a 168 del modelo de voz de 1,7B de Qwen ejecutándose en una GPU RTX 5080. Entonces dejó de pedirle a Whistle que transcribiera cualquier cosa que una persona pudiera decir y entrenó una red diminuta para mapear la salida de Whistle a un conjunto fijo de plantillas de comandos. Su resultado: 164 de 170, con una configuración pensada para correr en la propia CPU del Echo.
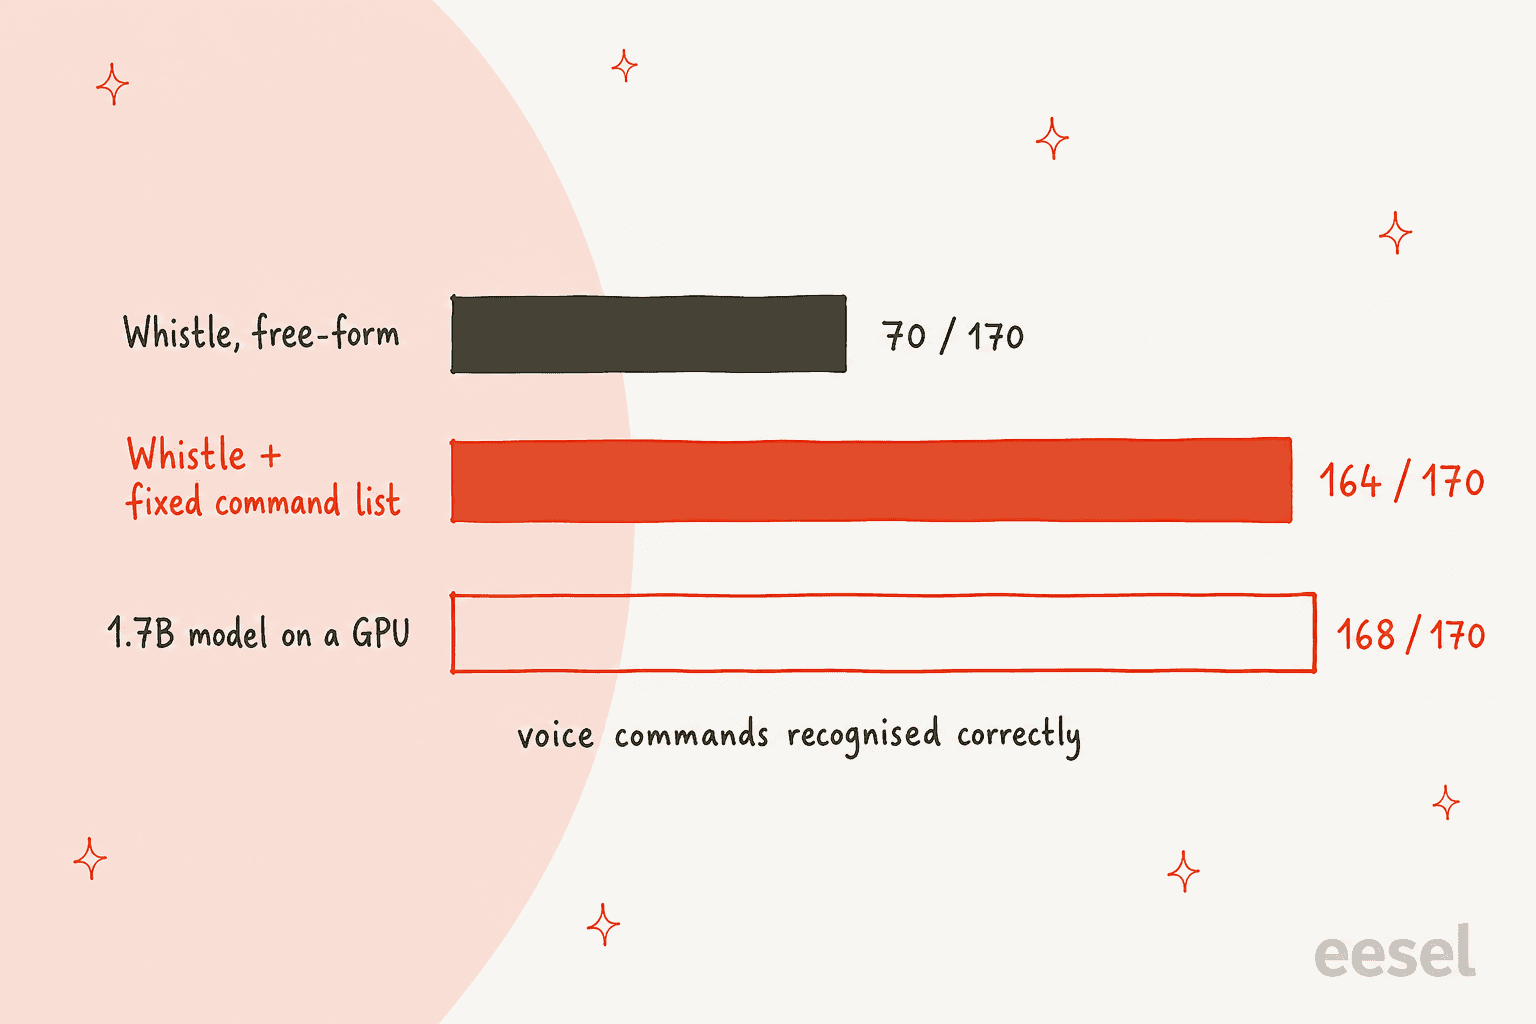
Ese es el cambio que yo me llevaría. Un modelo de 16,9 MB no tiene espacio para conocer todas las palabras de siete idiomas, así que cuanto más puedas decirle qué esperar, más se acerca a modelos mucho más grandes que él. Cactus creó herramientas justo para esto: el sesgo por palabras clave para nombres y términos de producto, y la lista de herramientas de Needle, que ya es en sí un vocabulario fijo de acciones. El mismo probador ejecutó después 208 frases y acertó 206, por delante de configuraciones con Vosk y Kaldi sobre el mismo conjunto.
Así que si juzgas Whistle hablándole al sandbox de tu fin de semana, estás probando lo que no toca. Júzgalo por los 20 comandos que tu dispositivo necesita entender de verdad.
¿Deberías lanzar Whistle a producción?
Así es como yo decidiría, a partir de los benchmarks y los informes de campo de arriba. Elige el trabajo que tienes en mente:
¿Qué quieres que haga Whistle?
Cómo probar Whistle en cinco minutos
El camino más rápido es el sandbox en el navegador del post de lanzamiento: la primera pulsación descarga el modelo de 16,9 MB en la pestaña y nada sale de tu equipo. Para una prueba real, el paquete de Python se instala con una línea:
pip install cactus-needle
import needle

print(needle.transcribe("clip.wav")["text"])
A partir de ahí, según la ficha del modelo:
word_timestamps=Trueañade el inicio, el fin y la probabilidad de cada palabra.keywords=[...]orienta la búsqueda hacia los nombres que dicen tus usuarios.language="de"fuerza un idioma en lugar de detectarlo.needle whistle comparepasa el mismo clip por Whistle, Whisper y Moonshine con tiempos, que es el comando más útil para decidir.
El motor se distribuye precompilado para diecisiete plataformas, desde macOS, Windows y Linux (incluidos RISC-V y MIPS) hasta Android, iOS, watchOS, tvOS y el navegador como WebAssembly. Cada carpeta de plataforma nativa contiene un binario needle, una biblioteca estática y una cabecera. El código fuente está en GitHub. Si estás montando un stack totalmente local, encaja junto a los agentes de IA de código abierto que la gente ya ejecuta en su propio hardware.
El coste es simple: los pesos y el motor son Apache 2.0, y Hugging Face no lista ningún proveedor de inferencia alojado para Whistle, así que lo ejecutas tú. Compáralo con los precios por minuto de Gemini 3.5 Transcribe o MAI-Transcribe 2, que son la opción correcta cuando importa más la precisión en audio largo y desordenado que el tamaño.
Dónde Whistle deja de ser la herramienta adecuada
Para ser justos con Cactus, nunca dijeron que Whistle reemplace a Whisper large ni a un servicio de transcripción en la nube. Aun así, estos son los límites que señalaría antes de que nadie construya sobre él:
| Límite | Qué significa en la práctica |
|---|---|
| Tope de 30 segundos por clip | Tu app debe dividir el audio más largo en fragmentos (un usuario de HN se topó enseguida con "audio limit is 30 s") |
| Sin salida en streaming | El texto aparece cuando termina el clip, no mientras alguien habla |
| 7 idiomas | Sin japonés, noruego, hindi, portugués, etc. |
| Audio de reuniones | 26,07% de WER en AMI, por detrás de Whisper base |
| Etiquetas de hablante | La documentación no lista separación de hablantes (diarización) |
Nada de esto son fallos. Es el precio de meter un modelo de voz en 16,9 MB, y Cactus publica el detalle suficiente para que puedas verlo antes de lanzar. Para la mayoría del trabajo de larga duración, Otter y las herramientas de mi lista de alternativas a Otter siguen siendo la opción práctica.
Qué significa Whistle para los equipos de atención al cliente
Aquí lo llevo al trabajo que hago yo. La voz en soporte son sobre todo llamadas telefónicas, mensajes de voz y videotutoriales grabados, y esos son largos, tienen dos hablantes y se salen del guion. Eso es el extremo AMI de la tabla de benchmarks de Whistle, no el de LibriSpeech. Para la automatización del soporte telefónico o los agentes de IA para call center, Whistle no es la capa de transcripción que elegiría hoy. Los agentes de voz con IA pensados para llamadas usan modelos más grandes y con streaming por una buena razón.
Lo más importante es que la transcripción sigue siendo cada vez más barata y pequeña, y nunca fue la parte difícil. En una llamada de ventas de eesel, una marca DTC de suplementos en Gorgias y Shopify, que gestiona unos 7.000 tickets al mes, dijo que quería que la IA resolviera automáticamente la mitad de sus preguntas sobre estado de pedidos, suscripciones y productos. El obstáculo no era convertir voz en texto. Sus respuestas estaban dispersas entre herramientas de SOP, macros desactualizadas y tutoriales en Loom que nadie había puesto por escrito. La transcripción de un vídeo de Loom es solo más texto; alguien tiene que leer el ticket, encontrar la respuesta correcta y contestar con la voz de la marca.
Esa es la línea que trazaría: Whistle es infraestructura, y eesel es el empleado. Un modelo como Whistle oye las palabras. Un compañero de IA para helpdesk trabaja la cola: aprende de tu base de conocimiento y de tickets anteriores, redacta o envía respuestas dentro de Zendesk o Gorgias, y pasa a una persona los tickets que no debería tocar.
Si ya tienes transcripciones de llamadas llegando a tu helpdesk, mis guías sobre resumir transcripciones de llamadas y eliminar datos personales (PII) de las transcripciones cubren los pasos posteriores al modelo de voz.
Y ya que el atractivo de Whistle es que lo manejas desde una terminal: eesel funciona igual. La CLI de eesel (npm i -g @eesel/cli) te permite conectar un helpdesk, editar las instrucciones permanentes del compañero, aprobar o rechazar sus acciones pendientes y leer su registro de actividad, con cada comando devolviendo JSON y una opción --dry-run que muestra la llamada exacta que haría una escritura. Agentes de código como Claude Code, Codex y Cursor pueden manejarla igual que una persona, así que el mismo compañero que ves en el panel se puede automatizar desde CI.
Prueba eesel
Si la voz está en tu hoja de ruta porque quieres menos tickets sin responder, empieza por la parte que los responde. El compañero de IA para helpdesk de eesel se conecta a Zendesk, Gorgias o Freshdesk en minutos, aprende de tu centro de ayuda y de tickets anteriores, y se prueba con tus propios tickets históricos antes de responder a un cliente real. Puedes probar eesel gratis y sin tarjeta, o compararlo antes con otros compañeros de IA.
