

En resumen
Subvocal son unas gafas de una startup de Y Combinator que convierten en texto las palabras que articulas en silencio, dirigidas a quienes dictan a herramientas de IA pero no pueden hablar en voz alta en el trabajo. Un depósito reembolsable de 199 $ te permite reservar unas gafas de 499 $ que deberían enviarse en el primer trimestre de 2027. La propuesta es real, pero las pruebas aún no están: sin cifras de precisión, sin especificaciones, solo en la nube, solo en inglés. Resérvalas si quieres seguirlo todo de cerca y puedes esperar. Si lo que realmente te frena es redactar respuestas de soporte, un compañero de IA como eesel, que las redacta por ti, te ahorrará más tiempo.
¿Qué es Subvocal?
Subvocal es un dispositivo vestible de habla silenciosa, un nuevo tipo de entrada de IA multimodal, de The Subvocal Company, una startup de tres personas de San Francisco que forma parte de la promoción de otoño de 2026 de Y Combinator. Te pones las gafas, articulas palabras sin emitir ningún sonido y el texto aparece en tu computadora. Su lema en la página de la empresa en YC es "Talk to your computer without talking."
El lanzamiento hizo mucho ruido. El anuncio en X del CEO Aarush Yadav el 30 de octubre acumuló 26,277 me gusta y aproximadamente 12 million visualizaciones, y el hilo de Show HN, unos días después, alcanzó unos 497 puntos y 270 comentarios. En la misma publicación, Yadav dijo que la empresa ha recaudado 1,3 M$ de YC y Afore Capital.
Los dos fundadores son Aarush Yadav (CEO) y Arnav Kumar (CTO), ambos estudiantes de informática en Georgia Tech. Un perfil del programa de honores de Georgia Tech cuenta que Yadav empezó a trabajar en el proyecto después del hackatón TreeHacks de Stanford en febrero de 2026 y consiguió los primeros $500k de Afore en cuestión de semanas.
Me dedico al desarrollo de producto en eesel, así que leo las páginas de lanzamiento como leería unas especificaciones: qué se promete, qué es un objetivo y qué es una demostración. Subvocal distingue con honestidad unas cosas de otras, si lees la letra pequeña. La publicación de lanzamiento en YC dice abiertamente que "the hardware currently looks a lot worse than the product we intend to ship."
Hay un detalle que conviene saber: el producto ha cambiado de forma rápidamente. Ese perfil de Georgia Tech de abril de 2026 describe "a wearable that sits behind your ear", con un prototipo que reconoce letras a 30 palabras por minuto. Seis meses después, son unas gafas que prometen 200+. Es normal en una startup de hardware en una fase tan temprana, y también es la razón por la que el producto final podría volver a cambiar.
¿Cómo funciona Subvocal?
Subvocal lee los músculos que usas para hablar, no tu voz ni tu cara mediante una cámara. Según la publicación de lanzamiento en YC, "We send low-power radio waves through the face and measure how they change as your muscles move. Our models then decode those signals directly into text."
El fundador añadió más detalles en Hacker News:
"They emit radio waves, similar to Bluetooth, that pass through your face. As they cross the tongue, lips and soft palate, they're modulated by silent mouthing. We train foundation models on this data to decode these perturbations to text."

Algunos datos de las propias páginas de Subvocal ayudan a entender cómo sería usarlo:
- Sin cámaras. Las preguntas frecuentes de la página de inicio dicen "There's no video or camera-based lip reading."
- Tienes que hacerlo de forma intencionada. "only decodes words you intentionally articulate", así que no lee tus pensamientos ni está siempre activo.
- Primero, la calibración. La configuración incluye "a short personal calibration process." En el vídeo de demostración con Dave, de YC, eso consistió en leer 20 frases.
- Necesita la nube. Cuando le preguntaron si funciona sin conexión, el fundador respondió en Hacker News: "Yes, it requires internet access."
- Solo en inglés. Está previsto añadir otros idiomas "after shipping", según otra respuesta del fundador.
¿Por qué radio y no una cámara? La respuesta del fundador es la explicación técnica más útil de todo el lanzamiento: "Speech has 40 phonemes, but only about 12 to 15 visemes," lo que significa que muchos sonidos se ven idénticos desde fuera (la P y la B, por ejemplo). Como lo explicó el fundador, la lectura de labios por cámara alcanza una tasa de error "too high to be product ready but just low enough to make for a good demo." La apuesta para superar ese límite es leer la lengua y el paladar blando desde dentro.
El hardware exacto no es público. La oferta de empleo de Subvocal para responsable de sensores enumera la detección por RF, EMG, EEG y mmWave como posibles tecnologías de diseño y dice: "For competitive and IP reasons, we are not publicly disclosing the exact architecture of our current system yet." Las propias páginas de Subvocal nunca usan la palabra radar. Hablan de "RF sensing" y "radio waves."
¿Qué tan rápido es Subvocal, realmente?
Subvocal afirma alcanzar 200+ palabras por minuto. La página de inicio dice que "decodes almost-invisible subtle, silent mouthing into text at 200+ WPM," y esa es la cifra que repitieron todos los titulares.
Para ponerlo en contexto, el fundador comparó escribir y hablar en Hacker News: "Most people type at 40-50 WPM. Developers can often type at 70-100 WPM. Meanwhile, most people can talk at 120-200 WPM."
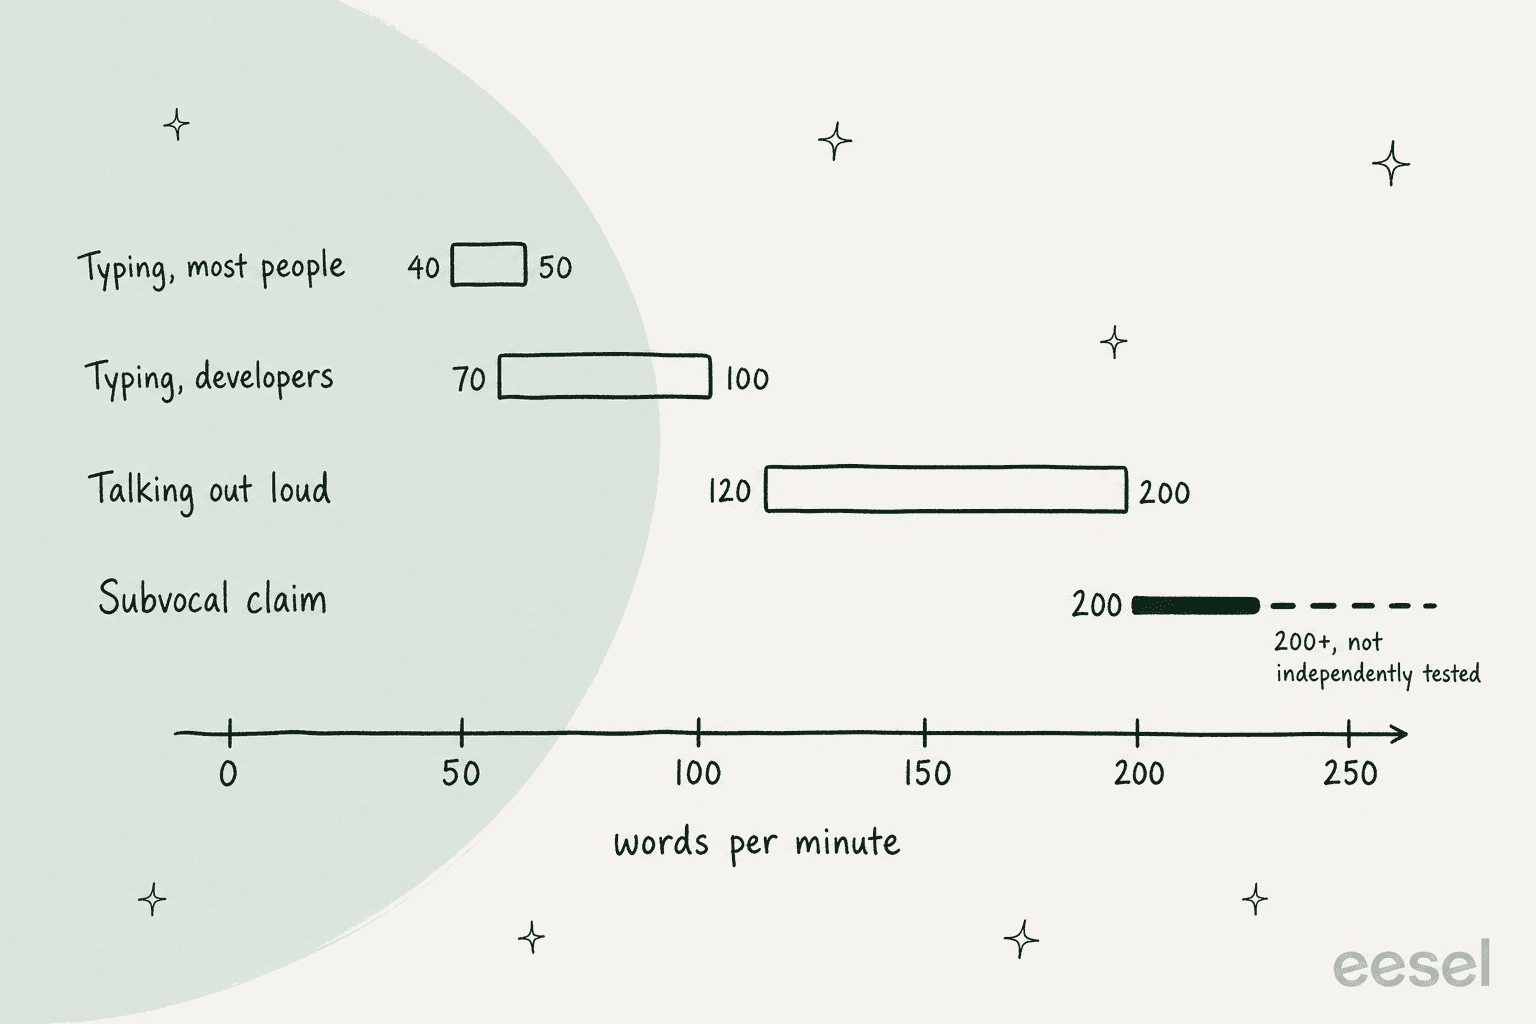
Visto así, la afirmación es que articular en silencio alcanza el extremo superior de la velocidad normal del habla, algo ambicioso para un prototipo. La velocidad tampoco significa nada sin precisión, y ahí está el vacío. Subvocal no ha publicado ninguna tasa de error. La página de inicio dice "it can occasionally get something wrong," y la publicación de lanzamiento habla de "a reasonably low error rate even at a small dataset scale." La única cifra que circula procede de alguien que vio el vídeo de demostración:
"I am so glad to see an unpolished early look and an honest evaluation of about five percent error rate in the YouTube video."
Es la estimación de una sola persona a partir de una sola demostración, así que tómala como una impresión aproximada, no como una prueba de referencia. Compárala con modelos de voz a texto como Nemotron 3.5 Transcribe o Voxtral 3, que cuentan con cifras públicas de tasa de error por palabra que puedes consultar.
El subhilo más grande de Hacker News ni siquiera trataba sobre la precisión. La cuestión era si hablar es más rápido para todo el mundo:
"Do most people talk faster than they can type? It's the opposite for me - I also read aloud slower than I can read in my head."
Mi opinión: si ya dictas mucho con Wispr Flow o la voz de ChatGPT, sabes si hablar te resulta más rápido. Si no lo haces, probablemente Subvocal no te hará cambiar de hábitos.
¿Cuánto cuesta Subvocal?
Subvocal cuesta $499 por par al precio Early Bird, y se reserva con un depósito reembolsable de $199. La página de reserva muestra los $499 frente a un precio tachado de $699, y la publicación de lanzamiento en YC lo llama "a special $200 early bird discount on the final price."
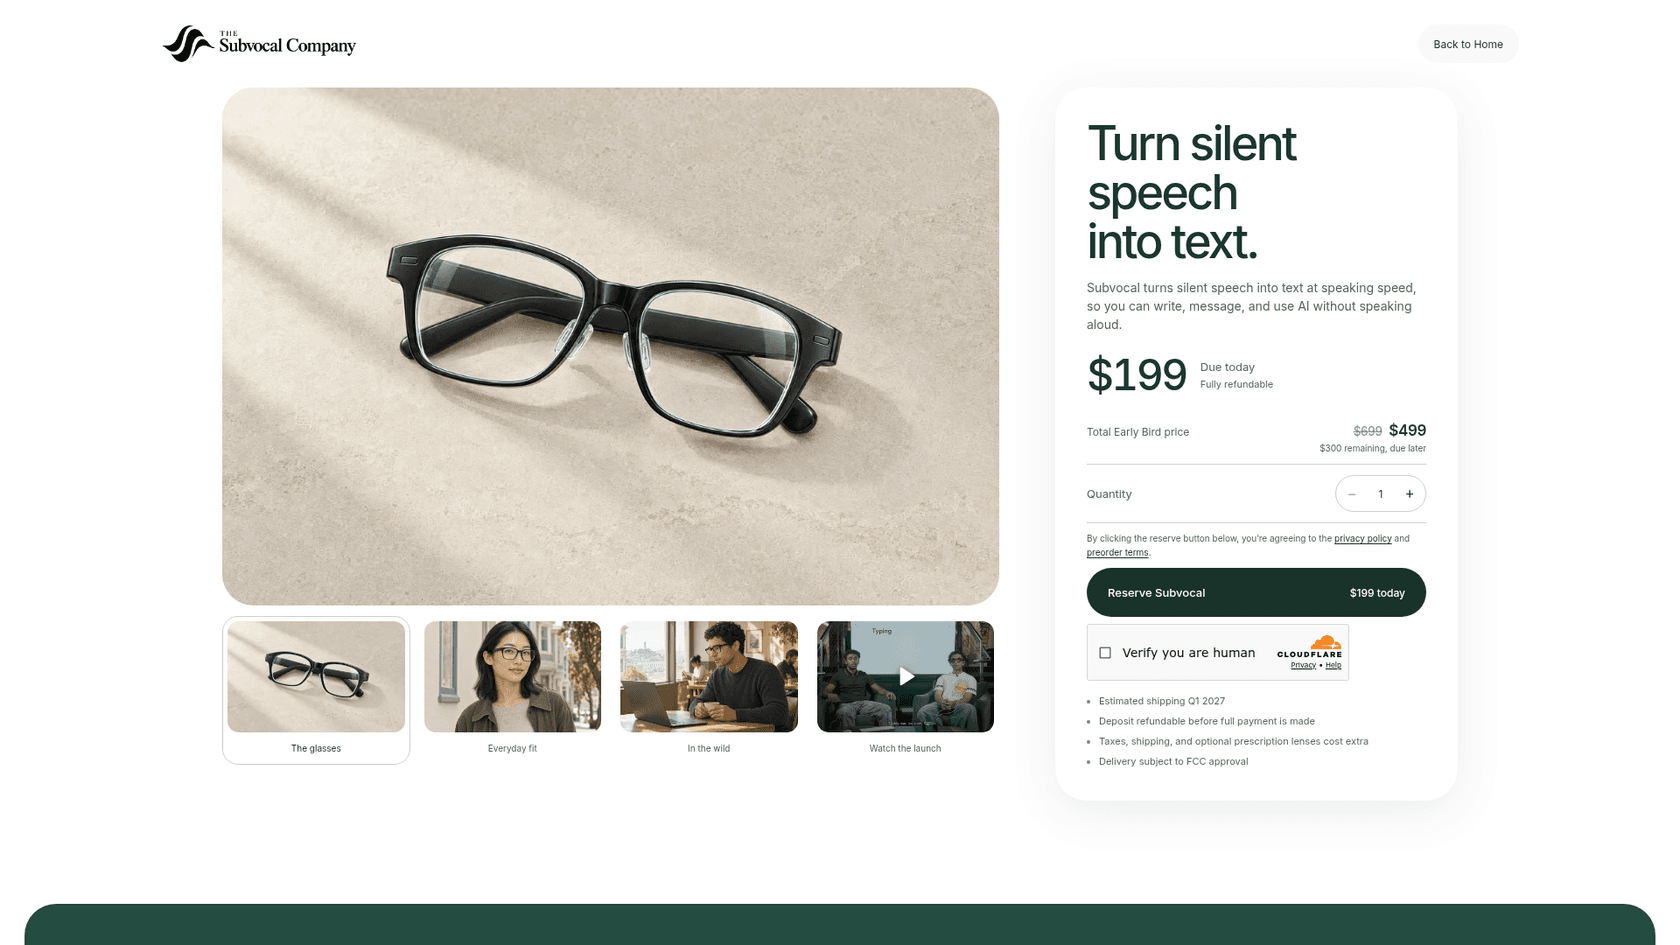
Las condiciones de reserva se comprometen únicamente a lo siguiente:
| Concepto | Qué dice Subvocal |
|---|---|
| Depósito hoy | $199 por par, totalmente reembolsable antes del pago final |
| Precio Early Bird | $499 por par ($699 aparece tachado) |
| Saldo pendiente para más adelante | $300 por par |
| Cómo se cobra el saldo | Nunca de forma automática. Recibes un correo y tienes 30 días para pagar |
| No incluido | Impuestos, envío, lentes graduadas, accesorios opcionales |
| Reembolsos | En cualquier momento antes del pago final, sin cargo por cancelación, se tramitan en un plazo de 7 días hábiles |
| Crédito por recomendaciones | $100 de descuento en tu saldo si 3 personas reservan a través de tu enlace |
| Envío estimado | Primer trimestre de 2027, "not a guaranteed delivery date", sujeto a la aprobación de la FCC |
| Quién puede comprar | Solo direcciones de entrega en EE. UU., compradores de 18+ |
| Especificaciones | No publicadas. "Final specifications are still being developed" |
| Política de devoluciones y garantía | Aún no publicadas, se comunicarán antes del pago final |
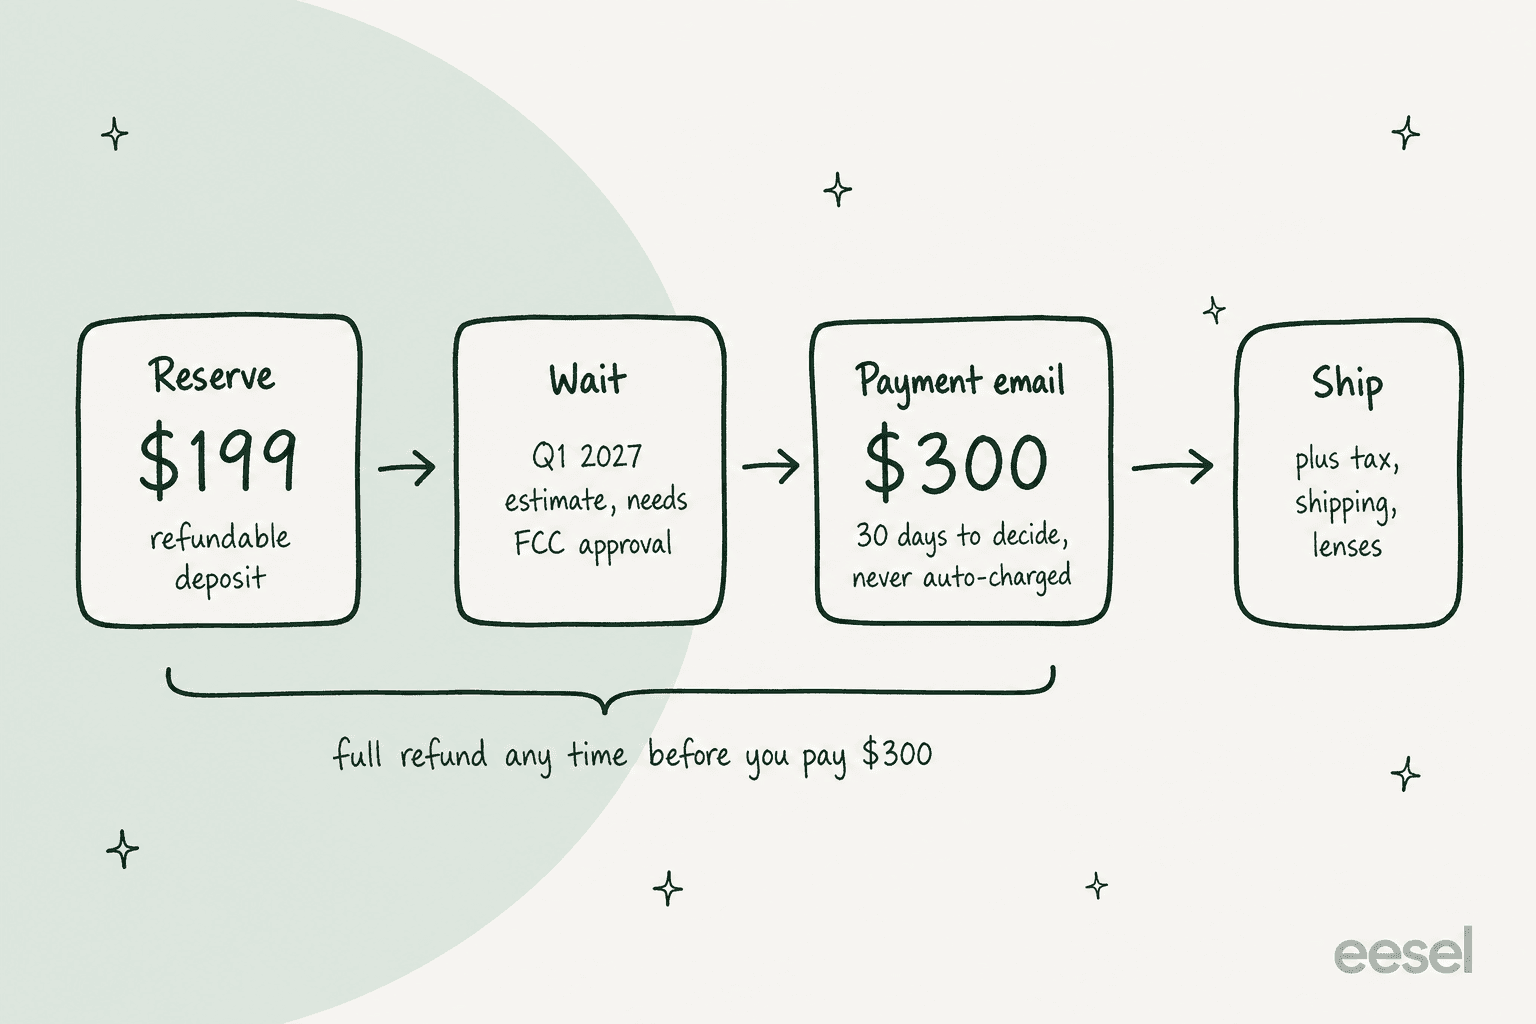
Las condiciones protegen más al comprador que las de la mayoría de las reservas de hardware que he leído. No se cobra nada sin que tú decidas pagar, y si Subvocal cambia el producto de manera sustancial, puedes cancelar y recuperar tu depósito. El coste real de reservar es que esos $199 se quedan en manos de una startup durante unos meses, y estás apostando a que el producto final esté a la altura de la demostración.
Lo que falta en la página importa igual: no hay datos de autonomía, peso ni lista de compatibilidad. Las preguntas frecuentes dicen que se está desarrollando para "ChatGPT, Claude, Cursor, Slack, email, documents, messaging, and anywhere else you'd normally type," pero eso es el objetivo, no una lista verificada.
¿En qué se diferencia Subvocal de AlterEgo, EchoSpeech y Neural Band de Meta?
Subvocal no es el primer dispositivo de entrada silenciosa, y las respuestas de "this already exists" no tardaron en llegar. La diferencia es que busca producir texto libre con unas gafas de aspecto normal, algo que ninguno de los demás vende hoy.
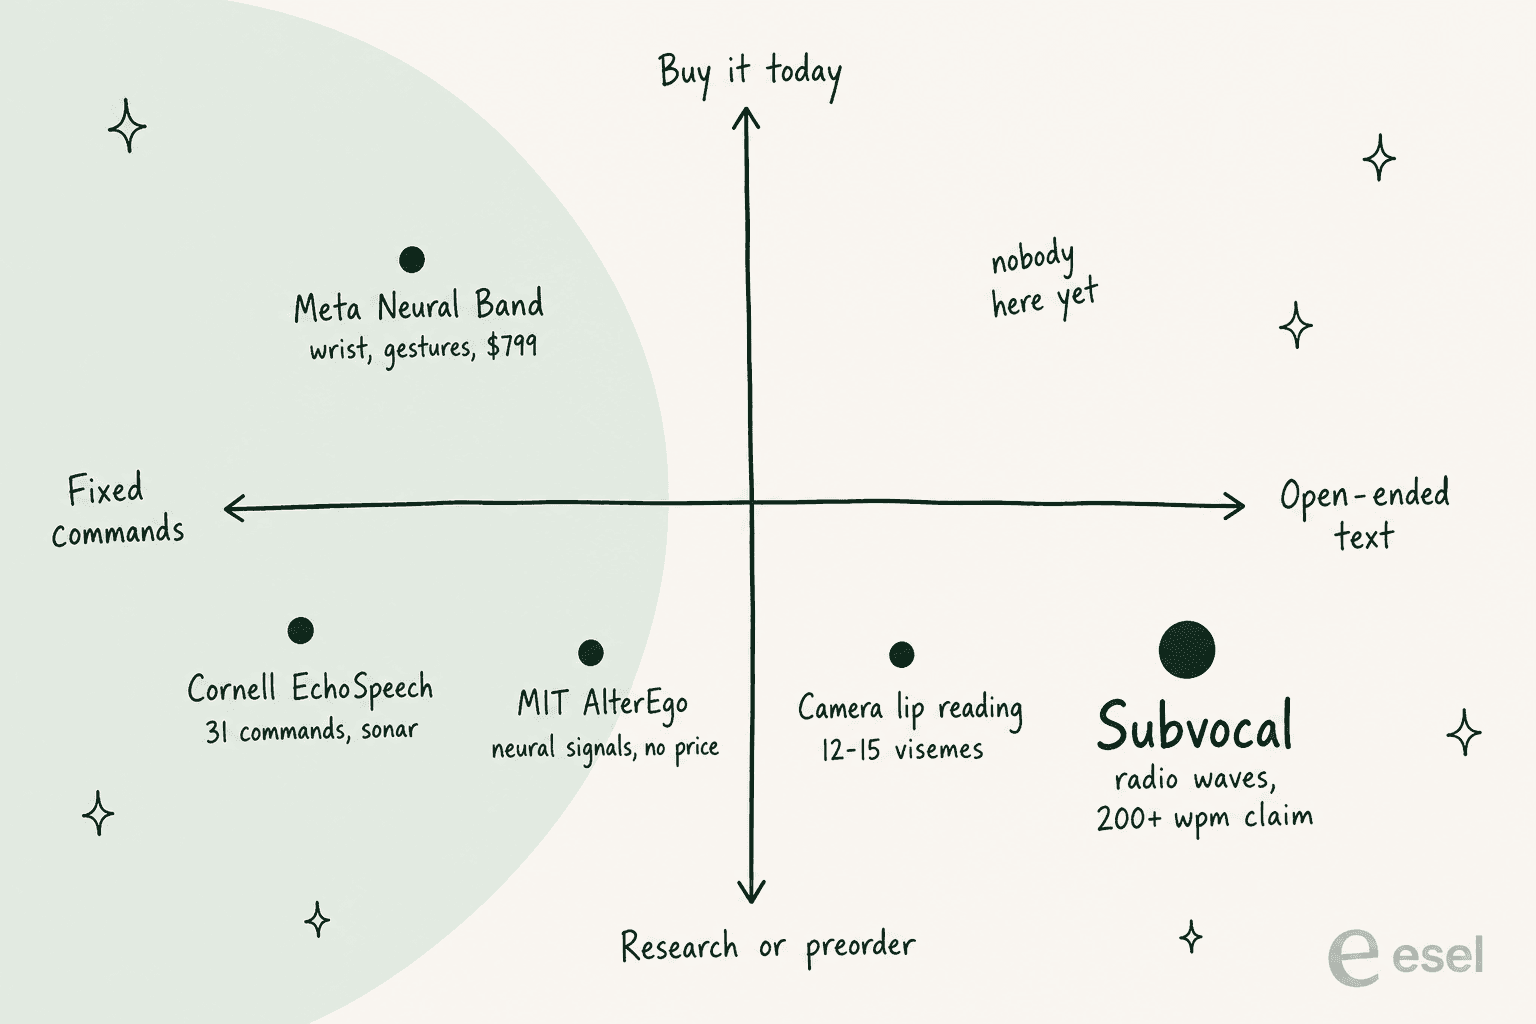
| Producto | Cómo detecta | Qué produce | ¿Puedes comprarlo? |
|---|---|---|---|
| Subvocal | Ondas de radio a través de la cara, desde unas gafas | Texto libre, promete 200+ palabras por minuto | Reserva, $499, fecha estimada del primer trimestre de 2027 |
| MIT AlterEgo | Señales neuronales de la articulación interna | Habla silenciosa, afirma no requerir movimiento visible | No. Se convirtió en una empresa independiente a principios de 2025, alterego.io solo permite registrarse |
| Cornell EchoSpeech | Sonar mediante pequeños altavoces y micrófonos en unas gafas | Hasta 31 comandos con una precisión aproximada del 95 % | No. Prototipo de investigación de 2023 |
| Meta Ray-Ban Display + Neural Band | Pulsera EMG que lee los músculos de los dedos | Gestos, con escritura a mano anunciada para más adelante | Sí, desde $799 en el lanzamiento |
El pariente más cercano es EchoSpeech de Cornell, que también se integra en una montura de gafas y también prescinde de la cámara. Sus límites son el punto de comparación: reconocía un conjunto fijo de 31 comandos, aunque funcionaba en tu teléfono sin la nube y duraba unas 10 horas con una carga.
AlterEgo va más allá en discreción, al afirmar que no requiere ningún movimiento visible desde fuera, mientras que las propias preguntas frecuentes de Subvocal dicen que alguien que esté cerca "may notice slight movement." La pulsera de Meta es la única que puedes comprar, pero lee tus dedos, no tu boca. Forma parte de una apuesta más amplia de los productos de IA de Meta por los dispositivos vestibles. Así que la verdadera competencia de Subvocal hoy no es otro dispositivo de habla silenciosa. Son el software de dictado y tu teclado.
¿Qué dice la gente sobre Subvocal?
Las reacciones se dividieron en tres grupos: entusiasmo entre quienes dictan a la IA todo el día, dudas sobre si el producto es real e inquietud por llevarlo en público.
Los entusiastas son, en su mayoría, personas que ya hablan con agentes de programación como Claude Code y Codex, y se encuentran con la misma barrera que describe la página de inicio de Subvocal: "control your coding agents without annoying your coworker":
"I already dictate a lot of my agent instructions. The problem is that you can't do that in an office or on a plane. This could fix it."
Los escépticos tenían dos argumentos. Uno era que las imágenes del producto parecen generadas, y un moderador intervino para separar las dos cuestiones:
"They're taking pre-orders. Obviously the product doesn't exist yet. The tech is real."
El otro era que resulta fácil de copiar. Una publicación de Joe Blau que decía "I recreated subvocal in 9 minutes with one prompt for AirPods Pro 3" consiguió 10,199 me gusta. En una respuesta del fundador en Hacker News, Yadav dijo que enfoques como ese solo permiten llegar a algo como "a 5 word classifier", que es aproximadamente donde también se sitúa la investigación de comandos fijos de EchoSpeech.
Luego está el lado humano. Articular en silencio parece sencillo hasta que lo intentas:
"For the ones thinking this is great, have you actually tried to talk without making sounds? I don't think it is an intuitive action at all and I became self-conscious about not making a sound rather than talking like I normally would."
La privacidad también salió a relucir, sobre todo porque la decodificación se ejecuta en la nube:
"Can this be made to work offline, without a cloud server? I wouldn't want my words to be passed through an API"
Y el hilo más esperanzador trataba sobre accesibilidad, con comentarios de personas que no pueden escribir o hablar con comodidad:
"This is also neat thing to have with people struggling with typing (RSI, injuries, disabilities)... people find they're hurting their vocal chords pretty quickly."
Creo que ese último grupo es donde Subvocal podría marcar más la diferencia, y también es el que más necesita una cifra de precisión publicada antes de gastar $499.
¿Deberías reservar Subvocal?
Reserva Subvocal si dictas a herramientas de IA todos los días, trabajas en un lugar donde no puedes hablar en voz alta y no te importa esperar hasta al menos el primer trimestre de 2027. Los $199 son reembolsables hasta que decidas pagar el resto, así que lo que arriesgas es tiempo, no dinero.
Déjalo pasar por ahora si:
- Necesitas que funcione desde el primer día. Todavía no se han publicado las especificaciones, las condiciones de garantía ni ninguna cifra de precisión.
- Vives fuera de EE. UU. Las reservas de pago solo están disponibles en EE. UU.
- Trabajas con texto sensible. Necesita la nube, y no se ha publicado el aviso de privacidad sobre los datos de los sensores. La política de privacidad actual solo cubre el sitio web y las reservas.
- Actualmente no dictas. Prueba primero el dictado gratuito o Wispr Flow. Si hablar en voz alta no te hace más rápido, hablar en silencio tampoco lo hará.
El hardware de un equipo de tres personas tiene un largo camino desde la demostración hasta las tiendas, como han mostrado dispositivos de IA anteriores como el Rabbit R1. Al menos, las condiciones de Subvocal están redactadas para que, si ese camino se alarga, puedas retirarte y recuperar tu depósito.
¿Importa la velocidad de escritura para los equipos de soporte?
Menos de lo que pensarías. Subvocal es una forma más rápida de introducir palabras en una computadora, y sus fundadores lo enmarcan en la transición hacia los agentes de IA, donde "our job moves upstream, to structured and detailed prompting." Llámalo ingeniería de prompts con otro nombre. Es una interpretación razonable del rumbo del trabajo del conocimiento. Sin embargo, para un agente de soporte, escribir no es la parte lenta de una respuesta. Lo es encontrar el pedido, la política y la última conversación, y eso es lo que aumenta el tiempo medio de atención.
Ese es el vacío que cubre un compañero de IA para soporte. Funciona como la asistencia al agente llevada un paso más allá: busca la información y redacta el borrador antes de que una persona abra el ticket. Lesson Pro, un grupo de marcas de clases particulares que usa Zendesk, utiliza eesel de esta manera: en un mes trabajó en unos 1,900 tickets, dejó unas 1,700 notas internas con contexto y próximos pasos, y redactó unas 560 respuestas para que una persona las aprobara y enviara. Nadie de ese equipo necesita escribir a 200 palabras por minuto, porque el primer borrador ya está escrito.
El mismo patrón aparece fuera del soporte. SamCart utiliza un agente de eesel en los tickets de Freshdesk y otro en el chat de su sitio web, y ambos responden a partir de los 280 artículos de su centro de ayuda. Si te interesa la idea en un sentido más amplio, aquí puedes ver en qué se diferencian los compañeros de IA de las herramientas que tienes que manejar tú, y qué hace realmente un empleado de IA en su día a día.
Y si te gusta la visión de Subvocal de hablar con agentes de programación, eesel tiene una CLI creada precisamente para ese tipo de usuario. Lleva al mismo compañero de eesel a tu terminal: puedes conversar con él, conectar tu plataforma de soporte, cargar conocimiento, configurar automatizaciones y aprobar acciones pendientes sin abrir el panel. Cada comando devuelve JSON, así que un agente de programación como Claude Code, Cursor o Codex puede encargarse de toda la configuración por ti, y todo lo que configures allí también aparece en el panel. Tanto si escribes la instrucción como si la dices o algún día la articulas en silencio, el trabajo llega a un compañero que ya conoce tu centro de ayuda.
Prueba eesel
Subvocal hace que escribir sea más rápido. eesel reduce cuánto tiene que escribir tu equipo. Su compañero de IA para soporte se integra en Zendesk, Freshdesk y otras plataformas de soporte, aprende de tus tickets anteriores y de tu centro de ayuda, y redacta o envía respuestas según cuánto confíes en él. Puedes simular su funcionamiento con tu propio historial de tickets antes de que interactúe con un cliente real. Prueba eesel gratis y descubre cuántas de tus respuestas habría redactado.
