

MAI Code 2 es el nuevo modelo de codificación de Microsoft dentro de GitHub Copilot, a $0.50/$2.50 por millón de tokens hasta el 17 de mayo de 2027. Las propias pruebas de Microsoft le dan el 98 % de la puntuación de GPT-6.1 Sol al 40 % del costo por tarea, pero ese costo usa el precio de promoción. Al precio de lista de $1/$5, las mismas tareas cuestan alrededor del 81 % de lo que cobra Sol.
Así que hoy es una buena opción por defecto para trabajo rutinario en varios archivos en Copilot. Mantenga un modelo más grande para tareas de repositorio largas y difíciles, donde queda 14 puntos por detrás de Claude Opus 5.5 en SWE Atlas.
¿Qué es MAI Code 2?
MAI Code 2 es un modelo de codificación que Microsoft AI entrenó desde cero y lanzó en Ignite el 17 de noviembre de 2026. La publicación de lanzamiento lo presenta para "tareas de codificación empresarial del día a día" y dice que "destaca en llevar código a producción, depuración profunda, implementación en varios archivos, razonamiento a nivel de repositorio y UI". Un hermano más pequeño, MAI Code 2 Flash, se lanzó el mismo día para ediciones rutinarias de gran volumen.
Es la segunda generación de la línea de codificación propia de Microsoft. MAI-Code-1-Flash llegó a GitHub Copilot en junio, y MAI Code 1.1 Flash le siguió en agosto. El salto esta vez está en el tamaño y el alcance. Según la model card, ambos modelos nuevos tienen una ventana de contexto de 1.050.000 tokens (922.000 de entrada, 128.000 de salida) y cinco niveles de esfuerzo de razonamiento, de bajo a máximo.
Soy ingeniero en el producto de eesel, y la mayor parte de mi día son integraciones y trabajo de API, así que vivo en un editor con un modelo de IA en el panel lateral. También trabajo en los agentes de IA de eesel que funcionan en colas de soporte reales, y con la CLI de eesel, un agente de codificación en ese mismo editor puede subir artículos de ayuda aprobados a un agente de eesel, ajustar sus instrucciones y ejecutar preguntas de prueba antes de que nada salga en vivo. Así que cuando aparece un nuevo modelo de codificación, la pregunta que me interesa es simple: ¿qué cuesta una tarea normal y dónde falla?
¿Cuál es la diferencia entre MAI Code 2 y MAI Code 2 Flash?
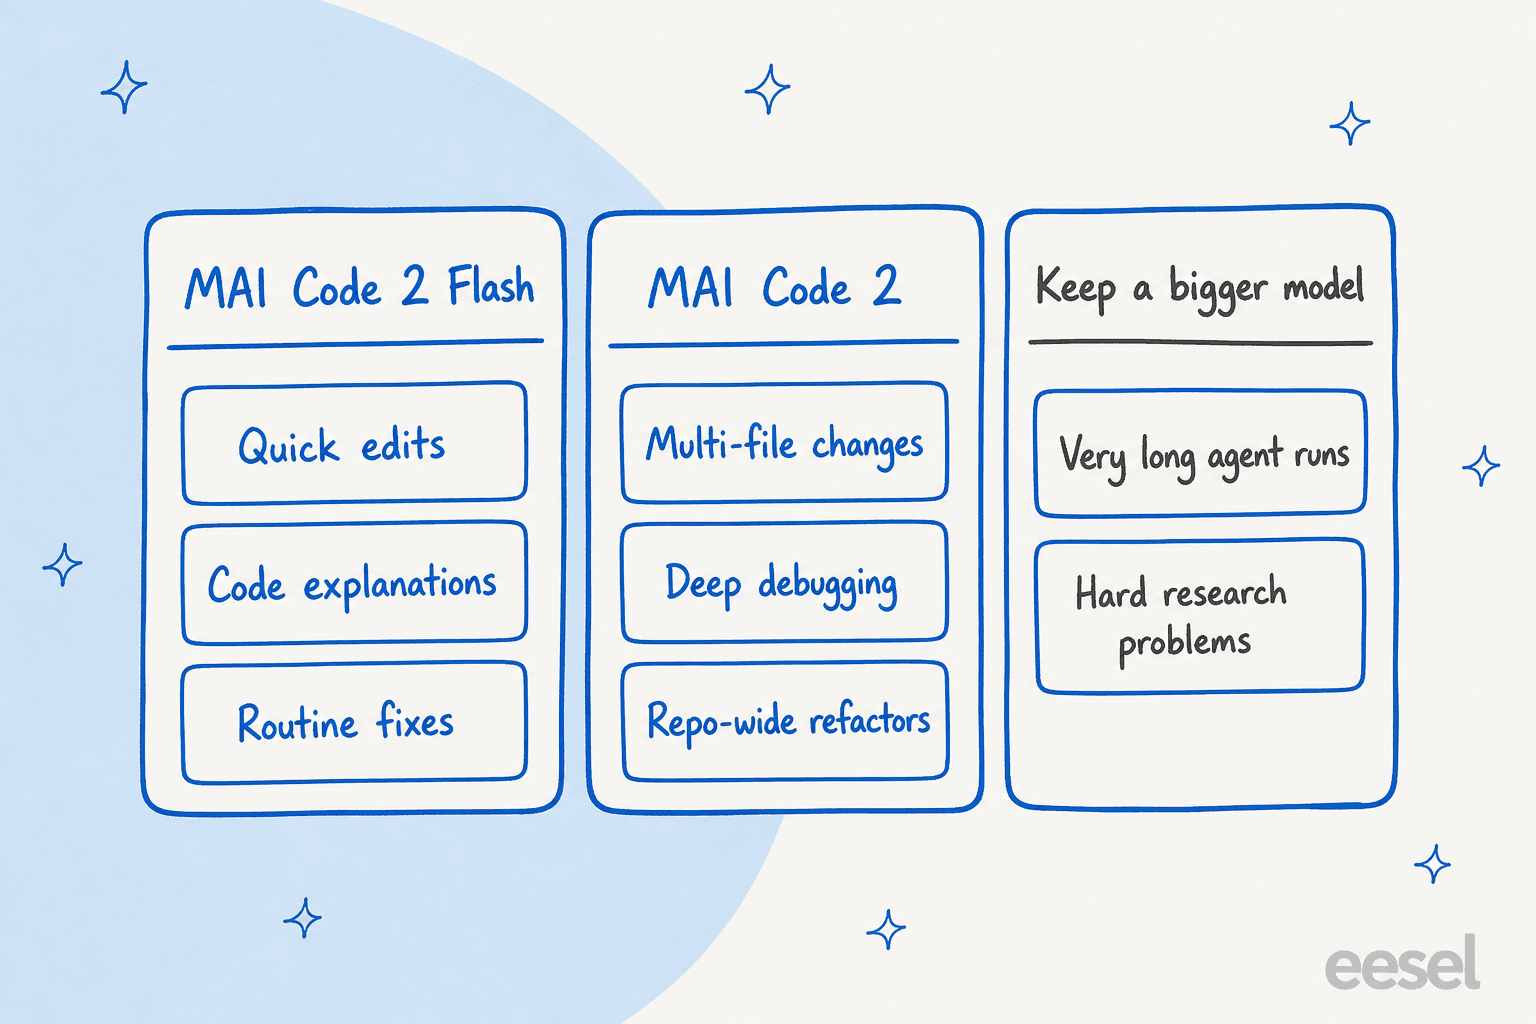
Los dos modelos dividen el trabajo por dificultad. El changelog de GitHub de Microsoft describe a MAI Code 2 como un modelo de propósito general "ideal para tareas complejas como depuración profunda, implementación en varios archivos, refactorización y razonamiento a nivel de repositorio". Flash es "un modelo de codificación ligero y eficiente en costo, optimizado para los flujos de trabajo de desarrollo del día a día".
| MAI Code 2 | MAI Code 2 Flash | |
|---|---|---|
| Construido para | Cambios en varios archivos, depuración profunda, razonamiento a nivel de repositorio | Ediciones rápidas, explicaciones de código, arreglos de rutina |
| Parámetros activos | 77 mil millones (unos 2,8 billones en total) | 12 mil millones (unos 398 mil millones en total) |
| Ventana de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Precio de promoción por 1M de tokens (entrada/salida) | $0.50 / $2.50 | $0.05 / $0.25 |
| Planes de Copilot | Pro, Pro+, Max, Business, Enterprise | Igual, más Free y Student |
| Microsoft Foundry | Todavía no | Vista previa de acceso limitado |
| Comparación de Microsoft | GPT-6.1 Sol, Claude Opus 5.5 | GPT-6 Luna, Claude Haiku 5.5 |
Los recuentos de parámetros vienen de la sección 1 de la model card. La propia tabla resumen de la ficha dice "80B activos" para MAI Code 2, así que trate la cifra exacta como aproximada. En cualquier caso, ambos son modelos de mezcla de expertos disperso, lo que significa que solo una parte de la red se activa en cada token. Ese diseño ayuda a mantener bajo el precio.
Un detalle que no esperaba: Flash supera a su hermano mayor en un benchmark. En SWE Atlas, Flash obtiene 44,8 % frente al 43,1 % de MAI Code 2, según la publicación de lanzamiento. Es una brecha pequeña, pero indica que la ventaja del modelo más grande no es uniforme.
¿Cuánto cuesta MAI Code 2?
En GitHub Copilot, MAI Code 2 cuesta $0.50 por millón de tokens de entrada y $2.50 por millón de tokens de salida hasta el 17 de mayo de 2027. Después de eso, el precio se duplica a $1.00 y $5.00, según la documentación de precios de GitHub. Copilot factura esto en créditos de IA, donde un crédito equivale a un centavo.
| Modelo | Entrada (por 1M) | Entrada en caché (por 1M) | Salida (por 1M) |
|---|---|---|---|
| MAI Code 2, promoción hasta el 17 de mayo de 2027 | $0.50 | $0.025 | $2.50 |
| MAI Code 2, desde el 17 de mayo de 2027 | $1.00 | $0.05 | $5.00 |
| MAI Code 2 Flash, promoción | $0.05 | $0.005 | $0.25 |
| MAI Code 2 Flash, desde el 17 de mayo de 2027 | $0.10 | $0.01 | $0.50 |
| GPT-6.1 Sol (hasta 272K) | $2.00 | $0.10 | $10.00 |
| GPT-6.2 Sol (hasta 272K) | $2.00 | $0.10 | $10.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
| GPT-6 Luna (hasta 272K) | $0.10 | $0.01 | $0.50 |
| Claude Haiku 5.5 (hasta 100K) | $0.10 | $0.01 | $0.50 |
Todas las filas vienen de la misma página de GitHub. Si tiene un plan anual Copilot Pro o Pro+ que todavía usa la facturación antigua por solicitud, los multiplicadores heredados son 1x para MAI Code 2 y 0.33x para Flash. La lista completa de planes está en la guía de precios de GitHub Copilot.
¿Cuánto cuesta realmente una tarea de codificación?
Los precios por token son solo la mitad de la cuenta. La otra mitad es cuántos tokens quema un modelo para terminar una tarea, y Microsoft también publicó eso. Con el esfuerzo de razonamiento al máximo, promediado sobre cuatro benchmarks, la publicación de lanzamiento enumera estos costos por tarea:
| Modelo | Tasa de aciertos promedio | Costo por tarea (Microsoft) | Costo por tarea a precio de lista (mi cálculo) |
|---|---|---|---|
| MAI Code 2 | 63,2 % | $0.309 (precio de promoción) | $0.618 |
| GPT-6.1 Sol | 64,1 % | $0.761 | $0.761 |
| Claude Opus 5.5 | 65,3 % | $6.306 | $6.306 |
| MAI Code 2 Flash | 61,0 % | $0.052 (precio de promoción) | $0.104 |
| GPT-6 Luna | 55,1 % | $0.080 | $0.080 |
| Claude Haiku 5.5 | 53,9 % | $0.319 | $0.319 |
Las filas de Flash promedian tres benchmarks, no cuatro, porque la tabla de Microsoft para el modelo pequeño deja fuera FrontierCode. Mi columna de precio de lista simplemente duplica la cifra de Microsoft, porque cada tarifa de MAI se duplica el 17 de mayo de 2027 y el número de tokens por tarea no cambia.
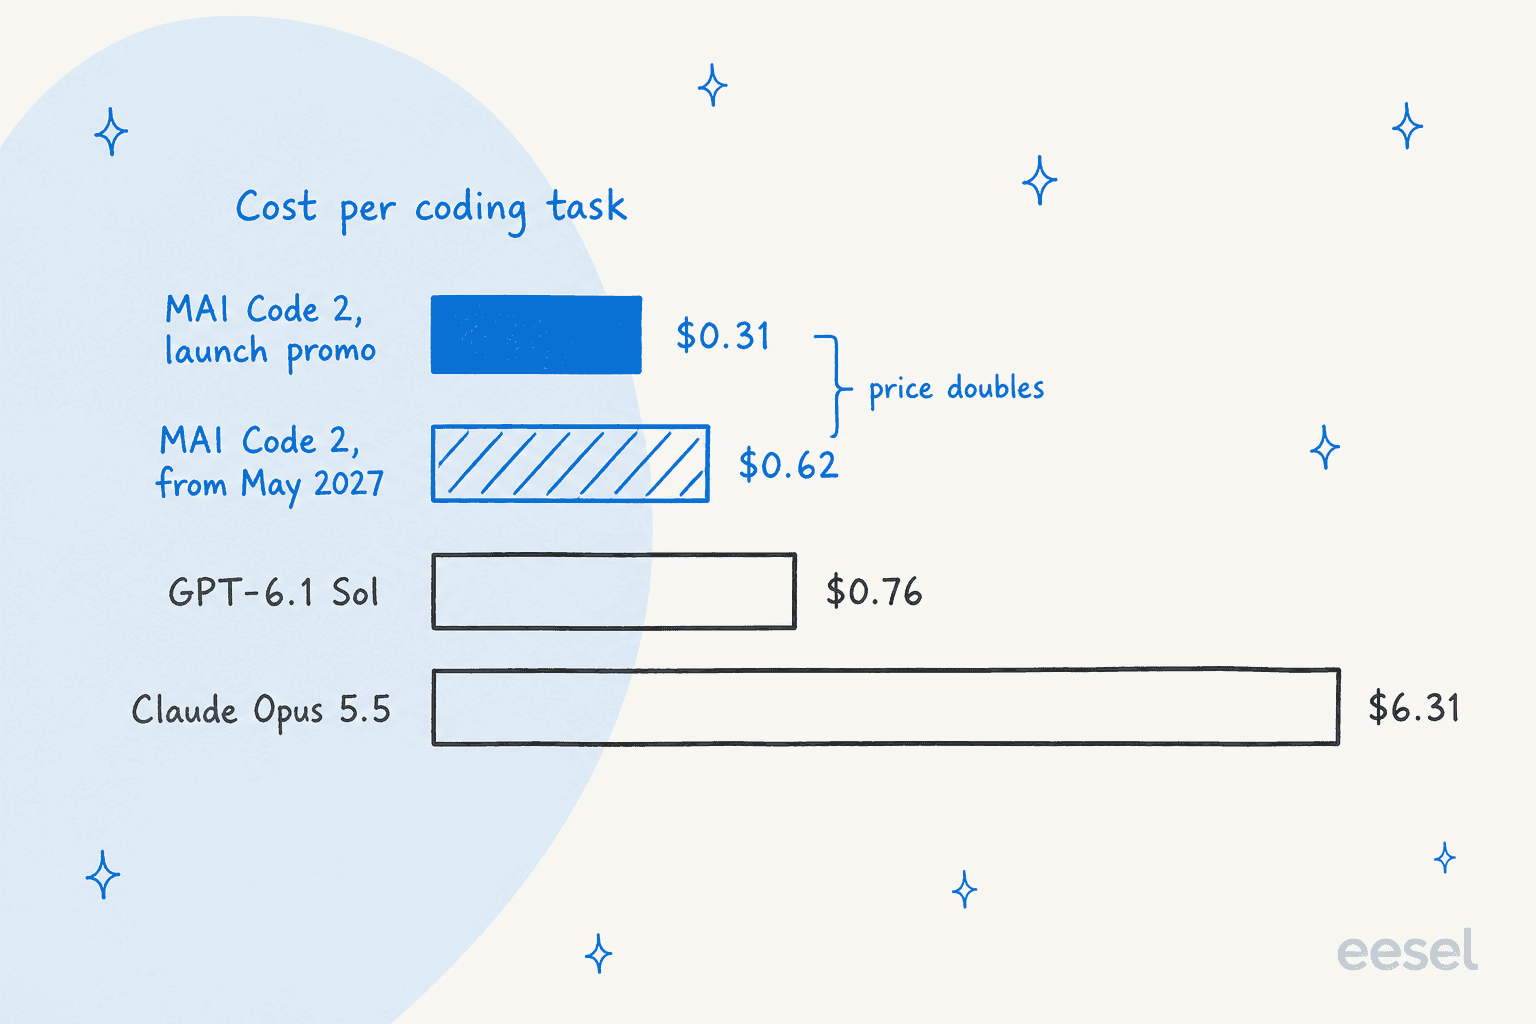
Esta es la parte que la mayoría de la cobertura del lanzamiento se salta. El precio por token de MAI Code 2 es un cuarto del de GPT-6.1 Sol durante la promoción, pero su costo por tarea es el 40 % del de Sol. Esa brecha significa que MAI Code 2 usó aproximadamente 1,6 veces más tokens por tarea que Sol en las propias pruebas de Microsoft. En cuanto termine la promoción, ese apetito de tokens se come la mayor parte del descuento, y el titular de "40 % del costo" se convierte en alrededor del 81 %.
Un comentarista en Hacker News hizo la pregunta obvia sobre la promoción:
"The promotional period lasts until May 2027. Why not just make the price lower if they'll be irrelevant by the time the "real" price kicks in?"

Es un punto justo. Seis meses es mucho tiempo en este mercado, y el modelo con el que se compare en mayo de 2027 probablemente ya no será GPT-6.1 Sol.
¿Los benchmarks de MAI Code 2 se sostienen?
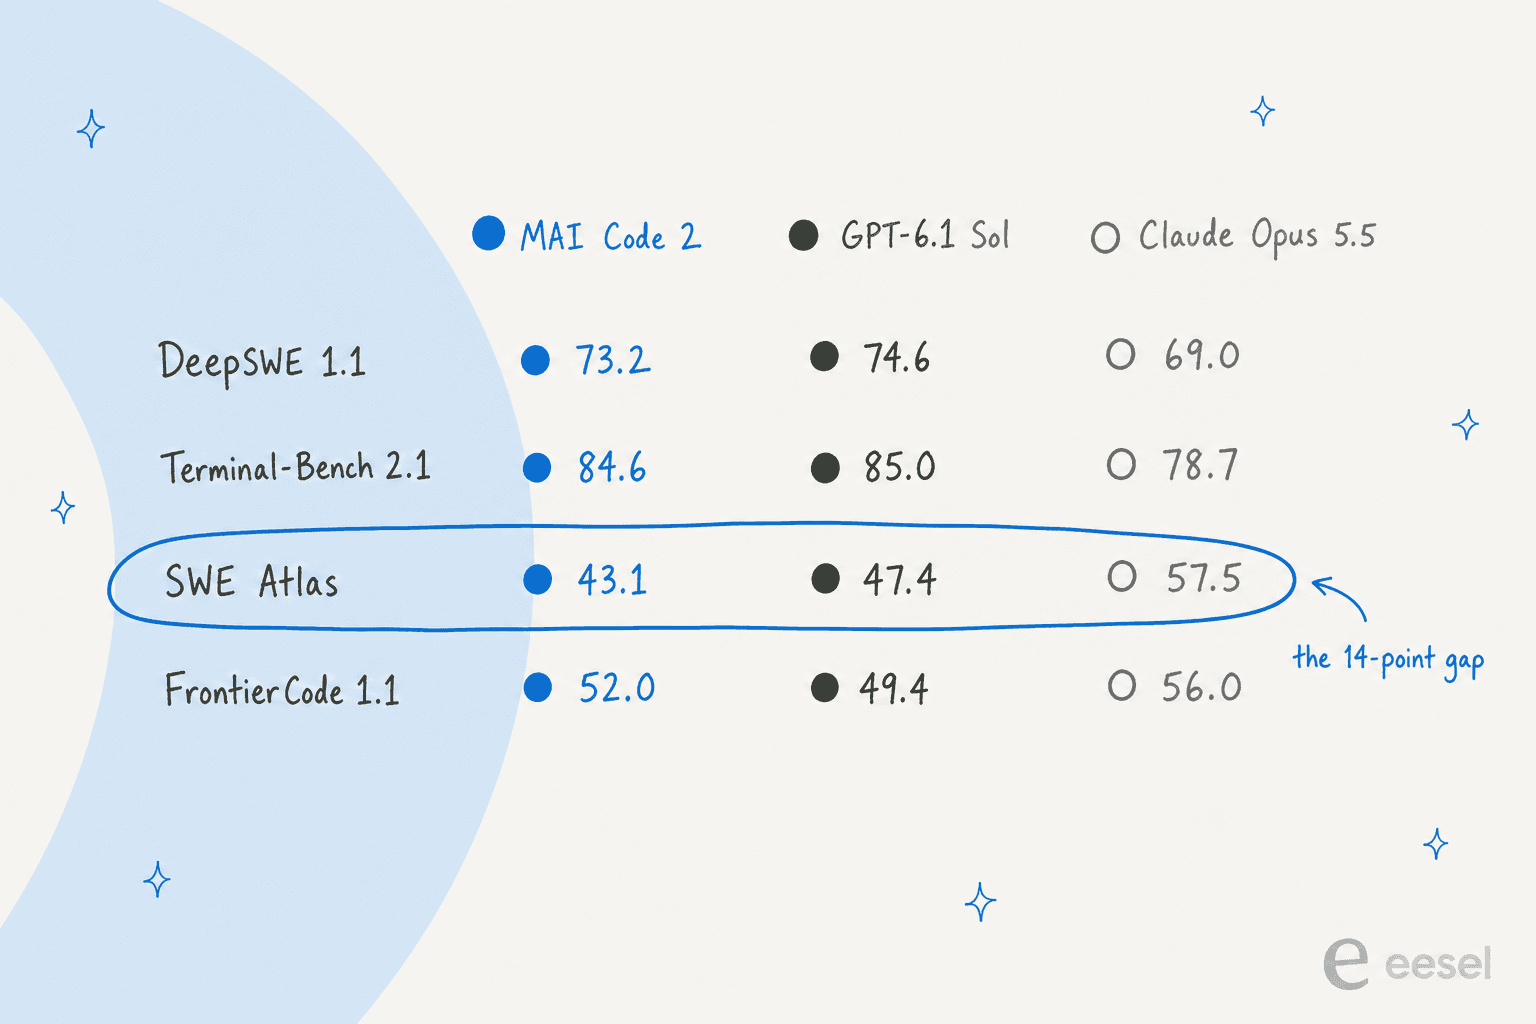
En su mayoría, con tres advertencias que vale la pena conocer antes de confiar en el titular del 98 %. Aquí está la tabla completa de Microsoft, todo con el esfuerzo de razonamiento al máximo, de la publicación de lanzamiento:
| Benchmark | MAI Code 2 | GPT-6.1 Sol | Claude Opus 5.5 | Quién lo ejecutó |
|---|---|---|---|---|
| DeepSWE 1.1 | 73,2 % | 74,6 % | 69,0 % | Microsoft |
| Terminal-Bench 2.1 | 84,6 % | 85,0 % | 78,7 % | Microsoft |
| SWE Atlas | 43,1 % | 47,4 % | 57,5 % | Microsoft |
| FrontierCode v1.1 | 52,0 % | 49,4 % | 56,0 % | Artificial Analysis |
| Promedio | 63,2 % | 64,1 % | 65,3 % |
Advertencia 1: Microsoft ejecutó tres de las cuatro pruebas por su cuenta. DeepSWE, Terminal-Bench y SWE Atlas corrieron en MSBench, la plataforma de evaluación interna de Microsoft, usando la CLI de Copilot sin subagentes. Solo FrontierCode vino de un tercero externo. Eso no hace que las cifras sean incorrectas, pero nadie independiente las ha vuelto a ejecutar todavía. Cuando lo revisé el 18 de noviembre, Artificial Analysis no tenía todavía una página de modelo para MAI Code 2.
Advertencia 2: el promedio esconde una brecha real. MAI Code 2 supera a Opus 5.5 en DeepSWE y Terminal-Bench. En SWE Atlas, obtiene 43,1 % frente al 57,5 % de Opus, una brecha de 14,4 puntos. Si su trabajo se parece a cambios de repositorio largos y extensos, esa fila importa más que el promedio.
Advertencia 3: las comparaciones están un poco desactualizadas. Microsoft comparó contra GPT-6.1 Sol el mismo día en que OpenAI lanzó GPT-6.2 Sol. La guía de GPT-6.2 Sol cubre ese lanzamiento. Hacker News lo notó:
"They are comparing to Sol 6.1's API prices. With Sol 6.2, and especially if you consider subsidization from Codex subscriptions, it's probably no longer on the Pareto frontier."
Otros señalaron las versiones de los benchmarks. Un comentarista notó que Terminal-Bench está "actualmente en la versión 4 (que es sustancialmente más difícil)" y FrontierCode "en la 2.0", mientras que Microsoft reportó 2.1 y 1.1. Los tres modelos se evaluaron en las mismas versiones, así que el orden se mantiene, pero los números absolutos se verán más bajos en las pruebas más nuevas.
Hay un resultado que tomaría al pie de la letra: en trabajo de frontend, revisores a ciegas prefirieron la salida de MAI Code 2 frente a la de GPT-6 Sol el 64 % de las veces, entre 258 evaluadores. La calidad de UI es difícil de falsear eligiendo el benchmark, y es justo el tipo de tarea del día a día para la que Microsoft dice haberlo construido.
¿Cómo se obtiene acceso a MAI Code 2?
Por ahora, solo a través de GitHub Copilot y en ningún otro lugar. Ambos modelos están disponibles de forma general, no en vista previa, según el changelog de GitHub.
- Planes: MAI Code 2 está en Copilot Pro, Pro+, Max, Business y Enterprise. Flash suma Free y Student, pero esos planes solo lo alcanzan mediante la selección automática de modelo.
- Dónde: el selector de modelos en VS Code, Visual Studio, JetBrains, Xcode, Eclipse, la CLI de Copilot, el agente en la nube, la app de Copilot, github.com y GitHub Mobile.
- Administradores: en Business y Enterprise, los modelos nuevos están activados por defecto a menos que un administrador haya desactivado el valor predeterminado global. Eso es un cambio respecto a MAI Code 1.1 Flash, que estaba desactivado por defecto en agosto.
- API: solo Flash está en Microsoft Foundry, como vista previa de acceso limitado y sin precio publicado todavía. MAI Code 2 en sí no está allí.
- Próximamente: Microsoft nombra a OpenRouter, Vercel, Hermes, Open Code y Kilo, sin fechas.
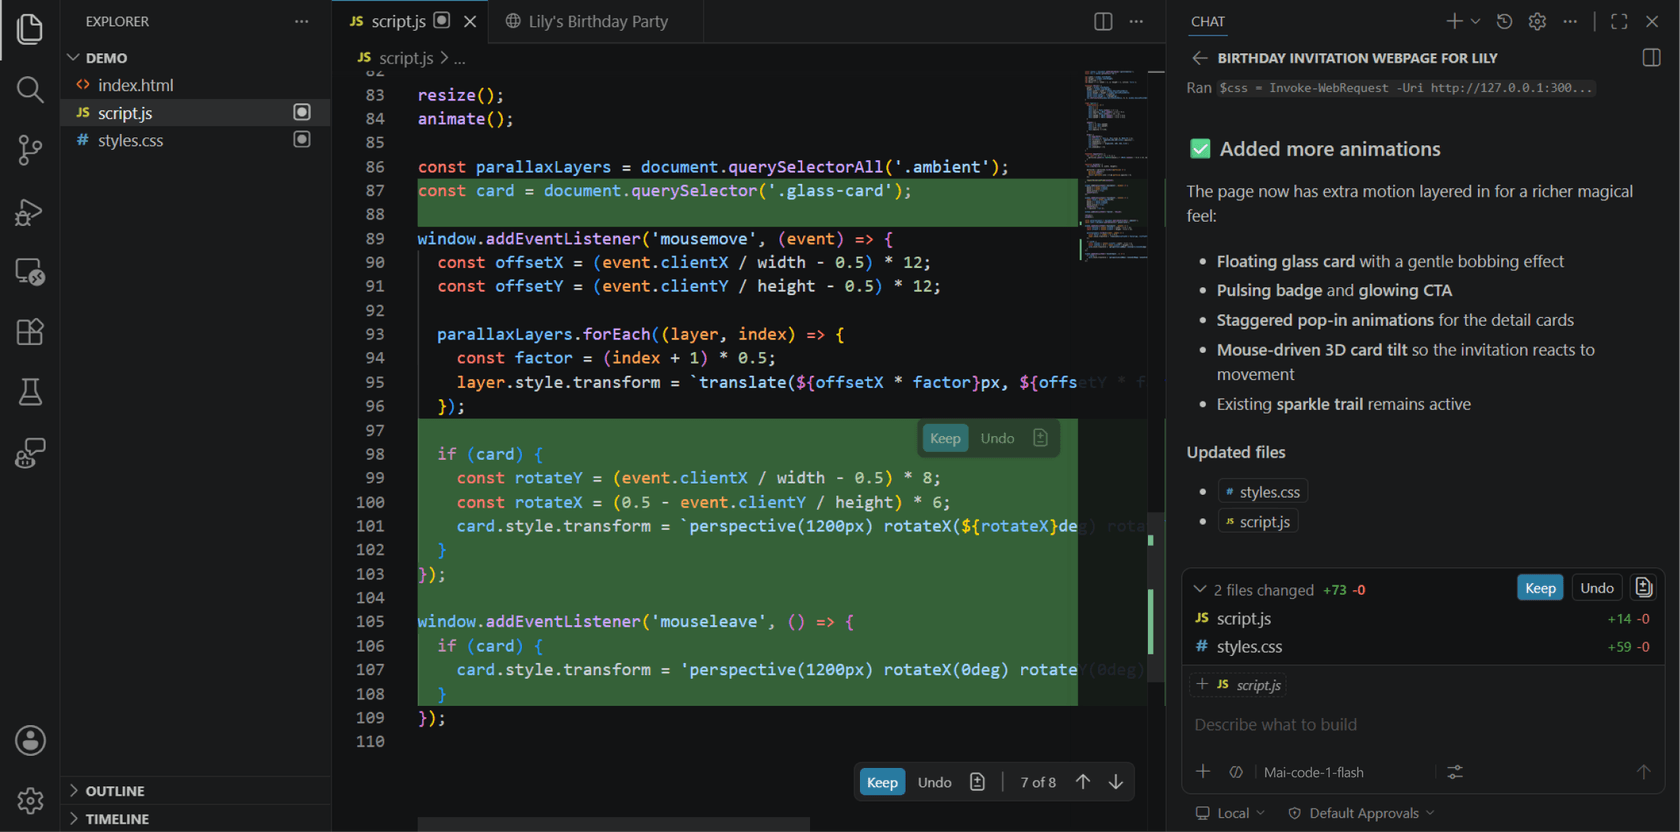
Esa captura es del lanzamiento anterior de MAI-Code-1-Flash, pero el flujo es el mismo para MAI Code 2: abra el chat de Copilot, elija el modelo en la parte inferior y trabaje como siempre. Si es administrador, revise ahora su política de modelos. Un modelo que su equipo no ha validado y que aparece activado por defecto merece una mirada de cinco minutos.
El acceso es el punto débil para quien está fuera de Copilot. Si usted construye sobre APIs directas, o vive en Claude Code u OpenAI Codex, todavía no puede conectar MAI Code 2. Un usuario de Hacker News resumió la frustración sin rodeos:
"What annoys me a lot about MSFT releases are, that is not possible to find how to use these models and where to try them. I didn't hear anyone in my circle using MAI models, none."
¿Es MAI Code 2 de código abierto?
No. La model card dice que "los pesos del modelo no se distribuyen, y los modelos se sirven en infraestructura de GPU de Microsoft Azure". Algunos artículos iniciales lo llamaron un modelo pequeño de pesos abiertos bajo licencia MIT. Eso parece venir del repositorio microsoft/MAI-Code, que tiene licencia MIT pero solo contiene un README y plantillas de issues para comentarios.
Para las empresas que quieren control sobre los pesos, Microsoft anunció MAI Licensed Weights ese mismo día. Permite a una empresa ejecutar y ajustar modelos MAI en su propio entorno de Azure, y está "próximamente disponible" a través de los equipos de cuenta de Microsoft. Las citas de socios en la página del modelo vienen de esta vía. AT&T dice que su versión personalizada de Flash superó a GPT-6.1 Sol en análisis estándar de redes 5G "siendo 50 veces más barata", según la página del modelo. Esos son modelos ajustados, sin embargo, no el que elegirá en Copilot.
¿Qué dicen los desarrolladores sobre MAI Code 2?
El hilo de lanzamiento en Hacker News llegó a 278 puntos y 131 comentarios en un día. La mayor parte del debate fue sobre benchmarks y facturación, no sobre el modelo en sí, ya que casi nadie había tenido tiempo real con él todavía.
La queja más común fue sobre el montaje de la comparación:
"While showing MAI Code 2 at a 50% promotional discount, and comparing to Max reasoning effort for Opus 5.5 and 6.1 Sol..."
La segunda fue la facturación de Copilot. Desde que GitHub pasó a la facturación por uso en junio, un modelo barato solo ayuda si sus créditos alcanzan:
"I think they won't help if they're billed at the announced rate on your Copilot quota. Microsoft would need to do something like Devin does and offer its own models with separate limits."
El interés fue real, sin embargo, sobre todo entre quienes ya mandan trabajo rutinario a modelos pequeños:
"Price and performance look good based on benchmarks. Am definitely interested in trying this to see given a lot of my workload of actual coding is handed over to Haiku/Luna right now."
Ese último coincide con mi lectura. Quienes más ganan son los que ya tratan la elección de modelo como una palanca de costo. Si está decidiendo entre Copilot, Cursor y una herramienta de codificación en terminal, MAI Code 2 es un motivo para volver a mirar Copilot, no un motivo para cambiar solo por eso.
¿Qué debería vigilar?
Microsoft es inusualmente transparente sobre los límites, algo que valoro. La publicación de lanzamiento dice que ambos modelos "explícitamente aún no están ajustados para problemas más difíciles, como la investigación científica fundamental y el trabajo agéntico de muy largo horizonte". La model card añade algunos puntos más:
- Las sesiones largas se desvían. "En sesiones agénticas largas, los modelos pueden repetir llamadas a herramientas, subutilizar la base de código existente, desviarse de las instrucciones o detenerse antes de verificar por completo su trabajo." Si ejecuta agentes autónomos largos desde una CLI de codificación, revise la salida.
- Solo inglés. "Al lanzamiento, el modelo está optimizado únicamente para la producción de código en inglés." Comentarios y documentación en otros idiomas pueden salir más débiles.
- Más esfuerzo no siempre es mejor. La ficha dice que un mayor esfuerzo de razonamiento "no siempre mejora los resultados". Empiece en medio y suba solo cuando una tarea falle.
- Alineación. Microsoft califica a ambos modelos como "similares en alineación a GPT-5.6 Sol, pero menos alineados que GPT-6". Mantenga sus revisiones habituales sobre cualquier cosa que haga commit.
- Sus prompts pueden haberlo entrenado. Según la data card, el post-entrenamiento usó contextos de conversación de usuarios de Copilot Free, Pro y Pro+ que no habían optado por excluirse. Si esto le importa, revise su configuración de datos de Copilot.
La ficha también califica a ambos modelos con riesgo "Alto" para uso cibernético ofensivo y mal uso químico, biológico, radiológico y nuclear, y dice que se entregan con un clasificador que filtra esas solicitudes. Eso es estándar hoy para un modelo cercano a la frontera, y no afectará el trabajo de codificación normal.
¿Debería usar MAI Code 2?
Si está en Copilot y la mayoría de su trabajo son cambios acotados, sí, al menos mientras dure la promoción. Así dividiría el trabajo:
| Si usa | Mi opinión |
|---|---|
| GPT-6.1 Sol o GPT-6.2 Sol en Copilot | Pruebe MAI Code 2 para trabajo rutinario en varios archivos. Puntuaciones similares a cerca del 40 % del costo por tarea hasta mayo de 2027. Vuelva a revisar después de que el precio se duplique. |
| Claude Opus 5.5 | Mantenga Opus para tareas de repositorio largas y difíciles, donde lidera SWE Atlas por 14 puntos. Mueva los arreglos acotados a MAI Code 2 y ahorre alrededor del 95 % en ellos. |
| GPT-6 Luna o Claude Haiku 5.5 | Pruebe Flash. Obtuvo entre seis y siete puntos más y cuesta menos por tarea durante la promoción. A precio de lista, cuesta más por tarea que Luna. |
| Claude Code, Codex o APIs directas | Espere. MAI Code 2 todavía no es accesible fuera de Copilot, y Flash es solo vista previa en Foundry. |
| Agentes autónomos largos | Quédese con un modelo más grande. Microsoft dice que no está ajustado para trabajo agéntico muy largo. |
Si está evaluando herramientas de codificación de forma más amplia, el resumen de las mejores herramientas de IA y la guía de alternativas a Copilot van más allá de un solo modelo. Los otros modelos propios de Microsoft, como MAI-Transcribe-2 para voz y Decision 1, siguen el mismo libro de jugadas: una tarea estrecha a un precio bajo.
¿Qué significa MAI Code 2 para un equipo de soporte?
Un modelo de codificación más barato es infraestructura más barata. No es un agente de soporte. MAI Code 2 no conoce su política de reembolsos, no puede ver su helpdesk, y Microsoft lo ajustó para escribir código en inglés, no para responder a clientes. Si está construyendo automatización de soporte, el modelo es solo una pieza del trabajo. El resto es conocimiento, tono, barreras de seguridad y reglas de traspaso, algo que una comparación de modelos para soporte no puede resolver por sí sola.
Esa es la capa que construye eesel. MAI Code 2 es infraestructura; eesel es el empleado. Usted contrata a un compañero de IA para helpdesk para su cola, o a un redactor de blog con IA para contenido, y cada uno llega con las integraciones, el conocimiento de la empresa y los límites de su rol. Donde un modelo de codificación sí ayuda es en construir alrededor de él: un desarrollador puede apuntar Copilot o Claude Code a la CLI de eesel para cargar conocimiento aprobado y probar respuestas, mientras que conectar el helpdesk en sí todavía necesita que un administrador lo apruebe.
SE Ranking muestra cómo luce eso a escala. La empresa de software de SEO opera tres productos con un solo equipo de soporte, así que ejecuta tres agentes de eesel, uno por producto, en tres conexiones de Zendesk. Entre el 8 de agosto y el 8 de septiembre de 2026, esos agentes gestionaron 4.650 conversaciones, respondieron primero 2.100 chats en vivo y usaron unas 16.800 páginas de conocimiento. Nada de eso depende de qué modelo esté de moda esta semana, y ese es el punto: el modelo de debajo puede cambiar sin que el cliente lo note.
Si está comparando herramientas para esa tarea, el resumen del mejor software de helpdesk IA cubre el terreno, y los benchmarks de costo por ticket ponen los precios de los modelos junto al costo total de un ticket.
Probar eesel
Si MAI Code 2 le hace pensar en lo que los modelos baratos pueden hacer por su cola de soporte, empiece por la parte que decide si funciona: el compañero de equipo alrededor del modelo. eesel se conecta al helpdesk que ya usa, aprende de sus tickets pasados y de su centro de ayuda, y le permite ejecutarlo contra tickets históricos reales para que pueda leer sus respuestas antes de que un cliente vea una. Los planes son paquetes de créditos fijos desde 299 $ por 500 créditos, así que su factura no cambia cuando el precio por token de un modelo se duplique en mayo.

Puede probar eesel gratis en una parte de su cola, o compararlo con usar ChatGPT directamente si todavía está decidiendo si construirlo usted mismo.