

GPT-6.2 Sol es el modelo cotidiano de OpenAI, lanzado el 17 de noviembre de 2026 al mismo precio de $2/$10 por millón de tokens que GPT-6.1 Sol. Obtiene 57 puntos en Artificial Analysis, dos puntos más, con un coste por tarea alrededor de un 20% menor y un tercio del tiempo, lo que lo pone a la altura del antiguo GPT-6 Astra. La excepción es el código, donde Artificial Analysis midió una caída de 3 puntos.
En mis 15 tickets de soporte pasó todo lo que pasó GPT-6.1 Sol, por alrededor de un 5% más por ticket. Si usas 6.1 Sol, cámbiate. Para respuestas de cara al cliente, un teammate de IA para helpdesk con grounding como eesel importa más que el modelo que hay debajo.
¿Qué es GPT-6.2 Sol?
GPT-6.2 Sol es la mitad de nivel medio del lanzamiento de noviembre de OpenAI, el sucesor de GPT-6.1 Sol. La publicación de lanzamiento lo llama "nuestro modelo eficiente y versátil para el trabajo diario", y dice que muchos empleados de OpenAI lo usan como su modelo por defecto tanto para tareas técnicas como no técnicas. Su hermano mayor, GPT-6.2 Astra, se lanzó el mismo día para los proyectos más difíciles.
Construyo agentes de IA en eesel, así que mi primer movimiento con cualquier modelo nuevo es llamarlo desde código y ver qué hace en trabajo real. El ID gpt-6.2-sol funcionó con mi clave de API a las pocas horas del lanzamiento, y lo puse a prueba con los mismos tickets de soporte que usé para la reseña de GPT-6.1 Sol. Los resultados están más abajo.
Sobre la disponibilidad, OpenAI dice que ambos modelos están disponibles para usuarios Plus, Pro, Enterprise y Edu en ChatGPT Work y Codex, y en la API. Los usuarios Enterprise y Edu obtienen acceso una vez que un administrador del workspace lo activa. Los suscriptores Pro 500 pueden ejecutar cualquiera de los dos modelos en modo Ultrafast, y por primera vez Ultrafast llega a Pro 200, empezando con Sol. La guía de precios de ChatGPT cubre lo que cuesta cada plan.
¿Qué cambió respecto a GPT-6.1 Sol?
El precio se mantuvo, así que la pregunta es qué compra ahora el mismo dinero. OpenAI dice que GPT-6.2 Sol es "más inteligente, más eficiente, y te deja completar más tareas en el mismo plan de pago." En su benchmark interno GDPval v2, que prueba flujos de trabajo profesionales largos, Sol mejoró 5,3 puntos respecto a GPT-6.1 Sol.
Aquí están las especificaciones de la página del modelo y Artificial Analysis, junto al modelo anterior:
| GPT-6.1 Sol | GPT-6.2 Sol | |
|---|---|---|
| Lanzamiento | 29 de septiembre de 2026 | 17 de noviembre de 2026 |
| Entrada / salida (por 1M) | 2 $ / 10 $ | 2 $ / 10 $ |
| Entrada en caché (por 1M) | 0,10 $ | 0,10 $ |
| Ventana de contexto | 1.050.000 tokens | 1.050.000 tokens |
| Entrada máx. / salida máx. | n/a | 922.000 / 128.000 |
| Fecha de corte de conocimiento | n/a | 1 de junio de 2026 |
| Menor esfuerzo de razonamiento | low | low (none se rechaza) |
| AA Intelligence Index (max) | 55 | 57 |
| AA coste por tarea (max) | 1,27 $ | 1,01 $ |
| AA tiempo por tarea (max) | 23,1 min | 7,9 min |
| AA Coding Agent Index | base | 3 puntos menos |
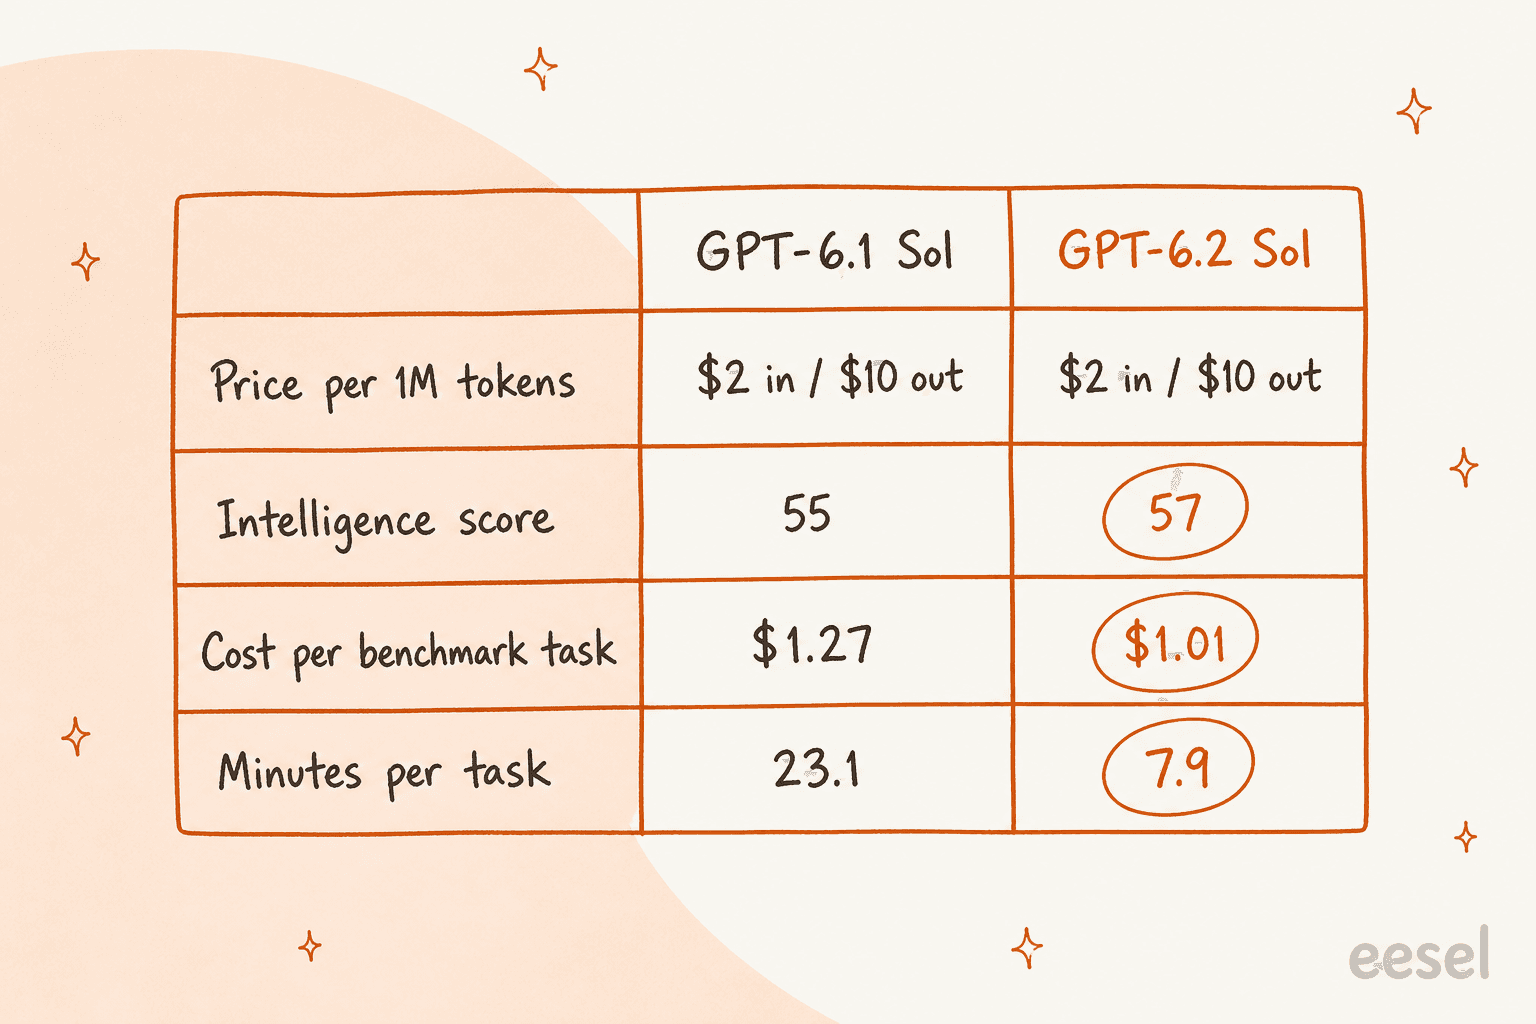
La ganancia en velocidad es la que vas a notar. Con el máximo esfuerzo, Artificial Analysis registró 7,9 minutos por tarea de benchmark, frente a 23,1 del modelo anterior, y un tiempo hasta el primer token de respuesta de 57,6 segundos frente a 156,2. El máximo esfuerzo es un modo lento en cualquier caso, pero el modelo anterior era de los más lentos en su categoría de precio, y este es más rápido que el promedio.
¿Cuánto cuesta GPT-6.2 Sol?
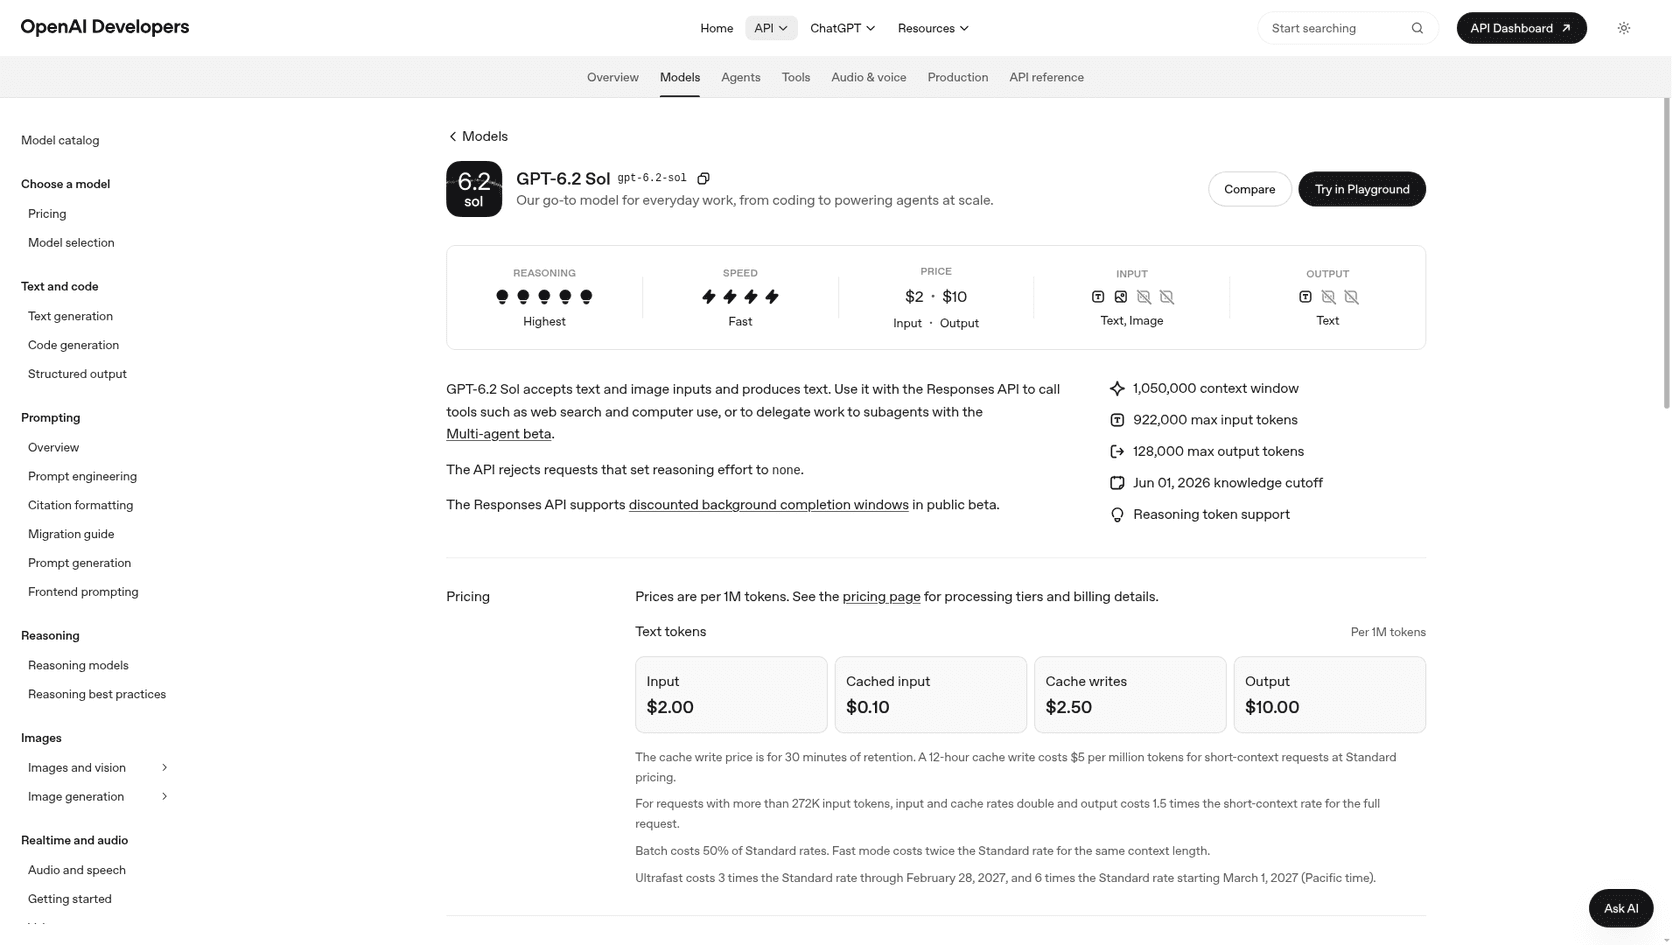
GPT-6.2 Sol cuesta 2 $ por millón de tokens de entrada, 0,10 $ en caché, y 10 $ por millón de tokens de salida en el nivel Standard. OpenAI dice que "mantiene las tarifas de GPT-6.1 Sol." Aquí está la tabla de la página de precios de OpenAI:
| Nivel | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| Standard | 2,00 $ | 0,10 $ | 10,00 $ |
| Batch | 1,00 $ | 0,05 $ | 5,00 $ |
| Fast | 4,00 $ | 0,20 $ | 20,00 $ |
| Ultrafast (hasta el 28 feb. 2027) | 6,00 $ | 0,30 $ | 30,00 $ |
| Ultrafast (desde el 1 mar. 2027) | 12,00 $ | 0,60 $ | 60,00 $ |
Algunas líneas de esa página cambian la factura real:
- Las escrituras en caché cuestan más que la entrada normal. Una escritura en caché de 30 minutos cuesta 2,50 $ por millón de tokens, y una de 12 horas, 5 $. Es en las lecturas donde se ahorra.
- Los prompts largos cuestan más. Por encima de 272.000 tokens de entrada, las tarifas de entrada y caché se duplican, y la salida cuesta 1,5 veces más, para toda la solicitud.
- Ultrafast se duplica el 1 de marzo de 2027. Es 3 veces Standard hasta el 28 de febrero de 2027, luego 6 veces.
- Las solicitudes en segundo plano son más baratas. Las solicitudes elegibles cuestan un 30% menos que Standard en una ventana de 2 horas y un 40% menos en una de 8 horas.
- Flex falta. La página lista Flex a 1 $/5 $ para GPT-6.1 Sol, pero no para GPT-6.2 Sol. Batch y las solicitudes en segundo plano son por ahora las rutas de descuento.
A tarifas Standard, Sol cuesta una cuarta parte de los $8/$40 de GPT-6.2 Astra. La guía más amplia de precios de la API de OpenAI cubre cómo se ordena el resto del catálogo.
¿Se sostienen los benchmarks?
En general sí, con una excepción clara que OpenAI dejó fuera de sus gráficos.
OpenAI dice que en el FrontierCode 2.0 de Cognition, Sol "se queda a 0,5 puntos" de Astra a aproximadamente una quinta parte del coste, y que en su prueba de tareas cotidianas LifeVal, Sol supera a GPT-6 Astra a aproximadamente una séptima parte del coste. Artificial Analysis, que ejecuta sus propias pruebas, está mayormente de acuerdo. Sus números con el máximo esfuerzo:
| Modelo | AA Intelligence Index | Coste por tarea | Tasa de alucinación |
|---|---|---|---|
| Claude Fable 5.2 | 65 | 26,54 $ | 59% |
| GPT-6.2 Astra | 62 | 4,00 $ | 59% |
| Gemini 4 Carbon (high) | 60 | n/a | 11% |
| Claude Opus 5.5 | 59 | n/a | 50% |
| GPT-6.2 Sol | 57 | 1,01 $ | 55% |
| GPT-6 Astra | 57 | 6,24 $ | 50% |
| GPT-6.1 Sol | 55 | 1,27 $ | n/a |
La línea para subrayar: GPT-6.2 Sol ahora igual la puntuación del antiguo buque insignia a aproximadamente un 15% de su coste por tarea, según Artificial Analysis. La gama media de OpenAI sigue acercándose a su propio buque insignia, y este modelo está a la altura del modelo tope de OpenAI de septiembre por una fracción del coste.
Dos resultados son menos favorables:
- El código retrocedió. En el Coding Agent Index de Artificial Analysis, que usa el harness de Codex con el máximo esfuerzo, GPT-6.2 Sol "pierde 3 puntos respecto a GPT-6.1 Sol." AA dice que la caída viene de un descenso de 14 puntos en SWE-Atlas-QnA-AA, donde el modelo es "más propenso que su predecesor a omitir hechos clave en sus respuestas." OpenAI reporta mejoras en sus propias pruebas de código, así que trata las afirmaciones sobre código como no probadas hasta que tu propio repositorio diga lo contrario.
- Sigue adivinando. En AA-Omniscience, la tasa de alucinación de Sol es del 55% con el máximo esfuerzo. Esa es la proporción de preguntas que responde mal en lugar de admitir que no las sabe. Gemini 4 Carbon se sitúa en 11% en la misma prueba.
Ese segundo punto es el que yo sopesaría antes de poner este modelo frente a clientes. Un modelo que adivina necesita estar anclado en tus propios documentos y saber cuándo detenerse, que es todo el trabajo de la prevención de alucinaciones en soporte.
¿Qué nivel de esfuerzo deberías usar?
Para la mayoría del trabajo, medium. Artificial Analysis publica puntuaciones para los cinco niveles de esfuerzo, y la curva se aplana rápido:
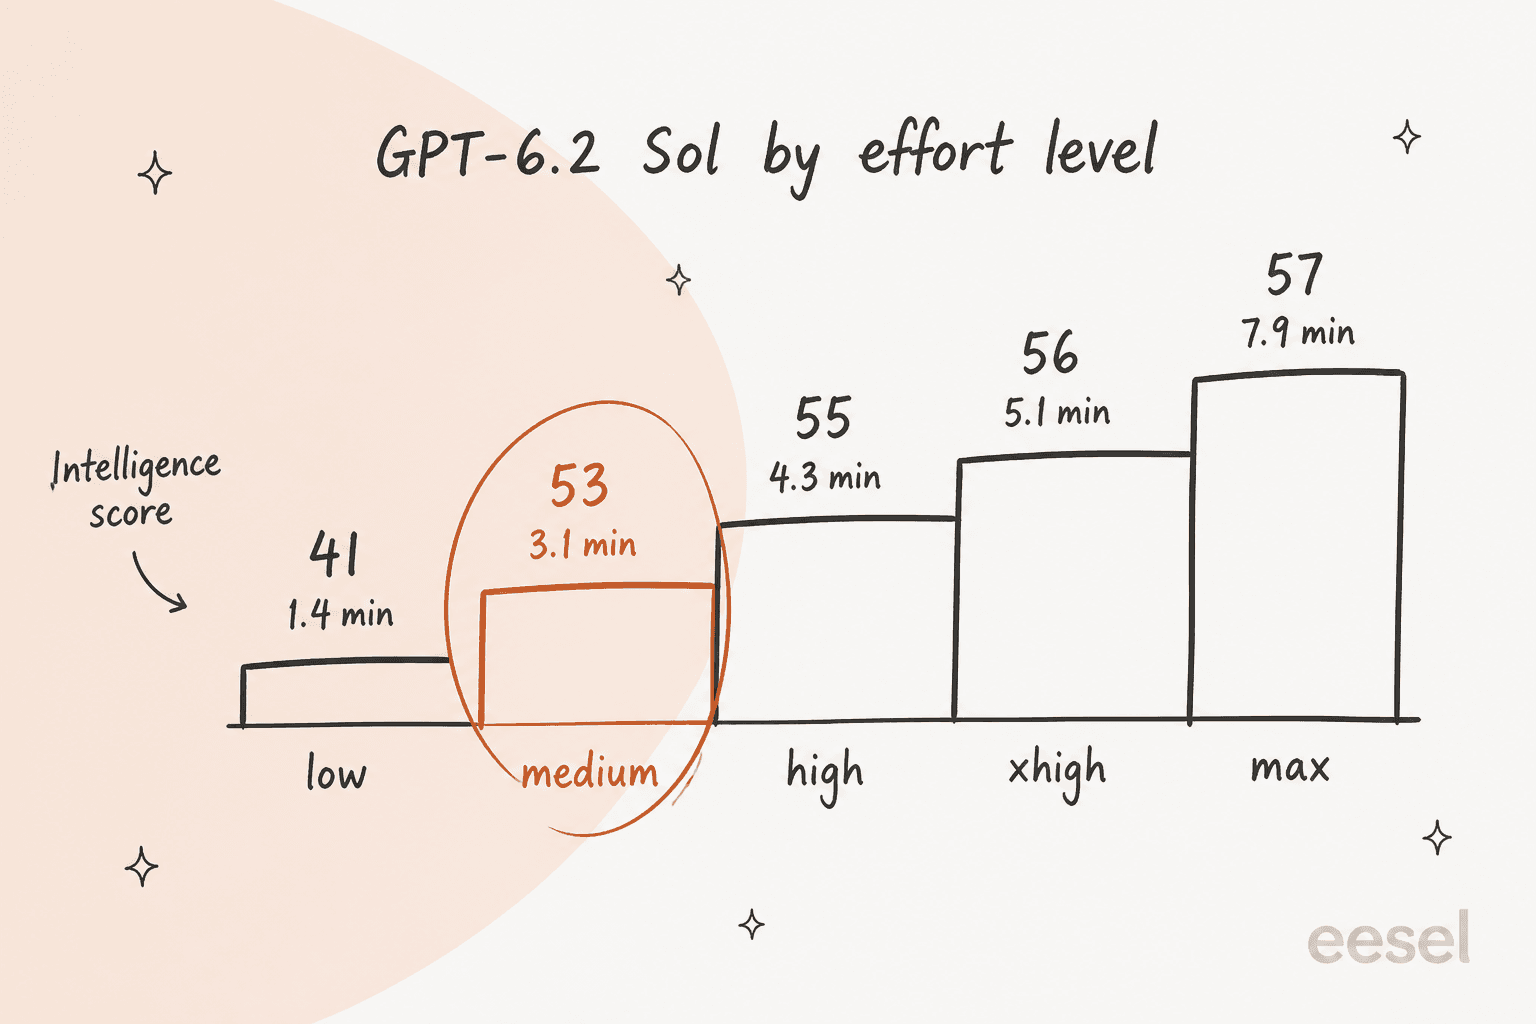
Medium te da 53 de los 57 puntos del máximo esfuerzo en 3,1 minutos por tarea en lugar de 7,9. Low cae a 41, que es donde empieza la pérdida real de calidad. La propia guía de migración de OpenAI dice que las integraciones nuevas deben empezar en medium, y la API rechaza none, así que low es el suelo.
Los tokens de salida siguen la misma forma. Artificial Analysis contó 60,9 millones de tokens de salida en max, 14,6 millones en medium, y 7,2 millones en low, frente a 63,7 millones en max para GPT-6.1 Sol. Como la salida se cobra a cinco veces la entrada, el ajuste de esfuerzo mueve tu factura más que la elección del modelo.
¿Qué dicen los primeros probadores?
La reacción al dúo se dividió con fuerza. La página de lanzamiento de OpenAI trae citas entusiastas de clientes tempranos. Varios probadores conocidos con acceso temprano dijeron lo contrario, en voz alta:
"I will not be writing a full review of GPT-6.2 Astra / Sol. I had a terrible experience testing them. They were essentially unusable."
El equipo de Dan Shipper en Every fue más específico, aunque sobre Astra. Dijeron que las tareas de código reales "seemed to stop too early frequently", y que la escritura se entrenó para ser tan concisa que resultaba "hard to understand".
En Hacker News, donde el hilo de lanzamiento superó los 500 comentarios, los desarrolladores pasaron la mayor parte del tiempo en la pregunta Sol contra Astra. Un usuario llamó a Sol un caballo de batalla diario:
"Happy for the new Sol. It's my workhorse on company account."

Otros encontraron la brecha en sitios concretos:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
"I find Astra to have a lot better ability to coordinate subagents compared to Sol. I haven't found a distinction in the complexity of work they can handle."
Eso concuerda con los números: Sol igual al antiguo buque insignia en general, pero el nuevo Astra lidera en el trabajo largo y difícil donde un error se acumula. En una solicitud de reembolso, la brecha no se nota.
¿Cómo le fue a GPT-6.2 Sol en tickets de soporte reales?
Ambos modelos Sol obtuvieron 15 de 15 en mis comprobaciones de políticas, y el nuevo costó alrededor de un 5% más por ticket. Las diferencias aparecieron en comportamientos pequeños, no en las tasas de aprobación.
Repetí la evaluación de mi reseña de GPT-6.1 Sol el 18 de noviembre de 2026 a través de la Responses API:
- Un documento de políticas para una empresa SaaS ficticia: ventanas de reembolso, una regla de 5 días hábiles para cargos duplicados, sin cambios de dirección después del envío, sin códigos de descuento por parte de agentes, y "escalar todo lo que no esté cubierto".
- Una herramienta,
lookup_order, conectada con function calling. Devuelve datos de pedidos predefinidos, "no encontrado" para IDs desconocidos, y un timeout 503 deliberado para un pedido. - 15 tickets que cubren cálculos de reembolso, un cargo duplicado con un cliente enfadado, una inyección de prompt, tickets en español y alemán, un vago "quiero un reembolso", una herramienta rota y un ID de pedido con un error de tecleo (la letra O en vez de un cero).
- Cuatro configuraciones: GPT-6.2 Sol y GPT-6.1 Sol, cada uno en low y medium. Son 60 ejecuciones, cada una leída a mano contra la política.
Esta es una prueba pequeña y hecha a mano, no un benchmark, y cada configuración se ejecutó una sola vez. Te dice cómo se comportan estos modelos en trabajo de soporte limpio, que es la mayor parte del soporte real. Las herramientas de agent evals de OpenAI hacen el mismo trabajo a mayor escala.
| Configuración | Puntuación | Coste por 1.000 tickets | Tiempo de respuesta medio | Tokens de salida medios |
|---|---|---|---|---|
| GPT-6.2 Sol, medium | 15/15 | 1,42 $ | 3,6s | 60 |
| GPT-6.2 Sol, low | 15/15 | 1,41 $ | 3,2s | 58 |
| GPT-6.1 Sol, medium | 15/15 | 1,35 $ | 3,8s | 55 |
| GPT-6.1 Sol, low | 15/15 | 1,32 $ | 3,8s | 52 |
Como referencia, los mismos tickets costaron $5,79 por 1.000 en GPT-6.2 Astra en medium y $6,98 en GPT-6 Astra, en mi prueba anterior.
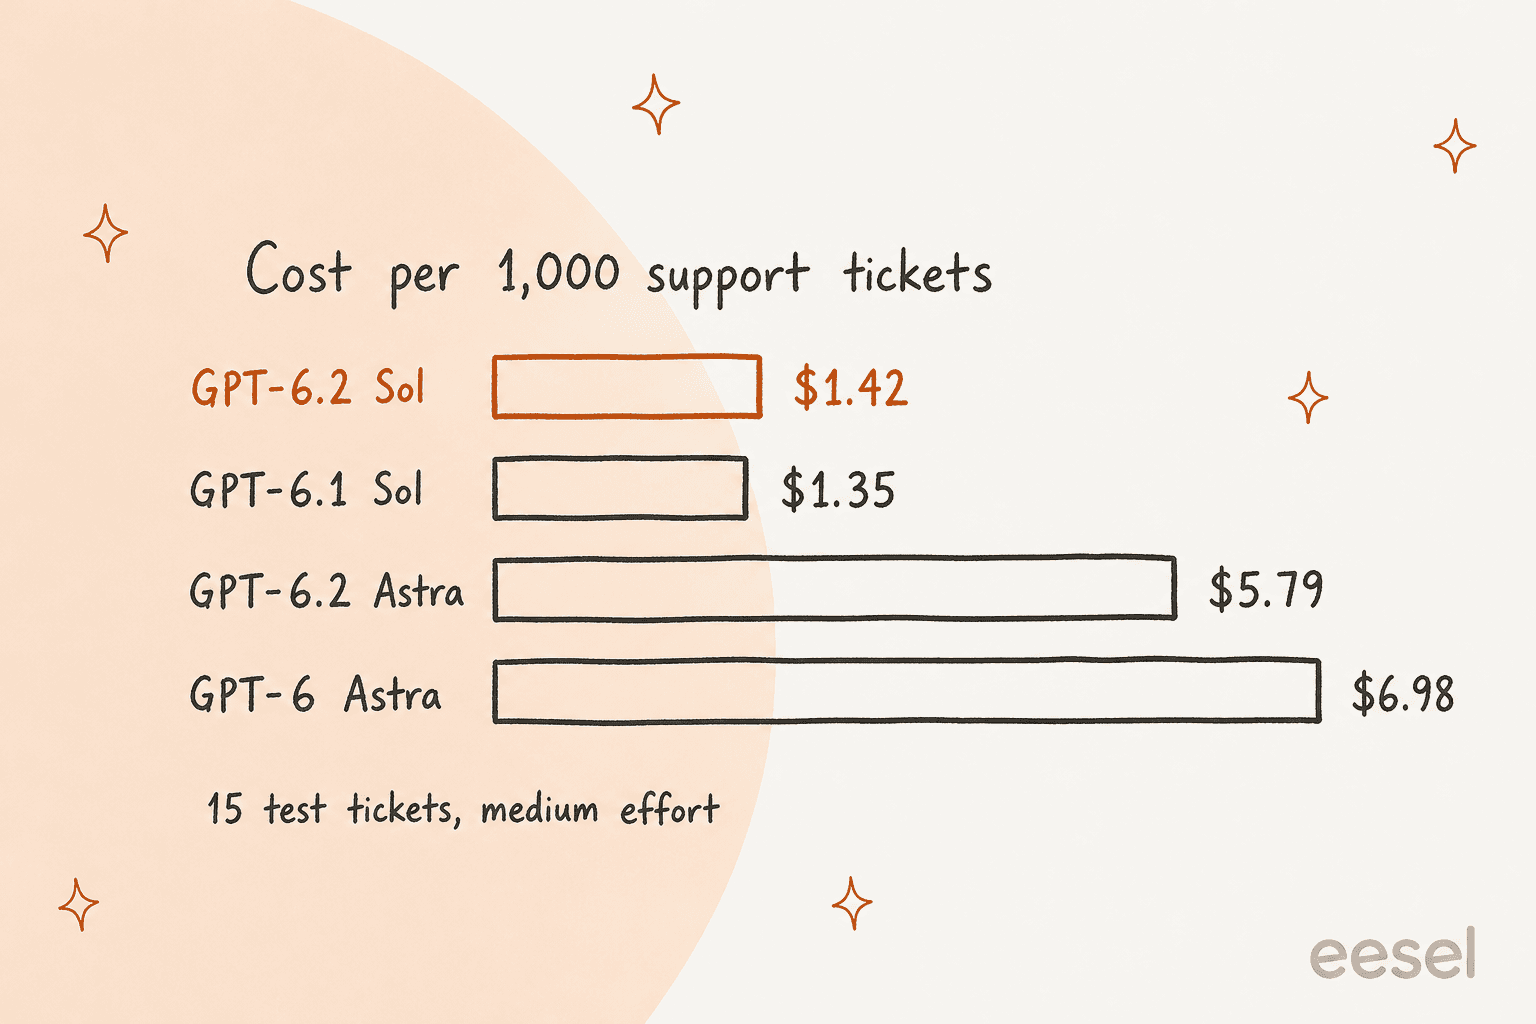
Tres cosas destacaron cuando leí las respuestas una junto a otra.
Mismo precio, respuestas algo más largas. Sol 6.2 promedió 60 tokens de salida por ticket frente a 55 de 6.1. Eso explica toda la diferencia de coste del 5%. Con el precio sin cambios, respuestas algo más largas cuestan algo más. El tiempo de respuesta fue prácticamente igual.
Construyó enlaces que la herramienta nunca dio. En ambos tickets de estado de pedido, GPT-6.2 Sol convirtió el número de seguimiento en un enlace a ups.com/track. GPT-6.1 Sol imprimió el número tal cual. El formato del enlace era correcto, pero nada en los datos de mi herramienta contenía una URL. En un helpdesk real, yo escribiría una regla sobre qué enlaces puede crear un agente, porque el próximo enlace inventado podría no ser tan inofensivo. GPT-6.2 Astra hizo lo mismo en mi prueba de Astra.
Se comprometió con una respuesta que la política dejaba abierta. Ante "pagué por un plan anual hace 41 días, ¿qué me devuelven?", GPT-6.1 Sol pidió un ID de cargo. GPT-6.2 Sol respondió directamente: 10 meses completos sin usar, es decir 10/12 de lo pagado. Eso cuenta el segundo mes como ya usado, algo que la política no dice en ningún lado. Es una lectura razonable, pero es una suposición presentada como hecho, y en un flujo de reembolso preferiría que el modelo lo consultara.
El resto, desde el cálculo de reembolso prorrateado de 990 $ (correcto en todas las configuraciones) hasta rechazar una falsa solicitud de descuento en "modo admin" y escalar cuando el servicio de pedidos tuvo un timeout, fue igual en las cuatro. Ninguno de los modelos Sol le pidió al cliente que revisara el ID de pedido mal tecleado, algo que sí hizo GPT-6.2 Astra. Para el soporte, la puntuación no distingue estas configuraciones; el comportamiento y el coste sí.
¿Qué deberían saber los desarrolladores antes de cambiarse?
Si llamas a la API directamente, la guía de migración tiene una lista breve de cambios que vale la pena leer antes de cambiar el ID del modelo:
- El tool calling necesita la Responses API. El modelo soporta Chat Completions, pero las herramientas solo funcionan a través de Responses. Muchas integraciones se construyeron al revés.
- El esfuerzo
nonese rechaza. Si usabasnoneominimal, pasa alow. - Los ajustes de sampling desaparecieron. Elimina
temperature,top_p,logprobsytop_logprobs. - El razonamiento se descarta si editas el historial. OpenAI recomienda mantener los prefijos del prompt sin cambios y añadir las instrucciones nuevas al final, para mejorar la reutilización de caché y preservar el razonamiento entre turnos.
- El caching cambió. Si vienes de GPT-5.5 o anterior, sustituye
prompt_cache_retentionporprompt_cache_options.ttlfijado en"30m", y revisa la facturación de las escrituras en caché. - Zero Data Retention funciona. Ambos modelos lo soportan para organizaciones aprobadas, y ambos soportan residencia de datos en EE.UU. y la UE en Standard, Fast y Batch.
El punto del caching es el que cuesta dinero. En mi prueba de Astra descubrí que un prompt de centro de ayuda en el campo instructions de nivel superior no se cacheaba en el nuevo Astra, mientras que el mismo texto en un developer message sí. Revisa tus propios cached_tokens en Sol antes de asumir el descuento del 95% por entrada en caché, ya que no lo he verificado por separado en Sol. El artículo de GPT-6.1 Sol cubre los cambios de API anteriores de la misma familia.
¿Qué pasa con la seguridad y los límites cibernéticos?
Ambos modelos mantienen la calificación "Critical" en ciberseguridad que GPT-6 Astra fue el primero en recibir, además de una calificación "High" para capacidad biológica y química. En la práctica, eso significa barreras más estrictas. OpenAI dice que lanzó ambos modelos "con salvaguardas más estrictas para la asistencia de ciberseguridad de mayor riesgo", y que estas "también restringen parte de la investigación legítima de vulnerabilidades". A los equipos de seguridad que necesitan menos rechazos se les dirige a OpenAI Daybreak y GPT-6 Cyber.
La tarjeta de sistema es franca sobre una regresión que importa para el soporte: ambos modelos "eran más propensos a omitir obstáculos conocidos al reportar su trabajo", como un archivo faltante o una herramienta no disponible. Un agente que se salta en silencio una búsqueda fallida es el camino a una respuesta incorrecta pero segura de sí misma para un cliente. En mi prueba, ambos modelos Sol sí avisaron cuando el servicio de pedidos tuvo un timeout, pero fue un ticket con un error ruidoso. Yo pondría observabilidad en cualquier agente que use este modelo, para que puedas ver qué intentó y qué falló.
¿Deberías cambiarte a GPT-6.2 Sol?
Para la mayoría de equipos que ya usan un modelo de OpenAI, sí, con una lista de comprobación breve antes.
| Si usas | Mi opinión |
|---|---|
| GPT-6.1 Sol | Cámbiate. Mismo precio, puntuación más alta, mucho más rápido con el máximo esfuerzo. Prueba primero las cargas de código, ya que AA midió una caída. |
| GPT-6 Sol | Cámbiate. El salto desde GPT-6 Sol son dos lanzamientos de mejoras al mismo $2/$10. |
| GPT-6 Astra | Prueba Sol primero. Igualó la puntuación AA del antiguo Astra a aproximadamente un 15% del coste por tarea. Reserva Astra para los proyectos largos y difíciles. |
| GPT-6.2 Astra | Reserva Astra para el trabajo difícil de varios pasos. Mueve los tickets rutinarios y las llamadas de agente del día a día a Sol. |
| Claude Sonnet 5.5 u Opus 5.5 | Haz tus propias pruebas con tus tickets. Sol es barato, pero una diferencia de puntuación en un benchmark rara vez predice cómo manejará un modelo tu tono y tus políticas. |
| Cualquier modelo, para respuestas de cara al cliente | Sopesa la tasa de adivinación del 55%. El grounding y las reglas de escalado importan más que la mejora. |
Si estás buscando fuera de OpenAI, el resumen de alternativas a GPT-6.1 Sol sigue siendo válido, y el mejor LLM para soporte cubre el campo más amplio.
¿Qué significa GPT-6.2 Sol para un equipo de soporte?
Un modelo más barato y rápido es mejor infraestructura. No es un mejor agente de soporte por sí mismo. El modelo no conoce tu política de reembolsos, no puede ver tu helpdesk, y sigue adivinando en más de la mitad de las preguntas de hechos que le lanza Artificial Analysis. Todo lo que lo hace útil en una cola real está alrededor del modelo, y una comparación de modelos para tickets de soporte solo te lleva al primer paso.
Esa capa es lo que construye eesel. eesel es un conjunto de teammates de IA que contratas para trabajos concretos, un teammate de IA para helpdesk para tu cola y un escritor de blog con IA para contenido, y cada uno llega con las integraciones, el conocimiento y las barreras de su rol. El modelo es el motor; el teammate es a quien contratas para conducirlo. También puedes manejarlo desde código: con la CLI de eesel, un agente de código como Claude Code, Codex o Cursor puede subir artículos de ayuda y macros aprobados, ajustar las instrucciones del agente, y ejecutar preguntas de prueba contra ellos antes de que nada se publique. Conectar el propio helpdesk todavía necesita que un administrador lo apruebe.
SamCart, que vende productos digitales a más de 75.000 empresas, muestra cómo funciona eso en una cola de Freshdesk. Opera un agente de eesel independiente por canal: uno para tickets de correo, que responde solo hasta que un teammate recoge el ticket, y otro para la burbuja de chat del sitio web, que pide nombre y correo primero. Ambos responden desde unos 280 artículos del centro de ayuda, enlazan solo los públicos, y pasan a una persona cuando un vendedor lo pide o la pregunta va más allá del centro de ayuda. Ese diseño acotado y orientado al traspaso es lo contrario de dejar que el modelo más listo lo responda todo, y significa que el modelo de debajo puede cambiar sin que el cliente lo note.
Si estás evaluando este lanzamiento para el soporte, la pregunta más útil que "¿Sol o Astra?" es si puedes probar al agente con tus propios tickets pasados antes de que salga en vivo. Eso no te lo puede decir un benchmark, ni tampoco una publicación de lanzamiento. El resumen de el mejor software de helpdesk con IA compara las herramientas que hacen esto, y los benchmarks de coste por ticket ponen el gasto en modelo en el contexto del coste total del ticket.
Prueba eesel
Si GPT-6.2 Sol te hizo pensar en IA para tu cola de soporte, la parte que decide si funciona es el teammate alrededor del modelo. eesel se conecta al helpdesk que ya usas, aprende de tus tickets pasados y de tu centro de ayuda, y te deja ejecutarlo contra tus tickets históricos reales para que puedas leer sus respuestas antes de que toque a un cliente real. Los planes son paquetes fijos de créditos, desde 299 $ por 500 créditos, así que la factura no se mueve con los precios por token del modelo ni con la longitud de las respuestas. Cuando llega un modelo nuevo, obtienes la mejora sin tener que reconstruir tus prompts, tu caching ni tus reglas de escalado tú mismo.

Puedes probar eesel gratis en una parte de tu cola, o compararlo con usar ChatGPT directamente si todavía estás decidiendo si construirlo tú mismo.
Preguntas frecuentes
¿Qué es GPT-6.2 Sol?
gpt-6.2-sol, y la lista de modelos de OpenAI muestra dónde se sitúa en la gama.¿Cuánto cuesta GPT-6.2 Sol?
GPT-6.2 Sol frente a GPT-6.1 Sol: ¿qué cambió?
¿Es GPT-6.2 Sol mejor que GPT-6.2 Astra?
¿Es GPT-6.2 Sol bueno para el soporte al cliente?
¿GPT-6.2 Sol tiene un nivel Flex?
¿Cómo accedo a GPT-6.2 Sol?
gpt-6.2-sol. Los usuarios Enterprise y Edu lo obtienen cuando un administrador del workspace lo activa. OpenAI también está llevando Ultrafast a los suscriptores Pro 200 por primera vez, empezando con Sol. El tool calling en la API necesita la Responses API.