

GPT-6.2 Sol es el modelo con mejor relación calidad-precio que vende OpenAI ahora mismo: $2/$10 por millón de tokens, 57 en Artificial Analysis, al nivel del antiguo GPT-6 Astra, y unas tres veces más rápido por tarea que GPT-6.1 Sol. La crítica es real pero concreta: los desarrolladores dicen que sigue sobrediseñando el código, y Artificial Analysis midió una caída de 3 puntos en programación.
En mis 77 pruebas nunca inventó un dato de empresa. Su costumbre es añadir cosas que los datos nunca contenían, como enlaces de seguimiento de FedEx y cuentas de días. Eso es inofensivo en un borrador y arriesgado en una respuesta a un cliente. Para soporte, un compañero de IA para helpdesk bien fundamentado como eesel importa más que el modelo que hay debajo.
¿Qué es GPT-6.2 Sol, y cómo lo probé?
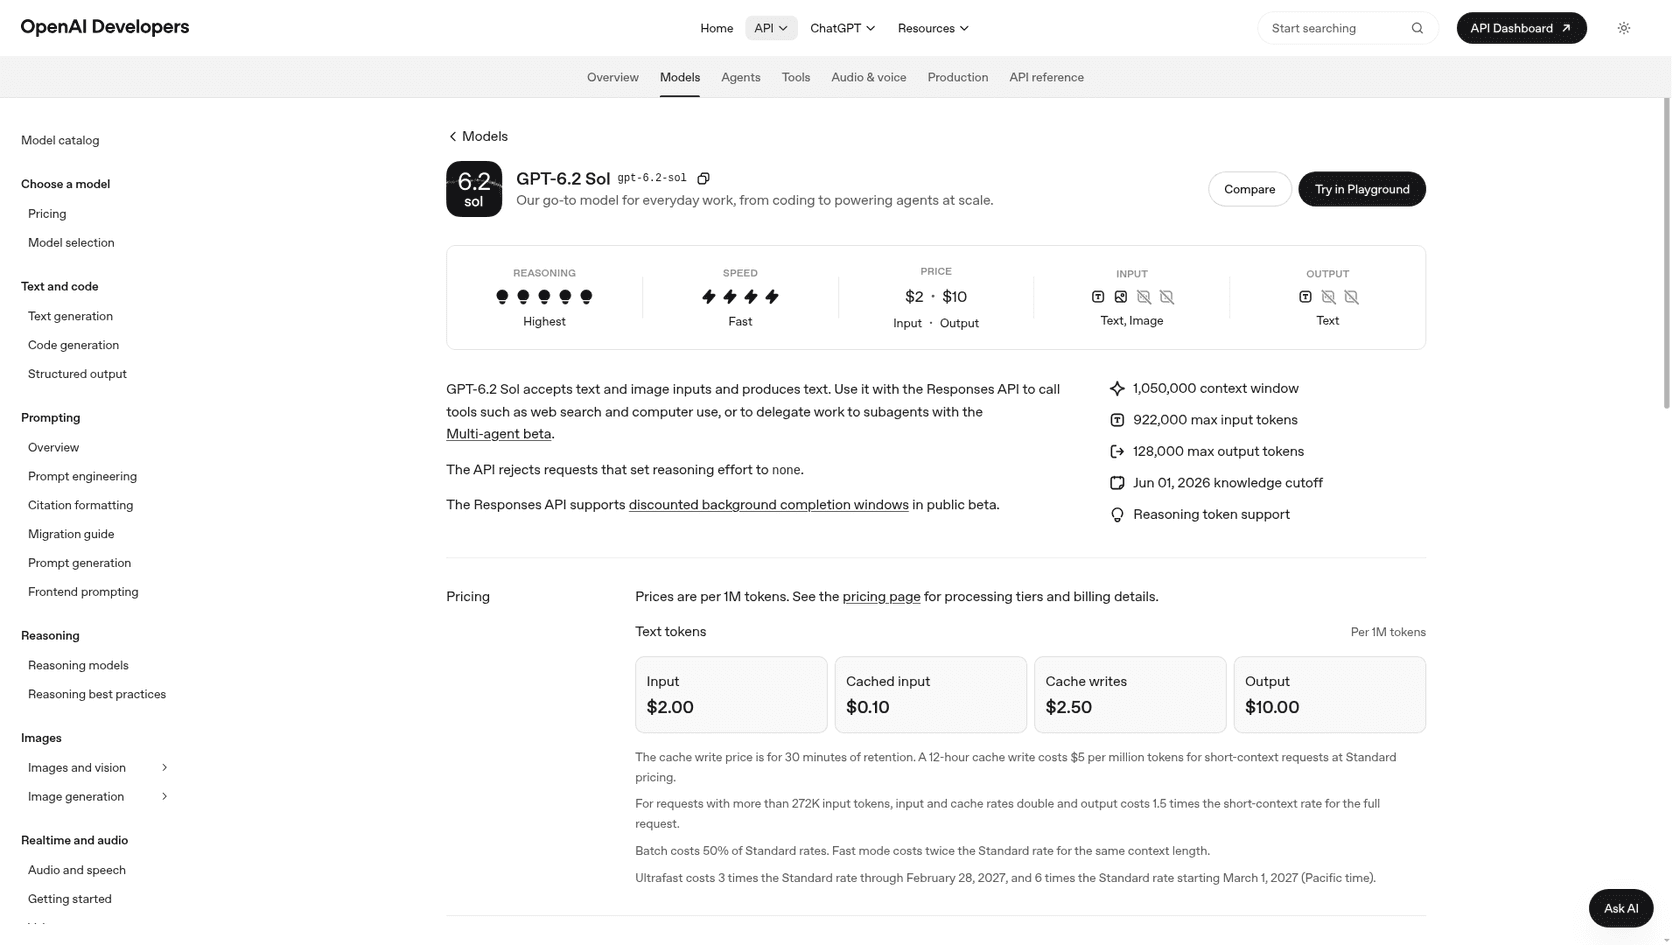
GPT-6.2 Sol es el modelo del día a día de OpenAI, lanzado el 17 de noviembre de 2026 junto a GPT-6.2 Astra. El artículo de lanzamiento de OpenAI lo llama "our efficient, versatile model for everyday work". Sustituye a GPT-6.1 Sol al mismo precio, y la visión general de GPT-6.2 Sol tiene todos los detalles del lanzamiento.
Construyo integraciones y la fontanería de API en eesel, así que leo una reseña de modelo como leería un changelog de API: ¿qué hace realmente cuando mi código lo llama? Las gráficas de lanzamiento no responden eso, así que esta semana ejecuté 77 llamadas a GPT-6.2 Sol a través de la Responses API en tres pequeñas pruebas, todas con esfuerzo medio salvo que se indique lo contrario:
- 15 tickets de soporte, con esfuerzo bajo y medio, evaluados a mano frente a una política de reembolsos (30 ejecuciones). Los resultados están en la visión general de GPT-6.2 Sol.
- 19 ejecuciones sobre las quejas que la gente planteó sobre Astra: escritura corta, fallos silenciosos de herramientas y datos de empresa inventados. Estas se ejecutaron junto a Astra en la reseña de GPT-6.2 Astra.
- 28 ejecuciones nuevas para esta reseña, frente a 28 en GPT-6.1 Sol: seis preguntas de política que cada una necesita dos o tres datos para responderse por completo, repetidas tres veces, más dos tickets de seguimiento de pedidos repetidos cinco veces.
Es una prueba pequeña y leída a mano, no un benchmark. Si quieres repetirla en tu propio entorno, la CLI de eesel permite que un agente de programación le haga el mismo tipo de preguntas de prueba a un agente de helpdesk de eesel y revise las respuestas antes de que nada salga en vivo. Cada ejecución pasa por el documento de política de una empresa SaaS ficticia y una herramienta lookup_order enlatada, construida con llamadas a funciones. Te dice cómo se comporta el modelo en trabajo de soporte limpio y cotidiano, que es la mayor parte del soporte.
¿Cuál es mi veredicto sobre GPT-6.2 Sol?
GPT-6.2 Sol es una muy buena opción por defecto para trabajo rutinario a un precio que nada en su categoría igual, con dos costumbres que gestionar: sobreconstruye código y añade detalles alrededor de los hechos. Aquí está la tarjeta de puntuación:
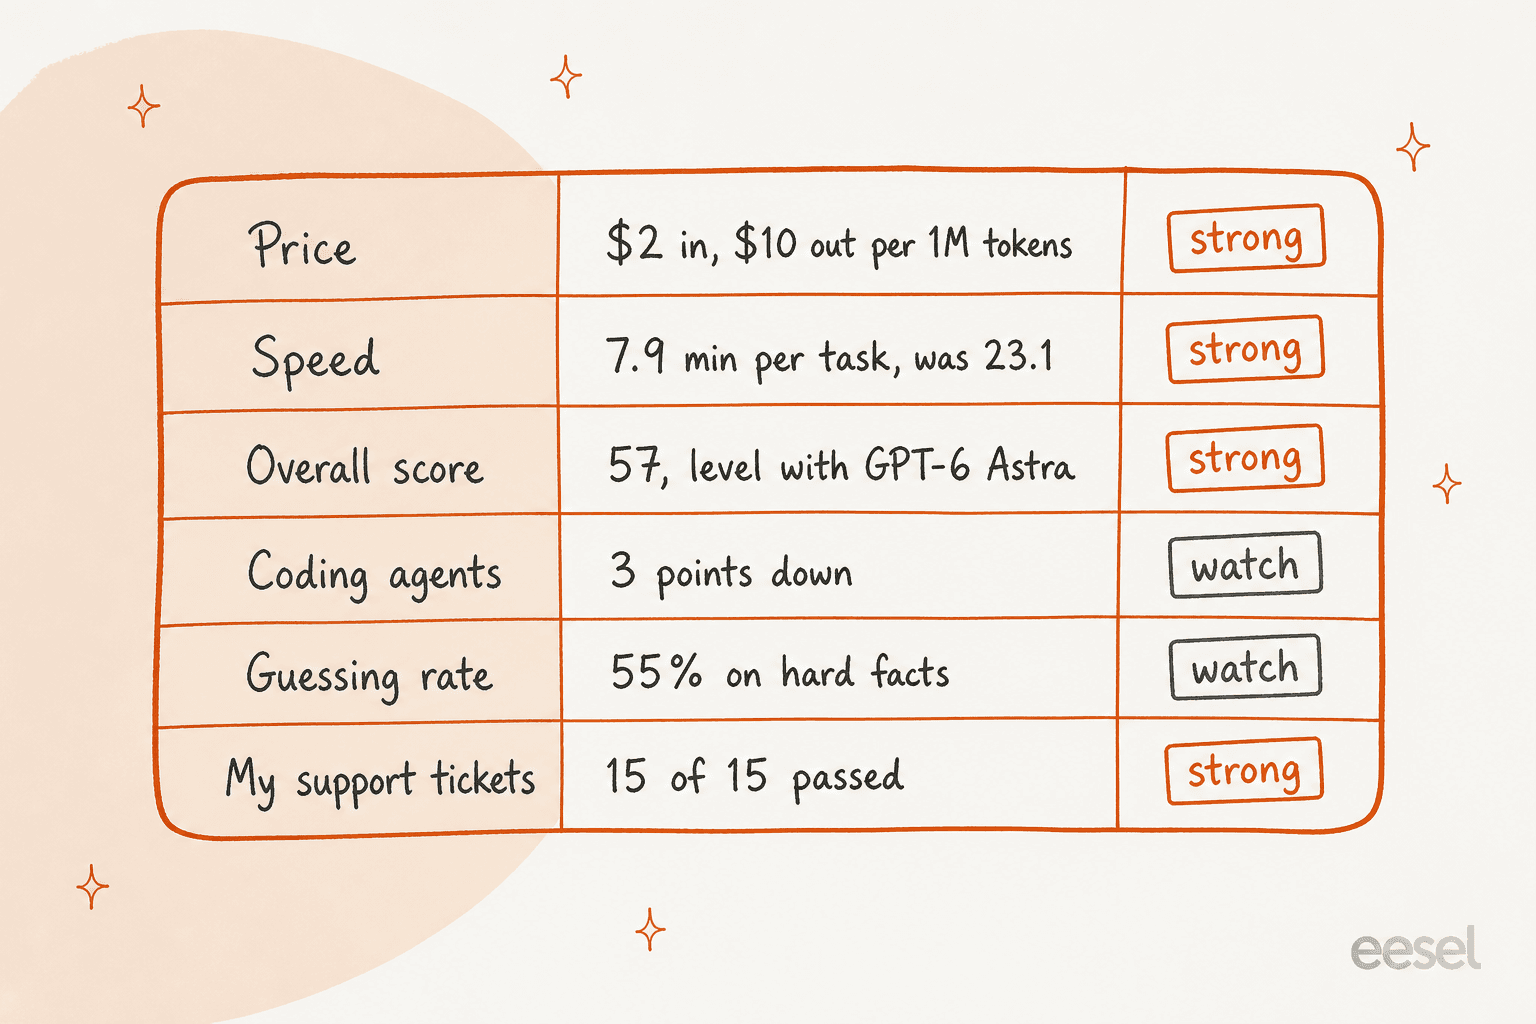
| Lo que comprobé | GPT-6.2 Sol | Fuente |
|---|---|---|
| Precio por 1M de tokens | $2 entrada, $0.10 en caché, $10 salida | Precios de OpenAI |
| Intelligence Index (esfuerzo máximo) | 57, sube de 55 | Artificial Analysis |
| Coste por tarea de benchmark (máx.) | $1.01, baja de $1.27 | Artificial Analysis |
| Tiempo por tarea de benchmark (máx.) | 7,9 min, baja de 23,1 | Artificial Analysis |
| Coding Agent Index | 3 puntos por debajo de GPT-6.1 Sol | Artificial Analysis |
| Tasa de alucinación (AA-Omniscience) | 55% | Artificial Analysis |
| Mis 15 tickets de soporte | 15/15 con bajo y medio | Mi prueba |
| Respuestas de política con varios datos | 18/18 completas | Mi prueba |
| Datos de empresa inventados | 0 de 10 | Mi prueba |
| Enlaces añadidos que la herramienta nunca envió | 7 de 14 respuestas de pedidos | Mis pruebas |
El salto desde 6.1 es fácil de recomendar. Mismo precio, una puntuación algo más alta, y las ejecuciones con esfuerzo máximo que antes tardaban 23 minutos ahora tardan 8. Si ya pagas por GPT-6.1 Sol, hay poca razón para quedarte.
¿Qué le gusta a la gente de GPT-6.2 Sol?
La relación precio-puntuación. En el hilo de lanzamiento en Hacker News, que superó los 600 comentarios, quienes defendían el lanzamiento defendían sobre todo a Sol, y en su mayoría por el coste:
"Whatever you’re doing, it’s unlikely to be what most users are doing. Fable and Astra aren’t in my price range so I’m paying attention to Sol."

El otro punto que se repite es que los niveles de esfuerzo más altos cierran la mayor parte de la distancia con el modelo más grande y antiguo:
"6.2 Sol xhigh and max show the results comparable to Astra 6 max, and Astra 6.2 only shows any improvement on 'max' reasoning effort level."
Eso coincide con Artificial Analysis, que sitúa a Sol en 57 frente a 57 de GPT-6 Astra, a aproximadamente un 15% del coste por tarea. Algunos desarrolladores también describieron una división que yo copiaría: un modelo más fuerte planifica, y Sol hace el volumen.
"I have hilariously started to just have an opus thread maintain Sol subagents to get the best of both worlds."
¿De qué se queja la gente?
Sobre todo del sobrediseño, y casi todo en código. La queja no es nueva en este lanzamiento, lo que hace que duela más:
"It's still overengineering especially Sol. This was the biggest complaint by everybody who has been using Sol since GPT 5.6. OpenAI is not listening to us."
En una base de código grande, un desarrollador midió la distancia con Astra en el trabajo de limpieza:
"I have a 1.5 MB C++ codebase, and at least a third of the tasks that Sol completed required cleaning up by Astra."
Las cifras respaldan la dirección, aunque no la magnitud. Artificial Analysis dice que Sol "loses 3 points relative to GPT-6.1 Sol" en su Coding Agent Index, impulsado por una caída de 14 puntos en SWE-Atlas-QnA-AA, donde el modelo es "more likely than its predecessor to omit key facts in its responses". Un consejo práctico del hilo: otro desarrollador descubrió que el sobrediseño empeora al subir el esfuerzo, así que si tu agente de programación sigue construyendo andamiaje que nadie pidió, prueba un nivel más bajo antes de cambiar de modelo.
Luego está la reacción más ruidosa de la gente con acceso anticipado. Matt Shumer dijo en X que encontró al dúo "essentially unusable" y que no los reseñaría. La mayoría de las críticas detalladas tempranas, sobre una escritura demasiado terca y ejecuciones de código que se detienen pronto, eran sobre Astra. Probé esas afirmaciones en la reseña de Astra, y en Sol la escritura estuvo bien: su artículo de ayuda al cliente tuvo entre 168 y 170 palabras y cubrió cada política.
¿GPT-6.2 Sol deja fuera hechos?
En mis pruebas no. Como Artificial Analysis había señalado omisiones, escribí seis preguntas que cada una necesita dos o tres hechos de política para responderse por completo. ¿Puede un administrador restaurar un espacio de trabajo eliminado? (Sí, dentro de 14 días, pero solo el propietario puede hacerlo.) ¿Se reembolsan los puestos eliminados? (No, se convierten en un crédito en la siguiente factura.)
Ambos Sol respondieron las 18 ejecuciones por completo, tras leer cada una a mano. La comprobación por palabras clave que programé primero señaló 11 fallos en 6.2 y 9 en 6.1, y cada uno de ellos fue una falsa alarma por frases como "14-day window" o un apóstrofo curvo. Eso es una advertencia justa sobre las evaluaciones automatizadas en general: un evaluador que compara cadenas de texto te habría dicho que 6.2 Sol omite más hechos, y no es así. Revisar conversaciones de soporte con IA a mano sigue siendo la única comprobación en la que confío con una muestra pequeña.
La prueba de fallos silenciosos fue igual. Cuando una de tres búsquedas de pedidos devolvió un {} vacío sin error, Sol marcó ese pedido y escaló en 5 de 5 ejecuciones. La system card de OpenAI advierte que ambos modelos nuevos "were more likely to omit known obstacles when reporting their work", así que seguiría manteniendo observabilidad en cualquier agente que lo ejecute. En trabajo de soporte corto, no logré que se lo saltara ni una vez.
¿GPT-6.2 Sol se inventa cosas?
No inventó hechos. Sí añadió cosas. Eso es lo más útil que aprendí sobre este modelo.
Artificial Analysis sitúa la tasa de alucinación de Sol en 55%, la proporción de preguntas factuales difíciles que responde mal en lugar de decir que no lo sabe. En mi prueba, con una política que no cubría ninguna de las preguntas, pregunté sobre auditorías SOC 2, residencia de datos en la UE, horario telefónico, límites de tasa de la API y un acuerdo HIPAA. Sol no inventó nada en 10 ejecuciones, con un prompt estricto o uno laxo de "sé útil". Con el prompt laxo, dijo "no tengo información verificada" y ofreció consejos generales.
Los extras aparecieron alrededor de los hechos:
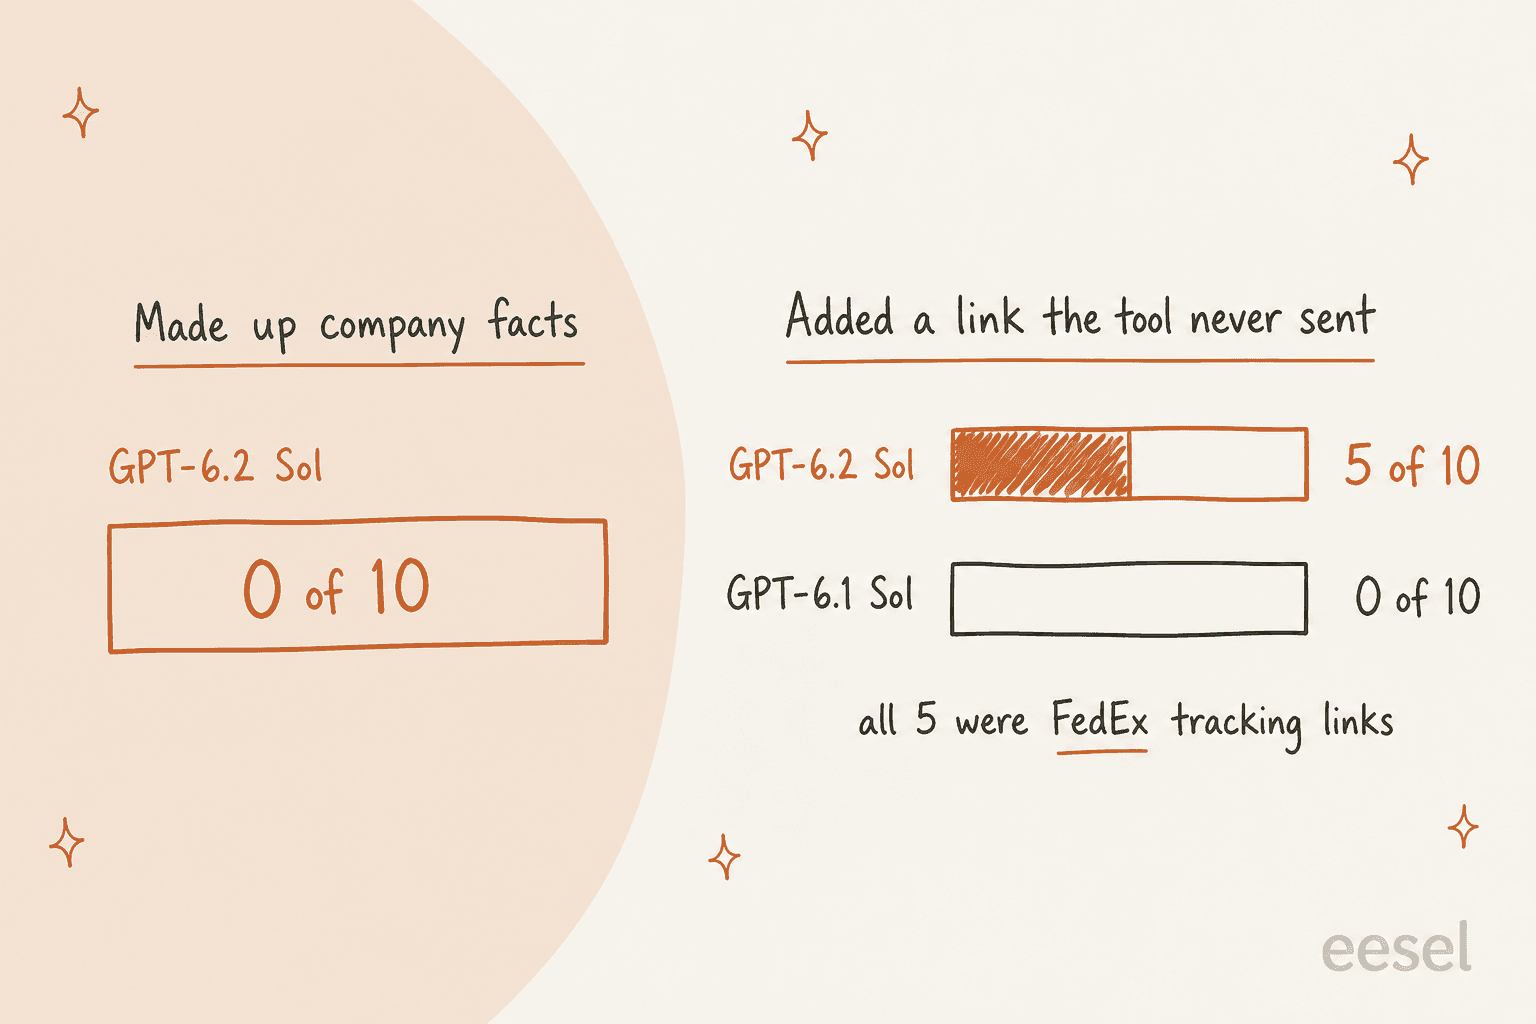
- Enlaces de seguimiento. Mi herramienta
lookup_orderdevuelve un transportista y un número de seguimiento, sin URL. Cuando un cliente preguntó cómo seguir un pedido de FedEx, GPT-6.2 Sol construyó un enlace de seguimiento defedex.comen 5 de 5 ejecuciones. GPT-6.1 Sol siempre imprimió el número por su cuenta. En el ticket sencillo de UPS "¿dónde está mi pedido?", 6.2 mencionó la página de seguimiento de UPS sin enlace. En mi prueba de tickets anterior, construyó enlaces deups.comen ambos tickets de pedidos con esfuerzo medio, y ninguno con esfuerzo bajo. Entre ambas pruebas, son 7 enlaces en 14 respuestas de pedidos, frente a ninguno de 6.1. - Aritmética que nadie pidió. En la pregunta del espacio de trabajo eliminado, 6.2 Sol añadió "quedan unos 5 días" en las tres ejecuciones. Eso es correcto (14 menos 9) y útil. En mi primera prueba también dio un reembolso como "10/12 de lo pagado" sin comprobar cómo cuenta la política un mes parcial, que era una suposición disfrazada de hecho.
Ninguno de los enlaces que comprobé estaba mal. El problema es el patrón: un modelo que construye una URL de transportista a partir de un número de seguimiento, un día construirá un enlace a un portal de devoluciones o de pago a partir de otra cosa. En una respuesta a un cliente, cualquier enlace que tus herramientas no devolvieron es una afirmación sin fuente. La solución es una línea en las instrucciones que limite los enlaces a los que provienen de resultados de herramientas o de tu centro de ayuda, más una prueba que lo compruebe. Permisos del agente de soporte de IA cubre la misma idea para las acciones. Para el dinero, consulta las barreras de reembolso.
¿Merece la pena el precio de GPT-6.2 Sol?
Sí, y no es ni de cerca, dentro de la gama de OpenAI. Esto es lo que costaron mis pruebas de soporte a las tarifas estándar:
| Prueba (esfuerzo medio) | GPT-6.2 Sol | GPT-6.1 Sol | GPT-6.2 Astra |
|---|---|---|---|
| 15 tickets de soporte, por 1.000 | $1.42 | $1.35 | $5.79 |
| Preguntas de política y seguimiento, por 1.000 | $1.55 | $1.49 | no probado |
| Longitud media de respuesta (preguntas de política) | 44 palabras | 40 palabras | no probado |
| Tokens medios de razonamiento (preguntas de política) | 4 | 9 | no probado |
6.2 Sol cuesta entre un 4% y un 5% más que 6.1 por ticket en estas pruebas, porque sus respuestas son algo más largas. Razona menos en preguntas fáciles y escribe un poco más, y los tokens de salida son donde se va el dinero. Frente a GPT-6.2 Astra, es aproximadamente un cuarto del coste por la misma tasa de éxito en tickets rutinarios.
Dos cosas mueven la factura más que la elección del modelo. El esfuerzo va primero: Artificial Analysis contó 14,6 millones de tokens de salida con esfuerzo medio frente a 60,9 millones con máximo, por 53 puntos frente a 57. Luego las vías de descuento: Batch reduce el precio a la mitad, pero todavía no hay nivel Flex para este modelo. La visión general de GPT-6.2 Sol tiene la tabla completa de precios, incluido el recargo por contexto largo a partir de 272.000 tokens de entrada.
¿Quién debería usar GPT-6.2 Sol, y quién debería evitarlo?
La mayoría de los equipos deberían hacerlo su opción por defecto y señalar las excepciones:
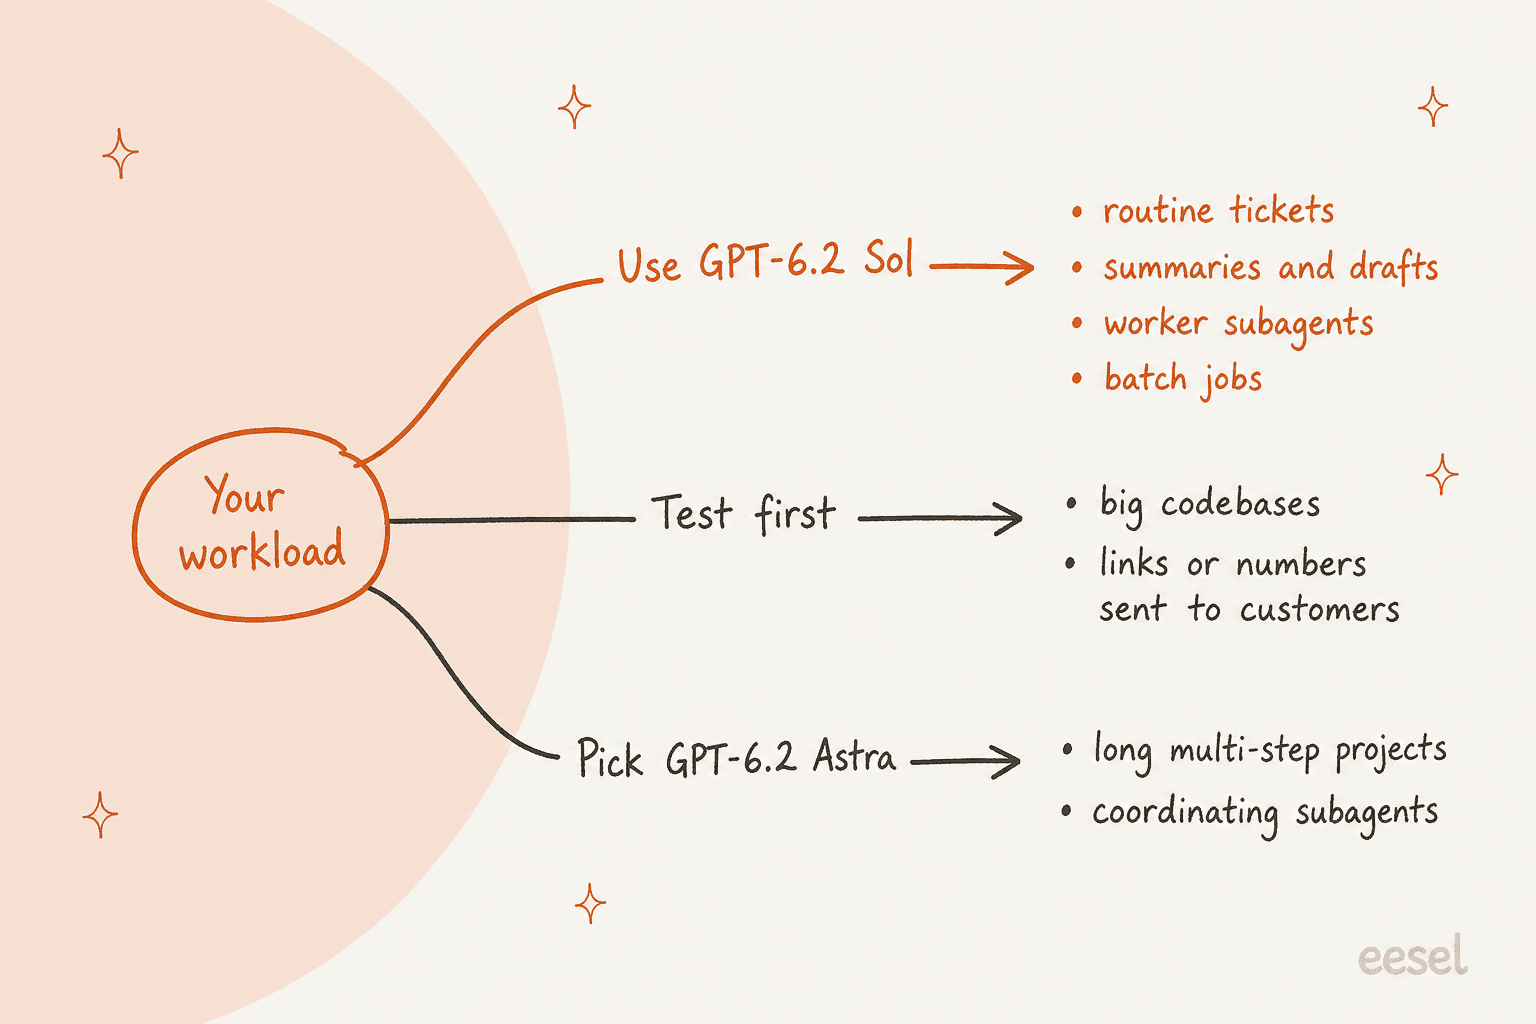
| Si estás... | Mi opinión |
|---|---|
| En GPT-6.1 Sol o GPT-6 Sol | Cambia. Mismo precio, más rápido, algo más listo. Vuelve a correr primero tus evaluaciones de código. |
| Ejecutando un agente de programación en un repositorio grande | Prueba antes de cambiar. El índice de código bajó y las quejas de sobrediseño son consistentes. Mantén Codex en Astra para las tareas difíciles. |
| Ejecutando respuestas de soporte o borradores | Úsalo, con una regla sobre enlaces y cifras y un conjunto de pruebas de tus propios tickets. |
| Construyendo un orquestador y trabajadores | Sol como trabajador, un modelo más fuerte como planificador. |
| Comparando con Claude Sonnet 5.5 o Claude Opus 5.5 | Pasa tus propios tickets por ambos. Los benchmarks no te dirán nada sobre el tono o el seguimiento de políticas. |
| Primero el precio y abierto a otros laboratorios | Mira el resumen de alternativas a GPT-6.1 Sol y DeepSeek V4 Flash. |
El artículo sobre cuál es el mejor LLM para atención al cliente compara el campo más amplio si Sol no es la opción adecuada.
¿Qué significa esto para un equipo de soporte?
Un modelo más barato y rápido es mejor infraestructura, no un mejor agente de soporte. Mi prueba muestra la brecha con claridad: Sol sabe que no debe inventar tu estado de SOC 2, pero igualmente le dará a un cliente un enlace que tus sistemas nunca produjeron. Lo que cierra esa brecha es la capa alrededor del modelo: qué puede buscar, qué puede decir y qué le pasa a una persona.
STIL Classics, una marca de agendas y papelería en Gorgias y Shopify, usa eesel con esa regla incorporada. Antes de redactar, eesel busca el pedido de Shopify, su estado de cumplimiento y el inventario en vivo, y nunca dice una fecha de envío, una estimación de entrega o una especificación de producto que no haya buscado. Si no encuentra el pedido, lo marca para el equipo en lugar de decírselo al cliente. En un mes preparó unos 320 tickets de Gorgias y buscó unos 230 pedidos de Shopify, y cada borrador pasa por una persona para revisarlo y enviarlo.
Eso es lo que construye eesel: compañeros de IA que contratas para tareas concretas, un compañero de IA para helpdesk para tu cola y un redactor de blog con IA para contenido. El modelo de debajo puede cambiar de 6.1 a 6.2 sin que tus reglas cambien con él. Desde una terminal, un agente de programación como Claude Code o Codex puede subir macros y artículos de ayuda aprobados a través de la CLI y afinar las instrucciones del agente (por ejemplo, "solo compartir enlaces devueltos por una búsqueda"). Conectar el propio helpdesk sigue necesitando a alguien con acceso de administrador que lo apruebe.
Si estás eligiendo un modelo para soporte, pruébalo con tus propios tickets pasados antes de que toque uno en vivo. La comparación de modelos para tickets de soporte pone las cifras en contexto. Los benchmarks de coste por ticket muestran dónde entra el gasto en modelos dentro de un ticket completo, y el resumen del mejor software de helpdesk con IA compara las herramientas que te permiten hacer esa prueba.
Prueba eesel
Si GPT-6.2 Sol te hace pensar en IA en tu cola, la parte que decide si sus extras llegan a un cliente es el compañero que lo rodea. eesel se conecta a tu helpdesk, aprende de tus tickets pasados y tu centro de ayuda, y te deja ejecutarlo contra tus tickets históricos para que leas sus respuestas, enlaces incluidos, antes de que salga en vivo. Los planes son paquetes fijos de créditos desde 299 $ por 500 créditos, así que la factura no se mueve con los precios de los tokens ni la longitud de las respuestas.

Puedes probar eesel gratis en una parte de tu cola, o leer cómo se compara con usar ChatGPT directamente si todavía estás sopesando construirlo tú mismo.