

MAI-Transcribe-2 es el nuevo modelo de voz a texto de Microsoft AI, anunciado el 3 de septiembre de 2026 y presentado como "el modelo de reconocimiento de voz más rápido, preciso y barato del mundo". Con las cifras de la propia Microsoft, la afirmación se sostiene en gran parte: una tasa media de error de palabras del 5,2 % en 60 idiomas, aproximadamente 10 veces más rápido que GPT-Transcribe en audio largo (según los benchmarks propios de Microsoft) y $0,10 por hora de audio como precio de lanzamiento.
Conviene conocer las salvedades antes de construir sobre él. Esos $0,10 son una oferta por tiempo limitado hasta finales de 2026 y el precio estándar no está publicado. Es un modelo por lotes en vista previa pública (sin SLA), los archivos están limitados a 300 MB y el tiempo real requiere una configuración aparte de Voice Live. Además, la tabla de benchmarks es de Microsoft, en un ranking donde queda segundo en la clasificación general.
Si solo necesitas convertir audio en texto limpio y multilingüe mediante una API, es una de las opciones más sólidas y baratas ahora mismo. Pero si tu objetivo es un flujo de soporte, recuerda que la transcripción es el comienzo, no el final: alguien debe leerla, encontrar la respuesta y resolver el ticket. Ese es el trabajo de un compañero de IA como eesel, y ahí está ahora el valor real.
En eesel construyo integraciones y APIs, así que leo un lanzamiento como este como lo haría un desarrollador: ¿qué hace realmente la API más allá del titular? Dediqué tiempo a la página del modelo MAI-Transcribe-2, la documentación de Azure Speech, el playground y los primeros comentarios de desarrolladores. Esto es lo que encontré.
Qué es realmente MAI-Transcribe-2
MAI-Transcribe-2 es un modelo de voz a texto creado internamente por Microsoft AI, el mismo grupo detrás de los modelos MAI-Voice y MAI-1. La propuesta es refrescantemente acotada: hace una sola cosa, convertir audio en texto, y lo hace en varios idiomas con un único modelo en lugar de obligarte a elegir un motor por idioma.
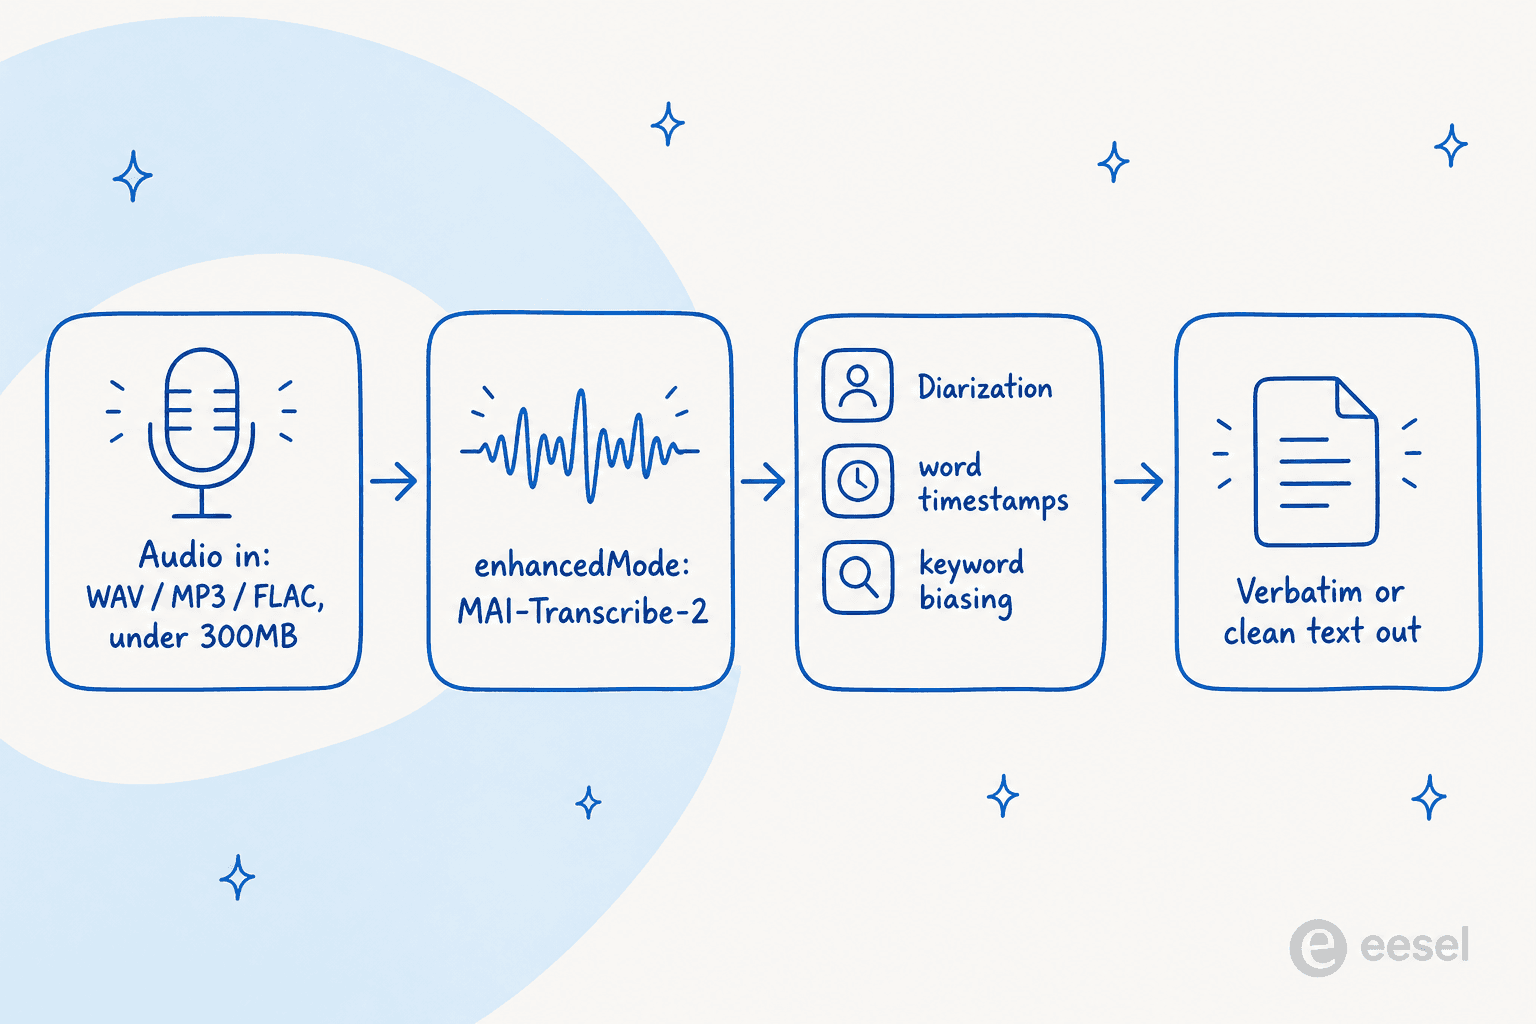
Lo que obtienes es más que una cadena de texto. El modelo gestiona la diarización de hablantes (etiquetar quién habló cuándo), marcas de tiempo por palabra, sesgo por palabras clave para que favorezca los nombres de tus productos y tu jerga, y la opción entre un estilo "verbatim" que conserva cada muletilla y falso comienzo para trabajos de cumplimiento normativo y un estilo "clean" que da formato a subtítulos legibles. Sucede a MAI-Transcribe-1.5 y MAI-Transcribe-1, que la documentación de Azure Speech marca como obsoletos desde el 20 de agosto de 2026.
El planteamiento honesto: es un modelo de Microsoft AI, así que forma parte del ecosistema de Azure Speech y no de una app de consumo independiente. Accedes mediante una API, un playground para desarrolladores o enrutadores de terceros, no con un producto pulido para usuarios finales. Si esperabas una app de reuniones al estilo Otter, esto es la capa que hay debajo, no la app en sí.
El titular: el más rápido, el más preciso y el más barato
Microsoft no se anduvo con rodeos. La publicación de lanzamiento llama a MAI-Transcribe-2 "el modelo de reconocimiento de voz más rápido, preciso y barato del mundo", el tipo de triple afirmación que suele caerse en la segunda parte. Esta se sostiene en su mayoría, con un par de asteriscos.
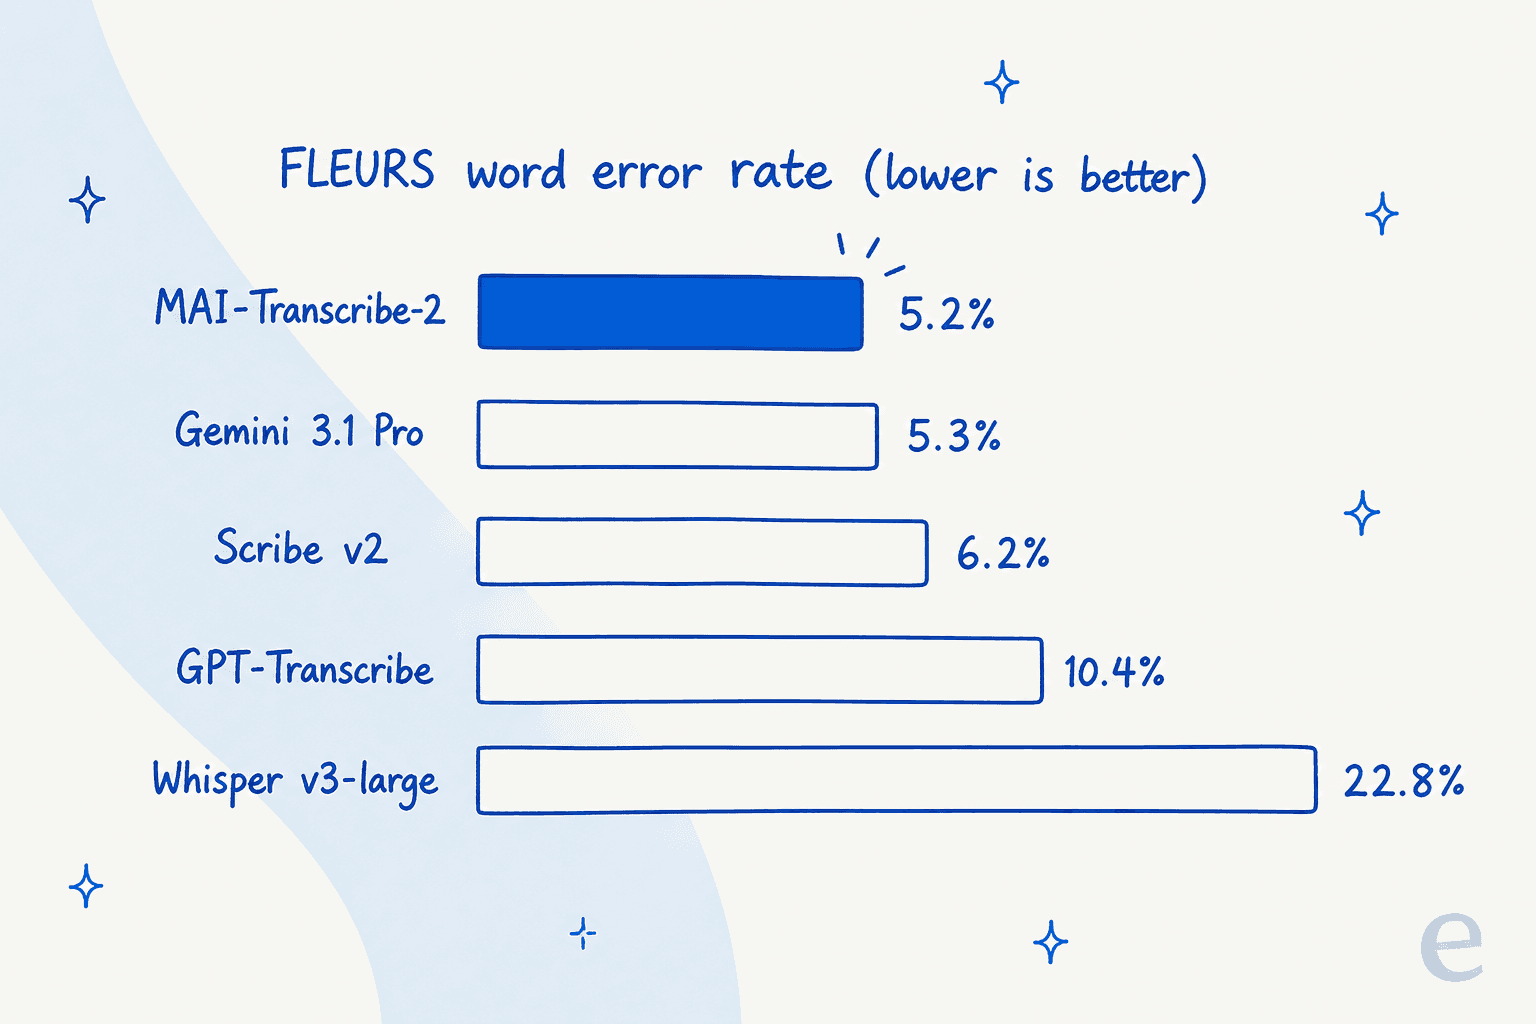
En precisión, el modelo logra una tasa media de error de palabras del 5,2 % en el benchmark FLEURS en 60 idiomas, que según Microsoft es el n.º 1 en FLEURS y el segundo en el ranking de tasa de error de palabras de Artificial Analysis. En los 25 idiomas principales de FLEURS baja al 3,4 %. Así lo compara la página del modelo con el resto (menor es mejor):
| Modelo | WER FLEURS en 60 idiomas (forced) |
|---|---|
| MAI-Transcribe-2 | 5,2 % |
| Gemini 3.1 Pro | 5,3 % |
| Scribe v2 (ElevenLabs) | 6,2 % |
| Gemini 3.5 Transcribe | 5,9 % |
| GPT-Transcribe (OpenAI) | 10,4 % |
| Whisper v3-large (OpenAI) | 22,8 % |
La diferencia con el antiguo Whisper v3-large, de código abierto, es enorme, y el margen sobre Gemini 3.5 Transcribe y GPT-Transcribe es real. En cambio, el margen sobre Gemini 3.1 Pro es de una décima de punto, así que "el más preciso" es cierto, pero por un pelo en lo alto de la tabla.
En velocidad, las cifras son realmente llamativas. Microsoft mide una hora de audio en unos 10 segundos de inferencia del modelo, y sus benchmarks de lanzamiento lo muestran 10 veces más rápido que GPT-Transcribe, 7 veces más rápido que ElevenLabs Scribe v2 y 5 veces más rápido que Gemini 3.5 Transcribe, situándose en la frontera de Pareto entre precisión y latencia. Un comentarista de HN que lo probó resumió el planteamiento con claridad:
"According to Artificial Analysis it is on the pareto frontier."

Lo que hay que tener presente al leer todo esto: son cifras de benchmark de Microsoft y puntos de comparación elegidos por Microsoft. Eso no las hace erróneas, y las primeras pruebas independientes van en la misma dirección. Solo significa que "el mejor del mundo" es el planteamiento del proveedor, y ser segundo en la clasificación general de Artificial Analysis es una lectura más mesurada.
Cómo se usa en la práctica
Aquí despertó mi lado de desarrollador, y aquí el modelo se vuelve más interesante que el ranking. MAI-Transcribe-2 funciona a través de la Fast Transcription API de Azure Speech, y se activa con una opción enhancedMode en lugar de un endpoint nuevo. Una llamada mínima se ve así:
curl --location 'https://YourResourceName.cognitiveservices.azure.com/speechtotext/transcriptions:transcribe?api-version=2025-10-15' \
--header 'Content-Type: multipart/form-data' \
--header 'Ocp-Apim-Subscription-Key: <YourSpeechResourceKey>' \
--form 'audio=@"YourAudioFile.wav"' \
--form 'definition={
  "enhancedMode": {
    "enabled": true,
    "model": "MAI-Transcribe-2"
  }
}'
A partir de ahí, los parámetros son claros: diarization.enabled para las etiquetas de hablante, phraseList.phrases para el sesgo por palabras clave, modelOptions.transcribeStyle para elegir literal o depurado, y locales si quieres saltarte la detección automática. Los archivos se suben como WAV, MP3 o FLAC y tienen un límite de 300 MB. Es una subida por lotes directa, lo cual es bueno o malo según lo que estés construyendo.
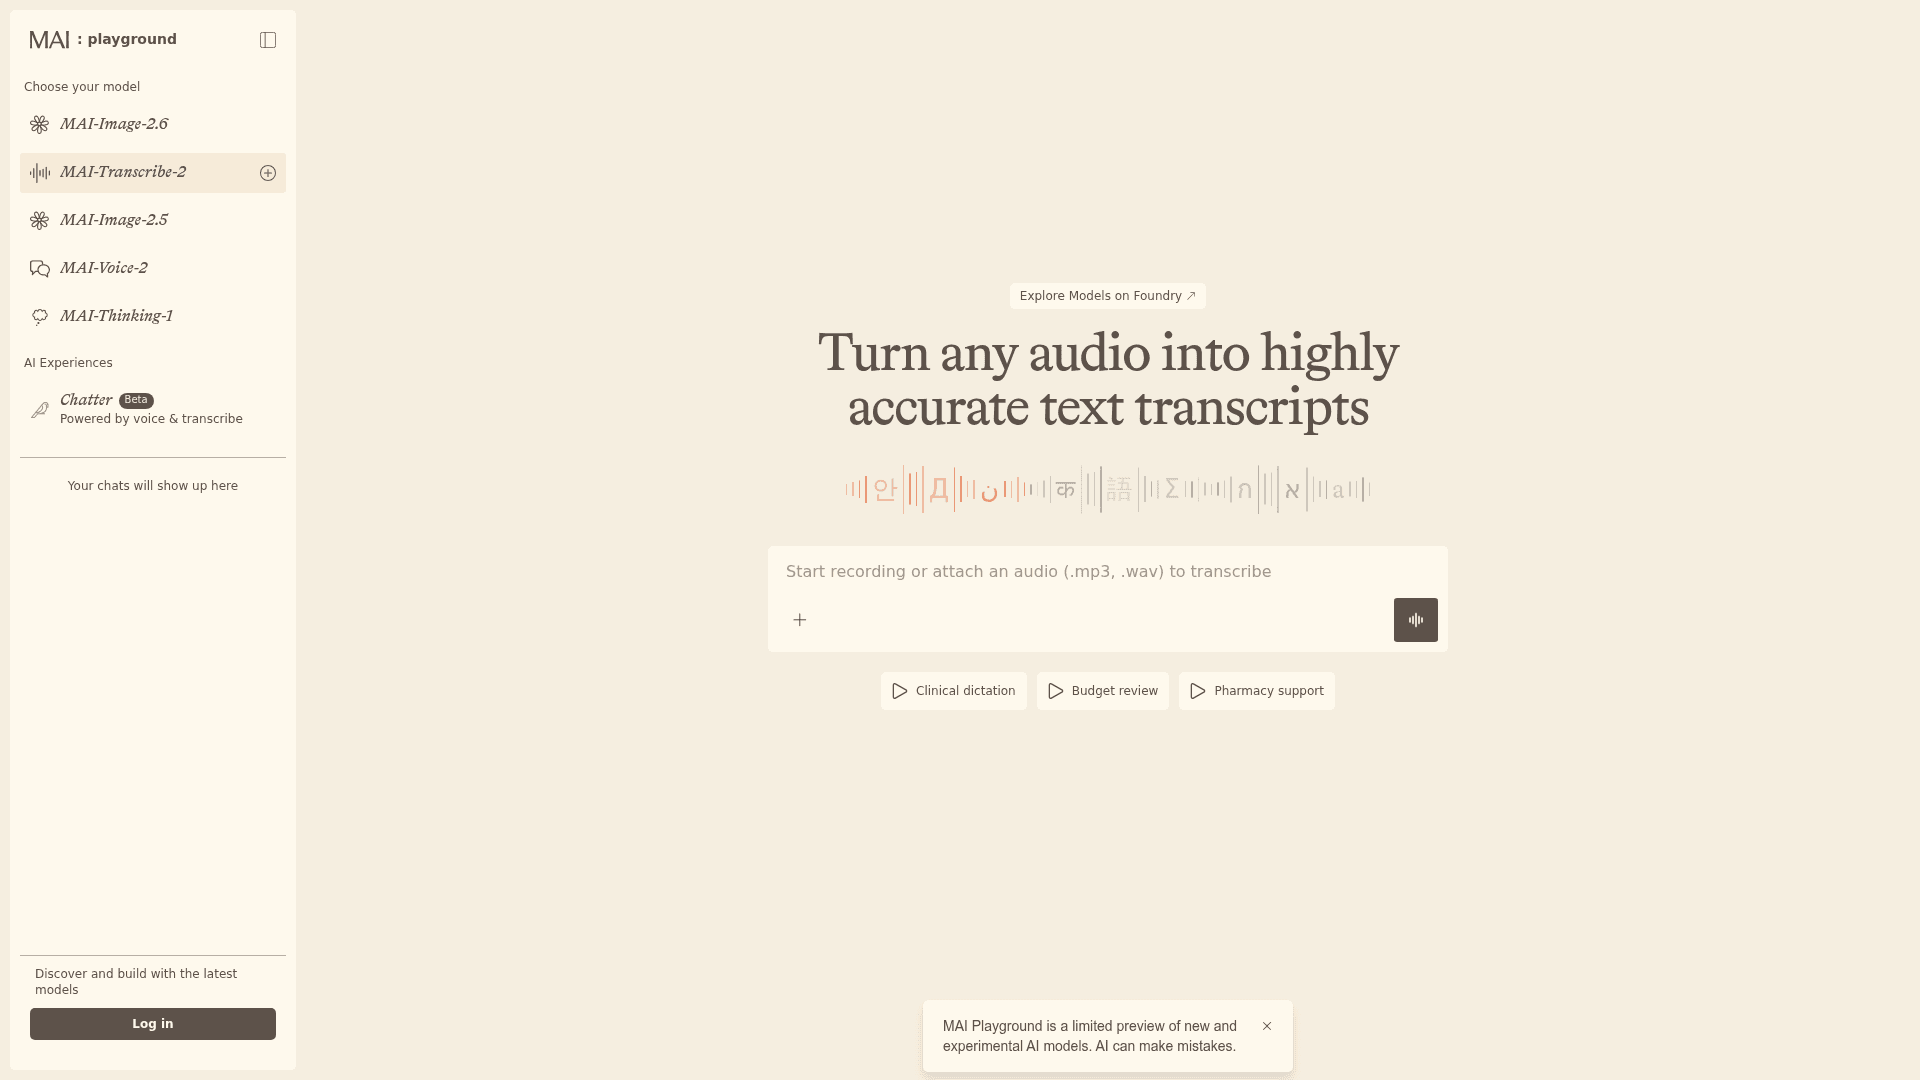
Si prefieres hacer clic a usar curl, hay dos puertas más fáciles. El MAI Playground te permite soltar un MP3 o grabar directamente desde el navegador, con ejemplos de dictado clínico y llamadas de soporte, y el modelo también figura en OpenRouter y en el catálogo de Azure AI Foundry.
Dónde es realmente bueno y dónde están las pegas
Primero, démosle a MAI-Transcribe-2 lo que merece. La reacción independiente más sólida que encontré no fue una republicación de la hoja de especificaciones. Vojtech Rinik, el desarrollador independiente detrás de la app Whisper Memos, pasó por el modelo un clip real difícil:
"I tried running a church homily with lots of echo in Slovak language through this... It did much better than ElevenLabs at 45% of the price."
El audio ruidoso, con eco y en un idioma distinto del inglés es justo el caso que rompe a los modelos más débiles, así que un desarrollador que lo elige frente a una herramienta que ya usa en producción dice algo que la tabla de benchmarks no puede.
Ahora las pegas, porque importan si lo vas a llevar a producción. El precio de $0,10 por hora es una promoción de lanzamiento que dura "hasta finales de año", y Microsoft no ha publicado qué ocurre después. Como referencia, la página del modelo sigue listando MAI-Transcribe-1.5 a $0,36 por hora, así que no sorprendería que la tarifa estándar de v2 caiga en ese rango. Un comentarista de Hacker News planteó las dos preguntas que Microsoft dejó abiertas en el lanzamiento:
"is this usable for streaming or only batch? do they give the price after the launch-discount (till end of year) goes away?"
La parte del streaming tiene respuesta, y es engorrosa: la Fast Transcription API es solo por lotes, y para audio en vivo hay que conectar el modelo como modelo de transcripción de entrada en la Voice Live API, que es aparte. Es factible, pero no es la misma llamada, así que planifícalo. Además sigue en vista previa pública y se publicó sin SLA, algo que Microsoft señala expresamente como no apto para producción.
La forma de integración es lo otro que hay que revisar. Al ser un modelo de transcripción puro, no encaja en las herramientas de chat completions como un LLM generalista. Los desarrolladores en Reddit se toparon con esto pronto:
"OpenRouter requires a dedicated endpoint (
/api/v1/audio/transcriptions) for pure transcription models like MAI-Transcribe-2."

Nada de esto es un impedimento. Es la textura normal de un modelo en vista previa con una semana de vida, y vale la pena mencionarlo para que no te sorprenda.
Lo que el gráfico de benchmarks no muestra
Este es el replanteamiento al que volvía una y otra vez. La transcripción solía ser la parte difícil y cara. MAI-Transcribe-2, junto con Gemini 3.5 Transcribe y ElevenLabs Scribe, la ha convertido discretamente en una capa rápida, barata y casi resuelta, una commodity. Es una gran noticia, pero también significa que el valor se ha desplazado. Una transcripción precisa no es lo que nadie quería realmente; es la materia prima de lo que sí querían.
En ningún sitio es más claro que en atención al cliente. Un modelo de transcripción puede convertir una llamada de soporte o un mensaje de voz en texto impecable, con hablantes diferenciados y marcas de tiempo, en unos diez segundos. ¿Y luego qué? Hay que leer el texto, encontrar la respuesta en tus documentos y tickets anteriores, redactar la respuesta y resolver el ticket. El modelo te da los oídos. No te da al compañero.
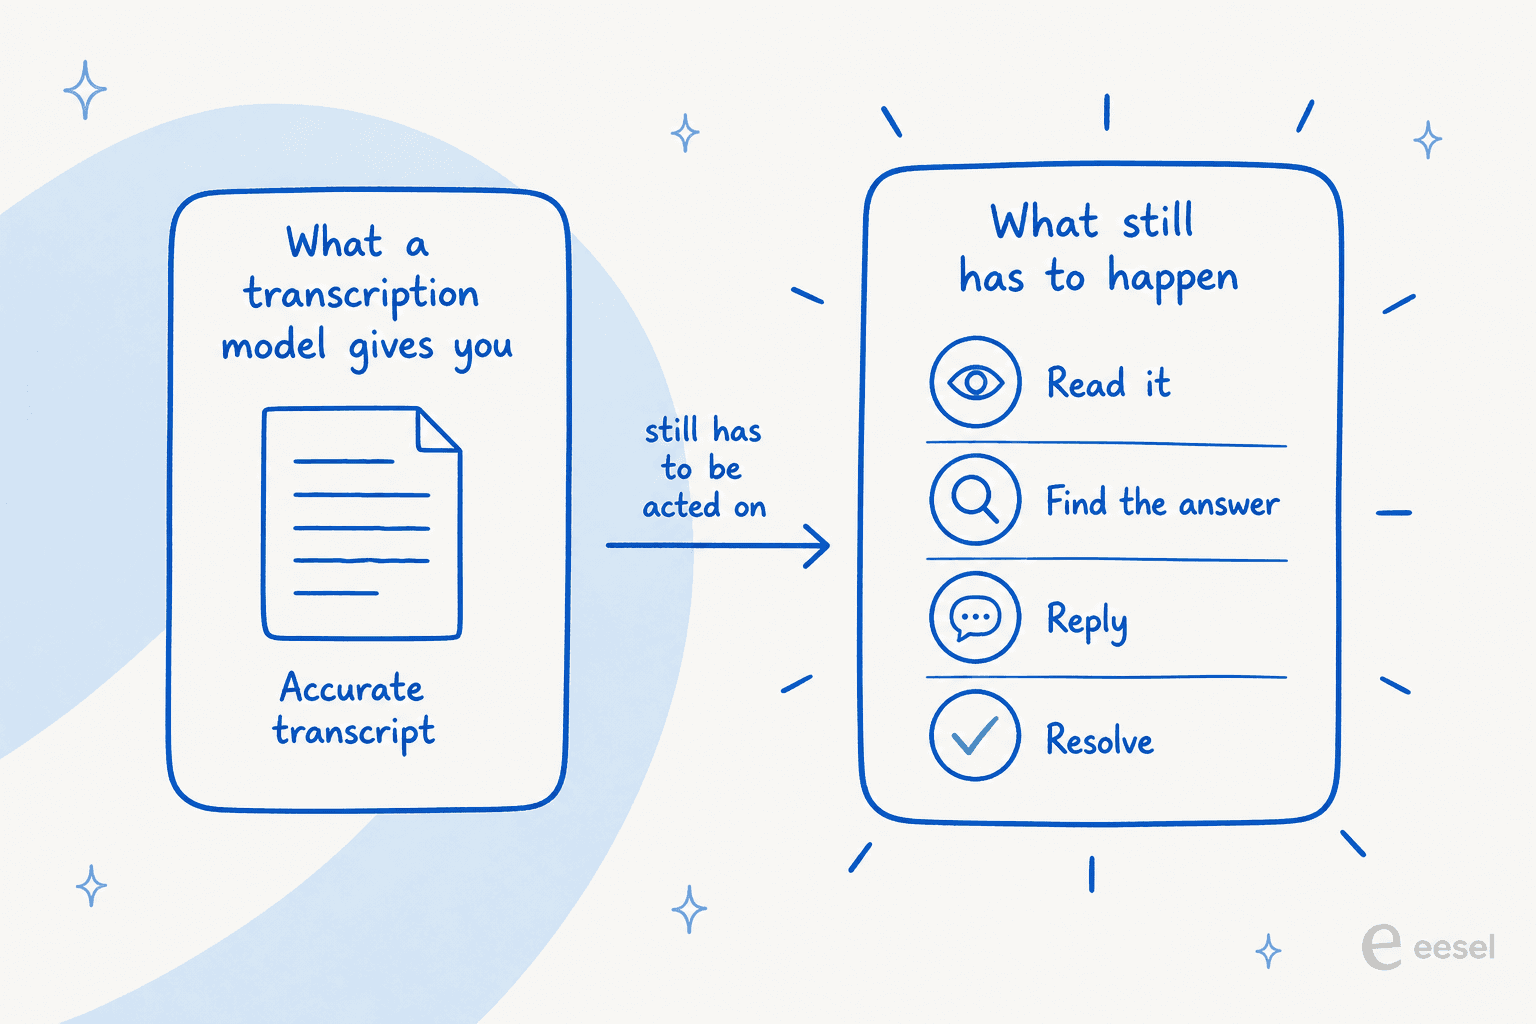
Este es el límite honesto de un modelo como MAI-Transcribe-2, y no es una crítica. Hace su trabajo extremadamente bien. Es solo un trabajo distinto de resolver la conversación, y si eres un equipo de soporte, el segundo es el que realmente mueve tus números.
Dónde encaja eesel
MAI-Transcribe-2 es infraestructura. eesel es el empleado que trabaja encima. Construimos compañeros de IA que contratas para un trabajo concreto, y el compañero de IA para helpdesk es el que recoge el testigo donde se detiene un modelo de transcripción: lee el texto, extrae la respuesta de tu centro de ayuda y tickets anteriores, y redacta o envía la respuesta directamente en Zendesk, Freshdesk o Slack. Combina ambos y un ticket de voz transcrito se convierte en uno resuelto, no solo en un párrafo ordenado.

Y como MAI-Transcribe-2 es un modelo pensado primero para APIs, los desarrolladores que lo eligen suelen querer ese mismo control sobre su automatización de soporte. eesel tiene una CLI pública para eso: maneja el mismo compañero y espacio de trabajo desde una terminal, de modo que una persona puede ejecutarla a mano, un script puede automatizarla y agentes de programación como Claude Code o Cursor pueden operarla sin interfaz, sin necesidad de panel. Puedes conectar la transcripción al inicio de ese flujo y eesel al extremo que resuelve. Es gratis para probar, se conecta a tu helpdesk en unos minutos y simula con tus tickets pasados reales antes de responder a ningún cliente, para que veas cómo habría gestionado tu cola antes de soltarlo.