

Cohere Parse 5 (parse-v5.0) es un modelo de visión pequeño y centrado en el coste que convierte páginas de documentos en Markdown limpio para búsqueda, RAG y agentes. Estuvo disponible de forma general el 27 de agosto de 2026.
El veredicto honesto: Parse 5 no es el parser más preciso del mercado, y no lo intenta. En el ParseBench propio de Cohere obtiene 79,2, por detrás de los LLM de frontera (GPT-5.5 con 84,4, Opus 4.8 con 84,3, Gemini 3.5 Flash con 81,8) pero por delante de la mayoría de las herramientas OCR dedicadas. Gana en precio y rendimiento: 1,50 $ por 1.000 páginas y 4,5 páginas por segundo, con Model Vault reduciendo aún más el coste por página a escala.
Cómpralo si analizas cientos de miles o millones de páginas para una cadena RAG y quieres un coste predecible. Ten cuidado si necesitas hoy una integración dura (el endpoint en producción acepta imágenes, no PDF), salida JSON estructurada o puntuaciones de confianza por campo, porque Parse 5 no ofrece ninguna de ellas. Y recuerda que Parse es solo el primer paso: te entrega texto limpio, no respuestas.
Cohere Parse 5 llegó con un planteamiento muy concreto. No "el mejor parser de documentos", sino "el mejor perfil de calidad-precio del mercado". Es algo refrescante de admitir en un lanzamiento, y es también toda la historia de si este modelo es adecuado para ti.
Me dedico a construir integraciones y conexiones de API, y en eesel he pasado mucho tiempo en la parte poco glamurosa de ese trabajo: lograr que documentos empresariales desordenados lleguen en una forma que una IA pueda usar de verdad. El análisis es donde una cadena de recuperación gana o pierde sin hacer ruido. Un parser que destroza una tabla de precios o pierde un campo de formulario envenena cada respuesta posterior, y rara vez lo notas hasta que a un cliente le dan la cifra equivocada. Así que leí la documentación de Parse 5 como leo cualquier parser: no "qué tan buena es la demo", sino "qué se rompe en producción".
Esto es lo que encontré.
Qué es realmente Cohere Parse 5
Parse es la entrada de Cohere en la inteligencia documental empresarial. La frase del producto es "convierte tus documentos empresariales en datos listos para la IA", y mecánicamente significa que transforma archivos complejos y multimodales (tablas, formularios, diagramas, imágenes incrustadas) en Markdown estructurado y legible por máquinas que puedes pasar a flujos de indexación, recuperación y agentes.
Los detalles importan, porque "modelo de visión y lenguaje para documentos" abarca mucho terreno. Según la documentación del modelo, parse-v5.0 es un modelo de 2.300 millones de parámetros, de unos 4,6 GB, con un contexto de 8.192 tokens, construido sobre la arquitectura north-micro-vision-instruct de Cohere. Es un modelo deliberadamente pequeño. Cohere es clara en que los LLM de frontera con los que se compara son "cada uno de propósito general y significativamente más grandes que Parse". Ser pequeño es el punto: es lo que hace que funcionen el precio y el rendimiento.
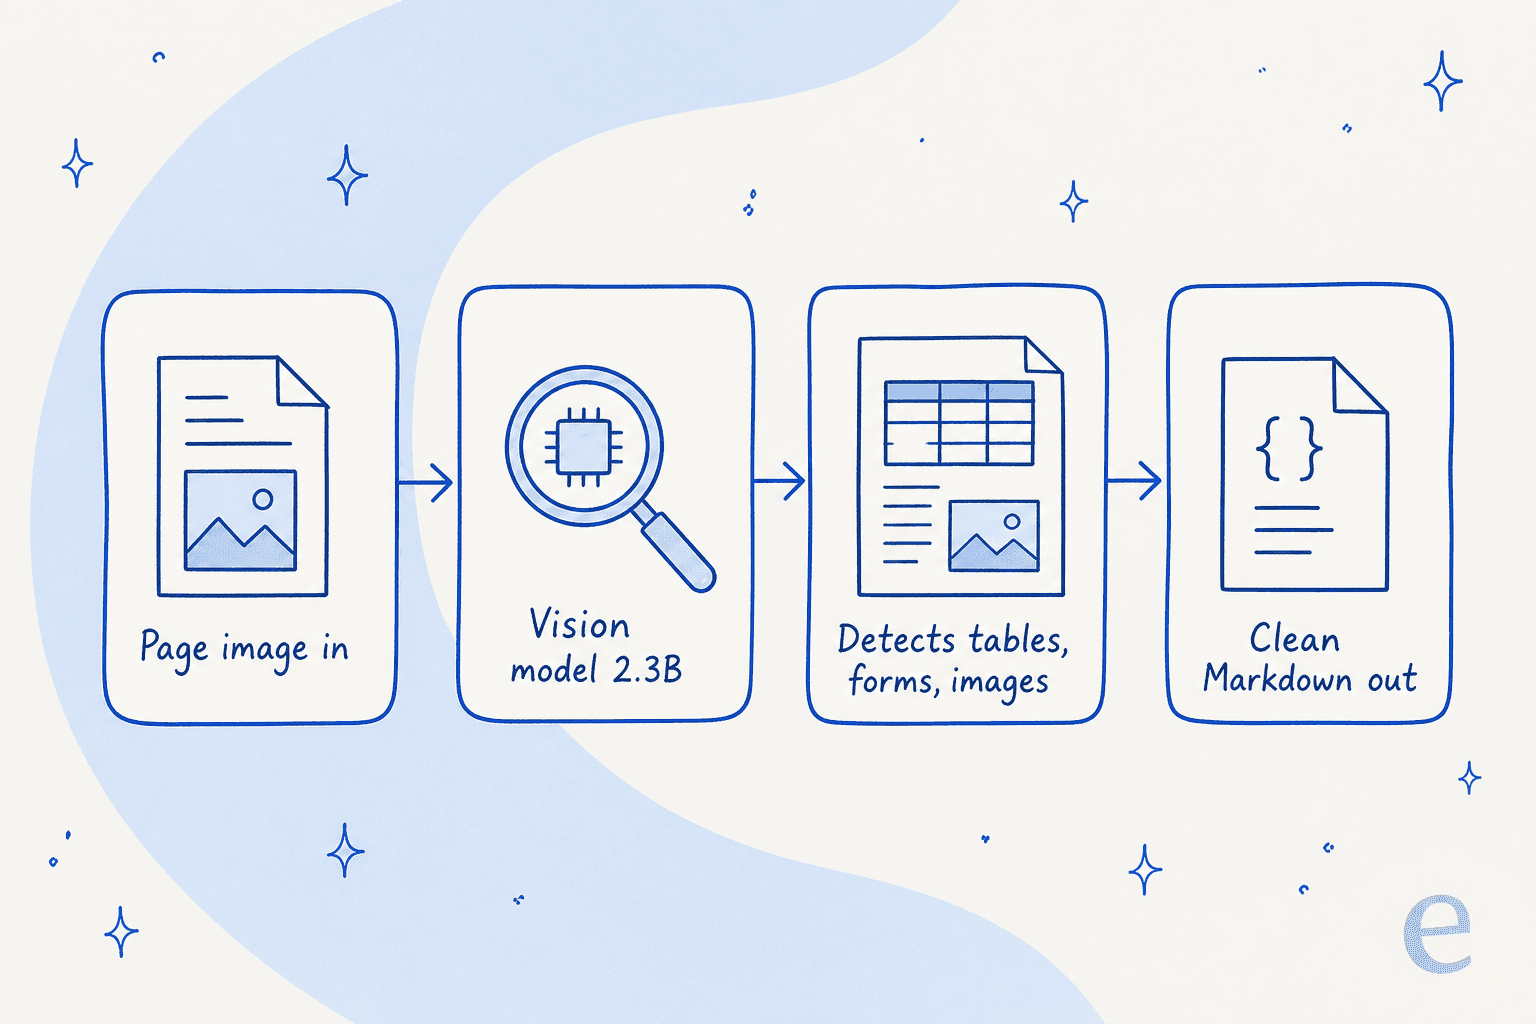
El flujo es simple. Le das una imagen de página, detecta la estructura visual y devuelve Markdown limpio con las tablas en HTML integrado y cuadros delimitadores para los elementos visuales.
El benchmark: sólido, pero no el primero
Cohere creó su propio benchmark, ParseBench, para medir el "rendimiento de análisis apto para agentes" en tres dimensiones: extracción de tablas, fidelidad del contenido (omisiones, alucinaciones, orden de lectura roto) y formato semántico (estilos que cambian el significado, como el tachado).
Parse alcanza 79,2 en el promedio de las tres dimensiones, y la forma de esa puntuación es interesante. Es realmente fuerte en tablas (87,0) y fidelidad del contenido (86,6), y más débil en formato semántico (64,0). Es decir, lee y estructura tu contenido de forma fiable, pero es menos cuidadoso al conservar matices como la cursiva o el tachado, que a veces cambian lo que dice el texto.
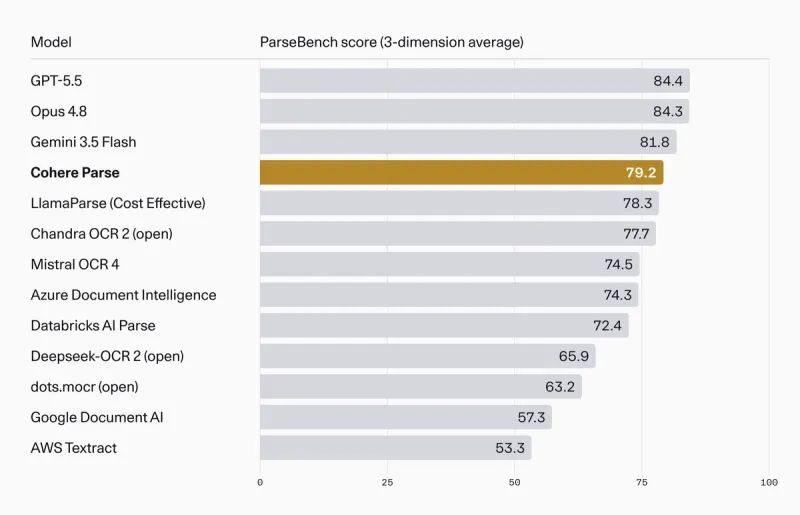
Si lees el gráfico con honestidad, dos cosas son ciertas a la vez. Parse es superado por los tres modelos de frontera: GPT-5.5 (84,4), Opus 4.8 (84,3) y Gemini 3.5 Flash (81,8). Y Parse supera a todos los parsers dedicados que Cohere probó, incluido el nivel económico de LlamaParse (78,3), Chandra OCR 2 (77,7), Mistral OCR 4 (74,5) y Databricks AI Parse (72,4). Frente a los servicios OCR en la nube de la vieja guardia no hay comparación: Cohere reporta una mejora de más de 20 puntos tanto sobre AWS Textract (53,3) como sobre Google Document AI (57,3).
Una salvedad que conviene nombrar: es el benchmark del propio proveedor, y el modelo que vende gana en el planteamiento ajustado por precio. Eso no hace que las cifras sean erróneas, pero por eso el gráfico más útil es el siguiente, donde la precisión se compara con el coste.
Rendimiento y precio: donde Parse realmente gana
Este es todo el argumento a favor de Parse, así que merece detenerse.
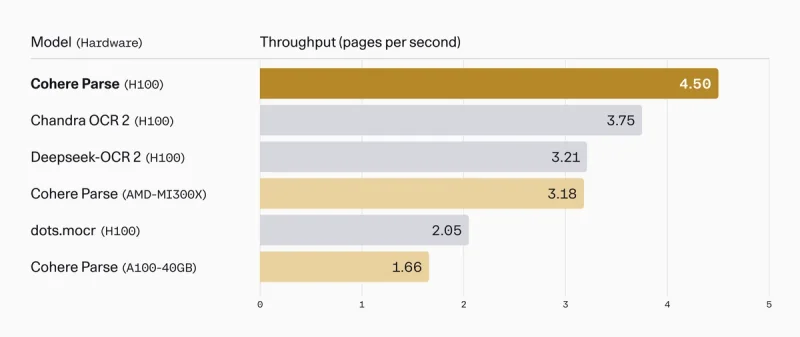
En precio, la API de Cohere cobra 1,50 $ por 1.000 páginas. En rendimiento, el modelo procesa 4,5 páginas por segundo, que Cohere reporta como 36 páginas por segundo (2.160 páginas por minuto) en un nodo 8×H100, aproximadamente 1,4 veces el rendimiento de dots.mocr de RedNote y 2,2 veces el de Chandra OCR 2 con el mismo hardware, todo servido con vLLM.
Si pones la precisión y el precio en los mismos ejes, la posición real de Parse salta a la vista. En el gráfico de Pareto de ParseBench, se sitúa en el cuadrante barato y de alta puntuación, mientras que los LLM de frontera ofrecen unos puntos más de precisión a entre 30 y 50 veces el coste por página.
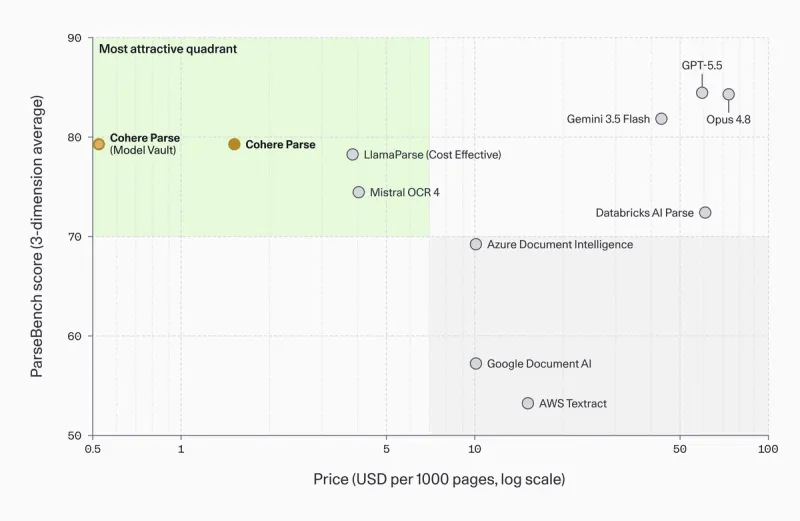
El ahorro se vuelve más concreto con volumen. El ejemplo práctico de Cohere: un flujo de cuentas por pagar que procesa unos 13 millones de páginas al mes en Model Vault en lugar de la API ahorra unos 12.000 $ al mes, o 144.000 $ al año. Frente a un parser de hiperescalador de 10 $ por 1.000 páginas, ese mismo flujo ahorraría unos 1,47 millones de $ al año. Son el tipo de cifras que llevan una decisión de análisis al departamento de finanzas, y son la razón de ser de Parse.
Precios de Cohere Parse 5 al detalle
Parse se vende por varias vías, y la más barata depende de lo constante que sea tu uso. Aquí está el panorama completo.
| Vía de acceso | Qué obtienes | Precio |
|---|---|---|
| API de Cohere | Endpoint gestionado, pago por página, sin infraestructura | 1,50 $ por 1.000 páginas |
| Model Vault (50 % de uso de GPU) | Instancia por horas de un solo inquilino | ~23 % menos que la API |
| Model Vault (uso completo) | Instancia por horas de un solo inquilino | hasta 61 % menos que la API |
| Microsoft Foundry | Modelo Cohere-parse-v5 en Azure | Precio de instancia de Azure |
| Amazon SageMaker | Despliegue desde el marketplace | Precio de instancia de AWS |
| Hugging Face Space | Demo gratuita para probarlo | Gratis |
Mi lectura: la API es la opción correcta para trabajo irregular o de bajo volumen, porque solo pagas las páginas que envías. Model Vault gana cuando tienes un volumen constante y alto que mantenga ocupadas las instancias, que es justo la carga a escala de cuentas por pagar para la que se creó Parse. Si tu volumen es irregular, haz las cuentas antes de comprometerte con una instancia dedicada, porque el tiempo de GPU ocioso borra rápido el ahorro por página.
Para ver cómo encaja esto en el catálogo y los planes más amplios de Cohere, nuestro desglose de precios de Cohere AI cubre las tarifas de Command, Embed y Rerank junto a esta.
Qué extrae y qué omite
Un parser se define tanto por lo que deja fuera como por lo que captura, y Parse tiene algunos bordes afilados que conviene conocer antes de construir sobre él.
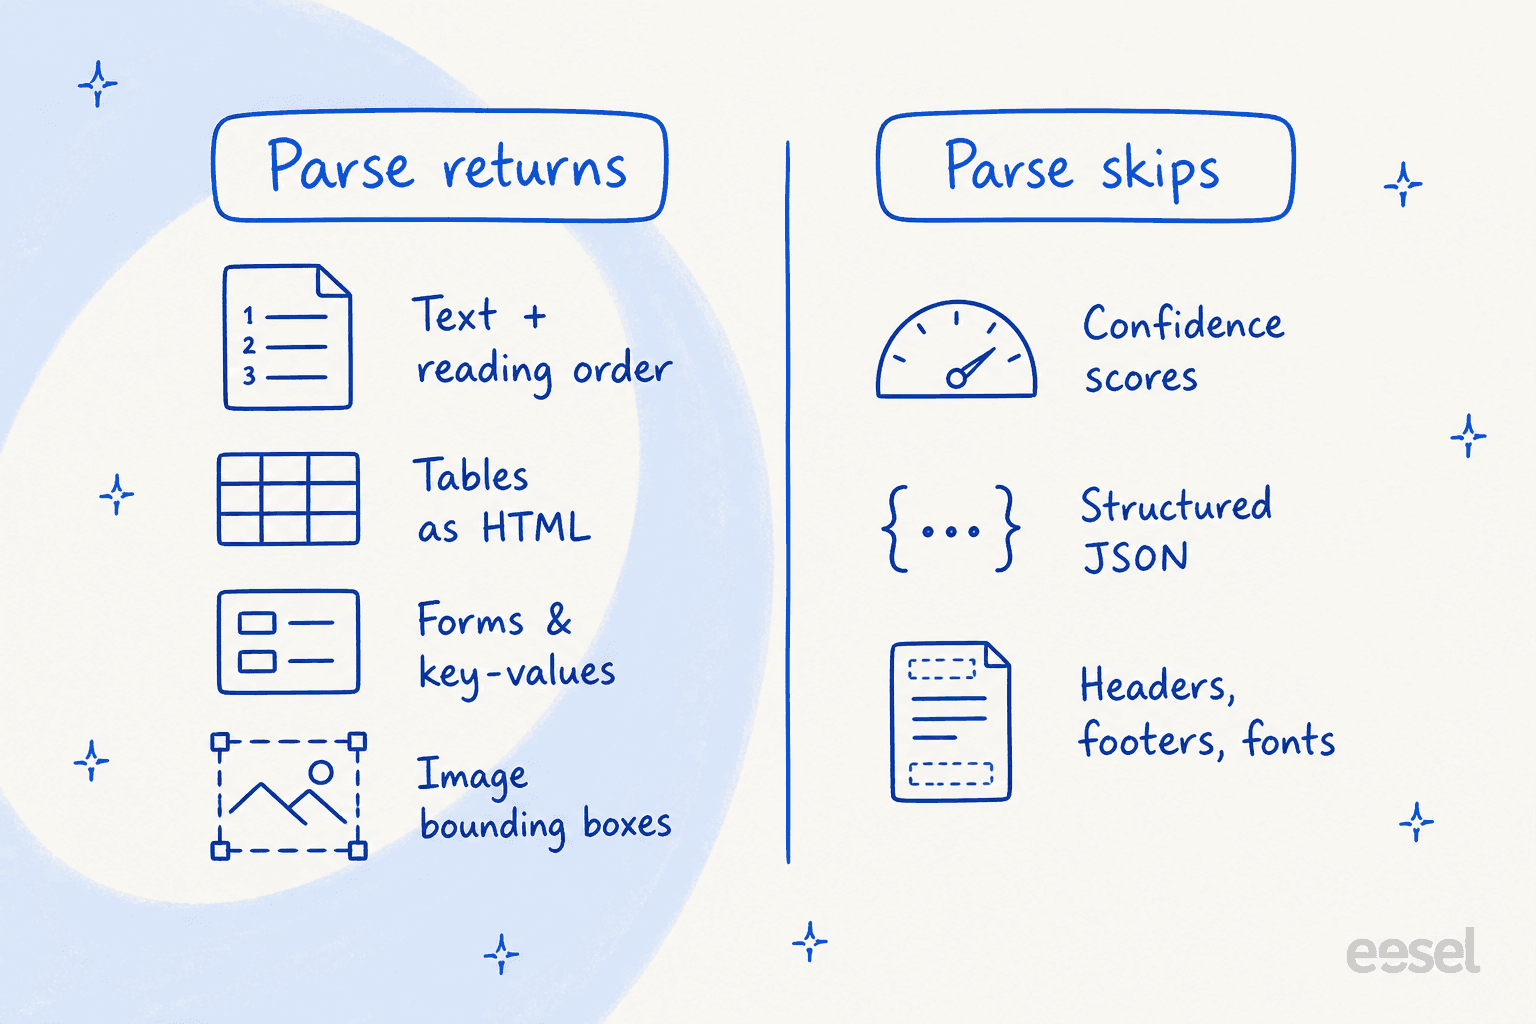
En el lado positivo, Parse devuelve texto con el orden de lectura correcto, tablas como HTML, formularios y pares clave-valor, y descripciones de imágenes con cuadros delimitadores. Es un conjunto de funciones sólido para alimentar una base de conocimiento o un chatbot de base de conocimiento con IA.
Los límites, directamente de la documentación, son donde debes prestar atención:
- Sin puntuaciones de confianza. No puedes preguntarle a Parse qué tan seguro está de una extracción, lo que dificulta el control de calidad automatizado. En un flujo de cuentas por pagar o de siniestros, es un vacío real.
- Solo Markdown, sin JSON estructurado. Si tu cadena espera campos tipados de entrada, tendrás que posprocesar el Markdown tú mismo.
- Sin detección de encabezados, pies de página ni jerarquía tipográfica. Lee el contenido, pero no etiqueta los elementos accesorios del documento ni los niveles de título.
- Cuadros delimitadores solo para tablas e imágenes. Según la nota al pie 2 del lanzamiento, Parse no emite cuadros por elemento para el texto. Cohere lo presenta como una decisión intencional sobre el orden de lectura, no como un error, y para la mayoría de los casos de RAG no importa, pero si necesitas coordenadas a nivel de palabra, busca en otro lado.
Ninguna de estas es un obstáculo para el caso de ingesta al que apunta Parse. Sí lo son si esperabas integrar Parse en un producto de extracción estructurada de documentos que necesite campos tipados y control de confianza. Adapta la herramienta al trabajo.
Llamar a la API (y el único problema)
La experiencia de desarrollo es limpia. Instalas el SDK, creas un cliente y llamas a co.parse en la API v2 de Cohere.
La llamada mínima del inicio rápido es tan simple como puede ser el análisis:
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")
data_uri = f"data:image/png;base64,{b64}"

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": data_uri},
)

for page in response.pages:
    print(page.markdown.content)
Aquí está el problema, y es grande para cualquiera que planee construir hoy. La documentación menciona PDF, PPT y JPEG como tipos admitidos, pero la referencia de la API es explícita: el endpoint admite actualmente solo document.type = image_url, es decir, un data URI o una URL de imagen remota. Las entradas directas de PDF y de URL de archivo aún no son compatibles. Así que, en la práctica, primero conviertes las páginas del PDF a imágenes y las envías una a una. Los límites de imagen son generosos (20 MB de tamaño de archivo, 50 megapíxeles), y puedes cambiar output_format a blocks cuando quieras el arreglo ordenado de regiones de texto, tabla e imagen con sus cuadros delimitadores en lugar de Markdown plano.
La cobertura de idiomas es de nueve idiomas de entrada estables hoy: árabe, inglés, francés, alemán, japonés, coreano, italiano, portugués y español, con soporte zero-shot para otros con menor precisión.
Dónde encaja Parse: es el primer paso, no toda la cadena
Esta es la parte que la mayoría de la cobertura del lanzamiento pasa por alto. Parse convierte documentos en texto limpio. No los incrusta, no los recupera y no responde nada. Es la puerta de entrada de una cadena de recuperación, no la cadena.
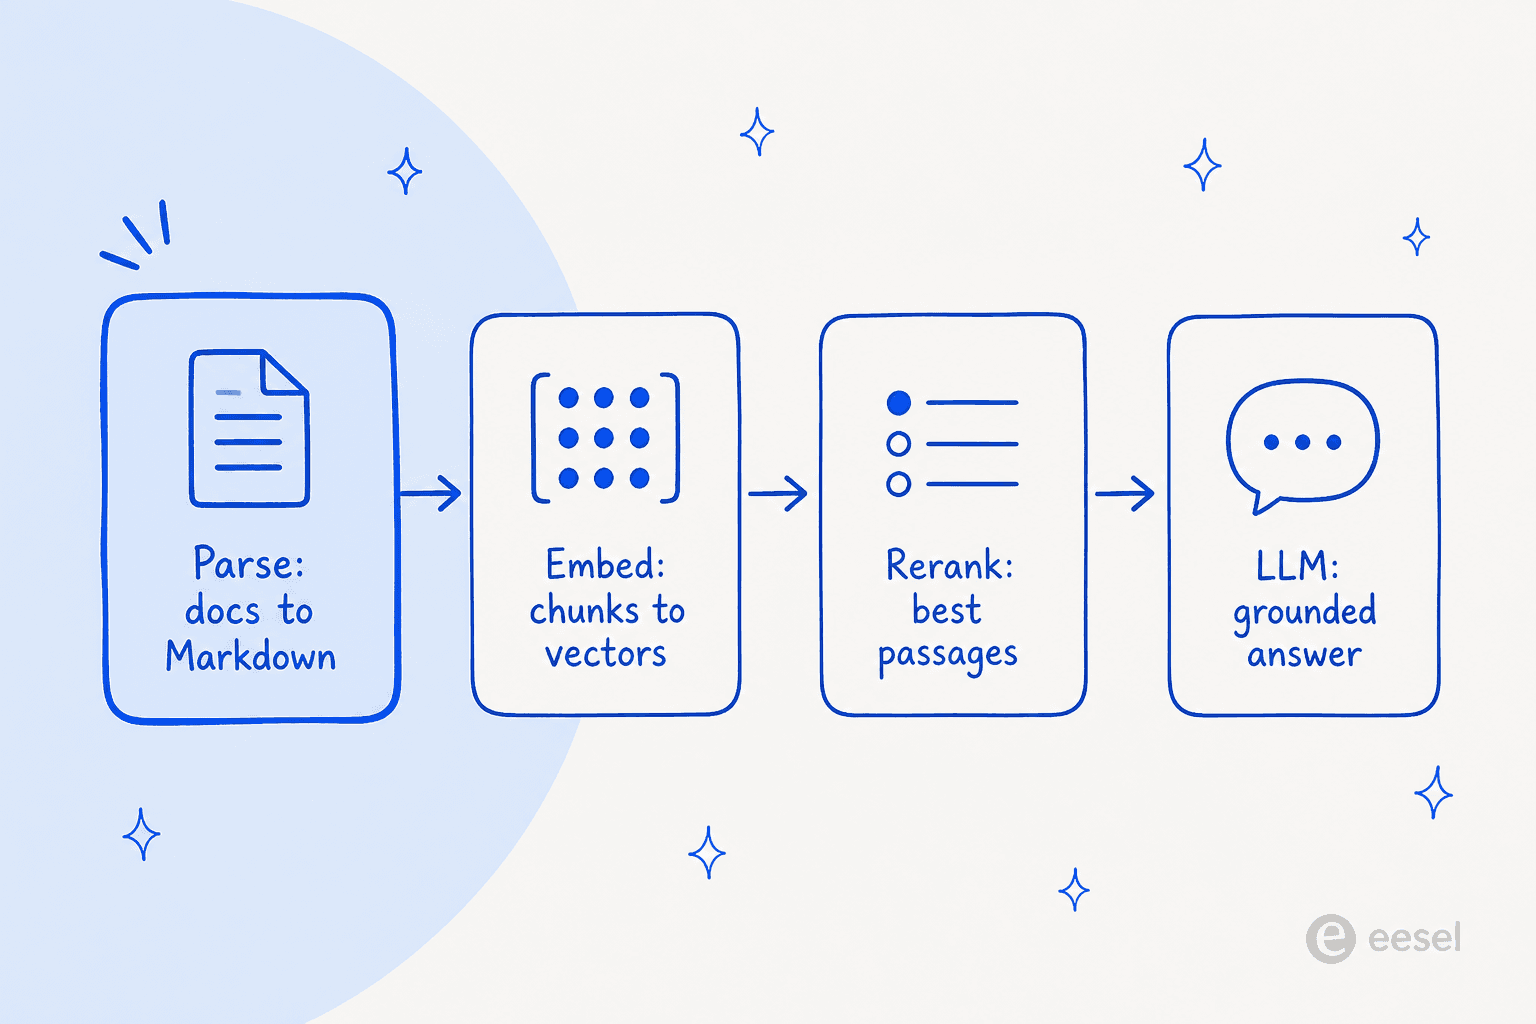
Cohere lo sabe, por eso Parse se entrega como componente de Compass, su pila de inteligencia documental y búsqueda, junto con Embed y Rerank. Si ya apuestas todo por Cohere, ese camino integrado es realmente cómodo. Si no, conviene sopesar las alternativas a Cohere antes de estandarizar en una sola pila.
La única voz externa creíble que encontré sobre el lanzamiento coincidía en que analizar es más difícil de lo que parece. El periodista de tecnología empresarial Sean Kerner lo expresó bien:
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Ese escepticismo es razonable. Parse 5 es un buen lanzamiento, pero es un parser sólido en un campo en constante agitación, y resuelve exactamente un eslabón de una cadena con cuatro o cinco. Si tu objetivo real es responder preguntas a partir de tus documentos, elegir un parser es el inicio del proyecto, no el final.
Quién debería usar realmente Cohere Parse 5
Después de revisarlo, esta es mi conclusión.
Elige Parse 5 si ingieres grandes volúmenes de documentos empresariales (piensa en cientos de miles a millones de páginas) en un sistema RAG o de gestión del conocimiento, te importa un coste por página predecible y "casi la precisión de frontera por una fracción del precio" es el compromiso que quieres. La opción de Model Vault y local lo convierte además en una elección sólida para sectores regulados que no pueden enviar documentos a una API pública.
Descártalo, por ahora, si necesitas ingesta directa de PDF hoy, salida JSON estructurada, puntuaciones de confianza por campo o los últimos puntos de precisión de formato que solo compra un modelo de frontera. Y descártalo si lo que querías en realidad eran respuestas y no texto limpio, porque un parser solo no te lleva ahí.
eesel: cuando quieres respuestas, no solo texto analizado
Si llegaste a Parse 5 porque quieres que una IA responda de verdad preguntas a partir de los documentos de tu empresa (tickets de soporte, artículos de ayuda, wikis internas), conviene nombrar lo que el parser no hace. Parse te da Markdown limpio. Aún tienes que construir encima las capas de embeddings, recuperación, ranking y respuesta, y luego mantenerlas precisas a medida que cambia tu contenido.
eesel es la versión lista para trabajar de toda esa cadena. En lugar de infraestructura que ensamblas, es un compañero de helpdesk con IA que contratas: se conecta a tu centro de ayuda, tickets anteriores y herramientas como Zendesk o Confluence, aprende el contexto de tu empresa y responde preguntas reales de clientes y empleados. Es una de las mejores opciones de helpdesk con IA precisamente porque toda la cadena está resuelta por ti. Parse 5 es un bloque de construcción; eesel es el trabajo terminado.

Lo que destacaría, porque es lo que desearía que tuviera toda cadena que empieza por el análisis: eesel te permite simular un despliegue con tus propios tickets históricos antes de que responda a un cliente real, para que veas la tasa de resolución real y las respuestas exactas sobre tu contenido real, no una demo. Esa es la diferencia entre lanzar un parser y lanzar algo en lo que confías. Puedes probar eesel gratis.
Preguntas frecuentes
¿Qué es Cohere Parse 5?
parse-v5.0) es un modelo de visión de 2.300 millones de parámetros que convierte páginas de documentos en Markdown limpio y legible por máquinas para búsqueda, RAG y agentes de IA. Estuvo disponible de forma general el 27 de agosto de 2026 y se posiciona por su relación calidad-precio, no por ser el más preciso de la tabla.