

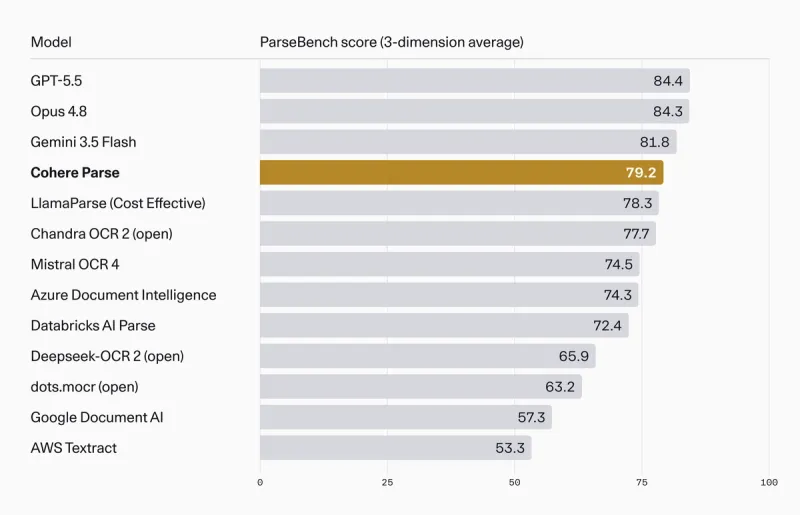
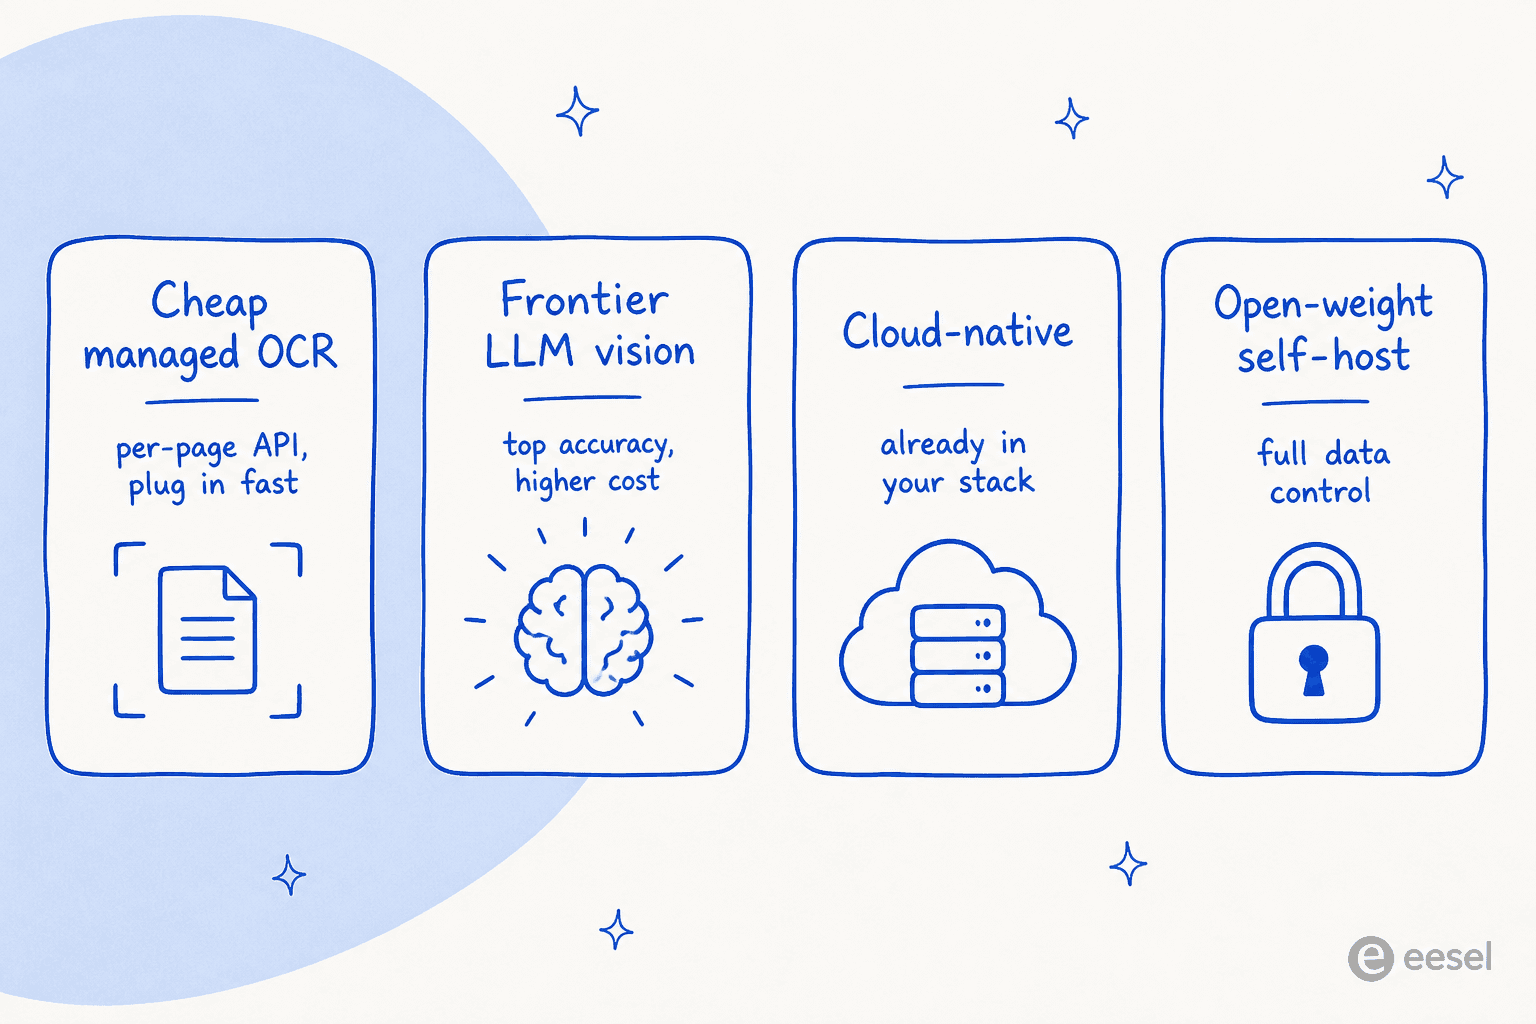
Cohere Parse 5 (parse-v5.0) es un analizador de documentos potente y barato: convierte páginas en Markdown limpio a 1,50 $ por 1.000 páginas y obtiene 79,2 en ParseBench. La gente busca alternativas por tres motivos: quiere mayor precisión, quiere una herramienta que viva dentro de una nube que ya paga, o quiere alojarla por su cuenta para controlar los datos.
Este es el resumen de adónde ir:
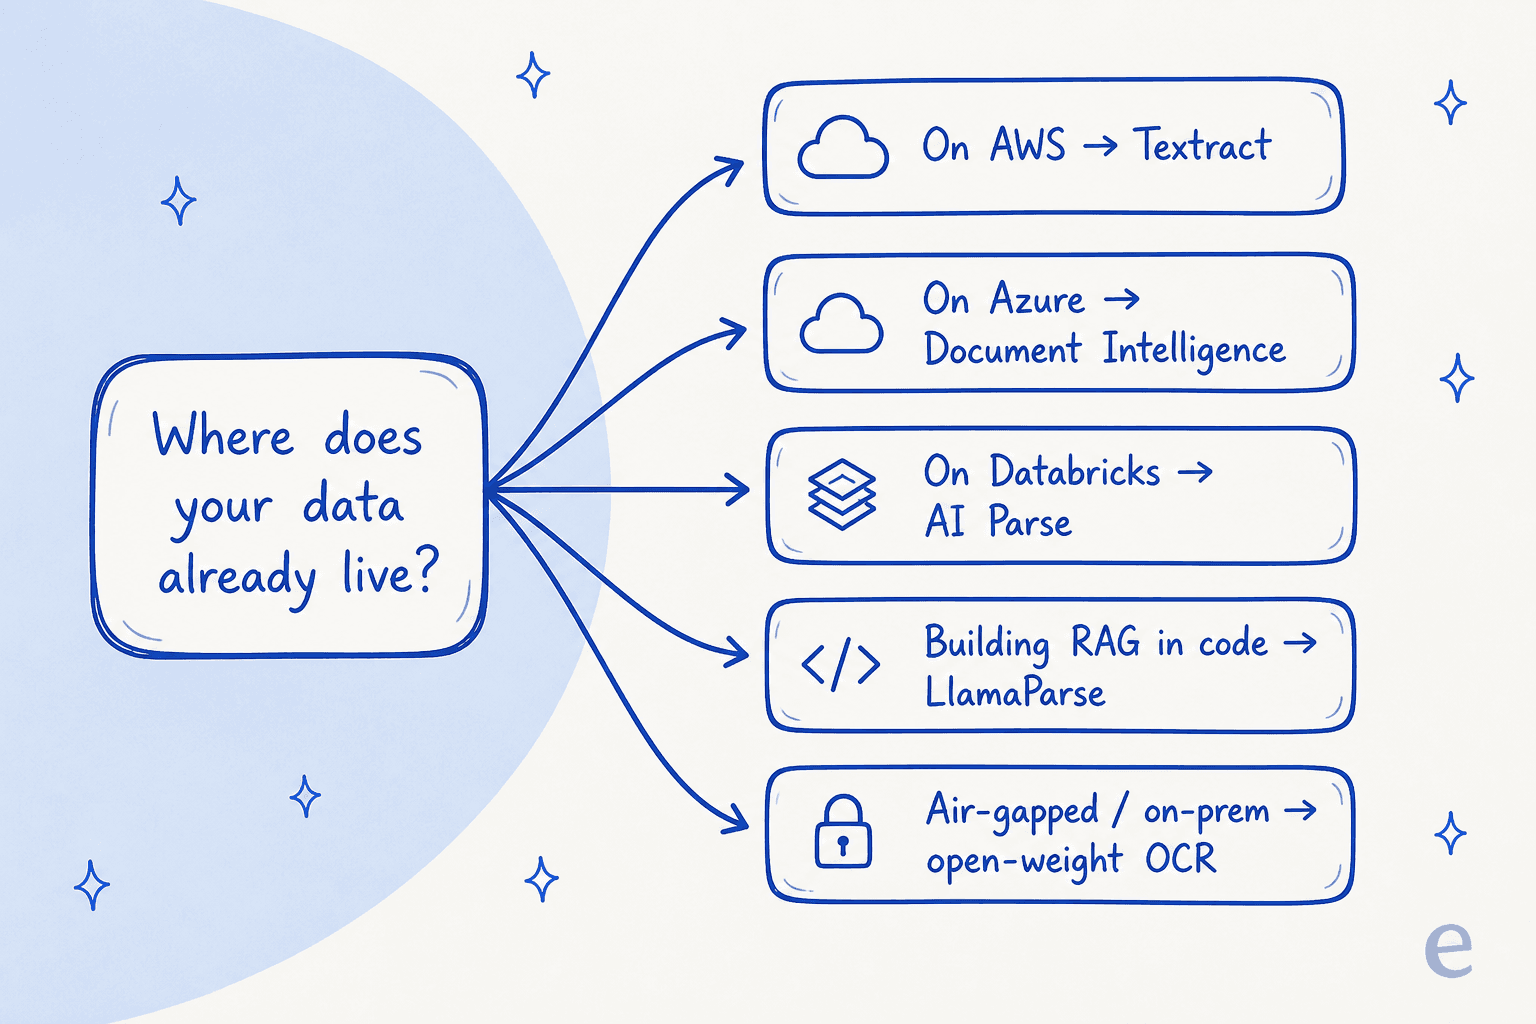
- ¿Quieres la mejor precisión cueste lo que cueste? Un modelo de frontera, GPT-5.5 (84,4) o Gemini 3.5 Flash (81,8), encabeza la tabla.
- ¿Quieres una API por página como Parse? Mistral OCR es el reemplazo más cercano.
- ¿Construyes RAG en código? LlamaParse encaja en el stack de LlamaIndex.
- ¿Ya estás en AWS, Azure o Databricks? Usa su analizador nativo (Textract, Document Intelligence, AI Parse) y evita un proveedor más.
- ¿Necesitas control total de los datos? Aloja tú mismo un modelo OCR de pesos abiertos.
Una cosa que conviene decir desde el principio: todas las herramientas de esta lista solo convierten documentos en texto. Si tu objetivo real es responder preguntas a partir de esos documentos, analizar es el paso uno de cuatro. Ahí entra un agente de IA para helpdesk listo para trabajar como eesel, que se encarga de toda la cadena y no solo del primer eslabón.
¿Por qué mirar más allá de Cohere Parse 5?
Primero, justicia con Parse, porque es un lanzamiento realmente bueno. Cohere lo presentó el 27 de agosto de 2026 como "un modelo de análisis visual de alto rendimiento con el perfil de precio-rendimiento más sólido del mercado", y las cifras respaldan ese planteamiento. Procesa 4,5 páginas por segundo, devuelve Markdown limpio que encaja directamente en un pipeline de RAG y cuesta una tarifa plana de 1,50 $ por 1.000 páginas. Si ingieres cientos de miles de páginas al mes, es difícil discutir esa relación precio-rendimiento. Profundicé en todo esto en nuestra reseña completa de Cohere Parse 5.
Entonces, ¿por qué alguien compara? Aparecen una y otra vez tres razones reales.
Precisión. Parse se posiciona explícitamente en precio-rendimiento, no en ser el analizador más preciso que se puede comprar. En ParseBench obtiene 79,2 y "solo lo superan los LLM de frontera" (GPT-5.5, Opus 4.8, Gemini 3.5 Flash). Si tus documentos son desordenados, densos o están llenos de tablas anidadas, esos puntos extra importan, y quizá pagues encantado más por página para conseguirlos.
Encaje con el stack. Si tus datos ya viven en AWS, Azure o Databricks, añadir Cohere significa otro proveedor, otra clave, otra factura y otro acuerdo de tratamiento de datos. El analizador nativo de tu nube suele ser "suficientemente bueno" y ahorra toda esa fricción.
Límites de entrada y control de datos. El endpoint en vivo de Parse solo acepta imágenes por ahora, así que hay que convertir los PDF antes, y es una API gestionada. Los equipos de sectores regulados suelen querer manejo directo de PDF o un modelo que puedan ejecutar por completo en su propio hardware. Algunas alternativas ofrecen ambas cosas.
Nada de esto es una crítica a Parse. Son simplemente las costuras donde otra herramienta encaja mejor. Así se reparte el mercado.
Cómo elegí y comparé estas alternativas
Todas las herramientas de aquí hacen el mismo trabajo central que Parse: toman páginas de documentos y devuelven texto o Markdown estructurado y legible por máquinas. Las ordené según cuatro criterios que a un comprador realmente le importan:
- Precisión - dónde queda en ParseBench, el benchmark que usó la propia Cohere, para que la comparación sea justa.
- Modelo de costes - por página, por token o con tu propia computación, y a cuánto equivale con volumen.
- Despliegue - API gestionada, dentro de una nube que ya usas o autoalojado.
- Manejo de entradas - solo imágenes, PDF directamente o una amplia variedad de tipos de archivo.
Aquí está todo el panorama de un vistazo. Las puntuaciones de ParseBench proceden directamente de la tabla publicada por Cohere.
| Herramienta | Media ParseBench | Ideal para | Despliegue | Entrada | Modelo de costes |
|---|---|---|---|---|---|
| Cohere Parse 5 | 79,2 | Análisis barato y de alto volumen | API, Model Vault, marketplaces de nube | Imágenes | 1,50 $ / 1.000 páginas |
| GPT-5.5 | 84,4 | Documentos más desordenados, máxima precisión | API | Imágenes, PDF (vía LLM) | Por token |
| Opus 4.8 | 84,3 | Máxima precisión, contexto largo | API | Imágenes, PDF (vía LLM) | Por token |
| Gemini 3.5 Flash | 81,8 | Análisis barato de nivel frontera | API | Imágenes, PDF (vía LLM) | Por token |
| LlamaParse | 78,3 | Pipelines de RAG basados en código | API / nube | PDF, Office, imágenes | Créditos por página |
| Mistral OCR 4 | 74,5 | API por página con autoalojamiento | API, autoalojado | Imágenes, PDF | 4 $ / 1.000 páginas |
| Databricks AI Parse | 72,4 | Equipos en el lakehouse | Dentro de Databricks | PDF, imágenes | DBU |
| Azure Document Intelligence | 69,3 | Formularios estructurados, modelos prediseñados | Azure | PDF, imágenes | Por 1.000 páginas |
| AWS Textract | 53,3 | Stacks nativos de AWS y regulados | AWS | PDF, imágenes | Por 1.000 páginas |
| Unstructured | No está en ParseBench | Ingesta abierta, muchos tipos de archivo | API, código abierto | Más de 25 tipos de archivo | Por página / código abierto |
Una nota rápida para leer la tabla: una puntuación más baja en ParseBench no es automáticamente "peor para ti". Textract queda al final en este benchmark general, pero si solo necesitas texto limpio de PDF estándar dentro de una empresa que usa AWS, sigue siendo una elección perfectamente sensata. Adapta la herramienta al trabajo, no a la clasificación.
1. LlamaParse
Ideal para: equipos que construyen un pipeline de RAG en código y ya viven en el ecosistema de LlamaIndex.
LlamaParse es el servicio de análisis de LlamaIndex, el popular framework de código abierto para crear aplicaciones LLM sobre tus propios datos. Está hecho exactamente para el trabajo al que apunta Parse: convertir PDF complejos, presentaciones y hojas de cálculo en Markdown limpio y listo para fragmentar para la recuperación. En ParseBench, su oferta Cost Effective obtiene 78,3, prácticamente a la par de los 79,2 de Parse.
Funciones. LlamaParse acepta PDF, archivos de Office e imágenes directamente (sin paso de conversión a imagen), ofrece varios modos de análisis que equilibran coste y profundidad, y encaja directamente en un pipeline de recuperación de LlamaIndex. Maneja tablas, imágenes incrustadas y diseños de varias columnas, y puede seguir instrucciones de análisis en lenguaje natural por documento.
Ventajas. Si ya escribes Python y usas LlamaIndex, es la opción con menos fricción de la lista. El soporte directo de PDF y Office ahorra tiempo de ingeniería real, y los 10.000 créditos gratuitos al mes facilitan prototipar antes de gastar nada.
Inconvenientes. Es una herramienta para desarrolladores, no un producto de apuntar y hacer clic. El modelo de créditos requiere un momento para entenderlo, ya que cada modo de análisis consume un número distinto de créditos por página. Y sigues montando tú mismo las capas de recuperación y respuesta.
Precios. LlamaParse factura en créditos: 1.000 créditos cuestan 1,25 $, y el análisis básico empieza en 1 crédito por página (los modos Agentic con conciencia de diseño cuestan más). El plan gratuito incluye 10.000 créditos al mes, y un Auto Mode envía cada página al nivel más barato que haga el trabajo.
Veredicto: la elección natural si construyes RAG en código y quieres un análisis que encaje con el resto de tu stack. Si no estás ya en el mundo de LlamaIndex, la dependencia del ecosistema es un motivo para buscar en otro sitio.
2. Mistral OCR
Ideal para: equipos que quieren la experiencia simple de API por página de Parse con otro proveedor, y una vía de autoalojamiento.
Mistral OCR es el parecido filosófico más cercano a Cohere Parse: un modelo OCR dedicado y de alto rendimiento que se vende como una API limpia por página. Mistral lo presenta como comprensión de documentos que devuelve Markdown estructurado con tablas e imágenes preservadas, de un modelo que también puedes ejecutar tú mismo. En ParseBench, Mistral OCR 4 obtiene 74,5, un escalón por debajo de Parse pero aún por delante de la mayoría de las opciones nativas de la nube.
Funciones. Maneja imágenes y PDF directamente, extrae tablas y figuras incrustadas, admite una amplia variedad de idiomas y devuelve Markdown pensado para la indexación posterior. Mistral también ofrece despliegue autoalojado para equipos que necesitan que los documentos permanezcan en su propia infraestructura.
Ventajas. Rápido y muy sencillo de integrar si alguna vez has llamado a una API al estilo OpenAI. La opción de autoalojamiento es un diferenciador real frente al endpoint solo gestionado de Parse, y la historia de residencia de datos europea atrae a equipos con requisitos de cumplimiento de la UE.
Inconvenientes. Queda por detrás de Parse y de los modelos de frontera en ParseBench, sobre todo en formato semántico, y el modelo actual ya no es la ganga de precio que era el original. En los documentos financieros o científicos más densos, la brecha de precisión puede verse como alguna tabla rota ocasional.
Precios. El actual Mistral OCR 4 cuesta 4 $ por 1.000 páginas, bajando a 2 $ por 1.000 con la API por lotes; la capa Document AI sin código cuesta 5 $ por 1.000. Eso está por encima de la tarifa plana de 1,50 $ de Parse, así que el cambio te cuesta algo más por página.
Veredicto: si te gustaba la idea de Parse pero quieres una segunda fuente, residencia de datos en la UE o una vía de autoalojamiento, Mistral OCR es el reemplazo más directo. Solo ten en cuenta que cambias unos puntos de precisión y pagas algo más por página.
3. GPT-5.5
Ideal para: los documentos más desordenados y valiosos, donde la precisión importa más que la factura por página.
No tienes por qué usar un analizador hecho a propósito. Un modelo multimodal de frontera como GPT-5.5 puede leer una imagen de página y devolver texto estructurado, y encabeza toda la tabla de ParseBench con 84,4, más de cinco puntos por delante de Parse. La propia Cohere admite que Parse "solo lo superan los LLM de frontera", y GPT-5.5 es uno de ellos.
Funciones. Como modelo de propósito general, GPT-5.5 no solo transcribe; razona sobre una página. Puedes pedirle que extraiga campos concretos, siga reglas de formato complejas o maneje un diseño que nunca ha visto, todo en una llamada. Lee imágenes y, a través de la API, PDF.
Ventajas. La mejor precisión del benchmark y una flexibilidad inigualable. Si un documento tiene un diseño raro con el que un analizador de esquema fijo se atasca, un LLM a menudo simplemente lo resuelve. Además es probablemente el mismo modelo que ya usas en otros sitios, así que no hay proveedor nuevo.
Inconvenientes. El coste. Pagas por token, y una página densa puede ser muchos tokens, así que con millones de páginas se encarece rápido frente a la tarifa plana por página de Parse. También es más lento por página, y los modelos generales pueden alucinar contenido, algo a lo que un modelo OCR específico es menos propenso.
Precios. Por token, facturado en entrada y salida, así que el coste escala con la complejidad de la página en lugar de una cifra fija por página. El buque insignia actual de OpenAI, GPT-5.6 Sol, cuesta 4 $ por millón de tokens de entrada y 20 $ por millón de salida en su tarifa promocional, con hermanos más baratos (Luna a 0,20 $ / 1,20 $) para trabajos más ligeros. Una página densa quema muchos tokens, así que con millones de páginas la factura se acumula rápido.
Veredicto: recurre a GPT-5.5 cuando los documentos sean de alto valor y bajo volumen, o cuando los diseños sean demasiado variados para un analizador fijo. Para páginas predecibles y de alto volumen, la factura por token hace que un analizador dedicado como Parse sea la compra más inteligente.
4. Gemini 3.5 Flash
Ideal para: equipos que quieren precisión de análisis de nivel frontera sin el precio completo de un modelo de frontera.
Gemini 3.5 Flash es el modelo multimodal rápido y barato de Google, y es el punto óptimo entre los dos extremos de esta lista. Obtiene 81,8 en ParseBench, superando a Parse y a todos los analizadores nativos de la nube, y es mucho más barato por token que un buque insignia como GPT-5.5 u Opus 4.8.
Funciones. Igual que GPT-5.5, es un modelo general que lee imágenes de página y PDF y puede extraer datos estructurados bajo instrucciones. Flash está optimizado para velocidad y bajo coste, con una ventana de contexto amplia que permite pasarle documentos largos de una vez.
Ventajas. Una combinación poco común: mayor precisión que Parse y la flexibilidad de un LLM, a un precio que sigue siendo razonable a escala. Si ya estás en Google Cloud o usas Vertex AI, la integración es trivial.
Inconvenientes. Sigue siendo por token, así que es menos predecible que un analizador de tarifa plana por página, y con un volumen realmente enorme los 1,50 $ por 1.000 páginas de Parse todavía pueden ganar en coste total. Como con cualquier LLM, asumes un pequeño riesgo de alucinación que un modelo OCR específico no tiene.
Precios. Por token, con las tarifas bajas de Flash. El actual Gemini 3.7 Flash cuesta 0,75 $ por millón de tokens de entrada y 3,75 $ por millón de salida en su precio promocional, y hay un nivel realmente gratuito (con límite de uso) para prototipar. Es una fracción del coste por token de un modelo insignia.
Veredicto: mi recomendación por defecto para equipos que quieren más precisión que Parse pero se echan atrás ante los precios de un modelo insignia. Flash es la opción de mejor valor del grupo de modelos de frontera.
5. Databricks AI Parse
Ideal para: equipos de datos cuyos documentos ya viven en el lakehouse de Databricks.
Databricks AI Parse (ai_parse_document) es análisis de documentos integrado directamente en la plataforma Databricks, invocable como función SQL sobre datos que ya tienes en el lakehouse. Obtiene 72,4 en ParseBench. El argumento no es la máxima precisión, sino cero movimiento de datos.
Funciones. Llamas al análisis en línea dentro de un flujo de SQL o de notebook, y el texto extraído vuelve directamente a tus tablas Delta, listo para la gestión del conocimiento y el análisis posteriores. Sin servicio aparte y sin que los datos salgan de la plataforma.
Ventajas. Si tu pipeline ya está en Databricks, es el camino de menor resistencia: sin proveedor nuevo, sin egreso de datos y con la gobernanza gestionada por Unity Catalog. Para unificar el análisis de documentos con el resto de tu ingeniería de datos, nada es tan fluido.
Inconvenientes. Solo tiene sentido si eres una empresa Databricks; montar la plataforma solo para analizar documentos sería absurdo. Y con 72,4 queda por detrás de Parse y de los modelos de frontera en calidad general de análisis.
Precios. Se factura en DBU (Databricks Units) como parte de tu computación normal, en lugar de una tarifa pública por página. Consulta la página de precios de Databricks y la tarifa de tu workspace.
Veredicto: un sí fácil para equipos que ya usan Databricks y valoran mantener los datos en su sitio por encima de exprimir los últimos puntos de precisión. Irrelevante para todos los demás.
6. Azure AI Document Intelligence
Ideal para: equipos en Azure que necesitan extracción estructurada de formularios, facturas y documentos de identidad con modelos prediseñados.
Azure AI Document Intelligence (antes Form Recognizer) es el maduro servicio de procesamiento de documentos de Microsoft. Obtiene 69,3 en ParseBench, pero esa puntuación general infravalora su verdadera fortaleza: modelos prediseñados que extraen campos estructurados de tipos de documento concretos, facturas, recibos, formularios fiscales y documentos de identidad, sin que entrenes nada.
Funciones. Además del OCR de texto simple (el modelo Read), incluye extractores prediseñados para documentos de negocio comunes y un flujo de modelos personalizados para entrenar el tuyo con un puñado de muestras. Acepta PDF e imágenes directamente y devuelve JSON estructurado con puntuaciones de confianza por campo, algo que el endpoint en vivo de Parse no emite por ahora.
Ventajas. Para formularios estructurados, está un nivel por encima del análisis genérico: no solo lee la factura, te dice el total, el proveedor y la fecha de vencimiento como campos etiquetados con confianza. La profunda integración con Azure y el cumplimiento empresarial lo hacen fácil de vender en empresas Microsoft.
Inconvenientes. Se centra más en la extracción de campos de formulario que en Markdown limpio para RAG, así que para convertir documentos en texto en general se queda atrás frente a los analizadores más nuevos. Las puntuaciones de confianza y los modelos prediseñados añaden configuración que no necesitas si solo quieres texto.
Precios. Por 1.000 páginas, según el tipo de modelo: el modelo Read OCR cuesta 1,50 $ por 1.000 páginas (igual que Parse), mientras que los modelos prediseñados cuestan 10 $ y la extracción personalizada 30 $ por 1.000. Un nivel gratuito F0 cubre 500 páginas al mes.
Veredicto: la mejor opción cuando tu problema real es la extracción estructurada de formularios conocidos, no el análisis general, y ya estás en Azure. Para Markdown limpio con el que alimentar un índice de RAG, encaja mejor un analizador más nuevo.
7. AWS Textract
Ideal para: equipos nativos de AWS y stacks regulados que quieren OCR de documentos dentro de su nube actual.
AWS Textract es el veterano servicio de OCR y análisis de documentos de Amazon. Está al final de la tabla general de ParseBench con 53,3, y Cohere informa de una "mejora de más de 20 puntos" frente a él, así que nadie elige Textract por la calidad punta de su Markdown. Se elige porque ya está en tu cuenta de AWS.
Funciones. Textract detecta texto, tablas y pares clave-valor de formularios, además de API especializadas para gastos y documentos de identidad. Acepta PDF e imágenes, se integra de forma nativa con S3, Lambda y el resto de AWS, y hereda de serie las certificaciones de cumplimiento de AWS.
Ventajas. Para una empresa AWS, la historia de integración y gobernanza es insuperable: sin proveedor nuevo, sin egreso de datos, con IAM y registros de auditoría en los que ya confías. Está probado a escala empresarial y su extracción de tablas y formularios en documentos estándar limpios es fiable.
Inconvenientes. En el benchmark moderno queda muy por detrás del resto, sobre todo en formato semántico (un 2,8 ahí). Es un motor OCR de generación anterior, no un modelo de visión y lenguaje, así que con diseños desordenados o inusuales sufre donde las herramientas más nuevas se defienden.
Precios. Por 1.000 páginas, con precio separado por API: Detect Text básico cuesta 1,50 $ por 1.000 páginas, mientras que Analyze Document salta a 15 $ para tablas y 50 $ para formularios, así que extraer campos estructurados se encarece rápido. Las cuentas nuevas tienen un nivel gratuito de tres meses.
Veredicto: la elección segura, aburrida y correcta para equipos nativos de AWS que analizan documentos estándar y valoran quedarse en la nube por encima de las puntuaciones de benchmark. Si la calidad de análisis en diseños difíciles es tu cuello de botella, mira más arriba en esta lista.
8. Unstructured
Ideal para: equipos que necesitan ingerir una amplia variedad de tipos de archivo en un solo pipeline limpio, con opción de código abierto.
Unstructured es menos un modelo OCR único y más una capa de ingesta completa: toma más de 25 tipos de archivo (PDF, Word, PowerPoint, HTML, correo, imágenes) y los normaliza en JSON limpio y fragmentado, listo para generar embeddings. No está en ParseBench porque cumple un papel algo distinto, la fontanería que lleva todo a tu almacén vectorial, no solo los PDF.
Funciones. Conectores a docenas de fuentes, una enorme variedad de formatos de entrada, fragmentación consciente del diseño y una conocida biblioteca de código abierto junto a la API gestionada. Es una opción habitual en stacks de RAG hechos a mano precisamente porque maneja la larga cola de tipos de archivo que los analizadores de propósito único ignoran, lo que importa si tu gestión del conocimiento está repartida en una docena de aplicaciones.
Ventajas. Amplitud. Si tu conocimiento vive en PDF, exportaciones de Confluence, correos y presentaciones, Unstructured los maneja todos en un solo pipeline. El núcleo de código abierto permite empezar gratis y autoalojar.
Inconvenientes. Su calidad de OCR en bruto con documentos complejos no es la mejor de su clase, así que muchos equipos lo combinan con un analizador más potente para los PDF difíciles. Y ejecutar la versión de código abierto a escala es trabajo de ingeniería real, no una comodidad gestionada.
Precios. La biblioteca de código abierto es gratuita para autoalojar; la Unstructured Platform gestionada se factura por página. Consulta su web para ver los precios actuales de la API.
Veredicto: la mejor opción cuando tu problema es la variedad de formatos, no la precisión de análisis en bruto sobre un solo tipo. Muchos equipos usan Unstructured por la amplitud y un modelo como Parse o Gemini para los documentos complicados.
Una nota sobre los analizadores de pesos abiertos
Si lo que te mueve es el control de los datos, el rincón que más rápido avanza de este espacio son los modelos OCR de pesos abiertos que alojas tú mismo: cosas como dots.ocr, Chandra OCR 2 y DeepSeek-OCR 2 aparecen todos en ParseBench (Chandra OCR 2 obtiene un respetable 77,7). dots.ocr se distribuye con licencia MIT y se ejecuta en local mediante vLLM, así que el trato es claro: ninguna tarifa por página jamás y control total sobre dónde se procesan los documentos, a cambio de ser dueño de las GPU y de las operaciones. En un entorno aislado o muy regulado, ese trato suele valer la pena. Para todos los demás, una API gestionada da menos trabajo.
Lo que todas las herramientas de esta lista te dejan por construir
Esta es la parte que es fácil pasar por alto al comparar analizadores. Todas las opciones anteriores, Parse incluido, hacen un solo trabajo: convierten documentos en texto limpio. Ese texto no es una respuesta. Para usar de verdad tus documentos, aún tienes que fragmentar y generar embeddings del texto, almacenarlo, recuperar el pasaje correcto para una pregunta dada y generar encima una respuesta fundamentada.
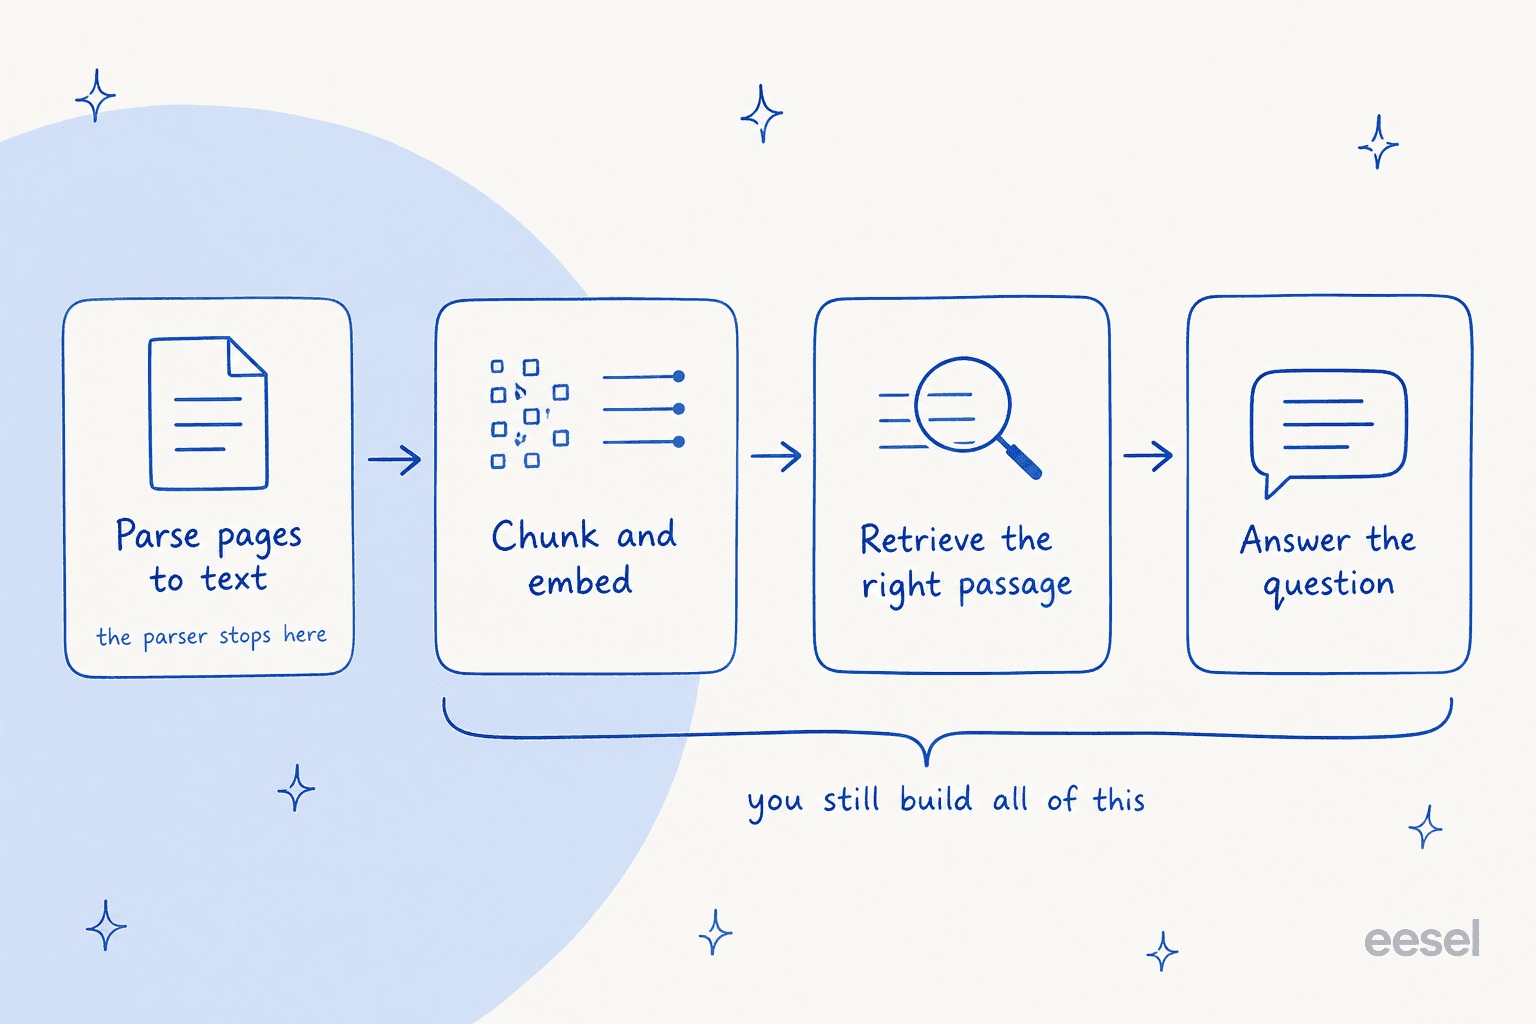
Si eres un equipo de datos que construye un producto a medida, conectar esas cuatro etapas es exactamente el trabajo que elegiste, y escoger el analizador adecuado de esta lista es una decisión real. Pero muchas de las personas que buscan "alternativas a Cohere Parse" no están construyendo un pipeline de análisis por sí mismo. Quieren el resultado: respuestas a preguntas de clientes o empleados, extraídas de sus propios documentos. Para ellas, elegir un modelo OCR es un medio para un fin que está tres pasos más adelante en la cadena.
Prueba eesel
Ese es el hueco que llena eesel. eesel es una plataforma de compañeros de equipo de IA: en lugar de un kit de herramientas que ensamblas, contratas a un compañero listo para trabajar en una tarea concreta. El agente de IA para helpdesk es el relevante aquí, y como agente de IA para atención al cliente ingiere tu centro de ayuda, tus documentos internos y tus tickets anteriores, se encarga del análisis, los embeddings y la recuperación por ti, y luego responde de verdad a las preguntas, en directo en tu helpdesk.

Así que el planteamiento honesto es este: si construyes un pipeline de documentos y necesitas un analizador como un componente, elige entre los ocho de arriba. Si tu objetivo real es responder preguntas a partir de tu conocimiento, no necesitas elegir un modelo OCR en absoluto, necesitas la capa que se sitúa encima. eesel es gratuito para probar, se conecta en minutos y puedes apuntarlo a tus documentos actuales y verlo responder antes de comprometerte con nada. (También hay un compañero de redacción de blogs con IA en el equipo, para un trabajo muy distinto.)