

Voxtral 3 es el mejor paquete de voz en relación calidad-precio que puedes comprar ahora mismo a un laboratorio europeo, y lo puntuaría con 3,5 sobre 5: excelente para la transcripción por lotes, prometedor pero todavía temprano como agente telefónico. Voxtral Small Transcribe 3 empata con Microsoft AI Transcribe 2 con una tasa de error de palabras del 4,0 % en la prueba de 45 idiomas de Mistral y cuesta $0.004 el minuto. La voz cuesta $13 por 1 M de caracteres y la API de agentes de voz todo en uno cuesta $0.04 el minuto.
Tres cosas lo frenan. Todos los modelos están en vista previa pública, esta vez los pesos son cerrados (Voxtral 1 y 2 eran abiertos) y las llamadas telefónicas por SIP son solo para empresas en el lanzamiento. El propio gráfico de Mistral también muestra a Gemini 3.5 Realtime por delante en transcripción en vivo en todos los ajustes de latencia.
Si gestionas soporte, la capa de voz es la mitad fácil. En eesel respondemos 27,000 tickets de Zendesk al mes en alemán para smava, y lo que hace que funcione es entrenar con tickets anteriores, no un mejor micrófono. Un modelo de voz le da oídos y voz a tu agente; aun así necesita conocer tu negocio.
¿Qué es Voxtral 3?
Voxtral 3 es la familia de voz de Mistral, lanzada el 20 de octubre de 2026. Reúne tres cosas que antes se compraban por separado: modelos de voz a texto, un modelo de texto a voz y un SDK de agentes de voz que los encadena con un modelo de chat en medio.
Me gano la vida construyendo integraciones y APIs, así que leo este lanzamiento como leería la documentación de cualquier proveedor: qué hace realmente cada ID de modelo, cuánto cuesta por unidad y qué se rompe al conectarlo. Esta es la gama:
| Modelo | Función | Precio | Notas |
|---|---|---|---|
| Voxtral Small Transcribe 3 | Transcripción por lotes, modelo estrella | $0.004/min | 50 idiomas, diarización, también traduce y responde preguntas sobre el audio |
| Voxtral Mini Transcribe 3 | Transcripción por lotes, económico | $0.0035/min | 4B parámetros, lo bastante pequeño para hardware limitado |
| Voxtral Mini Transcribe Realtime 3 | Transcripción en vivo | $0.008/min | Control de latencia de 80 ms a 2.400 ms, detección de fin de turno |
| Voxtral TTS 3 | Texto a voz | $13/1M chars | 35+ idiomas, 50+ dialectos, clonación de voz |
| API de agentes de voz (Mistral Small 4) | Flujo completo de llamada | $0.04/min | Voz de entrada, razonamiento, voz de salida |
| API de agentes de voz (modelo más grande) | Flujo completo de llamada | $0.08/min | Lo mismo, con un modelo de razonamiento mayor |
Los precios provienen de la publicación de lanzamiento y de la página de documentación de cada modelo, como la ficha de Voxtral Small Transcribe 3. Cada una de esas páginas etiqueta el modelo como Public Preview, lo cual importa más de lo que parece si planeas un despliegue en producción este trimestre.
¿Qué precisión tiene la transcripción de Voxtral 3?
Mucha, con audio grabado. Esta es la parte del lanzamiento en la que más confiaría, porque las cifras se sostienen incluso leyendo los gráficos de Mistral con más atención que su texto.
En el benchmark FLEURS de 45 idiomas, Voxtral Small Transcribe 3 obtiene una tasa de error de palabras del 4.0% cuando detecta el idioma por sí mismo. Así se alinean los siete modelos del gráfico de Mistral:
| Modelo | Tasa de error, idioma indicado | Tasa de error, idioma detectado |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.1% | 4.0% |
| Microsoft AI Transcribe 2 | 4.1% | 4.0% |
| Voxtral Mini Transcribe 3 | 4.6% | 4.5% |
| Gemini 3.5 Transcribe | 6.1% | 4.5% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 6.3% | 5.6% |
| Whisper large-v3 | 16.0% | 14.9% |
Fíjate en que la fila de arriba es un empate. El texto del lanzamiento dice que Small "supera a Whisper, Scribe v2 y Gemini 3.5 Transcribe", lo cual es cierto, y omite a Microsoft AI Transcribe 2, que lo iguala hasta el decimal. En el gráfico propio de Mistral del índice de error de palabras de Artificial Analysis, Voxtral Small Transcribe 3 aparece tercero, detrás de Fun-Realtime-ASR-preview y Microsoft AI Transcribe 2. Es un gran resultado. Solo que no es el barrido limpio que sugiere el titular.
El modelo Mini es el ganador discreto aquí. Con 4.5% iguala a Gemini 3.5 Transcribe en audio con idioma detectado, y la ficha del modelo Mini dice que es lo bastante pequeño para despliegues con recursos limitados. Si transcribes llamadas grabadas para el control de calidad, Mini a $0.0035 el minuto es con el que yo empezaría.
Quién dijo qué: diarización
La diarización (etiquetar qué hablante dijo cada línea) es donde Voxtral lidera su gráfico. En el benchmark combinado de diarización de Mistral, que mezcla grabaciones de reuniones y llamadas telefónicas, las tasas de error son:
- Voxtral Small Transcribe 3:
18.4% - Voxtral Mini Transcribe 3:
18.6% - Pyannote Orchestrator:
19.0% - Microsoft AI Transcribe 2:
20.3% - Scribe v2:
23.0% - Voxtral Mini Transcribe 2:
30.9% - Gemini 3.5 Transcribe:
38.4%
Ese salto de 30.9% en el antiguo Mini a 18.6% en el nuevo es la mayor mejora individual del lanzamiento. Para los equipos de soporte, la diarización es lo que convierte la grabación de una llamada en una transcripción utilizable: necesitas saber qué líneas eran del cliente y cuáles del agente antes de puntuar la llamada o extraer la queja. También importa si piensas redactar datos personales de las transcripciones, ya que las reglas de redacción a menudo difieren según el hablante.
Nombres de producto y jerga: sesgo de contexto
El sesgo de contexto te permite darle al modelo una lista de términos (nombres de producto, SKU, personas) para que los escriba bien. En la prueba de frases clave Earnings-22, Voxtral Small alcanza 94.6% de recall con contexto y 81.4% sin él. Scribe v2 obtiene 94.3% con contexto y 84.0% sin él.
Así que con una lista de términos los dos están a la par, y sin ella Scribe v2 en realidad recuerda más frases clave. La lectura práctica: si usas Voxtral, envía siempre una lista de términos. La guía de migración añade que ahora las entradas pueden ser frases de varias palabras, pero comparten la ventana de contexto con el audio, por lo que una lista larga puede provocar un error 400.
¿Es bueno Voxtral 3 para llamadas en vivo?
Bueno, no el mejor. Aquí mi veredicto se suaviza, y lo suaviza el propio gráfico de Mistral.
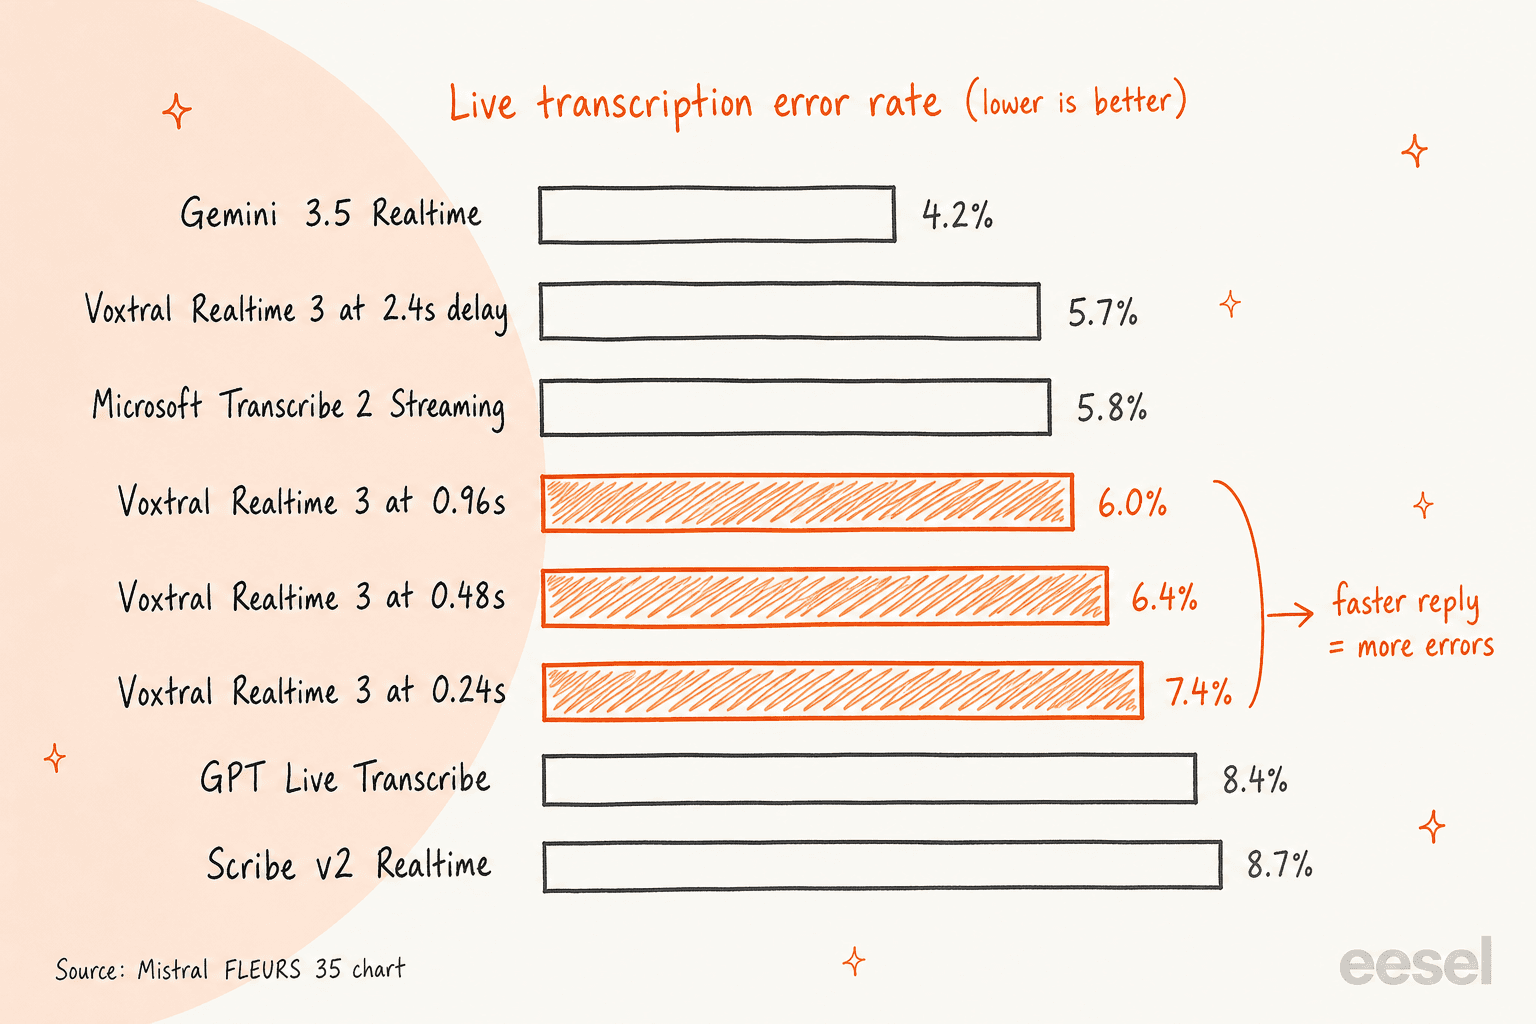
Voxtral Mini Transcribe Realtime 3 tiene un control de latencia: eliges cuánto espera antes de fijar las palabras, entre 80 ms y 2.400 ms. Esperar más significa más contexto y menos errores. En la prueba en tiempo real de 35 idiomas de Mistral:
| Ajuste | Tasa de error |
|---|---|
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Realtime 3 a 2.400 ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Realtime 3 a 960 ms | 6.0% |
| Voxtral Realtime 3 a 480 ms | 6.4% |
| Voxtral Realtime 3 a 240 ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
Destacan dos cosas. Primero, Gemini 3.5 Realtime supera todos los ajustes de Voxtral en el propio gráfico de Mistral. Segundo, el ajuste que usarías realmente para un agente telefónico ágil (alrededor de 240 a 480 ms) es donde Voxtral cede más precisión. Aun así supera a GPT Live Transcribe y a Scribe v2 Realtime en todos los ajustes, así que es una opción sólida. Solo que no la más precisa.
Una pequeña cosa que revisaría antes de construir sobre él: las páginas de Mistral no coinciden en cuántos idiomas cubre el modelo en tiempo real. La publicación de lanzamiento dice más de 35, la tarjeta de precios dice 40+ y el gráfico prueba 35. Prueba tus idiomas exactos en lugar de fiarte de la cifra mayor.
La buena noticia es la detección de fin de turno. El modelo en tiempo real predice cuándo ha terminado de hablar un cliente usando tanto el sonido como el significado de lo que dijo, y eso evita que un agente de voz hable por encima de alguien que hizo una pausa a mitad de frase. Quien haya aguantado a un bot que se mete cuando estás dictando el número de una tarjeta sabe por qué importa.
¿Qué tan natural suena la voz de Voxtral 3?
Lo bastante natural, y muy barata para lo que ofrece. Voxtral TTS 3 es la pieza que más mejoró en sensación, aunque no en una única cifra de titular.
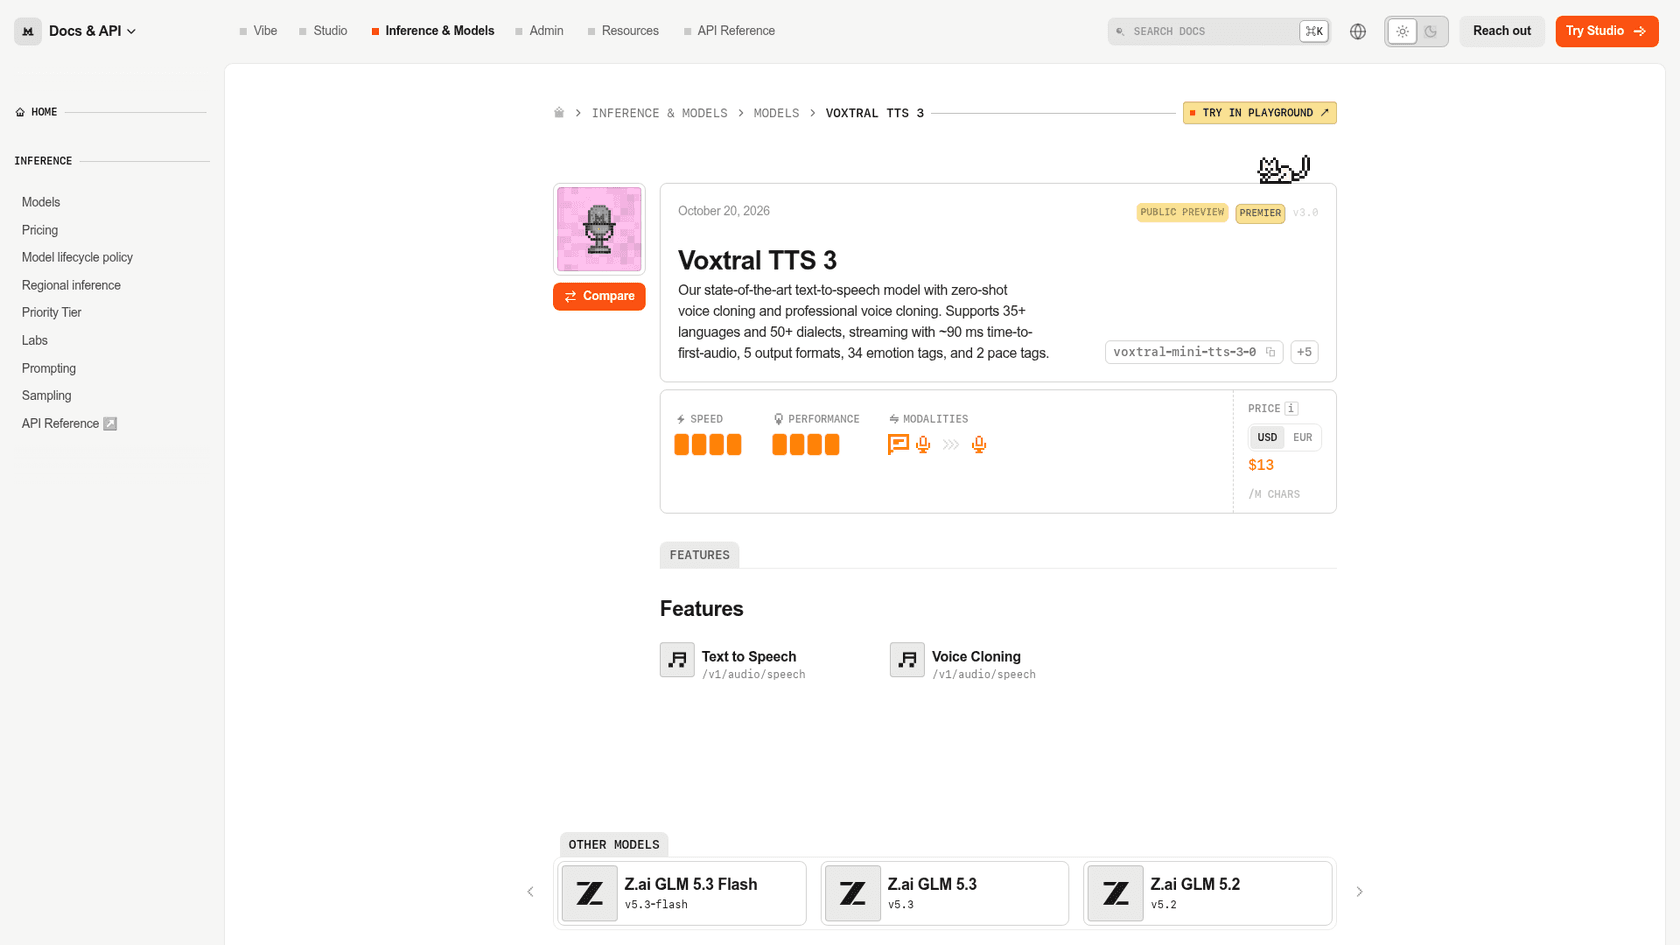
La hoja de especificaciones de la ficha del modelo:
- 35+ idiomas y 50+ dialectos, con voces predefinidas en 18 idiomas
- Unos
90 mshasta el primer audio en streaming - 34 etiquetas de emoción y 2 de ritmo que puedes insertar en línea, como
[emotion=...] - Clonación de voz zero-shot, más una opción "Pro Voice" entrenada con unos 30 minutos de audio
- 5 formatos de salida
Vale la pena escuchar los ejemplos de la página de lanzamiento, porque apuntan justo a donde fallan las voces de soporte. En uno, Voxtral 1 lee una hora de vuelo como "21,000pm on 10 over 10". Voxtral 3 la lee como "21pm on October 10th". Otro lee una dirección de correo a un cliente sin tropiezos. Esos son los momentos en que una voz barata te deja en evidencia en una línea de soporte.
En precio, Mistral afirma que 13 $ por 1 M de caracteres cuesta menos de operar que OpenAI TTS-1, Deepgram, ElevenLabs Flash y Gemini Flash, y sus gráficos de calidad por dólar (basados en el Voice Code Bench de BeSimple AI, que prueba números y nombres poco comunes en guiones de soporte) sitúan a Voxtral TTS en el extremo barato del mercado. Son gráficos hechos por el proveedor con un modelo Gemini como juez, así que tómalos como una lista corta, no como un veredicto. Si comparas en serio, ponlo junto a ElevenLabs, Cartesia Sonic 3 y Gemini 3.8 Flash TTS con tus propios guiones, o consulta la lista de alternativas a ElevenLabs.
Una nota de la guía de migración: las instrucciones de estilo, el control de texto libre de "dilo con calidez", figuran como no disponibles en el lanzamiento. Hoy tienes etiquetas de emoción y de ritmo.
¿Cómo funciona el SDK de agentes de voz de Voxtral 3?
El SDK es la parte más interesante del lanzamiento para quien construye un agente de voz para atención al cliente, y la más restringida.
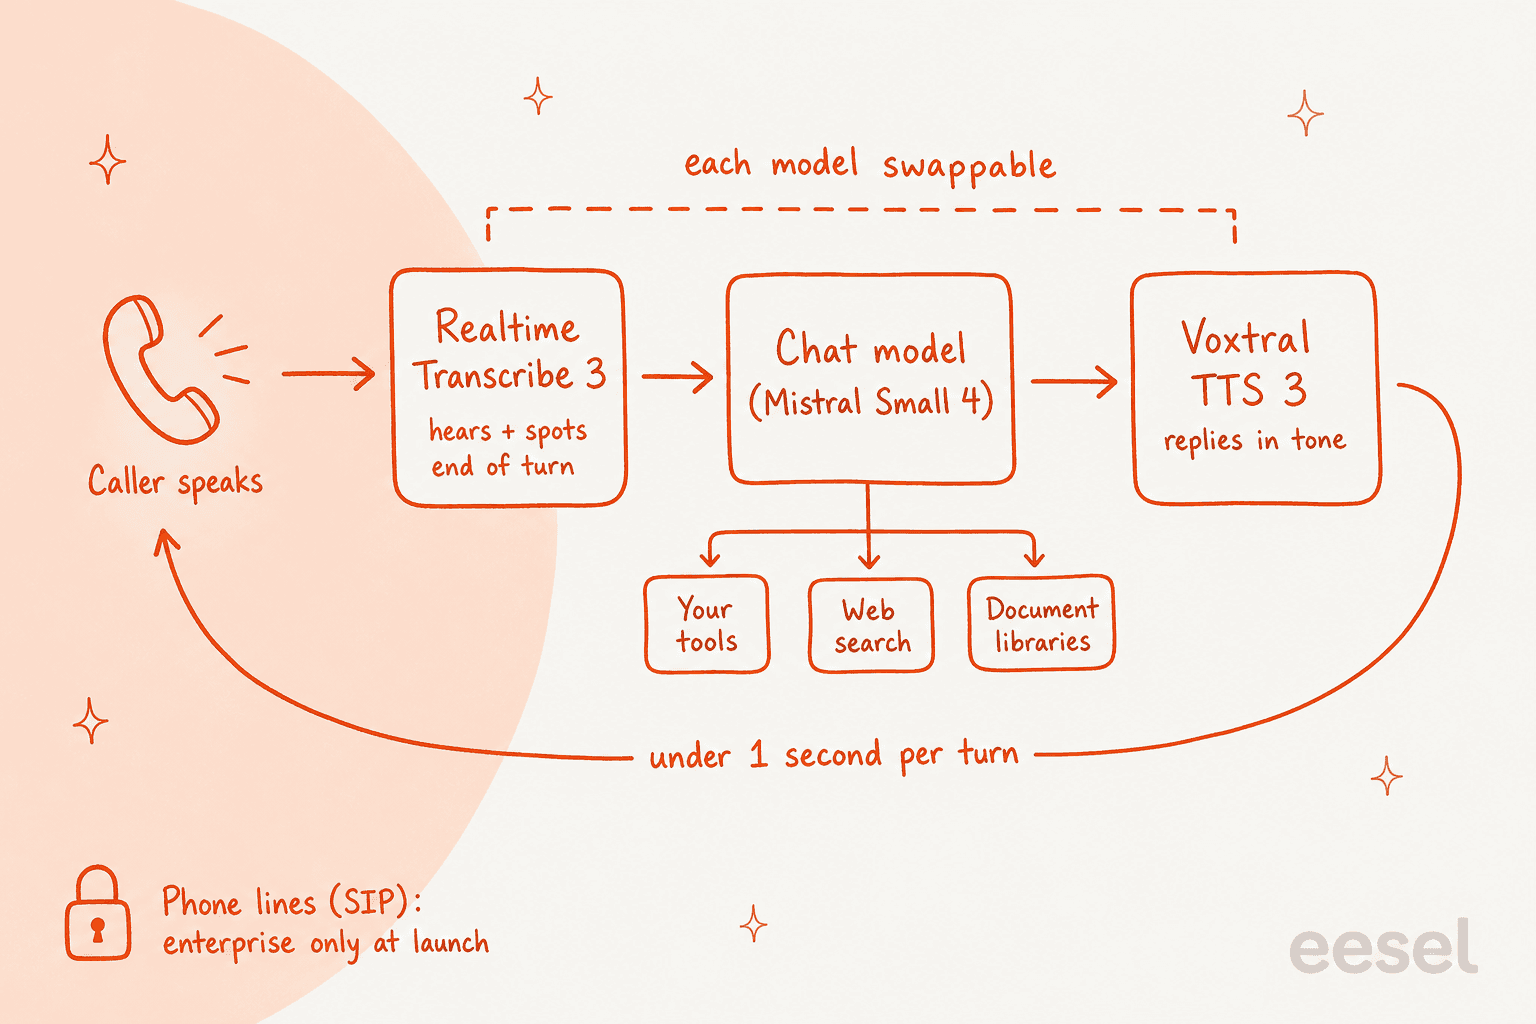
Según la documentación de agentes de voz, cada turno de una conversación pasa por tres etapas: el modelo en tiempo real transcribe y detecta el fin del turno, un modelo de chat como Mistral Small 4 redacta la respuesta y llama a herramientas, y Voxtral TTS la dice en voz alta. Mistral afirma que las etapas se transmiten una dentro de otra, de modo que cada turno se completa en menos de un segundo y el cliente puede interrumpir.
Lo que me gusta como desarrollador:
- Cada etapa es un modelo distinto. Puedes cambiar el modelo de razonamiento por uno mayor, o cambiar la voz o el idioma, sin reescribir el agente.
- Los agentes tienen versiones. Guardas la configuración de un agente, cada cambio crea una versión nueva y puedes fijar producción a una versión conocida mientras pruebas la siguiente. Es el diseño correcto para todo lo que hable con clientes.
- Los webhooks se disparan cuando una llamada empieza, termina o falla, así que puedes guardar cada transcripción en tu propio sistema de registro.
- Está construido sobre LiveKit para el transporte de audio, con bindings de Python y TypeScript, pero no necesitas conocer LiveKit para usarlo.
Lo que me da pausa:
- Las líneas telefónicas son solo para empresas en el lanzamiento. La documentación dice que la telefonía por SIP está "disponible para clientes empresariales en el lanzamiento, a través de tu equipo de cuenta". La voz en navegador y apps (por WebRTC) está abierta a todos. Para un equipo de soporte cuyos clientes llaman a un número de teléfono, esa es la línea decisiva.
- Las herramientas del lado del cliente fallan en llamadas telefónicas. La documentación explica que en una línea telefónica no se ejecuta código tuyo durante la llamada, así que todo lo que necesite un agente telefónico (consultar un pedido, revisar una factura) tiene que ser una herramienta del lado del servidor.
- Las herramientas son búsqueda web, bibliotecas de documentos, conectores de espacio de trabajo y tus propias funciones. No existe una noción integrada de tu helpdesk ni de tus tickets anteriores. En nuestras llamadas de ventas en eesel, la capacidad más solicitada es entrenar con tickets anteriores, porque ahí viven las respuestas reales de una empresa. Con Voxtral, eso es trabajo de integración que tendrías que hacer tú.
También está la cuestión de seguridad que planteó un comentarista de Hacker News en el hilo del lanzamiento, que alcanzó 770 puntos y 202 comentarios. Un agente de voz conectado a sistemas internos es un objetivo de inyección de prompts al que cualquiera con un teléfono puede llegar:
"I see companies hooking this up direct to the company intranet, and then users calling up and saying "Can you check this website for me?""

Eso no es tanto un defecto de Voxtral como la descripción del puesto de cualquier agente de voz que llame a herramientas. Pero es una buena razón para mantener a los agentes telefónicos con herramientas estrechas, del lado del servidor, y con límites claros sobre lo que pueden cambiar. Si estás definiendo qué debería y qué no debería poder hacer un agente de IA para call center, empieza por ahí.
¿Cuánto cuesta Voxtral 3 en la práctica?
Los precios por minuto son minúsculos hasta que añades el razonamiento. Esto cuestan 10.000 llamadas de cinco minutos (50.000 minutos) a los precios de lista de Mistral:
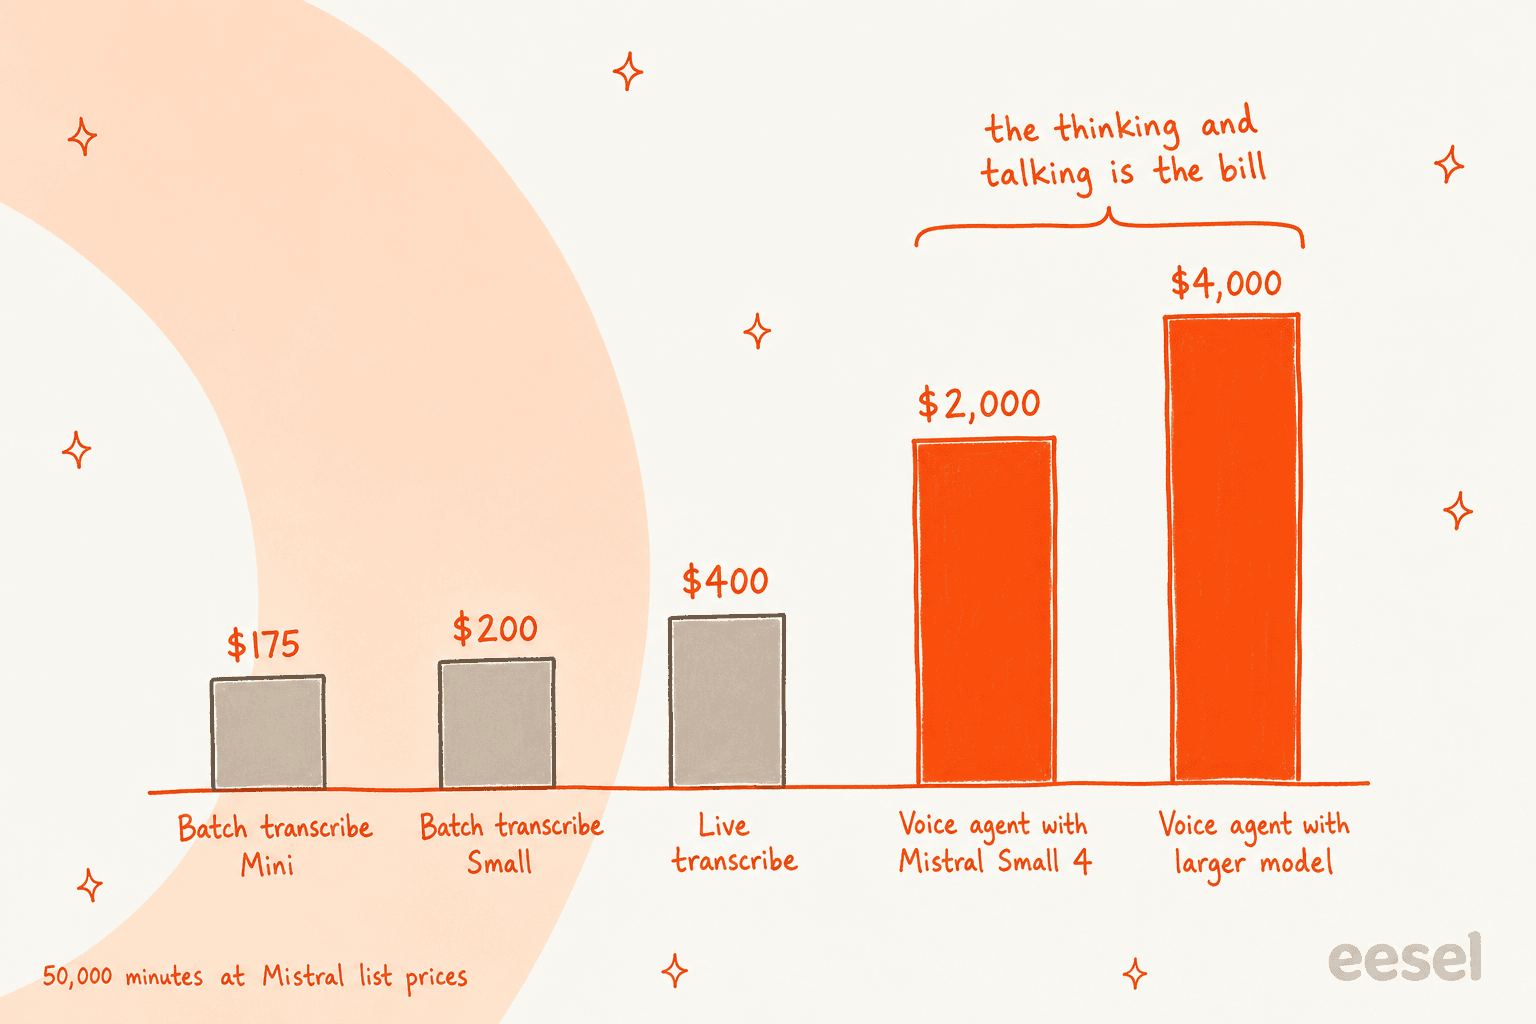
| Qué ejecutas | Tarifa | 50.000 minutos |
|---|---|---|
| Transcripción por lotes, Mini | $0.0035/min | $175 |
| Transcripción por lotes, Small | $0.004/min | $200 |
| Transcripción en vivo | $0.008/min | $400 |
| API de agentes de voz con Mistral Small 4 | $0.04/min | $2,000 |
| API de agentes de voz con un modelo más grande | $0.08/min | $4,000 |
El patrón es lo útil. Transcribir cada llamada que ya atiendes para control de calidad cuesta unos pocos cientos de dólares al mes. Que un agente de IA conteste esas llamadas cuesta de 10 a 20 veces más, porque el razonamiento y la voz son la factura. Una sola llamada de soporte de cinco minutos con la API de agentes cuesta $0.20 con Mistral Small 4. Ese es el número que debes poner en tu modelo de ROI del call center, no los $0.004.
La tarifa de agente de $0.04 también es competitiva a primera vista. Como referencia, mi análisis de Grok Voice de agosto cubría a un rival con precio de $0.08 el minuto. Consulta las tarifas más recientes en la página de cada proveedor antes de comprometerte, porque los precios de voz se han movido rápido este año. El desglose completo de los precios de Mistral AI cubre los modelos de chat que están detrás del agente.
¿Por qué los pesos de Voxtral 3 son cerrados?
Este es el cambio que provocó la reacción más fuerte, y es razonable. Los primeros modelos Voxtral (Mini 3B y Small 24B, julio de 2025) y el modelo Voxtral Mini 4B Realtime de enero de 2026 se lanzaron con pesos abiertos en Hugging Face. Solo ese modelo en tiempo real muestra más de 2 millones de descargas. Voxtral 3 no tiene pesos públicos.
El lanzamiento dice que Voxtral 3 está disponible "para autodespliegue en tu propia infraestructura", lo que confundió a los lectores hasta que un comentarista lo aclaró:
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
El comentario principal del hilo expresó la decepción con claridad:
"Closed model unfortunately, continues the theme of TTS / STT being really not great for local deployments."
Para ser justos con Mistral, no ha dejado del todo los lanzamientos abiertos, como muestra su serie de nuevos modelos. Los comentaristas señalaron Timestral la semana anterior y los pesos prometidos de Mistral Large 4. Y un profesional defendió el argumento comercial: los buenos modelos de voz con diarización escasean más que los buenos modelos de texto, y los compradores pagan un extra por ellos. Para un equipo de soporte empresarial, pesos cerrados más despliegue local por contrato es un camino de compra normal. Para un aficionado que construye un asistente doméstico, es un callejón sin salida.
¿Qué se rompe si estás en Voxtral 2?
Si ya llamas a Voxtral 2, lee la guía de migración antes de cambiar los IDs de modelo. Está bien escrita y es honesta sobre lo que se rompe.
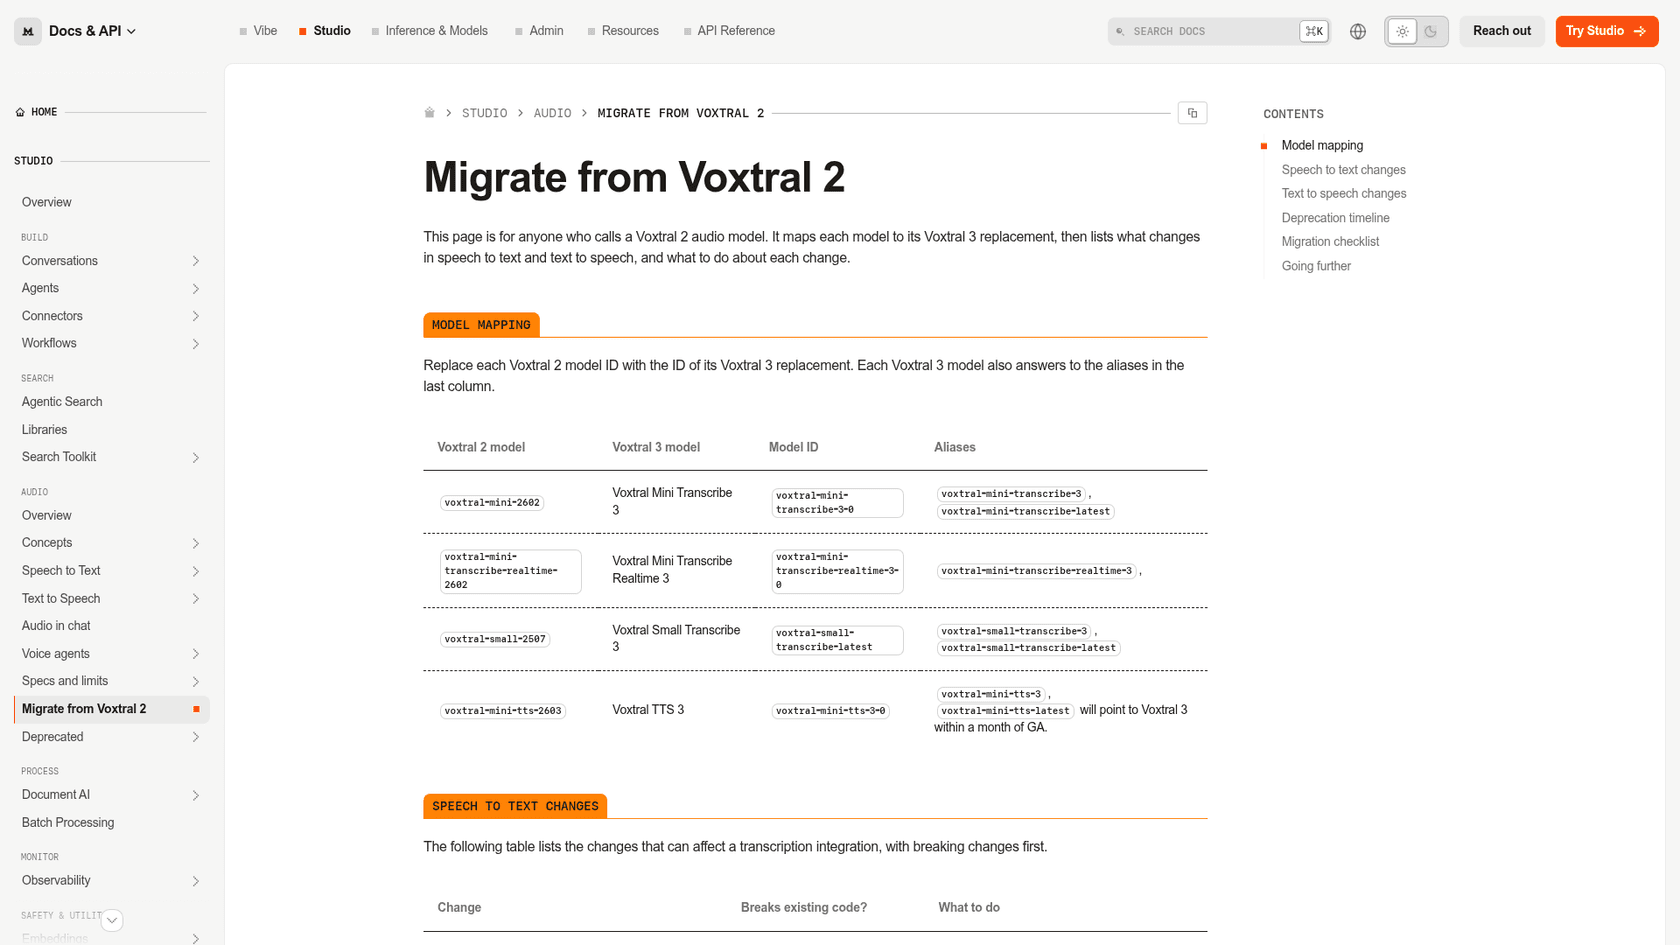
Los cambios incompatibles, en el orden en que los revisaría:
- Las marcas de tiempo por palabra desaparecen.
timestamp_granularitiessolo aceptasegment; pedirworddevuelve un error400. Si resaltas palabras mientras suena el audio, este duele. - Las sesiones en tiempo real bloquean su configuración cuando llega el primer fragmento de audio. Un
session.updateposterior devuelve un error, así que envía toda la configuración desde el principio. - Los segmentos con diarización ahora pueden solaparse cuando dos personas hablan a la vez. Si tu pantalla asume que nunca ocurre, necesitará una corrección.
El lado de TTS es más suave: las voces predefinidas antiguas como gb_jane_sad siguen funcionando, y la clonación con ref_audio también. El alias voxtral-mini-tts-latest pasará a Voxtral 3 en el plazo de un mes desde la disponibilidad general, así que fija IDs de modelo explícitos si no quieres sorpresas.
¿Quién debería usar Voxtral 3?
Donde aterrizo, por tipo de comprador:
| Si eres... | Veredicto |
|---|---|
| Transcribes llamadas grabadas para control de calidad o analítica | Sí. Precisión casi líder, la mejor diarización de su gráfico y $0.0035 a $0.004 el minuto. |
| Un equipo de la UE que necesita procesar audio en Europa | Sí. API alojada en la UE y despliegue local por contrato. Combínalo con una lectura de las normas de la Ley de IA de la UE para soporte. |
| Construyes un asistente de voz para navegador o dentro de una app | Probablemente. El SDK está bien diseñado y el precio del agente es bajo, pero es una vista previa. |
| Quieres poner una IA en tu línea telefónica de soporte este mes | Todavía no, salvo que seas cliente empresarial. SIP está restringido para el soporte telefónico con IA, y la integración con el helpdesk te toca construirla a ti. |
| Quieres pesos para ejecutar en local | No. Mira las alternativas a Mistral o los modelos Voxtral abiertos anteriores. |
En conjunto le daría a Voxtral 3 3,5 sobre 5. Los modelos de transcripción son un 4,5, la voz un 4 y el SDK de agentes un prometedor 3 frenado por el estado de vista previa y la restricción telefónica. Si Mistral abre SIP a todos y los modelos salen de la vista previa a estos precios, esa puntuación sube.
Si lo comparas con el mercado en general, mi resumen de la mejor IA para soporte por voz y la lista de empresas de voz con IA cubren las demás opciones. Y si aún estás decidiendo si vale la pena automatizar el soporte telefónico, la automatización del call center es el lugar para empezar.
Dónde encaja eesel junto a Voxtral 3
Voxtral 3 es infraestructura: muy buenos oídos y una voz barata y expresiva. eesel es el empleado. Nuestro compañero de helpdesk con IA se une al helpdesk que ya usas (Zendesk, Freshdesk, Gorgias y otros), aprende de tus tickets anteriores, tu centro de ayuda y tus macros, y se prueba con tu historial real de tickets antes de responder a un solo cliente.
Esa es la mitad del soporte que Voxtral te deja a ti. smava, un comparador alemán de préstamos, hace que eesel gestione 27,000 tickets de Zendesk al mes en alemán, categorizando 14,600 de ellos y redactando 15,300 respuestas a partir de 820 macros y artículos del centro de ayuda. Koffer.ch, una tienda suiza de maletas, lo usa para redactar respuestas de Freshdesk en alemán, francés, inglés o italiano, según el idioma en que escribió el cliente, con ortografía suiza. Eso es soporte multilingüe sin un paso de traducción. Ninguno necesitó un modelo de voz para llegar ahí, y ambos necesitarían exactamente ese conocimiento de tickets si algún día pusieran un agente al teléfono.
Si hoy tu cola es de correo y chat, ahí es donde yo automatizaría primero. Prueba eesel con tus propios tickets anteriores, gratis, y mira qué habría respondido.