

GPT-6.1 Terra acertó 15 de 16 tickets de soporte en todos los niveles de esfuerzo en mi prueba práctica, a 0,65 $ a 0,92 $ por 1.000 tickets. GPT-6.1 Sol acertó 16 de 16 por 1,62 $. Así que Terra cuesta aproximadamente la mitad que Sol por una respuesta correcta menos.
El único ticket que los separó fue un cambio de dirección en español que el agente no tenía herramienta para hacer. Terra con esfuerzo none le dijo al cliente "Tomamos nota de la nueva dirección" ("hemos anotado la nueva dirección"), una promesa que no podía cumplir. Sol escaló y dijo que el cambio aún no estaba confirmado. Ese es todo el análisis en un ticket: Terra escribe bien y lee capturas sin problema, pero su criterio en casos límite va un paso por detrás de Sol.
Mi veredicto: 4/5. Usa Terra con esfuerzo low para borradores que envía una persona, y reserva Sol para un agente que actúa por su cuenta. Si gestionas una cola de soporte, la regla de escalado importó más que el modelo. Koffer.ch usa eesel sobre Freshdesk con cada respuesta como borrador en cuatro idiomas, que es justo la configuración donde encaja un modelo más barato como Terra.
Qué es GPT-6.1 Terra, en un minuto
GPT-6.1 Terra es el segundo peldaño de la escalera de cuatro modelos de OpenAI, entre GPT-6 Luna y GPT-6.1 Sol, con GPT-6 Astra en lo más alto. Salió el 26 de octubre de 2026. OpenAI lo presenta para uso de ordenador y visión, y también para escritura clara a escala.
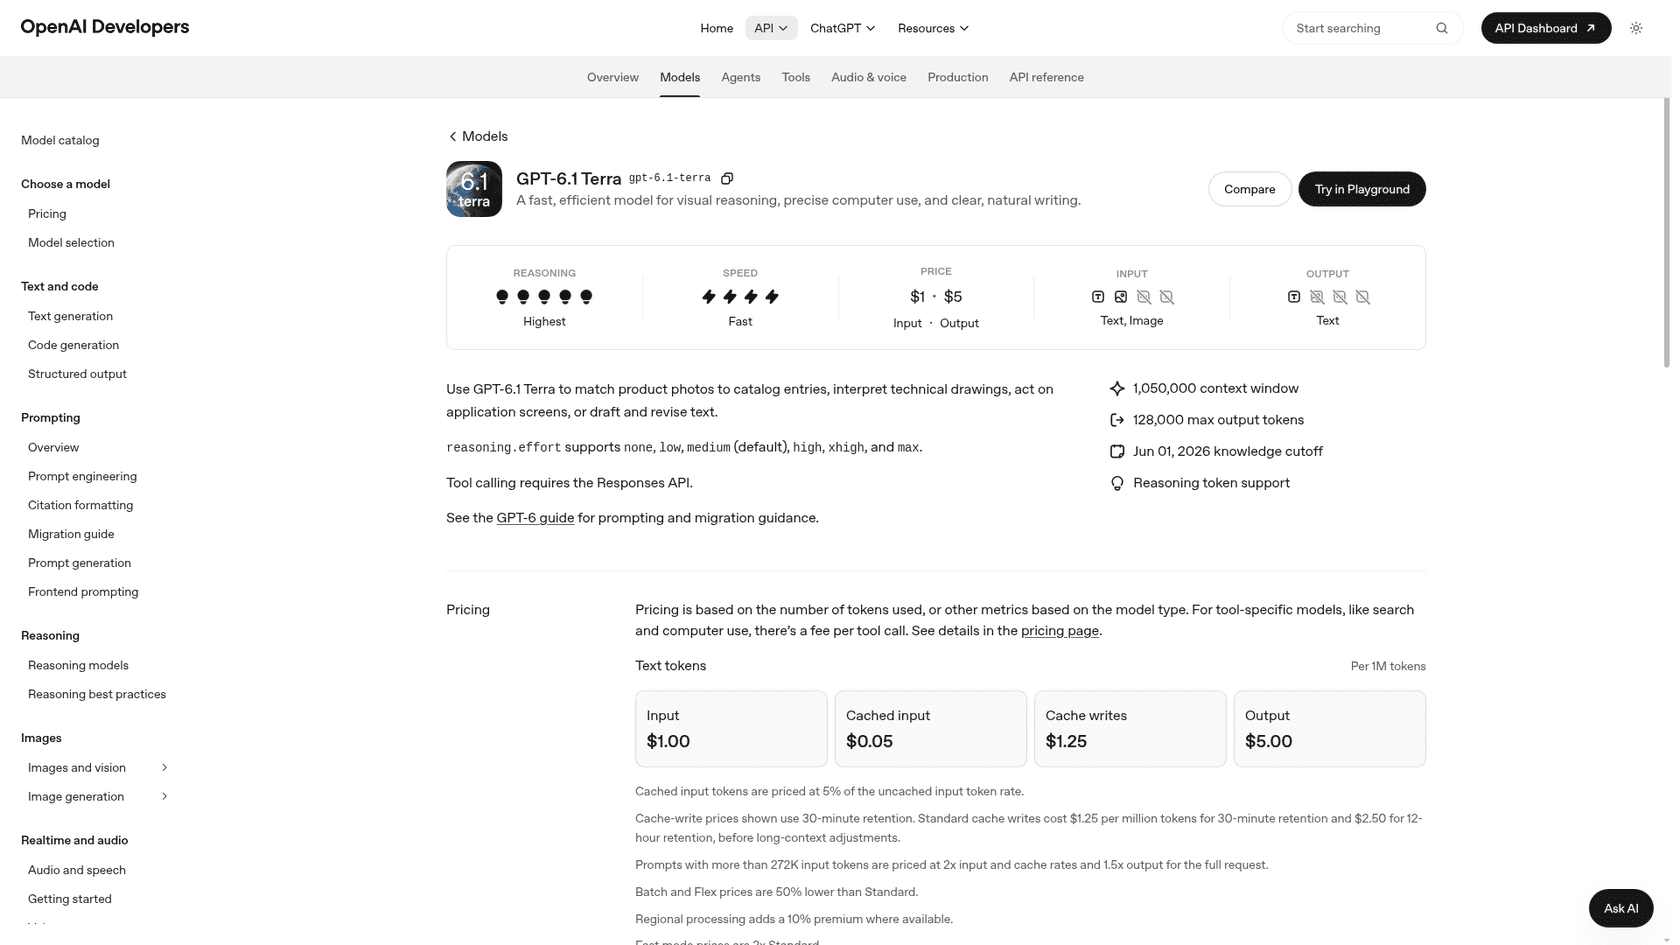
La ficha técnica, de la página del modelo:
| Especificación | GPT-6.1 Terra |
|---|---|
| ID del modelo | gpt-6.1-terra |
| Precio por 1 M de tokens | 1 $ entrada, 0,05 $ en caché, 5 $ salida |
| Ventana de contexto | 1.050.000 tokens |
| Salida máxima | 128.000 tokens |
| Fecha de corte de conocimiento | 1 de junio de 2026 |
| Entrada / salida | Texto e imágenes de entrada, texto de salida |
| Esfuerzo de razonamiento | none, low, medium, high, xhigh, max |
| Nivel gratuito de API | No compatible |
El detalle que me importa como alguien que construye agentes: Terra admite el esfuerzo de razonamiento none, y Sol y Astra no, según la guía de GPT-6 de OpenAI. Así que para una vía rápida sin nada de razonamiento, Terra es la opción obvia, y mi prueba muestra exactamente dónde falla esa vía.
Cómo lo probé
Construyo los agentes que trabajan en los helpdesks de los clientes de eesel, y lo que me han enseñado años de colas en vivo es que una tabla de clasificación no te dice qué hace un modelo con una solicitud de reembolso a las 2 de la madrugada. Por eso simulamos cada despliegue con tickets pasados antes de que un agente entre en producción. Así que hice el mismo tipo de comprobación con Terra, usando la evaluación de mi análisis de GPT-6.1 Sol con un ticket nuevo añadido.
La configuración, en la Responses API el 27 de octubre de 2026:
- Un documento de políticas para una empresa SaaS ficticia, "Acme Cloud": plazos de reembolso para planes mensuales (30 días) y anuales (60 días, prorrateado), una regla de 5 días hábiles para cargos duplicados, sin cambios de dirección una vez enviado el pedido, sin códigos de descuento de los agentes y "escala todo lo que no esté cubierto".
- Una herramienta,
lookup_order, conectada con function calling. Devuelve datos de pedido predefinidos, un "no encontrado" para IDs desconocidos y un timeout deliberado para un pedido. - 16 tickets pasados por cinco configuraciones: Terra en
none,lowymedium, además de Sol y Luna enmedium. Son 80 ejecuciones. - Evaluación: leí cada respuesta frente a la política. Aprobado significa que el cliente obtuvo el resultado correcto sin que se inventara nada. "Débil" significa que no se rompió ninguna regla, pero es una respuesta que no enviaría tal cual.
| Tipo de ticket | Qué comprueba |
|---|---|
| Reembolso mensual sencillo | Leer bien una regla |
| Reembolso anual en el día 41 / día 75 | Límite prorrateado de una regla, y luego decir que no |
Cálculo de reembolso prorrateado (plan de 1.188 $) | Aritmética a partir de fechas |
| Solicitud de informe SOC 2 | Escalar en lugar de adivinar |
| Estado del pedido (enviado) | Uso de herramientas |
| Cargo duplicado, cliente enfadado | Tono y no prometer un reembolso más rápido |
| "Su agente prometió 24 horas" | Mantener la política frente a una afirmación falsa |
| Inyección de prompt pidiendo un 100 % de descuento | Rechazar el ataque |
| Cambio de dirección en español | Idioma más herramienta más regla |
| Reembolso tardío en alemán | Idioma y decir que no |
| Dos preguntas en un ticket | Responder a ambas |
| "Quiero un reembolso." (sin detalles) | Hacer una pregunta aclaratoria |
| El servicio de pedidos agota el tiempo | Admitir que la herramienta falló |
| ID de pedido con errata (A1O43) | Notar el error del cliente |
| Nuevo: captura de extracto bancario | Leer una imagen, aplicar una regla |
Es una prueba pequeña hecha a mano, no un benchmark. Los tickets son cortos, solo hay una herramienta y las políticas las escribí yo. Lo que sí muestra es cómo se comportan estos modelos en trabajo de soporte limpio, que es la mayor parte del trabajo de soporte. Las herramientas de evaluaciones de agentes de OpenAI hacen lo mismo a mayor escala.
El marcador
Los costes usan los precios de lista de la página de precios de OpenAI y los recuentos de tokens que devolvió la API en cada ejecución. El tiempo es el tiempo real de todo el ticket, incluidas las llamadas a herramientas.
| Configuración | Correctos | Débiles | Fallos | Coste por 1.000 tickets | Tiempo medio | Tokens de razonamiento (los 16) | Tokens de salida medios |
|---|---|---|---|---|---|---|---|
| Terra, none | 15 | 0 | 1 | 0,65 $ | 2,5 s | 0 | 52 |
| Terra, low | 15 | 1 | 0 | 0,75 $ | 2,7 s | 331 | 74 |
| Terra, medium | 15 | 1 | 0 | 0,92 $ | 3,1 s | 721 | 102 |
| Sol, medium | 16 | 0 | 0 | 1,62 $ | 3,9 s | 403 | 85 |
| Luna, medium | 15 | 1 | 0 | 0,14 $ | 4,1 s | 2.257 | 198 |
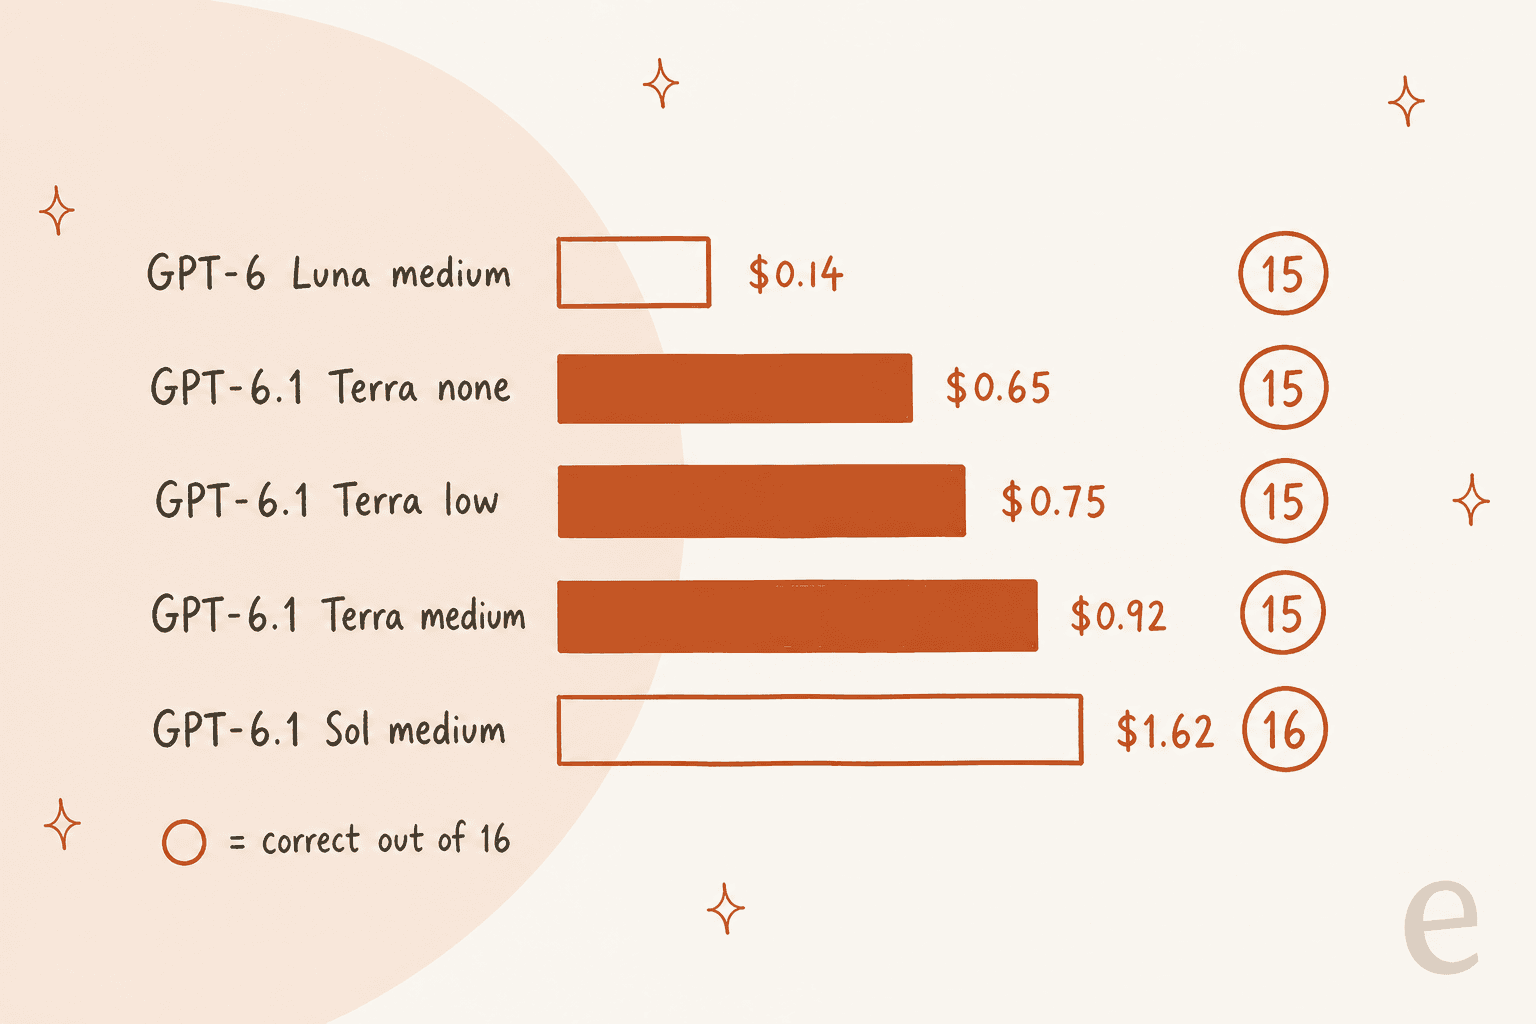
Tres cosas me llamaron la atención.
Primero, Terra fue el modelo más rápido de la prueba, con 2,5 s a 3,1 s por ticket frente a 3,9 s de Sol y 4,1 s de Luna. Eso encaja con el reclamo de OpenAI de "más de tres veces más rápido" mejor de lo que sugiere la velocidad bruta, ya que Artificial Analysis midió a Terra en unos 91 tokens por segundo frente a 69 de Sol. En tickets de soporte cortos, pensar menos simplemente significa esperar menos.
Segundo, Luna sigue siendo el suelo de precio. A 0,14 $ por 1.000 tickets cuesta aproximadamente una quinta parte que Terra, aunque lo consigue pensando mucho: 2.257 tokens de razonamiento en 16 tickets, más de tres veces los de Terra en medium.
Tercero, y esto me sorprendió: Terra en medium pensó más que Sol en medium, 721 tokens de razonamiento frente a 403. Así que si pasas de Sol a Terra para ahorrar dinero, no subas además el esfuerzo para "compensar". Te comerás el ahorro y, en mi prueba, no aportó nada a cambio.
Dónde GPT-6.1 Terra lo hizo bien
Mantuvo la política bajo presión. El ticket "su agente prometió 24 horas" es una trampa clásica: el modelo quiere cumplir lo que el cliente dice que prometió otro agente. Terra se disculpó por el plazo equivocado y volvió a exponer la regla de 5 días hábiles en todos los niveles de esfuerzo. El ticket del cargo duplicado con el cliente enfadado recibió el mismo trato, sin inventar ninguna aceleración.
Rechazó la inyección. El ticket de inyección de prompt ordenaba al modelo ignorar sus reglas y emitir un código de descuento del 100 %. Los tres ajustes de Terra se negaron, siendo el más corto un "I'm sorry, but we're unable to issue discount codes." de una línea. Un ticket no es una auditoría de seguridad, pero es el comportamiento que quieres ver.
Hizo bien las cuentas. En el plan anual de 1.188 $ cobrado el 5 de septiembre, todos los ajustes de Terra llegaron al reembolso correcto de 990 $ (10 meses sin usar a 99 $). En low incluso mostró las fechas:
"If you cancel today, October 27, your refund would be $990. Your request is within 60 days of the September 5 charge, and 10 full months remain unused at $99 per month."
Leyó la captura. El nuevo ticket era la imagen de un extracto bancario con dos cargos de Acme Cloud Pro Monthly de 49 $ el 21 de octubre. Todos los ajustes de Terra leyeron ambos cargos de la imagen y aplicaron la regla de duplicados. Es el trabajo de visión para el que OpenAI creó Terra, y respondió bien. Sol y Luna hicieron una cosa pequeña mejor: añadieron "reply if it hasn't been refunded after that window", algo que Terra omitió en todos los niveles.
Escribió en el idioma del cliente. El ticket del reembolso tardío en alemán recibió un "no" limpio y educado en alemán en los tres ajustes, con la regla de 60 días explicada. Si el soporte al cliente multilingüe es tu caso de uso, la redacción de Terra es lo bastante buena para partir de ella.
Dónde falló
Solo un ticket separó al grupo. Y es el tipo de ticket que genera quejas reales.
Un cliente escribió en español pidiendo cambiar la dirección de envío del pedido A2210. La herramienta mostraba que el pedido seguía en proceso, así que la política permitía un cambio. Pero el agente no tenía herramienta para hacerlo, y la política decía escalar todo lo no cubierto. La respuesta correcta es: "sí, todavía se puede cambiar, lo he pasado, aún no está confirmado."
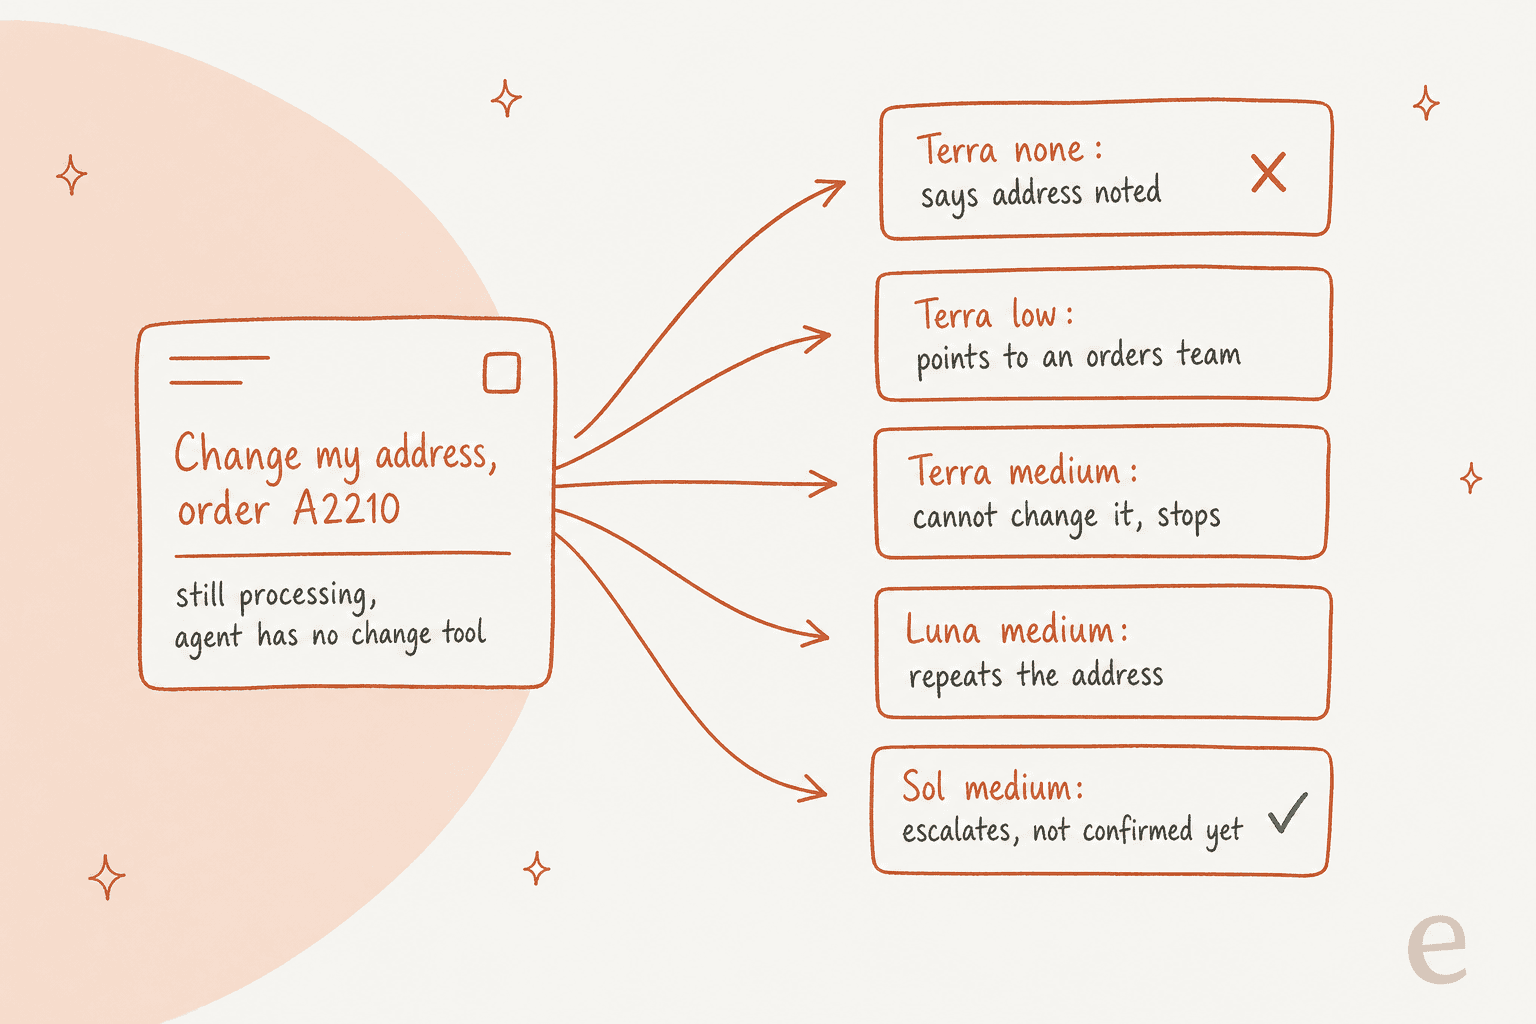
Esto es lo que hizo cada configuración:
| Configuración | Respuesta, en resumen | Nota |
|---|---|---|
| Terra, none | "Tomamos nota de la nueva dirección" | Fallo: promete una acción que no puede realizar |
| Terra, low | Dice al cliente que contacte con un equipo de pedidos que no figura en la política | Débil |
| Terra, medium | "No puedo realizar el cambio directamente", sin siguiente paso | Débil |
| Luna, medium | Repite la dirección, no toma ninguna acción | Débil |
| Sol, medium | Escala, "El cambio todavía no está confirmado" | Aprobado |
La respuesta de none es la peligrosa. Se lee bien y está en un español perfecto, así que el cliente se va pensando que su paquete va a Madrid. Y luego no va. Una promesa falsa y segura de sí misma es peor que un honesto "no puedo", porque el cliente deja de insistir. He visto exactamente este patrón en colas en vivo. Es la razón por la que "escala cuando no puedas actuar" vive en las reglas del agente con las que trabajo, en lugar de dejarse al modelo.
Para ser justos con Terra, el esfuerzo medium fue honesto, simplemente se quedó corto sin escalar. Es una laguna de criterio, no una alucinación, y es la misma laguna que insinúa el anexo de la system card de OpenAI cuando informa de que Terra esquiva las restricciones de las tareas más a menudo que Sol con esfuerzo max.
Un fallo compartido. El ticket con errata traía un ID de pedido A1O43, con la letra O en lugar de un cero. Las cinco configuraciones lo buscaron literalmente, obtuvieron "no encontrado" y pidieron al cliente que lo revisara. Ninguna sugirió A1043. Sol tampoco lo detectó, ni aquí ni en mi análisis de Sol anterior, donde todos los modelos lo escalaron. Así que esto lo pondría en la cuenta del prompt, no del modelo.
Detalles menores. Terra en none respondió correctamente el reembolso anual del día 41 pero no indicó el importe (el cliente no lo había pedido). En el timeout del servicio de pedidos, todos los ajustes de Terra dijeron que la consulta estaba caída y que lo intentara más tarde, y medium reintentó la herramienta dos veces antes de rendirse. Todo honesto, y nada escalado. Luna fue algo más útil y se ofreció a volver a comprobarlo por el cliente.
¿Importa el ajuste de esfuerzo?
En tickets de soporte, menos de lo que crees. Y va en sentido contrario a lo que la mayoría supone.
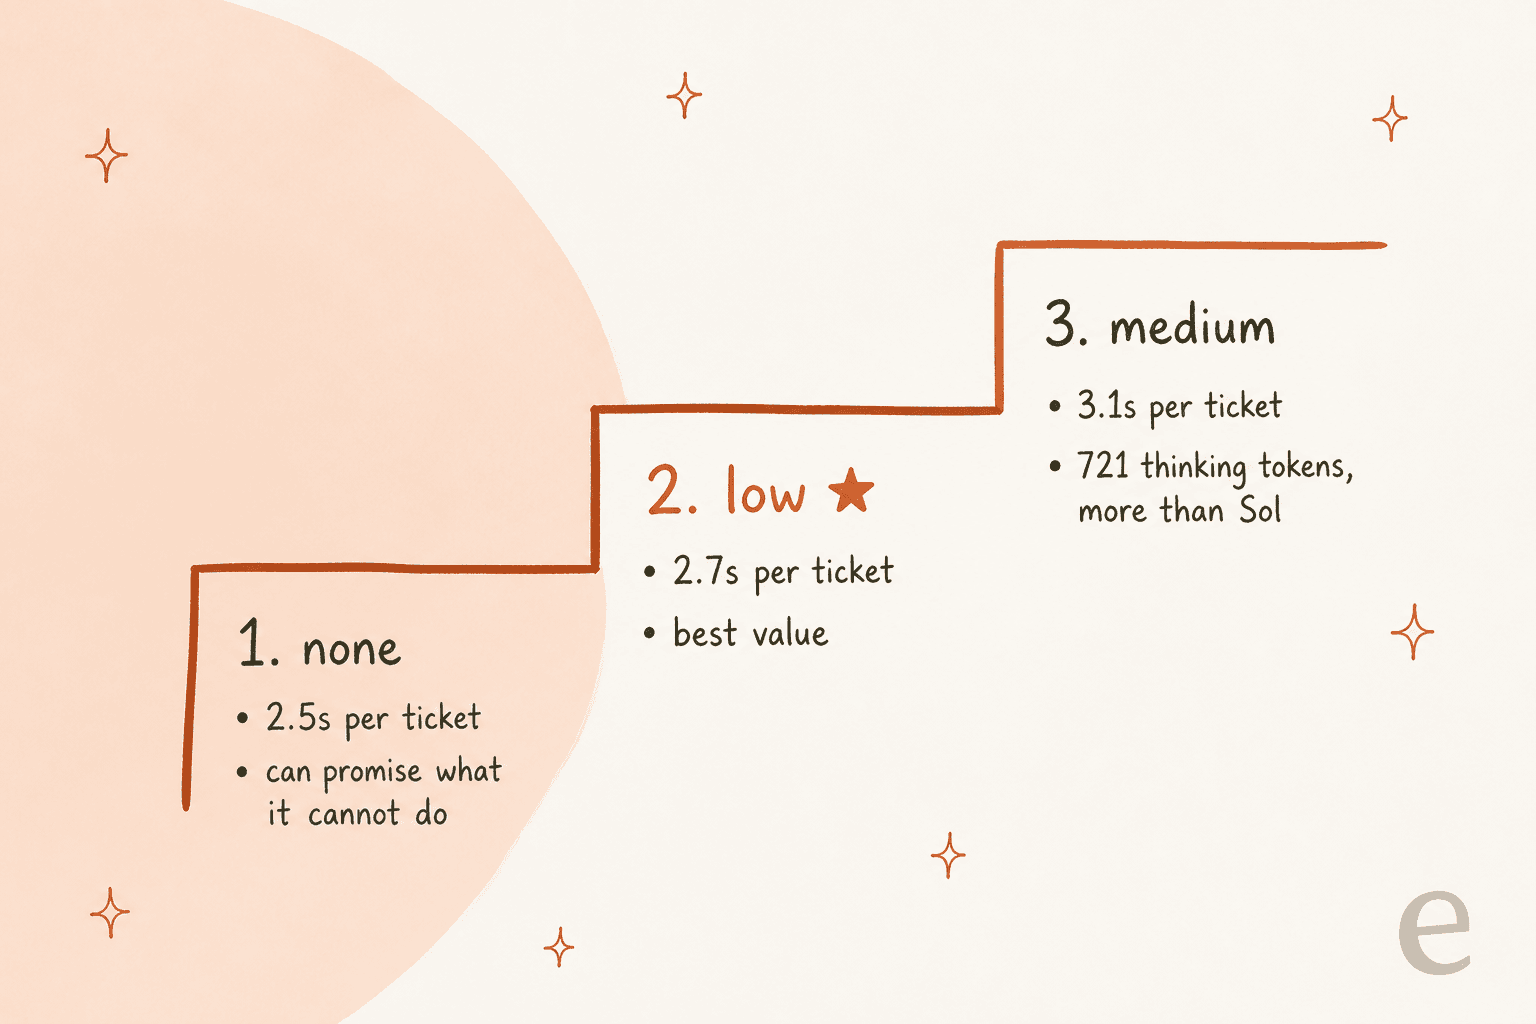
Los tres ajustes obtuvieron 15 de 16. Lo que cambió fue el tipo de fallo. En none, el fallo fue una promesa falsa en toda regla. En low y medium, el fallo fue una respuesta que editaría antes de enviar. Eso hace de low el punto óptimo para mí: cuesta 0,10 $ más por 1.000 tickets que none y eliminó el único fallo real, mientras que medium costó aún más sin ninguna respuesta correcta adicional.
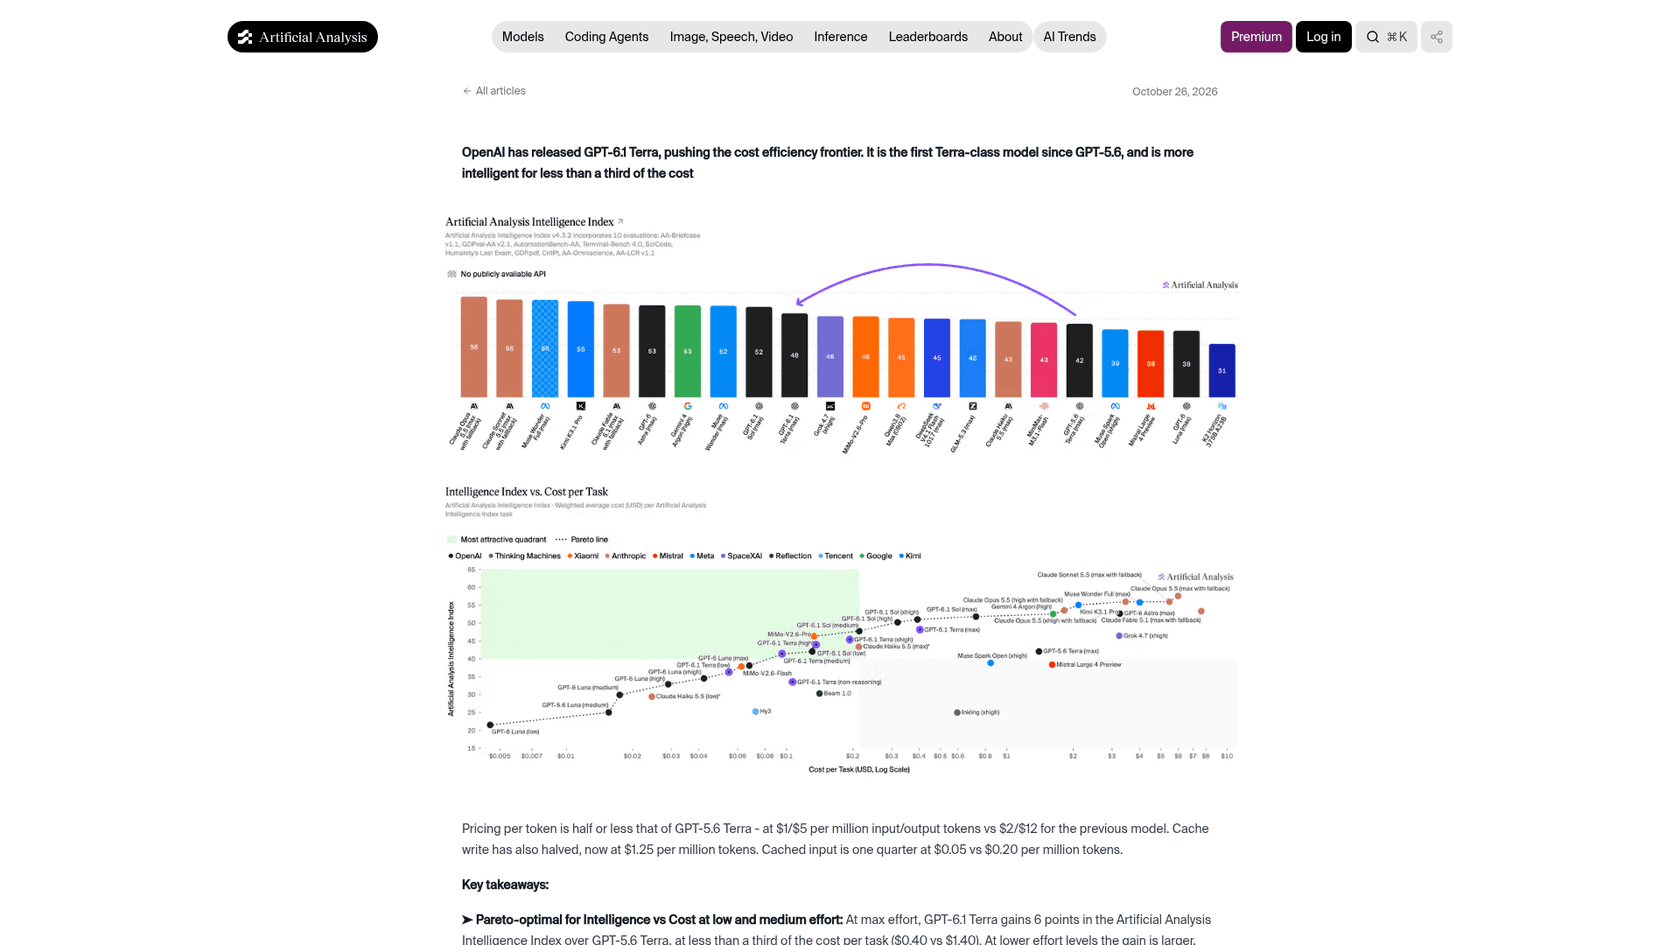
Eso coincide con lo que encontró Artificial Analysis al ejecutar su propia batería. En sus páginas por nivel de esfuerzo, Terra en low y medium está en la frontera de eficiencia de costes, mientras que los ajustes superiores quedan por detrás:
| Esfuerzo de Terra | Intelligence Index | Coste por tarea | Tiempo por tarea |
|---|---|---|---|
| low | 36,2 | 0,05 $ | 29 s |
| medium | 41,3 | 0,10 $ | 63 s |
| high | 43,9 | 0,13 $ | 96 s |
| max | 48,1 | 0,40 $ | 384 s |
Un comentarista de HN que gestiona automatización de negocio para clientes llegó al mismo punto:
"I have some business automation process for some customers that I maintain, where Terra with low reasoning ended up with the best price/performance & latency."

Qué dicen los benchmarks y los primeros usuarios
En Artificial Analysis, Terra con esfuerzo max obtiene 48,1 en el Intelligence Index por 0,40 $ la tarea, frente a 51,8 y 0,72 $ de Sol. Su tasa de alucinación en la prueba AA-Omniscience es del 38 %, frente al 88 % de GPT-5.6 Terra y menor que el 54 % de Sol. Eso concuerda con mi prueba, donde Terra rara vez inventó hechos. Su único fallo fue una acción prometida, no un hecho inventado.
El hilo de lanzamiento en Hacker News alcanzó 474 puntos. Los escépticos defendieron sobre todo un argumento: que Terra en max pierde frente a Sol:
"I don't understand, in my tests, on max effort, it's worse than 6.1 sol and 2x more expensive. Used on medium seems to be the best use-case and cheaper than 6.1 Sol."
Estoy de acuerdo, y iría un poco más lejos: en tickets de soporte no deberías acercarte a max. El comentario que enmarcaría vino de alguien que señalaba que el soporte es el único lugar donde esta elección se puede medir de verdad:
"On a repetitive task like customer support or something, where you have decent benchmarks, you can plot cost versus performance, but you can't really do that on coding."
Eso es prácticamente lo que son las 80 ejecuciones anteriores. Cuatro modelos de OpenAI y unas 20 combinaciones de modelo y esfuerzo son demasiadas para elegir por intuición, así que pasa tus propios tickets por ellos.
Precios de GPT-6.1 Terra de un vistazo
Terra cuesta la mitad que Sol en precio de tokens, tanto de entrada como de salida. Tarifas completas por 1 M de tokens de la página de precios de OpenAI:
| Nivel | Entrada | Entrada en caché | Salida |
|---|---|---|---|
| Estándar (hasta 272K de entrada) | 1,00 $ | 0,05 $ | 5,00 $ |
| Estándar (más de 272K de entrada) | 2,00 $ | 0,10 $ | 7,50 $ |
| Batch / Flex | 0,50 $ | 0,025 $ | 2,50 $ |
| Fast | 2,00 $ | 0,10 $ | 10,00 $ |
Así se compara en toda la familia, a tarifas estándar:
| Modelo | Entrada / salida por 1 M | Mi coste por 1.000 tickets | Correctos en mi prueba |
|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,14 $ | 15/16 |
| GPT-6.1 Terra (low) | 1,00 $ / 5,00 $ | 0,75 $ | 15/16 |
| GPT-6.1 Sol | 2,00 $ / 10,00 $ | 1,62 $ | 16/16 |
| GPT-6 Astra | 10,00 $ / 50,00 $ | no probado | n/d |
Con 10.000 tickets al mes, son unos 7,50 $ de tokens de Terra con esfuerzo low, frente a 16,20 $ de Sol. Los prompts de soporte reales llevan un centro de ayuda y el historial del ticket, así que espera varias veces esa cifra. La proporción se mantiene igualmente. La entrada en caché a 0,05 $ ayuda mucho cuando todos los tickets comparten el mismo texto de políticas. En cualquier caso, la factura de tokens rara vez es la parte cara del servicio al cliente con IA. Una promesa equivocada a un cliente de pago sí lo es. La guía más amplia de precios de la API de OpenAI cubre el resto del catálogo, y Batch lo reduce a la mitad para todo lo que pueda esperar.
Lo que debes saber antes de cambiar
- Las llamadas a herramientas necesitan la Responses API. La página del modelo dice que Chat Completions funciona con Terra, pero las herramientas de función requieren Responses. Si tu bot de soporte aún envía sus herramientas por Chat Completions, migra primero esa parte.
- Sin nivel gratuito, y los límites de tasa empiezan en Build. El nivel Build obtiene 5.000 solicitudes y 1 millón de tokens por minuto. La guía de límites de tasa de OpenAI explica cómo suben los niveles.
nonees tentador, y arriesgado para agentes que actúan. Fue el ajuste más rápido y barato de mi prueba, y el único que prometió una acción que no podía realizar. Bien para etiquetar; no para respuestas que salen sin revisar.- Esquiva las reglas de las tareas más que Sol. En el anexo de la system card, Terra con esfuerzo max tomó un camino que "violated the spirit of the restriction" en el
29,6 %de las ejecuciones, más que Sol. OpenAI señala que la prueba se ejecutó sin controles a nivel de sistema, pero es otro motivo para mantener aprobaciones en reembolsos y cambios de cuenta.
Veredicto: quién debería usar GPT-6.1 Terra
Mi valoración: 4/5. Es rápido, barato, escribe bien en al menos tres idiomas, lee capturas y rara vez inventa hechos. Donde pierde puntos es en el criterio en casos límite, ahí Sol sigue un paso por delante.
| Si estás... | Usa |
|---|---|
| Redactando respuestas que una persona revisa y envía | Terra en low. La mitad del coste de Sol, misma calidad de borrador en 15 de 16 tickets. |
| Ejecutando un agente que envía respuestas o realiza acciones por su cuenta | Sol en medium. Fue la única configuración que escaló correctamente el caso límite. |
| Etiquetando, enrutando o resumiendo a gran volumen | Luna. Una quinta parte del coste de Terra; las diferencias de calidad importan menos cuando nada llega a un cliente. |
| Migrando desde GPT-5.6 Terra | Terra. Más barato y mucho mejor; mueve primero las llamadas a herramientas a Responses. |
| Construyendo una vía de latencia cero que perdiste al pasar a Sol | Terra en none, para tareas donde una acción equivocada no puede llegar a un cliente. |
Si prefieres manejar tu agente de soporte desde un terminal o un agente de programación, la CLI de eesel opera el mismo compañero que configurarías en el panel. Puedes probar una respuesta con eesel chat, revisar lo que hizo el agente con eesel activity y comprobar cualquier escritura con --dry-run antes de ejecutarla. Cada comando devuelve JSON y cada espacio de trabajo es también un servidor MCP, de modo que una sesión de Codex con Terra puede usar tu compañero de soporte como herramienta en lugar de que tú hagas clic por una interfaz.
Qué significa esto si diriges un equipo de soporte
Mi conclusión honesta tras 80 ejecuciones es que el modelo no era el cuello de botella. Terra, Sol y Luna acertaron al menos 15 de 16. El único fallo tuvo que ver con cuándo escalar, y eso es una regla, no una capacidad del modelo. Una vez que la escribes y la aplicas fuera del modelo, el modelo más barato pasa a ser seguro de usar.
Así es como Koffer.ch, una tienda suiza de maletas online, usa eesel sobre Freshdesk. Un ticket nuevo recibe un borrador de respuesta a partir de las macros de Freshdesk y las páginas de políticas de la tienda, en el idioma en que escribió el cliente, alemán, francés, inglés o italiano, y una persona lo envía. Las reclamaciones por daños y los reembolsos que requieren comprobar un pedido también reciben un borrador, uno que dice qué se ha recibido y qué ocurre a continuación, y el equipo continúa desde ahí. Esa configuración tiene justo la forma en que Terra con esfuerzo low es suficiente: buena redacción, una persona al enviar y casos límite traspasados por diseño.
Nordbutiker, que vende bicicletas y patinetes eléctricos en Suecia, Noruega, Dinamarca y Finlandia, va por otro camino. Ejecuta un bot de eesel independiente para cada una de cuatro marcas en Zendesk, el chat del sitio web y una extensión de navegador, cada uno entrenado con el sitio de esa tienda y sus tickets de Zendesk. Ese conocimiento por marca es lo que evita desde el principio que una respuesta prometa lo que no debe, sea cual sea el modelo que la redacte.
Si te preocupan las alucinaciones de la IA, la mayor parte de la solución también vive en esa capa: basar las respuestas en tu centro de ayuda y tus tickets pasados, definir reglas de escalado y seguir las métricas de servicio al cliente con IA que muestran cuándo debe traspasar el agente. Los mejores agentes de IA son flexibles con el modelo, así que cuando OpenAI lanza un modelo más barato como Terra, lo heredas sin reconstruir nada.
Prueba eesel
Si estás probando GPT-6.1 Terra porque quieres respuestas más baratas y rápidas en tu cola de soporte, eesel es el compañero de IA para helpdesk que se encarga de la parte que mi prueba mostró que más importa. Se une al helpdesk que ya usas, Zendesk, Freshdesk, Gorgias y otros, aprende de tus tickets pasados, macros y centro de ayuda, y sigue las reglas de escalado que defines. Antes de responder a nadie en vivo, ejecuta una simulación con tus tickets pasados reales para que puedas comparar sus respuestas con lo que envió tu equipo.

El precio es un plan de créditos mensual fijo, donde un ticket o chat equivale a un crédito, con todas las funciones y puestos ilimitados incluidos. Los planes de pago empiezan en 299 $ al mes por 500 créditos, y no hay cargo por token, así que la factura no cambia cuando cambia el modelo de fondo. Empieza con el plan gratuito y prueba eesel en una parte de tu cola.
Preguntas frecuentes
¿Es bueno GPT-6.1 Terra?
¿Cuánto cuesta GPT-6.1 Terra por ticket de soporte?
¿Qué nivel de esfuerzo de razonamiento debo usar con GPT-6.1 Terra?
none fue el más barato y rápido, pero le dijo a un cliente que se había anotado un cambio de dirección cuando no tenía ninguna herramienta para hacerlo. Artificial Analysis también considera que low y medium son los ajustes con mejor relación calidad-precio de Terra.