

Jalapeño es el primer chip de IA propio de OpenAI, un ASIC de inferencia diseñado junto con Broadcom y anunciado el 24 de junio de 2026. Está hecho para un solo trabajo: ejecutar modelos de lenguaje grandes como ChatGPT y Codex de la forma más rápida y barata posible. No entrena modelos y no se puede comprar.
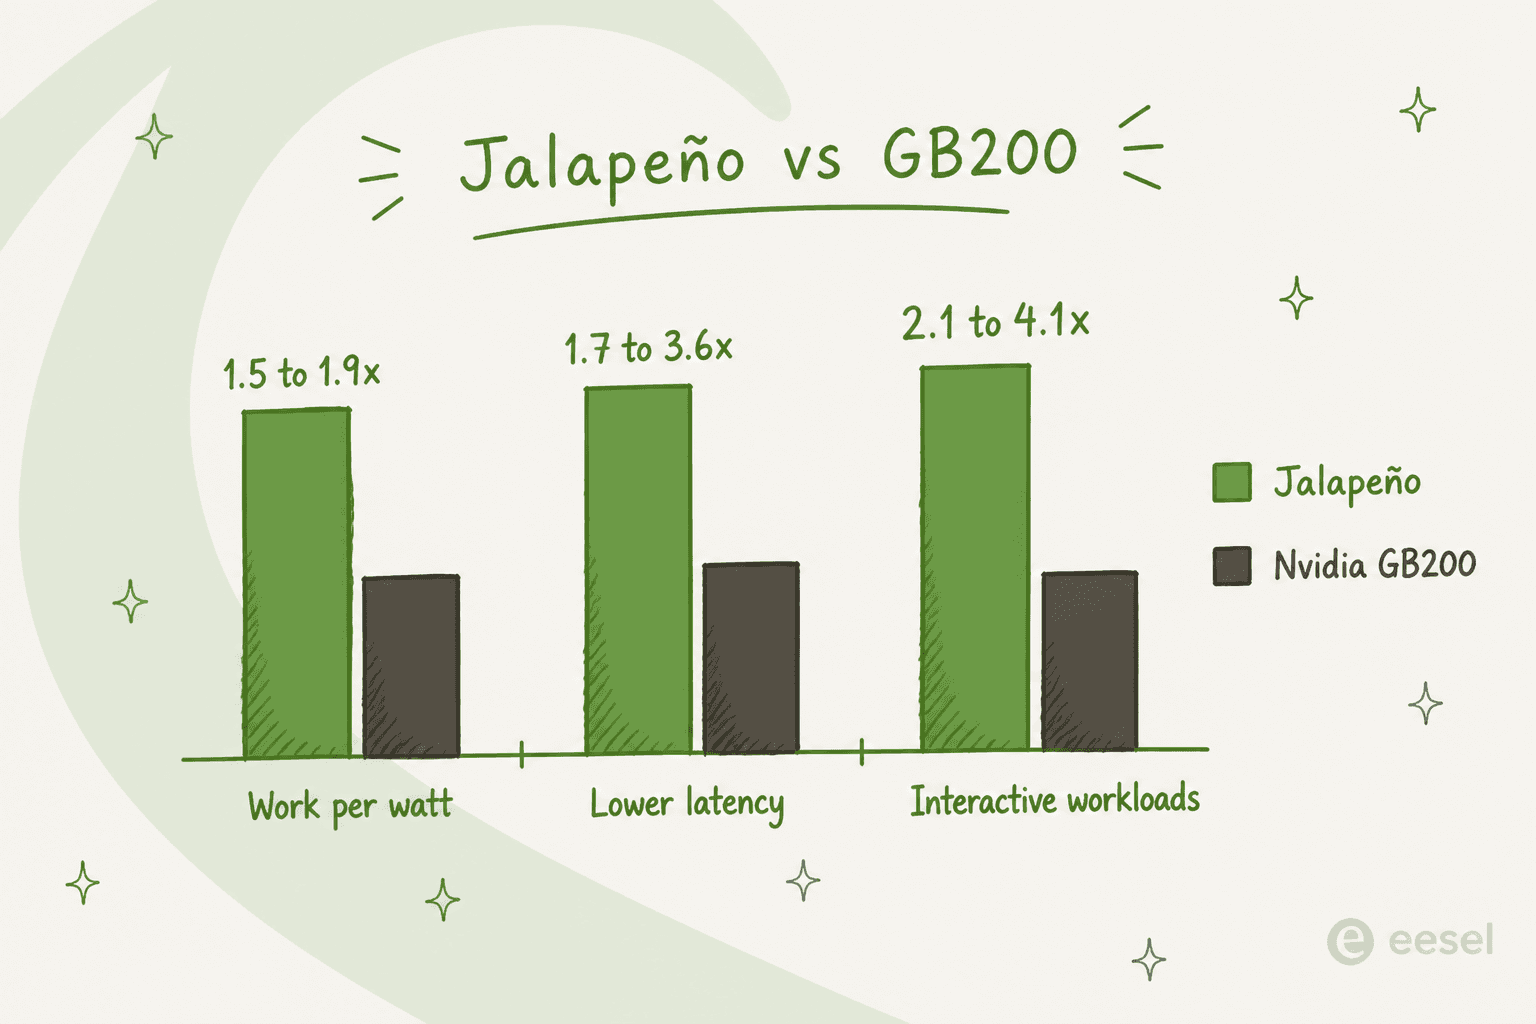
En los primeros benchmarks publicados por OpenAI (25 de agosto de 2026), Jalapeño ofreció entre 1,5 y 1,9 veces más trabajo de IA por vatio y entre 1,7 y 3,6 veces menos latencia que el sistema Nvidia GB200 de comparación, en tres modelos públicos. OpenAI planea ponerlo en marcha en sus propios centros de datos antes de que acabe 2026, como el primero de una hoja de ruta de varias generaciones ligada a un despliegue de 10 GW con Broadcom.
Si no eres OpenAI, la conclusión es sencilla: esta es la fontanería que hay bajo los modelos, y una fontanería más barata significa una IA más barata. Es la misma fuerza que hace que un agente de IA cueste menos que un agente humano a gran escala. Herramientas como eesel funcionan sobre estos modelos para hacer trabajo real, así que cuando el silicio de debajo se vuelve más eficiente, la economía del soporte y la automatización con IA mejora sin que tú toques nada.
Qué anunció realmente OpenAI
Construyo agentes de IA para ganarme la vida, así que leo los lanzamientos de chips con una sola pregunta: ¿esto cambia lo que pueden hacer los modelos de encima o lo que cuesta ejecutarlos? Jalapeño es claramente del segundo tipo, y de los grandes.
El 24 de junio de 2026, OpenAI y Broadcom presentaron Jalapeño, el primer chip propio de OpenAI. El nombre es una broma sobre el calor y la velocidad; lo importante es que OpenAI ya no alquila toda su capacidad de cómputo a otros. Diseñó su propio silicio, informó TechCrunch, y según Bloomberg ya había recibido las primeras muestras físicas y las estaba probando.
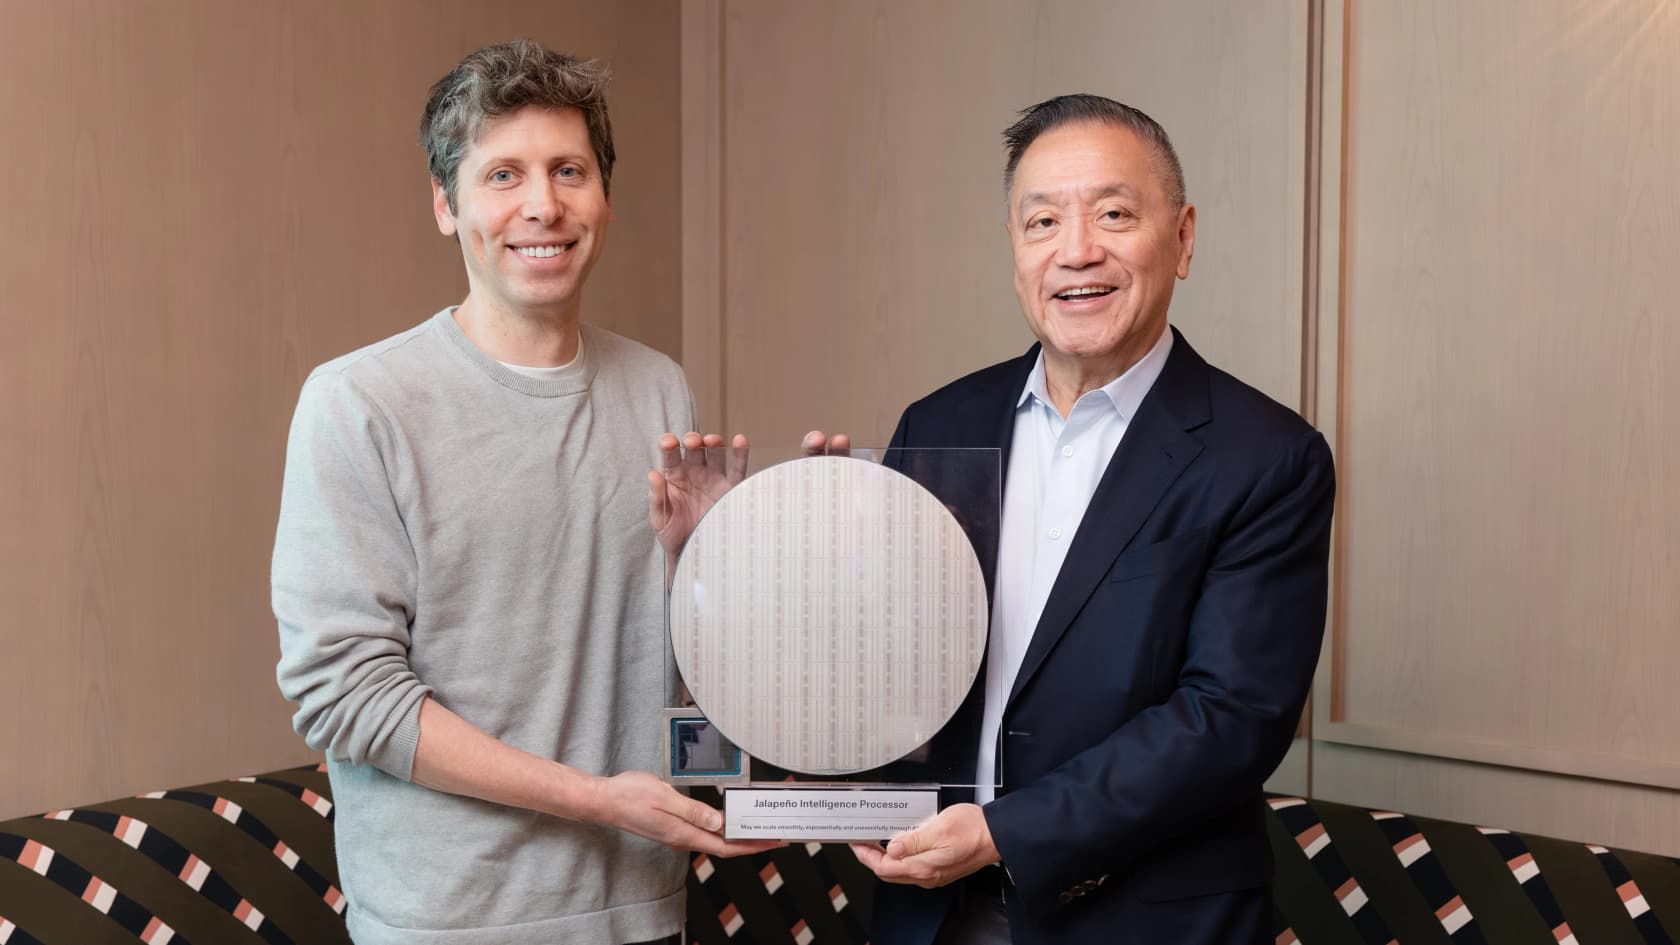
La escala es el titular que la mayoría pasó por alto. Este chip es una pieza de una alianza para desplegar 10 GW de aceleradores diseñados por OpenAI en los próximos años, un despliegue que OpenAI enmarca dentro de su "plan full stack" más amplio para controlarlo todo: modelos, productos, software de servicio, chips, memoria y redes. Jalapeño es donde ese plan deja de ser una diapositiva y se convierte en silicio que funciona.
Qué es Jalapeño y qué no es
Hay que hacer algunas distinciones, porque "OpenAI hizo un chip" se reduce enseguida a "OpenAI está peleando contra Nvidia", y eso se pierde lo esencial.
Jalapeño es un ASIC, un chip de aplicación específica. Mientras que una GPU de Nvidia es un procesador flexible de propósito general que puede entrenar modelos, ejecutar gráficos y servir inferencia, un ASIC hace un único trabajo muy concreto extremadamente bien y nada más. El único trabajo de Jalapeño es la inferencia, la parte de servicio en la que un modelo ya entrenado lee tu prompt y genera una respuesta. No entrena modelos. Para eso OpenAI sigue usando Nvidia y otros socios.
Y no se puede comprar. Jalapeño no es un producto; funciona dentro de la infraestructura propia de OpenAI para servir ChatGPT, Codex, la API y productos con agentes. Para todos los demás, el chip aparece de forma indirecta, como modelos de OpenAI más rápidos y baratos, no como hardware en tu rack. Si buscas la versión de esta historia con hardware de inferencia especializado que sí puedes alquilar, ese mercado ya existe en plataformas como Baseten.
Algo más para ser justos: esto fue rápido. OpenAI dice que pasó del diseño al tapeout en nueve meses, lo cual es rápido para silicio a medida y muestra cuánto talento y dinero de la industria apunta ahora al coste de la inferencia.
Las cifras de los benchmarks
El 25 de agosto de 2026, OpenAI publicó los primeros resultados de Jalapeño, y esas cifras son la razón por la que este lanzamiento dio tanto que hablar.
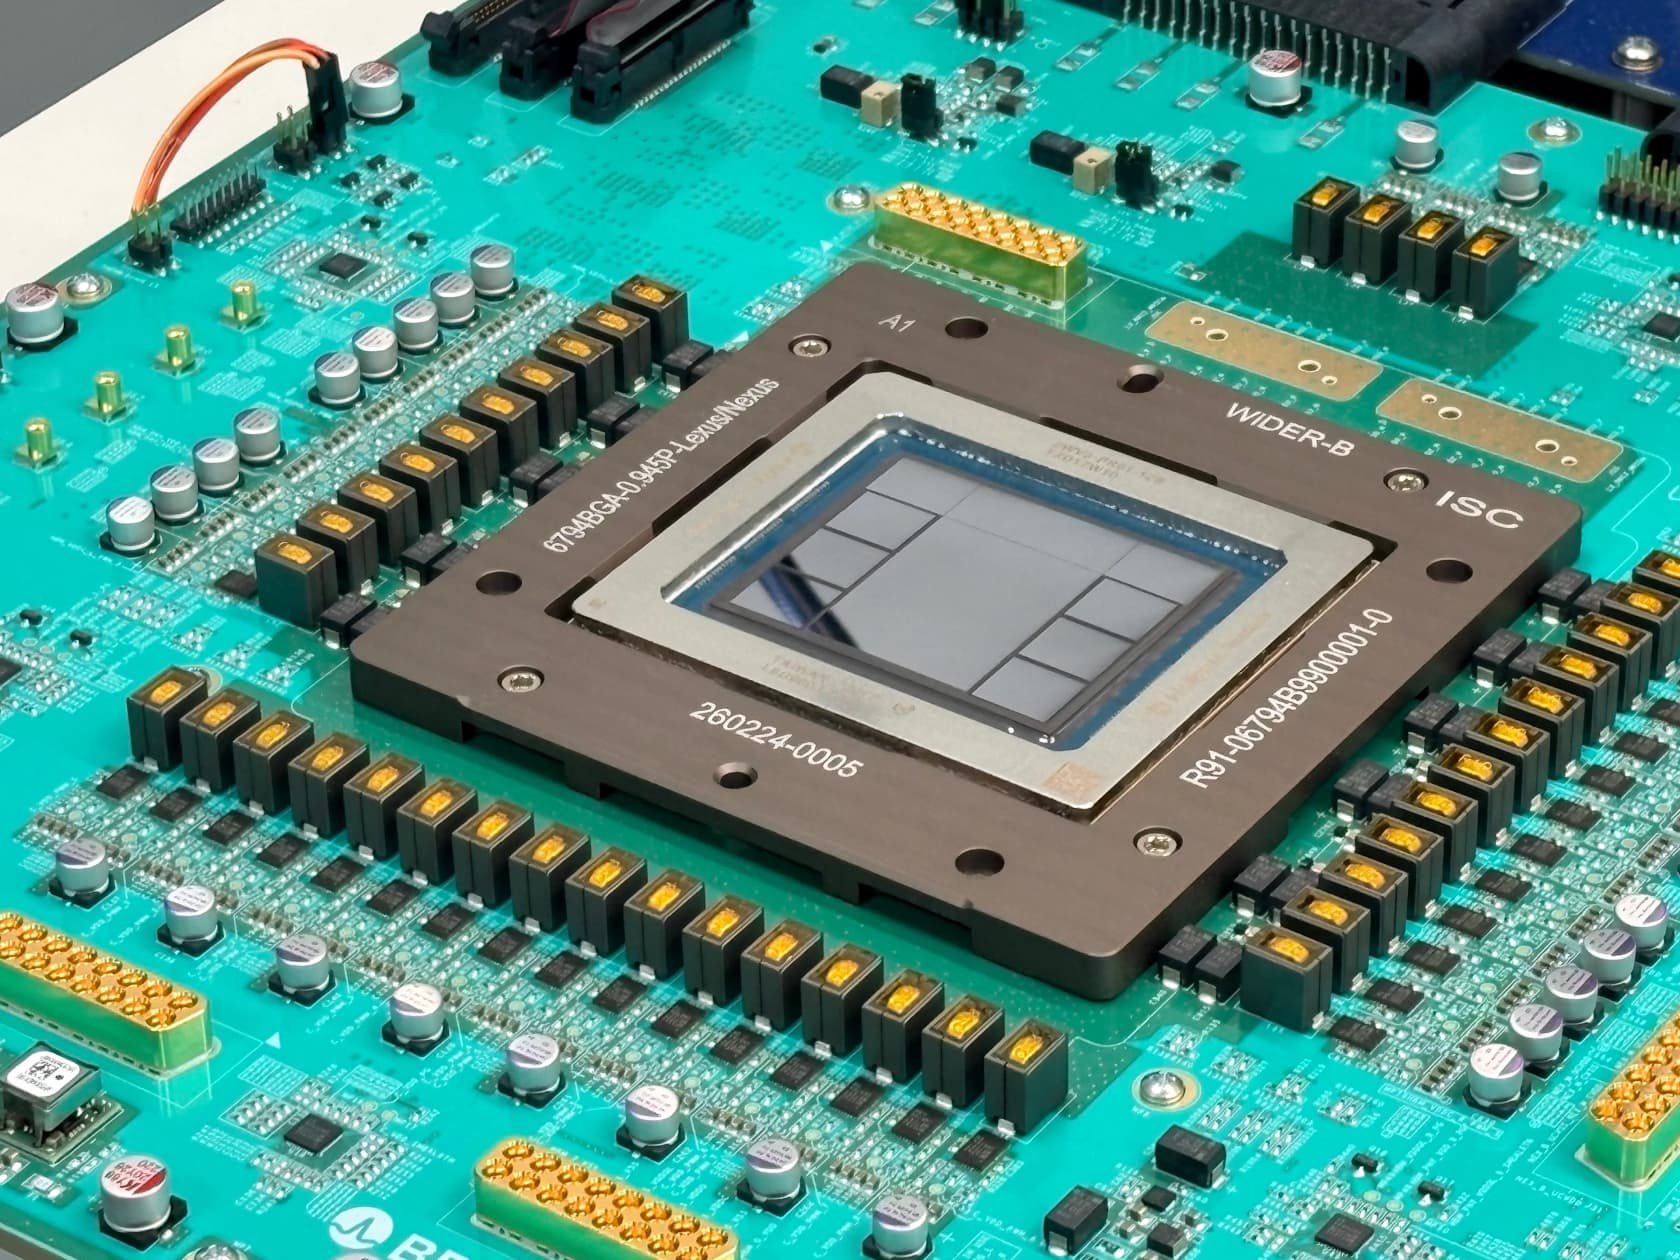
Probado con tres modelos públicos, GPT-OSS 120B, DeepSeek R1 670B y Kimi K2.5 1T, OpenAI informó de que Jalapeño ofreció:
- Entre 1,5 y 1,9 veces más trabajo de IA por vatio con el máximo rendimiento
- Entre 1,7 y 3,6 veces menos latencia de extremo a extremo
- Entre 2,1 y 4,1 veces más rendimiento en cargas de trabajo muy interactivas
El chip de comparación en los gráficos de OpenAI es el Nvidia GB200, con 1.200 vatios frente a los 700 de Jalapeño. OpenAI insiste en que consiguió tanto mayor rendimiento como menor latencia con un único diseño, cuando el hardware existente suele obligar a elegir entre ambos.
La lectura independiente viene de SemiAnalysis, cuyo benchmark InferenceX usó OpenAI. Su veredicto fue contundente ya en el titular, "Better Than Nvidia Blackwell", y cita que Jalapeño alcanza casi 700 tokens por segundo por usuario y más de 9 veces el siguiente mejor chip con un objetivo de interactividad equivalente. Conviene tener presente una cosa, de la que hablo más abajo: SemiAnalysis es dueña del benchmark que OpenAI eligió ejecutar.
La parte más interesante: el chip se diseñó a sí mismo
Este es el detalle que pondría en la portada, y que OpenAI casi enterró. La razón por la que un silicio en nueve meses fue posible es que OpenAI usó sus propios modelos para diseñar el chip.
Los modelos anteriores ayudaron a poner en marcha el chip; los más nuevos lo están optimizando y programando. Usando Codex con GPT-Astra, el equipo llevó a alto rendimiento, en dos meses, tres modelos de pesos abiertos que no estaban en el plan original. En bloques seleccionados de atención y de mezcla de expertos, las implementaciones generadas por IA fueron entre 1,5 y 1,8 veces más rápidas que las versiones de expertos humanos.
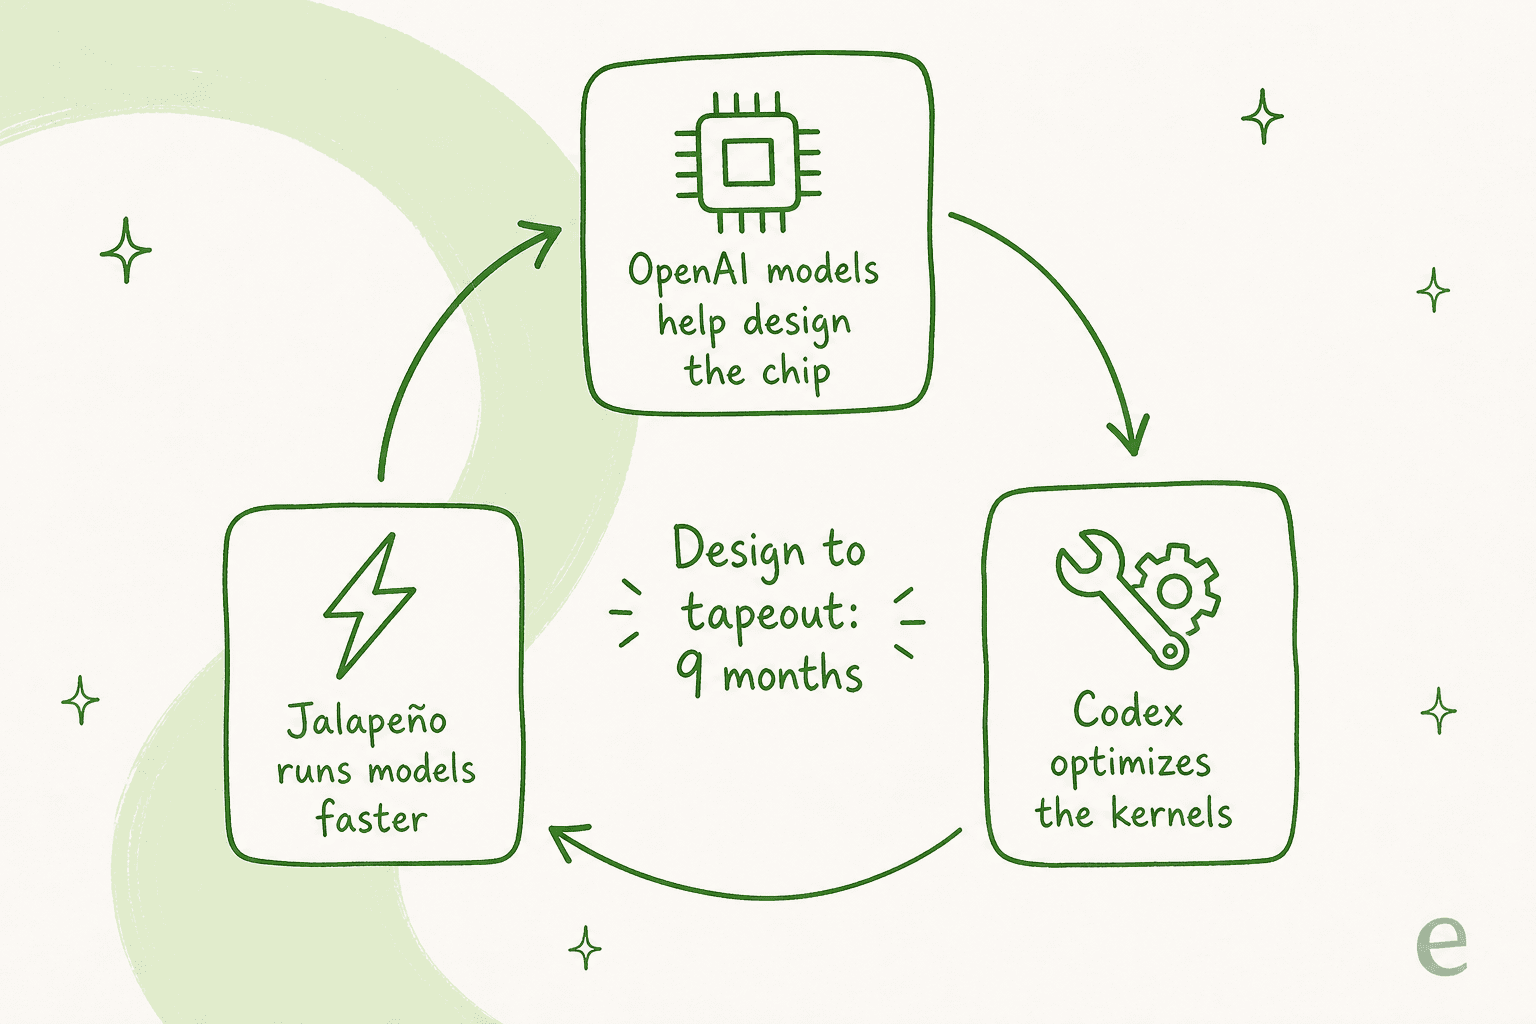
Eso es un bucle: los modelos ayudan a diseñar el silicio, el silicio ejecuta los modelos más rápido y los modelos más rápidos ayudan a diseñar el siguiente silicio. La Gen 2 está "deep in development" y la Gen 3 está "taking shape". Pienses lo que pienses de los benchmarks, este bucle de retroalimentación es la parte que se acumula, y es la misma razón por la que los asistentes de programación con IA tienen cada vez más peso en cómo se construyen los productos reales.
Qué opinó la comunidad
La reacción no fue una vuelta de honor sin más, y el escepticismo es lo bastante razonable como para incluirlo.
La crítica más afilada en Hacker News fue que esta no es una comparación en igualdad de condiciones:
"OpenAI's chip is targeting inference (FP8, FP4), while most of the chips it is being compared to are general purpose."

Un ASIC de inferencia hecho a propósito debería superar a una GPU de propósito general en inferencia por vatio. Eso es lo que compra la especialización, así que la ventaja es real pero también algo esperable. Otros señalaron quién escribió el marcador:
"This semi-analysis article reads a lot more like an OpenAI press release than a real analysis."
En el lado inversor de Reddit, el enfoque tenía menos que ver con los tokens y más con los márgenes: r/NVDA_Stock trató el silicio propio como una amenaza lenta al poder de fijación de precios de Nvidia, no como una de la noche a la mañana. Mi propia lectura cae en un punto medio: las cifras probablemente son ciertas en su dirección y reales para las cargas de trabajo de OpenAI, y además son exactamente las cifras que esperarías de un chip especializado medido con la prueba de su propio autor.
Por qué importa un anuncio de chip si no eres OpenAI
No vas a instalar Jalapeño. Entonces, ¿por qué debería importarte? Porque el coste de inferencia es la cifra silenciosa bajo cada producto de IA que usas o construyes.
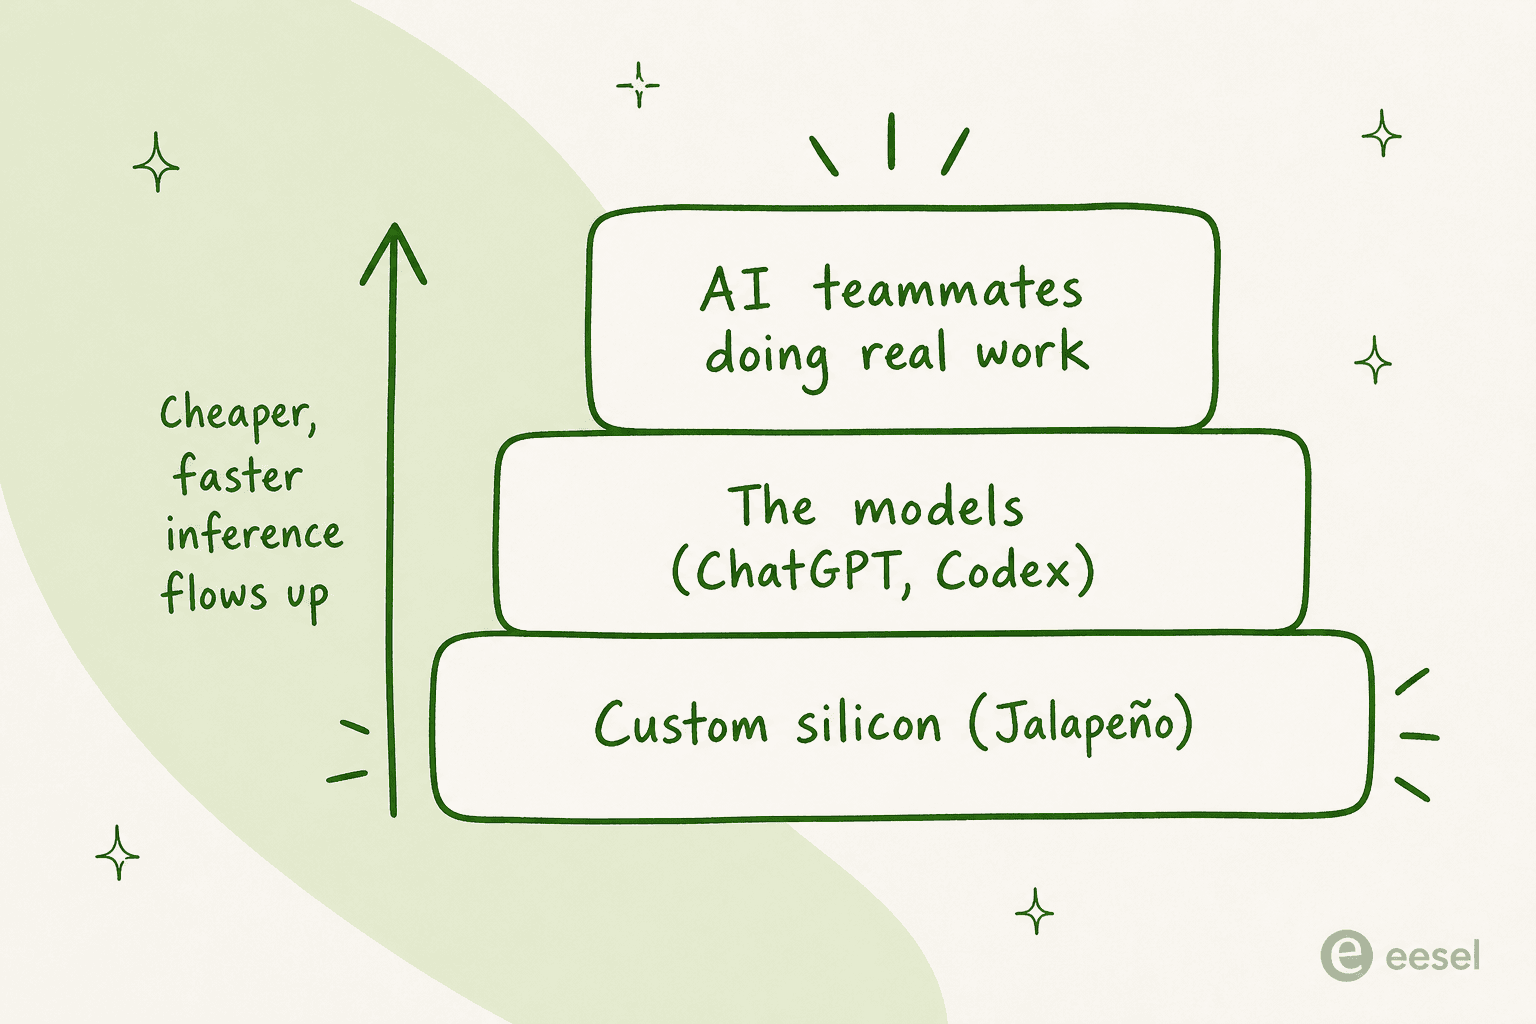
Cada respuesta de soporte con IA, cada correo redactado, cada agente de IA que lee un pedido y responde a un cliente es una llamada de inferencia que cuesta dinero real servir. Cuando OpenAI reduce ese coste, mejora primero sus propios márgenes, pero con el tiempo el efecto sube por la pila, en precios de API más baratos y modelos que hacen más por cada dólar. Ese es el viento a favor que sigue convirtiendo el soporte con IA de una demo en una partida que claramente se paga sola, la misma cuenta que hay detrás de cuánto puede ahorrar realmente la IA en atención al cliente.
También es un recordatorio de dónde está la verdadera palanca para la mayoría de los equipos. No compites teniendo silicio; compites poniendo los modelos a trabajar en tus problemas reales. El chip es la planta de la fábrica. El agente de IA que gestiona tus tickets es el empleado, y el empleado es la parte que tú puedes contratar.
Prueba eesel
Jalapeño es infraestructura, la capa bajo los modelos. eesel es la capa de encima, la parte que realmente pones a trabajar. Es una plataforma de compañeros de equipo de IA: contratas compañeros listos para trabajar en tareas concretas, y el compañero de helpdesk con IA se incorpora a tu cola actual de Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y de tu centro de ayuda, y empieza a redactar o enviar respuestas.
El diferenciador que destacaría es que puedes simular un compañero con tus tickets históricos antes de que responda a un cliente real, así ves cómo funcionará de antemano en lugar de accionar un interruptor y esperar lo mejor. El precio es desde 299 $/mes por 500 créditos (1 crédito por ticket o chat), sin cargos por usuario, y puedes empezar gratis con 100 créditos. Un silicio más barato por debajo está bien; un compañero que puedes probar hoy es la parte que te cambia la semana.