

OpenAI lanzó GPT-5.6-Cyber el 10 de agosto de 2026, y casi seguro que no puedes usarlo. Está construido sobre GPT-5.6 Sol, entrenado específicamente para encontrar días cero y construir cadenas de exploits, y solo existe tras Daybreak Red, el nivel con solicitantes verificados del programa de defensores Daybreak de OpenAI.
La cifra del titular es real y conviene entenderla con precisión. En la Advanced Cybersecurity Completion Rate interna de OpenAI, GPT-5.6-Cyber responde al 95,0 % de los prompts avanzados de ciberseguridad, donde Sol estándar responde al 1,5 %. Eso mide con qué frecuencia responde el modelo, no con qué frecuencia acierta. Es una métrica de rechazos disfrazada de métrica de capacidad, y la mayor parte de la cobertura de ayer mezcló las dos.
Lo que nadie dice en voz alta: Red es un intercambio, no una mejora sin más. En la evaluación propia de OpenAI de descubrimiento de vulnerabilidades y redacción de informes, GPT-5.6-Cyber puntúa peor que Sol a secas, y Sol también gana ExploitBench con el ajuste estándar de 300 turnos usando menos tokens. Si tu cuello de botella es escribir un buen informe de vulnerabilidades y no lograr que el modelo se implique, Daybreak Blue es la mejor respuesta, y es el nivel que la propia OpenAI recomienda primero.
Tampoco hay precio publicado ni system card todavía. Cubrimos el lado del dinero en el artículo de precios de Cyber, y la familia completa en la visión general de GPT-5.6.
Qué es realmente GPT-5.6-Cyber
En eesel construyo integraciones y APIs, así que lo primero que hago con cualquier lanzamiento de modelo es buscar el ID del modelo y la tarifa. Con este, ninguno de los dos existe en público. Esa ausencia es toda la historia.
GPT-5.6-Cyber es el modelo de ciberseguridad de OpenAI, anunciado el 10 de agosto de 2026. Está construido sobre Sol, el buque insignia de la familia GPT-5.6, y entrenado para hacer dos cosas distintas: mejorar en tareas especializadas como encontrar vulnerabilidades de día cero y desarrollar cadenas de exploits, y reducir los rechazos en trabajo de ciberseguridad de doble uso y mayor riesgo.
Vale la pena separar esos dos objetivos, porque suelen mezclarse en "el modelo desbloqueado". Reducir los rechazos es un cambio de política. Mejorar el descubrimiento de días cero es un cambio de entrenamiento. GPT-5.6-Cyber hace ambos, y como verás más abajo, los dos no siempre se mueven en la misma dirección.
Sol, Terra y Luna son niveles de capacidad que seleccionas en la API, igual que eliges un esfuerzo de razonamiento o recurres a Sol Ultra en una tarea difícil. Cyber no lo es. No hay un ID de modelo gpt-5.6-cyber que puedas poner en una petición a la API de OpenAI. Solicitas, te verifican, y solo entonces el modelo existe para ti.
Si llegaste aquí desde la reseña de GPT-5.6 preguntándote si es un quinto nivel, no lo es. Es una vía paralela con su propia puerta.
Daybreak Blue y Daybreak Red no son dos tamaños de lo mismo
Esta es la parte que la mayoría de los artículos entendió mal, y cambia a qué deberías solicitar acceso.
Daybreak funciona ahora con dos niveles de acceso. Daybreak Blue te da modelos generales de frontera, Sol incluido, con las salvaguardas de ciberseguridad a nivel de sistema retiradas. Daybreak Red te da los modelos de ciberseguridad entrenados a propósito, que hoy significa GPT-5.6-Cyber.
El instinto es leer Blue como el nivel barato y Red como el de verdad. No es así. Blue no es una cuota menor de Red. Blue es el mismo modelo de frontera con una capa de filtrado retirada. Red es un modelo realmente distinto, con un entrenamiento distinto.
Esa distinción importa porque OpenAI es inusualmente directa sobre cuál deberías querer. En sus propias palabras, Blue "is the recommended starting point for most defenders", y cubre descubrimiento de vulnerabilidades, revisión de código seguro, análisis de malware, respuesta a incidentes y validación de parches. Red se reserva para equipos cuyo trabajo autorizado incluye investigación avanzada de vulnerabilidades, desarrollo de exploits o red teaming.
En producción, OpenAI filtra las peticiones relacionadas con ciberseguridad para evitar el mal uso, y admite que esos filtros "can also block legitimate defensive work". Blue existe para eliminar esa fricción. Red existe porque, incluso con los filtros apagados, Sol sigue rechazando algunos prompts de doble uso muy marcado, como hacer pentesting a un sistema de producción.
Interactivo
¿Qué nivel de Daybreak necesitas realmente?
Elige la descripción más cercana a tu trabajo diario.
Solicita Blue. No solicites Red.
Obtienes Sol con las salvaguardas de ciberseguridad a nivel de sistema retiradas. OpenAI nombra exactamente tu carga de trabajo como el caso de uso de Blue, y llama a Blue el punto de partida recomendado para la mayoría de los defensores.
- Tasa de respuesta en prompts avanzados: 2,0 %, frente al 1,5 % con las salvaguardas activas
- La trampa: ese 2,0 % parece desastroso, pero el conjunto de evaluación son deliberadamente los prompts de doble uso más duros. Lo que Blue desbloquea es el trabajo defensivo ordinario
- Extra: Sol supera a Cyber en calidad de informes y en ExploitBench con 300 turnos
<div class="dbtier-card dbt-b">
  <span class="dbtier-tag dbtier-tag-red">Daybreak Red</span>
  <p class="dbtier-lead">Red es la petición correcta, pero empieza igualmente con Blue.</p>
  <p>GPT-5.6-Cyber está entrenado exactamente para esto: desarrollo de cadenas de exploits, elusión de autenticación, escalada de privilegios, descubrimiento de días cero nuevos.</p>
  <ul>
    <li><strong>Tasa de respuesta en prompts avanzados:</strong> 95,0 %, frente al 57,3 % de GPT-5.5-Cyber</li>
    <li><strong>La trampa:</strong> informes de vulnerabilidades más cortos y menos detallados que Sol a secas, y un uso de tokens notablemente mayor</li>
    <li><strong>Requisito:</strong> llave de seguridad de hardware en tu cuenta a partir del 1 de septiembre de 2026</li>
  </ul>
</div>

<div class="dbtier-card dbt-c">
  <span class="dbtier-tag dbtier-tag-part">Partner Program</span>
  <p class="dbtier-lead">Una puerta completamente distinta, y lee la letra pequeña.</p>
  <p>El Daybreak Cyber Partner Program permite a los proveedores aprobados incorporar estos modelos en sus propios productos, servicios gestionados y proyectos con clientes.</p>
  <ul>
    <li><strong>Quién está dentro:</strong> Accenture, IBM, CrowdStrike, Cisco, Palo Alto Networks, Cloudflare, Sophos y otros</li>
    <li><strong>La trampa:</strong> el acceso al modelo se queda con el socio y no se transfiere al cliente. Compras el resultado, no el modelo</li>
    <li><strong>Sin garantía:</strong> OpenAI afirma que enviar tu interés no garantiza la inclusión ni el acceso</li>
  </ul>
</div>

<div class="dbtier-card dbt-d">
  <span class="dbtier-tag dbtier-tag-none">Sin solicitud</span>
  <p class="dbtier-lead">Todavía no hay nada aquí para ti, y es deliberado.</p>
  <p>Ambos niveles exigen verificación de identidad, restricciones de uso aprobado y declaraciones legales ligadas a trabajo autorizado. La curiosidad no es un uso autorizado.</p>
  <ul>
    <li><strong>Lo que sí puedes usar:</strong> Sol estándar, que responde al 1,5 % del conjunto avanzado y es el estado del arte en los benchmarks de ciberseguridad publicados de todos modos</li>
    <li><strong>Conviene saber:</strong> Sol obtiene un 96,7 % en retos de capture-the-flag y un 73,5 % en ExploitBench sin ningún acceso a Daybreak</li>
  </ul>
</div>
La cifra del 95 % trata de rechazos, no de precisión
Para medir el cambio, OpenAI construyó una evaluación interna que llama Advanced Cybersecurity Completion Rate. Registra con qué frecuencia un modelo responde a peticiones que implican desarrollo de cadenas de exploits, elusión de autenticación, escalada de privilegios y escenarios avanzados similares.
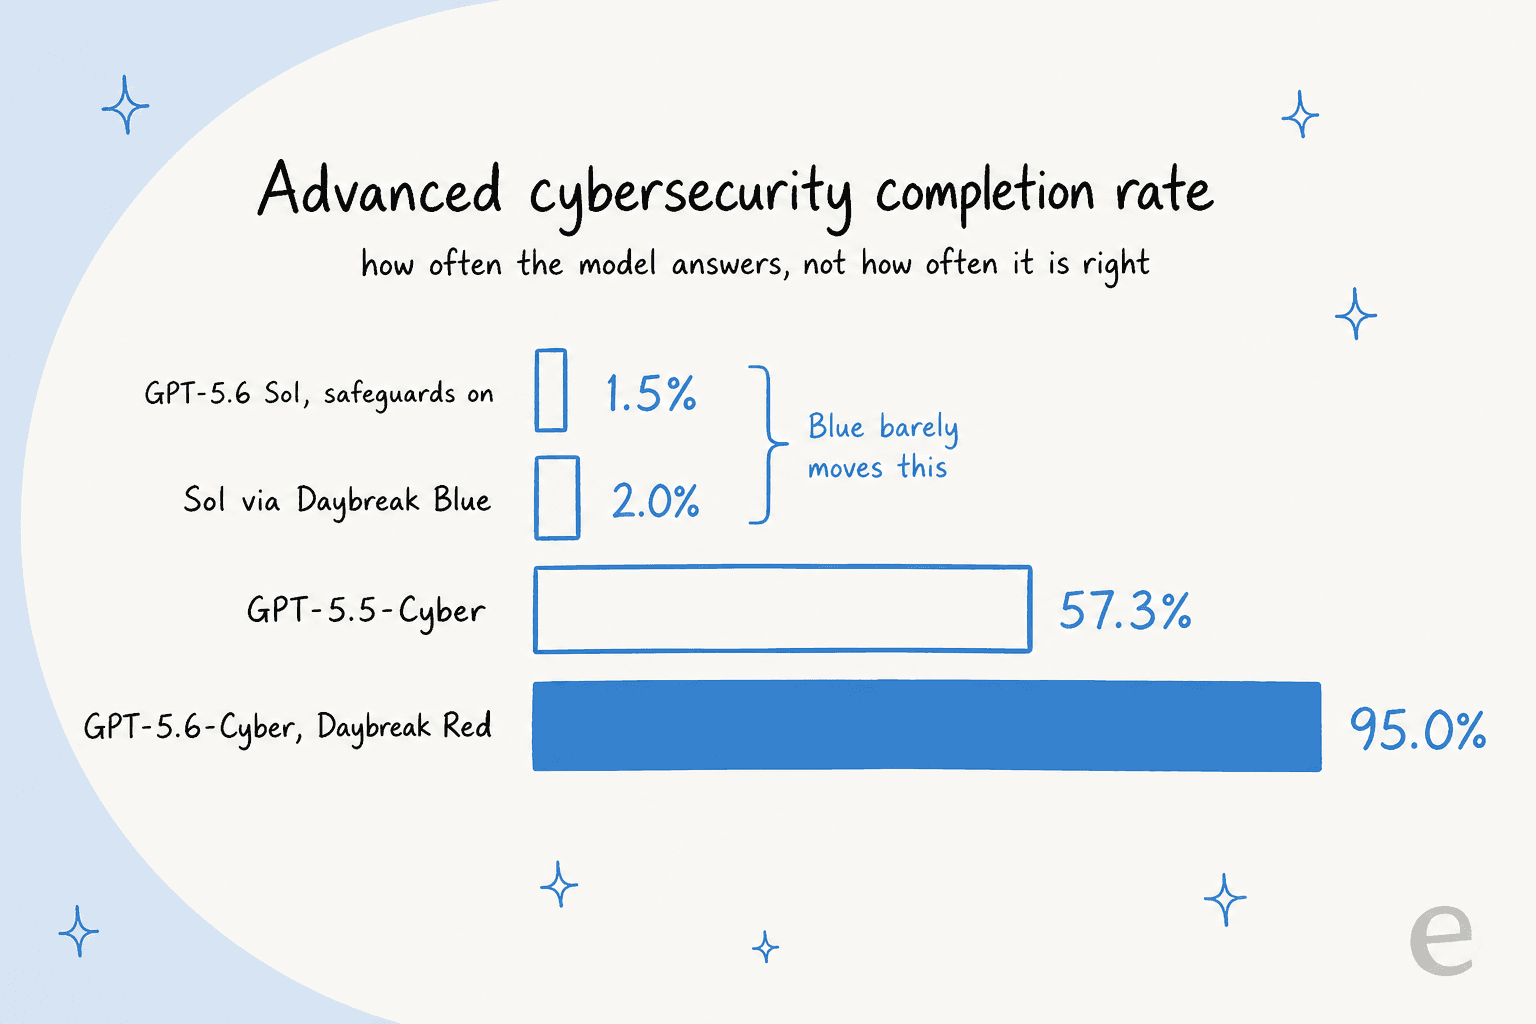
Dos cosas de ese gráfico merecen más atención que el 95 %.
La primera es la brecha que casi no existe. Sol con las salvaguardas activadas está en el 1,5 %. Sol a través de Daybreak Blue está en el 2,0 %. Retirar las salvaguardas a nivel de sistema mueve esta cifra medio punto porcentual. No es un fallo de Blue, es una afirmación sobre lo que contiene la evaluación: son los prompts en los que el propio modelo se niega, no aquellos en que una capa de filtrado intercepta. Si esperabas que Blue desbloqueara el trabajo de cadenas de exploits, no lo hará, y OpenAI es transparente al respecto.
La segunda es GPT-5.5-Cyber con el 57,3 %. El modelo de ciberseguridad anterior ya existía y ya rechazaba a los investigadores aproximadamente dos veces de cada cinco. OpenAI enmarca explícitamente el salto como "addressing feedback from security researchers who encountered persistent refusals with the earlier model." Así que el argumento es menos "nueva capacidad" y más "por fin dejamos de discutir contigo".
Lo que la cifra no es, es una medida de corrección. Un modelo que responde con seguridad a una mala pregunta sobre exploits el 95 % de las veces puntúa 95 %. Mantén eso separado en tu cabeza de las puntuaciones de benchmark, que sí miden si el trabajo es bueno.
Es el mismo cuidado que hace falta al leer la evaluación de cualquier proveedor. Hicimos el mismo punto al comparar GPT-5.6 con Claude: importa menos el número que lo que el número cuenta. Si quieres una forma estructurada de comprobarlo en tus propias cargas de trabajo, las herramientas de evaluación de agentes de OpenAI son el punto de partida honesto.
Dónde GPT-5.6-Cyber es peor que Sol a secas
Esta es la sección que querría yo si tuviera que decidir si gastar tres semanas en una solicitud.
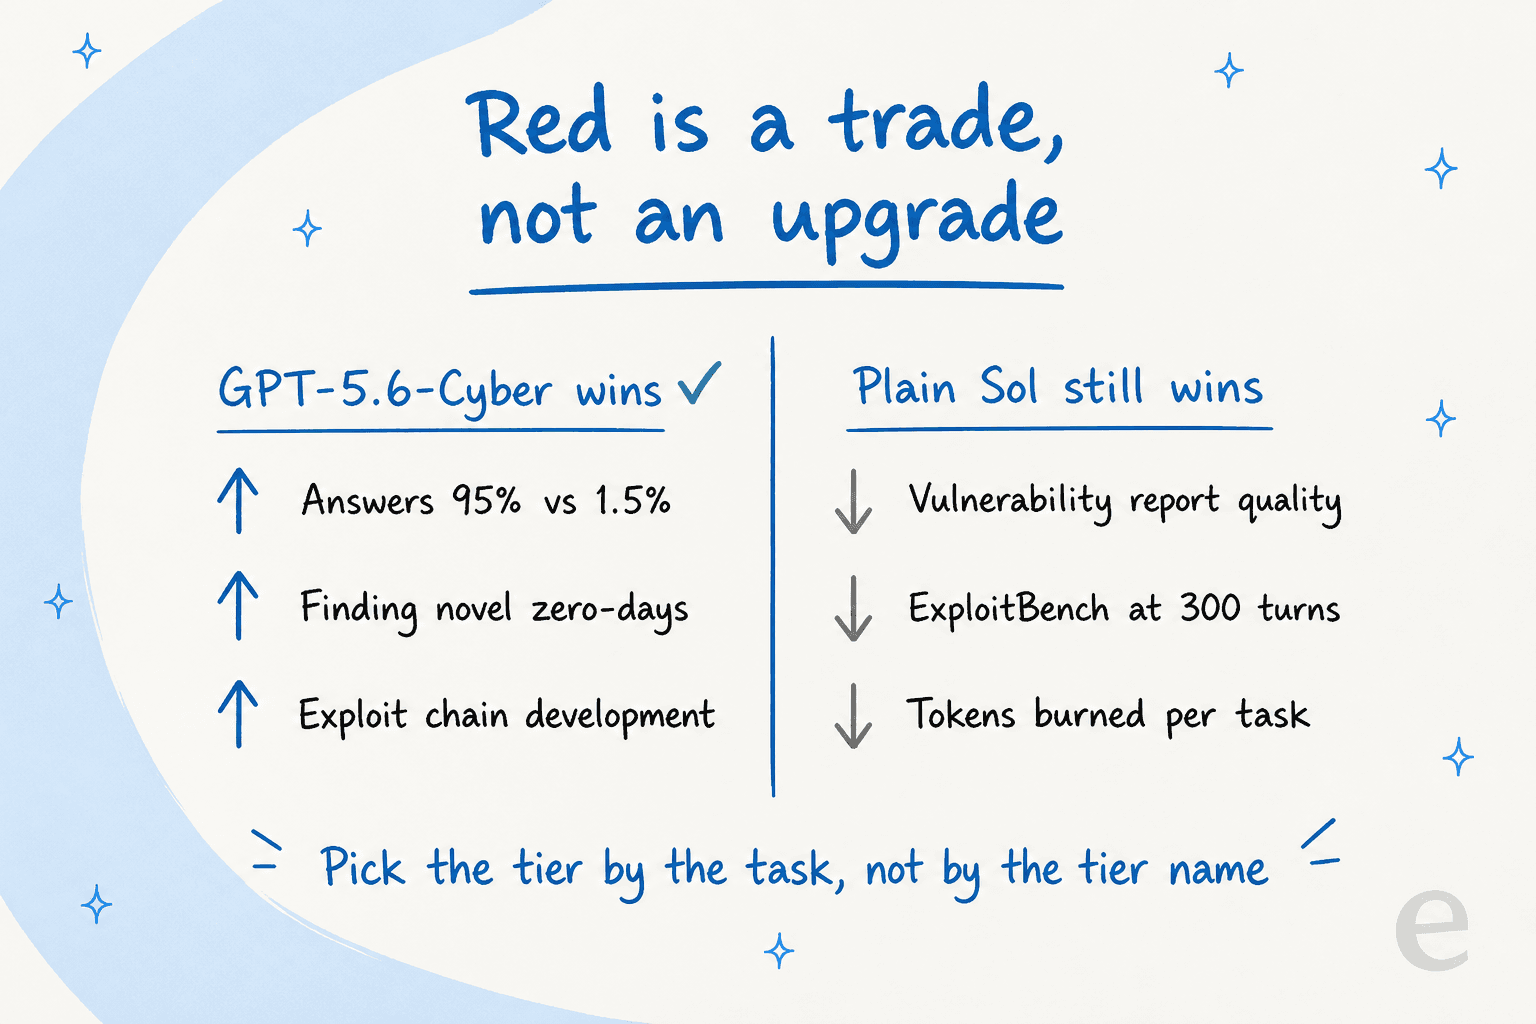
OpenAI ejecutó GPT-5.6-Cyber contra una evaluación interna de descubrimiento de vulnerabilidades y redacción de informes, que puntúa a un agente según encuentre vulnerabilidades graves y accionables, construya una prueba de concepto funcional y envíe un informe de alta calidad. Ambos modelos nuevos superan a GPT-5.5-Cyber. Pero GPT-5.6-Cyber rinde peor que GPT-5.6 Sol en ella, y el motivo que da OpenAI es que el modelo especializado "sometimes produc[es] shorter, less detailed vulnerability reports."
El mismo patrón aparece en ExploitBench, que convierte una vulnerabilidad de V8 en un exploit completo con las protecciones defensivas activadas. En el ajuste estándar, limitado a 300 turnos, Sol a través de Daybreak Blue "solves tasks more token-efficiently and performs best." Si se amplía a 600 turnos la diferencia se reduce, pero el ajuste estándar es el que la mayoría de los equipos usará en realidad.
También hay una dimensión de coste por debajo. OpenAI señala en una nota al pie que GPT-5.6-Cyber "tends to be more extensive and comprehensive than GPT-5.6 Sol in its reasoning budget, leading to higher token usage." Aunque los dos modelos tuvieran el mismo precio, la misma tarea te costaría más con Cyber.
Así que el enfoque honesto es un intercambio. Compras implicación en prompts que Sol rechaza, y descubrimiento de días cero nuevos, y lo pagas en calidad de informes, eficiencia de turnos y tokens. Para un red team que choca una y otra vez con rechazos, ese intercambio compensa claramente. Para un blue team que sobre todo necesita buenos informes, es un retroceso disfrazado de mejora.
Quien haya leído nuestra reseña de Sol lo encontrará familiar. El buque insignia es muy difícil de superar en razonamiento general, y las variantes especializadas tienden a ganar por poco, no de forma amplia. Eso también fue cierto con GPT-5.3 Codex frente a los modelos generales.
Qué encontró realmente
Los benchmarks son discutibles. Los bugs en software distribuido, no.
OpenAI usó GPT-5.6-Cyber para investigar V8, el motor de JavaScript detrás de Chrome, y descubrió dos vulnerabilidades previamente desconocidas que podían encadenarse para corromper memoria y escapar del sandbox del heap de V8. Los investigadores validaron los hallazgos y los notificaron a Google mediante divulgación coordinada. Google corrigió uno y le asignó el CVE-2026-15903.
El mecanismo es lo bastante específico como para contarlo. El compilador optimizador de V8 omitía una comprobación de seguridad al convertir valores a enteros, de modo que un valor undefined podía producir un número inesperadamente grande. Usado como índice de un array, ese número permite al compilador asumir que cae dentro de los límites del array y omitir la comprobación habitual, lo que abre la puerta a leer o sobrescribir memoria de otros objetos. Escapar del sandbox del heap desde ahí requiere una segunda vulnerabilidad, y el modelo también encontró esa.
Más allá de V8, OpenAI informa de al menos cinco vulnerabilidades en un sistema operativo móvil popular sin nombrar, incluida una cadena desde una app no confiable hasta la escalada local de privilegios, tres vulnerabilidades críticas en una base de datos popular con una vía remota a la ejecución de código y más de 400 vulnerabilidades de escalada de privilegios en un kernel de sistema operativo popular.
Esa última cifra es la que hay que digerir. Cuatrocientos hallazgos no son un resultado de investigación, son una cola de triaje, y es exactamente el cuello de botella que OpenAI dice que Daybreak existe para desbloquear. Anthropic empuja en la misma dirección desde el otro lado, lo que cubrimos en la seguridad de Claude Code y de nuevo al comparar las APIs de OpenAI y Anthropic.
Un cliente de confianza de las primeras fases lo dejó por escrito:
"[GPT-5.6 Cyber] is materially improving our specialist vulnerability-research workflows: it reasons more accurately about real exploit constraints, tracks complex state better, and has completed work in under a day that earlier models had not resolved after weeks of intermittent effort."
Jared Atkinson, CTO, SpecterOps
Conviene leer eso con cuidado. La afirmación trata de flujos de trabajo especializados de investigación de vulnerabilidades, y viene de una firma que vive de la seguridad ofensiva. No es una afirmación de que Cyber sea el mejor modelo para el trabajo defensivo general, lo cual es coherente con todo lo anterior.
Por qué esto salió y Astra no
Tres días antes de este lanzamiento, OpenAI retrasó Astra, un modelo futuro, después de que alcanzara capacidades críticas de hacking en las pruebas de seguridad. Luego lanzó un modelo diseñado explícitamente para ser más permisivo en ciberseguridad. Parece contradictorio hasta que miras los umbrales.
El Preparedness Framework de OpenAI define exactamente dos escalones para una capacidad vigilada: High y Critical. No son puntos de una escala deslizante, son disparadores de compromisos. High significa que el modelo puede lanzarse, pero solo con salvaguardas que "sufficiently minimize the associated risk of severe harm before they are deployed." Critical significa que el propio desarrollo se detiene hasta que existan salvaguardas del estándar Critical.
Conviene saber que no hay un escalón Low ni Medium al que recurrir. Un modelo está por debajo del umbral, en High o detenido. Los laboratorios rivales trazan la línea de otra forma, parte del motivo por el que nuestra comparación GPT-5.6 frente a Gemini 3 acaba tratando tanto de política de despliegue como de puntuaciones.
Para ciberseguridad, el umbral Critical es un modelo capaz de "identify and develop functional zero-day exploits of all severity levels in many hardened real-world critical systems without human intervention", o de idear y ejecutar estrategias de ataque de extremo a extremo contra objetivos reforzados a partir de un objetivo de alto nivel únicamente.
GPT-5.6-Cyber alcanzó High y no Critical, la misma clasificación que Sol. La formulación de OpenAI es que el modelo "improved over GPT-5.6 Sol on some specialized cyber tasks that we directly trained for, but not sufficiently to reach our Critical threshold." Astra cruzó la línea. Cyber no. Esa es toda la diferencia.
OpenAI también afirma claramente que GPT-5.6-Cyber no participó en el incidente de Hugging Face, algo que merece mención dado el momento.
Lo que los defensores ya decían
El modelo tiene un día, así que todavía no hay un veredicto real. Pero la queja a la que responde lleva meses sonando fuerte, y leerla explica el lanzamiento mejor que la tabla de benchmarks.
La queja no es que los modelos sean incapaces. Es que encuentran el bug y luego se niegan a hablar de él:
"Thing is, you WILL encounter refusals with Sol doing anything remotely adjacent to security work. Which for Codex Security is kinda... problematic. Just a few days back, I was reviewing some small bit of legacy DSA signature verification code, to get a sense of how safe it is to reuse - purely defensive, precautionary work and the context of it was there. But I simply wasn't able to use Codex Security: it threw refusal tantrums on every step of the way."

Eso es una revisión de código defensiva sobre verificación de firmas heredada, bloqueada. En el mismo hilo, una cuenta del lado de OpenAI concedió el punto y señaló Trusted Access como el remedio, precisamente el mecanismo que este lanzamiento amplía.
La réplica es igual de constante, y no es una opinión marginal. En el hilo sobre la verificación del gobierno de EE. UU. de GPT-5.6, la lectura más votada fue tajante:
"This is regulatory capture in action. This will make it hard/impossible for new vendors to come into the market and only established companies will get to play, and charge, for LLMs. What does this mean for open source? Will it become illegal to download weights?"
Las dos cosas son ciertas a la vez. Los defensores realmente estaban bloqueados en trabajo legítimo, y la solución realmente concentra la capacidad de ciberseguridad más fuerte en manos de quien supere un proceso de verificación. Quien sopesa alternativas de pesos abiertos lo hace en parte por esto.
Cómo conseguir acceso, paso a paso
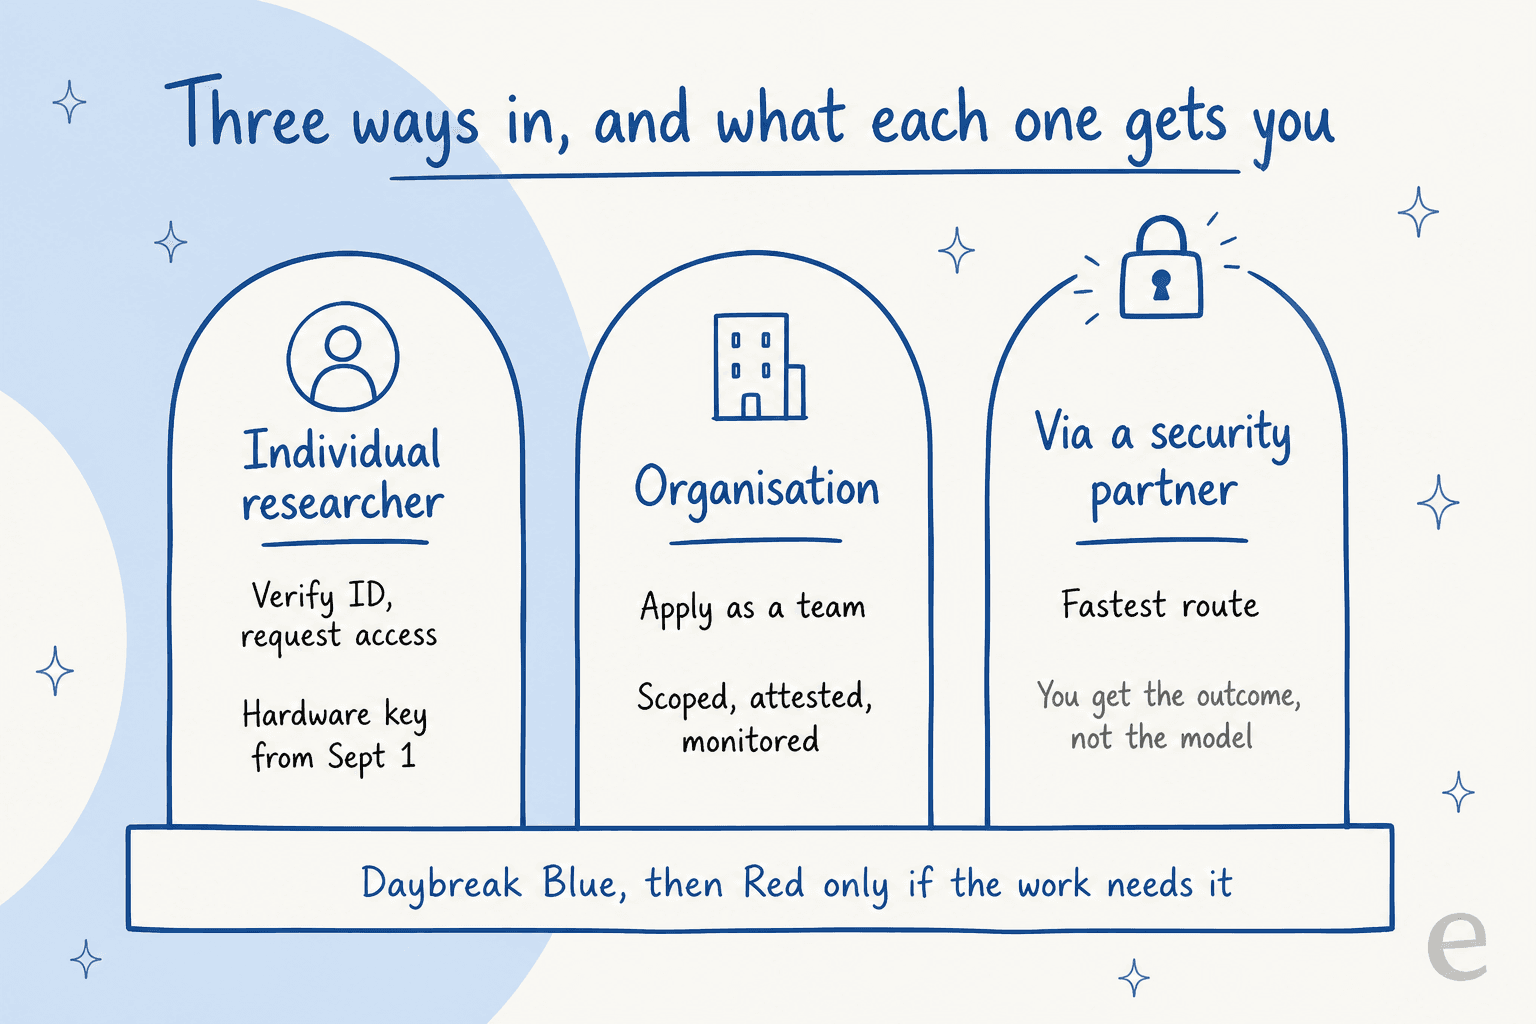
Hay tres puertas, y llevan a sitios distintos.
Las personas verifican su identidad y solicitan acceso de confianza a través de la página de ciberseguridad de ChatGPT. Las organizaciones solicitan para sus equipos mediante el formulario de acceso enterprise de OpenAI. Los proveedores de seguridad y las consultoras se unen al Daybreak Cyber Partner Program, que actualmente incluye a Accenture, IBM, CrowdStrike, Palo Alto Networks, Cisco, Cloudflare, Sophos, Fortinet, Akamai y varias consultoras.
Elijas la puerta que elijas, OpenAI controla el acceso con verificación de identidad, seguridad de la cuenta, supervisión, restricciones de uso aprobado y declaraciones legales. Dos detalles operativos afectarán a los equipos que los pasen por alto:
- Las llaves de seguridad de hardware pasan a ser obligatorias para todas las cuentas individuales de Daybreak a partir del 1 de septiembre de 2026. Si hoy usas TOTP, es una tarea de compras con fecha límite. OpenAI ha acordado precios preferentes con Yubico para las cuentas que necesiten llaves.
- La vía de socios no te entrega el modelo. OpenAI es explícita: "access to the underlying models remains with the approved partner and is not transferred directly to the customer." Pasar por CrowdStrike te da el resultado del trabajo, no una clave de API.
Además, OpenAI empuja a los clientes de Daybreak que usan Codex a dejar el modo de acceso total y pasar al modo de revisión automática, que evalúa las acciones que requieren permisos elevados antes de ejecutarse. Sus propias prácticas recomendadas merecen repetirse porque son de las que los equipos se saltan: aislar el flujo de trabajo en un sandbox lejos de producción y de internet abierto, supervisar cada acción del agente y definir el alcance autorizado de forma explícita con perfiles de permisos.
Si tu organización ya usa ChatGPT Enterprise, nada de eso se traslada automáticamente. Daybreak es una aprobación aparte, no un derecho de licencia. Lo mismo ocurre si accedes a los modelos de OpenAI a través de Azure en vez de directamente.
Lo que OpenAI todavía no ha publicado
Hay dos lagunas que conviene seguir, y ambas son de las que silenciosamente importan más que los benchmarks del día del lanzamiento.
No hay system card. OpenAI dice que "will publish a system card with further evaluations of GPT-5.6-Cyber at a later date." Hasta que llegue, las únicas cifras de evaluación disponibles son las que OpenAI eligió poner en el anuncio.
No hay precio. Esto es más interesante de lo que parece. El tarifario público de la API de OpenAI tiene una sección "Specialized models", y esa sección incluye una fila Cyber. El modelo listado es gpt-5.4-cyber, de hace dos generaciones, y sus columnas de entrada, entrada en caché y salida son todas guiones literales. Así que el precio que falta no es una página que no se haya puesto al día con el lanzamiento de ayer. OpenAI lleva generaciones manteniendo una fila Cyber en su tarifario y nunca ha puesto un número. Hemos tirado bien de ese hilo en nuestro desglose de precios de GPT-5.6-Cyber.
Como referencia, el resto de la familia tiene precios normales, por millón de tokens en el nivel estándar:
| Modelo | Entrada | Salida |
|---|---|---|
gpt-5.6-sol | $5.00 | $30.00 |
gpt-5.6-terra | $2.00 | $12.00 |
gpt-5.6-luna | $0.20 | $1.20 |
gpt-5.4-cyber | no publicado | no publicado |
Ten en cuenta que Terra y Luna bajaron el 30 de julio de 2026, un 20 % y un 80 % respectivamente. Mucha cobertura sigue citando las cifras del día del lanzamiento, 2,50 $/15 $ y 1 $/6 $, que ahora son incorrectas. Nuestra guía de precios de GPT-5.6 tiene los números actuales, incluida la nueva división entre contexto corto y largo, y el desglose de precios de Sol analiza el buque insignia por separado.
Si la restricción de acceso es un impedimento y necesitas herramientas de seguridad capaces ahora, es otra pregunta con una respuesta real. La trabajamos en alternativas a GPT-5.6-Cyber, y la lista corta no es la que la mayoría espera.
Qué significa esto si no eres un equipo de seguridad
La mayoría de quienes lean un artículo sobre GPT-5.6-Cyber nunca solicitarán Daybreak. La lección transferible sigue valiendo la pena, porque es la misma que no dejamos de reaprender en eesel.
Lo difícil de lanzar un modelo capaz nunca fue la capacidad. Es la superficie de control a su alrededor. Mira lo que OpenAI construyó de verdad aquí: no un modelo desbloqueado, sino un sistema de niveles, una verificación de identidad, una definición de alcance, un modo de revisión automática, una capa de supervisión y la obligación de llaves de hardware. El modelo fue la parte fácil.
Es la misma razón por la que la distinción entre agente de IA y chatbot importa más que la elección del modelo, y por la que la IA frente al soporte humano rara vez se decide por puntuaciones de benchmark.
Reconozco esa forma desde el otro lado de la mesa. En tres años poniendo agentes de IA en colas de soporte reales, he visto cómo trato tras trato dependía de la revisión y no de la demo. Un comprador danés de telemática no dejó pasar ni un solo ticket hasta quedar convencido de que los datos con números de tarjeta y contraseñas se quedaban dentro de su entorno. Un equipo de soporte de Bruselas con 400 a 500 tickets al mes nunca superó su revisión interna ISO. En ninguna de esas conversaciones nadie preguntaba si la IA era lo bastante lista.
Por eso construimos eesel como lo hicimos. Antes de que un agente de IA responda a un solo cliente real, puedes simularlo sobre miles de tus propios tickets históricos y ver exactamente qué habría dicho, y luego acotarlo a los tipos de ticket en los que confías. Es el mismo instinto que la guía de sandbox y alcance de Daybreak, apuntado a una cola de soporte en lugar de a un heap de V8.
Los paralelismos continúan. Los permisos acotados son como pensamos en el cumplimiento normativo de los chatbots, registrar cada acción es lo que hace llevaderas las revisiones de seguridad del helpdesk, y la versión más estricta de todo esto aparece en la IA conforme a HIPAA. Nada de esto trata del modelo.
Prueba eesel
Si diriges un equipo de soporte y no un red team, el nivel del modelo importa menos que lo que lo rodea. eesel se conecta a tu helpdesk actual, aprende de tus tickets pasados y de tu centro de ayuda, y te permite probarlo todo con conversaciones históricas antes de que se acerque a un cliente.
Tú eliges qué tipos de ticket gestiona y escalas el resto, así que no hay un momento de apretar el interruptor. Cada acción de herramienta que realiza el agente queda registrada, y puedes poner las sensibles tras una aprobación humana, la versión para el servicio de soporte del modo de revisión automática. La configuración lleva minutos en lugar de un ciclo de verificación, y es gratis probarlo.
