

Mi veredicto de un vistazo
Trabajo cada día en la cola de soporte de eesel, así que cuando sale un modelo lo leo con una pregunta en mente: ¿el cliente espera menos o recibe una respuesta mejor? Haiku 5.5 es el primer Claude pequeño en el que la respuesta es un sí claro para una buena parte de los tickets. La tabla completa está abajo.
| Qué revisé | Veredicto | El número detrás |
|---|---|---|
| Precio por debajo de 100k tokens | Excelente | $0.10 entrada / $0.50 salida, 90% por debajo de Haiku 4.5 |
| Precio por encima de 100k tokens | Mediocre | $0.50 / $2.50, Luna sigue siendo más barato aquí |
| Inteligencia | La mejor de su clase | 43 en AA, frente a 38 de GPT-6 Luna |
| Velocidad | Excelente | 137-243 tokens/s en AA, según el nivel de esfuerzo |
| Programación agéntica | Débil | 39,2% en Terminal-Bench 4.0 frente a 70,6% de Sonnet 5.5 |
| Eficiencia de tokens | Pobre con esfuerzo alto | ~162k tokens de salida por tarea de AA en Max, ~3x Luna |
| Alucinación | Mejor que los rivales, aún real | 40% en AA-Omniscience frente a 77% de Luna |
| Esfuerzo de migración | Medio | 6 cambios incompatibles, incluidos temperature y prefill |
Qué es Claude Haiku 5.5
Claude Haiku 5.5 es el modelo pequeño y rápido de Anthropic, lanzado el 7 de octubre de 2026 con el ID de modelo claude-haiku-5-5. Anthropic lo plantea para "high-volume, cost-sensitive tasks" como resúmenes, compactación, clasificación y consultas a bases de datos, y como subagente de Opus 5.5 y Sonnet 5.5 en trabajo de programación.
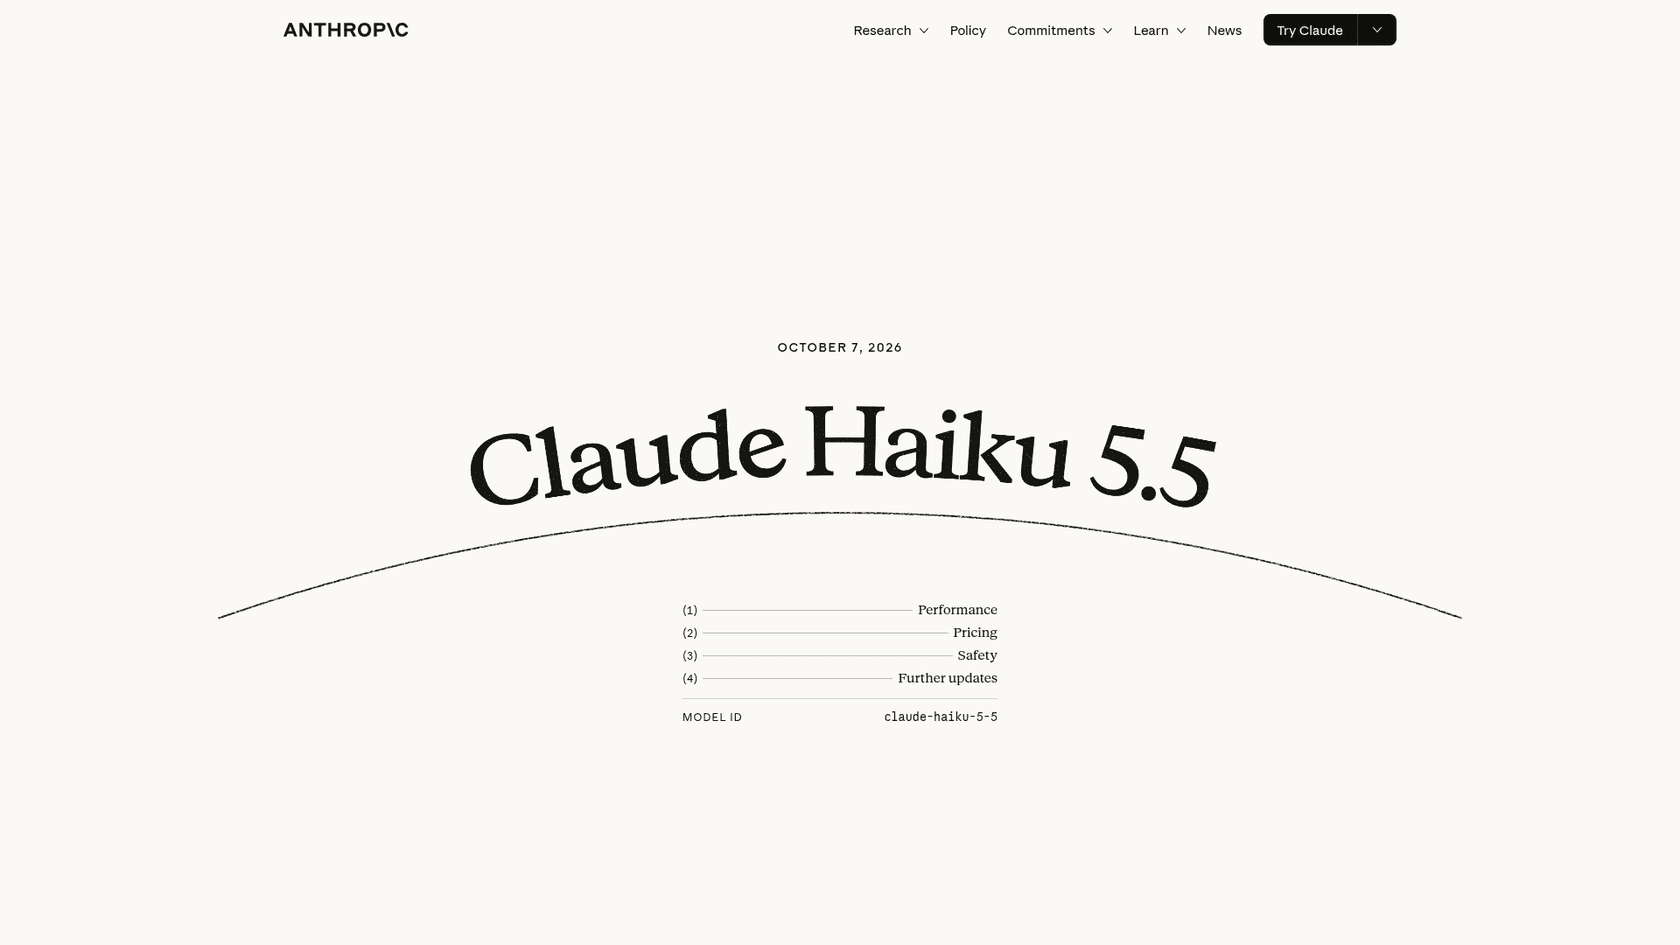
La ficha técnica es un gran salto respecto a Haiku 4.5. La ventana de contexto crece de 200k a 1M de tokens, la salida máxima pasa de 64k a 128k y el corte de conocimiento se mueve a junio de 2026. Además es el primer Haiku con esfuerzo ajustable y thinking adaptativo, y ese thinking viene activado por defecto en Medium.
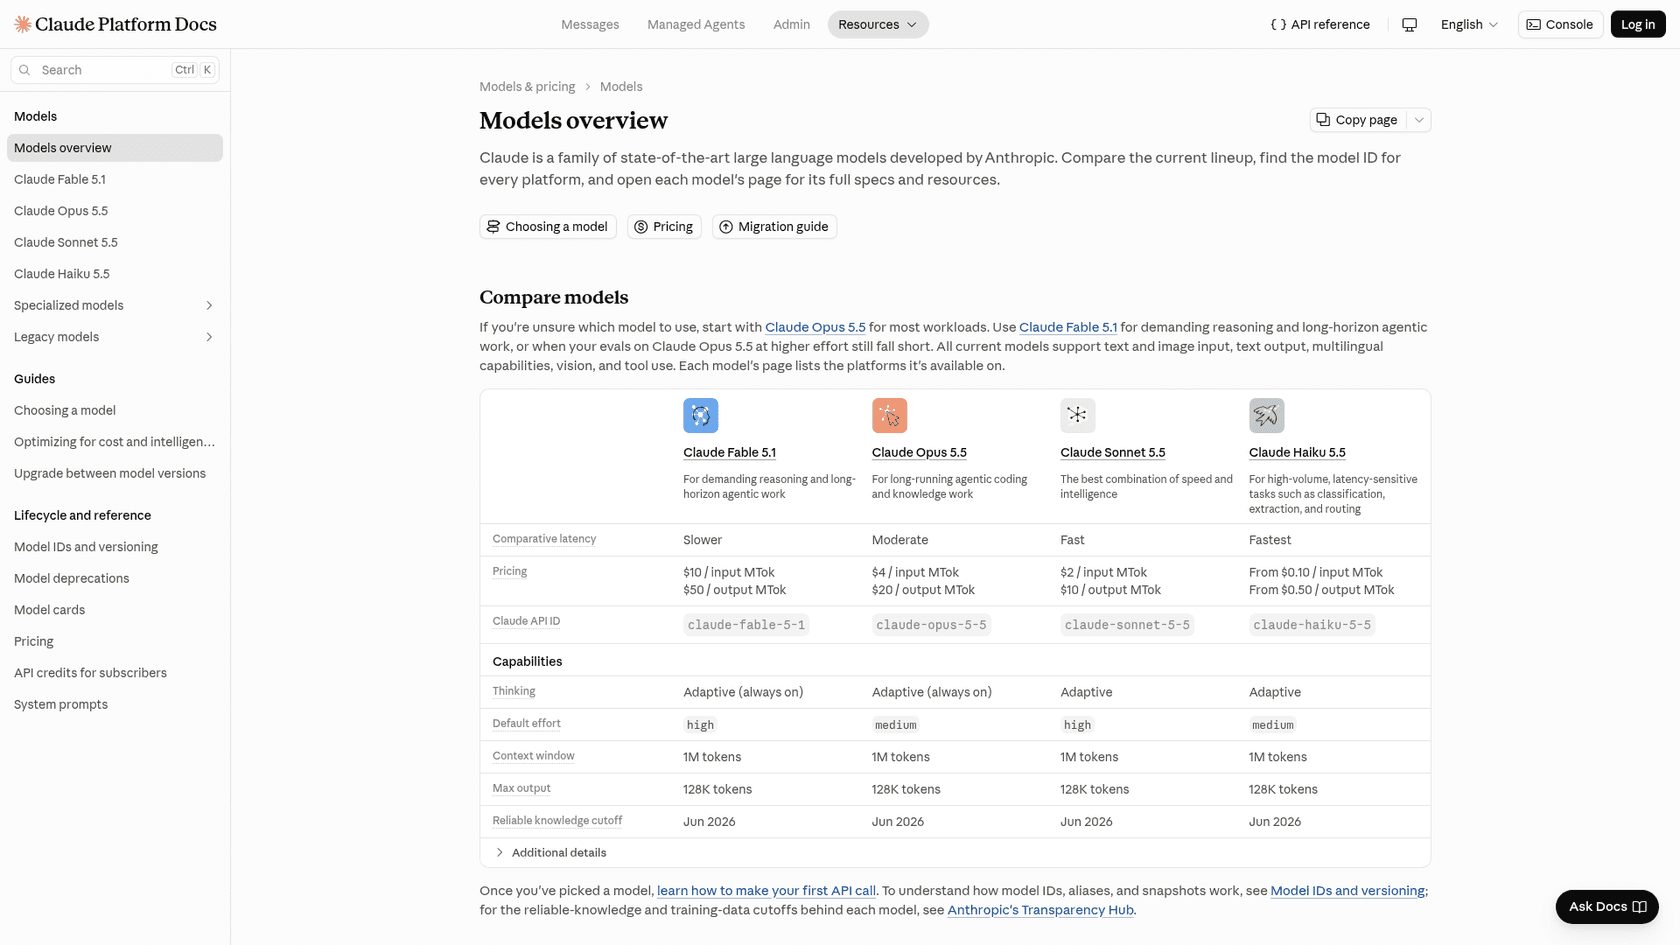
El resumen de modelos lo describe como el modelo "for high-volume, latency-sensitive tasks such as classification, extraction, and routing." Esa frase es, creo, un buen resumen de dónde brilla y dónde no.
Dónde Claude Haiku 5.5 es fuerte
Hay mucho que gusta aquí, y las mejoras sobre Haiku 4.5 no son pequeñas, así que veamos dónde se gana su lugar.
Se acerca a Sonnet 5.5 en la mayor parte del trabajo
En los benchmarks de lanzamiento de la propia Anthropic, Haiku 5.5 alcanza 1620 en GDPval-AA frente a 1840 de Sonnet 5.5, y 72,4% en OSWorld 2.1 frente a 83,9%. Para un modelo que cuesta una vigésima parte del precio de entrada de Sonnet, es un resultado llamativo.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (trabajo de conocimiento) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (uso del ordenador) | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam, sin herramientas | 45,9% | 10,2% | n/a | 56,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1 | 46,4% | n/a | 42,4% | 52,1% (Xhigh) |
| Chartography, sin herramientas | 46,4% | 6,4% | 29,1% | 61,6% |
El patrón se ve mejor al dividir cada puntuación de Haiku entre la de Sonnet, que es lo que hace el gráfico de abajo.
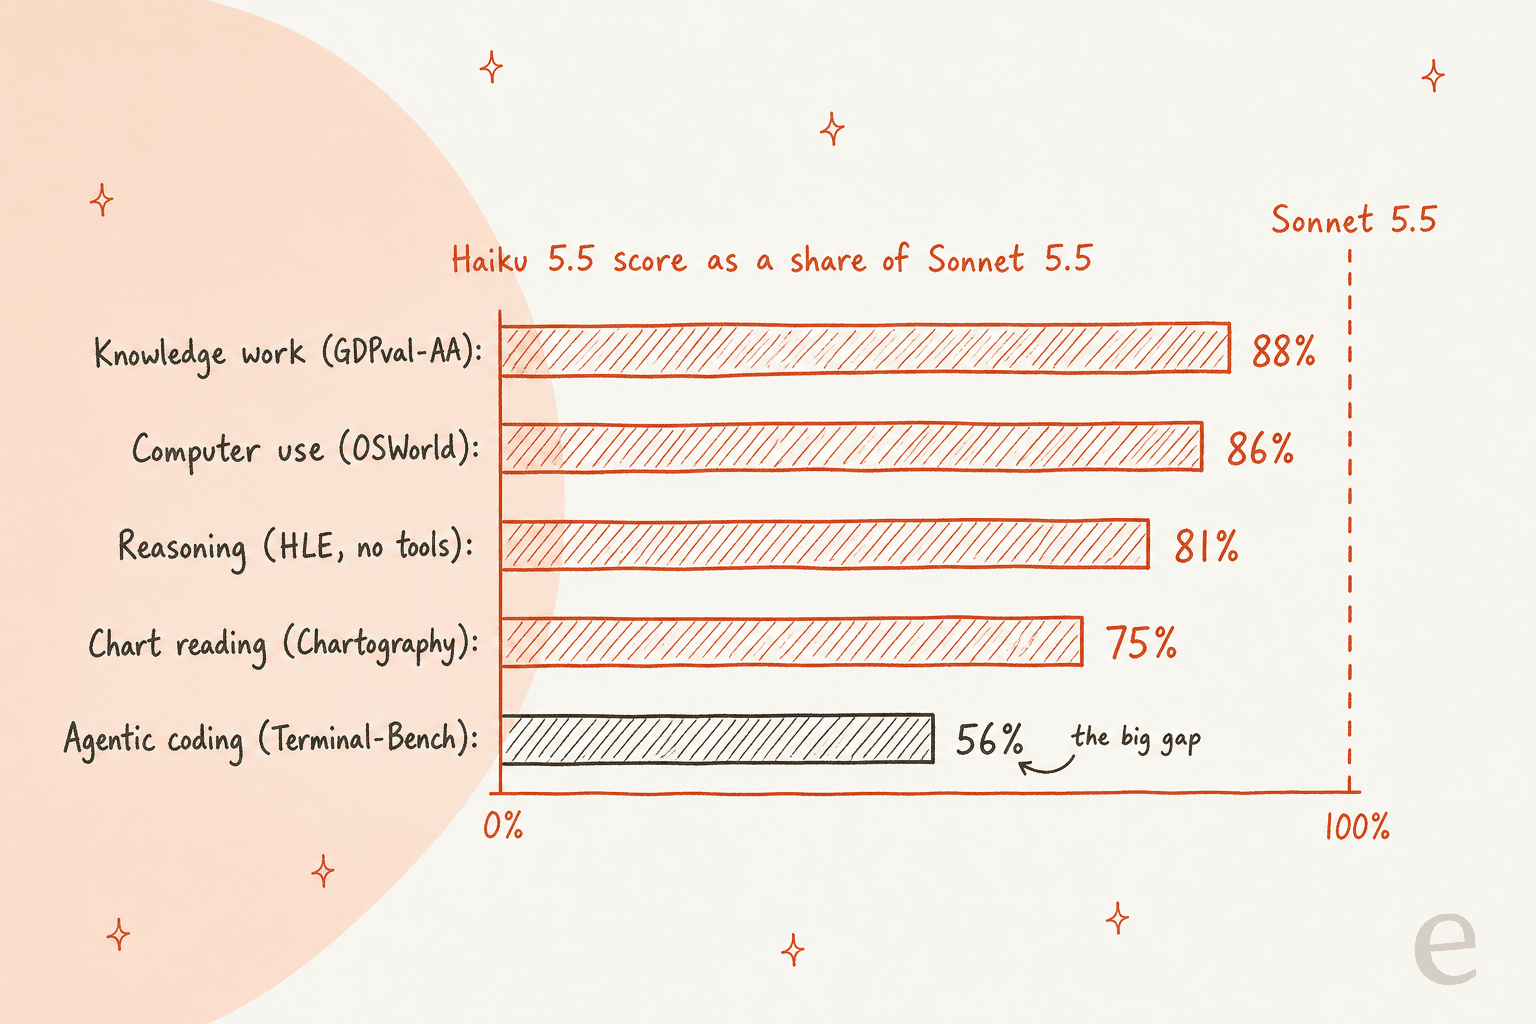
En trabajo de conocimiento y uso del ordenador, Haiku 5.5 te da el 86-88% de Sonnet 5.5. En programación agéntica te da el 56%. Esa brecha indica exactamente qué trabajos asignarle.
Supera a GPT-6 Luna en inteligencia y alucinación
Artificial Analysis sitúa a Haiku 5.5 en 43 en su Intelligence Index con esfuerzo Max, por delante de GLM-5.3 Flash (42), Gemini 3.8 Flash (41) y GPT-6 Luna (38). También encontró que Haiku está más dispuesto a decir que no sabe algo, con una tasa de alucinación del 40% en AA-Omniscience frente al 77% de Luna.
"Haiku 5.5 is noticeably smarter than GPT-6 Luna, so I can see their pricing strategy here. For a while Anthropic has lacked a cost effective "cheap" LLM for summarisation, compacting, RAG helpers, etc."

Es rápido
Anthropic lo llama "our fastest model to date" a velocidad estándar. Artificial Analysis midió de 137 a 243 tokens de salida por segundo según el esfuerzo, frente a 128 de Luna en Max y 90 de Haiku 4.5. Los reportes de clientes coinciden: Asana vio "over a 30% reduction in latency for task completions" en sus evaluaciones de AI Teammates, y Box midió 11 puntos más que Haiku 4.5 "at about half the latency."
La velocidad no es una métrica de vanidad en soporte. Un comprador con el que hablé hizo una evaluación metódica de 67 pruebas de una solución de chat con IA, encontró las respuestas sólidas y aun así se fue porque el widget de chat era, en sus palabras, "slow and often gets stuck." Una gran respuesta que llega tarde se siente simplemente como un producto roto.
Es fuerte en trabajo corto y fundamentado
Las mejores citas de clientes del lanzamiento tratan todas de tareas estrechas y repetidas. HubSpot reportó 92,8% en su suite de evaluación de CRM, "the best score we've seen on this suite yet", con la tasa de falsos positivos más baja en una auditoría de registros obsoletos. AlphaSense vio un salto estadísticamente significativo en su Q&A de documentos de 8M de llamadas por semana, de 0,76 a 0,84.
La comunidad encontró lo mismo en trabajo con mucha recuperación de información.
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Esa es la forma de la mayoría de los tickets de soporte: lees unos artículos de ayuda y el ticket, y luego respondes la pregunta. Por eso creo que Haiku 5.5 importa más para la clasificación de tickets con IA y el resumen de tickets que para programar.
Funciona como modelo auxiliar
El planteamiento de Anthropic es Haiku como subagente de un modelo mayor, y los primeros reportes lo respaldan. Rogo usa un subagente Haiku 5.5 para extraer una línea de ingresos de un 10-K mientras un modelo mayor construye la presentación. Cognition dice que su configuración Devin Fusion, con Opus 5.5 como líder y Haiku 5.5 como auxiliar, "holds a top-tier FrontierCode score of 66.2 while cutting cost and latency."
Un probador de Hacker News incluso vio cómo delegaba por su cuenta una compleja construcción de UI a Opus, y notó que "at least knows what it isn't good at." Si ya usas subagentes de Claude Code, la configuración de Haiku en Claude Code es el lugar obvio para probarlo primero.
Dónde se queda corto Claude Haiku 5.5
Ninguno de estos puntos es un impedimento por sí solo, pero en conjunto deciden si Haiku 5.5 te ahorra dinero o te cuesta en silencio más de lo previsto.
El precipicio de precio a los 100k tokens
Este es el grande. Haiku 5.5 es el único modelo Claude actual sin precio plano a lo largo de toda su ventana de contexto. Según la documentación de precios, un prompt de más de 100.000 tokens paga la tarifa más alta en todas las líneas: entrada, salida y caché.
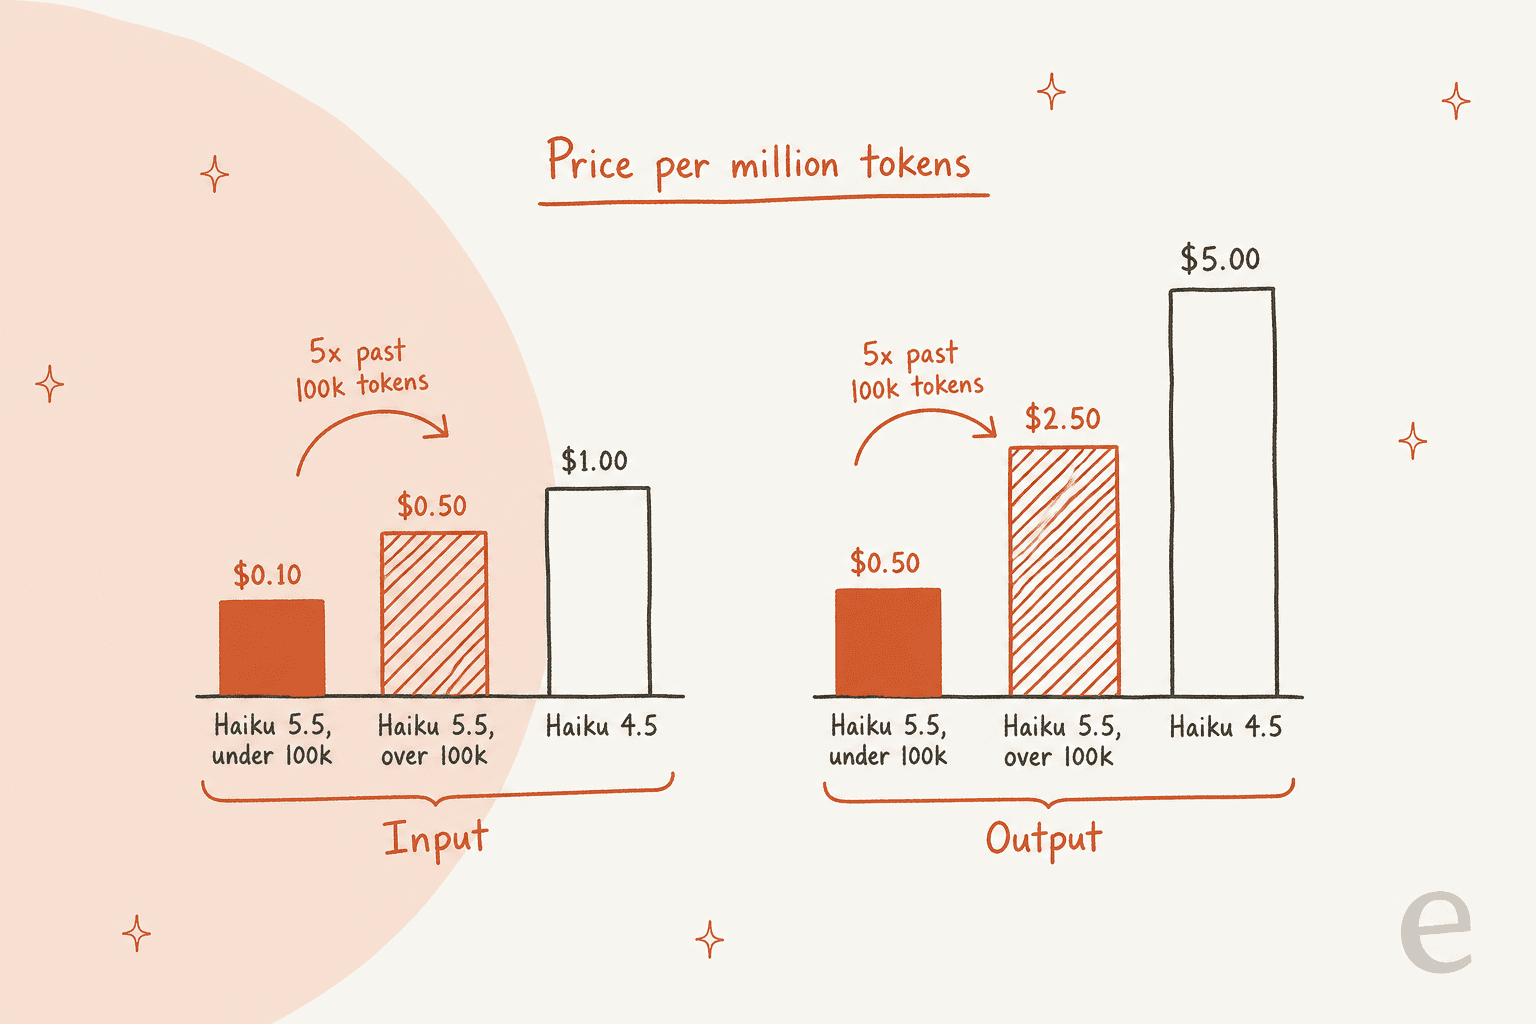
Anthropic dice que los prompts por debajo de 100k suponen alrededor del 90% de las solicitudes al Haiku anterior, así que la mayoría de los trabajos clásicos de Haiku caen en el nivel barato. Los bucles de agente son otra historia, porque el historial de conversación se acumula rápido.
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value"
El artículo de lanzamiento de Simon Willison plantea bien el compromiso: por debajo de 100k, Haiku iguala el precio de Luna con mejores puntuaciones, pero "Above 100,000 tokens, Luna looks like a much better deal." El propio salto de precio de Luna llega a los 272k tokens y solo sube a $0.20/$0.75.
Un nuevo tokenizador añade tokens en silencio
La guía de migración dice que el mismo texto produce "approximately 30% more tokens than on Haiku 4.5." Simon Willison midió cerca de 1,25x en un prompt largo y lo llamó "a hidden price increase." También significa que llegas a la línea de 100k antes de lo que sugiere el recuento de caracteres.
Un probador puso números reales con un trabajo de clasificación.
| Modelo | Tokens de entrada | Tokens de salida | Coste en batch | Coste síncrono |
|---|---|---|---|---|
| Haiku 5.5 | 11,893,643 | 240,451 | $0.21 | $0.42 |
| GPT-6 Luna | 7,903,468 | 177,602 | $0.16 | $0.31 |
Esas cifras vienen de Farmadupe en Hacker News. Mismo precio por token, pero Luna salió un 26% más barato en el mismo trabajo porque necesitó menos tokens para leer y escribir lo mismo.
El esfuerzo Max es un horno de tokens
Los ajustes de esfuerzo son nuevos en Haiku, y el extremo superior es caro. Artificial Analysis encontró que Haiku 5.5 en Max usa alrededor de 162k tokens de salida por tarea del Intelligence Index, unas 3 veces Luna en Max. Su tiempo hasta el primer token en Max fue de 415 segundos.
| Esfuerzo | AA Intelligence Index | Coste de ejecutar el índice | Tokens de salida | Tiempo hasta el primer token |
|---|---|---|---|---|
| Low | 29.4 | $34.31 | 32M | 13.6s |
| Medium (por defecto) | 34.5 | $56.36 | 54M | 14.2s |
| High | 37.8 | $94.07 | 97M | 26.2s |
| Xhigh | 41.2 | $157.58 | 180M | 86.8s |
| Max | 43.4 | $330.25 | 440M | 415.3s |
Pasar de Medium a Max añade 9 puntos por casi 6 veces el coste. Artificial Analysis también señala que estos costes aún no incluyen el salto de precio de 100k, así que las tareas largas saldrán más caras que lo que indica la tabla. La prueba del pelícano de Simon Willison muestra lo mismo en miniatura: Low tardó 7 segundos y costó 0,0936 centavos, y Max tardó 5 minutos y 9 segundos.
Para chat en vivo, vale la pena probar con tus propios tickets el tiempo hasta el primer token en Medium de ese benchmark (unos 14 segundos), ya que el thinking adaptativo se ejecuta antes de que empiece la respuesta. La documentación dice que un esfuerzo menor permite al modelo saltarse el thinking en solicitudes simples, y el thinking aún puede desactivarse con esfuerzo High o inferior.
Todavía se equivoca en hechos cuando no tiene nada que leer
La system card de Anthropic es franca en esto. En la prueba a libro cerrado AA-Omniscience, Haiku 5.5 respondió correctamente un 44%, incorrectamente un 32% y se abstuvo en un 24%. Es mejor que Haiku 4.5 en términos netos, pero una tasa de error de aproximadamente uno de cada tres en preguntas que no puede consultar es justo la razón por la que un modelo de soporte necesita tu base de conocimiento delante.
La system card también señala que rechazó solicitudes en exceso más que cualquier otro modelo en la auditoría automatizada de comportamiento, y Artificial Analysis dice que su puntuación de AutomationBench de 35% está "likely understated" por un problema de rechazo excesivo previo al lanzamiento que Anthropic está corrigiendo.
Tus propias evaluaciones pueden discrepar
No a todos les fueron bien las pruebas el primer día, y creo que vale la pena escucharlo antes de activar un cambio en producción.
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Un segundo comentarista respondió que sus evaluaciones y pruebas humanas por pares también situaron a Haiku 4.5 primero, y que estaba reajustando sus prompts como resultado. Haiku 4.5 sigue figurando como activo, con retirada no antes del 15 de octubre de 2026, así que hay una ventana para ejecutar ambos en paralelo.
Qué se rompe al migrar
La página de novedades enumera varios cambios incompatibles. Para bots de soporte y clasificadores, estos son los que muerden.
| Cambio | Qué pasa ahora | La solución |
|---|---|---|
| Presupuestos de thinking manuales | budget_tokens devuelve un 400 | Usa thinking adaptativo más effort |
| Parámetros de muestreo | Cualquier top_k, o temperature distinto de 1, devuelve un 400 | Elimínalos; guía con el prompt |
| Prefill del asistente | Devuelve un 400, incluso con thinking desactivado | Termina messages con un turno de usuario |
| Historial solo de adición | Editar system, herramientas o turnos anteriores y luego reenviar el thinking devuelve un 400 | Mantén el historial solo de adición |
| Herramienta de uso del ordenador | computer_20250124 se rechaza en la API y en Google Cloud | Pasa a computer_toolset_20260801 |
| Tokenizador | ~30% más tokens para el mismo texto | Recalcula max_tokens y presupuestos |
El cambio de temperature es el más traicionero para soporte. Muchos pipelines de triaje de tickets funcionan con temperature 0 para obtener etiquetas consistentes, y esa solicitud ahora falla directamente. El prefill es el otro truco habitual (a menudo usado para forzar una llave de apertura JSON), y también desapareció.
El tool_choice forzado sigue funcionando, lo cual es una buena noticia después de que Sonnet 5.5 lo eliminara. La pega es que una llamada de herramienta forzada vuelve sin bloque de thinking, según la guía de migración. Si quieres que el modelo razone antes de llamar a tu herramienta de reembolsos o de enrutamiento, usa auto e indícalo en el prompt.
Precios de Claude Haiku 5.5 en una tabla
Aquí está la tarifa completa de la documentación de precios de Claude, con Haiku 4.5 y Sonnet 5.5 como referencia. Todos los precios son por millón de tokens.
| Tarifa | Haiku 5.5, hasta 100k | Haiku 5.5, más de 100k | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| Entrada | $0.10 | $0.50 | $1.00 | $2.00 |
| Salida | $0.50 | $2.50 | $5.00 | $10.00 |
| Escritura en caché de 5 minutos | $0.125 | $0.625 | $1.25 | $2.50 |
| Escritura en caché de 1 hora | $0.20 | $1.00 | $2.00 | $4.00 |
| Lectura de caché | $0.01 | $0.05 | $0.10 | $0.10 |
| Batch entrada / salida | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 | $1.00 / $5.00 |
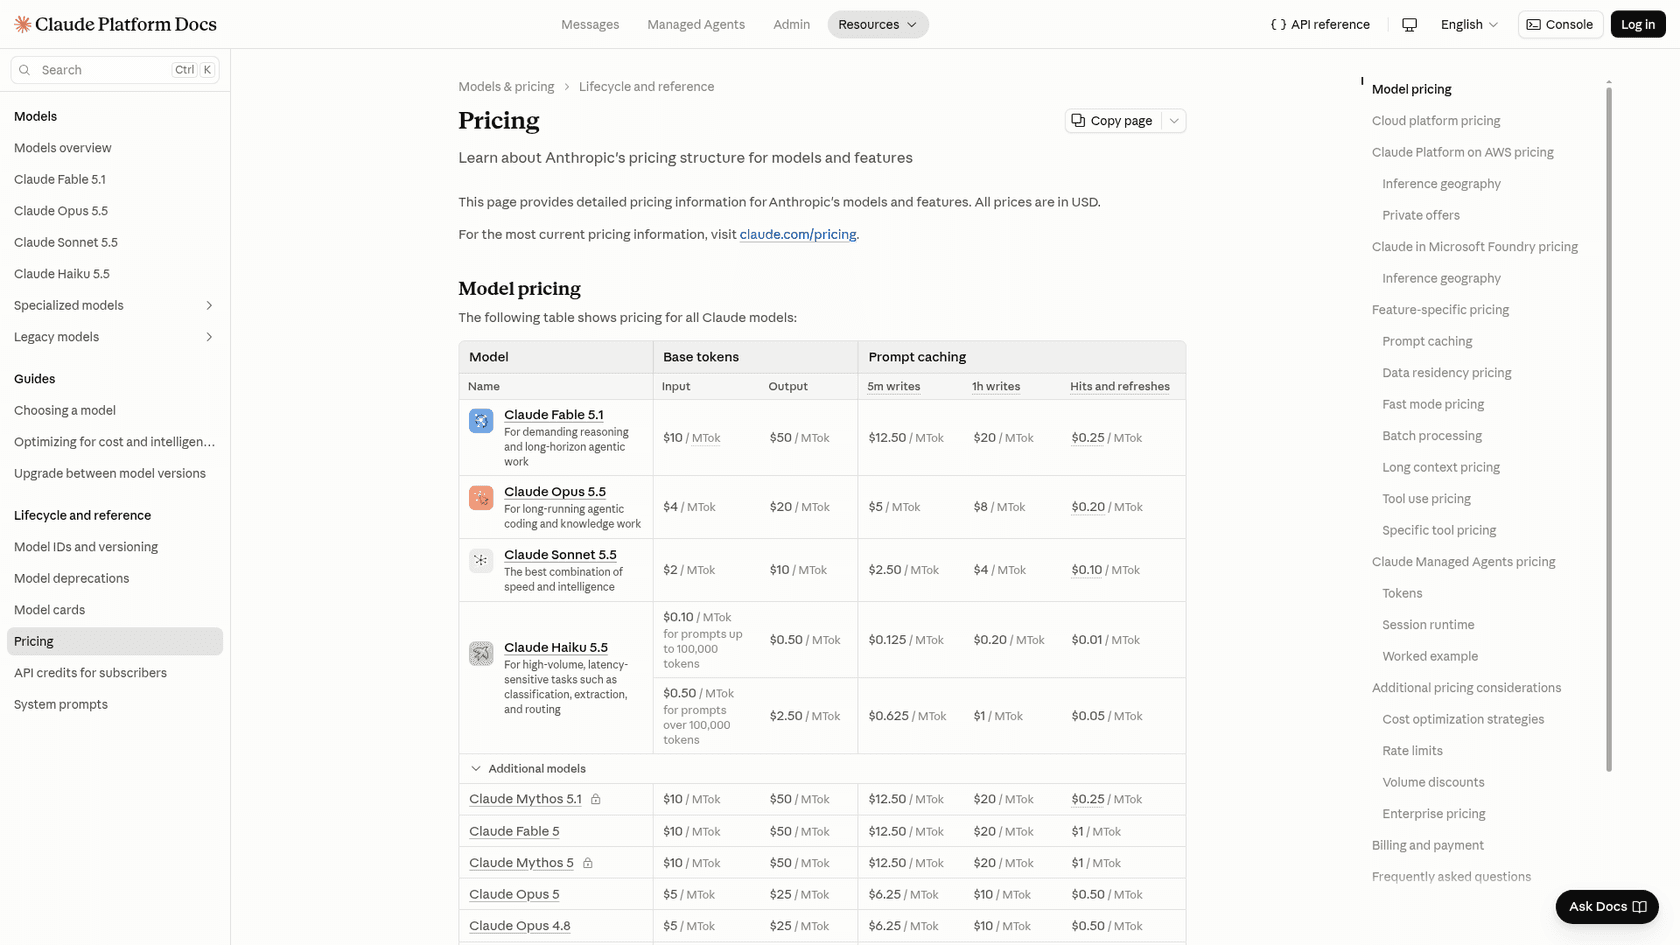
Para concretar, toma una respuesta de soporte con un prompt de 8.000 tokens (instrucciones, unos artículos de ayuda y el ticket) y 600 tokens de salida, thinking incluido. En Haiku 5.5 eso son unos $0.0011 por ticket, o aproximadamente $11 por 10.000 tickets. Si la misma conversación crece hasta un prompt de 150.000 tokens, solo la entrada cuesta $0.075, cinco veces lo que costaría por debajo del límite. No hay modo Fast para Haiku 5.5, y Anthropic también redujo a la mitad las lecturas de caché de Sonnet 5.5 a $0.10 el mismo día, lo que estrecha la brecha para agentes con mucha caché. Mi guía de precios de Sonnet 5.5 cubre ese lado.
Cómo lo usaría en una cola de soporte
La forma en que ejecutaría Haiku 5.5 en soporte se deriva bastante directamente de las fortalezas y los precipicios de arriba. Deja que haga el trabajo rápido, corto y de alto volumen en cada ticket, y pasa los difíciles hacia arriba.
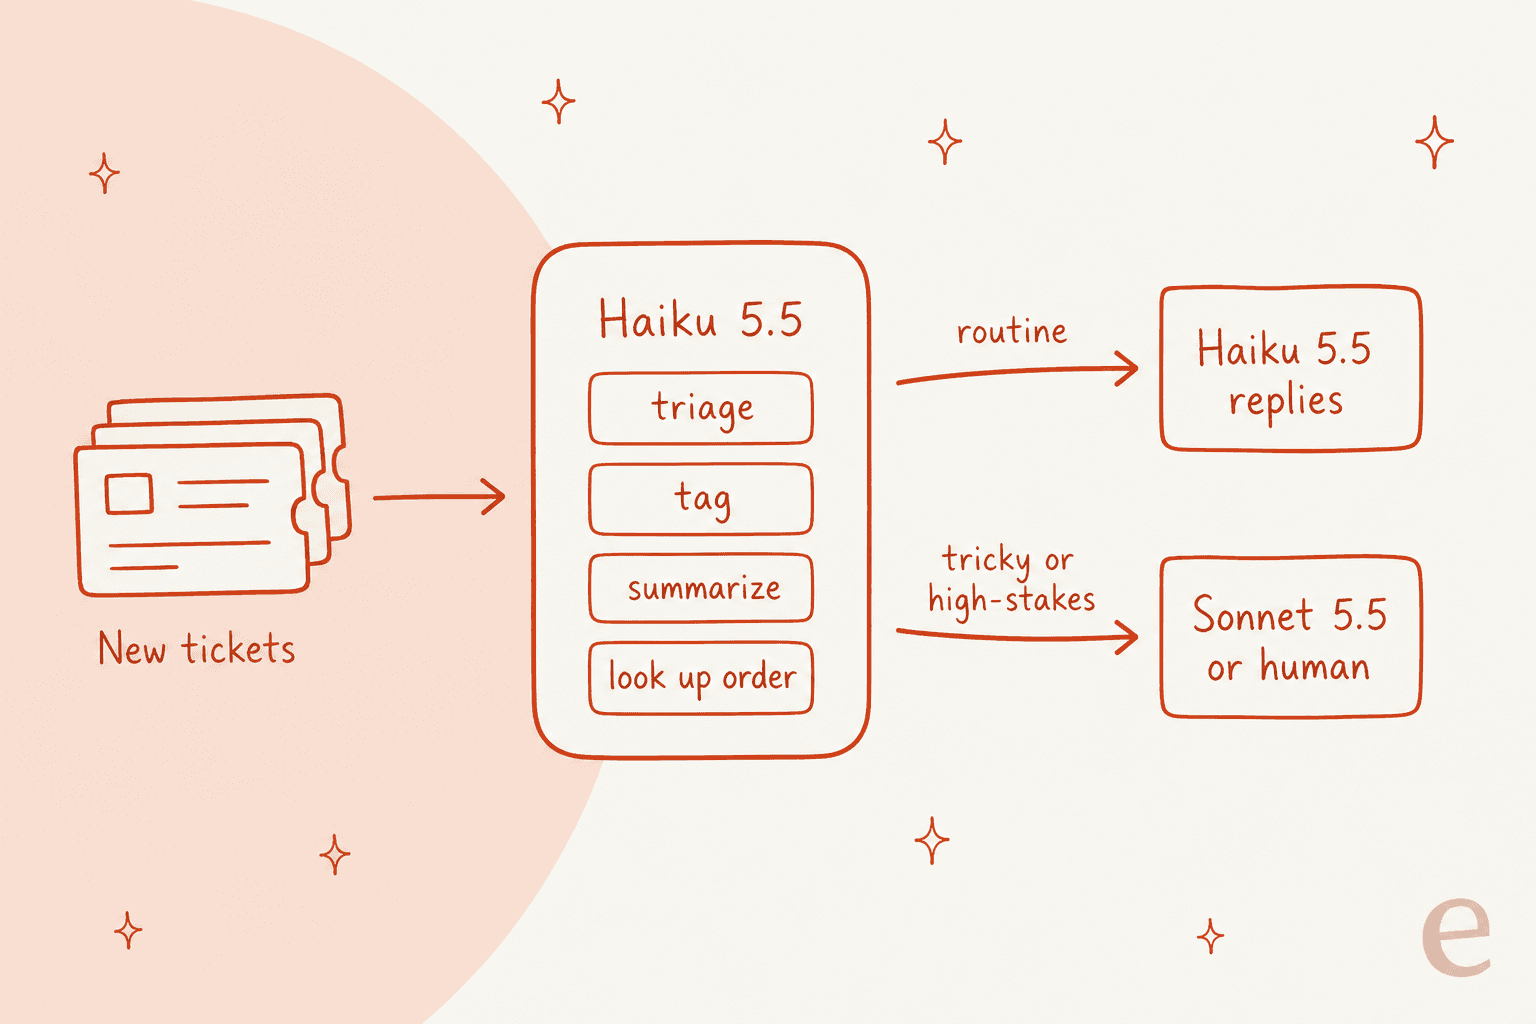
En la práctica eso significa:
- Triaje y etiquetado con esfuerzo Low. Prompts cortos, una lista fija de etiquetas, sin historial largo. Este es el trabajo para el que se creó el nivel de 100k, y también sirve para la priorización de tickets.
- Resúmenes y notas de traspaso con Medium. Lo bastante rápido para ejecutarse en cada ticket sin que nadie note el coste.
- Respuestas rutinarias, fundamentadas en tu centro de ayuda. Estado de pedidos, restablecimiento de contraseñas, plazos de devolución. Mantén recortado el contexto recuperado para que el prompt quede por debajo de 100k.
- Escala el resto. Disputas de reembolso, resolución de problemas en varios pasos y cualquier cosa con un hilo largo van a Sonnet 5.5 o a una persona.
Así es también, más o menos, una prueba real cuando sale bien. En una prueba de comercio electrónico con tráfico real de Zendesk, el triaje fue el trabajo más fuerte de la IA, con un 93% de precisión y 100% de detección de spam, mientras que los borradores completos necesitaron más ayuda de las respuestas anteriores del propio equipo. Un modelo pequeño y rápido encaja bien con ese primer trabajo, creo.
Qué dicen los desarrolladores
El hilo de lanzamiento en Hacker News superó los 770 puntos y 380 comentarios, y la reacción se dividió por una línea: a quienes tenían trabajos cortos y bien acotados les encantó, y quienes ejecutaban sesiones largas de agentes hicieron la cuenta del precipicio de 100k.
"Ran our DataAnalyticsBench benchmark on it: 9x cheaper than Haiku 4.5 and 2 letter grades better. It's also now the fastest model (using the default speeds, not trying any of the other models "Fast" mode) to complete the exam."
El mismo probador añadió que resolvió todas las preguntas de analítica sencillas pero se quedó corto en las que requerían un análisis estadístico más profundo, y que GPT-6 Luna lo hizo algo mejor, a un 30% del coste.
"With that said, the real reason to use Haiku is that it's faster than all of these models. OpenRouter is showing an average so far of 93 tokens/sec, and AA got at least 137 in each of their benchmarks. So it might be valuable for speed at lower thinking levels."
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
El equipo de Artificial Analysis lo resumió como "notably fast, however very verbose", lo que coincide con todo lo anterior.
Quién debería cambiar y quién esperar
Así lo decidiría yo, según el trabajo y no según el gráfico de benchmarks.
| Estás ejecutando | Mi decisión | Por qué |
|---|---|---|
| Clasificación, etiquetado, enrutamiento | Cambia, tras una evaluación breve | Nivel más barato, modelo más rápido, prompts pequeños |
| Respuestas RAG sobre un centro de ayuda | Cambia, mantén prompts por debajo de 100k | Buenos resultados fundamentados, ventana de 1M si la necesitas |
| Subagentes bajo un líder Sonnet u Opus | Cambia | El caso de uso que señalan Anthropic y los primeros clientes |
| Bucles de agente largos más allá de 100k tokens | Espera o elige Luna | Salto de precio de 5x más el tokenizador más pesado |
| Programación agéntica compleja | Quédate en Sonnet 5.5 | 39,2% frente a 70,6% en Terminal-Bench 4.0 |
| Pipelines que dependen de temperature 0 o prefill | Reserva tiempo de migración | Ambos devuelven ahora un error 400 |
Si lo comparas con opciones externas, mis artículos sobre alternativas a GPT-6 Luna, Gemini 3.8 Flash y Kimi K3 cubren el resto del campo de modelos pequeños y medianos.
Para soporte en concreto, la guía sobre qué LLM encaja con soporte va más allá.
Un modelo más rápido no arregla una respuesta equivocada
Una cosa que un análisis de modelo no puede mostrarte es que la mayoría de los fallos de bots de soporte que veo no tienen nada que ver con el modelo. Un equipo B2B de telemática de vehículos descubrió que su bot decía a los clientes que soportaba marcas de coches que no estaban en su base de datos. El modelo no se inventaba nada, para ser justos. Su base de conocimiento decía que soportaban "all models", y el bot se lo creyó. Haiku 5.5 habría dado la misma respuesta equivocada, solo que más rápido y barato.
Por eso cada despliegue de eesel se simula con tickets históricos antes de que el compañero hable con un cliente. Ese paso es donde detectas las lagunas de conocimiento que ninguna mejora de modelo puede arreglar, y con un modelo que se equivoca en el 32% de los hechos a libro cerrado importa todavía más.
Prueba eesel con modelos Claude rápidos en tu cola
Si lo que quieres de Haiku 5.5 es su velocidad en tus tickets, eesel es el atajo. Su compañero de helpdesk con IA se integra en tu helpdesk actual, como Zendesk, Freshdesk o Gorgias, aprende de tus tickets anteriores y tu centro de ayuda, y hace triaje, etiqueta y responde con un modelo de frontera por debajo. El precipicio de 100k, el ajuste de esfuerzo, los cambios incompatibles de arriba: todo eso pasa a ser problema de eesel y no tuyo.

Si vives en una terminal, la CLI de eesel opera el mismo compañero y espacio de trabajo que el panel. Puedes automatizarla con scripts o dejar que la maneje un agente de programación como Claude Code, que es el mismo patrón de líder y auxiliar de este análisis aplicado a tu configuración de soporte.
Mis artículos sobre la CLI de agentes de IA y los servidores MCP profundizan más.
Los planes de pago empiezan en $299 por 500 créditos, y puedes probarlo gratis primero con una parte de tus tickets reales. Prueba eesel y comprueba si un modelo más rápido se traduce de verdad en respuestas más rápidas para tus clientes.
¿Vale la pena Claude Haiku 5.5?
Sí, si tu trabajo es corto y repetitivo. Por debajo de 100k tokens de prompt y con esfuerzo Low o Medium, Claude Haiku 5.5 es el mejor modelo pequeño que he visto de Anthropic: más inteligente que GPT-6 Luna al mismo precio de lista y más rápido que cualquier otro que venda Anthropic, y queda lo bastante cerca de Sonnet 5.5 en trabajo de conocimiento como para asumir una gran parte de una cola de soporte.
Pasada cualquiera de las dos líneas, la cuenta se invierte: las sesiones largas de agentes pagan 5x, el esfuerzo Max quema tokens y el nuevo tokenizador adelanta ambas cosas. Ejecuta tu propia evaluación contra Haiku 4.5 mientras siga disponible, mantén los prompts recortados y deja que los modelos mayores se ocupen de lo que Haiku 5.5 les pase.