

Por qué la gente busca alternativas a Claude Haiku 5.5
Empiezo por la buena noticia, porque Haiku 5.5 la merece. Claude Haiku 5.5 salió el 7 de octubre de 2026, puntúa 43 en el Intelligence Index de Artificial Analysis, por delante de cualquier otro modelo pequeño de este artículo, genera 243 tokens por segundo y, por debajo de 100.000 tokens de prompt, cuesta $0.10 de entrada y $0.50 de salida por millón. Lo cubrí todo en mi reseña de Haiku 5.5.
En eesel yo escribo la fontanería de la API, así que leo lanzamientos como este desde el lado de la integración. Mis preguntas son qué se rompe, cuánto cuesta con una carga real y qué tengo que reescribir. Con esas comprobaciones, veo cuatro razones por las que un equipo podría decidir que Haiku 5.5 no es su modelo.
- El precipicio de los 100k. Según la documentación de precios de Claude, un prompt de más de 100.000 tokens paga $0.50 de entrada y $2.50 de salida, más 5 veces en lecturas y escrituras de caché. Haiku 5.5 es el único modelo Claude actual sin precio plano en toda su ventana de 1M.
- El tokenizador. La página de novedades dice que el mismo texto produce "approximately 30% more tokens" que en Haiku 4.5. Pagas por más tokens y llegas antes a la línea de los 100k.
- Cambios de API que rompen cosas. Cualquier
temperature,top_potop_kdistinto del valor por defecto devuelve ahora un error, igual que el prefill del asistente. Muchos clasificadores se construyeron justo sobre esos dos trucos, por eso este duele. - Verbosidad. Artificial Analysis contó 440M de tokens generados en su índice para Haiku 5.5 frente a 140M de GPT-6 Luna. Mismo precio de lista y, aun así, una factura unas 3 veces mayor por el mismo trabajo.
Para ser justos, Hacker News hizo las cuentas de los prompts largos una hora después del lanzamiento.
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."

Así que la alternativa correcta depende de cuál de esos cuatro te afectó, y este es el mapa que uso.
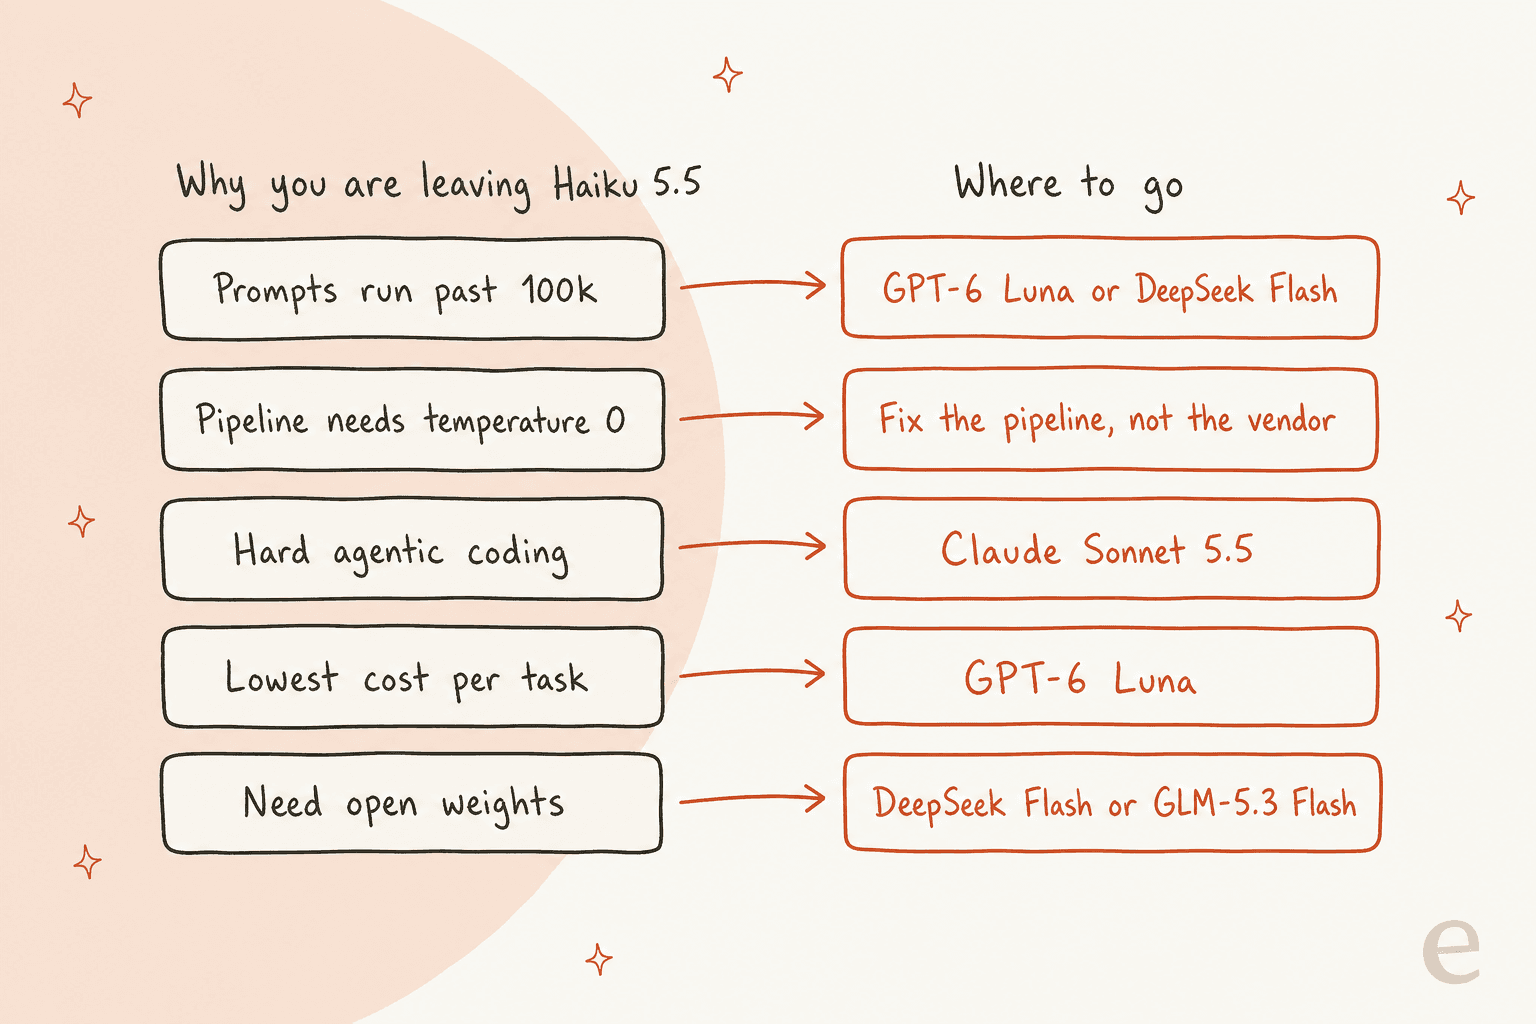
Alternativas a Claude Haiku 5.5 de un vistazo
Cada precio de abajo es por millón de tokens a tarifas estándar, comprobado en la página de precios de cada proveedor el 8 de octubre de 2026. Las columnas de Artificial Analysis (AA) usan su Intelligence Index v4.3.2 al nivel de esfuerzo que AA reporta.
| Modelo | Entrada / salida | Regla de prompt largo | Contexto | Índice AA | Coste AA por tarea | Velocidad de salida | Temperature 0 | Pesos abiertos | Mejor para |
|---|---|---|---|---|---|---|---|---|---|
| Claude Haiku 5.5 (referencia) | $0.10 / $0.50 | 5x en cada línea pasados 100k | 1M | 43 | $0.21 | 243 tok/s | Error | No | Trabajos cortos, listos y rápidos |
| GPT-6 Luna | $0.10 / $0.50 | 2x entrada, 1.5x salida pasados 272k | 1.05M | 38 | $0.07 | 128 tok/s | Solo con esfuerzo none | No | Menor coste por tarea |
| Claude Haiku 4.5 | $1 / $5 | Plano | 200k | n/d | n/d | n/d | Funciona | No | Ganar tiempo con prompts antiguos |
| Claude Sonnet 5.5 | $2 / $10 | Plano | 1M | 56 (max) | $7.60 (max) | n/d | Error | No | Razonamiento y programación difíciles |
| DeepSeek V4.1 Flash | $0.30 / $1.20 en punta, mitad fuera de punta | Plano | 1M | 39 | $0.27 (punta) | n/d | Ignorado en modo thinking | Sí, MIT | Prompts largos con presupuesto ajustado |
| GLM-5.3 Flash | $0.15 / $0.50 | Plano | 1M | 42 | $0.25 | 51 tok/s | Thinking siempre activo | Sí | Pesos abiertos cerca de la puntuación de Haiku |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | Plano | 1M | 22 | $0.19 | 346 tok/s | Google aconseja 1.0 | No | Rendimiento bruto |
| Gemini 3.8 Flash | $0.75 / $3.75 (se duplica el 1 de enero de 2027) | Plano | 1M | 41 (high) | $1.24 | n/d | Google aconseja 1.0 | No | Tareas largas de agentes en el stack de Google |
Una nota sobre la columna de velocidad: "n/d" significa que no tenía una lectura de AA del mismo día en la que confiar, no que el modelo sea lento.
Cómo los elegí
Limité la lista a modelos a los que un usuario de Haiku 5.5 podría pasarse esta semana: de disponibilidad general, con precio público y en el mismo nivel de pequeño y rápido, más un escalón arriba (Sonnet 5.5) y uno atrás (Haiku 4.5). Comprobé cada precio en la página del proveedor, cada comportamiento de API en la documentación del proveedor y cada benchmark en Artificial Analysis en lugar de en gráficos de lanzamiento.
La métrica en la que más me apoyo es el coste por tarea terminada, no el precio por token. Haiku 5.5 y Luna tienen precios por token idénticos pero facturas muy distintas, que es toda la historia de este nivel.
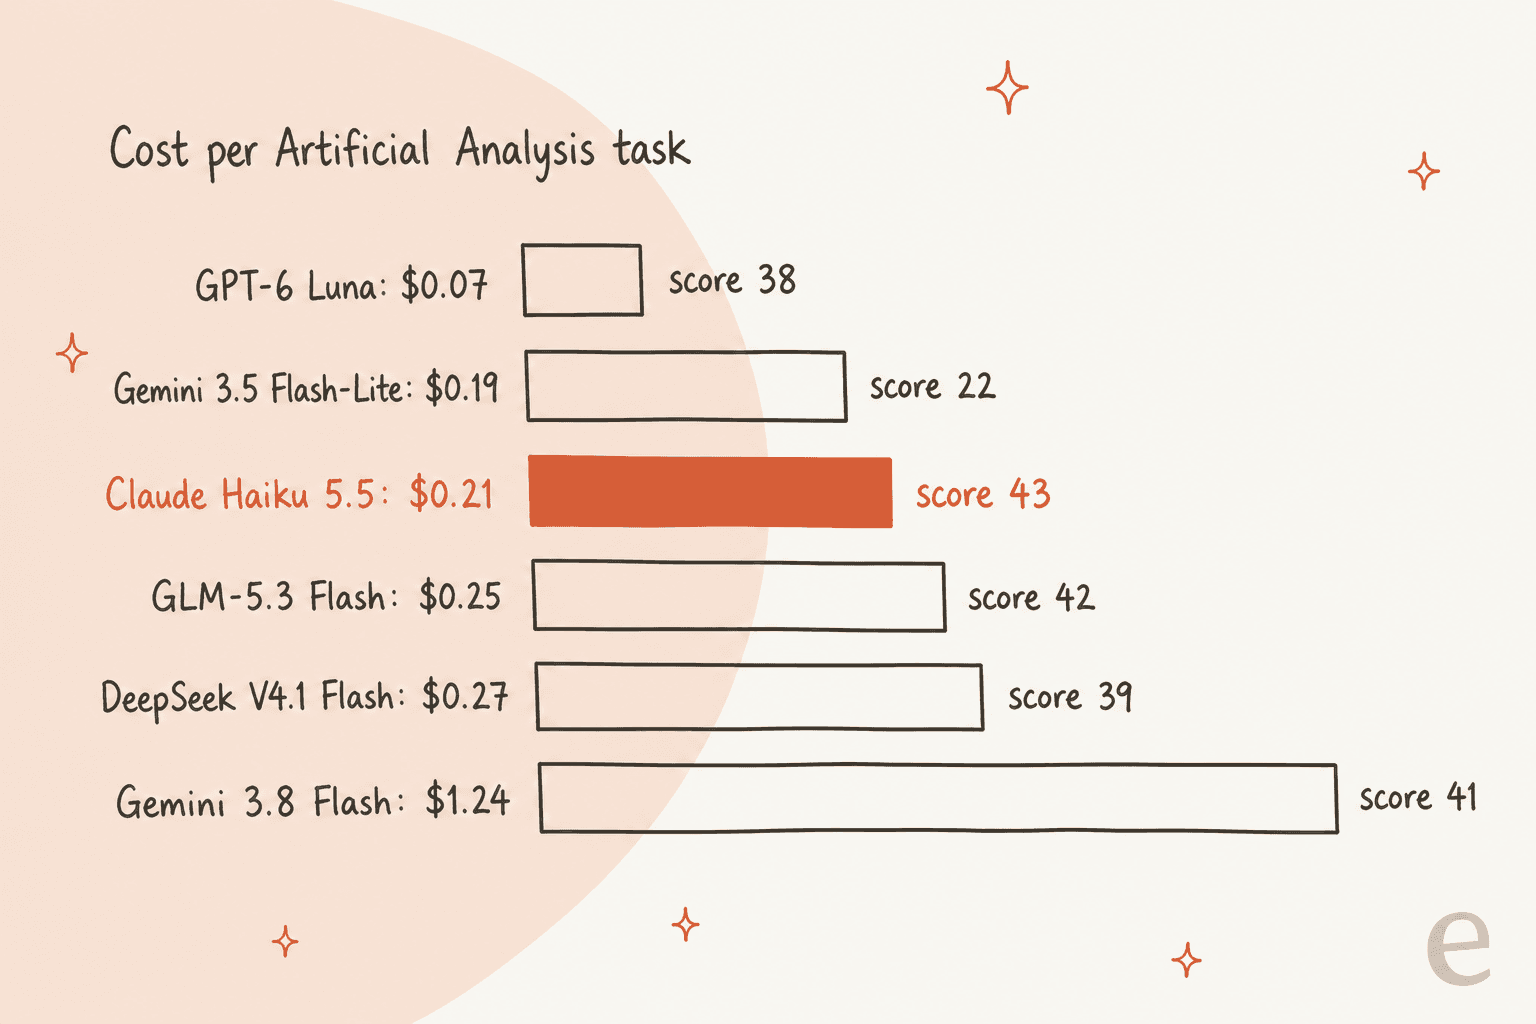
Lee ese gráfico como un intercambio, no como un ranking. Haiku 5.5 te da 5 puntos más de índice que Luna por 3 veces el coste por tarea. Que valga la pena depende de si tu tarea es de las que notan esos 5 puntos.
1. GPT-6 Luna
Mejor para: equipos que quieren precios de Haiku sin el precipicio de los 100k, y la factura más baja por trabajo terminado.
Qué hace mejor que Haiku 5.5
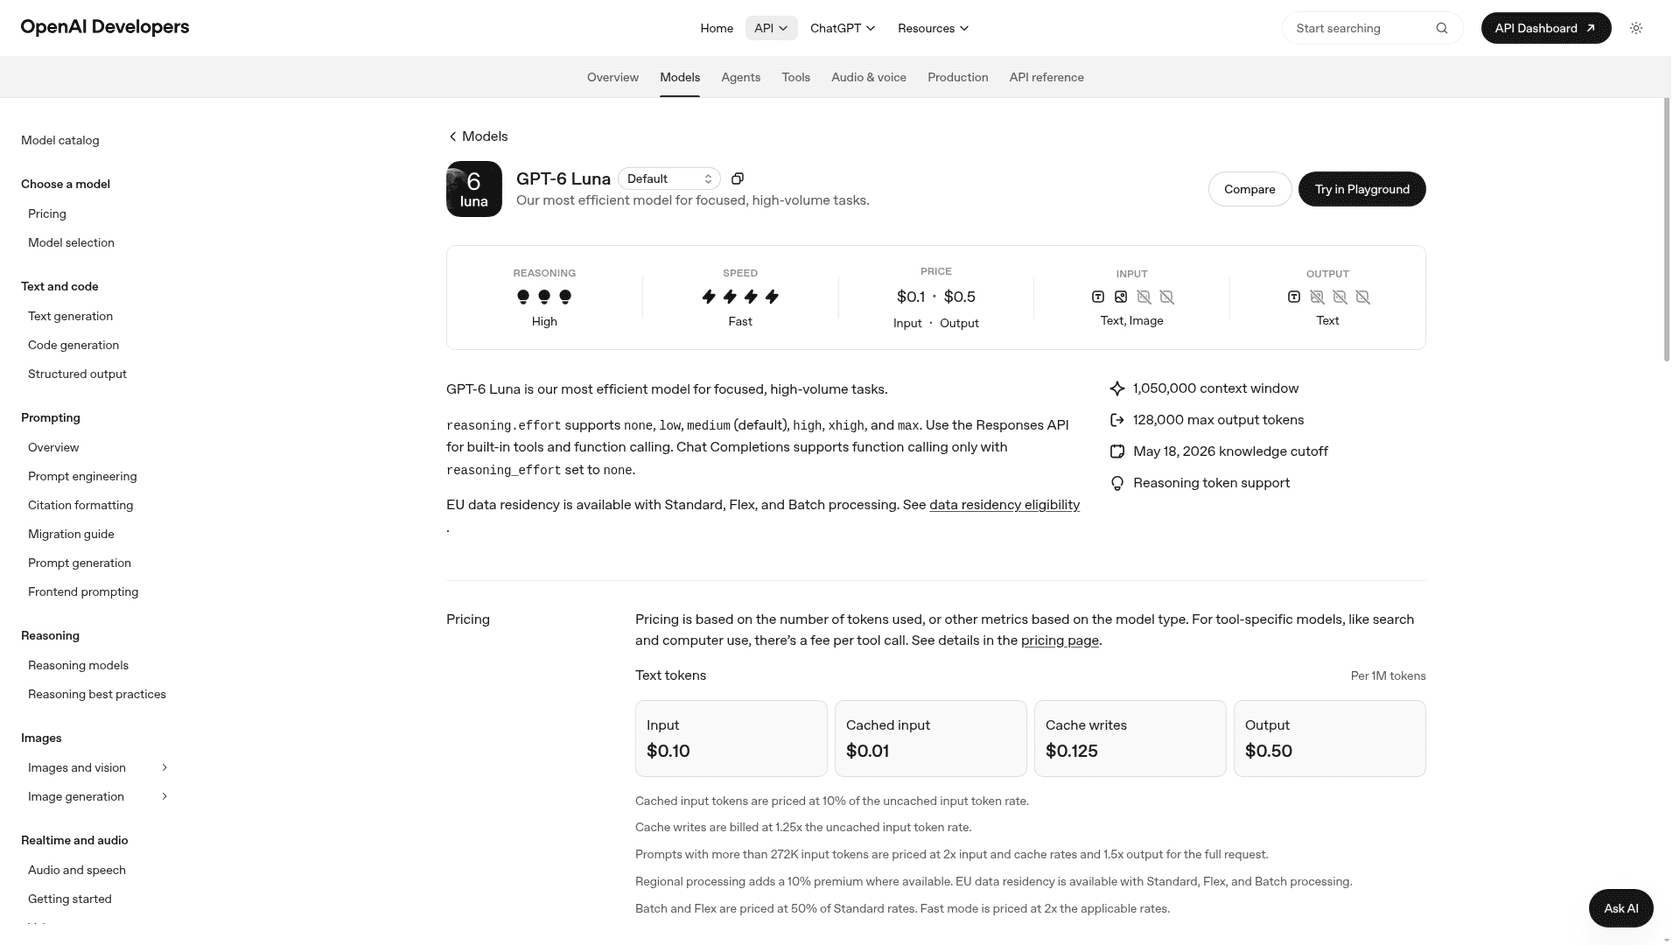
Luna es el modelo con cuyo precio se igualó Haiku 5.5, y gana en dos cosas que importan en las facturas reales. La primera es que su regla de contexto largo es mucho más suave. La página del modelo dice que los prompts de más de 272K tokens de entrada pagan 2x en entrada y caché y 1.5x en salida, lo que da $0.20 de entrada y $0.75 de salida. Haiku 5.5 sube a los 100k, y por 5x.
La segunda es que escribe menos, algo que se nota rápido en la factura. AA puso a Luna en 140M de tokens en su índice frente a los 440M de Haiku, y en $0.07 por tarea frente a $0.21. Un probador de Hacker News ejecutó el mismo trabajo de clasificación en ambos y encontró Luna un 26% más barato con idéntico precio por token. Los tokenizadores también importan:
"There's also a tokenizer efficiency difference: modern Claude's 100K tokens are about ~60-65K modern GPT tokens, so in reality the Luna cutoff is much further away than the Haiku one."
Dónde se queda corto
Luna puntúa 38 en AA frente a 43 de Haiku, y la prueba de alucinaciones de AA muestra la brecha mayor: 77% para Luna frente a 40% para Haiku 5.5, según mi reseña de Haiku. También es más lento, con 128 tokens de salida por segundo, y eso importa en uso en vivo. Y la API tiene su propio inconveniente. La guía del último modelo de OpenAI dice que cuando el esfuerzo de razonamiento no es none, debes quitar temperature y top_p, y Chat Completions solo admite function calling con esfuerzo none. Para herramientas con razonamiento se usa la Responses API.
Precios
| Tarifa | Hasta 272K de entrada | Más de 272K de entrada |
|---|---|---|
| Entrada | $0.10 | $0.20 |
| Entrada en caché | $0.01 | $0.02 |
| Salida | $0.50 | $0.75 |
| Batch / Flex entrada / salida | $0.05 / $0.25 | $0.10 / $0.375 |
Fuente: precios de la API de OpenAI. La guía de precios de Luna repasa el modo Fast y las tarifas regionales.
Mi opinión
Sinceramente, este es el cambio por defecto. Si tu uso de Haiku 5.5 cruza los 100k tokens con regularidad, o te importa más el coste por tarea que los últimos puntos de calidad, muévete aquí. Quédate en Haiku si tus evaluaciones muestran que esos 5 puntos extra (o la menor tasa de alucinación) se notan en tu tarea real. Mi artículo sobre las alternativas a GPT-6 Luna hace la comparación desde el otro lado.
2. Claude Haiku 4.5
Mejor para: pipelines que dependen de temperature: 0, prefill o presupuestos de thinking manuales, mientras los reescribes.
Qué hace mejor que Haiku 5.5
Nada en benchmarks, pero lo que hace mejor es no romper tu código. Haiku 4.5 aún acepta los parámetros de muestreo, el prefill y budget_tokens que Haiku 5.5 rechaza, su precio es plano en toda su ventana de 200k y su tokenizador más antiguo cuenta menos tokens para el mismo texto. Algunos equipos simplemente prefieren su salida en su tarea concreta.
"Not really. We use Haiku 4.5 to turn users' natural language queries and requests into fairly complex structured specs for interior design and construction. It has near perfect accuracy."
Dónde se queda corto
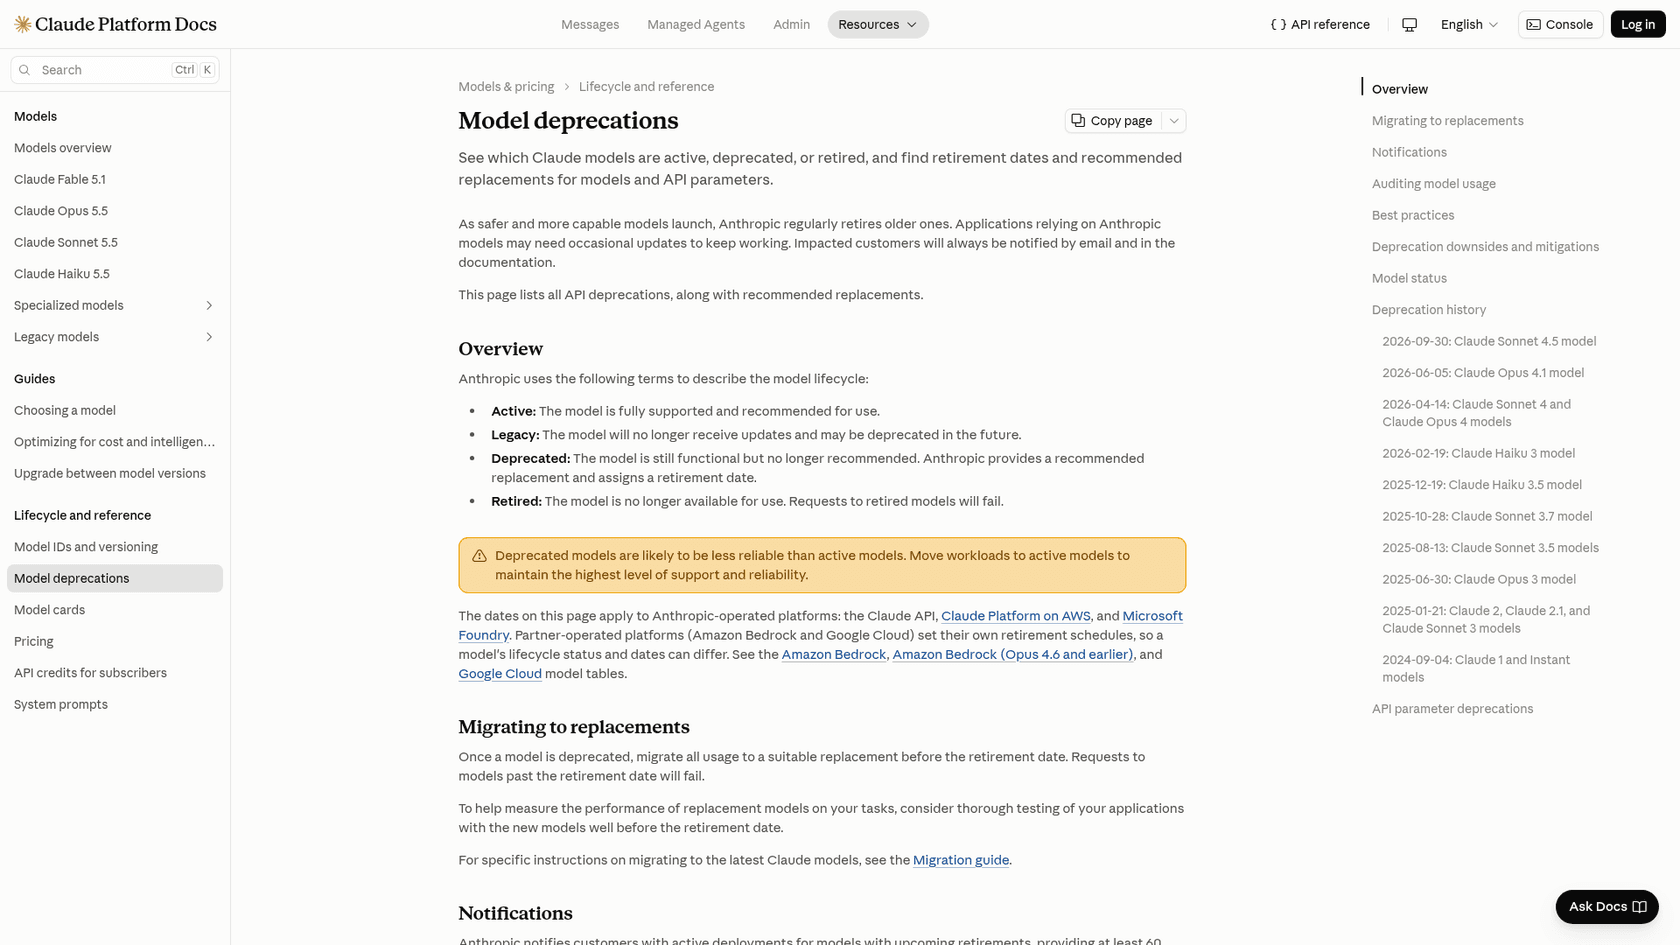
Cuesta 10 veces el precio por token de Haiku 5.5 por debajo de 100k ($1 / $5 frente a $0.10 / $0.50), y la brecha de capacidad es enorme: OSWorld 2.1 pasó de 15.7% a 72.4% entre ambos. El problema mayor es el tiempo. La página de retiradas lista claude-haiku-4-5-20251001 como Active, con retirada "Not sooner than October 15, 2026". Eso es un suelo, no una fecha programada, y Anthropic dice que avisa a los clientes antes de una retirada. Así que construir algo nuevo sobre él es una apuesta contra el calendario.
Precios
| Tarifa | Claude Haiku 4.5 |
|---|---|
| Entrada / salida | $1 / $5 |
| Escritura de caché 5 minutos / 1 hora | $1.25 / $2 |
| Lectura de caché | $0.10 |
| Batch entrada / salida | $0.50 / $2.50 |
Fuente: documentación de precios de Claude. La guía de precios de la API de Anthropic cubre toda la gama.
Mi opinión
Úsalo como puente: mantén el pipeline antiguo funcionando en 4.5 mientras pasas las etiquetas a salidas estructuradas, y luego ejecuta ambos modelos en paralelo sobre los mismos tickets. No empieces nada nuevo aquí.
3. Claude Sonnet 5.5
Mejor para: las tareas que Haiku 5.5 deriva hacia arriba, sobre todo programación agéntica y trabajo largo de varios pasos.
Qué hace mejor que Haiku 5.5
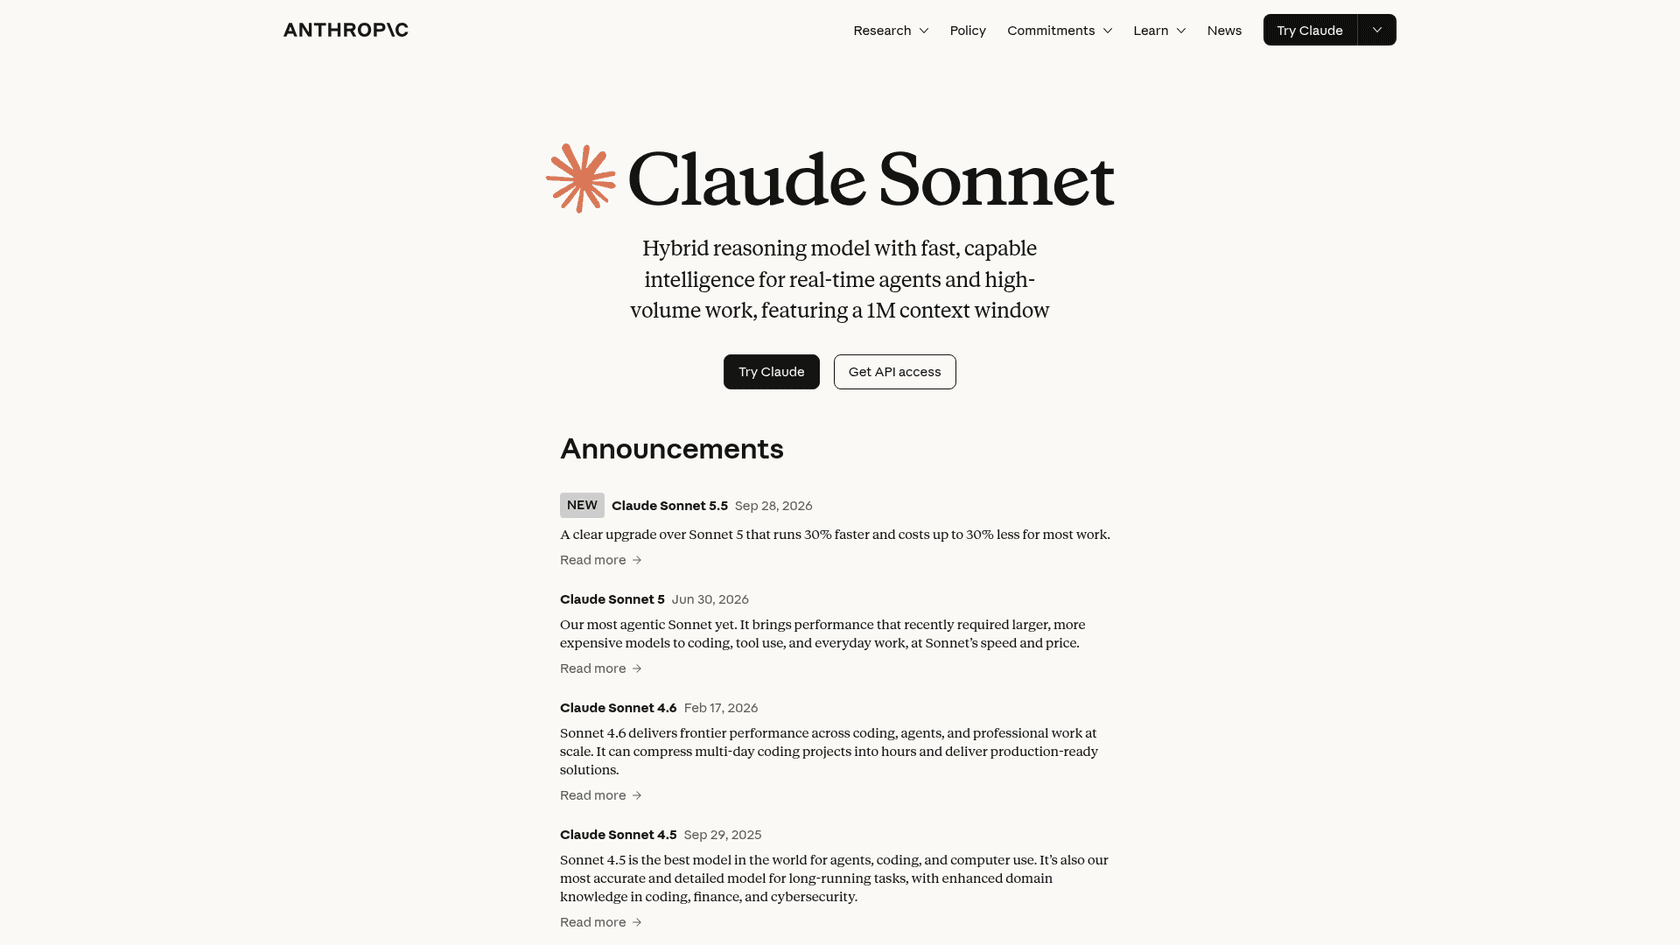
La brecha es mayor justo donde Haiku es más débil, que es la programación. En los benchmarks de lanzamiento de Anthropic, Sonnet 5.5 puntúa 70.6% en Terminal-Bench 4.0 frente al 39.2% de Haiku 5.5. En trabajo de conocimiento la brecha es pequeña (1840 frente a 1620 en GDPval-AA), lo que te dice dónde vale la pena pagar por Sonnet. Claude Sonnet 5.5 también tiene precio plano en toda su ventana de 1M, y Anthropic redujo a la mitad sus lecturas de caché a $0.10 el día del lanzamiento de Haiku.
Dónde se queda corto
Cuesta 20 veces Haiku 5.5 por token por debajo de 100k ($2 / $10), y tiene las mismas restricciones de muestreo y prefill más algunas propias, como rechazar tool_choice forzado. En cuanto al coste, el nivel de esfuerzo también importa mucho: AA midió $7.60 por tarea a esfuerzo máximo, por lo que mi reseña de Sonnet 5.5 recomienda Medium para la mayor parte del trabajo.
Precios
| Tarifa | Claude Sonnet 5.5 |
|---|---|
| Entrada / salida | $2 / $10 |
| Escritura de caché 5 minutos / 1 hora | $2.50 / $4 |
| Lectura de caché | $0.10 |
| Batch entrada / salida | $1 / $5 |
Fuente: documentación de precios de Claude. El artículo sobre los precios de Sonnet 5.5 calcula facturas reales por nivel de esfuerzo.
Mi opinión
No sustituyas Haiku por Sonnet, enruta hacia él. Deja el trabajo corto y de alto volumen en un modelo pequeño y envía la programación y la resolución larga de problemas un nivel más arriba, y también todo lo de alto riesgo. Si el obstáculo son las rarezas propias de Sonnet 5.5, mi artículo sobre las alternativas a Sonnet 5.5 cubre ese nivel.
4. DeepSeek V4.1 Flash
Mejor para: prompts largos y trabajos por lotes con presupuesto ajustado, con pesos abiertos como plan B.
Qué hace mejor que Haiku 5.5
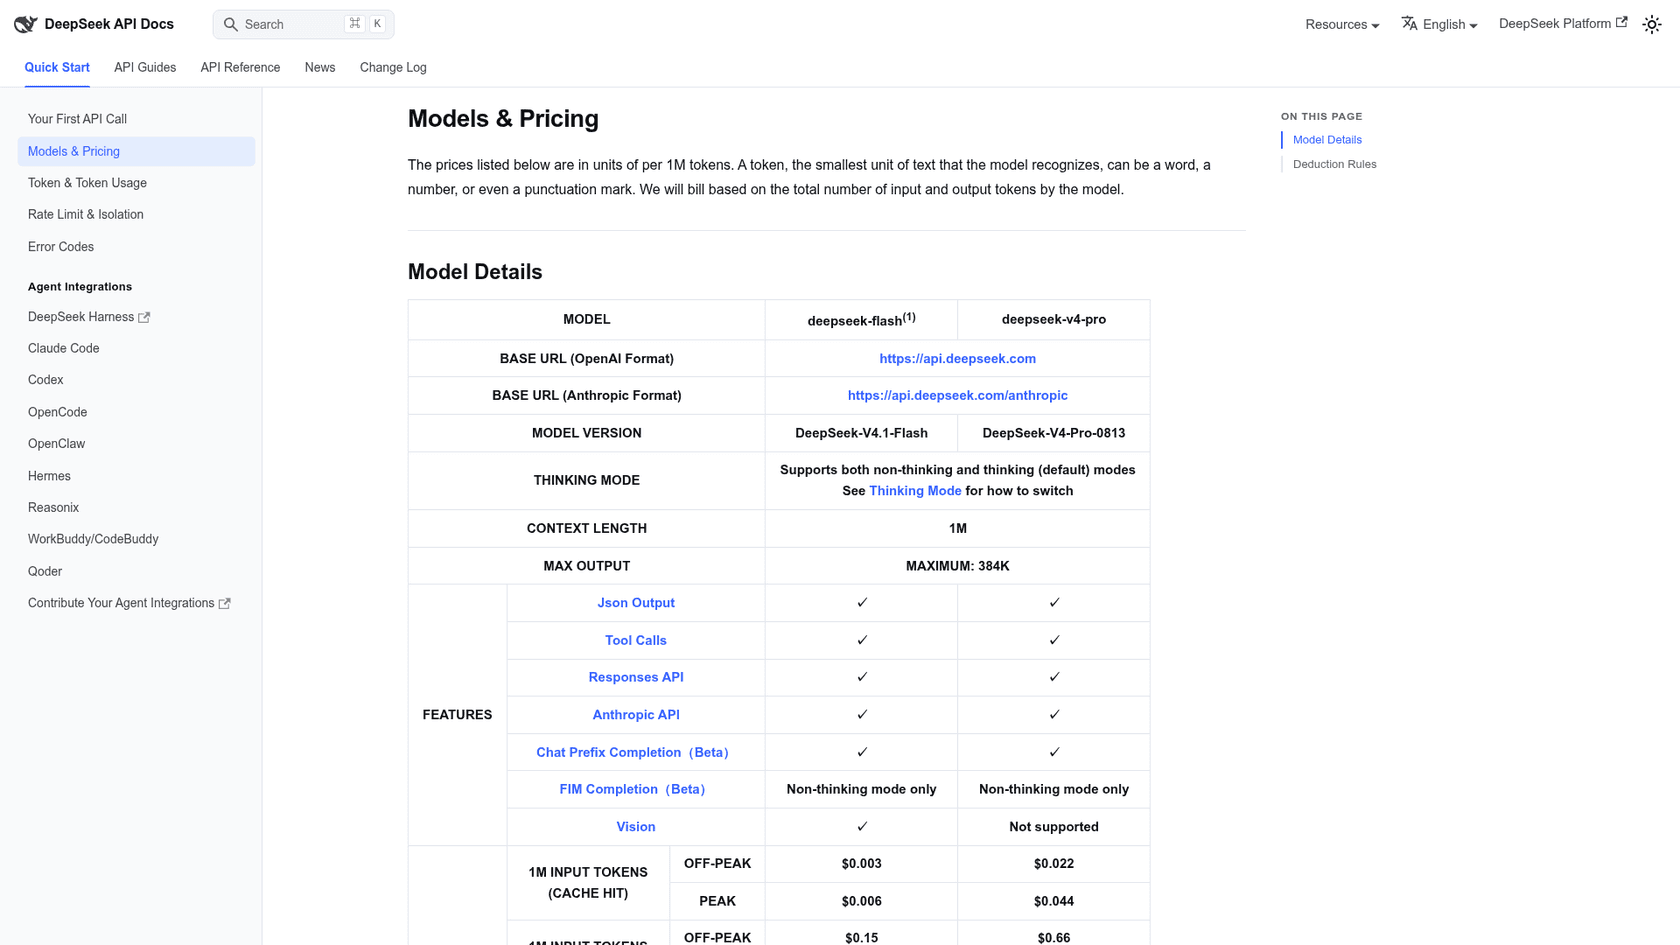
Sin precipicio de precio. DeepSeek V4.1 Flash cobra la misma tarifa desde el primer token hasta el millonésimo, y fuera de punta son $0.15 de entrada y $0.60 de salida. Los aciertos de caché cuestan $0.003 fuera de punta, un tercio de los $0.01 de Haiku. Así, con un prompt de 150.000 tokens, la entrada de DeepSeek fuera de punta cuesta $0.0225 mientras que Haiku 5.5 cuesta $0.075.
También habla el formato de API de Anthropic, lo que significa que apuntar una integración Claude existente hacia él es sobre todo cambiar la URL base, y admite chat prefix completion (prefill, en términos de Anthropic) en beta. Los pesos están en Hugging Face con licencia MIT.
Dónde se queda corto
Dos inconvenientes. El precio en punta es el doble, y las horas punta son de 01:00 a 04:00 y de 06:00 a 10:00 UTC entre semana, que es la mañana laboral europea. Y en modo thinking, la guía del modo thinking de DeepSeek dice que temperature "will not trigger an error but will also have no effect", así que el mismo problema de etiquetas deterministas te sigue aquí, solo que en silencio. AA lo puntúa con 39, cuatro puntos por debajo de Haiku.
Precios
| Tarifa | Fuera de punta | Punta |
|---|---|---|
| Entrada, fallo de caché | $0.15 | $0.30 |
| Entrada, acierto de caché | $0.003 | $0.006 |
| Salida | $0.60 | $1.20 |
Fuente: precios de DeepSeek. Mi artículo sobre los precios de V4.1 Flash cubre las cuentas de las horas punta.
Mi opinión
La elección para trabajo por lotes de contexto largo donde el precipicio de los 100k duele más, como resumir por la noche historiales largos de tickets. Comprueba antes la residencia de datos y las normas de proveedores de tu empresa, porque algunos equipos no pueden enviar datos de clientes a una API con sede en China, y alojar los pesos abiertos por tu cuenta es la solución.
5. GLM-5.3 Flash
Mejor para: equipos que quieren un modelo de pesos abiertos que puntúe a un punto de Haiku 5.5.
Qué hace mejor que Haiku 5.5
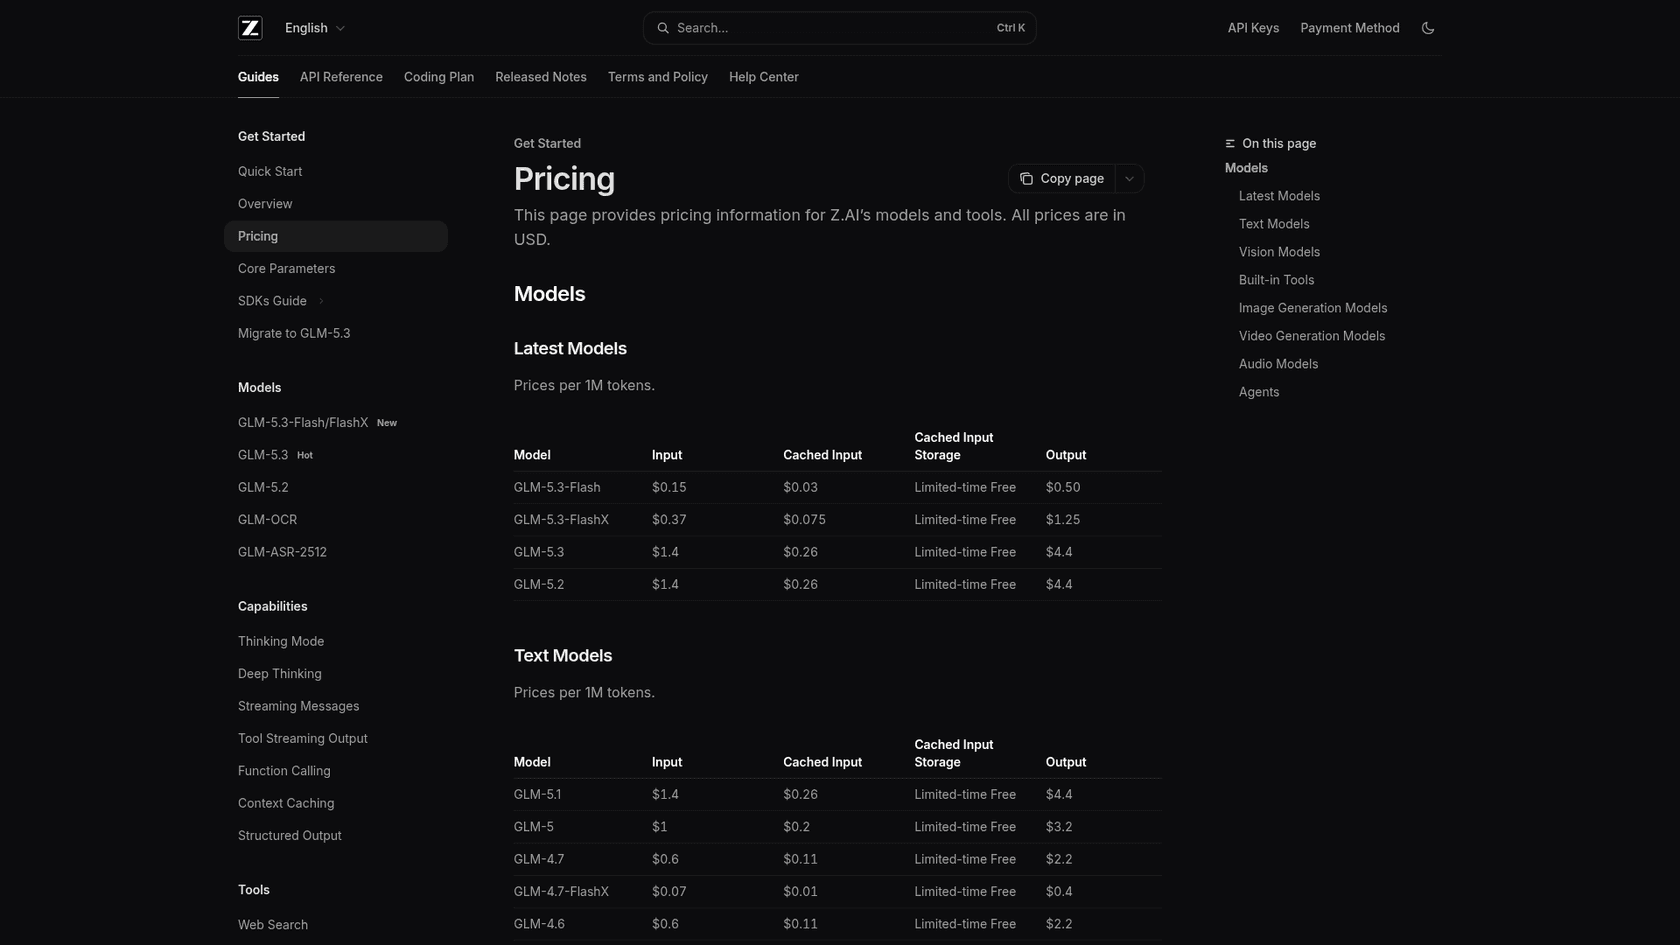
Puntuación por dólar sin precipicio. GLM-5.3 Flash puntúa 42 en Artificial Analysis, un punto por debajo de Haiku 5.5, a $0.15 de entrada y $0.50 de salida planos en una ventana de 1M. El precio de salida iguala el nivel barato de Haiku y nunca pagas el salto de 5x. Los pesos son públicos en Hugging Face, así que puedes ejecutarlo en tu propio hardware o a través de un host de terceros.
Algunos desarrolladores ya lo usan como su modelo barato de cada día:
"Not me, I use GLM-5.3-Flash for almost everything (the subscription-subsidized pricing on a legacy Z.ai plan makes it the best value model by a wide margin), along with some MiMo and DeepSeek."
Dónde se queda corto
El problema es la velocidad. AA mide 51 tokens de salida por segundo en la API propia, frente a 243 de Haiku 5.5, así que encaja mal en cualquier cosa que una persona espere. Tampoco se puede desactivar el thinking: la página del modelo dice "thinking.type only supports enabled", y Z.ai recomienda temperature: 1. La entrada también es $0.15 frente a $0.10 de Haiku, así que los prompts muy cortos y cargados de entrada cuestan algo más.
Precios
| Tarifa | GLM-5.3 Flash | GLM-5.3 FlashX |
|---|---|---|
| Entrada | $0.15 | $0.37 |
| Entrada en caché | $0.03 | $0.075 |
| Salida | $0.50 | $1.25 |
Fuente: precios de Z.AI. Mi reseña de GLM-5.3 Flash y el artículo de precios profundizan más.
Mi opinión
La mejor respuesta de pesos abiertos a Haiku 5.5 en calidad y una opción sólida para trabajos en segundo plano, aunque yo lo evitaría en chat en vivo, donde se nota su velocidad. El artículo sobre las alternativas a GLM-5.3 Flash cubre a sus vecinos.
6. Gemini 3.5 Flash-Lite
Mejor para: trabajos sencillos de volumen muy alto donde el rendimiento pesa más que la inteligencia.
Qué hace mejor que Haiku 5.5
Es el modelo más rápido de aquí, con 346 tokens de salida por segundo en Artificial Analysis, y el menos verboso: 59M de tokens en el índice de AA frente a los 440M de Haiku. El precio es plano en su ventana de 1M, acepta texto, imagen, vídeo, audio y PDF como entrada, y además Google ofrece un nivel gratuito para probar. Gemini 3.5 Flash-Lite está pensado para análisis, etiquetado y enrutado a escala.
Dónde se queda corto
La inteligencia es la brecha. Puntúa 22 en AA, aproximadamente la mitad de los 43 de Haiku 5.5, y su coste por tarea ($0.19) acaba cerca del de Haiku de todos modos porque su precio de salida es $2.50, cinco veces el nivel barato de Haiku. La salida máxima es de 65.536 tokens. Y la guía de Gemini 3 de Google recomienda encarecidamente mantener la temperature en 1.0 para todos los modelos Gemini 3, advirtiendo de que valores más bajos pueden causar "looping or degraded performance".
Precios
| Tarifa | Gemini 3.5 Flash-Lite |
|---|---|
| Entrada / salida | $0.30 / $2.50 |
| Caché de contexto | $0.03, más almacenamiento |
| Nivel gratuito | Sí |
Fuente: precios de la API de Gemini. El artículo sobre los precios de Flash-Lite cubre los niveles batch y prioritario.
Mi opinión
Úsalo para el paso más tonto y de mayor volumen de un pipeline, como la detección de idioma o el filtrado de spam, y mantenlo lejos de cualquier cosa que requiera criterio. Sinceramente, para la mayoría de los usuarios de Haiku 5.5 es un paso atrás, no lateral.
7. Gemini 3.8 Flash
Mejor para: tareas largas de agentes para equipos que ya están en Google Cloud, donde el razonamiento extra del modelo compensa.
Qué hace mejor que Haiku 5.5
Precio plano en una ventana de 1M y un buen rendimiento en trabajo agéntico largo, además de toda la caja de herramientas de Google (grounding con búsqueda, un nivel gratuito, Vertex AI). Gemini 3.8 Flash puntúa 41 en AA con esfuerzo alto, cerca de Haiku 5.5, y es la opción natural si tus datos y contratos ya viven en Google Cloud.
Dónde se queda corto
Sobre todo coste y tiempo de espera. AA lo sitúa en $1.24 por tarea, unas 6 veces Haiku 5.5, y el precio en la página de precios de Google se duplica el 1 de enero de 2027, de $0.75/$3.75 a $1.50/$7.50. AA también midió 13.3 segundos hasta el primer token en el lanzamiento, lo que mi reseña de Gemini 3.8 Flash señala como problema para cualquier cosa que un cliente esté viendo. El consejo sobre temperature es el mismo que con Flash-Lite: déjala en 1.0.
Precios
| Tarifa | Hasta el 31 dic. 2026 | Desde el 1 ene. 2027 |
|---|---|---|
| Entrada | $0.75 | $1.50 |
| Salida, thinking incluido | $3.75 | $7.50 |
| Lectura de caché | $0.075 | $0.15 |
| Batch entrada / salida | $0.375 / $1.875 | $0.75 / $3.75 |
Fuente: precios de la API de Gemini. El artículo sobre los precios de Gemini 3.8 Flash incluye el nivel prioritario.
Mi opinión
No es un reemplazo equivalente de Haiku. Es un modelo más caro para trabajo de agentes más pesado, lo que significa que el cambio de precio de enero lo convierte en peor valor el año que viene. Si quieres la opción de Google, presupuesta ya con la tarifa de 2027. El artículo sobre las alternativas a Gemini 3.8 Flash cubre ese nivel.
El problema de temperature 0 te sigue
Es la razón que más veo cuando los equipos explican por qué cambian, y por eso tiene su propia sección. Haiku 5.5 devuelve un error con cualquier temperature distinta del valor por defecto, y muchos pipelines de triaje de tickets se construyeron con temperature 0 para etiquetas consistentes, más prefill para forzar una llave de apertura JSON.
Lo incómodo, entonces, es que el resto del nivel barato se ha movido en la misma dirección.
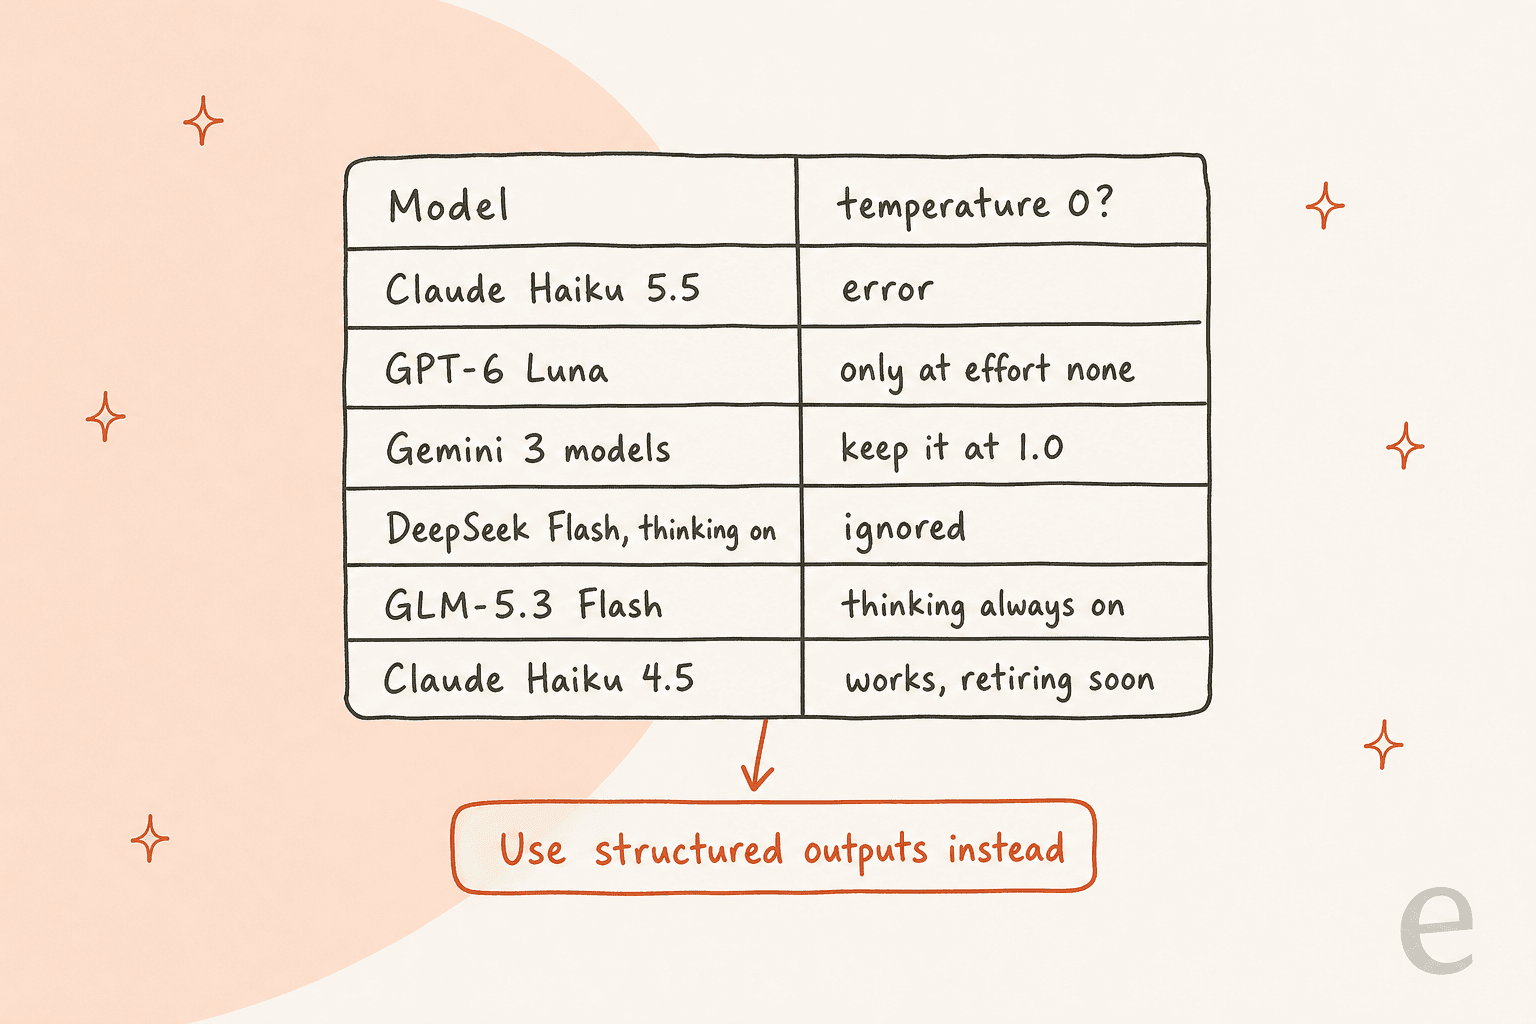
Los modelos de razonamiento muestrean su pensamiento, y los proveedores han decidido que las temperaturas bajas perjudican más de lo que ayudan. Así que cambiar de proveedor para conservar temperature 0 te da unos pocos meses como mucho. La solución duradera, entonces, es dejar de depender del muestreo para la consistencia.
- Usa salidas estructuradas o esquemas de herramientas estrictos para forzar un conjunto fijo de etiquetas. El modelo solo puede responder con una de tus categorías, sea cual sea su temperature.
- Elimina el prefill. Termina tus mensajes con un turno de usuario y pon la regla de formato en el prompt o en el esquema.
- Ejecuta esfuerzo bajo para clasificar. Menos thinking significa menos ocasiones de divagar y también una factura menor.
- Mide la consistencia, no la des por hecha. Ejecuta los mismos 200 tickets dos veces y cuenta los cambios de etiqueta. Ese número te dice más que cualquier ajuste de temperature.
Hay una lección relacionada de las llamadas de ventas de eesel. Un responsable de CX de una marca DTC de suplementos que gestiona unos 7.000 tickets al mes le dijo al equipo lo que realmente quería:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Ese es el objetivo real detrás de la mayoría de los montajes con temperature 0. No redacción idéntica, sino saber cuándo el modelo está seguro. El enrutado basado en confianza, donde la IA responde lo que tiene claro y deja el resto para una persona, te lleva ahí con más fiabilidad que cualquier ajuste de muestreo, y funciona igual con todos los modelos de esta lista.
Qué alternativa a Claude Haiku 5.5 encaja con qué trabajo
Así lo resolvería yo, por trabajo y no por benchmark.
| Estás ejecutando | Mi elección | Por qué |
|---|---|---|
| Clasificación corta, etiquetado, enrutado | Quedarse en Haiku 5.5, o Luna si gana el coste por tarea | Ambos $0.10/$0.50 por debajo de 100k; Luna escribe menos tokens |
| Bucles de agentes que pasan de 100k tokens | GPT-6 Luna | El salto llega a 272k y solo de 2x / 1.5x |
| Resúmenes por lotes de contexto largo | DeepSeek V4.1 Flash, fuera de punta | $0.15 / $0.60 planos hasta 1M tokens |
| Pipelines con temperature 0 o prefill | Haiku 4.5 a corto plazo, salidas estructuradas a largo | Todo modelo de razonamiento restringe el muestreo |
| Programación agéntica | Claude Sonnet 5.5 | 70.6% frente a 39.2% en Terminal-Bench 4.0 |
| Pesos abiertos o autoalojamiento | GLM-5.3 Flash o DeepSeek V4.1 Flash | AA 42 y 39, ambos en Hugging Face |
| Filtrado simple de volumen masivo | Gemini 3.5 Flash-Lite | 346 tok/s, el menos verboso |
Un punto práctico más antes de migrar. La mayoría de los equipos acaban con dos modelos, no uno: uno barato para el grueso y otro más listo para las escaladas. Ese patrón funciona con cualquier pareja de aquí, así que no estás atado a un proveedor. Para soporte, mi guía sobre qué LLM encaja en soporte y la lista de los mejores modelos de IA para tickets van más allá.
Prueba eesel en lugar de reconstruir tu pipeline de tickets
Si buscas una alternativa a Haiku 5.5 para una cola de soporte, el modelo es, sinceramente, la mitad más pequeña del problema. eesel es un compañero de helpdesk con IA que se une al helpdesk que ya usas, como Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y de tu centro de ayuda, y se encarga de la clasificación de tickets, los resúmenes y las respuestas. Cuando un proveedor añade un precipicio de precio o empieza a rechazar un parámetro, esa migración le toca a eesel, no a ti.

Antes de que responda a un solo cliente, cada despliegue se simula contra tus tickets históricos, así que puedes ver qué tickets resolvería y cuáles pasaría a tu equipo. Eso te da el enrutado basado en confianza que pedía el responsable de CX de los 7.000 tickets, sin un ajuste de temperature a la vista.
Si trabajas desde una terminal, la CLI de eesel maneja el mismo compañero y espacio de trabajo que el panel. Puedes automatizarla con scripts o conectarla a CI, y también dejar que un agente de programación como Claude Code la ejecute. Mi artículo sobre la CLI de agentes de IA cubre esa configuración.
Los planes de pago empiezan en $299 por 500 créditos, y puedes probarlo gratis antes con una parte de tus tickets reales. Prueba eesel.