

¿Qué es Claude Haiku 5.5?
Claude Haiku 5.5 es el modelo pequeño de la gama actual de Anthropic. Lo eliges cuando una tarea se ejecuta miles de veces al día y cada ejecución es corta. La publicación de lanzamiento de Anthropic lo describe como "the cheapest, fastest, and most capable small model we've ever released" y nombra las tareas para las que fue creado: resúmenes, compactaciones, consultas a bases de datos, clasificación, atención al cliente en vivo y uso del navegador.
Construyo agentes de IA en eesel y, sinceramente, la mayor parte de lo que hacen esos agentes todo el día no es razonamiento difícil. Leen un ticket y deciden adónde va, extraen un número de pedido de un mensaje, a veces escriben un resumen de tres líneas para que la siguiente persona no tenga que desplazarse. Durante años ese trabajo estuvo en un punto incómodo: un buen modelo costaba demasiado para esto y uno barato lo hacía mal una y otra vez. Haiku 5.5 apunta justo a ese punto.
También había un hueco en la gama de Anthropic, y esto lo llena. Antes de este lanzamiento, el Claude actual más barato era Sonnet 5.5 a $2/$10, y Haiku 4.5 a $1/$5 se había quedado muy por detrás de rivales más baratos como GPT-6 Luna. Como dijo un desarrollador en X una semana antes del lanzamiento, el espacio de modelos pequeños y baratos era "mostly chinese labs", con Luna como única excepción.
Especificaciones de Claude Haiku 5.5 de un vistazo
Esta es la hoja de especificaciones tal como está ahora, tomada de la página de resumen de Haiku 5.5 en la documentación de Anthropic.
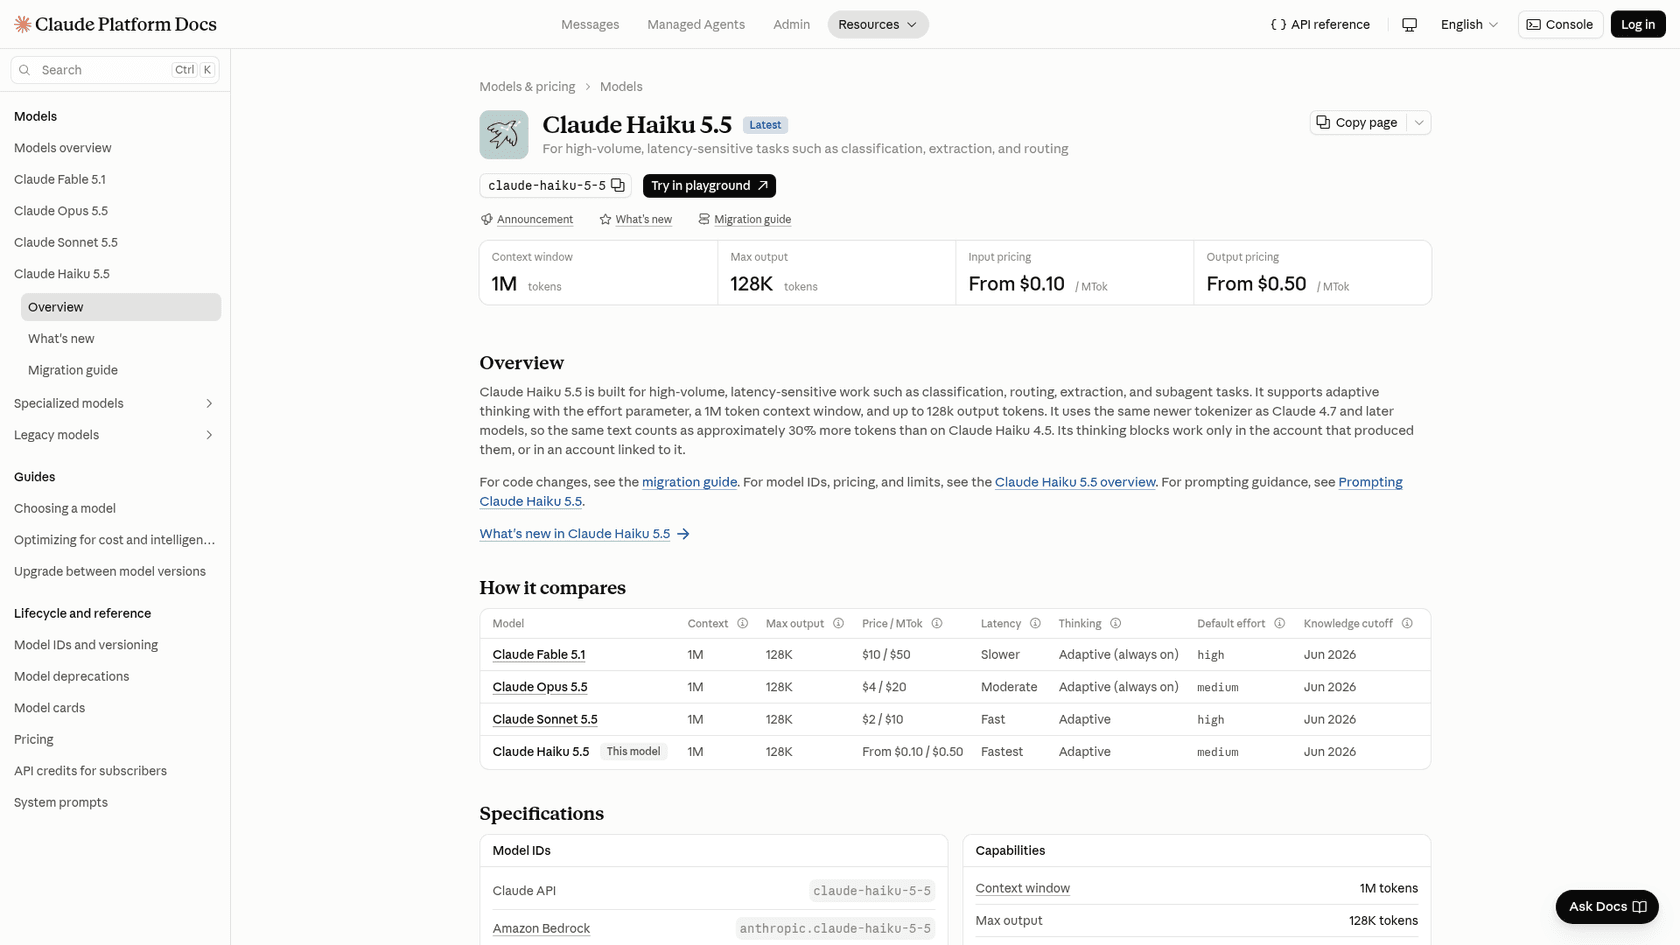
| Especificación | Claude Haiku 5.5 |
|---|---|
| ID de modelo en la API | claude-haiku-5-5 (sin sufijo de fecha, sin alias aparte) |
| ID en Amazon Bedrock | anthropic.claude-haiku-5-5 |
| Lanzamiento | 7 de octubre de 2026 |
| Ventana de contexto | 1M de tokens |
| Salida máxima | 128K tokens (300K en la Batch API, en beta) |
| Pensamiento | Adaptativo, activado por defecto |
| Esfuerzo por defecto | medium |
| Entrada / salida | Texto e imágenes de entrada, texto de salida |
| Fecha de corte de conocimiento | Junio de 2026 |
| Plataformas | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS |
| Retirada | No antes del 7 de octubre de 2027 |
Un par de detalles de esa tabla pasan desapercibidos. Primero, el ID del modelo no tiene una instantánea con fecha, así que claude-haiku-5-5 es el nombre fijo y no un alias que se mueva más adelante. Segundo, con un encabezado beta la Batch API puede devolver hasta 300K tokens de salida, algo útil si usas Haiku para escribir archivos estructurados largos durante la noche.
Dónde encaja Haiku 5.5 en la gama de Claude
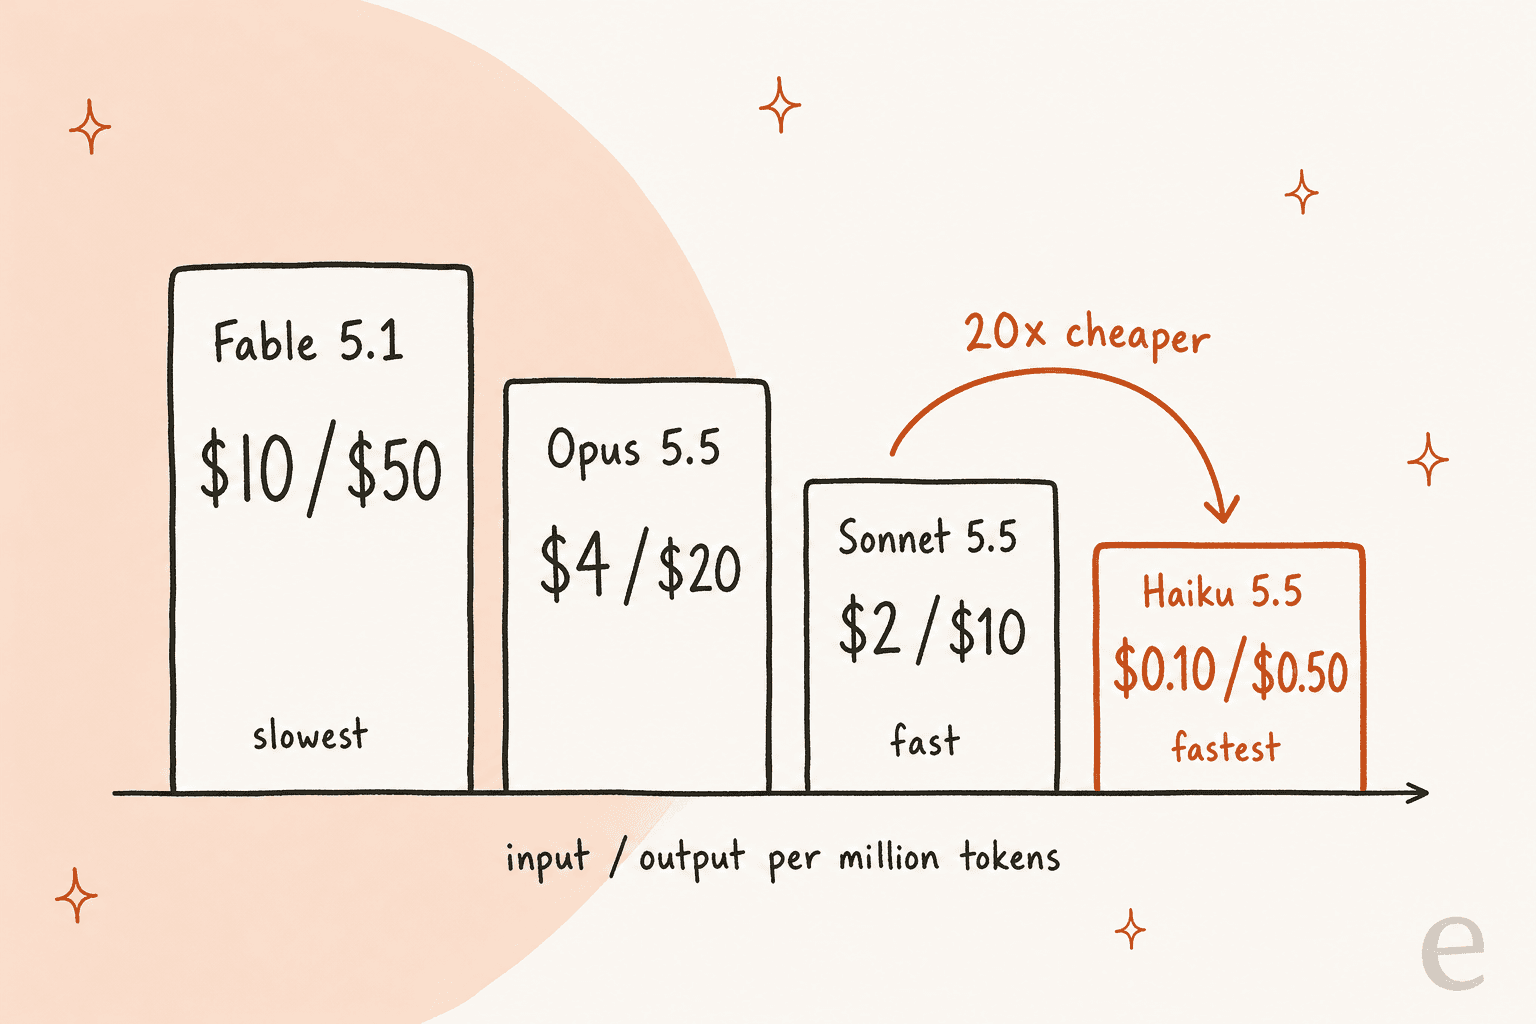
Anthropic mantiene ahora cuatro modelos actuales. Haiku 5.5 está en el peldaño más bajo de la escalera, que aquí es el extremo rápido y barato.
| Modelo | Ideal para | Latencia | Precio entrada / salida por 1M | Esfuerzo por defecto |
|---|---|---|---|---|
| Claude Fable 5.1 | Razonamiento exigente, agentes de largo recorrido | Más lento | $10 / $50 | high |
| Claude Opus 5.5 | Programación agéntica de larga duración y trabajo del conocimiento | Moderada | $4 / $20 | medium |
| Claude Sonnet 5.5 | La mejor mezcla de velocidad e inteligencia | Rápida | $2 / $10 | high |
| Claude Haiku 5.5 | Clasificación, extracción, enrutamiento, subagentes | La más rápida | Desde $0.10 / desde $0.50 | medium |
Los cuatro comparten la misma ventana de contexto de 1M, el mismo límite de salida de 128K y la misma fecha de corte de junio de 2026, según la visión general de modelos. La ventana dejó de ser un motivo para elegir un modelo sobre otro. Lo que queda por decidir es el precio y la velocidad, además de lo difícil que sea realmente la tarea.
Anthropic tampoco finge que Haiku sea un Sonnet barato. Su publicación de lanzamiento dice que Sonnet 5.5 y Opus 5.5 "remain better choices for complex agentic coding tasks", y que Haiku 5.5 sirve para trabajo muy acotado como compactación, resumen y tareas de subagentes. Para mí esa frase vale más que cualquier otra cosa del anuncio, y la tengo presente en cada decisión de abajo.
Qué hay de nuevo respecto a Haiku 4.5
Haiku 4.5 salió un año antes que este. Por el número de versión esperarías un paso pequeño, pero el salto es mucho mayor.
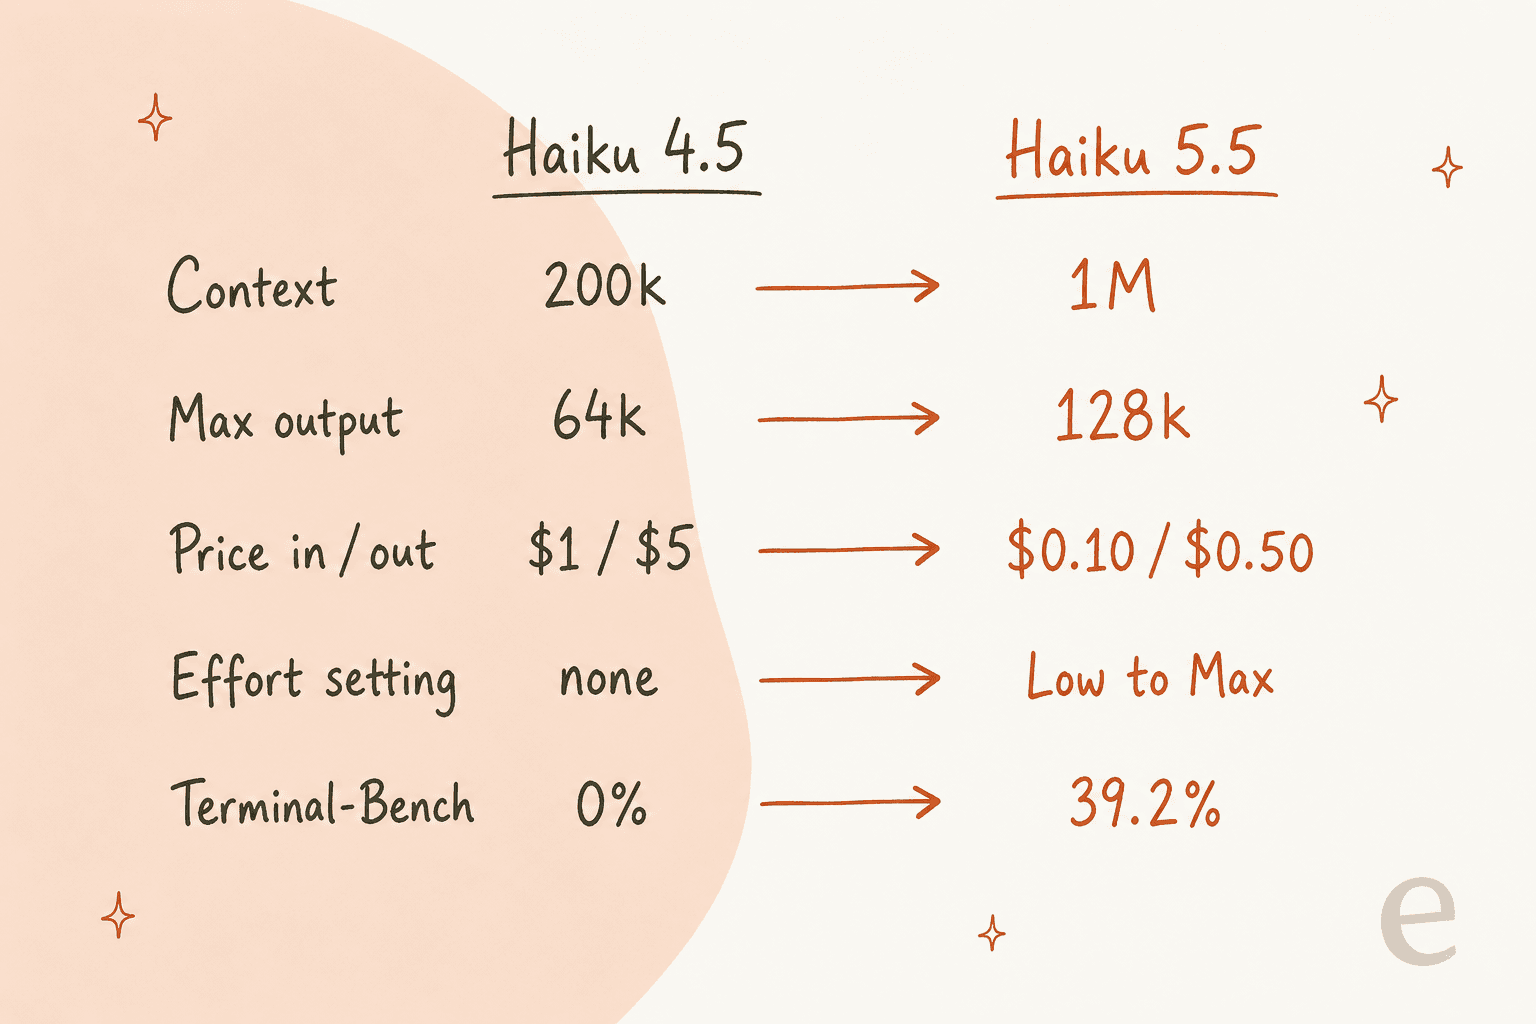
La página de novedades de Anthropic enumera 13 cambios: 4 capacidades nuevas, 5 cambios incompatibles y 4 cambios de comportamiento. Abajo solo repaso los que cambian cómo usas realmente el modelo.
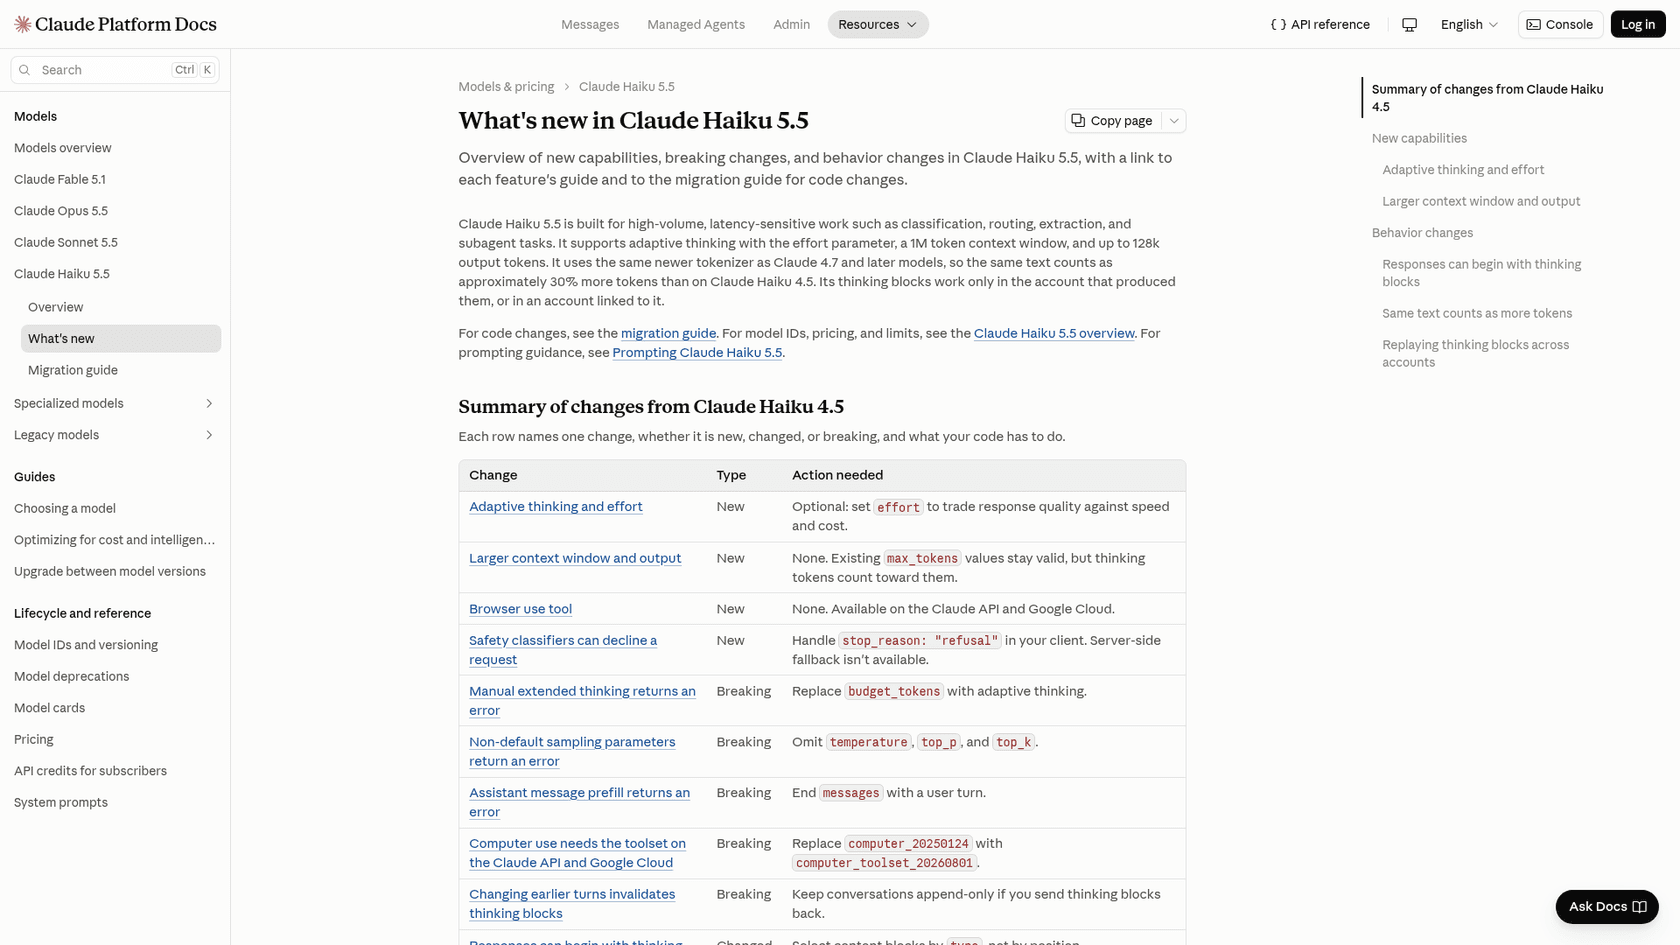
Pensamiento adaptativo y un ajuste de esfuerzo
Haiku 5.5 es el primer modelo de la clase Haiku con un ajuste de esfuerzo configurable. El pensamiento es adaptativo y está activado por defecto. En la práctica, el modelo decide por sí mismo cuándo pensar y durante cuánto tiempo, y tu palanca es effort en lugar de un presupuesto de pensamiento fijo. Con un esfuerzo menor, una petición sencilla puede no recibir pensamiento alguno. Qué hace cada nivel lo explico más abajo.
Una ventana de 1M y salidas de 128K
El contexto pasó de 200k a 1M de tokens y la salida máxima de 64k a 128K. Ojo aquí: los tokens de pensamiento cuentan para max_tokens. Si ajustaste ese límite al máximo para Haiku 4.5, la respuesta ahora puede terminar justo después del bloque de pensamiento, antes de que salga texto.
Uso de navegador y de ordenador
Haiku 5.5 admite la herramienta de uso del navegador en la Claude API y Google Cloud, y Anthropic lanzó el mismo día un SDK de uso de navegador y ordenador para Python y TypeScript. Según Anthropic, Haiku 5.5 es "especially well-suited" para estas tareas por su velocidad y precio. La puntuación de 72,4 % en OSWorld 2.1 (frente a 15,7 % de Haiku 4.5) respalda esa afirmación.
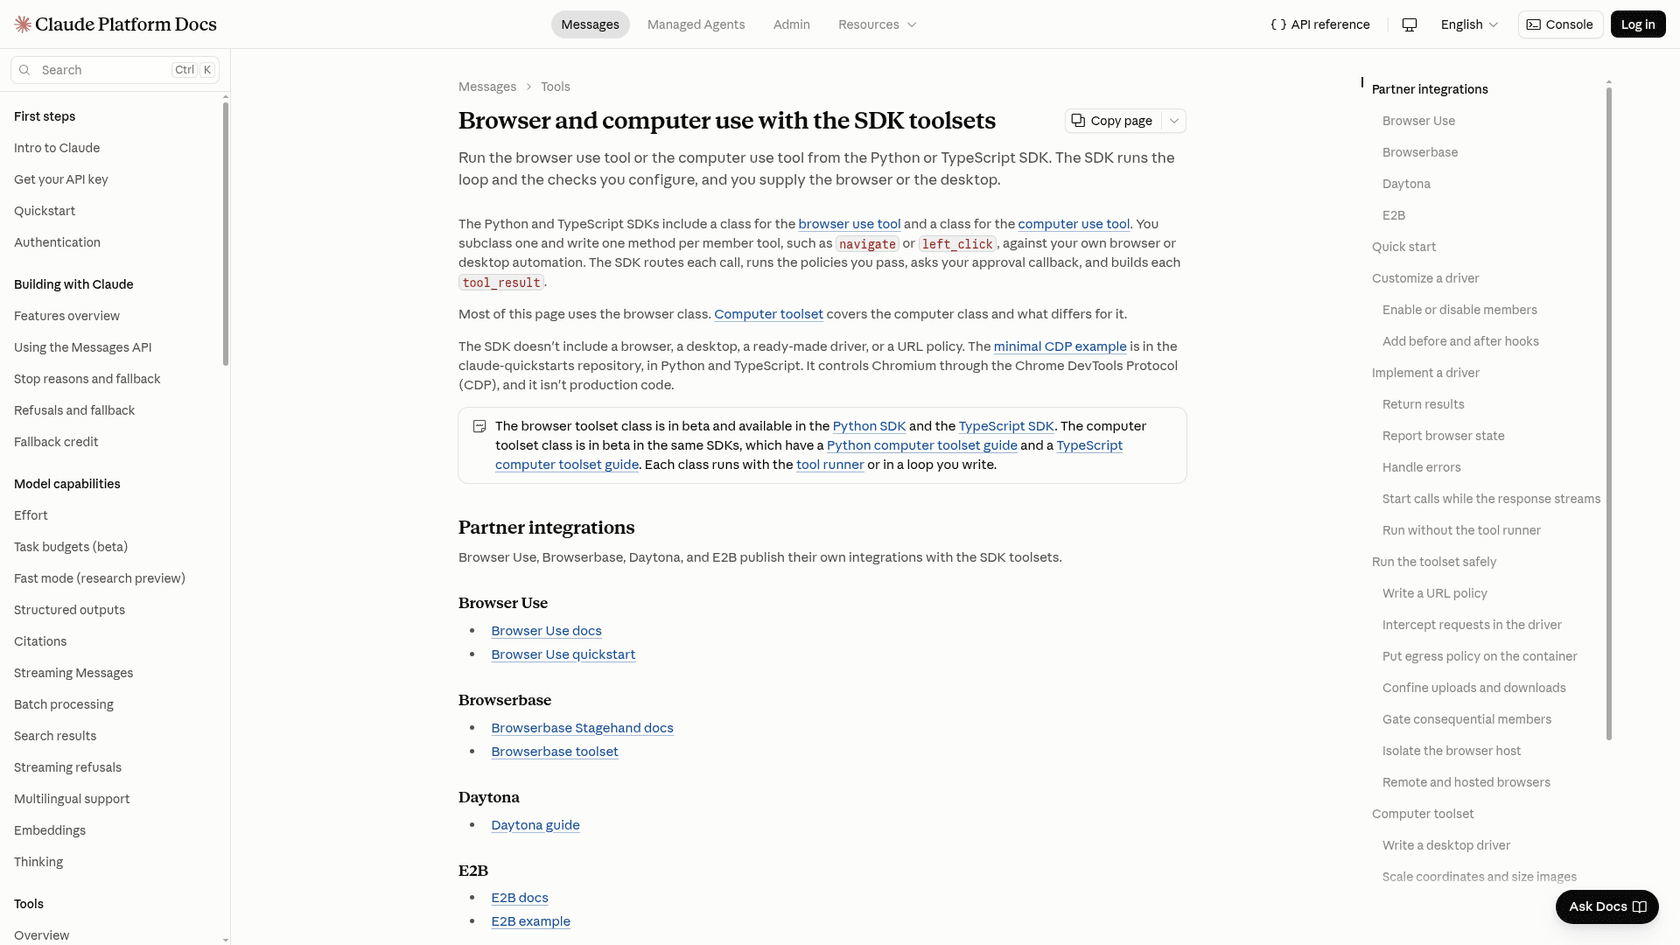
Conviene saber antes de entusiasmarte: el SDK se entrega sin navegador, sin escritorio y sin ninguna política de URL. El controlador lo pones tú, y los ejemplos de inicio de la documentación llevan la etiqueta "not production code". Si no te apetece escribir uno, Browser Use, Browserbase, Daytona y E2B ya publican integraciones listas para usar.
Un tokenizador nuevo
Haiku 5.5 usa el mismo tokenizador más reciente que Sonnet 5.5 y Opus 5.5, y la guía de migración dice que el mismo texto produce cerca de un 30 % más de tokens que en Haiku 4.5. Eso explica por qué la cifra destacada de la propia Anthropic dice "around 75% less to run" y no 90 %. Por token el precio bajó un 90 %, pero cada tarea consume ahora más tokens.
Cómo cambia el ajuste de esfuerzo a Haiku 5.5
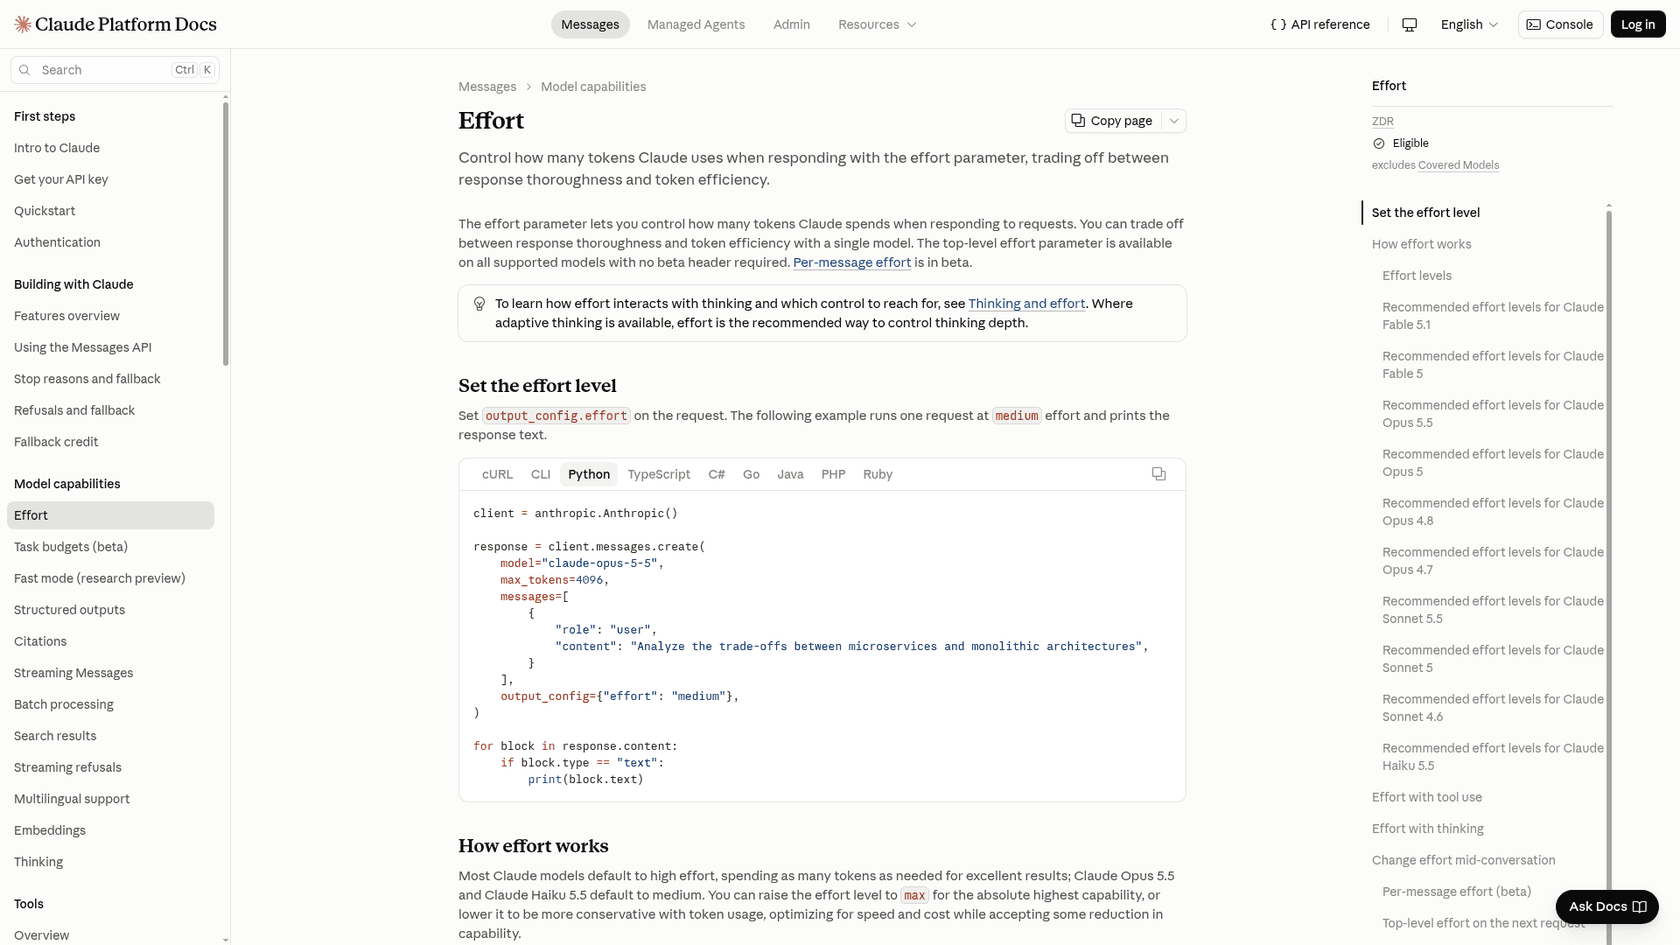
Si solo pudiera dedicar mi tiempo a una parte de Haiku 5.5, sería esta, porque nada más cambia tanto el comportamiento del modelo. La documentación de esfuerzo describe cinco niveles, y Haiku usa medium por defecto donde la mayoría de los modelos Claude usan high.
Artificial Analysis ejecutó Haiku 5.5 en cada nivel, y el equilibrio que encontró no es sutil. Su puntuación del Intelligence Index sube de 29,4 en Low a 43,4 en Max, pero el tiempo hasta el primer fragmento de salida, que incluye el pensamiento, pasa de unos 14 segundos a 415 segundos.
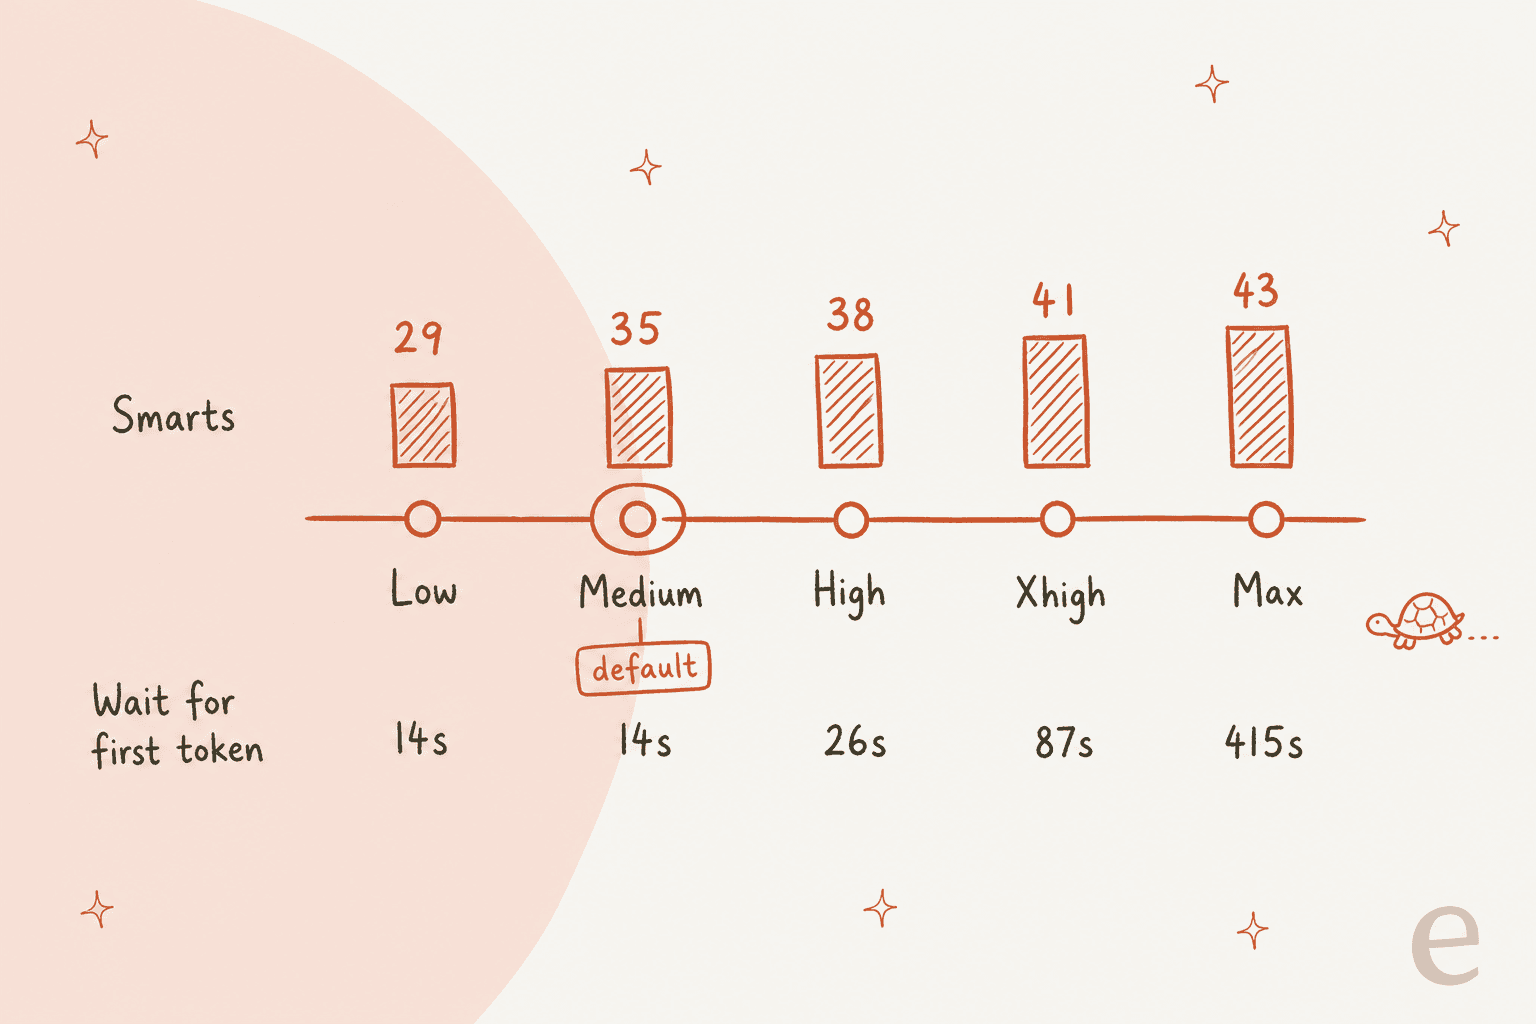
| Esfuerzo | AA Intelligence Index | Tokens de salida para ejecutar el índice | Velocidad de salida | Tiempo hasta el primer fragmento |
|---|---|---|---|---|
| Low | 29.4 | 32M | 181 tokens/s | 13.6 s |
| Medium (por defecto) | 34.5 | 54M | 137 tokens/s | 14.2 s |
| High | 37.8 | 97M | 173 tokens/s | 26.2 s |
| Xhigh | 41.2 | 180M | 188 tokens/s | 86.8 s |
| Max | 43.4 | 440M | 243 tokens/s | 415.3 s |
Leo esa tabla más bien como una lista de precios disfrazada. Pasar de Medium a Max compra 9 puntos, y los pagas con unas 8 veces más tokens de salida. Artificial Analysis también señaló en su publicación de lanzamiento en X que pasar de Xhigh a Max "adds 2 points for ~1.8x the tokens".
En una tarea diminuta, la prueba del pelícano de Simon Willison dibuja la misma curva:
"Low messes up the bicycle frame, but medium/high/xhigh/max all get the bicycle frame right. The max one took 5 minutes 9 seconds and cost 3.3826 cents. The cheapest one (low) cost 0.0936 cents and took 7 seconds."

La regla práctica a la que llegué construyendo agentes es esta. Cualquier cosa con un conjunto de respuestas fijo, como etiquetas o enrutamiento, empieza en Low. Cualquier cosa que escriba prosa que leerá un cliente empieza en Medium. Y cuando una tarea solo sale bien en High o más, eso suele indicar que era una tarea de Sonnet desde el principio.
¿Qué tan bueno es Claude Haiku 5.5?
Para su tamaño es muy bueno, aunque todavía se nota que es un modelo pequeño. Abajo están los benchmarks publicados por Anthropic con sus configuraciones destacadas.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (trabajo del conocimiento, Elo) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (trabajo del conocimiento, Elo) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (uso del ordenador) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam (sin herramientas) | 45.9% | 10.2% | n/a | 56.9% |
| Terminal-Bench 4.0 (programación agéntica) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (programación agéntica) | 46.4% | n/a | 42.4% | 52.1% |
| Chartography (razonamiento visual, sin herramientas) | 46.4% | 6.4% | 29.1% | 61.6% |
El patrón se mantiene en toda la tabla. En todo lo que se probó, Haiku 5.5 supera a GPT-6 Luna, y queda cerca de Sonnet 5.5 en trabajo del conocimiento y uso del ordenador. La programación agéntica larga es donde se queda bastante por detrás de Sonnet.
En la página de lanzamiento, los primeros informes de clientes cuentan más o menos la misma historia, solo que con palabras más sencillas. HubSpot dijo que obtuvo "the best score we've seen on this suite yet, at 92.8%" en sus tareas de CRM. AlphaSense midió 0,84 frente a 0,76 de Haiku 4.5 en una carga de preguntas y respuestas sobre documentos que ronda 8M de llamadas por semana. Box informó de 11 puntos más que Haiku 4.5 con aproximadamente la mitad de latencia.
Hay una advertencia de Artificial Analysis que tendría en cuenta. Haiku 5.5 conoce menos datos que los modelos más grandes, con un 36 % de precisión en su prueba AA-Omniscience, pero dice "I don't know" con más facilidad, así que su tasa de alucinación es del 40 %, frente al 77 % de GPT-6 Luna. Cuando un cliente va a leer la salida, me importa más esa cifra que la puntuación del índice. La conclusión práctica: dale a Haiku tu centro de ayuda y no confíes en lo que recuerda.
Precios de Claude Haiku 5.5
De los modelos actuales de Claude, solo Haiku 5.5 tiene dos tramos de precio. El que pagas depende de la longitud del prompt, y la página de precios enumera cada línea.
| Precio por 1M de tokens | Prompts de hasta 100.000 tokens | Prompts de más de 100.000 tokens | Haiku 4.5 (tarifa única) | Sonnet 5.5 |
|---|---|---|---|---|
| Entrada | $0.10 | $0.50 | $1.00 | $2.00 |
| Salida | $0.50 | $2.50 | $5.00 | $10.00 |
| Lectura de caché | $0.01 | $0.05 | $0.10 | $0.10 |
| Escritura de caché de 5 minutos | $0.125 | $0.625 | $1.25 | $2.50 |
| Escritura de caché de 1 hora | $0.20 | $1.00 | $2.00 | $4.00 |
| Batch API | 50 % de descuento en entrada y salida | 50 % de descuento | 50 % de descuento | 50 % de descuento |
Anthropic fijó la barrera en 100.000 tokens porque, según su publicación de lanzamiento, cerca del 90 % de las solicitudes a Haiku 4.5 quedaban por debajo. Con una carga de ese tipo, Haiku 5.5 iguala el precio de lista de $0.10/$0.50 de GPT-6 Luna. Con otra forma de carga, bueno, el hilo de HN hizo las cuentas rápido:
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."
También hay una diferencia más discreta entre los tokens de Claude y los de OpenAI. Otro comentarista señaló que "modern Claude's 100K tokens are about ~60-65K modern GPT tokens", así que el mismo documento alcanza antes el límite de Haiku que el de Luna. Profundizo en el lado del coste en mi reseña de Claude Haiku 5.5 y en los precios de GPT-6 Luna.
Introduce tus propias cifras abajo para ver cuánto te cuesta un mes de llamadas y dónde empieza a notarse la barrera de 100k. Usa recuentos de tokens tal como los cuenta Haiku 5.5.
Como ejemplo, prueba 50.000 solicitudes con 6.000 tokens de prompt y 800 de salida. En Haiku 5.5 eso son $50 al mes, mientras que Sonnet 5.5 son $1.000. Luego sube el prompt a 120.000 tokens y verás cómo Haiku se multiplica por 5.
Cómo acceder a Claude Haiku 5.5 y usarlo
Haiku 5.5 está disponible en todas las plataformas por las que vende Anthropic: la Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry y Claude Platform on AWS. También puedes usarlo en las apps de claude.ai, donde Anthropic publica su prompt de sistema.
Aquí tienes una llamada mínima a la API. El esfuerzo se fija de forma explícita y no hay parámetros de muestreo:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[
        {"role": "user", "content": "Tag this ticket as billing, shipping, bug or other: ..."}
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Unos cuantos hábitos que me ahorraron tiempo de depuración más adelante:
- Selecciona los bloques de contenido por
type. Una respuesta puede abrir con un bloque de pensamiento aunque nunca hayas pedido pensamiento, así que no des por hecho que el primer bloque es la respuesta. - Omite
temperature,top_pytop_k. En Haiku 5.5, cualquier valor distinto del predeterminado te da un error 400. - Gestiona
stop_reason: "refusal". Haiku 5.5 ejecuta clasificadores de seguridad que a veces rechazan una solicitud, y según la guía de migración ningún modelo de respaldo en el servidor la recoge.
Quienes tienen un plan de Claude ahora pueden probarlo más o menos gratis. Desde la semana del lanzamiento, Anthropic da créditos mensuales de API a los suscriptores de Max y Team: $100 al mes en Max 5x, $200 en Max 20x y hasta $500 compartidos en Team. Puedes gastar los créditos en cualquier modelo. Lo que no cubren son las sesiones interactivas de Claude Code.
Dentro del propio Claude Code, Haiku es una elección habitual para subagentes, y mi guía de selección de modelo en Claude Code explica cuándo cambiar.
Qué se rompe al cambiar desde Haiku 4.5
Llamar a Haiku 5.5 un reemplazo directo solo es cierto si tu código ya estaba escrito para los modelos Claude más nuevos. La guía de migración tiene una lista de 10 pasos, y estos cinco devuelven errores:
| Qué hace tu código hoy | Qué pasa en Haiku 5.5 | La solución |
|---|---|---|
Envía thinking con budget_tokens | Error 400 | Usa {"type": "adaptive"} y fija effort |
Fija temperature, top_p o top_k | Error 400 | Quítalos |
Termina messages con un turno del asistente (prefill) | Error 400 | Termina con un turno de usuario, usa salidas estructuradas |
Usa computer_20250124 en la Claude API o Google Cloud | Rechazado | Pasa a computer_toolset_20260801 |
| Edita turnos anteriores y reenvía bloques de pensamiento | Bloques de pensamiento invalidados | Mantén la conversación solo de añadir |
De estos, el cambio de temperatura es el que yo planificaría. Muchas canalizaciones de clasificación fijan la temperatura en 0 para obtener una salida repetible, y en Haiku 5.5 esa solicitud simplemente falla. Si ahora quieres consistencia, las salidas estructuradas con un esquema fijo son la mejor vía. Una cosa más: el Priority Tier no se ofrece en Haiku 5.5, así que un equipo con un compromiso de Priority en 4.5 tiene que planificar la capacidad de otra forma.
¿Para qué sirve Claude Haiku 5.5?
Cuando juzgo un modelo pequeño, primero pregunto por la tarea. ¿El prompt es corto, hay una respuesta correcta clara y además se ejecuta a gran volumen? Haiku 5.5 está hecho para tareas en las que la respuesta a todo eso es sí.
| Tarea | Encaje | Por qué |
|---|---|---|
| Clasificación de tickets y etiquetado | Fuerte | Prompts cortos, etiquetas fijas, funciona con esfuerzo Low |
| Resúmenes de tickets y notas de traspaso | Fuerte | Rápido en Medium, lo bastante barato para ejecutarlo en cada ticket |
| Enrutamiento y priorización | Fuerte | La velocidad importa más que la profundidad |
| Respuestas del centro de ayuda (RAG) | Fuerte, si los prompts se mantienen por debajo de 100k | Menor tasa de alucinación que Luna, ventana de 1M si hace falta |
| Subagentes bajo un líder Sonnet u Opus | Fuerte | Anthropic y Cognition señalan este uso |
| Uso de navegador y de ordenador | Bueno | 72,4 % en OSWorld 2.1, el Claude más rápido |
| Bucles largos de agentes y programación difícil | Débil | 39,2 % frente a 70,6 % de Sonnet 5.5 en Terminal-Bench 4.0 |
La gente subestima la velocidad. En una evaluación de eesel, un comprador sometió al bot de soporte de eesel a una revisión minuciosa de 67 pruebas y encontró sólidas las respuestas de conocimiento. Aun así se fue, porque el widget de chat se sentía lento y se atascaba. Las buenas respuestas no pudieron salvar una experiencia lenta. Haiku 5.5 es el modelo más rápido de Anthropic a velocidad estándar, y una medición de OpenRouter compartida en HN lo sitúa en aproximadamente el doble del rendimiento de Luna, así que responde directamente a ese tipo de venta perdida.
En Hacker News, los desarrolladores a quienes más les gustó fueron los que hacían justo este tipo de trabajo corto y fundamentado:
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Otro probador le dio una tarea demasiado grande para él, y pareció conocer sus propios límites:
"One interesting thing is it took a look at the job at hand, and immediately delegated it to Opus 5.5. It at least knows what it isn't good at. Very fast though, and likely best used for small subagent tasks / tightly scoped work."
Qué dicen los desarrolladores
El hilo de lanzamiento en Hacker News fue mayormente positivo sobre precio y velocidad. Las quejas reales se redujeron a dos: la barrera de 100k y los equipos cuyas propias evaluaciones no coincidían con los gráficos de Anthropic.
"It's absolutely better than Luna. It feels closer to a "sonnet 5.2" if that makes sense. Of course it's not as big, and hence falls-off quicker."
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Me tomaría en serio ese segundo comentario. Haiku 4.5 funcionaba sin pensamiento por defecto, así que un prompt ajustado para él puede comportarse distinto en un modelo que piensa con esfuerzo Medium nada más sacarlo de la caja. Anthropic publicó una guía de prompts para Haiku 5.5 justo para esto. Si un prompt migrado se vuelve más lento, mi primer paso sería bajar el esfuerzo a Low.
El panorama más amplio de modelos pequeños lo cubro en mis publicaciones sobre alternativas a Claude Haiku 5.5, Gemini 3.8 Flash y GLM-5.3 Flash.
Respuestas tan rápidas como Haiku en tu cola de soporte con eesel
Si lees sobre Haiku 5.5 por una cola de soporte, entonces el modelo es la parte fácil. Lo difícil es todo lo que lo rodea: qué tickets reciben el modelo rápido, cómo se mantienen los prompts por debajo de la barrera de 100k, con qué nivel de esfuerzo corre cada tarea y cómo se detectan las respuestas erróneas antes de que un cliente vea una.
Ese trabajo es lo que te quita de encima el compañero de IA para helpdesk de eesel. Se une al helpdesk que ya usas, como Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y clasifica, etiqueta, resume y responde. Cada despliegue se simula con tus tickets históricos antes de hablar con un solo cliente, así que primero ves cómo habría gestionado la cola del mes pasado.

Si prefieres manejarlo desde una terminal, la CLI de eesel ejecuta el mismo compañero y el mismo espacio de trabajo que el panel, de modo que un script o un agente de programación como Claude Code puede configurarlo y revisar su trabajo. Es básicamente el patrón de líder y ayudante que Anthropic recomienda para Haiku, apuntado a tu configuración de soporte. Mis publicaciones sobre la CLI de agentes de IA y los servidores MCP profundizan más.
Los planes empiezan en $299 por 500 créditos, aunque puedes ejecutarlo gratis sobre una muestra de tickets reales antes de pagar nada. Prueba eesel y comprueba si las respuestas más rápidas llegan de verdad a tus clientes.
Preguntas frecuentes
¿Qué es Claude Haiku 5.5?
claude-haiku-5-5. Tiene una ventana de contexto de 1M de tokens, hasta 128K tokens de salida, pensamiento adaptativo con un ajuste de esfuerzo, y está pensado para trabajo de alto volumen como clasificación, enrutamiento, extracción, resúmenes y tareas de subagentes.¿Cuánto cuesta Claude Haiku 5.5?
¿Es Claude Haiku 5.5 mejor que Haiku 4.5?
¿Cuál es la diferencia entre Claude Haiku 5.5 y Sonnet 5.5?
¿Cómo uso Claude Haiku 5.5?
model: "claude-haiku-5-5", o usa anthropic.claude-haiku-5-5 en Amazon Bedrock. Omite temperature, top_p y top_k, y fija output_config.effort en low, medium, high, xhigh o max. También está en Google Cloud, Microsoft Foundry y Claude Platform on AWS. Para equipos de soporte, el compañero de IA para helpdesk de eesel ejecuta modelos rápidos dentro de tu helpdesk sin escribir código.¿Es Claude Haiku 5.5 bueno para atención al cliente?
¿Qué se rompe al cambiar a Claude Haiku 5.5?
budget_tokens, temperature, top_p o top_k distintos del valor por defecto, el prefill de mensajes del asistente, la antigua herramienta computer_20250124 en la Claude API y Google Cloud, y las ediciones de turnos anteriores cuando reenvías bloques de pensamiento. Además, el nuevo tokenizador cuenta cerca de un 30 % más de tokens para el mismo texto. La publicación sobre alternativas a Claude Haiku 5.5 explica adónde ir si esos cambios no te convienen.