

Resumen
Mistral Large 4 es el mayor salto individual que he visto de Mistral: 38,4 en el Artificial Analysis Intelligence Index, frente a 9,3 de Large 3. También es rápido, barato por token durante su oferta de preview a mitad de precio, y el único modelo de clase frontera que conozco cuyo creador promete alojamiento europeo y pesos abiertos en el mismo mes.
Pero las cifras independientes lo sitúan a mitad de tabla, no en cabeza. Va por detrás de Kimi K3 y Qwen 3.8 Max, puntúa casi igual que modelos que cuestan una cuarta parte por tarea, y alucinó en el 41,9 % de las preguntas que falló en la prueba de conocimiento de Artificial Analysis. Los gráficos de lanzamiento de Mistral destacan pruebas de ciberseguridad y de derecho, y esas victorias parecen reales pero acotadas.
Mi veredicto: elígelo si necesitas un proveedor de la UE o trabajo de seguridad sin rechazos. Descártalo si solo quieres la mejor respuesta por dólar. Y si piensas ponerlo frente a clientes, la elección del modelo importa menos que las salvaguardas alrededor, que es justo lo que ya hace el compañero de helpdesk con IA de eesel en Zendesk, Freshdesk y Gorgias.
¿Qué es Mistral Large 4?
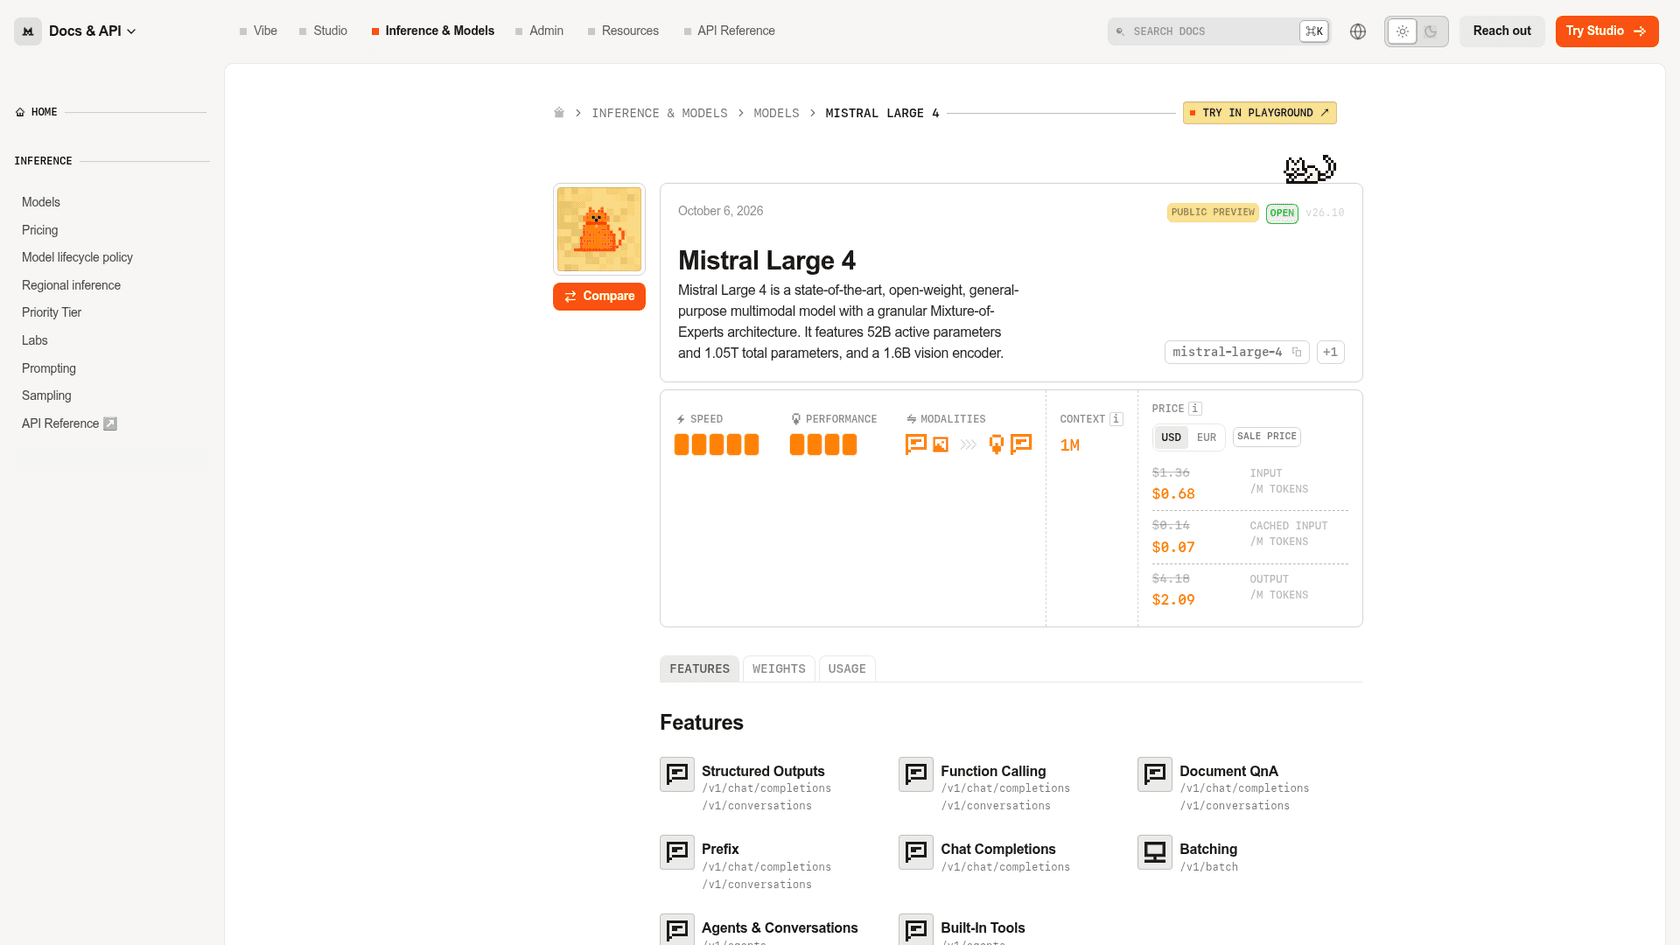
Mistral Large 4 es el nuevo buque insignia de Mistral, lanzado el 6 de octubre de 2026 como preview pública y apodado "Le Chonk". Según su ficha del modelo, es un LLM de mezcla de expertos con 1,05 billones de parámetros totales, 52.000 millones activos por token, un codificador de visión de 1.600 millones y una ventana de contexto de 1 millón de tokens. Es un modelo híbrido: puedes pedirle que razone primero con el ajuste reasoning_effort, o que responda directamente.
Una nota rápida sobre mi punto de partida. Escribo y llevo el SEO del blog de eesel, y quienes buscan "reseña de Mistral Large 4" rara vez tienen curiosidad por el número de parámetros. Tienen una pregunta más concreta: ¿es lo bastante bueno para cambiar, y para qué? Esa es la pregunta que responde esta reseña. Para la ficha técnica completa, consulta mi resumen de Mistral Large 4, y para todos los niveles de precio, mi desglose de precios de Mistral Large 4.
No he ejecutado el modelo yo mismo, así que mis opiniones se apoyan en quienes sí lo han hecho: las pruebas independientes de Artificial Analysis, la documentación de Mistral y los informes de uso real en Hacker News, Reddit y X durante los primeros tres días.
Reseña de Mistral Large 4 de un vistazo
Aquí va la versión corta, antes del detalle.
| Qué revisé | Resultado | Fuente |
|---|---|---|
| Inteligencia general | 38,4 en el AA Intelligence Index (mediana de su nivel de precio: 26) | Artificial Analysis |
| Salto sobre Large 3 | 9,3 a 38,4, unas 4,1x | AA: Large 3 |
| Posición entre rivales cercanos | Detrás de Kimi K3 (43,6) y Qwen 3.8 Max (45,4) | AA |
| Precio (oferta de preview) | 0,68 $ entrada / 2,09 $ salida por 1 M de tokens | Precios de Mistral |
| Costo por tarea de AA | 1,13 $ a precio de lista, unos 0,57 $ en oferta | Artificial Analysis |
| Tasa de alucinación | 41,9 % en AA-Omniscience | Artificial Analysis |
| Velocidad de salida | 116,1 tokens/s; ~18,7 s hasta el primer token de respuesta | Artificial Analysis |
| Verbosidad | 200 M de tokens para ejecutar el índice vs 81 M de mediana | Artificial Analysis |
| Pesos abiertos | Prometidos para finales de octubre de 2026, aún no disponibles | Mistral |
| Mejor en | Tareas de ciberseguridad sin rechazos, agentes legales, anclaje visual | Gráficos de lanzamiento de Mistral |
¿Qué arregló realmente Mistral?
El titular honesto es que Mistral vuelve a estar en la carrera. En diciembre pasado, Mistral Large 3 puntuó 9,3 en el mismo índice, lejos de la frontera. Large 4 puntúa 38,4. Esa es la diferencia entre un modelo para resúmenes baratos y uno sobre el que podrías ejecutar un agente de IA.
El equipo de Plotly lo pasó por su benchmark de analítica de datos el día del lanzamiento y vio el mismo salto desde otro ángulo:
"Es 10 veces más barato que Mistral Medium 3.5 de abril y pasa del 58 % al 74 % de aciertos. Sin duda un cambio generacional."

El inconveniente es de dónde viene ese salto. Large 4 es un modelo de razonamiento y Large 3 no lo era, así que buena parte de la mejora se compró con tokens de razonamiento.
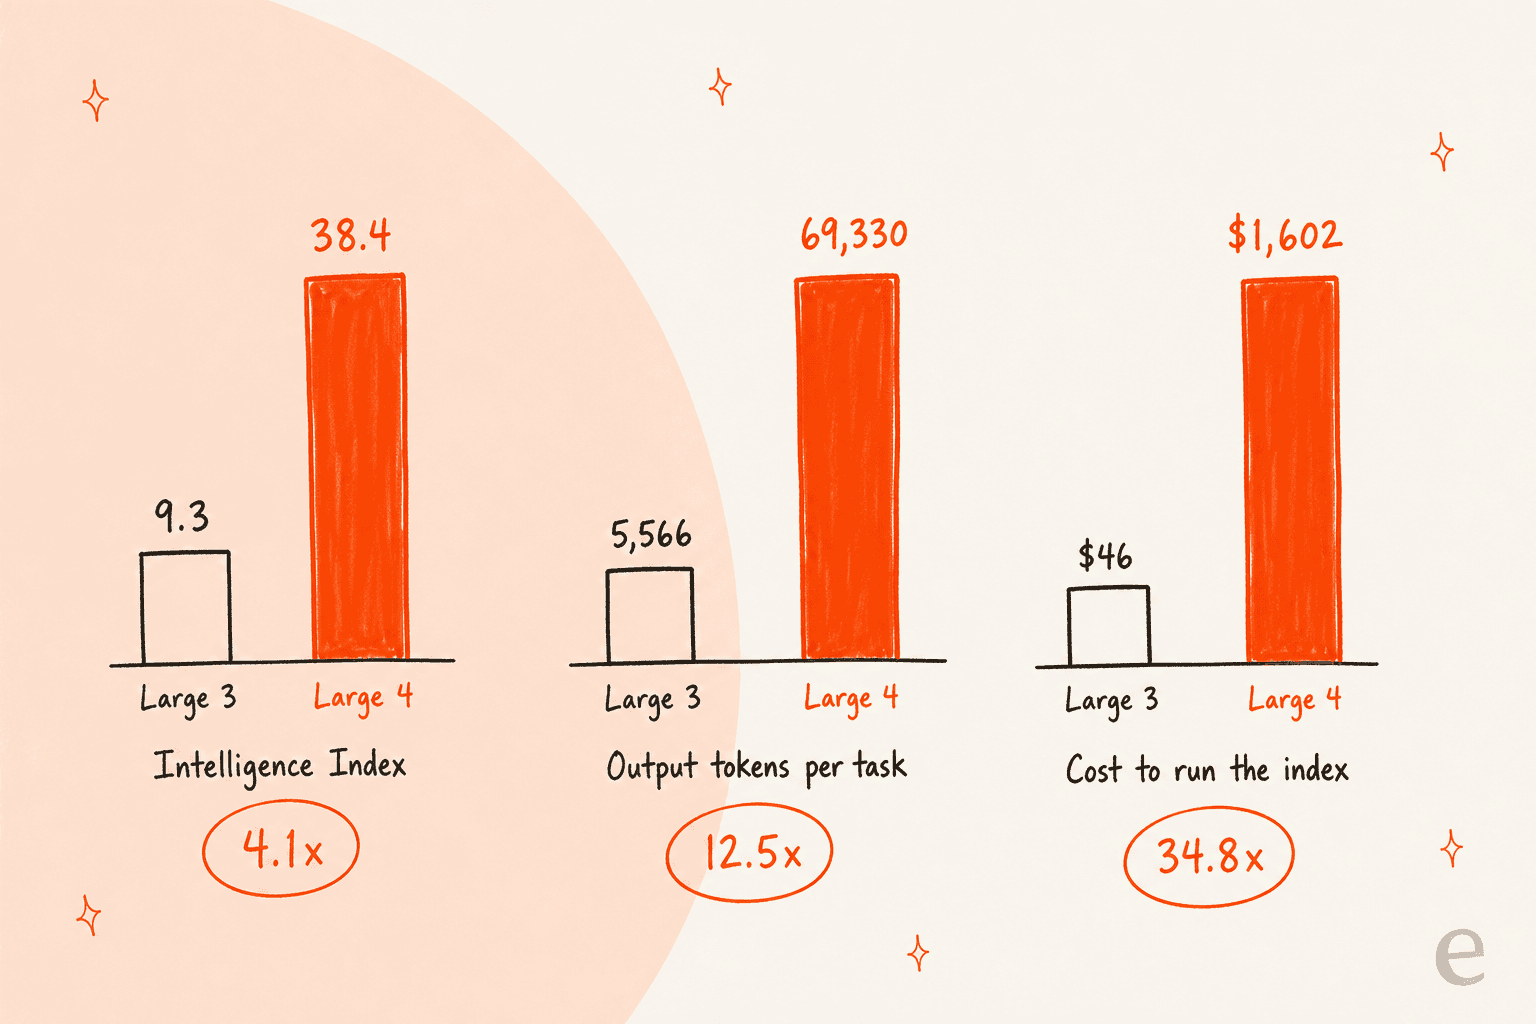
La puntuación subió unas 4,1 veces. Los tokens que escribe por tarea subieron 12,5 veces, y el costo de ejecutar el índice completo a precio de lista subió 34,8 veces, de 46 $ a 1.602 $, según Artificial Analysis. No es una crítica al modelo; todos los laboratorios pagaron el mismo peaje por el razonamiento. Pero significa que el precio por token es una mala guía de lo que te costará Large 4. Artificial Analysis lo califica de "muy verboso": 200 M de tokens para completar el índice frente a una mediana de 81 M.
Cómo se compara Mistral Large 4 en benchmarks independientes
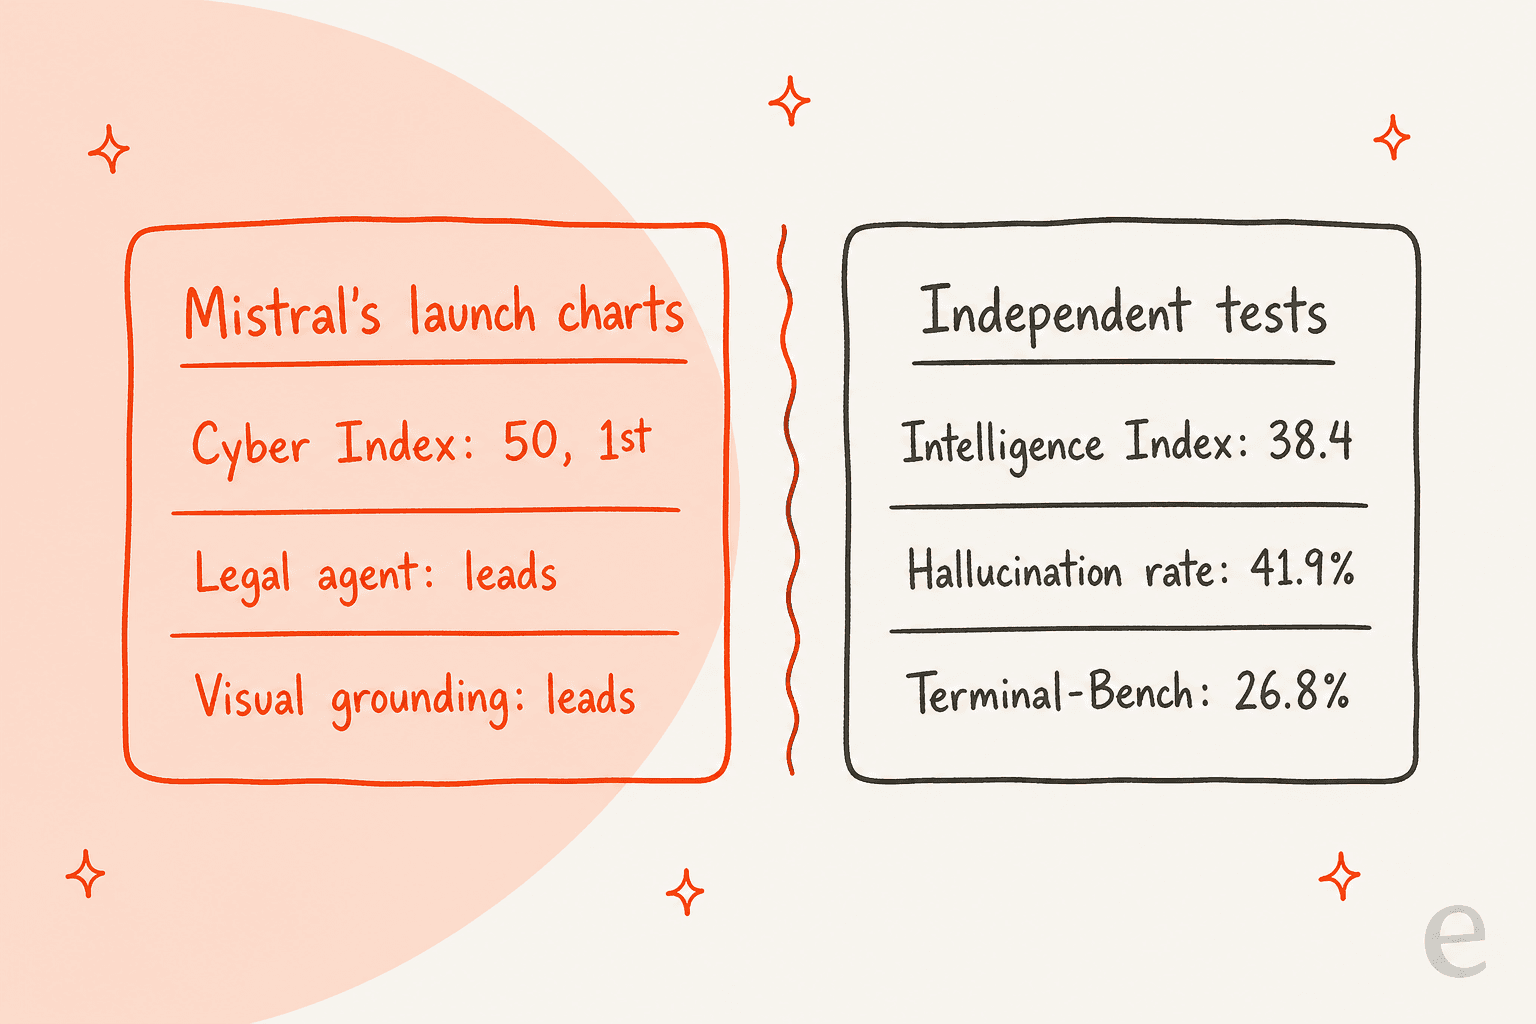
Aquí la reseña se vuelve menos halagadora. La publicación de lanzamiento de Mistral está llena de gráficos, y la mayoría muestra a Large 4 ganando. El panorama independiente es más mixto.
En el índice v4.3.2 de Artificial Analysis, que combina 10 evaluaciones, así queda Large 4 entre los modelos con los que se compara:
| Modelo | Índice AA | Precio entrada / salida por 1 M (lista) | Costo por tarea de AA | Velocidad de salida |
|---|---|---|---|---|
| Claude Sonnet 5.5 (Xhigh) | 51,9 | 2 $ / 10 $ | 2,01 $ | 100,7 t/s |
| Qwen 3.8 Max | 45,4 | 2 $ / 6 $ | 5,41 $ | 37,6 t/s |
| Kimi K3 | 43,6 | 3 $ / 15 $ | 2,00 $ | 41,7 t/s |
| Gemini 3.8 Flash | 40,9 | 0,75 $ / 3,75 $ | 1,24 $ | 125,2 t/s |
| DeepSeek V4.1 Flash | 39,5 | 0,30 $ / 1,20 $ | 0,27 $ | 216,1 t/s |
| Mistral Large 4 Preview | 38,4 | 1,36 $ / 4,18 $ | 1,13 $ | 116,1 t/s |
| GPT-5.6 Luna | 37,3 | 0,20 $ / 1,20 $ | 0,18 $ | 117,0 t/s |
Todas las cifras proceden de las páginas de modelos de Artificial Analysis, consultadas el 8 de octubre de 2026. El costo por tarea de Large 4 se reduce aproximadamente a la mitad con el precio de oferta actual.
Dos cosas destacan. Primero, Large 4 es más barato por tarea que todos los modelos por encima y emite más rápido que Kimi K3 y Qwen 3.8 Max. Segundo, DeepSeek V4.1 Flash y GPT-5.6 Luna están a un punto aproximadamente y cuestan una fracción por tarea, incluso tras el 50 % de oferta de Mistral. Si tu trabajo es "respuestas decentes, muchas", esos dos son la competencia más dura.
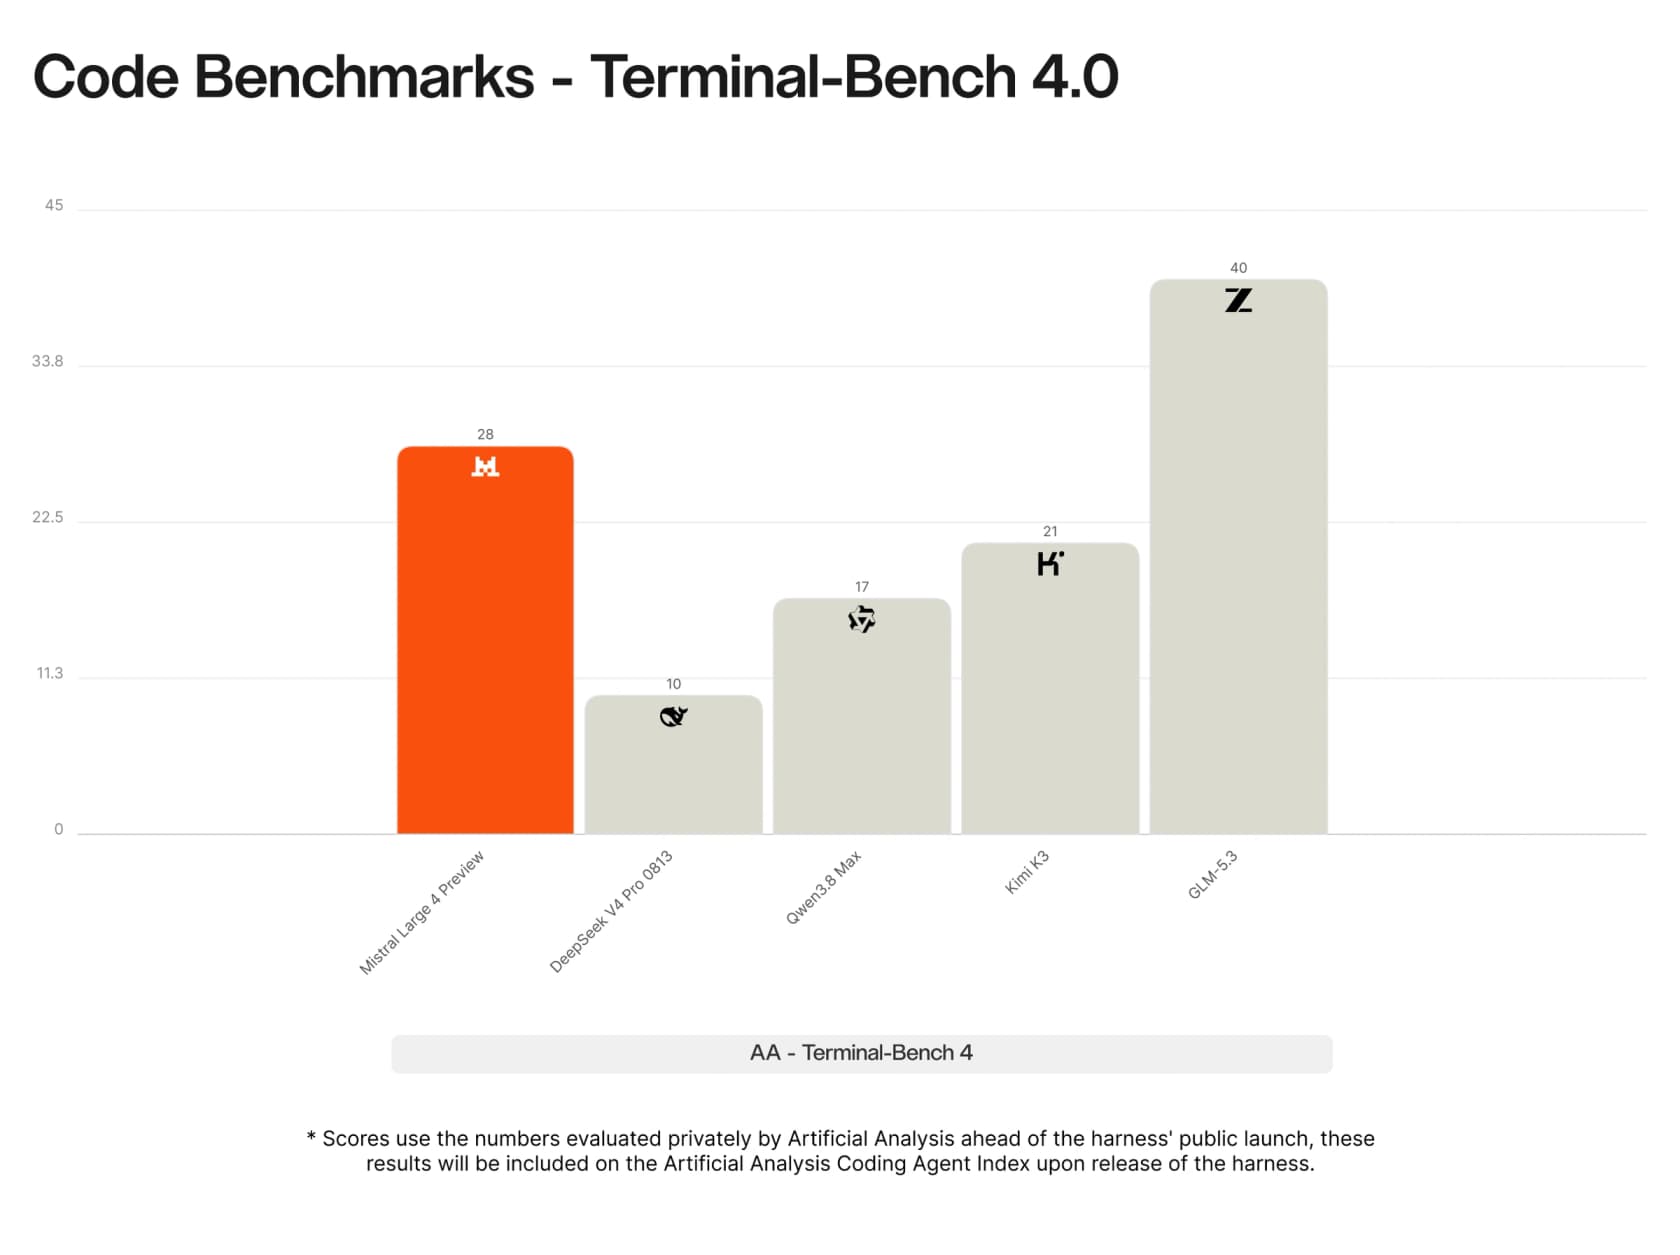
El gráfico de Terminal-Bench 4.0 de Mistral es un buen ejemplo de cómo importa el encuadre. Muestra a Large 4 en 28, por delante de Qwen 3.8 Max y Kimi K3, pero bastante por detrás de GLM-5.3 con 40.
Algunos lectores de Hacker News fueron más directos sobre la elección de gráficos. Un comentarista comparó un gráfico multimodal con las cifras públicas de Artificial Analysis y encontró una discrepancia:
"No conozco este benchmark, pero el listado GDP.pdf de AA tiene a Sol 5.6 Max en 27, incluso sin razonamiento supera el 12,8. Es rarísimo elegir a conveniencia Sol 5.6 y además mentir sobre la puntuación publicada del benchmark de terceros."
Yo no llegaría a decir "mentir". Las versiones y configuraciones de los benchmarks difieren, y los gráficos de Mistral pueden usar otra ejecución. Pero es una buena razón para leer los gráficos de los proveedores como el mejor escenario y tomar la página de Artificial Analysis como referencia.
Dónde Mistral Large 4 es realmente fuerte
Estar a mitad de tabla en general no significa estarlo en todo. Tres áreas resisten el escrutinio.
Trabajo de seguridad sin rechazos. En el Cyber Index de Artificial Analysis, según el gráfico de Mistral, Large 4 puntúa 50, por delante de Kimi K3 y DeepSeek V4.1 Flash con 41. Lo más interesante del gráfico son las barras grises: otros modelos de frontera tuvieron una gran proporción de intentos detenidos por bloqueos de seguridad.
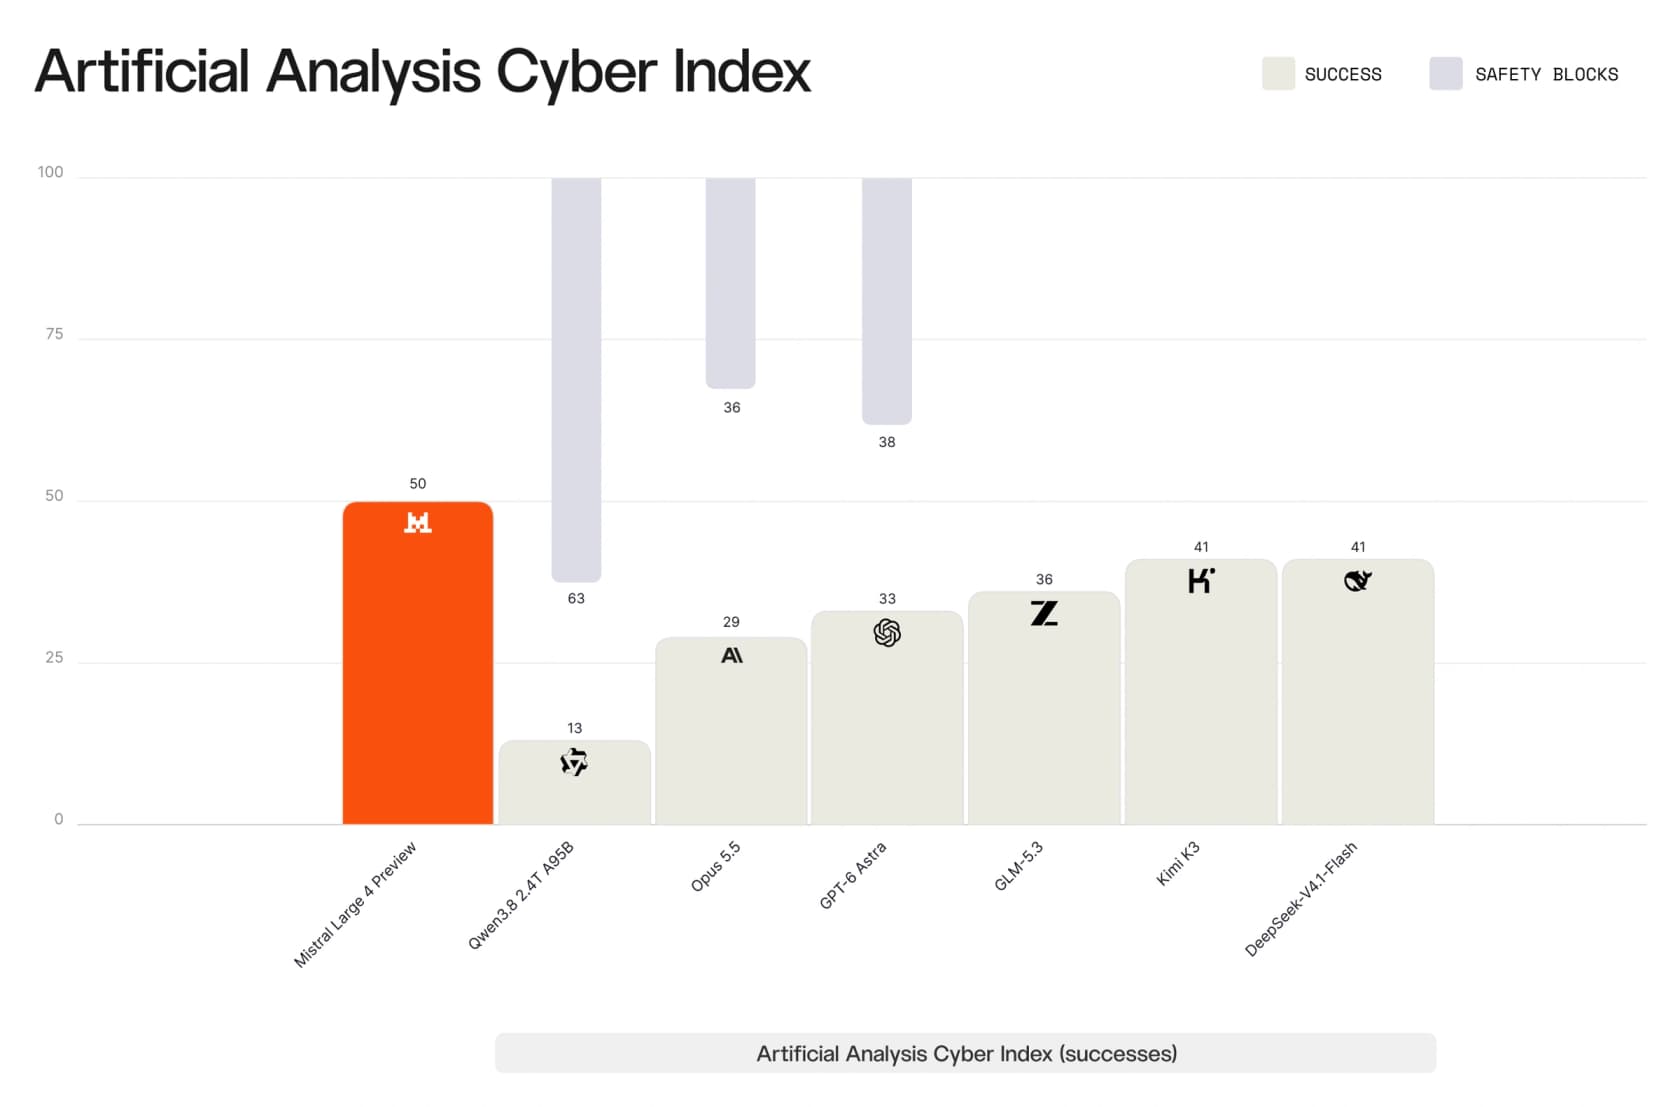
El cofundador de Mistral Guillaume Lample defendió justo este ángulo el día del lanzamiento, diciendo que los modelos abiertos "no se niegan a ayudar". Si diriges un equipo de seguridad y tu modelo actual se niega una y otra vez a examinar código de exploits en tu propio stack, es una razón real para probar Large 4.
Trabajo legal y documental. El gráfico de Mistral de Vals.ai sitúa a Large 4 liderando el benchmark de agente legal de Harvey, y Artificial Analysis le da un 81,3 % en AA-LCR, su prueba de razonamiento de contexto largo. Los contratos largos encajan bien con una ventana de 1 M de tokens.
Velocidad una vez que empieza a hablar. Con 116,1 tokens por segundo en la API de Mistral, emite bastante más rápido que Kimi K3 y Qwen 3.8 Max. Un primer probador en Hacker News lo valoró como herramienta de uso diario por ese motivo:
"Es muy rápido vía OpenRouter (bastante mejor que Kimi K3) en webui. Muy verboso y parece que empieza a olvidar instrucciones después de un rato, pero me dio bastante información útil durante media hora de chat sobre C y programación embebida."
Fíjate en la parte central de esa cita. "Empieza a olvidar instrucciones" es algo que importa mucho más en producción que en una ventana de chat.
Dónde se queda corto Mistral Large 4
Los puntos débiles son igual de concretos.
Recuerdo factual y alucinación. Este es el número que marcaría en rojo si lo evaluara para cualquier uso de cara al cliente. En AA-Omniscience, que formula preguntas de conocimiento y premia al modelo por decir "no lo sé" en lugar de adivinar, Large 4 acertó el 25,8 % y tuvo una tasa de alucinación del 41,9 %, para una puntuación global de -5,3, según Artificial Analysis. Un probador en Hacker News vio lo mismo en un juego de preguntas:
"Mistral Large 4 no es muy bueno. A veces puede resolver un juego con ~40 intentos mientras que los mejores modelos como Gemini 3.8 Flash o Grok 4.7 resuelven la mayoría de los acertijos a la primera. Mi benchmark coincide con AA Omniscience."
Tiempo hasta la primera respuesta. Es un modelo de razonamiento, así que piensa antes de hablar. Artificial Analysis midió unos 18,7 segundos hasta el primer token de respuesta con un prompt largo y 28,4 segundos con 100.000 tokens. Está bien para un agente de back-office y es doloroso para un widget de chat en vivo.
Programación agéntica. Va por detrás de GLM-5.3 en Terminal-Bench y obtuvo un 26,8 % en la propia ejecución de Artificial Analysis. Algunos informes de uso real fueron aún más duros:
"Estuve probándolo un rato, para análisis de código, clasificación de imágenes y capacidad de ajedrez. Se siente bastante anticuado y muy por detrás de lo que suelo usar."

Para ser justos con Mistral, esto es una preview. Lample dijo en X que el entrenamiento de aprendizaje por refuerzo "sigue en curso", y se espera una versión final con los pesos. Las puntuaciones pueden cambiar antes de fin de octubre.
¿Son los "pesos abiertos" una razón para elegirlo hoy?
Todavía no. La ficha del modelo lleva una insignia "Open", pero el campo de licencia está vacío y, al 9 de octubre, la página de Mistral en Hugging Face no tiene repositorio de Large 4. Artificial Analysis lo lista como propietario hasta que lleguen los pesos.
Incluso cuando se publiquen, un modelo de 1,05 billones de parámetros no es algo que la mayoría de los equipos ejecute en una GPU de sobra. La respuesta con más me gusta al tuit de lanzamiento de Mistral lo dijo mejor:
"yo con 12 GB de VRAM leyendo 'pesos abiertos, 1,05T de parámetros'"
El valor práctico de los pesos abiertos aquí es para grandes empresas y gobiernos que quieran alojar un modelo capaz en su propio hardware en Europa. Para todos los demás, está la API, y la API es una preview con un aviso de retirada de un mes, no los seis meses que tiene un modelo de disponibilidad general. Construir un flujo de producción sobre una preview implica aceptar que puede cambiar con cuatro semanas de aviso.
¿Quién debería usar Mistral Large 4?
Tras todo lo anterior, mi respuesta se reduce a dos preguntas: ¿necesitas que tus datos permanezcan en Europa (o en tus propios servidores), y es la precisión pura lo más importante para tu caso de uso?
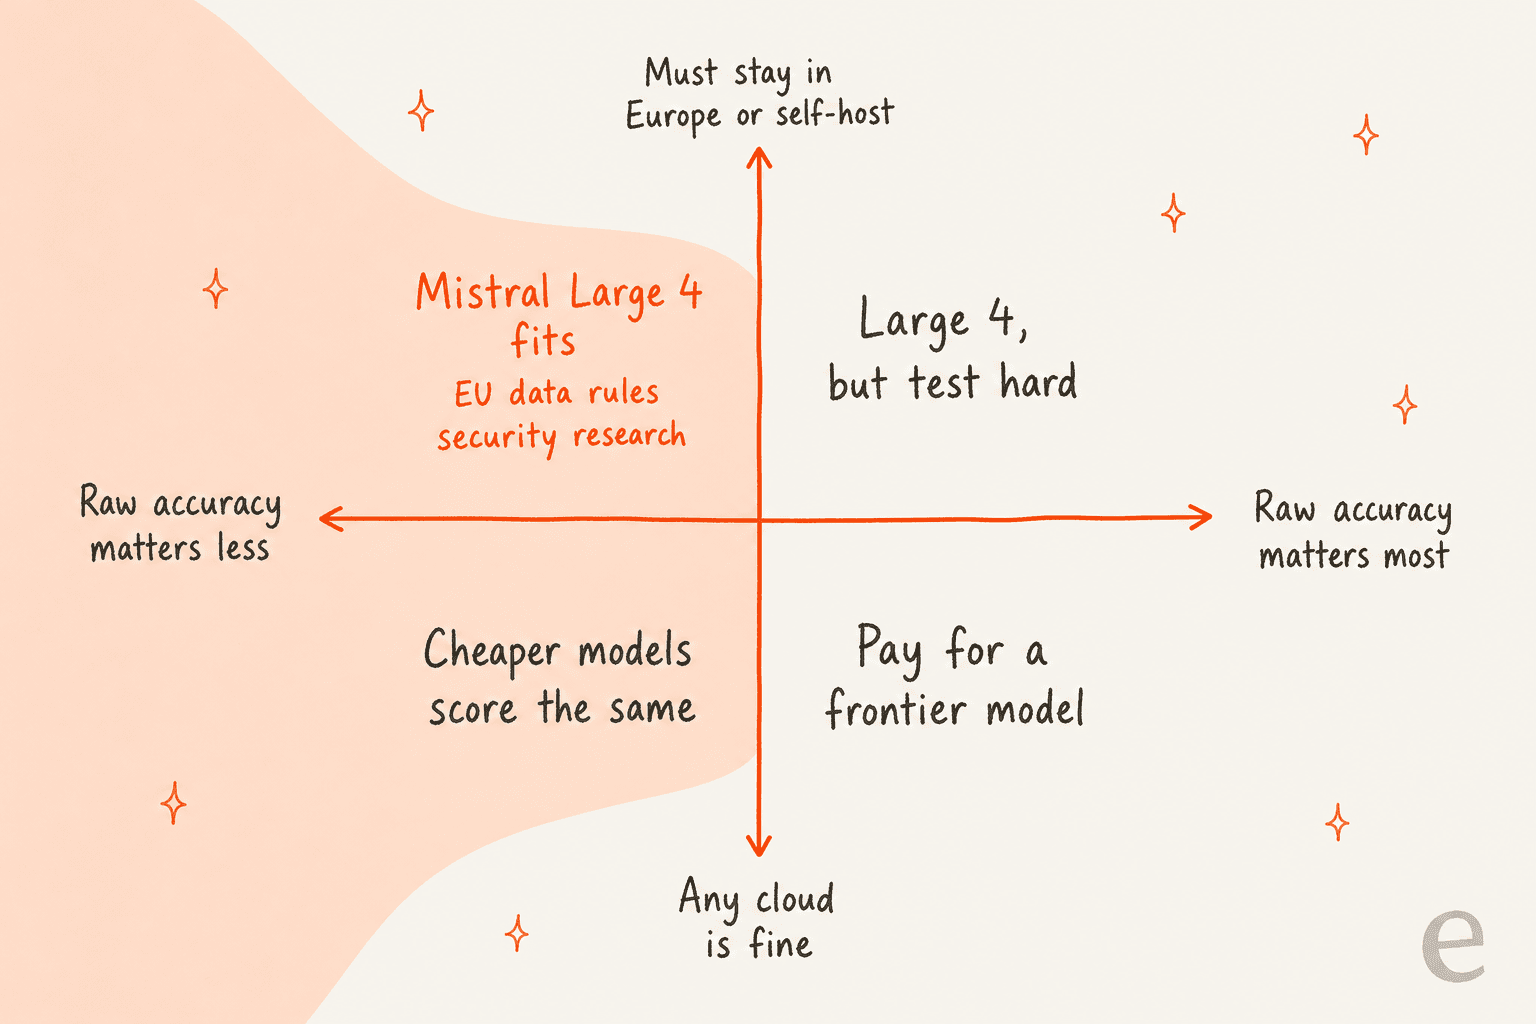
El argumento de la soberanía es real, y muchos comentaristas lo dijeron sin rodeos:
"En la mayoría de los flujos de trabajo corporativos probablemente es suficientemente bueno. Y no tienes que venderle tu alma a Xi ni a Trump. Como europeo, temía algo mucho peor."
Prueba el test de encaje de abajo para ver dónde cae tu caso de uso.
¿Qué es lo más importante para tu carga de trabajo?
Elige una opción para ver mi veredicto.
Qué significa esto si diriges un equipo de soporte
Mucha gente que lee reseñas de modelos ahora se pregunta si un modelo europeo más barato podría impulsar su bot. Lo entiendo. Pero el número de alucinación es el que yo meditaría.
He visto qué pasa cuando un bot de soporte responde desde la memoria del modelo en lugar de desde tus documentos. A principios de este año, unos cuantos clientes de pago de eesel tenían un bot que, cuando la búsqueda en la base de conocimiento no devolvía nada, rellenaba el hueco con sus datos de entrenamiento en lugar de derivar. Uno envió detalles de suscripción inventados a clientes reales. Otro respondió una pregunta de soporte con "Oxígeno", el elemento de la tabla periódica. Fue un problema de respaldo, no de modelo, y un modelo más grande no lo habría arreglado. Por eso cada despliegue de eesel se simula ahora con tickets pasados antes de tocar a un cliente.
Una responsable de CX de una marca de suplementos que gestiona unos 7.000 tickets expresó el requisito real mejor que cualquier benchmark:
"Necesito una IA que solo gestione los tickets que está segura de poder gestionar y deje en paz todos los demás."
Eso es primero un problema de enrutamiento y de puntuación de confianza, y después de modelo. Un modelo con un 41,9 % de alucinación hace esa capa más importante, no menos. Si construyes tu propio bot sobre Large 4, mis guías sobre RAG para soporte, cómo detener las alucinaciones y el mejor LLM para soporte son un buen punto de partida. Y si tu motivo para elegir Mistral son las normas de datos de la UE, comprueba primero qué exigen realmente SOC 2 y RGPD al proveedor; el país de origen del modelo es solo una parte.
Alternativas a Mistral Large 4 que vale la pena probar
Si la reseña te hace dudar, esto es lo que miraría en su lugar, según lo que necesites:
| Quieres | Mira | Por qué |
|---|---|---|
| Más precisión, aún asequible | Sonnet 5.5 o Kimi K3 | 51,9 y 43,6 en el índice AA |
| La misma puntuación, menor costo | Familia DeepSeek V4 Flash, GPT-5.6 Luna | 39,5 y 37,3 a entre 0,18 $ y 0,27 $ por tarea |
| Pesos abiertos que puedes ejecutar hoy | DeepSeek V4.1 Flash, GLM-5.3 | Ambos figuran como open-weight junto a Large 4 en esta comparación de AA |
| Un Mistral más barato | Large 3 o Small 4 (ver precios de Mistral AI) | 0,50 $/1,50 $ y 0,15 $/0,60 $ por 1 M |
Para una lista más larga, mi recopilación de alternativas a Mistral y los cara a cara de Claude vs Mistral y ChatGPT vs Mistral profundizan más.
El veredicto
Mistral Large 4 es un regreso real de un laboratorio que parecía estancado. El salto de puntuación es real, el precio es justo mientras dure la oferta, y la velocidad es buena. Si necesitas un proveedor europeo o un modelo que de verdad ayude con trabajo de seguridad, es el que probaría primero.
Para todos los demás, las cifras aún no justifican el cambio. Está casi a la par de modelos que cuestan una cuarta parte por tarea, alucina más de lo que yo aceptaría para trabajo de cara al cliente, y la versión que pruebas hoy es una preview que puede cambiar con un mes de aviso. Volvería a mirar tras la versión final y los pesos de finales de octubre, y entonces decidiría.
Prueba eesel
Si llegaste aquí porque estás eligiendo un modelo para un bot de soporte, este es el atajo: el modelo es infraestructura, y eesel es el empleado. El compañero de helpdesk con IA de eesel se conecta a Zendesk, Freshdesk o Gorgias, aprende de tus tickets pasados y tu centro de ayuda, y ejecuta una simulación sobre cientos de tus tickets reales para que veas sus respuestas antes que un cliente. La elección del modelo, el anclaje y la alternativa de "no lo sé, paso a una persona" están resueltos, y pagas por ticket gestionado, así que un modelo verboso nunca aparece en tu factura. Los planes empiezan gratis en la página de precios.

Prueba eesel y repite tu último mes de tickets antes de decidir nada.