

Qué publicó realmente Z.ai el 12 de octubre
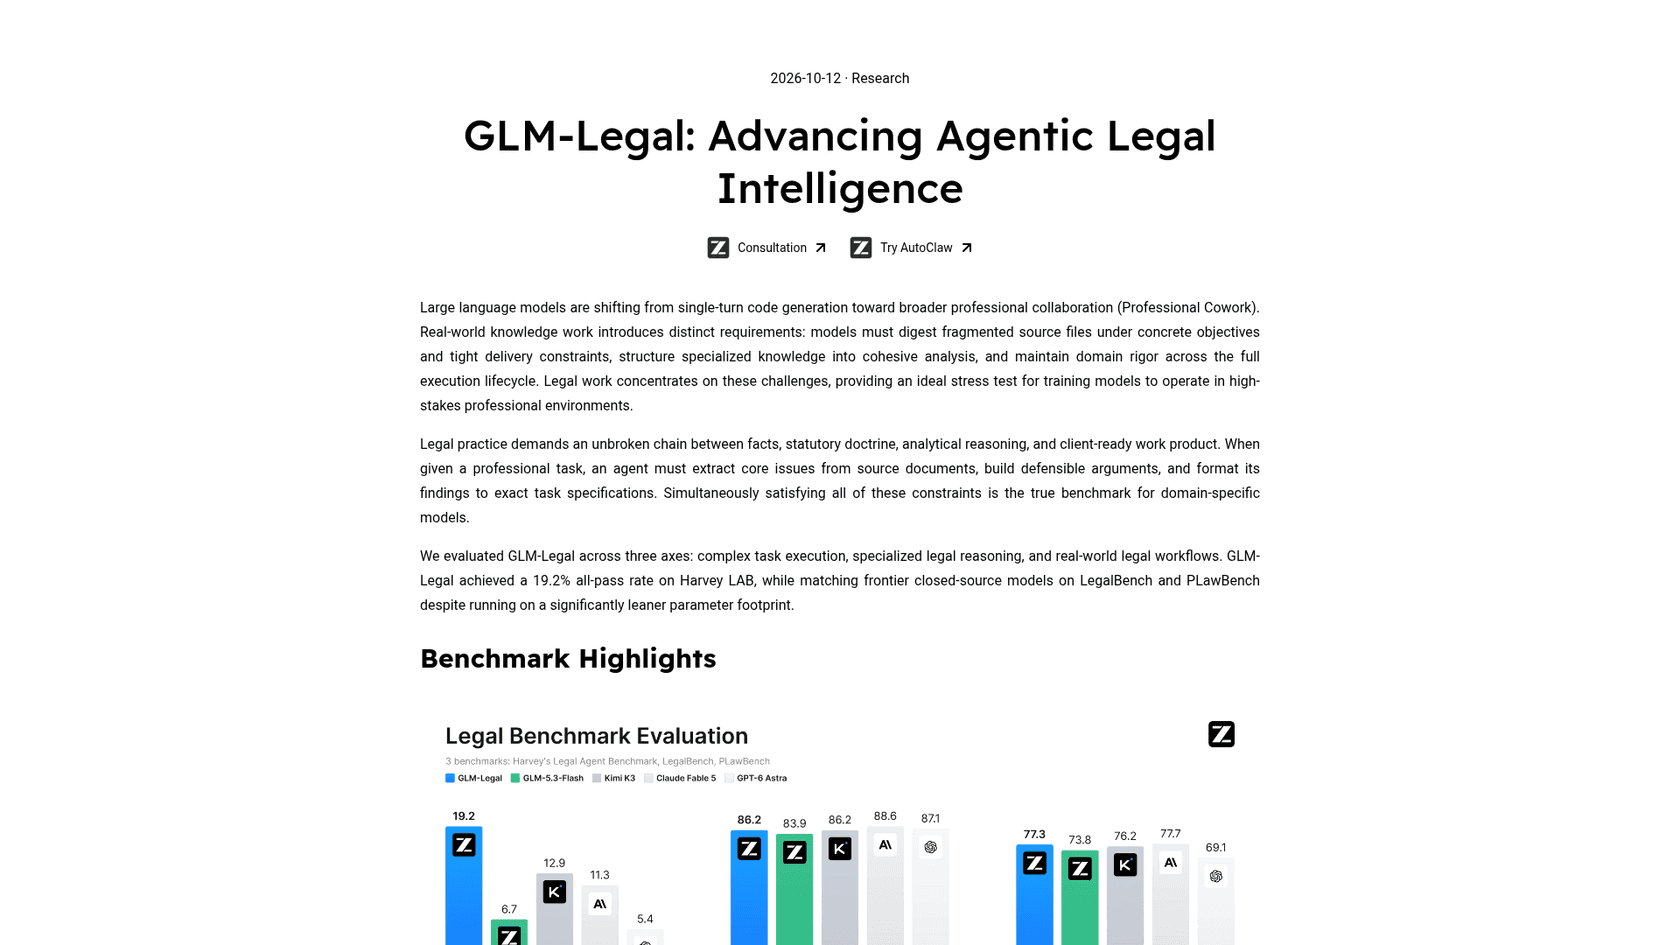
Z.ai publicó GLM-Legal como un artículo de investigación titulado "Advancing Agentic Legal Intelligence", con dos botones arriba: uno para un formulario de consulta y otro para AutoClaw, su aplicación de agente de escritorio. La publicación de lanzamiento en X tiene más de 7.000 me gusta, y el hilo de Hacker News llegó a 594 puntos y 332 comentarios.
Esto es lo que trae y lo que no:
| Lo que Z.ai dice o muestra | |
|---|---|
| Modelo base | GLM-5.3-Flash, un modelo de mezcla de expertos de 320B parámetros con 18B activos |
| Ventana de contexto | 1M de tokens; 128k de salida máxima (ficha del modelo en Vals) |
| Entrada | Solo texto en las pruebas de Vals, aunque el modelo base maneja imágenes |
| Trabajo objetivo | Revisión de contratos, análisis de pruebas, investigación de cumplimiento |
| Usuarios objetivo | Despachos de abogados, empresas de legal tech, equipos internos, abogados independientes |
| Acceso | Prueba de API por solicitud; compatibilidad con AutoClaw "pronto" |
| Precio | No publicado |
| Pesos | Sin descarga en la página de Hugging Face de Z.ai a 14 de octubre |
Si seguiste el lanzamiento de GLM-5.2 o el de Flash en agosto, el patrón te resultará familiar: Z.ai toma un modelo general potente y lo apunta a un trabajo concreto. Lo nuevo es que ese trabajo es una profesión regulada y que el lanzamiento es restringido.
Cómo funciona GLM-Legal por dentro
Z.ai describe tres etapas de entrenamiento, y la tercera es la interesante.
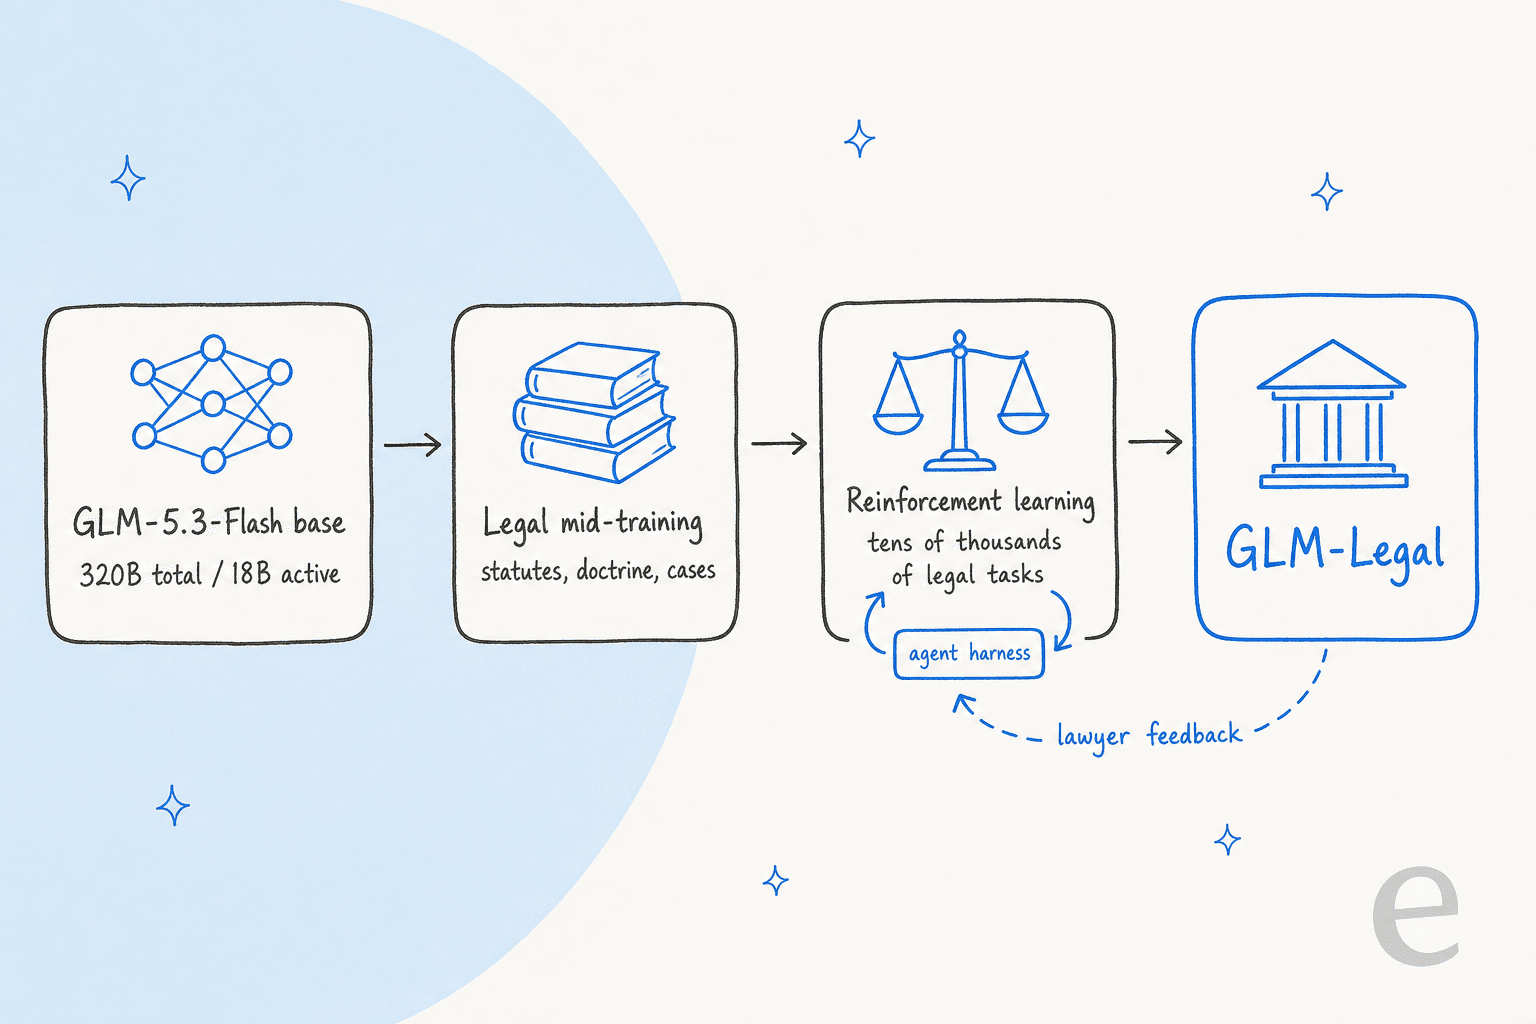
1. Entrenamiento intermedio con texto jurídico. Z.ai "expanded the volume of high-quality legal corpora" para que el modelo aprenda leyes, doctrina y cómo las interpretan los abogados. Es el movimiento habitual de los LLM específicos de dominio y, por sí solo, ayuda sobre todo a recordar.
2. Aprendizaje por refuerzo dentro de un arnés de agente. Esta es la parte a la que prestaría atención. El modelo se entrenó "across tens of thousands of realistic legal environments", donde planifica un análisis, abre archivos, redacta un entregable y recibe una calificación. El arnés (el código que le entrega al modelo sus archivos y herramientas) se entrenó junto con él. Cuando el modelo fallaba, Z.ai corregía también el arnés, y a la inversa.
He construido agentes sobre modelos generales durante años, y la mayoría de los errores que persigo no son "el modelo es tonto". Son "el modelo no leyó el archivo correcto" o "dio formato incorrecto a la respuesta para el paso siguiente". Entrenar el modelo y su arnés juntos ataca justo esa clase de fallo. También significa que GLM-Legal probablemente se comportará mejor dentro del arnés propio de Z.ai, AutoClaw, y de forma menos predecible dentro del tuyo.
3. Un ciclo con abogados en ejercicio. Z.ai dice que los abogados califican las salidas con preguntas como "Are all critical issues and edge cases addressed?" y "Are arguments well-substantiated and citations legally sound?" Esas calificaciones alimentan la siguiente ronda de entrenamiento.
Nada de esto se publica como un artículo con las fuentes de datos. Un comentarista de HN señaló que, sin conocer el conjunto de entrenamiento, no se pueden descartar tareas muy parecidas a las de la prueba. Ten eso presente en la siguiente sección.
Las tres demos que muestra Z.ai
La publicación de lanzamiento compara GLM-5.3-Flash y GLM-Legal en las mismas tres tareas. La diferencia es sobre todo de concreción. En un contrato de servicios de software, el modelo base sugiere "consider shortening the notice period". GLM-Legal dice que se recorte "from 60 to 30 days", que se elimine el plazo de subsanación para incumplimientos de propiedad intelectual, confidencialidad y seguridad de datos, y que se añada "up to 90 days of transition assistance".
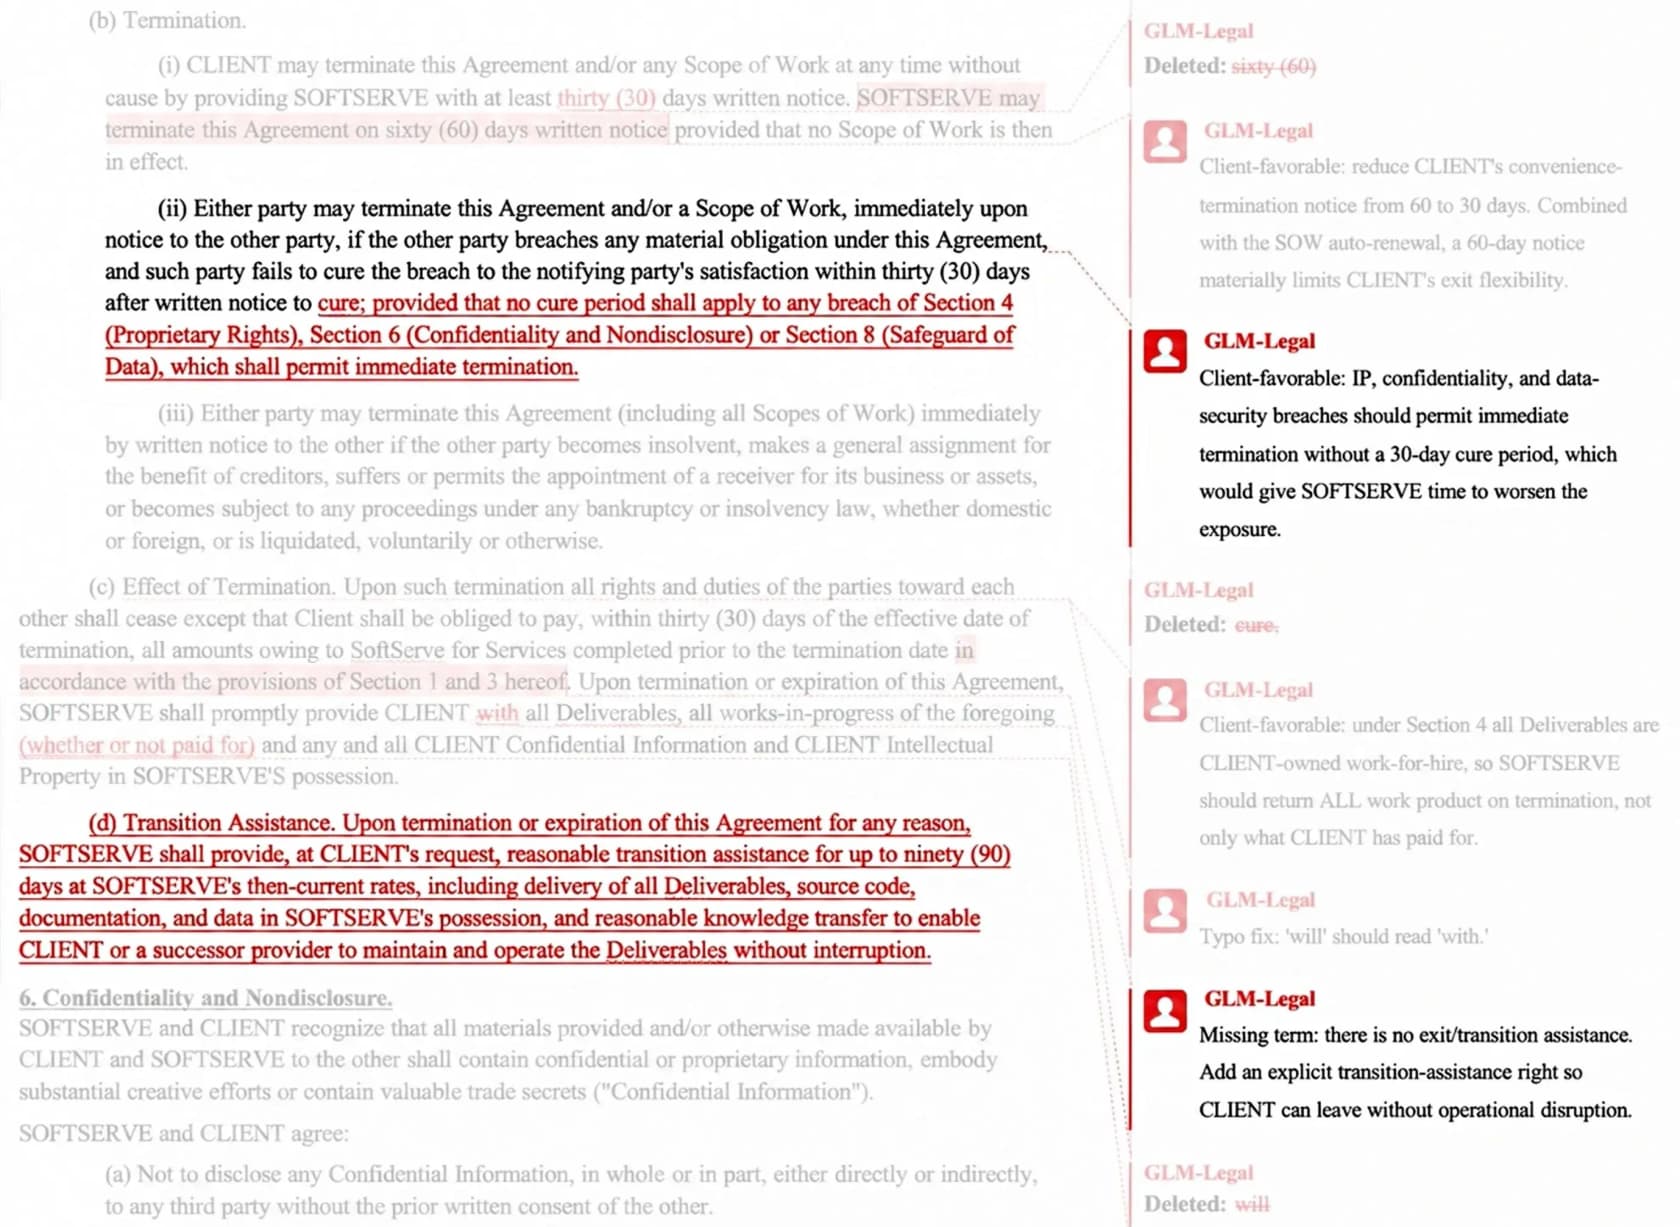
El resultado llega como cambios con control de cambios y comentarios en un archivo de Word, que es la forma correcta: un abogado acepta o rechaza cada edición en lugar de fiarse de un resumen.
La segunda demo lee 40 documentos de una disputa por un proyecto de software y construye una cronología con cada entrada citada a un número de documento. GLM-Legal relaciona un informe al cliente de "60% complete" con una instantánea interna de en torno al 41 % y con un correo que dice al personal que siga facturando. La tercera planifica el cumplimiento de privacidad para un lanzamiento en Singapur, Malasia e Indonesia, con referencias a artículos de la ley de datos de cada país.
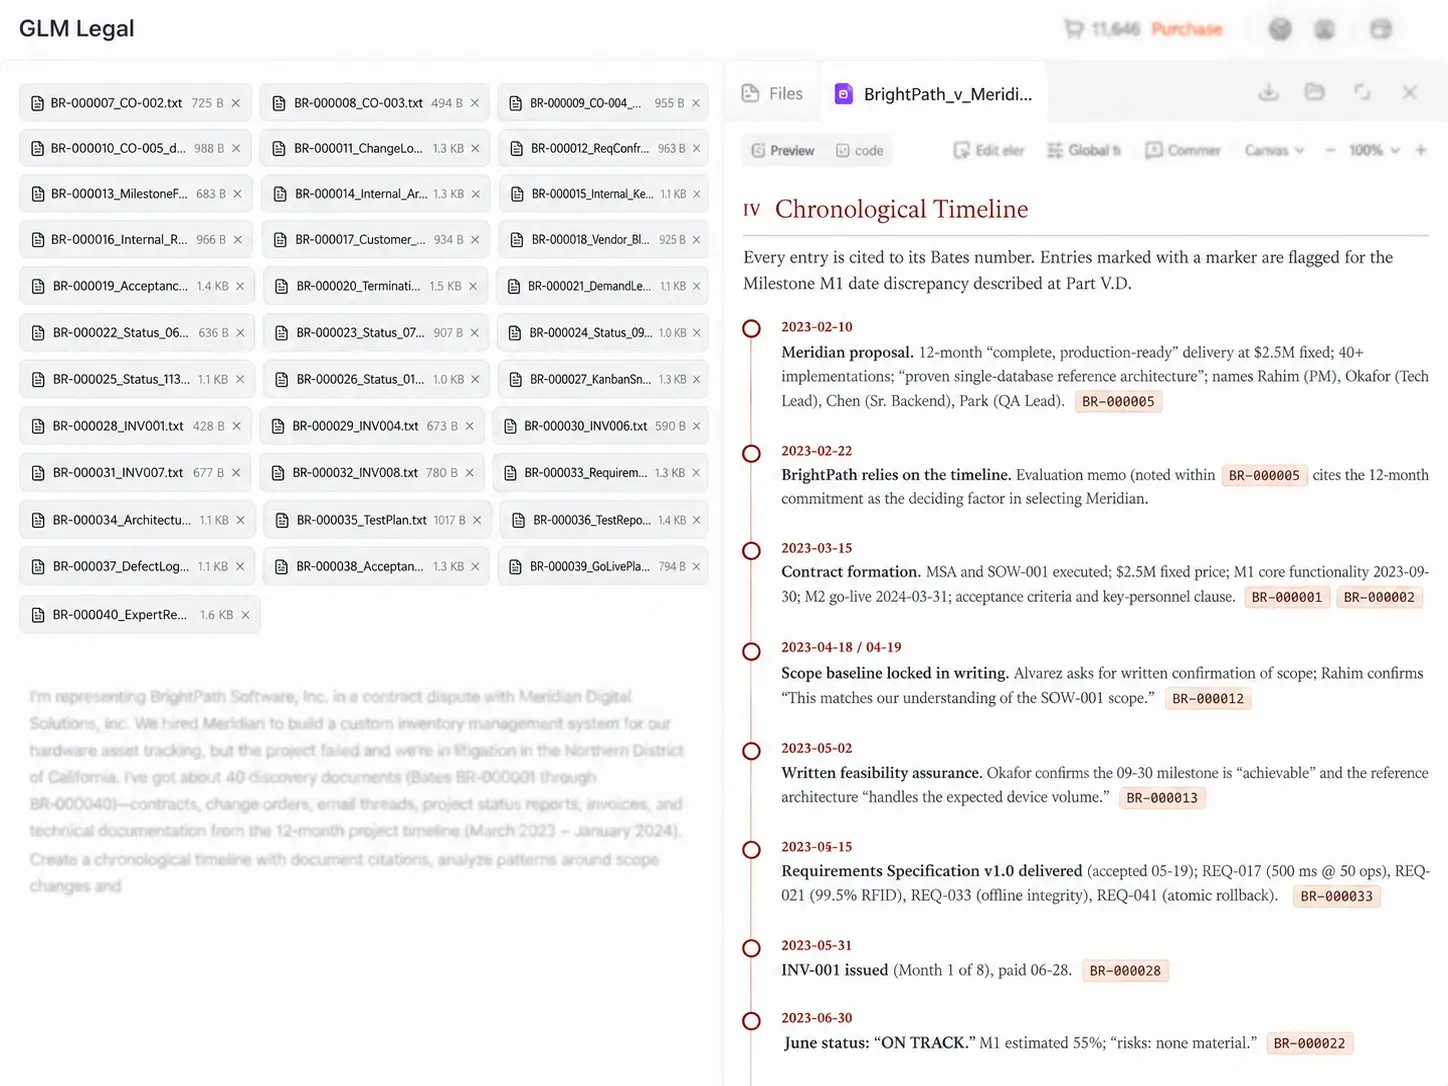
Estas demos están escogidas a propósito, por definición. Aun así, el hábito que muestran (citar el documento fuente de cada afirmación) es el que hace verificable la salida de una IA, y en trabajo jurídico lo verificable importa más que lo ingenioso.
Benchmarks de GLM-Legal: qué significa realmente el 19,2 %
El gráfico de Z.ai compara GLM-Legal con su propio modelo base, Kimi K3, Claude Fable 5 y GPT-6 Astra en tres pruebas.
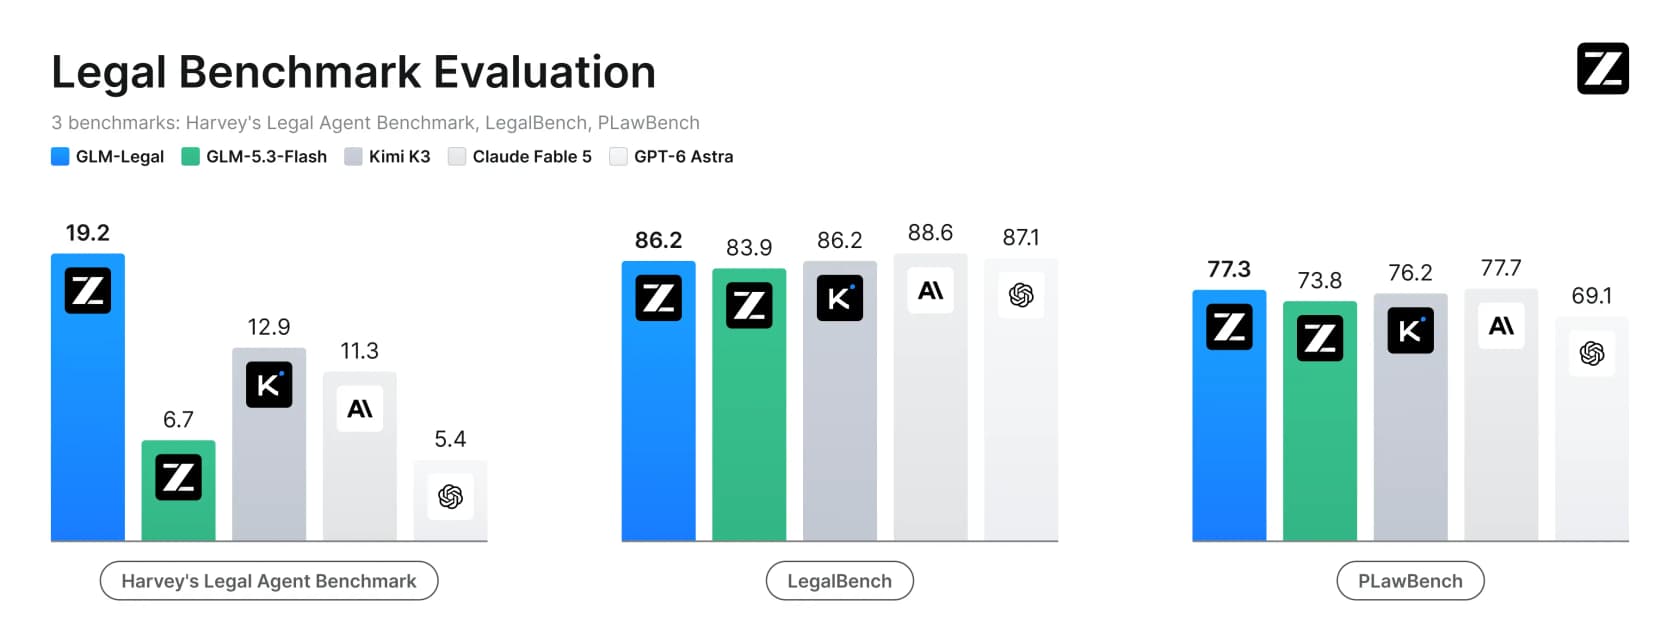
| Benchmark (gráfico de Z.ai) | GLM-Legal | GLM-5.3-Flash | Kimi K3 | Claude Fable 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Harvey Legal Agent Benchmark | 19.2 | 6.7 | 12.9 | 11.3 | 5.4 |
| LegalBench | 86.2 | 83.9 | 86.2 | 88.6 | 87.1 |
| PLawBench (derecho chino) | 77.3 | 73.8 | 76.2 | 77.7 | 69.1 |
Léelo con atención y "matches frontier models" significa algo más acotado de lo que suena. GLM-Legal gana una columna con claridad. En LegalBench y PLawBench empata o queda uno o dos puntos por debajo de Claude Fable 5. Sigue siendo un resultado sólido para un modelo con 18B de parámetros activos, pero es paridad en las pruebas más antiguas y ventaja en una nueva.
Por qué las puntuaciones parecen tan bajas
El Legal Agent Benchmark de Harvey le da a un agente una carpeta de archivos, seis herramientas (leer, editar y escribir archivos, más búsqueda y una shell) y habilidades de Word, Excel y PowerPoint. Cada tarea tiene una rúbrica de criterios, y la cifra principal es una tasa de acierto total: la tarea solo cuenta si se cumple cada criterio.
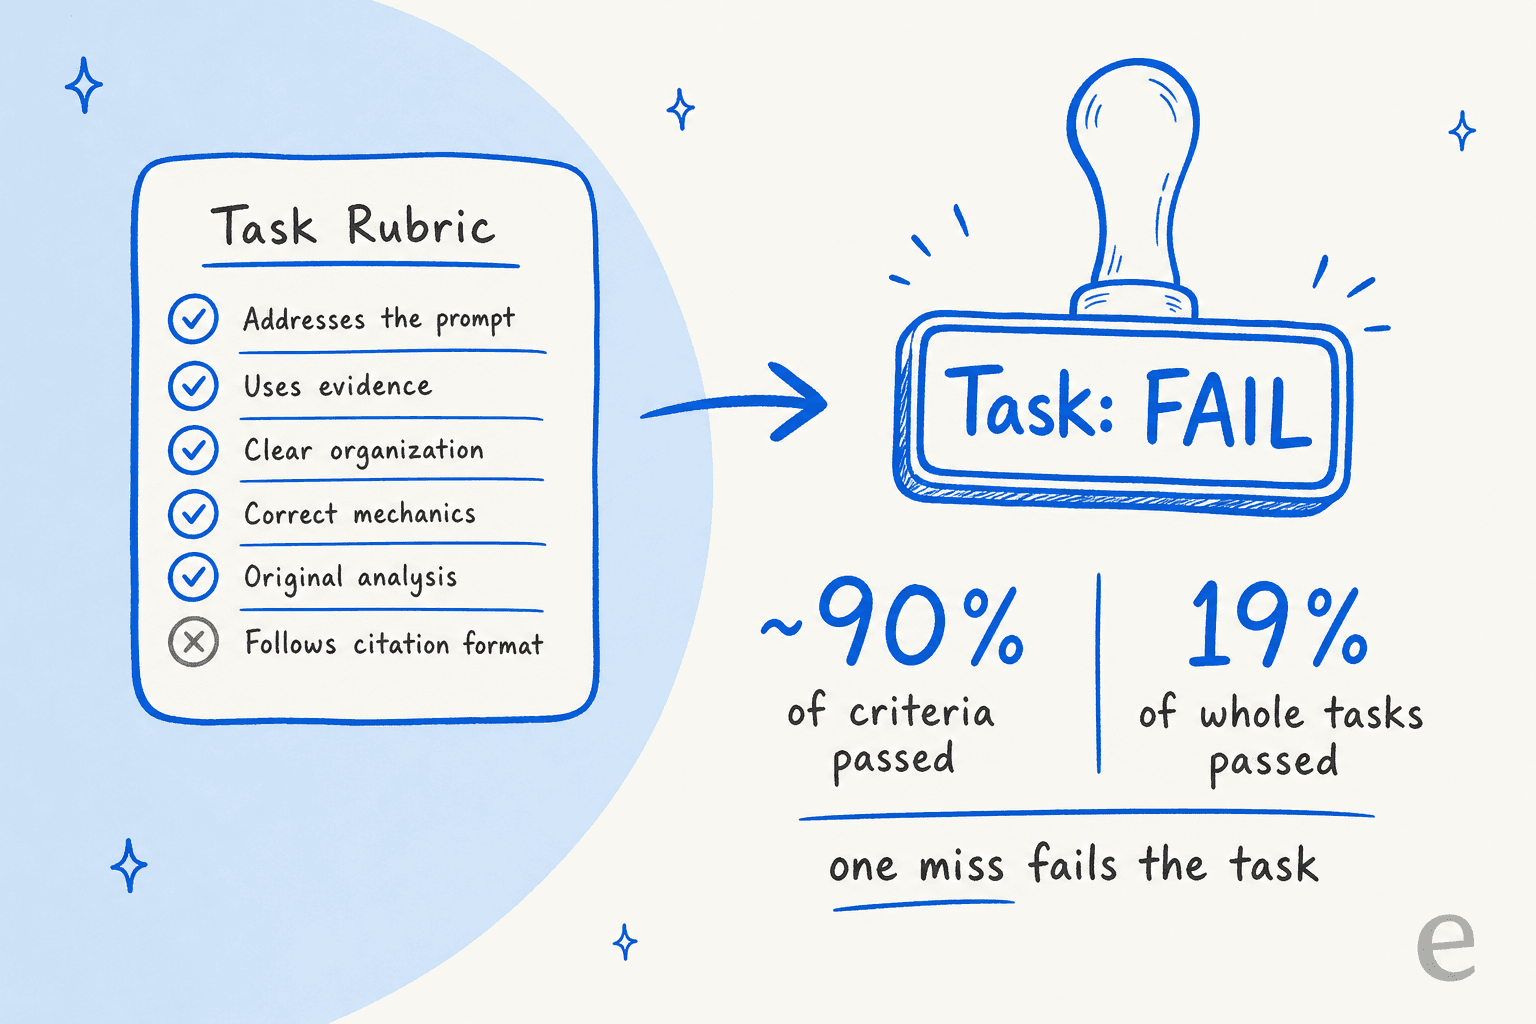
Vals señala que los mejores modelos superan alrededor del 90 % de los criterios individuales, mientras que la mejor puntuación por tarea completa es 25,42 %. Así que un modelo del 19 % no se equivoca cuatro de cada cinco veces. Suele hacer bien la mayor parte del trabajo y fallar un requisito. En trabajo jurídico, ese único fallo puede ser todo el problema, por eso la puntuación estricta es defendible.
"This is why I severely dislike using all pass rate. A model could be at like 93%, meeting practically every requirement except the broken ones and all pass would give it like 20%."

Qué añade la clasificación independiente
Z.ai envió GLM-Legal a Vals AI para una prueba independiente, y la clasificación HLAB de Vals es la vista más útil porque incluye a todos:
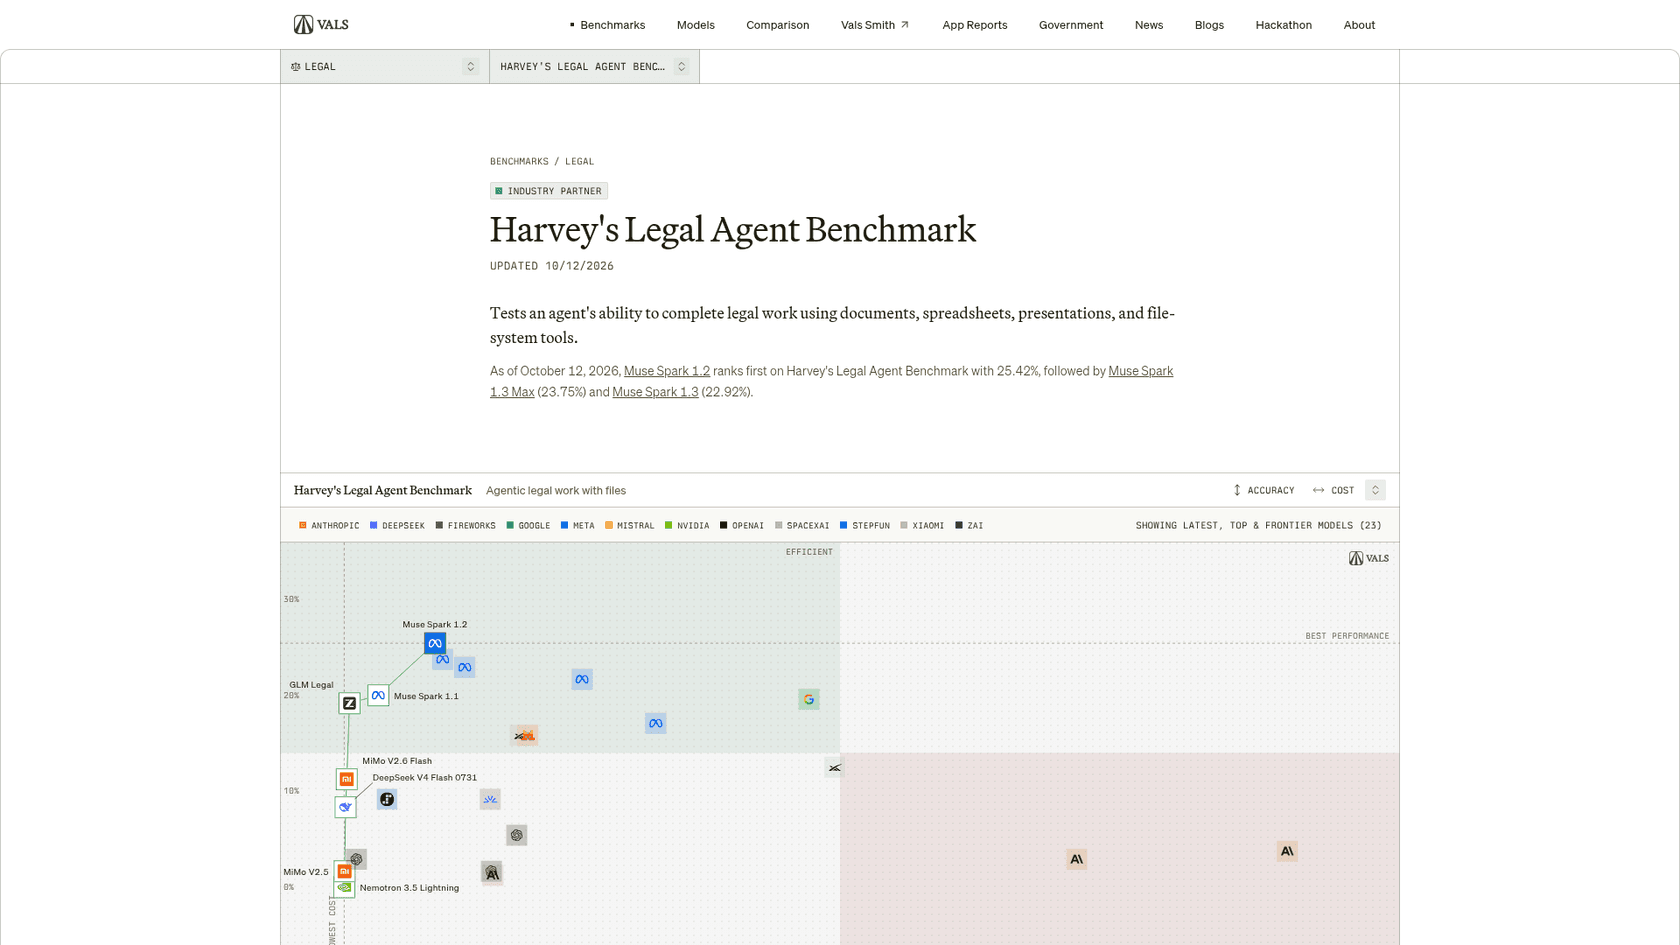
| Puesto | Modelo | Tasa de tareas superadas | Costo por tarea | Tiempo por tarea |
|---|---|---|---|---|
| 1 | Muse Spark 1.2 | 25.42% | $2.09 | 24m16s |
| 2 | Muse Spark 1.3 Max | 23.75% | $2.26 | 14m43s |
| 3 | Muse Spark 1.3 | 22.92% | $2.76 | 17m04s |
| 4 | Muse Wonder Full | 21.67% | $5.41 | 53m21s |
| 6 | Gemini 4 Argon | 19.58% | $10.55 | 43m55s |
| 7 | GLM-Legal | 19.17% | $0.15 | 1h12m |
| 9 | Mistral Large 4 | 15.83% | $4.18 | 39m25s |
| 12 | Kimi K3 | 12.92% | $3.83 | 13m58s |
| 31 | GLM-5.3-Flash (base) | 6.67% | $0.57 | 52m17s |
| 41 | Claude Opus 5.5 | 3.75% | $21.38 | 52m55s |
Destacan dos cosas. Primero, el salto de 6,67 % a 19,17 % son exactamente los 12,5 puntos que afirma Z.ai, así que la cifra del proveedor se sostiene. Segundo, cuatro modelos de Meta superan a GLM-Legal y ninguno aparece en el gráfico de Z.ai. Un comentarista de HN lo notó el día del lanzamiento. En la página del modelo en Vals, GLM-Legal también puntúa 86,23 % en LegalBench (14.º de 150, el mejor resultado de GLM ahí) y 41,83 % en Legal Research Bench (24.º de 78).
La propia prueba de Harvey también tiene críticos. Un comentarista de HN que revisó trazas de agentes dijo que "found multiple problematic tasks and rubrics" y enlazó una incidencia abierta en el repositorio de Harvey. Un margen de ±3,25 puntos sobre una puntuación del 19 % es amplio. Yo trataría a GLM-Legal y Gemini 4 Argon como empatados, no como ordenados.
La historia real: costo por tarea y la espera
Si GLM-Legal hubiera salido con 19 % a 10 $ por tarea, nadie escribiría sobre él. Importa por la factura.
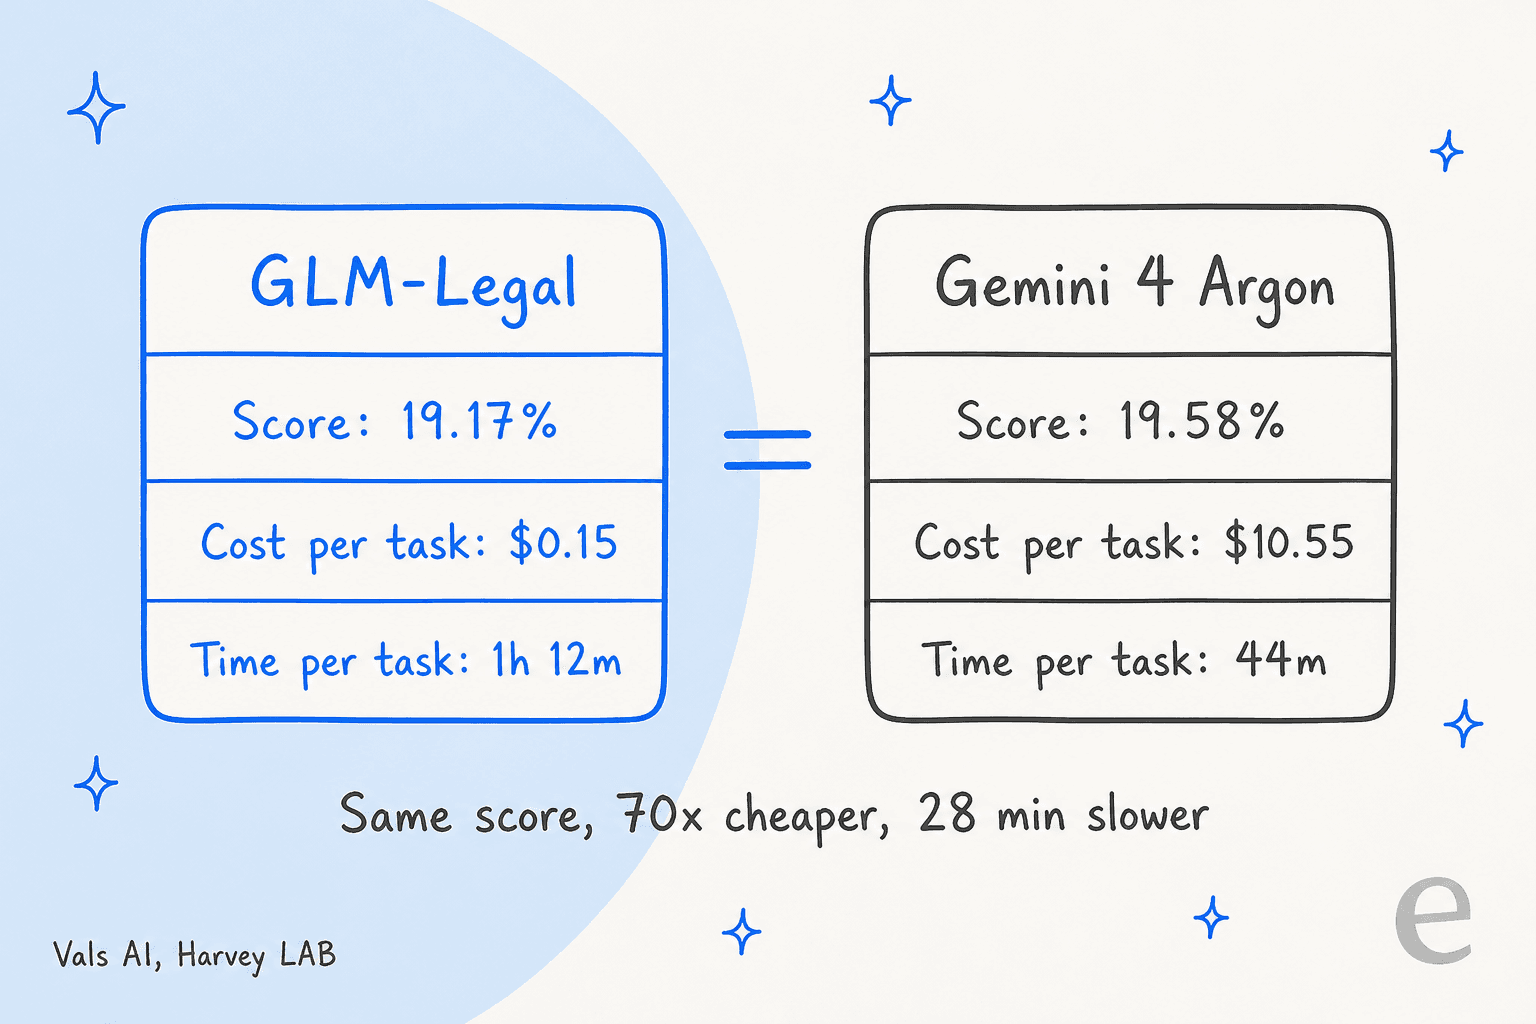
Con las cifras de Vals, GLM-Legal alcanza la puntuación de Gemini 4 Argon por cerca de 1/70 del costo, y Vals lo llama el modelo más barato del top 10. La pega es el tiempo: 72 minutos por tarea frente a 44 de Argon y 24 del líder. Para un lote nocturno de revisiones de due diligence, eso no importa. Para un abogado que espera un redline antes de una llamada, sí.
Introduce tu propio volumen mensual de tareas para ver cómo sale el intercambio:
A 500 tareas al mes, las cifras de Vals dan unos 75 $ para GLM-Legal frente a 5.275 $ para Gemini 4 Argon, con unas 600 horas de agente frente a 366. Muse Spark 1.2 queda en medio, con unos 1.045 $, y supera más tareas que cualquiera de los dos. Si solo miras puntuación por dólar, GLM-Legal gana con facilidad. Si miras tareas superadas por hora, gana el modelo de Meta.
Precios y acceso de GLM-Legal
Esta es la parte del lanzamiento que sigue casi en blanco. Esto es todo lo que es público hoy:
| Pregunta | Respuesta a 14 de octubre de 2026 |
|---|---|
| ¿Puedo registrarme y usarlo? | No. Rellenas el formulario de consulta (empresa, tamaño, cargo, caso de uso) para solicitar acceso a la API |
| ¿Hay un precio de GLM-Legal? | No en la página de precios de Z.ai |
| ¿Cuánto cuesta el modelo base? | GLM-5.3-Flash: 0,15 $ por 1M de tokens de entrada, 0,03 $ en caché, 0,50 $ de salida |
| ¿A qué tarifa probó Vals? | 0,075 $ de entrada y 0,25 $ de salida, la promoción de lanzamiento de Flash que terminó el 9 de septiembre |
| ¿Puedo usarlo en AutoClaw? | "Soon", según la publicación de lanzamiento |
| ¿Puedo descargar los pesos? | Hoy no; no hay repositorio de GLM-Legal en la página de Hugging Face de Z.ai |
La cuestión de los pesos no está resuelta. La ficha del modelo en Vals dice "Weights: Open", mientras que la publicación de lanzamiento de Z.ai nunca menciona una licencia y varios lectores de HN concluyeron que es cerrado. El modelo base es abierto, como cuenta mi reseña de GLM-5.3-Flash. Hasta que Z.ai publique pesos o una licencia, planificaría como si GLM-Legal fuera solo por API. Para un desglose completo de la tarifa del modelo base, consulta precios de GLM-5.3-Flash.
Eso importa por una razón por encima de las demás: adónde van los documentos de los clientes. Los despachos que no enviarán un contrato a la API de un laboratorio estadounidense difícilmente lo enviarán a la de uno chino, y un lanzamiento solo por API cierra la vía del autoalojamiento que hizo populares los modelos GLM anteriores entre equipos sensibles a la privacidad.
"Wait, so this not an open weight model, correct? Only available via z.ai?"
Qué dicen abogados y desarrolladores
El hilo de HN se dividió más o menos en tres bandos. Los abogados en ejercicio no quedaron impresionados por la cifra absoluta:
"As an attorney, I am not particularly impressed about a 20% pass rate on a benchmark. The name of the game for litigation practice is about being prepared for novel situations, not relitigating past ones."
Quienes conocen el benchmark señalaron en cambio la posición relativa:
"To be fair to them, on this particular benchmark (Harvey's Legal Agent) 20% puts it almost top of the pack of any model, and certainly top for any remotely in its price class."
Y un tercer grupo se preocupó por el problema más antiguo de la IA jurídica: la jurisprudencia inventada. Un comentarista notó que el lanzamiento se apoya en "tracked changes and human review" pero no dice nada sobre cómo detectar a "LLMs outright hallucinating cases or holdings". Otro, abogado, hizo una observación más sutil sobre el redlining: "I don't just see what's there but also what is missing." Detectar una cláusula ausente es más difícil para un modelo que editar una presente.
En X, la respuesta más votada al anuncio de Z.ai fue simplemente "We need glm illegal", con más de 1.200 me gusta. Internet sigue siendo internet.
GLM-Legal frente a modelos de frontera y productos de IA jurídica
Conviene distinguir tres comparaciones.
Frente a los modelos generales de frontera, GLM-Legal gana en la prueba de agentes de Harvey y empata más o menos en LegalBench. Claude Opus 5.5 cuesta unas 140 veces más por tarea en la ejecución de Vals y puntúa 3,75 %. Un modelo general sigue siendo la mejor opción si tu trabajo jurídico se mezcla con todo lo demás, o si necesitas entrada de imágenes, que GLM-Legal no aceptó en las pruebas de Vals.
Frente a la línea Muse Spark de Meta, GLM-Legal pierde en puntuación y velocidad. Muse Spark 1.2 supera un tercio más de tareas en un tercio del tiempo por unos 2 $ cada una. Si 2 $ por tarea está bien, el modelo de Meta es hoy la opción más fuerte.
Frente a productos jurídicos como Harvey AI, no es la misma categoría. Harvey vende los flujos de trabajo, permisos, registros de auditoría y despliegue en el despacho alrededor de los modelos, y su precio lo refleja. GLM-Legal es un componente sobre el que podría construir una empresa de legal tech. El comentarista de HN que se preguntó si esto tiene relación con los márgenes de Harvey señalaba eso: los modelos especializados baratos dejan la capa de producto como lo único por lo que se puede cobrar. Mi reseña de Harvey AI cuenta qué hace realmente esa capa.
Entonces, ¿quién debería solicitar la beta? Los equipos de legal tech con revisión de primera pasada nocturna y de alto volumen (due diligence, triaje de contratos, cronologías de discovery) donde una persona revisa igualmente cada salida. Ahí, 0,15 $ y 72 minutos es un gran intercambio. Todos los demás pueden esperar a tener precios, pesos y una reseña independiente de alguien que lo haya usado en casos reales. Si buscas una herramienta terminada en lugar de un modelo, mi lista de herramientas de escritura con IA para despachos de abogados es un mejor punto de partida.
Qué significa GLM-Legal si diriges un equipo de soporte
La mayoría de quienes leen sobre un modelo jurídico no trabajan en un despacho. Dirigen un equipo de soporte u operaciones que atiende preguntas con aristas legales: condiciones de reembolso, reclamaciones de garantía, solicitudes de eliminación de datos, "can you send me a copy of my data under GDPR."
Un modelo jurídico es la herramienta equivocada para eso. Esas preguntas no tratan de jurisprudencia. Tratan de tu política, escrita en tu centro de ayuda y tus documentos internos, y la respuesta correcta es lo que diga tu política, aunque un modelo más listo pudiera argumentar lo contrario. Es un problema de recuperación con traspaso a una persona, no de razonamiento.
Llevo años construyendo en eesel los agentes que atienden colas de soporte reales, y la lección del benchmark de GLM-Legal es la que seguimos reaprendiendo: la salida peligrosa es la que supera el 90 % de las comprobaciones. Una responsable de soporte de una marca DTC de suplementos lo planteó con claridad en una llamada con nosotros:
"The AI will never be able to answer 100% of the questions... I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Por eso ejecutamos cada despliegue de eesel contra los tickets históricos de un equipo antes de que responda a un cliente real, y por eso cualquier cosa que toque reembolsos, amenazas legales o cumplimiento de datos puede enviarse directamente a una persona. Nuestra guía de alucinaciones cubre la configuración. Si atiendes tú mismo a clientes del sector jurídico, atención al cliente con IA para despachos profundiza en ese caso.
Prueba eesel
GLM-Legal es infraestructura: un modelo que solicitas, conectas a un arnés, le escribes prompts, supervisas y pagas por token. eesel es el empleado. El compañero de helpdesk con IA se incorpora a tu cola actual en Zendesk, Freshdesk, Gorgias y el resto, aprende tus políticas de reembolso, garantía y datos a partir de tu centro de ayuda y tickets pasados, y pasa a una persona, con un resumen, todo aquello de lo que no esté seguro. Antes de que responda a nadie, puedes ver cómo habría respondido a cientos de tus tickets históricos.

Si tu equipo prefiere manejarlo desde una terminal, la CLI de eesel te permite leer y editar las reglas permanentes del compañero, revisar las acciones pendientes de aprobación y ver qué hizo y por qué, de modo que un agente de código pueda gestionar tu compañero de soporte como gestiona tu repositorio. Si lo tuyo es escribir contenido, la misma plantilla incluye un redactor de blog con IA.
¿Quieres una IA que responda preguntas de políticas a partir de tus propias políticas y sepa cuándo parar? Prueba eesel con los tickets del mes pasado y mira cuáles habría resuelto.