

Gimlet Labs opera lo que llama la primera "nube de inferencia multi-silicio". En palabras sencillas: software que divide una carga de trabajo de IA entre distintos tipos de chips, de modo que cada fase de un modelo se ejecuta en el hardware que mejor la maneja. El 4 de septiembre de 2026 levantó una Serie B de 300 millones de dólares liderada por Andreessen Horowitz, con una valoración de 3.000 millones de dólares, a la que se sumaron Arm y el brazo de capital riesgo de Microsoft.
La razón por la que esto recibió una valoración de 3.000 millones es la misma por la que me importa a mí, que me dedico a crear agentes de IA: las cargas de trabajo agénticas rompen la premisa de "un modelo, una GPU". Un agente encadena una docena de llamadas secuenciales al modelo, y cada una exige a una parte distinta del hardware. La apuesta de Gimlet es enviar cada parte al chip que es más rápido en ella.
La afirmación es una inferencia de 3 a 10 veces más rápida con la misma energía. Son cifras de la propia empresa y conviene una buena dosis de escepticismo, de lo que hablaré más adelante. Pero el problema de fondo es real, y lo noto cada vez que lanzamos algo.
¿Qué es Gimlet Labs?
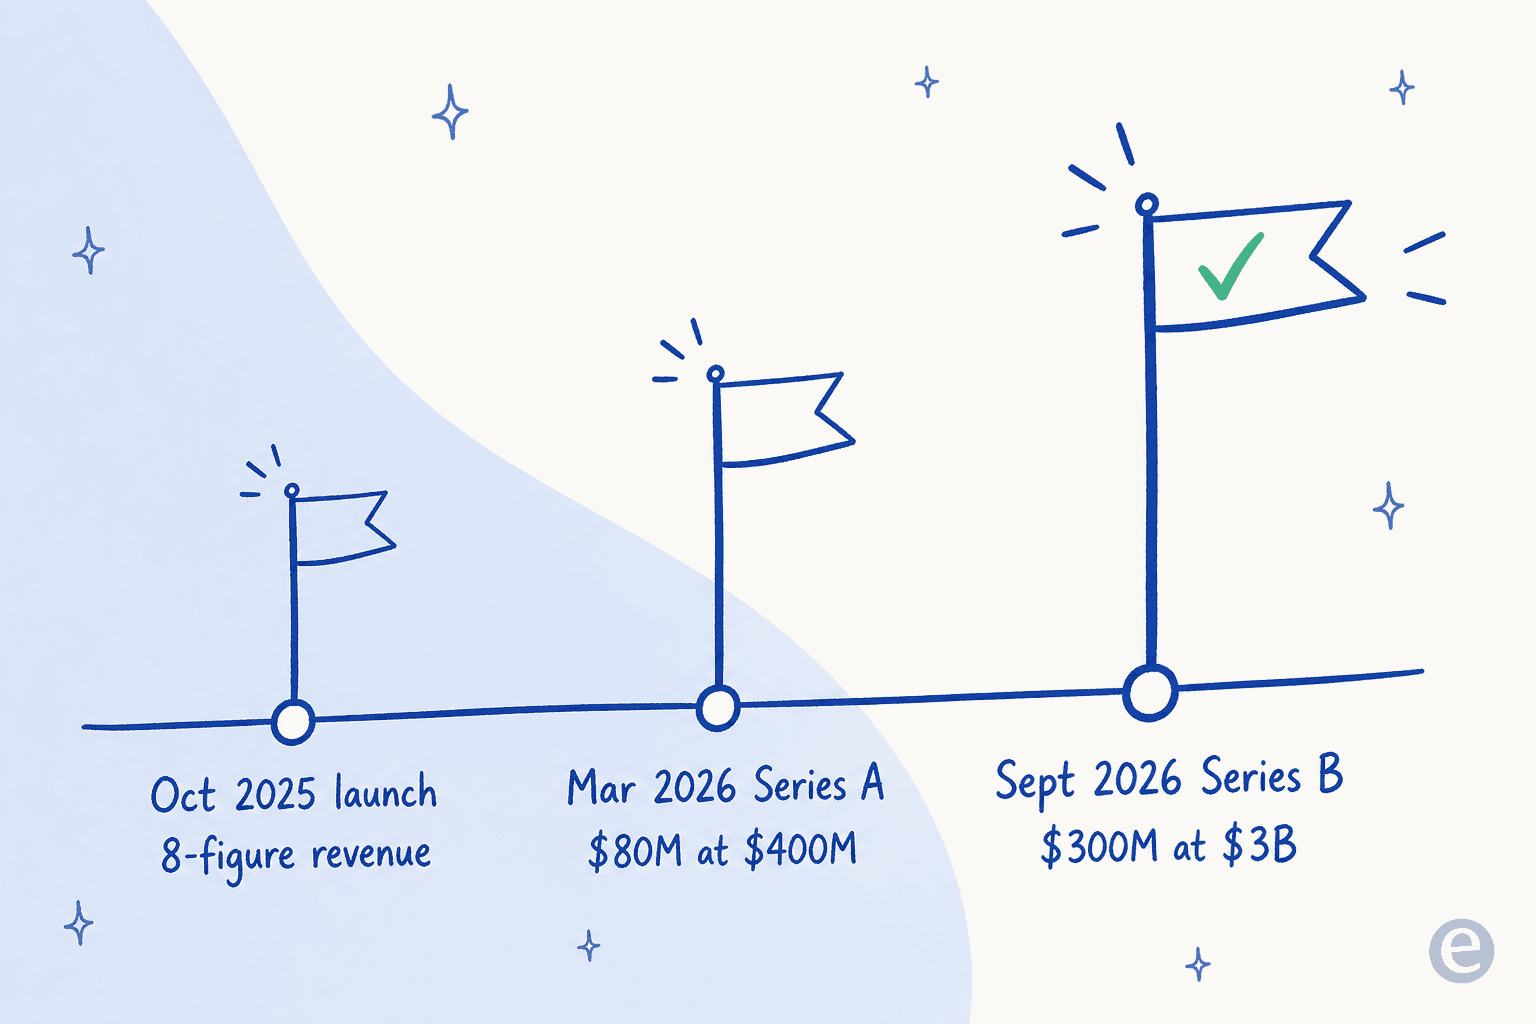
Gimlet Labs es una empresa de investigación aplicada y de producto en IA. Se lanzó públicamente en octubre de 2025 con, según su propio relato, ingresos de ocho cifras desde el principio, algo inusual para una empresa tan joven.
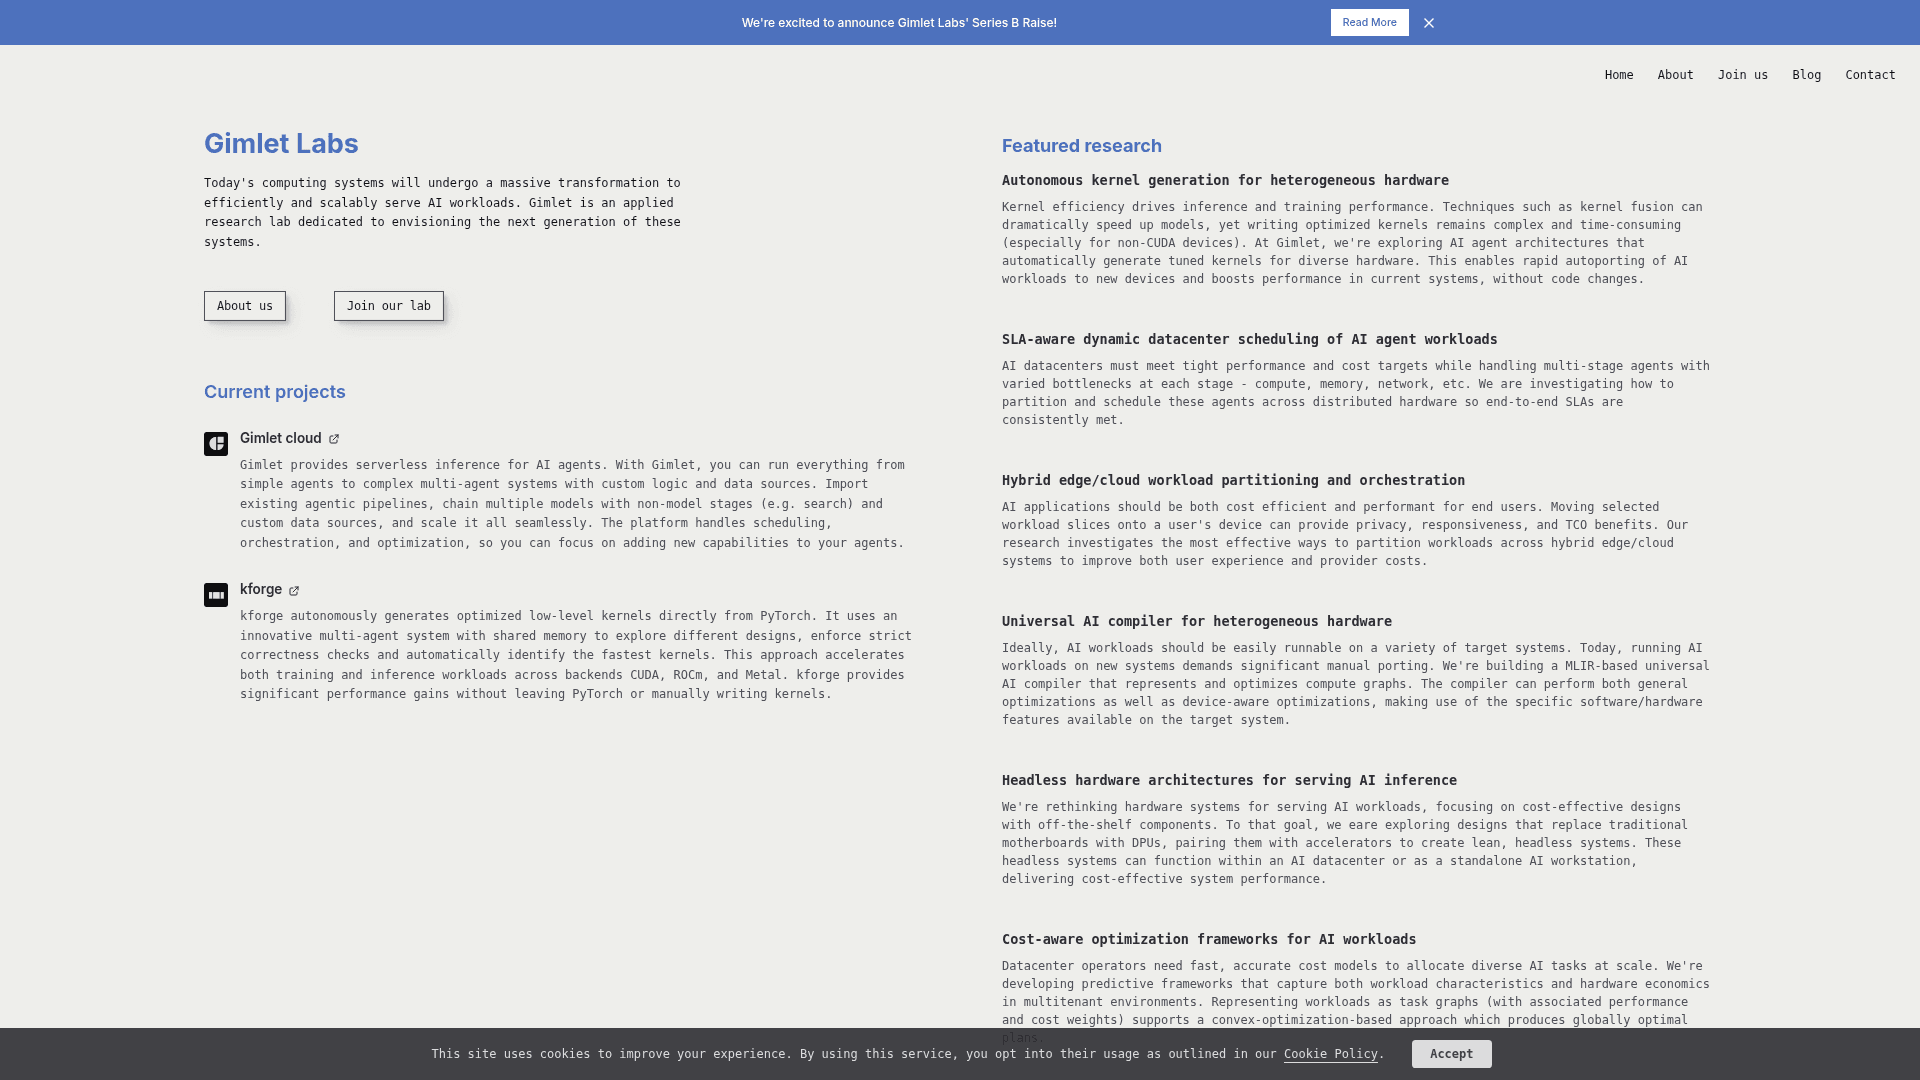
Su página de inicio resume la visión en una frase: "Today's computing systems will undergo a massive transformation to efficiently and scalably serve AI workloads." Todo lo demás se desprende de ahí. En lugar de aceptar que un modelo se ejecute en la GPU que alquilas, Gimlet construye la capa que reparte el modelo entre muchos tipos de chip a la vez.
Detrás de la propuesta hay dos productos:
- Gimlet Cloud es una plataforma de inferencia serverless orientada a agentes de IA. Importas un pipeline agéntico existente, encadenas varios modelos con pasos que no son modelos, como la búsqueda, y la plataforma se encarga de la planificación y la orquestación.
- kforge es la pieza de más bajo nivel. Genera automáticamente kernels optimizados directamente desde PyTorch para los backends CUDA, ROCm y Metal, mediante un sistema multiagente que explora diseños de kernel y comprueba su corrección, de modo que los ingenieros obtienen mejoras de velocidad sin escribir kernels a mano.
El problema: los agentes rompieron la inferencia en un solo chip
Esta es la parte que hace que todo encaje, y por eso creo que esto es más que un titular de financiación.
Un modelo de lenguaje grande no hace un único tipo uniforme de trabajo. Cuando responde, primero lee tu prompt (la fase de prefill), que está limitada por el cómputo: necesita capacidad bruta de cálculo. Después genera tokens uno a uno (la fase de decode), que está limitada por el ancho de banda de memoria: se pasa el tiempo moviendo datos de entrada y salida de la memoria. Y un agente de IA moderno no se detiene ahí: llama a herramientas, consulta APIs y obtiene documentos, lo que está limitado por la red.
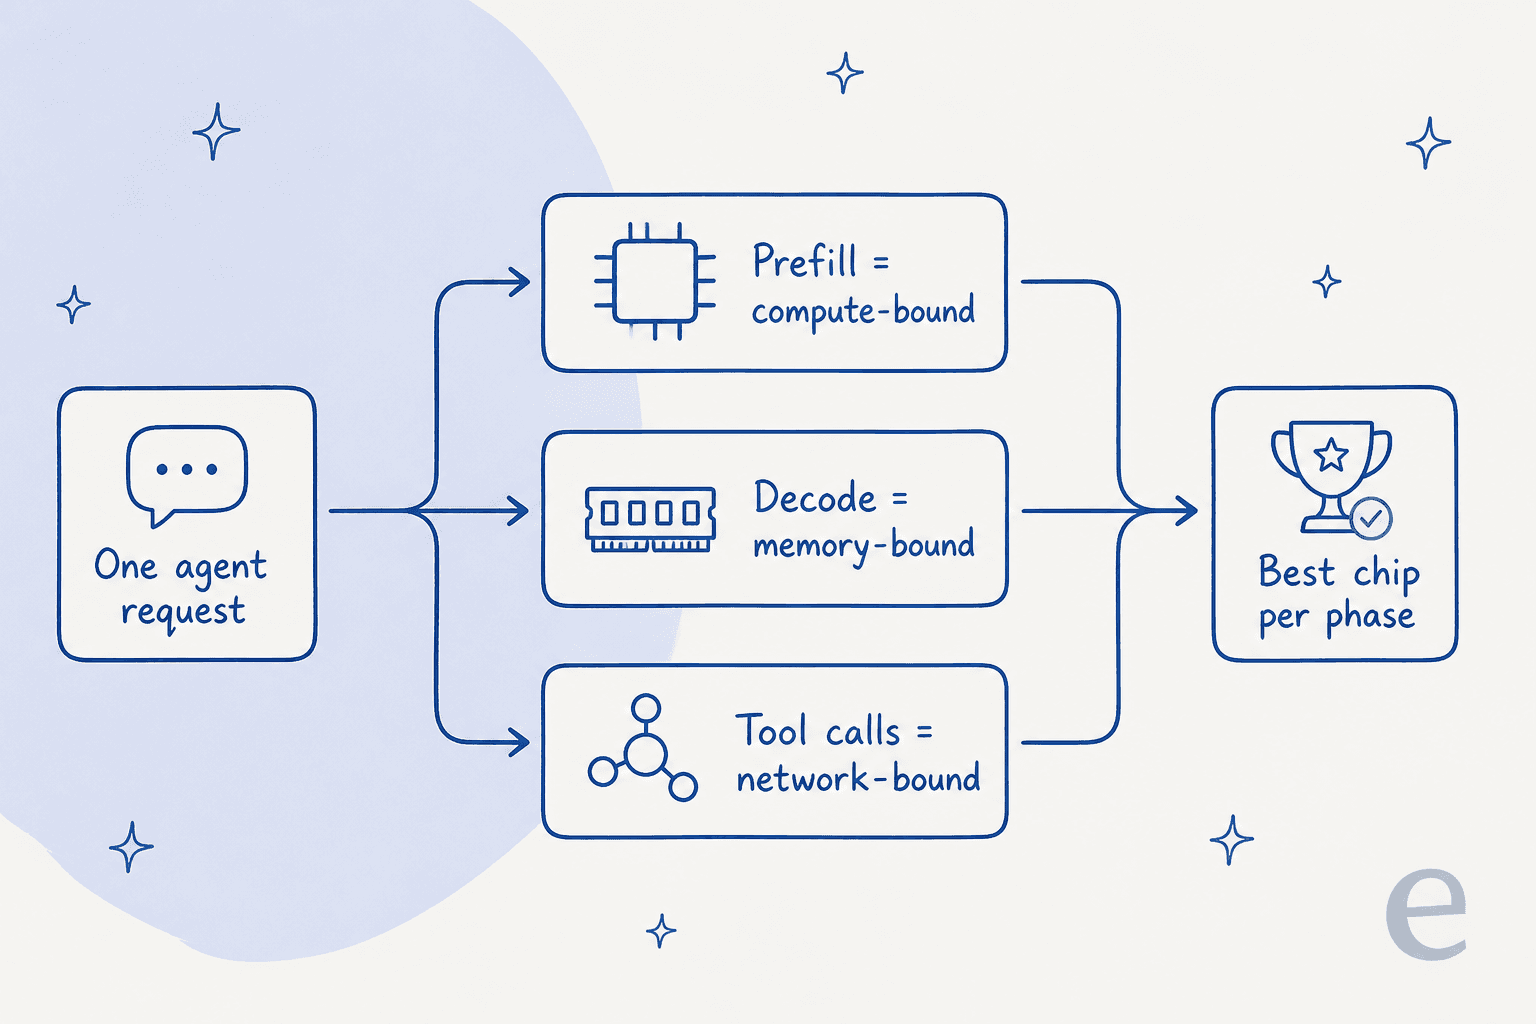
Si ejecutas todo eso en un clúster homogéneo de GPU, siempre dejas algo ocioso. Durante el decode, tu costoso cómputo se usa a medias. Durante las llamadas a herramientas, todo el acelerador espera a la red. El argumento de Gimlet, tomado directamente de su publicación de la Serie B, es que el hardware homogéneo por sí solo no puede satisfacer las necesidades de velocidad y eficiencia de las cargas de trabajo agénticas. Cuantos más pasos encadena un agente, más se acumula ese desperdicio.
Para mí no es una preocupación abstracta. En eesel construyo agentes de IA que resuelven tickets de soporte, y una sola resolución es una cadena: leer el ticket, buscar en la base de conocimiento, razonar sobre lo encontrado, a veces llamar a una API de consulta de pedidos y luego redactar una respuesta. Cada uno de esos pasos tiene un cuello de botella distinto. Cuando la gente pregunta por qué los productos agénticos pueden sentirse lentos, esta es una parte importante de la respuesta.
Cómo funciona la nube multi-silicio
La solución de Gimlet es la desagregación. Separa las fases y ejecuta cada una en el silicio más adecuado: el prefill en un conjunto de dispositivos optimizado para cómputo, el decode en otro optimizado para ancho de banda de memoria, y así sucesivamente. Añade decodificación especulativa y la separación entre atención y feed-forward, y reequilibra de forma dinámica a medida que se libera hardware.
Para hacerlo posible, Gimlet se asocia con toda la industria de chips en lugar de elegir bando. Trabaja con chips de NVIDIA junto con AMD, Intel, Arm, Cerebras y d-Matrix. El software es el producto; el silicio es intercambiable. Es lo contrario de la típica historia de "compra nuestro acelerador", y por eso Arm invirtió en la ronda en lugar de ver a Gimlet como una amenaza.
El beneficio que anuncia Gimlet son mejoras de 5 a 10 veces dentro de la misma envolvente de potencia, o el mismo rendimiento con menor latencia. En la IA agéntica en particular, donde una solicitud puede requerir decenas de llamadas secuenciales al modelo, recortar latencia en cada llamada es donde el efecto compuesto juega a tu favor en vez de en tu contra.
La historia de la financiación y quién apuesta
El dinero dice quién cree en esto. La Serie B fue liderada por Andreessen Horowitz, con una larga lista de participantes que incluye a Menlo Ventures (que lideró la Serie A), Arm, M12, Samsung Ventures, Tiger Global y XTX Markets. Gimlet dice que desde marzo ha sumado miles de millones en ingresos contratados y que tiene una cartera de centros de datos medida en gigavatios.
La trayectoria es empinada: una Serie A de 80 millones de dólares en marzo de 2026 con una valoración de unos 400 millones, y un salto a 3.000 millones seis meses después. En un mercado en el que todos los laboratorios persiguen una inferencia de LLM más barata, la tesis de que la eficiencia, y no solo los modelos más grandes, es el próximo campo de batalla claramente resuena entre los inversores.
Las salvedades honestas
Quiero ser justo, porque una valoración de 3.000 millones y una promesa de 10 veces invitan exactamente al tipo de bombo que intento evitar.
Primero, las cifras de rendimiento son de la propia Gimlet. Cuando la empresa publicó un artículo sobre kernels de Metal generados por IA, un ingeniero de PyTorch en Hacker News planteó una objeción directa y razonable:
"I work on PyTorch and there are many things that make me suspicious about these results. My TL;DR is unless we get a zip file of all the kernels with how they're benchmarked results like this are almost impossible to verify."

Eso no es un varapalo, y el equipo de Gimlet participó en el hilo. Pero es el marco correcto: las mejoras de velocidad en benchmarks son una afirmación que hay que verificar con tu propia carga de trabajo, no un resultado establecido. Segundo, Gimlet no ha nombrado públicamente a sus clientes y los describe solo como "a major model maker" y "an extremely large cloud computing company". Y tercero, esto es infraestructura para laboratorios y centros de datos. Si estás creando un producto, probablemente nunca toques Gimlet directamente; solo lo notarás como una inferencia más rápida y barata bajo las herramientas que realmente usas.
Qué significa esto si construyes con IA
Entonces, ¿dónde te deja esto si no diriges un laboratorio de frontera?
Gimlet es un buen recordatorio de la estructura en capas. Abajo está el silicio; en el medio, la capa de inferencia que Gimlet lucha por dominar; luego los modelos; y encima, los empleados que realmente contratas. Gimlet es infraestructura. Hace que el motor funcione mejor; no es lo que hace tu trabajo.
Esa distinción es exactamente cómo pienso en eesel. eesel es una plataforma de compañeros de equipo con IA: contratas compañeros listos para trabajar en tareas concretas, y hoy el equipo lo forman un compañero de helpdesk con IA y un redactor de blog con IA. El compañero de helpdesk se incorpora a tu cola de soporte existente, aprende de tus tickets anteriores y de tu centro de ayuda, y resuelve conversaciones dentro de Zendesk, Freshdesk o Gorgias. El redactor de blog hace lo mismo con el contenido. Sea cual sea la nube de inferencia que haya debajo, el compañero es quien lleva el trabajo hasta el final.

Y como todo el mundo de Gimlet es agéntico y programable, conviene decir que eesel también sale al encuentro de ese lector. La CLI de eesel maneja al mismo compañero de helpdesk desde una terminal: una persona puede ejecutarla a mano, los scripts pueden automatizarla y los agentes de programación como Claude Code o Cursor pueden operarla a través de la CLI y de su servidor MCP, de modo que simular un despliegue con tickets históricos o lanzar una ejecución pasa a ser un solo comando en lugar de un clic en el panel. Si prefieres verlo resolver tickets reales antes que leer otra hoja de especificaciones, puedes probar eesel gratis y conectarlo a tu propio centro de ayuda en unos minutos.
Si estás en una fase más temprana y solo comparas opciones, las guías sobre los mejores agentes de IA y la clasificación de tickets con IA son un mejor punto de partida que una nube de inferencia de 3.000 millones.
Conclusión
Gimlet Labs es una empresa interesante que resuelve un problema real y poco glamuroso: el hardware bajo la IA encaja mal con la forma en que realmente se ejecutan los agentes, y alguien tenía que construir el software para arreglarlo. La valoración de 3.000 millones es una apuesta a que la eficiencia de la inferencia será la próxima gran batalla, y dado lo rápido que crece la IA agéntica, no es una apuesta descabellada.
Solo toma las promesas de velocidad con cautela hasta que se prueben de forma independiente, y recuerda qué capa estás comprando realmente. Gimlet hace el motor más rápido. El compañero de equipo que va encima sigue siendo quien hace el trabajo.