

Groq 3 LPX es el nuevo acelerador de inferencia a escala de rack de NVIDIA para la plataforma Vera Rubin y entró en producción completa el 24 de agosto de 2026. Cada rack reúne 256 chips Groq 3 LPU que trabajan junto a las GPU Vera Rubin NVL72. Las GPU se ocupan del trabajo de contexto, que exige mucha memoria; las LPU, de la tarea sensible a la latencia de generar tokens rápidamente. El objetivo de este reparto es que la IA agéntica se sienta rápida sin sacrificar rendimiento.
El nombre es confuso a propósito. NVIDIA licenció la tecnología LPU de Groq (no exclusiva) y contrató a su fundador y a miembros clave del equipo, así que es un producto de NVIDIA basado en el diseño de Groq que usa el nombre Groq bajo licencia. La empresa Groq sigue siendo independiente y GroqCloud sigue funcionando.
Sobre las cifras principales: NVIDIA cita 3.400 tokens por segundo con Gemma 4 31B a 100K de contexto, además de una proyección de 35x de rendimiento por megavatio y 10x de ingresos por vatio frente a su generación anterior. Son afirmaciones del fabricante medidas contra las bases de comparación de la propia NVIDIA, así que léelas como un objetivo, no como un resultado independiente verificado. Si construyes agentes o automatizas soporte, la conclusión práctica es más simple: casi seguro no comprarás este rack, consumirás la velocidad que desbloquea a través de un modelo o una nube, y lo que realmente despliegas es un compañero como eesel que trabaja encima.
Qué es realmente Groq 3 LPX
NVIDIA describe Groq 3 LPX como "el acelerador de inferencia de IA interactiva para NVIDIA Vera Rubin". En palabras más sencillas: es un rack completo de chips especializados cuyo único trabajo es generar tokens rápido, y encaja en la plataforma de centros de datos más reciente de NVIDIA junto a las GPU de propósito general.
NVIDIA plantea un compromiso clásico de tres vías. Durante años, el hardware de inferencia ofrecía dos de tres propiedades a la vez: inteligencia más rendimiento, o inteligencia más interactividad, pero nunca las tres a bajo costo. Los modelos grandes son lentos para conversar; los rápidos son pequeños. Groq 3 LPX se presenta como la pieza que permite que un modelo grande siga siendo ágil, al pasar la parte sensible a la latencia de cada token a un chip construido exactamente para eso.
Conviene ser preciso sobre lo que no es. No es un producto independiente que se instale en cualquier servidor ni un reemplazo de la GPU. Es una extensión codiseñada de Vera Rubin NVL72 que funciona junto a las GPU Rubin, y entre ambas calculan conjuntamente cada capa del modelo para cada token de salida. NVIDIA incluso llama a la LPU "el séptimo chip" de la plataforma Vera Rubin.
Un momento, ¿es la startup Groq?
Esta es la reacción más común que he visto, y es razonable. Durante años, Groq fue la startup de inferencia atrevida cuya LPU era el contraejemplo de "usa más GPU". Ahora "Groq 3 LPX" es una línea de productos de NVIDIA. Una persona en X resumió bien el ambiente:
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Esta es la versión precisa, directa de las fuentes primarias. Groq firmó un acuerdo de licencia no exclusivo con NVIDIA para su tecnología de inferencia, la misma que está detrás de los precios de GroqCloud y de su gama de alternativas a Groq. Como parte del acuerdo, el fundador Jonathan Ross y otros miembros del equipo de Groq se unieron a NVIDIA para ayudar a escalar el diseño licenciado. Groq sigue independiente bajo un nuevo CEO, Simon Edwards, y GroqCloud continúa operando. La propia página de prensa de NVIDIA incluye en el pie la línea "Groq and LPU are used under license from Groq, Inc."
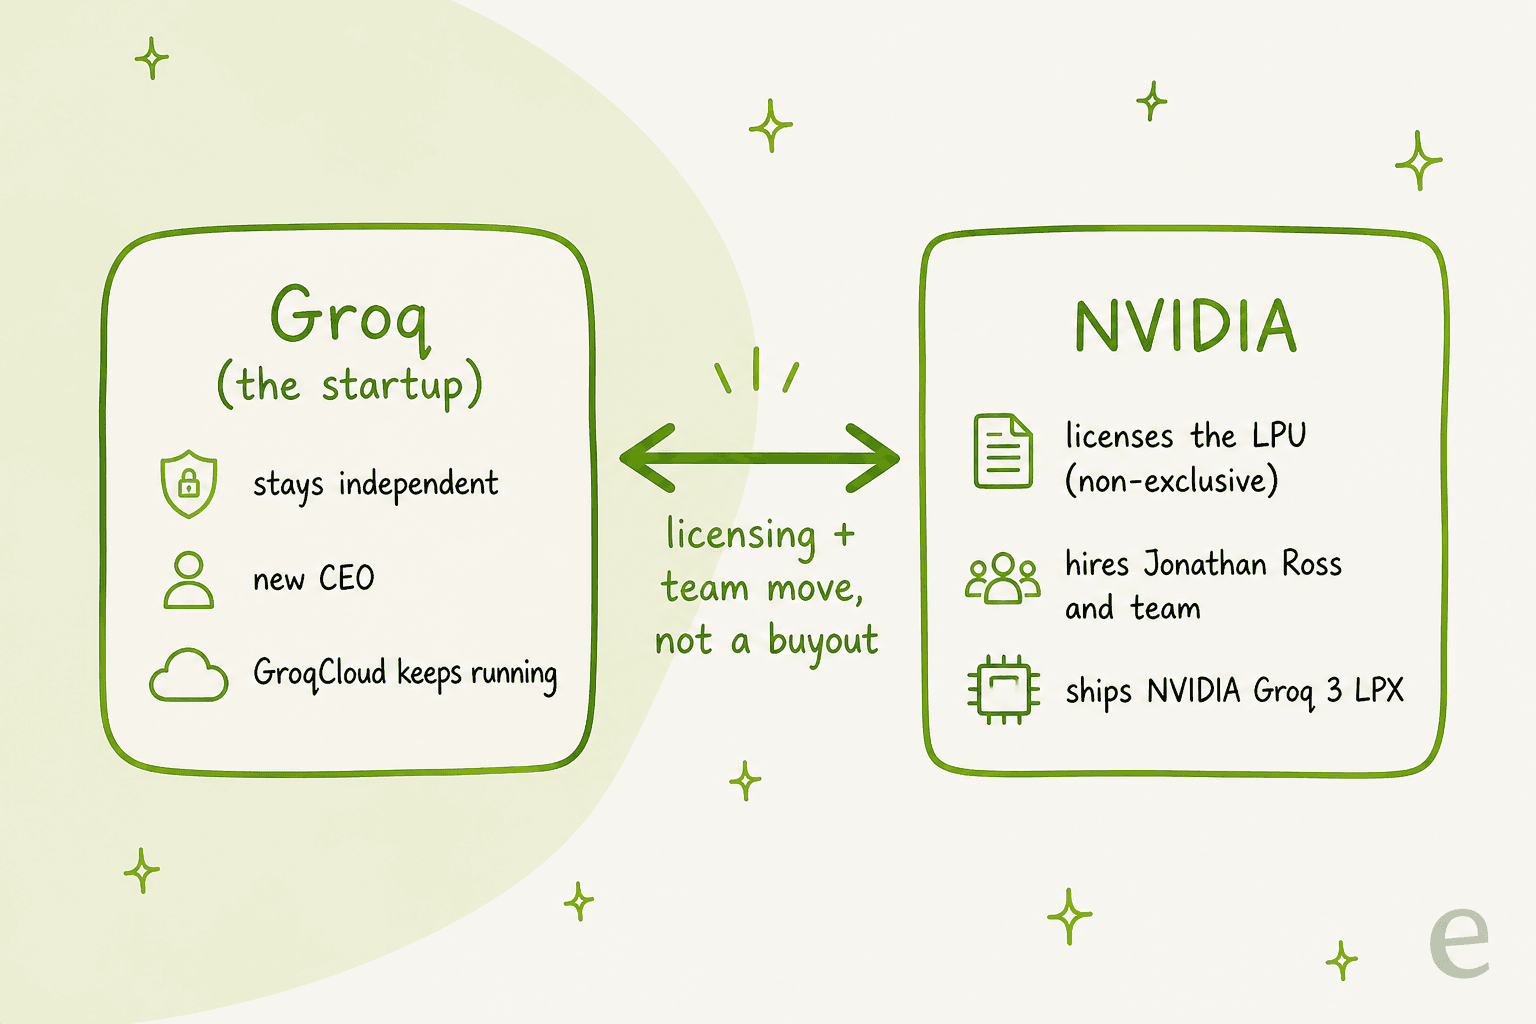
Así que cuando leas "NVIDIA Groq 3 LPX", piensa en una licencia y una contratación de equipo, no en una adquisición limpia. Circulan cifras elevadas en la prensa sobre el acuerdo, pero esos números no aparecen en las declaraciones de ninguna de las dos empresas, así que los dejo fuera. Lo que respaldan las fuentes primarias es la estructura de arriba, y es lo que realmente importa para entender el producto.
Todo en un solo rack
Las especificaciones son la parte divertida, porque son realmente inusuales. Esto es lo que NVIDIA indica para un solo rack Groq 3 LPX.
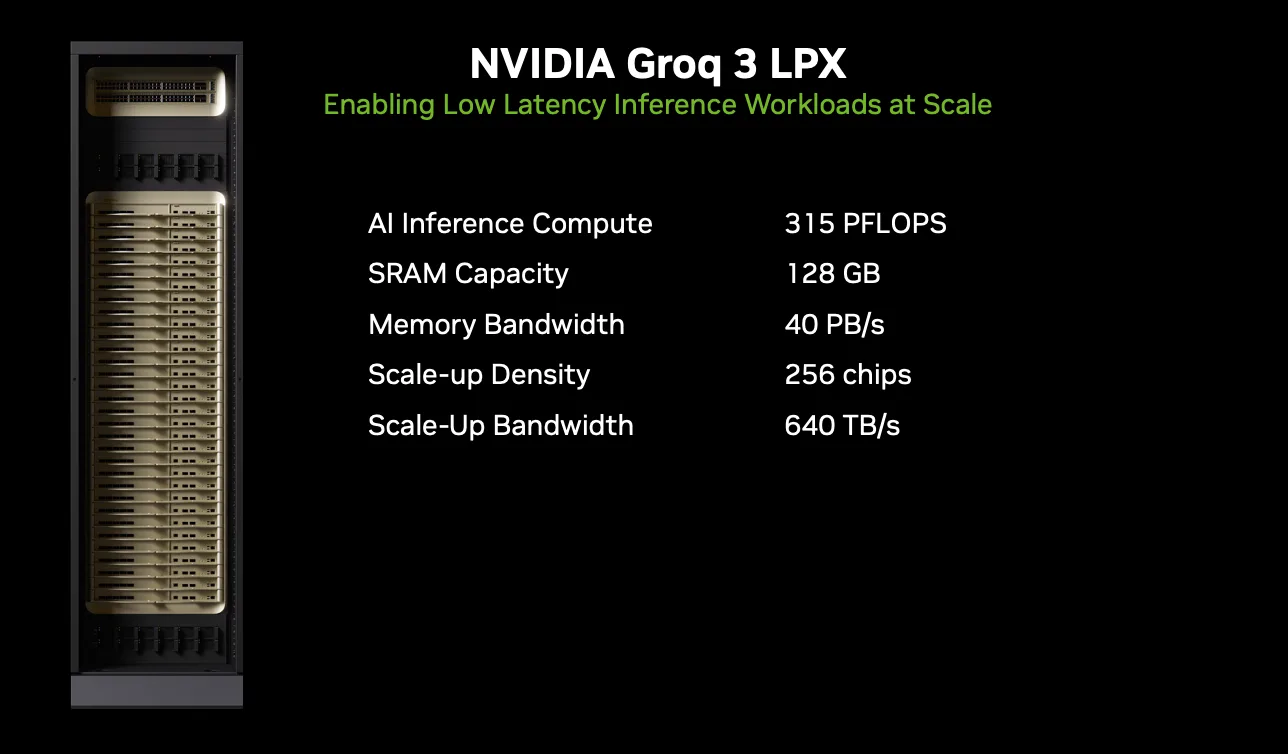
| Especificación a nivel de rack | NVIDIA Groq 3 LPX |
|---|---|
| Chips por rack | 256 aceleradores Groq 3 LPU |
| Cómputo de inferencia de IA | 315 PFLOPS (FP8) |
| Capacidad total de SRAM | 128 GB |
| Ancho de banda de SRAM en el chip | 40 PB/s |
| Ancho de banda de escalado vertical | 640 TB/s |
| Construcción | 32 bandejas de cómputo 1U con refrigeración líquida, 8 LPU cada una |
La cifra que salta a la vista son los 40 petabytes por segundo de ancho de banda de SRAM en el chip. No es un error de dedo, y es toda la tesis del diseño en un solo número. En lugar de alimentar los chips desde memoria externa más lenta, la LPU mantiene los datos de trabajo en el chip y los mueve a un ancho de banda que una configuración de memoria convencional no puede alcanzar. La contrapartida es la capacidad: 128 GB de SRAM en un rack son minúsculos frente a los terabytes de HBM de un rack de GPU, y por eso las LPU necesitan a las GPU a su lado.
¿Por qué construir un chip completamente nuevo?
Para ver por qué NVIDIA se tomó la molestia, ayuda poner los dos chips lado a lado. El diagrama de la propia NVIDIA lo hace con claridad.
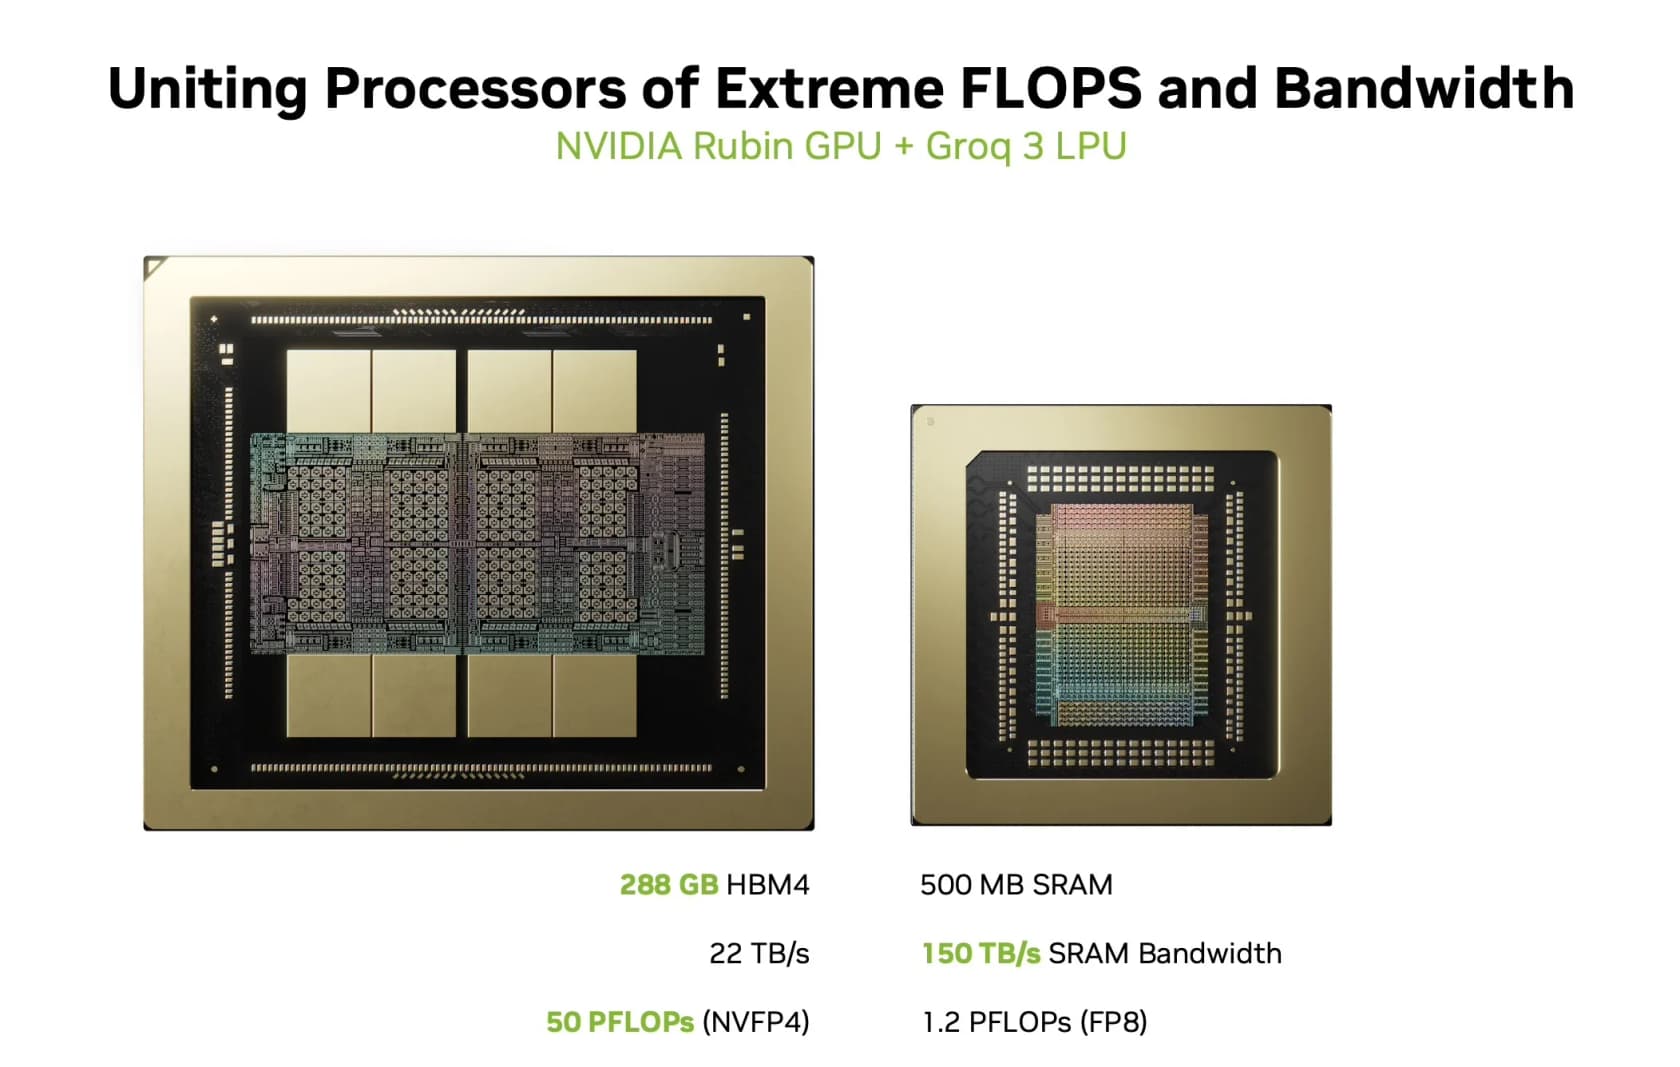
Una GPU Rubin aporta aproximadamente 288 GB de HBM4, unos 22 TB/s de ancho de banda de memoria y alrededor de 50 PFLOPs de cómputo. Una sola Groq 3 LPU aporta 500 MB de SRAM, pero a 150 TB/s de ancho de banda, con 1,2 PFLOPs de cómputo FP8. La GPU es un caballo de batalla optimizado para el máximo rendimiento y mucha memoria. La LPU está optimizada para una sola cosa: mantener un flujo de tokens con latencia baja y predecible.
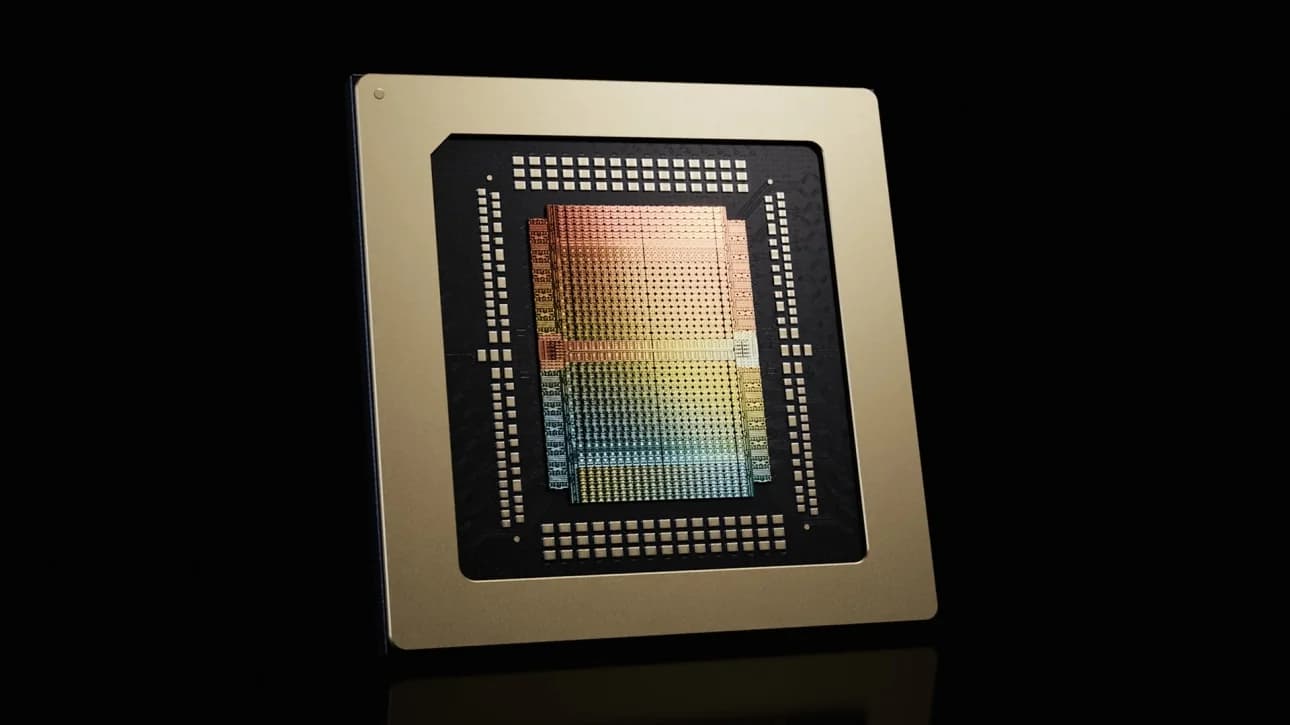
Las decisiones de diseño internas son lo que hace que la LPU sea distinta de una GPU, y me parecen muy interesantes porque invierten cosas que los programadores de GPU dan por sentadas:
- La SRAM es la memoria principal, no una caché. Hay 500 MB de SRAM en el chip por LPU, y guarda directamente los pesos activos, las activaciones y el estado KV. No hay HBM en el chip.
- Sin cachés gestionadas por hardware. El compilador y el runtime colocan y mueven los datos de forma explícita, en lugar de depender de heurísticas de caché. Eso reduce las paradas impredecibles y mantiene la latencia estable.
- Ejecución determinista programada por el compilador. El chip se basa en el modelo de ejecución espacial de Groq, donde el cómputo, el movimiento de datos y la sincronización se programan por adelantado. NVIDIA describe un protocolo de hardware que cancela la deriva del reloj para que cientos de LPU actúen como un sistema coordinado.
- Movimiento de datos explícito y centrado en tensores. Todo opera sobre vectores fijos de 320 bytes mediante unidades dedicadas de matrices, vectores y conmutación, de modo que la planificación sigue siendo predecible.
Si has pensado alguna vez por qué los costos de inferencia de LLM son tan sensibles a la latencia, esta es la respuesta desde el hardware: construir un chip cuyo tiempo de ejecución se conoce y luego conectar cientos de ellos sin perder esa propiedad.
Cómo funciona en realidad: un bucle de dos motores
Aquí es donde encaja todo. La idea de NVIDIA es que la inferencia no es una carga de trabajo uniforme. Una solicitud tiene dos fases muy distintas, y cada una quiere un hardware diferente.
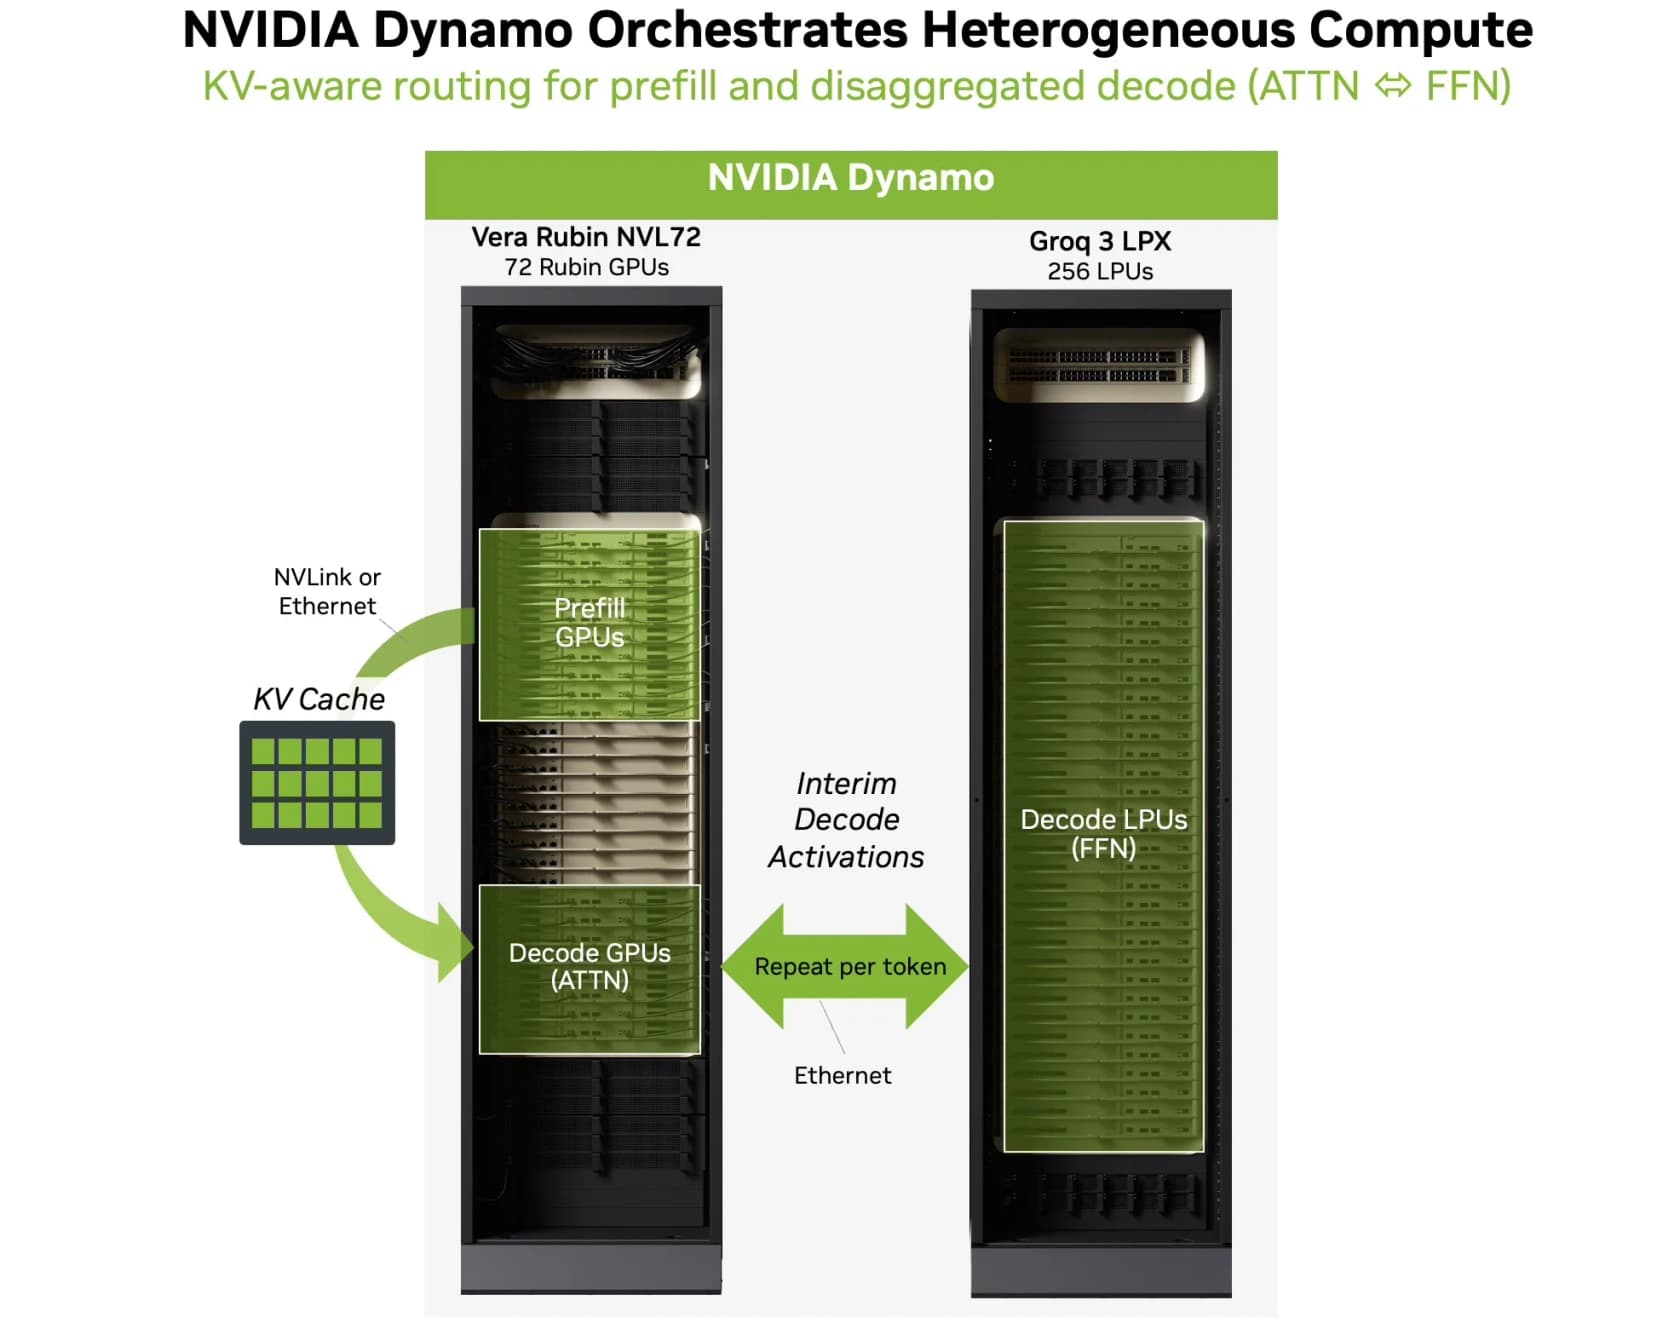
La primera fase, el prefill, ingiere tu prompt y construye la caché KV. Es trabajo denso, paralelo y que consume mucha memoria, y encaja muy bien en la GPU. La segunda fase, el decode, genera la respuesta token a token en un bucle. NVIDIA reparte ese bucle entre ambos chips con una técnica que llama desagregación attention-FFN: las GPU Rubin ejecutan la atención sobre el contexto acumulado, y Groq 3 LPX se encarga de las operaciones feed-forward y de mezcla de expertos, que son las más sensibles a la latencia. Por cada token, ambos intercambian activaciones intermedias.
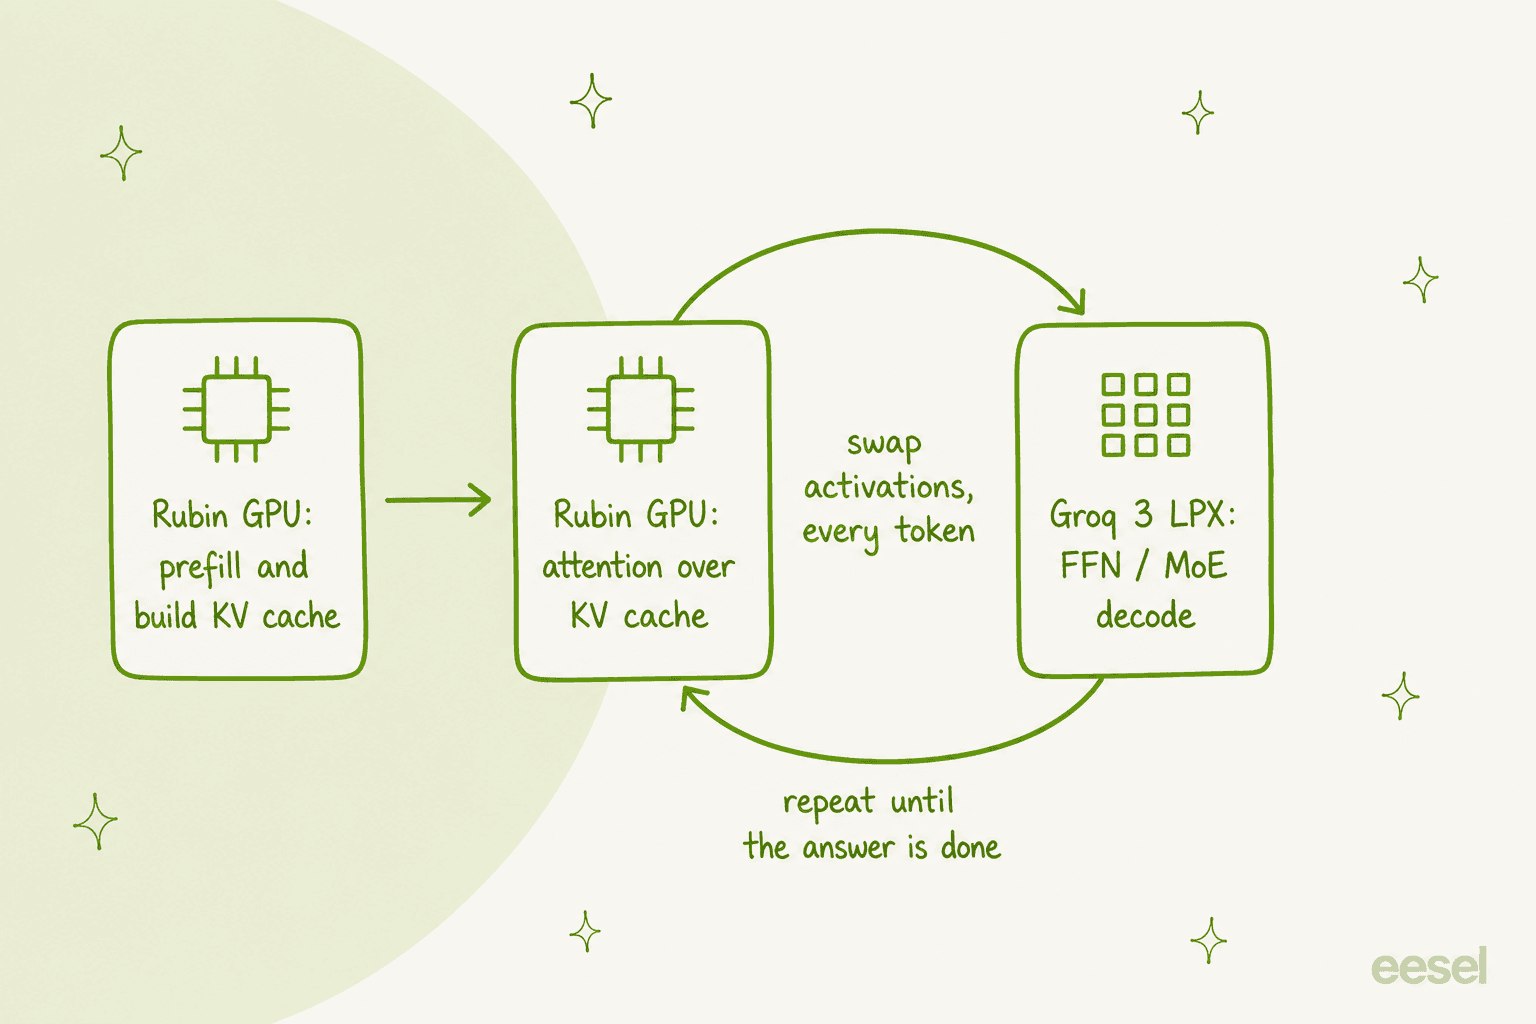
El director de tráfico de todo esto es NVIDIA Dynamo, la capa de orquestación que dirige el prefill a los workers de GPU, mueve las activaciones por token entre motores y lo programa todo según objetivos de latencia para que una sesión interactiva no quede atascada detrás de un trabajo por lotes.
LPX cumple un papel más que conviene conocer: actúa como motor de borrador para la decodificación especulativa. Su ejecución determinista y su enorme ancho de banda de SRAM le permiten producir tokens borrador rápidamente, adelantándose a la GPU, que los verifica. Es otra forma en que los dos chips se reparten el trabajo en lugar de duplicarlo.
Dentro del rack
Si quieres ver dónde viven físicamente las piezas, el diagrama de la bandeja de cómputo de NVIDIA es la vista más clara. Un rack son 32 de estas bandejas 1U con refrigeración líquida, y cada bandeja contiene ocho LPU.
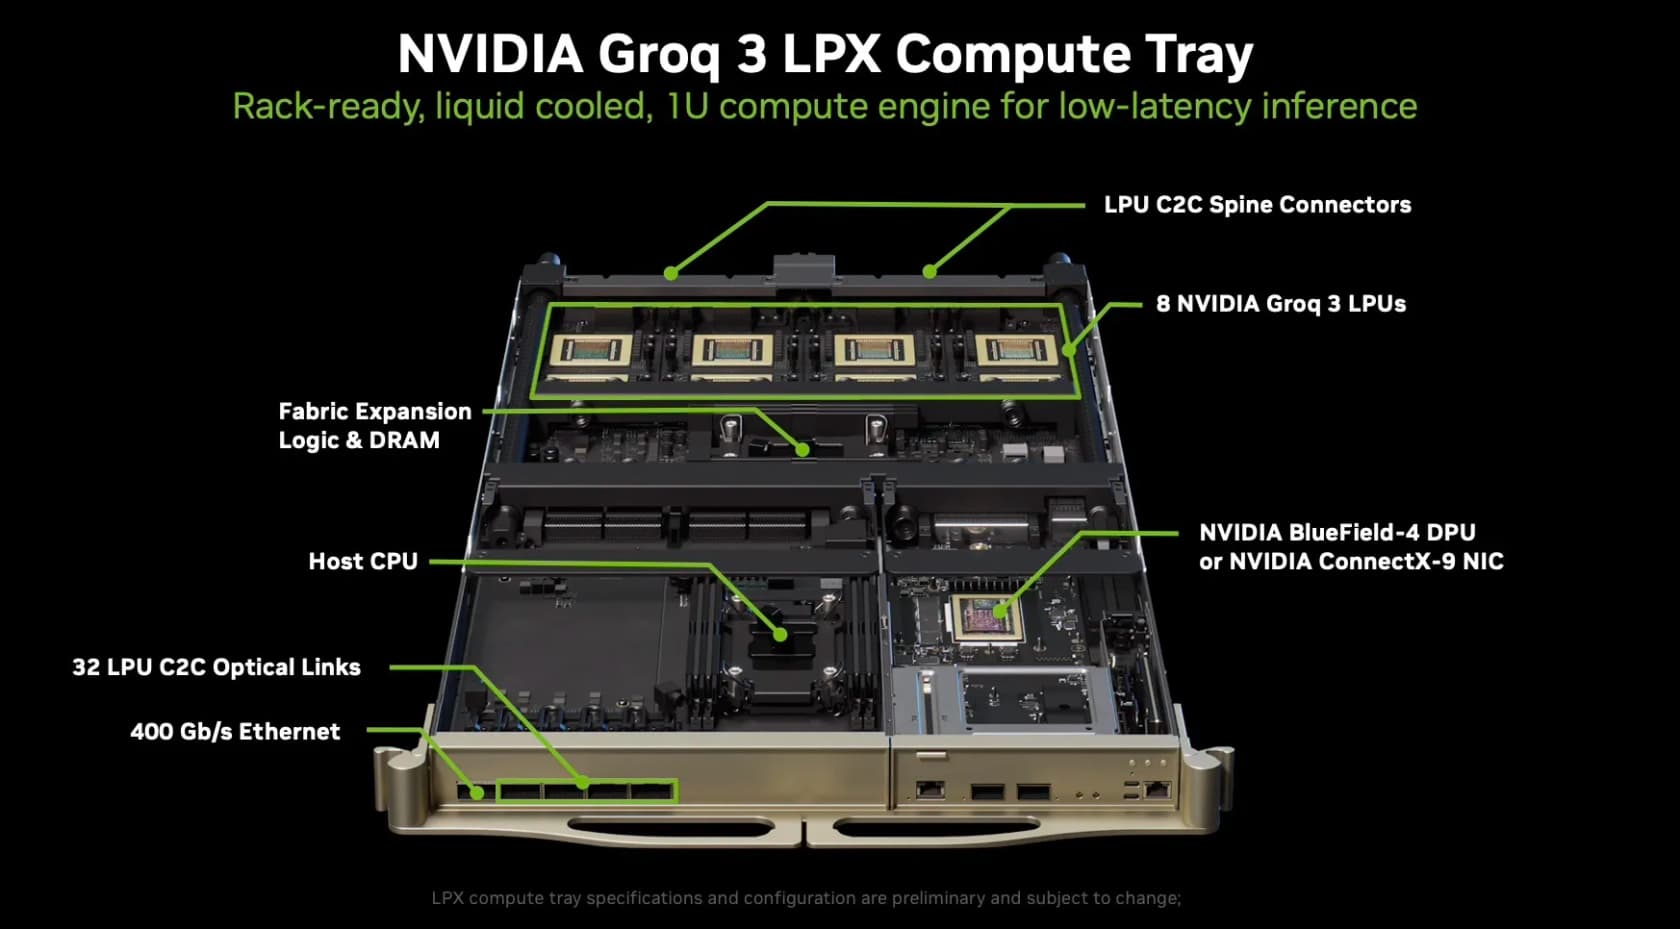
Varias cosas destacan en ese diseño. Cada LPU se conecta mediante 96 enlaces chip a chip a 112 Gbps, que suman 2,5 TB/s de ancho de banda de escalado por chip, y así 256 de ellas se comportan como una sola máquina. Cada bandeja lleva además una DPU BlueField-4 y una CPU host, y todo es sin cables y con refrigeración líquida. Se apoya en la arquitectura de rack MGX de NVIDIA, de modo que un centro de datos puede planificar un diseño de rack común para todo su despliegue Vera Rubin en lugar de una configuración a medida para la ruta de inferencia.
Las afirmaciones de rendimiento y cómo leerlas
Ahora las cifras que todos citan. El titular de NVIDIA es hasta 35x más rendimiento por megavatio para modelos de billones de parámetros cuando se combina Vera Rubin NVL72 con LPX, frente a su generación anterior GB200, medido a 400 tokens por segundo por usuario. También proyecta hasta 10x más ingresos por vatio para las cargas de trabajo más sensibles a la latencia. La imagen más clara es el propio gráfico de Pareto de NVIDIA.
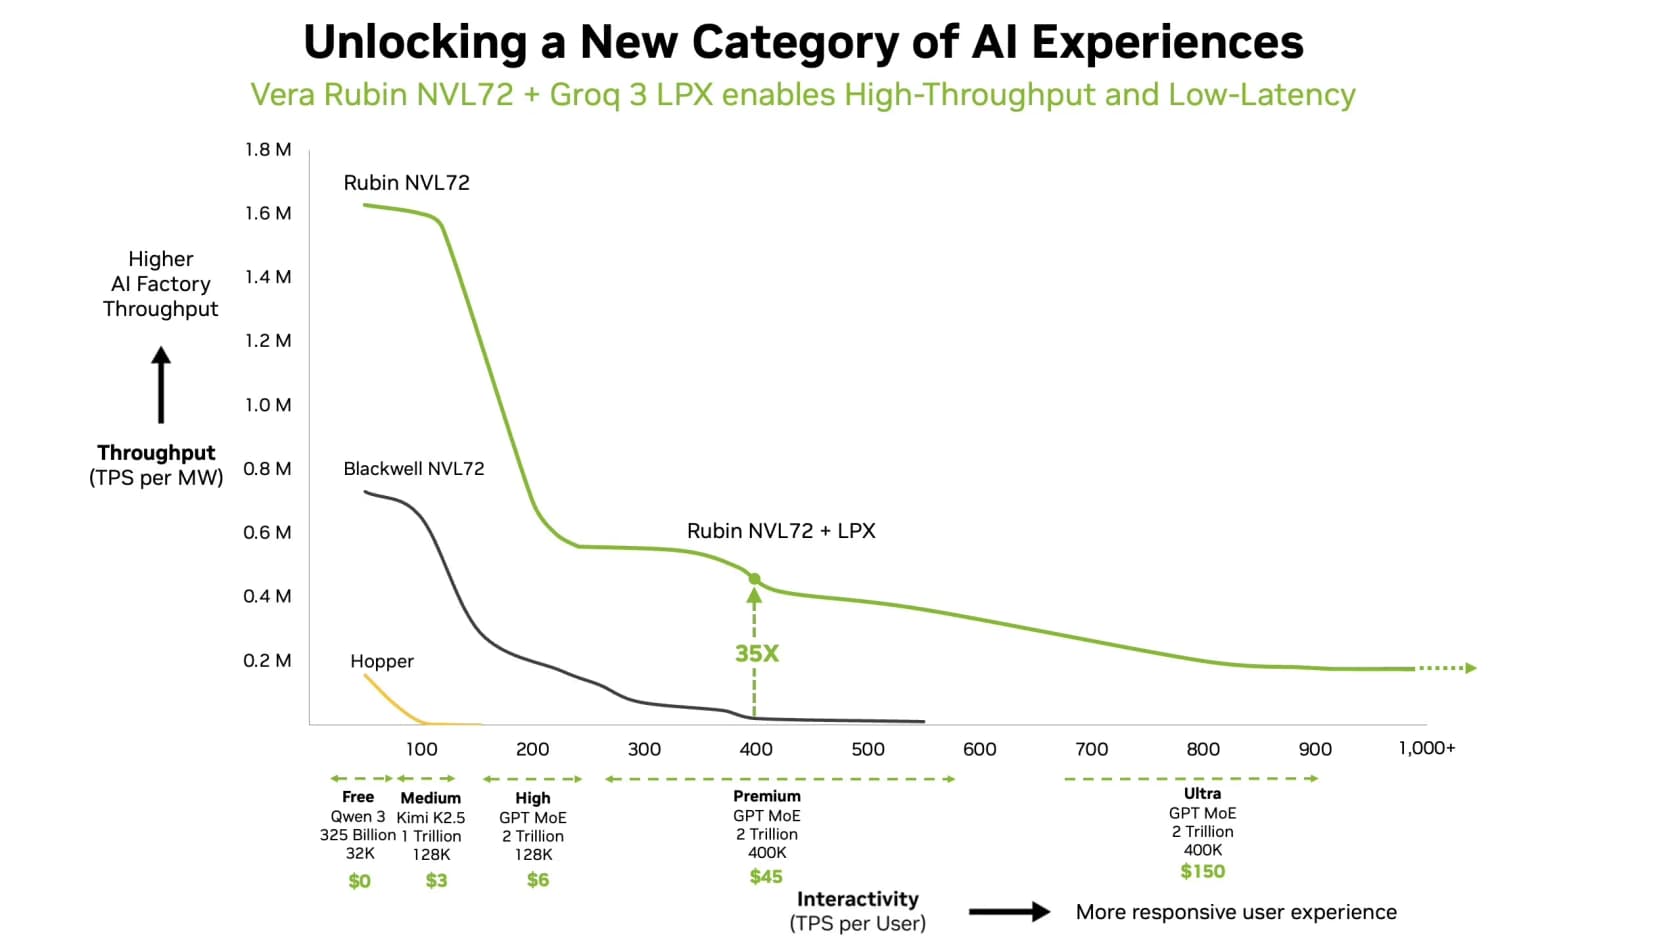
Si se lee el gráfico con honestidad, dice algo real: la brecha entre la línea verde (Rubin más LPX) y los sistemas anteriores se abre de forma dramática en el lado derecho, donde cada usuario recibe tokens rápido. Con baja interactividad todos se parecen; con alta interactividad, la ruta LPX se mantiene alta mientras las líneas solo de GPU se desploman. Esa es la afirmación real, y es coherente.
La salvedad honesta es quién lo midió. Son cifras de NVIDIA contra las bases de comparación de la propia NVIDIA, y el escenario "premium" modelado es un modelo concreto de 2 billones de parámetros con 400K de contexto. El único dato con aire independiente que encontré es un benchmark de Artificial Analysis citado por NVIDIA, de 3.400 tokens por segundo con Gemma 4 31B a 100K de contexto. Es una cifra sólida, pero casi toda la conversación pública hasta ahora repite las diapositivas de NVIDIA en lugar de probar el hardware, porque Nebius es solo la primera nube en desplegarlo. En Hacker News, una de las pocas opiniones sustanciales lo leyó frente al historial de Groq en lugar de frente al marketing:
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Mi lectura: la arquitectura es genuinamente ingeniosa, el benchmark es prometedor, y la cifra de 35x es un número de marketing del mejor caso que conviene tomar con cautela hasta que terceros lo ejecuten.
Por qué ahora: la inferencia se volvió la parte cara
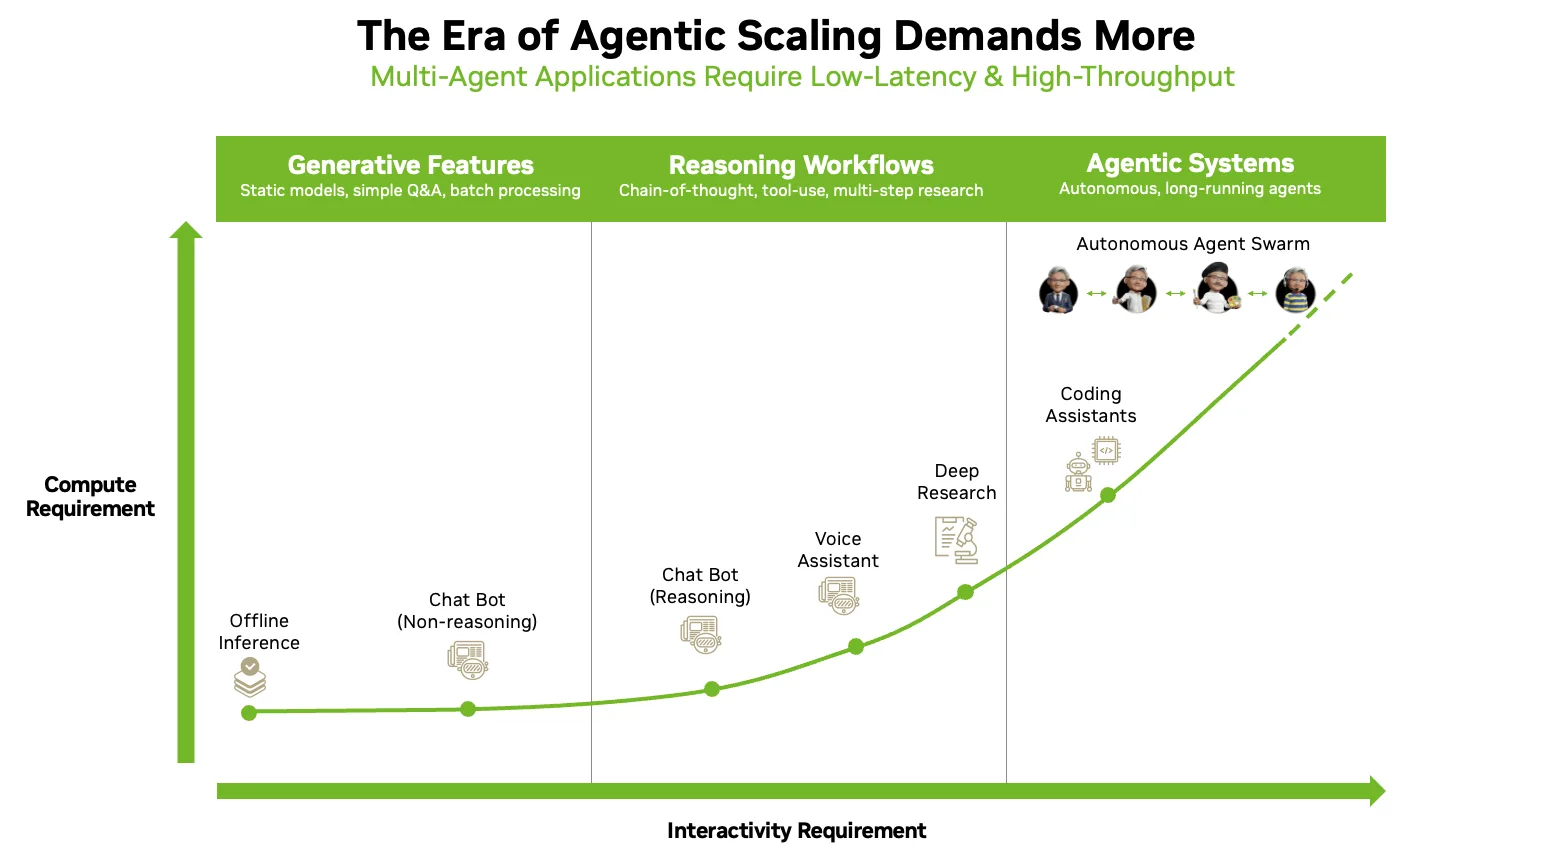
Un chip así existe porque la forma de las cargas de trabajo de IA ha cambiado. Cuando la mayoría de la inferencia era una sola respuesta de chatbot, la latencia de decode apenas importaba. Los sistemas agénticos lo rompieron. Generan tokens a lo largo de cientos o miles de pasos, y NVIDIA cita datos según los cuales las cargas agénticas consumen aproximadamente 15 veces más tokens que una solicitud de chat simple. Cada pequeño retraso por token se multiplica ahora a lo largo de una cadena larga.
El mismo cambio se ve en hacia dónde va el dinero del mercado. El negocio de centros de datos de NVIDIA cabalga esta ola con fuerza: la empresa informó ingresos de 96.200 millones de dólares en su trimestre terminado a finales de julio de 2026, un 106 % más que un año antes. La inferencia, no el entrenamiento, es ahora el motor de crecimiento, y un chip creado específicamente para generación de baja latencia y de varios pasos es una apuesta directa por ello. Un analista en X resumió bien el ángulo estratégico:
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
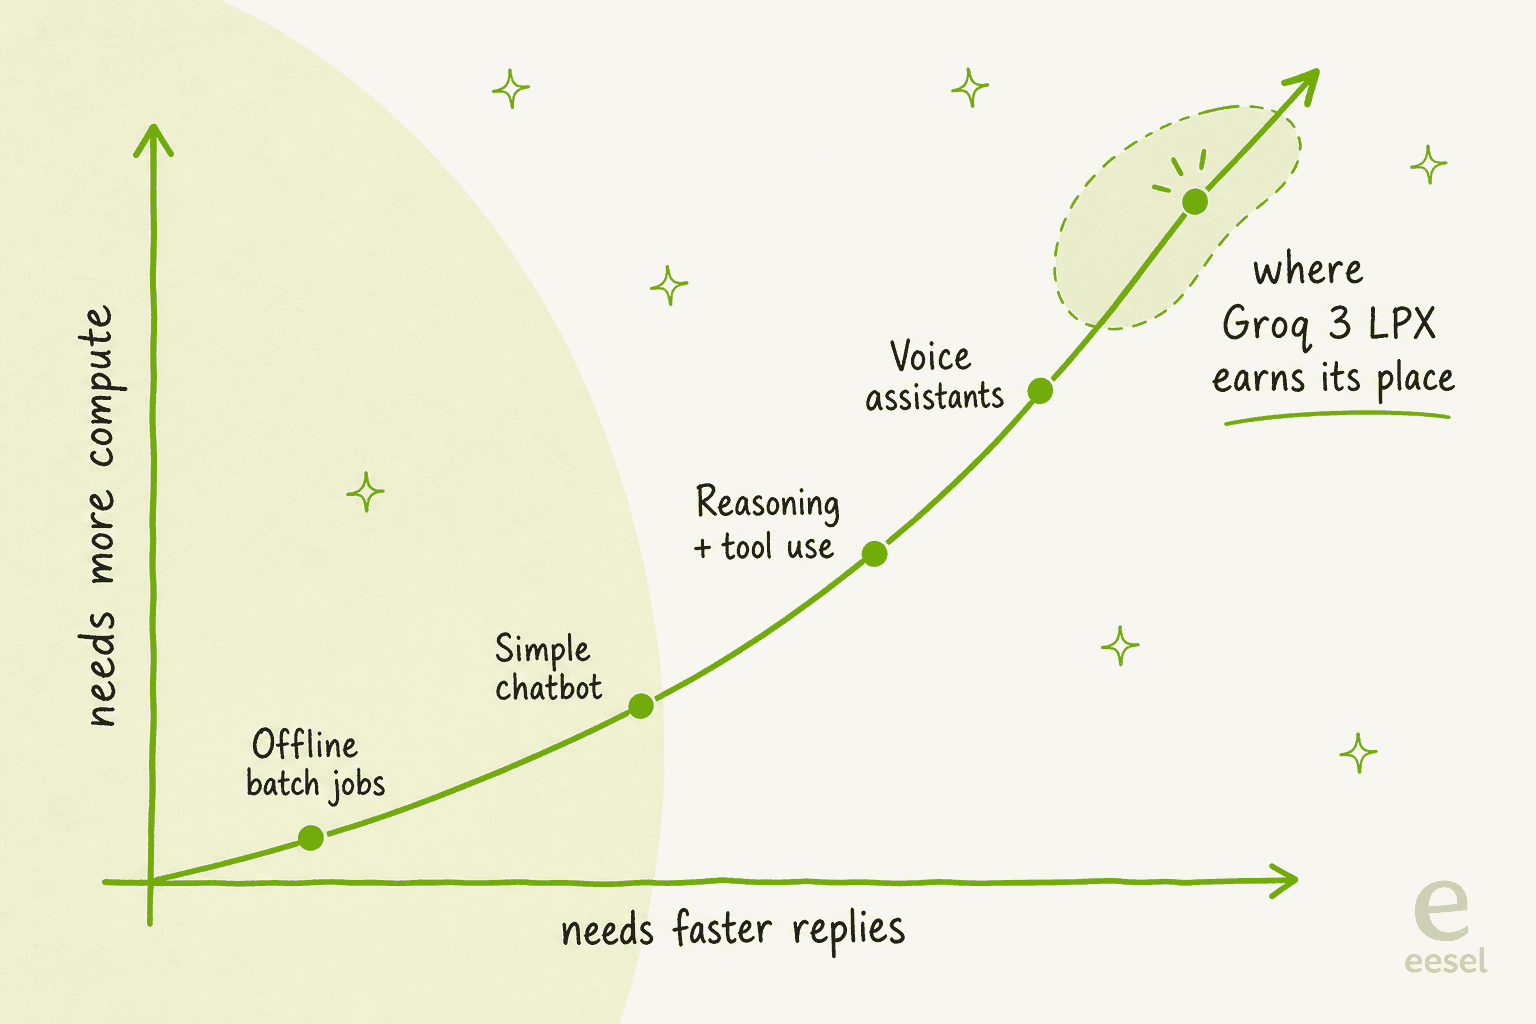
El modelo mental que ayuda: cuanto más se acerque tu carga de trabajo a "muchos turnos rápidos", más importa un motor dedicado de baja latencia. A los trabajos por lotes les da igual. A los asistentes de programación, los enjambres de agentes y la voz les importa mucho.
Qué significa esto si construyes con IA
Esta es la parte en la que quiero ser directo, porque es fácil dejarse llevar por la hoja de especificaciones. A menos que operes una nube o una plataforma de IA muy grande, no vas a comprar un rack Groq 3 LPX. Es infraestructura que está varias capas por debajo de donde trabaja la mayoría de los equipos. La notarás como tokens más rápidos y baratos en las APIs de modelos y las nubes que ya usas, igual que nunca compraste una GPU para usar un agente de IA.
Y ese es el replanteamiento útil. El chip es el motor; lo que realmente despliegas es el trabajador que va encima. Una inferencia más rápida hace que los agentes sean más ágiles y baratos de ejecutar, baja la barrera para poner automatización real en producción y cambia las cuentas de costos frente a un agente humano, ya sea un agente de programación, un agente de investigación o un agente de helpdesk con IA trabajando tu cola de soporte. La carrera del hardware consiste en hacer viable esa capa a escala. El valor sigue estando en la capa.
Dónde encaja eesel
Chips como Groq 3 LPX son la tubería. eesel es lo que contratas para hacer el trabajo encima. eesel es una plataforma de compañeros de IA: no aprovisionas inferencia ni montas un pipeline, incorporas un compañero listo para trabajar en un rol concreto y lo conectas a tus apps. El equipo actual incluye un compañero de helpdesk con IA que se une a tu cola de soporte y es más que un simple chatbot de soporte, y un redactor de blog con IA que produce contenido como este artículo.

La diferencia concreta está en dónde aterrizan los tokens rápidos. Un compañero de soporte que responde en un segundo en vez de en ocho es toda la experiencia para quien espera, y los años que llevamos ejecutando IA en colas de soporte reales nos enseñaron la mitad poco glamurosa: la velocidad solo ayuda si la respuesta es correcta, por eso eesel simula un despliegue con tus tickets pasados antes de responder a un cliente real. Todo el silicio del mundo no arregla una respuesta equivocada dicha con seguridad. Si quieres ver al compañero en lugar del rack, puedes probar eesel gratis.